۴.۴ درس ۳ — کدگذاری و دینامیک زمانی
۴.۴.۰ چرا زمان مهم است؟
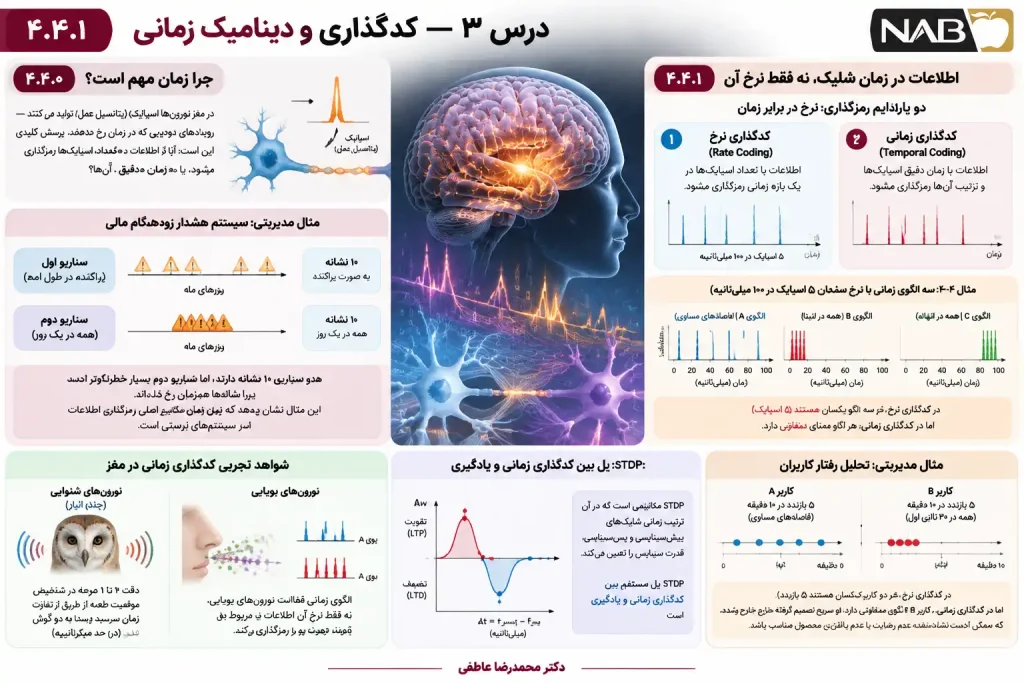
در بخش قبل دیدیم که مغز از چندین مکانیزم پلاستیسیتی همزمان استفاده میکند. اما یک پرسش بنیادینتر باقی میماند: اطلاعات در مغز چگونه رمزگذاری میشوند؟ در شبکههای عصبی مصنوعی، پاسخ ساده است: هر نورون یک عدد (فعالیت) تولید میکند و این عدد اطلاعات را منتقل میکند. اما در مغز، نورونها اسپایک (پتانسیل عمل) تولید میکنند — رویدادهای دودویی که در زمان رخ میدهند. پرسش کلیدی این است: آیا اطلاعات در «تعداد» اسپایکها رمزگذاری میشود، یا در «زمان دقیق» آنها؟
بیایید با یک مثال مدیریتی شروع کنیم. فرض کنید یک سیستم هشدار زودهنگام برای بحرانهای مالی طراحی میکنید. دو سناریو را در نظر بگیرید:
- سناریو اول: در طول یک ماه، ۱۰ نشانه هشدار (افزایش نرخ بهره، کاهش نقدینگی، افزایش نکول) بهطور پراکنده و متوالی ظاهر میشوند. سیستم شما هر نشانه را بهعنوان یک «اسپایک» دریافت میکند. در این حالت، تعداد نشانهها (۱۰) اطلاعات اصلی را منتقل میکند.
- سناریو دوم: همان ۱۰ نشانه، اما این بار همه در یک روز ظاهر میشوند. آیا این دو سناریو یکسان هستند؟ قطعاً خیر. سناریو دوم بسیار خطرناکتر است، زیرا نشانهها همزمان رخ دادهاند و احتمال بحران سیستمیک را بهشدت افزایش میدهند.
- این مثال ساده نشان میدهد که زمان فقط یک بُعد اضافی نیست؛ بلکه مکانیزم اصلی رمزگذاری اطلاعات در سیستمهای زیستی است. در این بخش، به بررسی عمیق این ایده میپردازیم: چگونه اطلاعات در زمان شلیک رمزگذاری میشود، و چگونه شبکههای عصبی اسپایکی (SNN) این اصل را پیادهسازی میکنند.
۴.۴.۱ اطلاعات در زمان شلیک، نه فقط نرخ آن
دو پارادایم رمزگذاری: نرخ در برابر زمان
در تحقیقات شبکههای عصبی اسپایکی، دو پارادایم اصلی برای رمزگذاری اطلاعات وجود دارد (Ayasi et al., 2025, p. 5):
۱. کدگذاری نرخ (Rate Coding): در این روش، اطلاعات با تعداد اسپایکها در یک بازه زمانی رمزگذاری میشود. هرچه یک نورون در واحد زمان بیشتر شلیک کند، «شدت» سیگنال بیشتر است. این روش ساده و سازگار با سختافزار نورومورفیک است (Search Result 0, L7-L9).
۲. کدگذاری زمانی (Temporal Coding): در این روش، اطلاعات با زمان دقیق اسپایکها رمزگذاری میشود. نه فقط تعداد اسپایکها، بلکه فاصله بین آنها و ترتیب آنها اطلاعات را منتقل میکند (Search Result 0, L10-L11).
بیایید تفاوت این دو را با یک مثال عددی روشن کنیم:
مثال ۴-۳: فرض کنید یک نورون در بازه ۱۰۰ میلیثانیهای، ۵ اسپایک تولید میکند. در کدگذاری نرخ، اطلاعات منتقلشده فقط «۵ اسپایک در ۱۰۰ میلیثانیه» است. اما در کدگذاری زمانی، الگوی دقیق این ۵ اسپایک مهم است:
- الگوی A: اسپایکها در زمانهای ۱۰، ۲۰، ۳۰، ۴۰، ۵۰ (فاصلههای مساوی)
- الگوی B: اسپایکها در زمانهای ۱، ۲، ۳، ۴، ۵ (همه در ابتدا)
- الگوی C: اسپایکها در زمانهای ۹۶، ۹۷، ۹۸، ۹۹، ۱۰۰ (همه در انتها)
در کدگذاری نرخ، هر سه الگو یکسان هستند (۵ اسپایک). اما در کدگذاری زمانی، هر الگو معنای متفاوتی دارد. الگوی B ممکن است نشاندهنده «پاسخ سریع به یک محرک» باشد، در حالی که الگوی C نشاندهنده «پاسخ تأخیری» است.
کدگذاری زمانی در مغز: شواهد تجربی
شواهد تجربی متعددی نشان میدهند که مغز از کدگذاری زمانی استفاده میکند. یکی از معروفترین مثالها، نورونهای شنوایی در مغز جغد انبار است. این جغد میتواند موقعیت طعمه را با دقت ۱ تا ۲ درجه تشخیص دهد — و این دقت فقط از طریق تفاوت زمان رسیدن صدا به دو گوش (در حد میکروثانیه) امکانپذیر است (Gerstner et al., 2010).
مثال دیگر، نورونهای بویایی در سیستم بویایی است. مطالعات نشان دادهاند که الگوی زمانی فعالیت نورونهای بویایی، نه فقط نرخ آن، اطلاعات مربوط به هویت بو را رمزگذاری میکند. دو بوی متفاوت ممکن است همان نرخ فعالیت را در یک نورون ایجاد کنند، اما الگوهای زمانی متفاوتی داشته باشند (Gerstner et al., 2010).
STDP: پل بین کدگذاری زمانی و یادگیری
همانطور که در بخش ۴.۳ دیدیم، STDP (پلاستیسیتی وابسته به زمانبندی اسپایک) مکانیزمی است که در آن ترتیب زمانی شلیکهای پیشسیناپسی و پسسیناپسی، قدرت سیناپس را تعیین میکند. STDP در واقع پل مستقیم بین کدگذاری زمانی و یادگیری است: اگر مغز از کدگذاری زمانی استفاده میکند، پس مکانیزم یادگیری آن نیز باید حساس به زمان باشد. STDP دقیقاً همین کار را میکند.
مثال مدیریتی از کدگذاری زمانی: فرض کنید یک پلتفرم تجارت الکترونیک میخواهد رفتار کاربران را تحلیل کند. دو کاربر را در نظر بگیرید:
- کاربر A: در ۱۰ دقیقه، ۵ صفحه محصول مختلف را بازدید میکند (فاصلههای مساوی).
- کاربر B: در ۱۰ دقیقه، ۵ صفحه محصول را بازدید میکند، اما همه در ۳۰ ثانیه اول و سپس خروج.
در کدگذاری نرخ، هر دو کاربر یکسان هستند (۵ بازدید). اما در کدگذاری زمانی، کاربر B الگوی متفاوتی دارد: او سریع تصمیم گرفته و خارج شده — که ممکن است نشاندهنده عدم رضایت یا عدم یافتن محصول مناسب باشد. یک سیستم با کدگذاری زمانی میتواند این تفاوت را تشخیص دهد؛ یک سیستم با کدگذاری نرخ نمیتواند.
۴.۴.۲ شبکههای عصبی اسپایکی (SNN) بهعنوان نسل سوم
نسلهای شبکههای عصبی
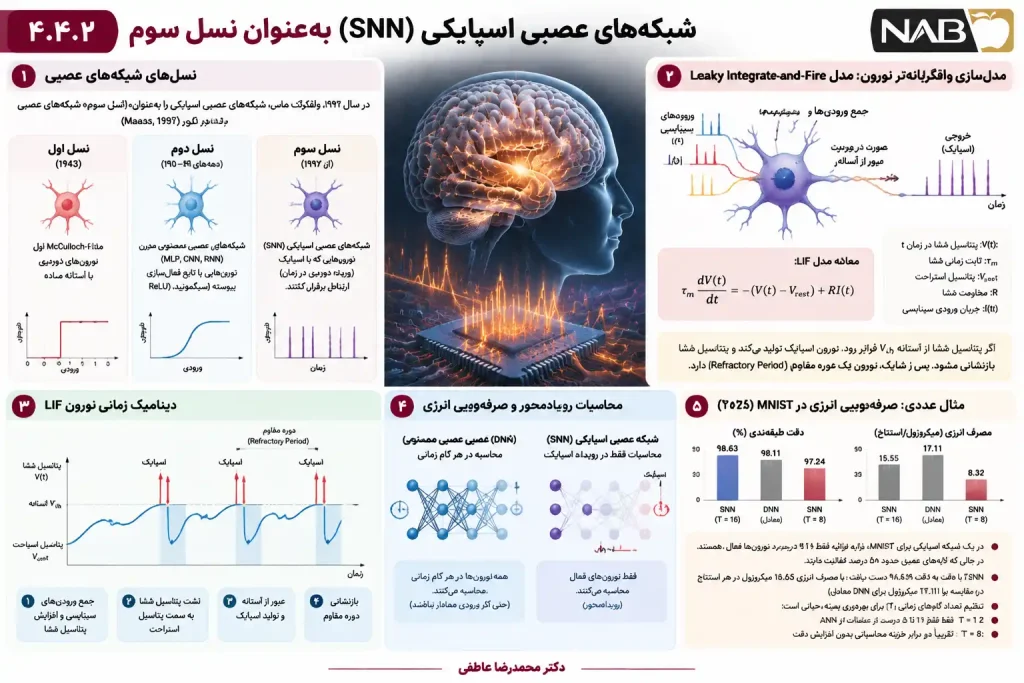
در سال ۱۹۹۷، ولفگانگ ماس، یکی از پیشگامان علوم اعصاب محاسباتی، شبکههای عصبی اسپایکی را بهعنوان «نسل سوم» شبکههای عصبی معرفی کرد (Maass, 1997). در این طبقهبندی:
- نسل اول: مدل McCulloch-Pitts (۱۹۴۳) — نورونهای دودویی با آستانه ساده
- نسل دوم: شبکههای عصبی مصنوعی مدرن (MLP، CNN، RNN) — نورونهایی با تابع فعالسازی پیوسته (سیگموئید، ReLU)
- نسل سوم: شبکههای عصبی اسپایکی (SNN) — نورونهایی که با اسپایک (رویداد دودویی در زمان) ارتباط برقرار میکنند
تفاوت بنیادین: در نسل دوم، خروجی هر نورون یک عدد پیوسته است (مثلاً ۰.۷). در نسل سوم، خروجی هر نورون یک رویداد زمانی است: یا اسپایک تولید میشود (۱) یا نمیشود (۰)، و زمان این رویداد حامل اطلاعات است (Maass, 1997).
مدلسازی واقعگرایانهتر نورون
SNN ها از مدلهای نورونی استفاده میکنند که به زیستشناسی نزدیکتر هستند. یکی از رایجترین این مدلها، مدل Leaky Integrate-and-Fire (LIF) است. در این مدل:
۱. نورون یک پتانسیل غشا (Membrane Potential) دارد که با ورود سیگنالهای تحریکی افزایش و با گذشت زمان نشت (Leak) میکند.
۲. اگر پتانسیل غشا از یک آستانه فراتر رود، نورون اسپایک تولید میکند و پتانسیل غشا بازنشانی میشود.
۳. پس از شلیک، نورون یک دوره مقاوم (Refractory Period) دارد که در آن نمیتواند شلیک کند.
فرمول ساده مدل LIF:
که در آن:
- V(t)— پتانسیل غشا در زمانt
- τm — ثابت زمانی غشا
- Vrest— پتانسیل استراحت
- R —مقاومت غشا
- I(t)—جریان ورودی سیناپسی
تفسیر شهودی: معادله ۴-۷ بیان میکند که پتانسیل غشا با نشت به سمت پتانسیل استراحت میل میکند، اما ورودیهای سیناپسی آن را بالا میبرند. اگر ورودیها کافی باشند، پتانسیل از آستانه فراتر میرود و نورون شلیک میکند. این مدل، دینامیک زمانی نورون را بهطور طبیعی در بر میگیرد — چیزی که در نورونهای مصنوعی نسل دوم غایب است.
محاسبات رویدادمحور و بهرهوری انرژی
یکی از مزایای کلیدی SNN، محاسبات رویدادمحور (Event-Driven Computation) است. در شبکههای نسل دوم، همه نورونها در هر گام زمانی محاسبه میکنند — صرفنظر از اینکه ورودی معناداری دریافت کردهاند یا نه. اما در SNN، محاسبات فقط زمانی انجام میشود که یک اسپایک رخ دهد (Search Result 0, L30-L31).
مثال عددی از صرفهجویی انرژی: مطالعهای در سال ۲۰۲۵ نشان داد که در یک شبکه اسپایکی برای طبقهبندی MNIST، لایههای اولیه فقط ۴ تا ۹ درصد نورونها فعال هستند، در حالی که لایههای عمیق حدود ۵۰ درصد فعالیت دارند (Search Result 7, L18-L20). این پراکندگی فعالیت (Sparsity) به این معناست که SNN میتواند ۵۰ تا ۹۰ درصد محاسبات را حذف کند — بدون از دست دادن دقت.
مطالعه دیگری نشان داد که SNN با T=16 گام زمانی، به دقت ۹۸.۶۳٪ در MNIST دست یافت، با مصرف انرژی ۱۵.۵۵ میکروژول در هر استنتاج، در مقایسه با ۱۷.۱۱ میکروژول برای DNN معادل — یعنی ۱.۱ برابر بهرهوری انرژی بیشتر (Search Result 8, L22-L24).
نکته مهم: بهرهوری انرژی SNN به تعداد گامهای زمانی (Time Steps) بستگی دارد. مطالعهای دیگر نشان داد که SNN با T=1 یا T=2 فقط به ۲۴ تا ۵۲ درصد از عملیات ANN نیاز دارد، در حالی که T=8 تقریباً دو برابر هزینه ایجاد میکند بدون افزایش دقت (Search Result 7, L21-L24). این یافته نشان میدهد که تنظیم دقیق گامهای زمانی برای بهرهوری بهینه حیاتی است.
۴.۴.۳ چالشها و فرصتها
دشواری آموزش SNN
با وجود مزایای انرژی، SNN ها با یک چالش بنیادین مواجهند: آموزش آنها دشوار است. دلیل اصلی این است که تولید اسپایک یک فرآیند غیرقابلمشتقگیری (Non-Differentiable) است. وقتی نورون شلیک میکند، خروجی آن از ۰ به ۱ میپرد — و در این نقطه، گرادیان تعریف نشده است (Search Result 3, L17-L18).
راهحل: گرادیان جانشین (Surrogate Gradient). محققان روشی ابداع کردهاند که در آن، در مسیر رفت (Forward Pass) از تابع پلهای واقعی (شلیک/عدم شلیک) استفاده میشود، اما در مسیر برگشت (Backward Pass) از یک تابع هموار (مانند سیگموئید) بهعنوان جانشین گرادیان استفاده میشود (Search Result 3, L9-L10). این روش به SNN امکان میدهد با Backpropagation آموزش ببیند.
چالش باقیمانده: گرادیان جانشین یک تقریب است، نه یک گرادیان دقیق. این بدان معناست که آموزش SNN ممکن است ناپایدار باشد یا به کمینههای محلی ضعیف منتهی شود. مطالعهای در سال ۲۰۲۵ نشان داد که توزیع پتانسیل غشا ممکن است با گذشت زمان از آستانه منحرف شود، که منجر به محو شدن گرادیان میشود (Search Result 3, L31-L34).
پتانسیل سختافزار نورومورفیک
یکی از بزرگترین فرصتهای SNN، سختافزار نورومورفیک است — تراشههایی که بهطور اختصاصی برای اجرای SNN طراحی شدهاند. معروفترین این تراشهها عبارتند از:
- IBM TrueNorth: یک تراشه با ۱ میلیون نورون و ۲۵۶ میلیون سیناپس که فقط ۷۰ میلیوات انرژی مصرف میکند (Search Result 9, L30-L32).
- Intel Loihi: یک تراشه تحقیقاتی که یادگیری on-chip را پشتیبانی میکند (Search Result 10, L44).
- SpiNNaker: یک سیستم چندهزارهای که برای شبیهسازی شبکههای عصبی بیولوژیکی در زمان واقعی طراحی شده است (Search Result 9, L28-L29).
مزیت کلیدی این تراشهها: آنها حافظه و محاسبه را در یک مکان قرار میدهند (In-Memory Computing)، که مشکل انتقال داده بین حافظه و پردازنده را — که در معماریهای فوننویمان گلوگاه اصلی است — برطرف میکند (Search Result 10, L41-L44).
چالش باقیمانده: سختافزار نورومورفیک هنوز بالغ نشده است. مجموعههای داده رویدادمحور (Event-Based Datasets) کمیاب هستند، ابزارهای توسعه محدودند، و دسترسی به این سختافزارها محدود است (Search Result 11, L24-L28).
مثال گسترده: پیادهسازی SNN برای MNIST و مقایسه انرژی
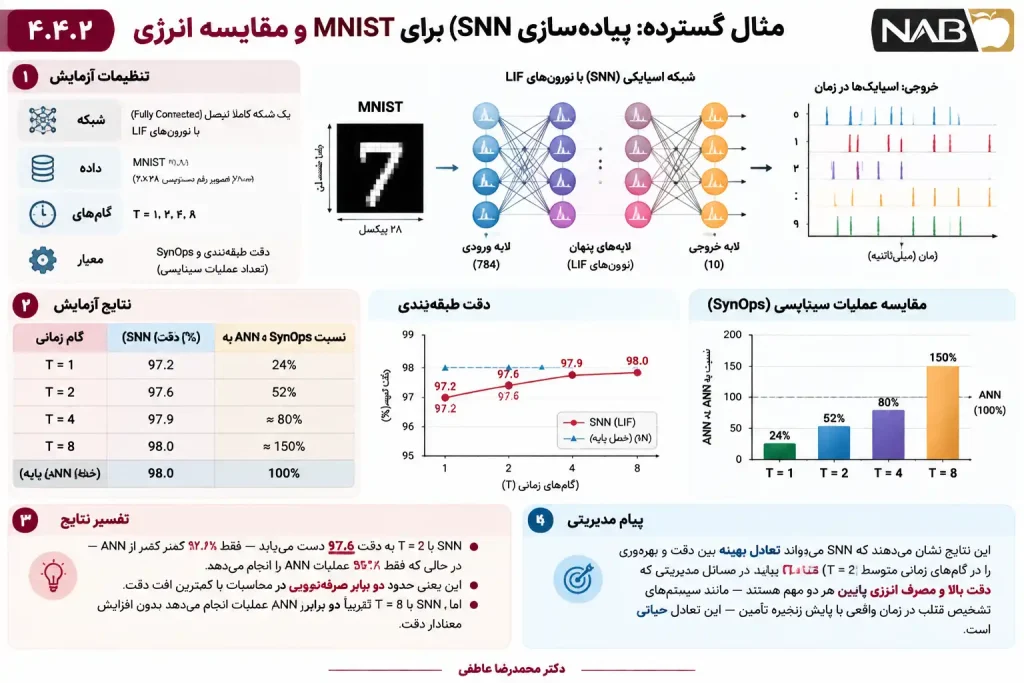
برای درک عملی این مفاهیم، بیایید یک مثال کامل را مرور کنیم. مطالعهای در سال ۲۰۲۵ یک SNN با نورونهای LIF و آموزش گرادیان جانشین را برای طبقهبندی MNIST پیادهسازی کرد (Search Result 7, L12-L17).
تنظیمات آزمایش:
- شبکه: یک شبکه کاملاً متصل (Fully Connected) با نورونهای LIF
- داده: MNIST (۷۰,۰۰۰ تصویر رقم دستنویس ۲۸×۲۸)
- گامهای زمانی: ۱، ۲، ۴، ۸ =T
- معیار: دقت طبقهبندی و SynOps (تعداد عملیات سیناپسی)
نتایج:
| گام زمانی | دقت SNN | نسبت SynOps به ANN |
| ۱= T | ۹۷.۲٪ | ۲۴٪ |
| T =۲ | ۹۷.۶٪ | ۵۲٪ |
| ۴=T | ۹۷.۹٪ | ~۸۰٪ |
| ۸= T | ۹۸.۰٪ | ~۱۵۰٪ |
| ANN (خط پایه) | ۹۸.۰٪ | ۱۰۰٪ |
تفسیر: SNN با ۲= T به دقت ۹۷.۶٪ دست مییابد — فقط ۰.۴٪ کمتر از ANN — در حالی که فقط ۵۲٪ از عملیات ANN را انجام میدهد. این یعنی حدود دو برابر صرفهجویی در محاسبات با کمترین افت دقت. اما SNN با T=۸ تقریباً دو برابر ANN عملیات انجام میدهد بدون افزایش معنادار دقت (Search Result 7, L21-L24).
پیام مدیریتی: این نتایج نشان میدهند که SNN میتواند تعادل بهینه بین دقت و بهرهوری را در گامهای زمانی متوسط (۲ T=تا ۴) بیابد. در مسائل مدیریتی که دقت بالا و مصرف انرژی پایین هر دو مهم هستند — مانند سیستمهای تشخیص تقلب در زمان واقعی یا پایش زنجیره تأمین — این تعادل حیاتی است.
جمعبندی: از زمان تا هوش کارآمد
در این بخش دیدیم که:
۱. زمان فقط یک بُعد اضافی نیست؛ بلکه مکانیزم اصلی رمزگذاری اطلاعات در مغز است. کدگذاری زمانی (Temporal Coding) اطلاعات را در زمان دقیق اسپایکها رمزگذاری میکند، نه فقط در تعداد آنها.
۲. شبکههای عصبی اسپایکی (SNN) بهعنوان نسل سوم شبکههای عصبی، از مدلهای نورونی واقعگرایانهتر (مانند LIF) استفاده میکنند و دینامیک زمانی را بهطور طبیعی در بر میگیرند.
۳. محاسبات رویدادمحور در SNN به بهرهوری انرژی قابلتوجه منجر میشود: در MNIST، SNN با ۲ T= فقط ۵۲٪ عملیات ANN را انجام میدهد، با کمترین افت دقت.
۴. چالش اصلی SNN، آموزش آن است: تولید اسپایک غیرقابلمشتق است، و روشهای گرادیان جانشین اگرچه مؤثرند، اما تقریبی هستند و ممکن است به ناپایداری منجر شوند.
۵. سختافزار نورومورفیک (مانند TrueNorth و Loihi) پتانسیل تحولآفرین دارد، اما هنوز بالغ نشده است و با محدودیتهای ابزار، داده و دسترسی مواجه است.
پیام مدیریتی کلیدی: در مسائلی که دادهها ماهیت زمانی دارند — مانند تحلیل سریهای زمانی مالی، پیشبینی تقاضا، تشخیص ناهنجاری در تراکنشها، یا پایش بلادرنگ سیستمها — کدگذاری زمانی و SNN میتوانند دقت بالاتر و بهرهوری انرژی بیشتر ارائه دهند. در مقابل، در مسائلی که دادهها ایستا هستند (مانند طبقهبندی تصاویر ثابت)، شبکههای نسل دوم ممکن است همچنان گزینه بهتری باشند. انتخاب بین این دو رویکرد، باید آگاهانه و بر اساس ماهیت مسئله انجام شود.
در بخش بعدی، به درس چهارم میپردازیم: بهرهوری انرژی — یعنی چگونه مغز با ۲۰ وات انرژی کارهایی انجام میدهد که ابررایانهها با مگاوات از انجام دقیق آنها عاجزند، و چه درسهایی برای طراحی سیستمهای مصنوعی دارد.
منابع این بخش
Ayasi, B., Carmona, C. J., Saleh, M., & García-Vico, A. M. (2025). A practical tutorial on spiking neural networks: Comprehensive review, models, experiments, software tools, and implementation guidelines. Eng, 6(11), 304. https: //doi.org/10.3390/eng6110304
Gerstner, W., Ritz, R., & van Hemmen, J. L. (2010). Why spikes? Hebbian learning and retrieval of time-resolved excitation patterns. Biological Cybernetics, 103(5), 379–391. https: //doi.org/10.1007/s00422-010-0401-7
Maass, W. (1997). Networks of spiking neurons: The third generation of neural network models. Neural Networks, 10(9), 1659–1671. https: //doi.org/10.1016/S0893-6080(97)00011-7
۴.۵ درس ۴ — بهرهوری انرژی
۴.۵.۰ چرا یک مغز ۲۰ واتی میتواند کارهایی انجام دهد که ابررایانهها از آن عاجزند؟
در بخش قبل دیدیم که شبکههای عصبی اسپایکی چگونه با محاسبات رویدادمحور، بهرهوری انرژی قابلتوجهی بهدست میآورند. اما این دستاورد، در مقایسه با کارایی مغز انسان، تقریباً ناچیز است. بیایید با یک مقایسه ساده شروع کنیم.
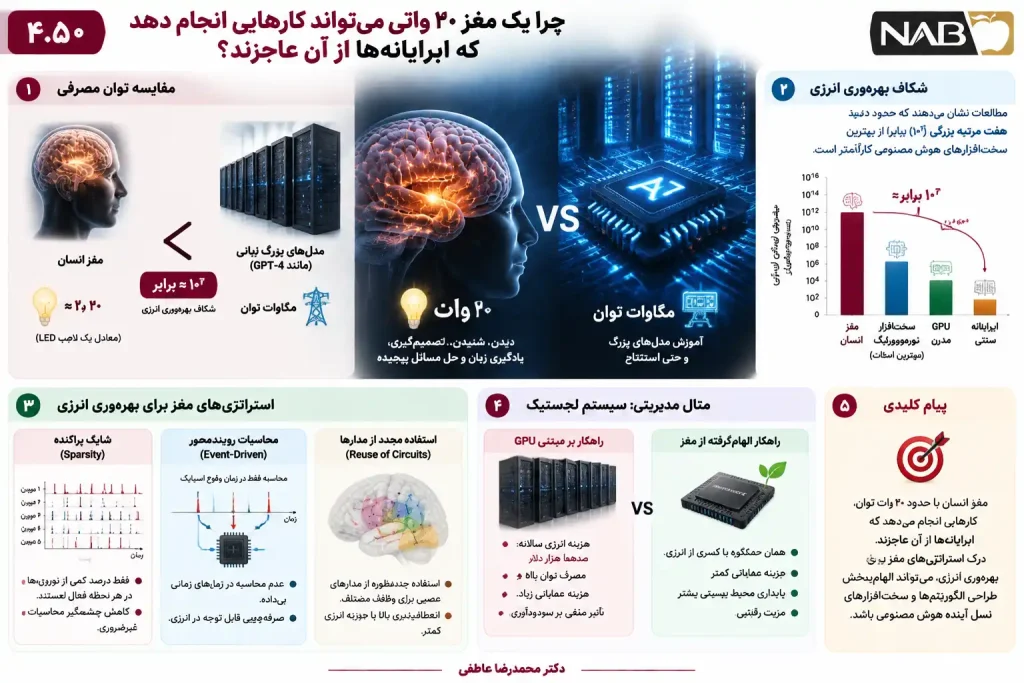
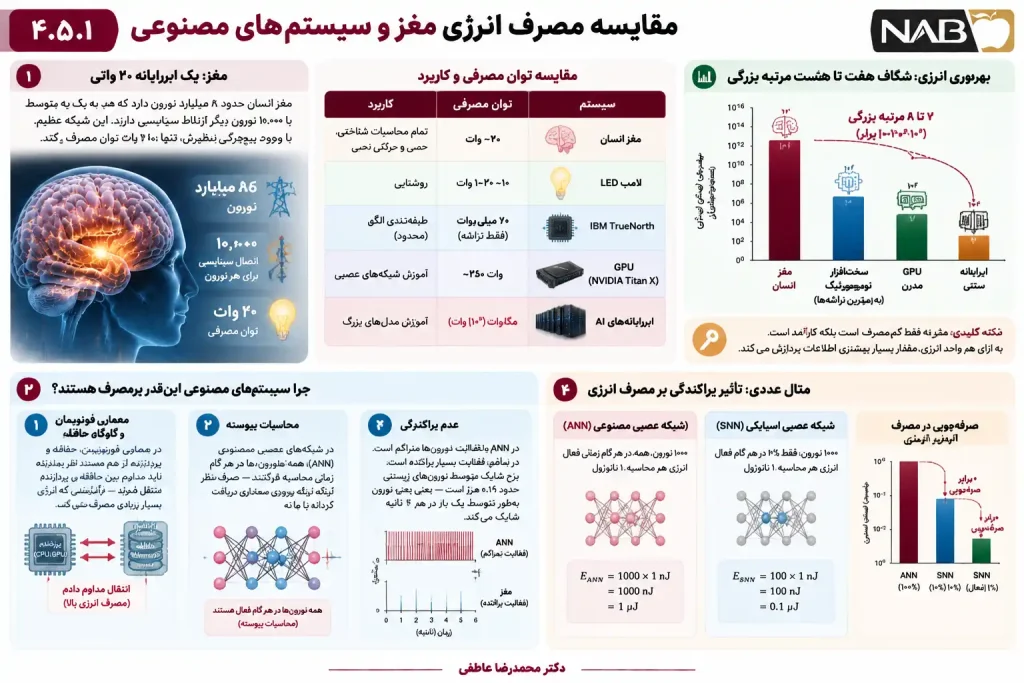
مغز انسان با حدود ۲۰ وات توان — معادل یک لامپ LED کممصرف — تمام محاسبات لازم برای دیدن، شنیدن، تصمیمگیری، یادگیری زبان و حل مسائل پیچیده را انجام میدهد (The Conversation, 2026). در مقابل، یک مدل بزرگ زبانی مانند GPT-4 برای آموزش، به مگاوات توان نیاز دارد و حتی در زمان استنتاج نیز مصرف انرژی آن با مغز قابل مقایسه نیست. مطالعهای در سال ۲۰۲۴ نشان داد که شکاف بهرهوری انرژی بین مغز و بهترین سختافزارهای هوش مصنوعی، حدود هفت مرتبه بزرگی (۱۰⁷ برابر) است (Hayadan, 2025).
این شکاف حیرتانگیز، یک پرسش بنیادین را مطرح میکند: مغز چگونه این کارایی را بهدست میآورد؟ و چه درسهایی برای طراحی سیستمهای مصنوعی دارد؟
بیایید با یک مثال مدیریتی این اهمیت را روشن کنیم. تصور کنید یک شرکت لجستیک میخواهد یک سیستم هوش مصنوعی برای بهینهسازی مسیرهای ناوگان خود پیادهسازی کند. اگر از مدلهای بزرگ مبتنی بر GPU استفاده کند، هزینه انرژی سالانه این سیستم میتواند به صدها هزار دلار برسد — و این هزینه، مستقیماً بر سودآوری شرکت تأثیر میگذارد. در مقابل، اگر سیستم الهامگرفته از مغز طراحی شود، میتواند همان عملکرد را با کسری از انرژی ارائه دهد. این تفاوت، نه فقط یک مسئله فنی، بلکه یک مزیت رقابتی است.
در این بخش، به بررسی عمیق استراتژیهای مغز برای بهرهوری انرژی میپردازیم: شلیک پراکنده، محاسبات رویدادمحور، و استفاده مجدد از مدارها. سپس نشان میدهیم که چگونه این استراتژیها در سختافزار نورومورفیک پیادهسازی شدهاند و چه پیامدهایی برای طراحی الگوریتمهای یادگیری عمیق دارند.
۴.۵.۱ مقایسه مصرف انرژی مغز و سیستمهای مصنوعی
مغز: یک ابررایانه ۲۰ واتی
مغز انسان حدود ۸۶ میلیارد نورون دارد که هر یک بهطور متوسط با ۱۰,۰۰۰ نورون دیگر ارتباط سیناپسی دارند. این شبکه عظیم، با وجود پیچیدگی بینظیرش، تنها ۲۰ وات توان مصرف میکند (The Conversation, 2026; Quantum Zeitgeist, 2025). برای درک بهتر این عدد، مقایسه زیر مفید است:
| سیستم | توان مصرفی | کاربرد |
| مغز انسان | ~۲۰ وات | تمام محاسبات شناختی، حسی و حرکتی |
| لامپ LED | ~۱۰–۲۰ وات | روشنایی |
| IBM TrueNorth | ۷۰ میلیوات (فقط تراشه) | طبقهبندی الگو (محدود) |
| GPU (NVIDIA Titan X) | ~۲۵۰ وات | آموزش شبکههای عصبی |
| ابررایانههای AI | مگاوات (۱۰⁶ وات) | آموزش مدلهای بزرگ |
نکته کلیدی: مغز نه فقط کممصرف است، بلکه کارآمد است. یعنی به ازای هر واحد انرژی، مقدار بسیار بیشتری اطلاعات پردازش میکند. مطالعهای در سال ۲۰۲۴ نشان داد که بهرهوری انرژی مغز میتواند تا هشت مرتبه بزرگی (۱۰⁸ برابر) بیشتر از پیشرفتهترین تراشههای کامپیوتری باشد (Quantum Zeitgeist, 2025).
چرا سیستمهای مصنوعی اینقدر پرمصرف هستند؟
پرمصرف بودن سیستمهای مصنوعی، ناشی از چند عامل بنیادین است:
۱. معماری فوننویمان و گلوگاه حافظه: در معماری فوننویمان (که اساس تمام کامپیوترهای مدرن است)، حافظه و پردازنده از هم جدا هستند. این بدان معناست که دادهها باید مداوم بین حافظه و پردازنده منتقل شوند — فرآیندی که انرژی بسیار زیادی مصرف میکند. در مغز، حافظه و محاسبه در یک مکان قرار دارند (In-Memory Computing)، بنابراین این گلوگاه وجود ندارد.
۲. محاسبات پیوسته: در شبکههای عصبی مصنوعی نسل دوم (ANN)، همه نورونها در هر گام زمانی محاسبه میکنند — صرفنظر از اینکه ورودی معناداری دریافت کردهاند یا نه. این محاسبات پیوسته، انرژی زیادی مصرف میکند. در مغز، محاسبات رویدادمحور است: نورونها فقط زمانی فعال میشوند که ورودی کافی دریافت کنند.
۳. عدم پراکندگی: در ANN، فعالیت نورونها متراکم است: اکثر نورونها در هر لحظه فعال هستند. در مغز، فعالیت بسیار پراکنده است: مطالعهای نشان داد که نرخ شلیک متوسط نورونهای زیستی حدود ۰.۱۶ هرتز است — یعنی هر نورون بهطور متوسط یک بار در هر ۶ ثانیه شلیک میکند (KIT, 2023). این پراکندگی شدید، مصرف انرژی را بهشدت کاهش میدهد.
مثال عددی: فرض کنید یک شبکه عصبی مصنوعی با ۱۰۰۰ نورون داریم که در هر گام زمانی، همه نورونها محاسبه میکنند. اگر هر محاسبه ۱ نانوجول انرژی مصرف کند، کل انرژی در هر گام برابر است با:
در مقابل، یک شبکه اسپایکی با همان ۱۰۰۰ نورون، اگر فقط ۱۰٪ نورونها در هر گام فعال باشند، انرژی مصرفی برابر است با:
این یعنی ۱۰ برابر صرفهجویی — فقط به دلیل پراکندگی. اگر پراکندگی به ۱٪ برسد (که در مغز واقعی است)، صرفهجویی به ۱۰۰ برابر میرسد.
۴.۵.۲ استراتژیهای مغز برای بهرهوری انرژی
مغز برای دستیابی به این کارایی حیرتانگیز، از چند استراتژی کلیدی استفاده میکند که هر یک بهطور مستقل قابل پیادهسازی در سیستمهای مصنوعی است.
الف) شلیک پراکنده (Sparse Firing)
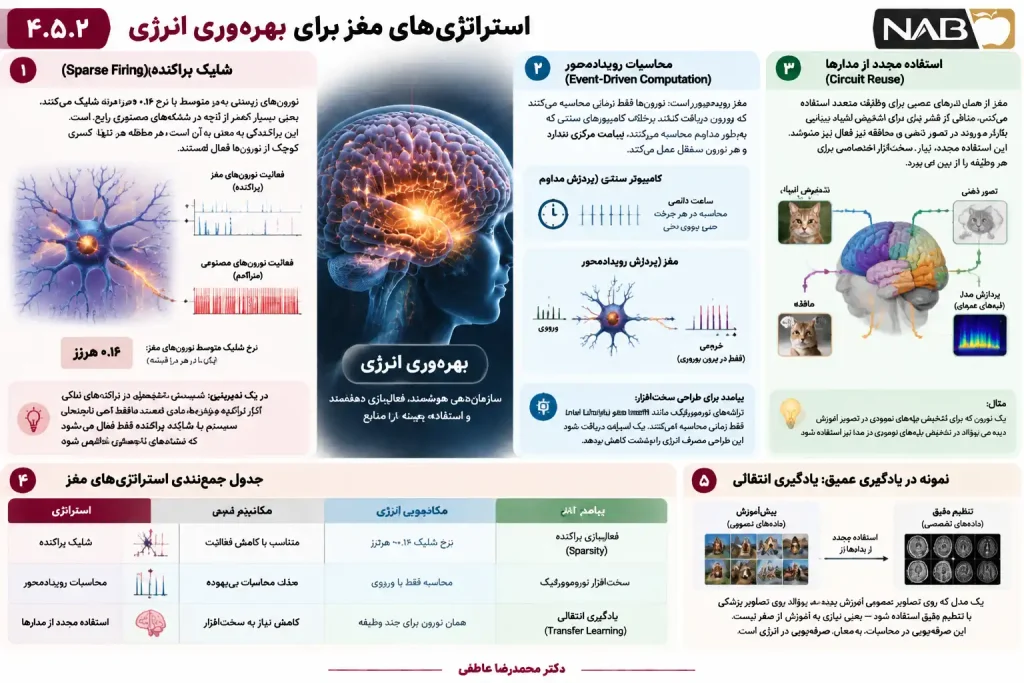
شلیک پراکنده یکی از مهمترین استراتژیهای مغز برای صرفهجویی در انرژی است. همانطور که اشاره شد، نورونهای زیستی بهطور متوسط با نرخ ۰.۱۶ هرتز شلیک میکنند — یعنی بسیار کمتر از آنچه در شبکههای مصنوعی رایج است (KIT, 2023). این پراکندگی به معنای آن است که در هر لحظه، تنها کسری کوچک از نورونها فعال هستند.
چرا پراکندگی انرژی را کاهش میدهد؟ تولید هر اسپایک، انرژی قابلتوجهی مصرف میکند (عمدتاً به دلیل پمپهای یونی که باید غلظت یونها را بازگردانند). اگر نورونها کمتر شلیک کنند، انرژی کمتری مصرف میشود. اما نکته مهم این است که اطلاعات از دست نمیرود: مطالعات نشان دادهاند که کدهای پراکنده (Sparse Codes) میتوانند ظرفیت نمایشی بالا با هزینه انرژی پایین داشته باشند، زیرا ترکیبهای بسیار متنوعی از «کدام نورونها فعال هستند» میتواند اطلاعات را رمزگذاری کند (Levy & Baxter, 1996; PLOS Computational Biology, 2022).
مثال مدیریتی: در یک سیستم تشخیص ناهنجاری در تراکنشهای بانکی، اکثر تراکنشها عادی هستند و فقط تعداد کمی ناهنجار. یک سیستم با شلیک پراکنده، فقط زمانی فعال میشود که نشانههای ناهنجاری ظاهر شود — نه برای هر تراکنش. این یعنی مصرف انرژی متناسب با رخدادها، نه متناسب با حجم داده.
ب) محاسبات رویدادمحور (Event-Driven Computation)
مغز رویدادمحور است: نورونها فقط زمانی محاسبه میکنند که ورودی دریافت کنند. این برخلاف کامپیوترهای سنتی است که مداوم محاسبه میکنند، صرفنظر از وجود ورودی.
تفاوت بنیادین: در یک کامپیوتر سنتی، ساعت (Clock) مداوم تیک میزند و پردازنده در هر چرخه محاسبه انجام میدهد. در مغز، ساعت مرکزی وجود ندارد: هر نورون مستقل عمل میکند و فقط زمانی که سیگنال کافی دریافت کند، پاسخ میدهد.
پیامد برای طراحی سختافزار: این اصل، اساس سختافزار نورومورفیک است. تراشههای نورومورفیک مانند IBM TrueNorth و Intel Loihi رویدادمحور طراحی شدهاند: آنها فقط زمانی محاسبه میکنند که یک اسپایک دریافت شود. این طراحی، مصرف انرژی را بهشدت کاهش میدهد، زیرا بخش اعظم تراشه در هر لحظه غیرفعال است.
ج) استفاده مجدد از مدارها (Circuit Reuse)
مغز از همان مدارهای عصبی برای وظایف متعدد استفاده میکند. برای مثال، مناطقی از قشر که برای تشخیص اشیاء بینایی استفاده میشوند، در تصور ذهنی و حافظه نیز فعال میشوند. این استفاده مجدد، نیاز به سختافزار اختصاصی برای هر وظیفه را از بین میبرد و بهرهوری انرژی را افزایش میدهد.
مثال: یک نورون که برای تشخیص لبههای عمودی در تصویر آموزش دیده، میتواند در تشخیص لبههای عمودی در صدا (از طریق تبدیل فرکانس به فضای شبیه تصویر) نیز استفاده شود. این تعمیمپذیری، نیاز به نورونهای جدید را کاهش میدهد.
پیامد برای یادگیری عمیق: در شبکههای عصبی مصنوعی، یادگیری انتقالی (Transfer Learning) و پیشآموزش (Pre-training) نمونههایی از استفاده مجدد هستند. یک مدل که روی تصاویر عمومی آموزش دیده، میتواند روی تصاویر پزشکی با تنظیم دقیق (Fine-tuning) استفاده شود — یعنی نیازی به آموزش از صفر نیست. این صرفهجویی در محاسبات، به معنای صرفهجویی در انرژی است.
جدول جمعبندی استراتژیهای مغز
| استراتژی | مکانیزم | صرفهجویی انرژی | پیامد برای AI |
| شلیک پراکنده | نرخ شلیک ~۰.۱۶ هرتز | متناسب با کاهش فعالیت | فعالسازی پراکنده (Sparsity) |
| محاسبات رویدادمحور | محاسبه فقط با ورودی | حذف محاسبات بیهوده | سختافزار نورومورفیک |
| استفاده مجدد از مدار | همان نورون برای چند وظیفه | کاهش نیاز به سختافزار | یادگیری انتقالی |
۴.۵.۳ پیامدها برای طراحی سختافزار و الگوریتم
سختافزار نورومورفیک: از نظریه تا عمل
استراتژیهای مغز، الهامبخش نسل جدیدی از سختافزارها شدهاند که به نورومورفیک (Neuromorphic) معروف هستند. این تراشهها بهطور اختصاصی برای شبکههای عصبی اسپایکی طراحی شدهاند و محاسبات رویدادمحور را در سطح سختافزار پیادهسازی میکنند.
معروفترین تراشههای نورومورفیک:
| تراشه | سازنده | تعداد نورون | توان مصرفی | ویژگی کلیدی |
| TrueNorth | IBM | ۱ میلیون | ۷۰ میلیوات | ۲۵۶ میلیون سیناپس |
| Loihi 2 | Intel | ~۱ میلیون | ۱.۸ وات | یادگیری on-chip |
| SpiNNaker 2 | TU Dresden | ~۱۰ میلیون | متغیر | شبیهسازی زمان واقعی |
| BrainScaleS | Heidelberg | ~۲۰۰,۰۰۰ | متغیر | مدلسازی آنالوگ |
مثال گسترده: IBM TrueNorth و مقایسه با GPU
برای درک عملی این مفاهیم، بیایید به IBM TrueNorth نگاه دقیقتری بیندازیم. TrueNorth یک تراشه نورومورفیک است که در سال ۲۰۱۴ معرفی شد. این تراشه ۱ میلیون نورون و ۲۵۶ میلیون سیناپس دارد — اما تنها ۷۰ میلیوات توان مصرف میکند (IBM Research, 2014).
مقایسه با GPU:
| معیار | IBM TrueNorth | NVIDIA Titan X (GPU) |
| توان مصرفی | ۷۰ میلیوات | ~۲۵۰ وات |
| حافظه | ۲۵۶ MB (on-chip) | ۱۲ GB (خارجی) |
| معماری | رویدادمحور | مبتنی بر ساعت |
| کارایی (تصویر/وات) | ~۶۰۰۰ فریم/وات | ~۱۰ فریم/وات |
نتیجه: TrueNorth در وظایف رویدادمحور (مانند طبقهبندی تصاویر ثابت)، ۶۰۰ برابر کارآمدتر از GPU است (IBM Research, 2016). IBM همچنین نشان داد که TrueNorth میتواند صرفهجویی انرژی تا ۱۰,۰۰۰ برابر در وظایف رویدادمحور داشته باشد (The Conversation, 2026).
نکته مهم: TrueNorth فقط برای وظایف خاص (مانند طبقهبندی الگو) طراحی شده و عمومیمنظوره نیست. یعنی نمیتوان از آن برای آموزش مدلهای بزرگ زبانی استفاده کرد. اما برای وظایفی که ذاتاً رویدادمحور هستند — مانند پردازش سیگنالهای حسگر، تشخیص ناهنجاری در زمان واقعی، یا رباتیک — این تراشه بیرقیب است.
پیامدها برای الگوریتمهای یادگیری عمیق
استراتژیهای مغز، نه فقط بر سختافزار، بلکه بر الگوریتمها نیز تأثیر میگذارند:
۱. فعالسازی پراکنده (Sparsity): مدلهای زبانی بزرگ امروزی متراکم هستند: در هر لحظه، میلیاردها پارامتر فعال هستند. تحقیقات نشان میدهد که مدلهای پراکنده (Sparse Models) میتوانند همان عملکرد را با کسری از پارامترها ارائه دهند. برای مثال، Mixture of Experts (MoE) فقط زیرمجموعهای از پارامترها را در هر ورودی فعال میکند — شبیه به شلیک پراکنده در مغز.
۲. محاسبات رویدادمحور در زمان: شبکههای Transformer و RNN ذاتاً زمانی هستند، اما محاسبات آنها متراکم است. مدلهای اسپایکی که در بخش ۴.۴ دیدیم، محاسبات را رویدادمحور میکنند و بهرهوری انرژی را بهشدت افزایش میدهند.
۳. یادگیری انتقالی و استفاده مجدد: پیشآموزش روی دادههای بزرگ و تنظیم دقیق روی دادههای کوچک، نمونهای از استفاده مجدد است. این رویکرد، نیاز به آموزش از صفر را حذف میکند و هزینه محاسباتی — و در نتیجه مصرف انرژی — را کاهش میدهد.
مثال مدیریتی: فرض کنید یک شرکت داروسازی میخواهد مدلی برای پیشبینی اثربخشی داروهای جدید طراحی کند. اگر مدل را از صفر آموزش دهد، به میلیونها دلار انرژی GPU نیاز دارد. اما اگر از یک مدل پیشآموزشدیده روی دادههای شیمیایی عمومی استفاده کند و آن را روی دادههای خاص خود تنظیم دقیق کند، هزینه به کسری کاهش مییابد. این استفاده مجدد، دقیقاً همان استراتژی مغز است.
۴.۵.۴ چالشها و محدودیتها
با وجود پتانسیل عظیم، بهرهوری انرژی الهامگرفته از مغز با چالشهایی نیز مواجه است:
- چالش اول — عدم بلوغ ابزارها: سختافزار نورومورفیک هنوز بالغ نشده است. مجموعههای داده رویدادمحور (Event-Based Datasets) کمیاب هستند، ابزارهای توسعه محدودند، و دسترسی به این سختافزارها محدود است.
- چالش دوم — دشواری برنامهنویسی: برنامهنویسی برای تراشههای نورومورفیک کاملاً متفاوت از GPU است. توسعهدهندگان باید با مدلهای نورونی، کدگذاری اسپایکی و قواعد یادگیری محلی آشنا باشند — که هنوز استانداردسازی نشدهاند.
- چالش سوم — محدودیت دقت: تراشههای نورومورفیک معمولاً از دقت پایین (کمتر از ۸ بیت) استفاده میکنند، که برای آموزش مدلهای بزرگ مناسب نیست. آنها برای استنتاج (Inference) طراحی شدهاند، نه آموزش.
- چالش چهارم — عدم تعمیمپذیری: TrueNorth و Loihi برای وظایف خاص طراحی شدهاند و عمومیمنظور نیستند. نمیتوان از آنها برای همه مسائل مدیریتی استفاده کرد.
جمعبندی: از ۲۰ وات تا هوش کارآمد
در این بخش دیدیم که:
۱. مغز انسان با ۲۰ وات توان، کارهایی انجام میدهد که ابررایانهها با مگاوات از انجام دقیق آنها عاجزند. شکاف بهرهوری انرژی حدود هفت مرتبه بزرگی است.
۲. علت اصلی این شکاف، سه تفاوت بنیادین است: شلیک پراکنده (نرخ شلیک ~۰.۱۶ هرتز)، محاسبات رویدادمحور (محاسبه فقط با ورودی)، و استفاده مجدد از مدارها (همان نورون برای چند وظیفه).
۳. سختافزار نورومورفیک — مانند IBM TrueNorth و —Intel Loihi این استراتژیها را پیادهسازی میکنند. TrueNorth با ۷۰ میلیوات، ۶۰۰ برابر کارآمدتر از GPU در وظایف رویدادمحور است.
۴. پیامدها برای الگوریتمها شامل فعالسازی پراکنده (Sparsity)، محاسبات رویدادمحور، و یادگیری انتقالی است.
۵. چالشها شامل عدم بلوغ ابزارها، دشواری برنامهنویسی، محدودیت دقت و عدم تعمیمپذیری است.
پیام مدیریتی کلیدی: در مسائلی که دادهها ذاتاً رویدادمحور هستند — مانند تشخیص ناهنجاری در زمان واقعی، پایش زنجیره تأمین، یا رباتیک — سختافزار نورومورفیک میتواند صرفهجویی انرژی چشمگیر ارائه دهد. اما در مسائل عمومی (مانند آموزش مدلهای بزرگ زبانی)، شبکههای نسل دوم همچنان گزینه بهتری هستند. انتخاب آگاهانه بین این دو رویکرد، نیازمند درک ماهیت مسئله و محدودیتهای سختافزاری است.
در بخش بعدی، به درس پنجم میپردازیم: یادگیری بدون نظارت و خودسازماندهی — یعنی چگونه مغز بدون برچسب یاد میگیرد، و چگونه این اصول در یادگیری خودنظارتی (Self-Supervised Learning) پیادهسازی میشوند.
منابع این بخش
Hayadan. (2025, December 5). Narrowing the energy efficiency gap between the brain and artificial intelligence. https: //en.hayadan.org.il
IBM Research. (2014). TrueNorth: A million-neuron chip. IBM.
IBM Research. (2016). TrueNorth: Energy-efficient neuromorphic computing. IBM.
KIT. (2023). Biological neurons are estimated to spike on average with a frequency of 0.16 Hz. Karlsruhe Institute of Technology.
Levy, W. B., & Baxter, R. A. (1996). Energy efficient neural codes. Neural Computation, 8(3), 531–543. https: //doi.org/10.1162/neco.1996.8.3.531
PLOS Computational Biology. (2022). Efficient coding hypothesis and sparse coding. PLOS Computational Biology, 18(7), e1009642. https: //doi.org/10.1371/journal.pcbi.1009642
Quantum Zeitgeist. (2025, August 6). Neural spheres reveal brain’s energy efficiency. https: //quantumzeitgeist.com
The Conversation. (2026, September 16). Your brain runs on 20 watts. Could brain-inspired computing do the same? https: //theconversation.com
۴.۶ درس ۵ — یادگیری بدون نظارت و خودسازماندهی
۴.۶.۰ چرا مغز بدون معلم یاد میگیرد؟
تا اینجا در این فصل، درباره دندریتها، پلاستیسیتی چندمکانیزمی، کدگذاری زمانی و بهرهوری انرژی صحبت کردیم. اما یک پرسش بنیادین باقی مانده است: مغز چگونه بدون معلم و برچسب یاد میگیرد؟
بیایید با یک مثال مدیریتی شروع کنیم. تصور کنید یک شرکت بزرگ خردهفروشی میخواهد مشتریان خود را بدون هیچ دستهبندی از پیش تعیینشده به گروههای رفتاری تقسیم کند. هیچکس به سیستم نمیگوید «این مشتری وفادار است» یا «آن مشتری در حال ریزش است». سیستم باید خودش الگوها را کشف کند. مغز انسان دقیقاً همین کار را انجام میدهد: یک نوزاد بدون اینکه کسی به او بگوید «این گربه است» یا «این سگ است»، خودش مفاهیم را از دادههای حسی استخراج میکند.
این توانایی که به یادگیری بدون نظارت (Unsupervised Learning) معروف است، یکی از شگفتانگیزترین ویژگیهای مغز است. دونالد هب در سال ۱۹۴۹ پیشنهاد کرد که یادگیری در مغز از یک اصل ساده پیروی میکند: «نورونهایی که با هم شلیک میکنند، با هم سیمکشی میشوند.» این اصل — که به قاعده هب معروف شد — پایهگذار تمام مدلهای یادگیری بدون نظارت در علوم اعصاب محاسباتی است (Hebb, 1949).
اما یادگیری بدون نظارت فقط یک مکانیزم ساده هبی نیست. مغز از نورومدولاتورها — مواد شیمیایی مانند دوپامین و استیلکولین — برای تنظیم فرآیند یادگیری استفاده میکند. این مواد نرخ یادگیری را کنترل میکنند، توجه را هدایت میکنند و تعادل بین یادگیری و تثبیت حافظه را حفظ میکنند (Doya, 1999; Mei et al., 2025).
در این بخش، به بررسی عمیق این مکانیزمها میپردازیم: چگونه مغز بدون نظارت خودسازماندهی میکند، نورومدولاتورها چه نقشی در تنظیم یادگیری دارند، و چگونه این اصول در یادگیری خودنظارتی (Self-Supervised Learning) — که امروزه ستون فقرات مدلهای زبانی بزرگ مانند GPT است — پیادهسازی میشوند.
۴.۶.۱ قشر بهعنوان یک سیستم خودسازمانده
اصل خودسازماندهی
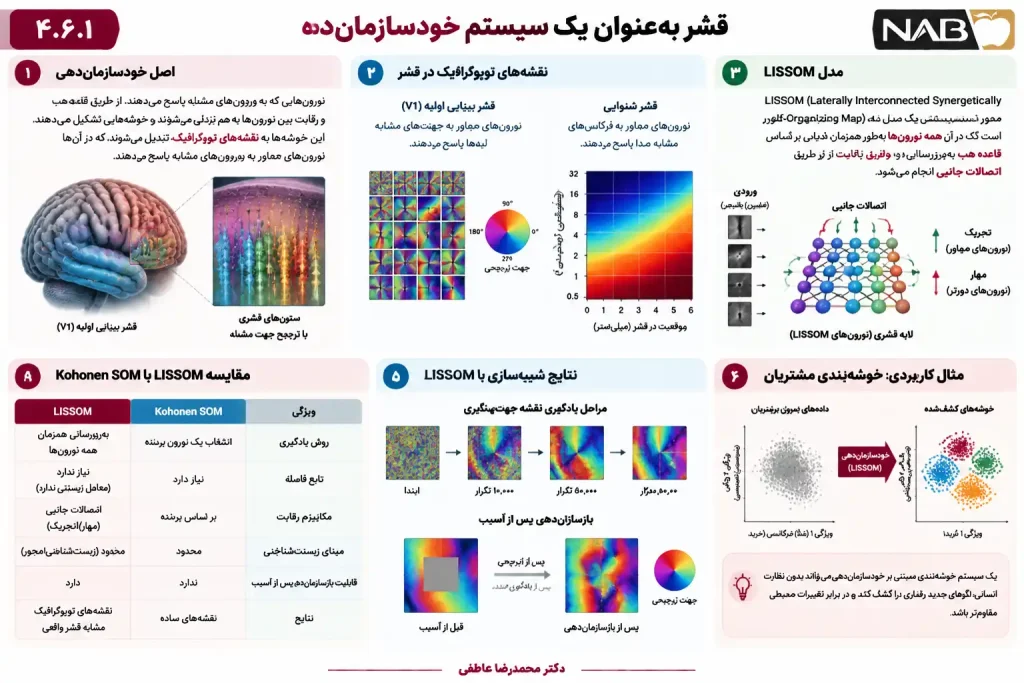
- خودسازماندهی (Self-Organization) به فرآیندی گفته میشود که در آن یک سیستم بدون کنترل خارجی، ساختار درونی خود را از طریق تعامل با محیط بازآرایی میکند. در قشر مغز، این فرآیند از قاعده هب و رقابت بین نورونها ناشی میشود.
- ایده اصلی این است: نورونهایی که به ورودیهای مشابه پاسخ میدهند، به هم نزدیک میشوند و خوشههایی تشکیل میدهند. این خوشهها بهتدریج به نقشههای توپوگرافیک (Topographic Maps) تبدیل میشوند — نقشههایی که در آنها نورونهای مجاور به ورودیهای مشابه پاسخ میدهند. برای مثال، در قشر بینایی اولیه (V1)، نورونهای مجاور به جهتهای مشابه لبهها پاسخ میدهند. در قشر شنوایی، نورونهای مجاور به فرکانسهای مشابه صدا پاسخ میدهند (Sirosh & Miikkulainen, 1994).
مدل LISSOM: یک پیادهسازی زیستشناختیمحور
- یکی از موفقترین مدلهای خودسازماندهی قشر، LISSOM (Laterally Interconnected Synergetically Self-Organizing Map) است. این مدل در دهه ۱۹۹۰ توسط Sirosh و Miikkulainen توسعه یافت و برخلاف مدلهای قبلی مانند Kohonen SOM، کاملاً زیستشناختیمحور است (Sirosh & Miikkulainen, 1994; Bednar et al., 2004).
تفاوت LISSOM با Kohonen SOM:
در Kohonen SOM، یک نورون برنده انتخاب میشود و وزنهای آن بهروزرسانی میشوند. اما این انتخاب برنده نیازمند یک تابع فاصله است که معادل زیستی ندارد. در LISSOM، بهجای انتخاب برنده، همه نورونها بهطور همزمان بر اساس قاعده هب بهروزرسانی میشوند. رقابت از طریق اتصالات جانبی (Lateral Connections) انجام میشود: نورونهای فعال، نورونهای مجاور را تحریک میکنند و نورونهای دورتر را مهار میکنند. این مکانیزم — که به مهار جانبی (Lateral Inhibition) معروف است — باعث میشود که خوشههای فعالیت در قشر شکل بگیرند (Sirosh & Miikkulainen, 1994).
- نتایج شبیهسازی LISSOM: مطالعات نشان دادهاند که LISSOM میتواند نقشههای توپوگرافیک مشابه قشر بینایی اولیه را از ورودیهای خام بدون هیچ برچسبی یاد بگیرد. همچنین، LISSOM قادر است پس از آسیب (Lesion) بخشی از قشر، خود را بازسازماندهی کند — ویژگیای که در مدلهای غیرزیستی مانند Kohonen SOM غایب است (Bednar et al., 2004).
پیامد مدیریتی خودسازماندهی
- خودسازماندهی قشر، یک درس مهم برای طراحی سیستمهای مدیریتی دارد: سیستمهایی که خودشان ساختار درونی خود را از دادهها استخراج میکنند، در برابر تغییرات محیطی مقاومتر هستند. برای مثال، یک سیستم خوشهبندی مشتریان که بر اساس خودسازماندهی طراحی شده باشد، میتواند بدون نظارت انسانی الگوهای جدید رفتاری را کشف کند — چیزی که در سیستمهای مبتنی بر قواعد ثابت ممکن نیست.
۴.۶.۲ نقش نورومدولاتورها در تنظیم یادگیری
نورومدولاتورها چیستند؟
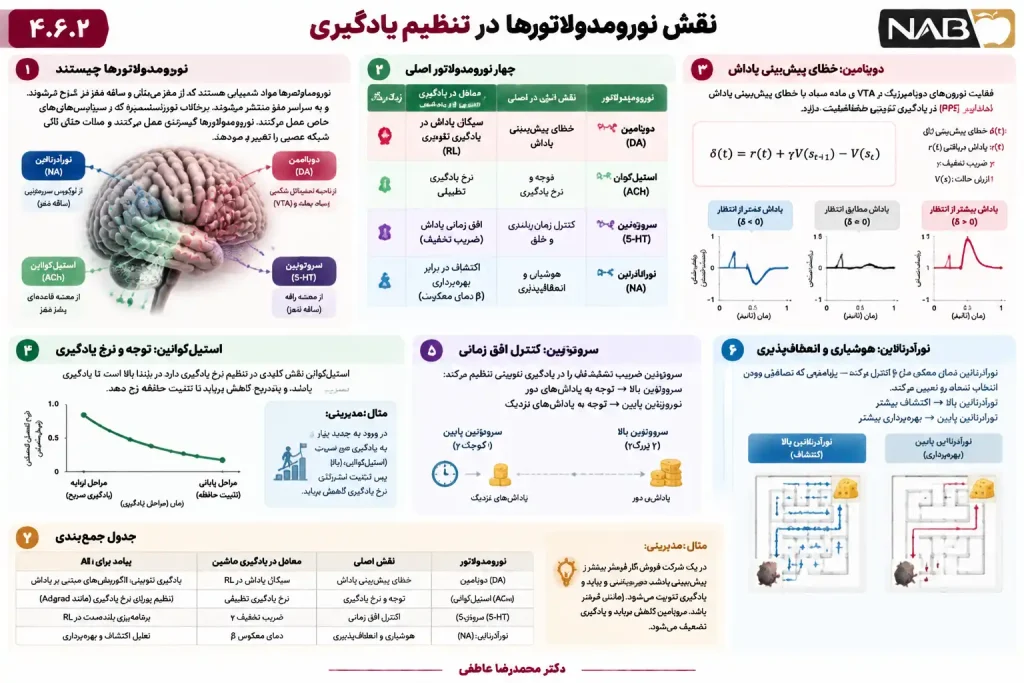
نورومدولاتورها (Neuromodulators) مواد شیمیایی هستند که از مغز میانی و ساقه مغز ترشح میشوند و به سراسر مغز منتشر میشوند. برخلاف نوروترانسمیترها که در سیناپسهای خاص عمل میکنند، نورومدولاتورها گسترده عمل میکنند و حالت کلی شبکه عصبی را تغییر میدهند (Mei et al., 2025, p. 2).
چهار نورومدولاتور اصلی عبارتند از:
| نورومدولاتور | نقش اصلی | معادل در یادگیری ماشین |
| دوپامین (DA) | خطای پیشبینی پاداش | سیگنال پاداش در یادگیری تقویتی |
| استیلکولین (ACh) | توجه و نرخ یادگیری | نرخ یادگیری تطبیقی |
| سروتونین (5-HT) | کنترل زمانبندی و خلق | افق زمانی پاداش |
| نورآدرنالین (NA) | هوشیاری و انعطافپذیری | اکتشاف در برابر بهرهبرداری |
دوپامین: خطای پیشبینی پاداش
دوپامین یکی از مهمترین نورومدولاتورهاست. تحقیقات نشان دادهاند که فعالیت نورونهای دوپامینرژیک در ناحیه تگمنتال شکمی (VTA) و ماده سیاه (Substantia Nigra) با خطای پیشبینی پاداش (Reward Prediction Error — RPE) در یادگیری تقویتی مطابقت چشمگیری دارد (Cone et al., 2024, p. 1; Doya, 1999).
خطای پیشبینی پاداش چیست؟ در یادگیری تقویتی، RPE به تفاوت بین پاداش واقعی و پاداش مورد انتظار اشاره دارد:
که در آن:
- r(t)— پاداش دریافتی در زمان t
- γ —ضریب تخفیف (Discount Factor)
- V(s)— ارزش حالت s
- δ(t)— خطای پیشبینی
تفسیر شهودی: اگر پاداش واقعی بیشتر از انتظار باشد (δ>0δ>0)، دوپامین افزایش مییابد و یادگیری تقویت میشود. اگر پاداش کمتر از انتظار باشد (δ<0δ<0)، دوپامین کاهش مییابد و یادگیری تضعیف میشود.
مثال مدیریتی: فرض کنید یک شرکت فروش، بهتازگی یک کمپین تبلیغاتی را اجرا کرده است. اگر فروش بیشتر از پیشبینی باشد، دوپامین در مغز مدیران افزایش مییابد و آنها یاد میگیرند که این کمپین مؤثر بوده است. اگر فروش کمتر از پیشبینی باشد، دوپامین کاهش مییابد و آنها یاد میگیرند که کمپین مؤثر نبوده است. این مکانیزم دقیقاً همان چیزی است که در یادگیری تقویتی استفاده میشود.
نکته مهم: مطالعهای در سال ۲۰۲۴ نشان داد که مدلهای سنتی یادگیری تقویتی )مانند TD Learning) نمیتوانند تمام پیچیدگیهای سیگنال دوپامین را توضیح دهند. محققان چارچوب جدیدی به نام FLEX (Flexibly Learned Errors in Expected Reward) پیشنهاد کردهاند که در آن نمایشهای زمانی بهطور پویا یاد گرفته میشوند — برخلاف مدلهای TD که از پایههای زمانی ثابت استفاده میکنند (Cone et al., 2024, p. 1).
استیلکولین: توجه و نرخ یادگیری
- استیلکولین (Acetylcholine — ACh) نقش کلیدی در تنظیم نرخ یادگیری دارد. Doya (1999) پیشنهاد کرد که استیلکولین مانند نرخ یادگیری در الگوریتمهای یادگیری ماشین عمل میکند: در ابتدا بالا است تا یادگیری سریع باشد، و بهتدریج کاهش مییابد تا تثبیت حافظه رخ دهد (Doya, 1999; theses, 2024).
- مکانیزم عمل: استیلکولین از هسته قاعدهای پیشمغز (Basal Forebrain) ترشح میشود و به سراسر قشر میرسد. افزایش استیلکولین باعث افزایش نرخ یادگیری میشود — یعنی شبکه سریعتر یاد میگیرد. کاهش استیلکولین باعث کاهش نرخ یادگیری میشود — یعنی شبکه پایدارتر میشود و اطلاعات قبلی را حفظ میکند (Doya, 1999; Mei et al., 2025).
- مثال مدیریتی: فرض کنید یک شرکت در حال ورود به بازار جدید است. در مراحل اولیه ورود، نیاز به یادگیری سریع از اشتباهات و تطبیق با شرایط جدید است — استیلکولین بالا است. اما پس از تثبیت استراتژی، نیاز به حفظ دانش کسبشده و پایدارسازی عملکرد است — استیلکولین کاهش مییابد. این برنامه کاهش نرخ یادگیری دقیقاً مشابه الگوریتمهای نرخ یادگیری تطبیقی (مانند Adagrad) در یادگیری ماشین است (theses, 2024, p. 12).
سروتونین و نورآدرنالین: تنظیمکنندههای مکمل
سروتونین (5-HT) نقش کلیدی در کنترل افق زمانی یادگیری دارد. Doya (1999) پیشنهاد کرد که سروتونین ضریب تخفیف (γγ) را در یادگیری تقویتی تنظیم میکند: سروتونین بالا به معنای توجه به پاداشهای دور است، در حالی که سروتونین پایین به معنای توجه به پاداشهای نزدیک است.
نورآدرنالین (NA) نقش کلیدی در هوشیاری و انعطافپذیری دارد. Doya (1999) پیشنهاد کرد که نورآدرنالین دمای معکوس (β) را کنترل میکند — پارامتری که تصادفی بودن انتخاب عمل را تعیین میکند. نورآدرنالین بالا به معنای اکتشاف بیشتر است، در حالی که نورآدرنالین پایین به معنای بهرهبرداری بیشتر از دانش موجود است.
جدول جمعبندی نقش نورومدولاتورها:
| نورومدولاتور | پارامتر یادگیری تقویتی | نقش در یادگیری |
| دوپامین (DA) | δ (خطای پیشبینی) | سیگنال یادگیری |
| استیلکولین (ACh) | α (نرخ یادگیری) | سرعت یادگیری |
| سروتونین (5-HT) | γ (ضریب تخفیف) | افق زمانی |
| نورآدرنالین (NA) | β (دمای معکوس) | اکتشاف/بهرهبرداری |
4.6.3.پیامدها برای یادگیری عمیق
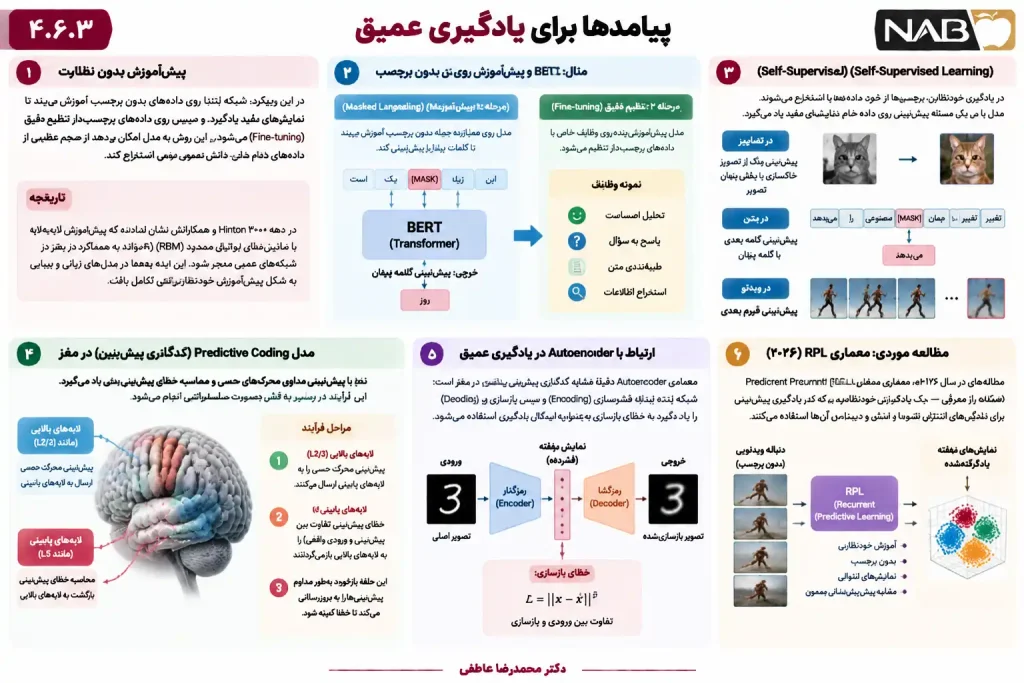
پیشآموزش بدون نظارت
یکی از مهمترین پیامدهای خودسازماندهی و نورومدولاتورها برای یادگیری عمیق، پیشآموزش بدون نظارت (Unsupervised Pre-training) است. در این رویکرد، شبکه ابتدا روی دادههای بدون برچسب آموزش میبیند تا نمایشهای مفید یاد بگیرد، و سپس روی دادههای برچسبدار تنظیم دقیق (Fine-tuning) میشود.
تاریخچه: در دهه ۲۰۰۰، Hinton و همکارانش نشان دادند که پیشآموزش لایهبهلایه با ماشینهای بولتزمن محدود (Restricted Boltzmann Machines) میتواند به عملکرد بهتر در شبکههای عمیق منجر شود. این ایده بعدها در مدلهای زبانی و مدلهای بینایی به شکل پیشآموزش خودنظارتی (Self-Supervised Pre-training) تکامل یافت.
مثال: مدل BERT ابتدا روی متن بدون برچسب آموزش میبیند تا کلمات پنهان را پیشبینی کند (Masked Language Modeling). سپس روی وظایف خاص (مانند تحلیل احساسات یا پاسخ به سؤال) تنظیم دقیق میشود. این پیشآموزش بدون نظارت، به مدل امکان میدهد نمایشهای زبانی عمیق را از میلیاردها کلمه استخراج کند.
یادگیری خودنظارتی (Self-Supervised Learning)
- یادگیری خودنظارتی (SSL) پیشرفتهترین شکل یادگیری بدون نظارت است. در SSL، برچسبها از خود دادهها استخراج میشوند. برای مثال:
- در تصاویر: پیشبینی رنگ از تصویر خاکستری، یا پیشبینی بخش پنهان تصویر
- در متن: پیشبینی کلمه بعدی یا کلمه پنهان
- در ویدئو: پیشبینی فریم بعدی
ارتباط با مغز: تحقیقات اخیر نشان دادهاند که قشر مغز نیز از یادگیری خودنظارتی استفاده میکند. مطالعهای در سال ۲۰۲۵ که در Nature Communications منتشر شد، نشان داد که لایه ۲/۳ قشر (L2/3) ورودیهای حسی گذشته را با زمینه بالا-به-پایین ترکیب میکند تا محرک حسی آینده را پیشبینی کند. یادگیری خودنظارتی است زیرا پیشبینیهای L2/3 با نمایشهای نهفته ورودی حسی واقعی که به لایه ۵ (L5) میرسد، مقایسه میشوند (Nejad et al., 2025, p. 1).
مدل Predictive Coding: کدگذاری پیشبین (Predictive Coding) یک چارچوب نظری است که توضیح میدهد چگونه مغز خطای پیشبینی را در سراسر قشر منتشر میکند. در این چارچوب:
۱. لایههای بالایی (مانندL2/3) پیشبینی محرک حسی را به لایههای پایینی ارسال میکنند.
۲. لایههای پایینی (مانند L5) خطای پیشبینی (تفاوت بین پیشبینی و ورودی واقعی) را به لایههای بالایی بازمیگردانند.
۳. این حلقه بازخورد بهطور مداوم پیشبینیها را بهروزرسانی میکند تا خطا کمینه شود.
ارتباط با Self-Supervised Learning: این چارچوب دقیقاً مشابه معماریهای خودنظارتی در یادگیری عمیق است. برای مثال، در Autoencoder ها، شبکه ابتدا فشردهسازی (Encoding) و سپس بازسازی (Decoding) را یاد میگیرد. خطای بازسازی — که تفاوت بین ورودی و بازسازی است — بهعنوان سیگنال یادگیری استفاده میشود.
مطالعه موردی: مطالعهای در سال ۲۰۲۶ که در eLife منتشر شد، معماری RPL (Recurrent Predictive Learning) را معرفی کرد — یک معماری خودنظارتی که از یادگیری پیشبین برای نمایشهای انتزاعی از هویت اشیاء و دینامیک آنها استفاده میکند. این معماری بدون هیچ برچسبی آموزش میبیند و نمایشهای متوالی مشابه آنچه در قشر پیشپیشانی میمون مشاهده میشود، یاد میگیرد (Gorgan et al., 2026, p. 1).
جدول جمعبندی: از مغز تا یادگیری عمیق
| مکانیزم مغزی | معادل در یادگیری عمیق | کاربرد |
| قاعده هب | یادگیری بدون نظارت | خوشهبندی، کاهش ابعاد |
| مهار جانبی | رقابت در SOM | نقشههای توپوگرافیک |
| دوپامین (RPE) | یادگیری تقویتی | بهینهسازی سیاست |
| استیلکولین (α) | نرخ یادگیری تطبیقی | آموزش سریعتر |
| سروتونین (γ) | ضریب تخفیف | افق زمانی |
| نورآدرنالین (β) | اکتشاف/بهرهبرداری | تعادل Exploration-Exploitation |
| کدگذاری پیشبین | Self-Supervised Learning | پیشآموزش، نمایشهای عمیق |
۴.۶.۴ چالشها و محدودیتها
با وجود پیشرفتهای چشمگیر، یادگیری خودنظارتی و مدلهای الهامگرفته از نورومدولاتورها با چالشهایی مواجهند:
- چالش اول — پیچیدگی تنظیم: مدلهای خودنظارتی نیازمند تنظیم دقیق هایپرپارامترها (نرخ یادگیری، معماری، اندازه دسته) هستند. مغز خودش این پارامترها را تنظیم میکند (از طریق نورومدولاتورها)، اما در مدلهای مصنوعی این تنظیم دستی است.
- چالش دوم — کارایی محاسباتی: پیشآموزش خودنظارتی روی دادههای بزرگ (مانند تمام اینترنت) نیازمند منابع محاسباتی عظیم است. مغز این کار را با ۲۰ وات انجام میدهد، اما مدلهای مصنوعی به مگاوات نیاز دارند.
- چالش سوم — قابلیت تفسیر: نمایشهای یادگرفتهشده در مدلهای خودنظارتی مشکل تفسیر هستند. نمیدانیم شبکه دقیقاً چه چیزی را یاد گرفته است. در مقابل، نقشههای توپوگرافیک قشر قابل تفسیر هستند: میدانیم نورونهای مجاور به چه ویژگیهایی پاسخ میدهند.
- چالش چهارم — عدم تطابق کامل با زیستشناسی: بسیاری از مدلهای خودنظارتی از Backpropagation استفاده میکنند که — همانطور که در بخش ۴.۳ دیدیم — از نظر زیستی قابل قبول نیست. مغز از قواعد یادگیری محلی استفاده میکند، اما این قواعد در مقیاس بزرگ عملکرد ضعیفتری دارند (Illing et al., 2021).
جمعبندی: از خودسازماندهی تا هوش بدون نظارت
در این بخش دیدیم که:
۱. قشر بهعنوان یک سیستم خودسازمانده عمل میکند: نورونها از طریق قاعده هب و مهار جانبی، نقشههای توپوگرافیک را از ورودیهای خام یاد میگیرند — بدون هیچ برچسبی. مدل LISSOM یک پیادهسازی زیستشناختیمحور از این فرآیند است (Sirosh & Miikkulainen, 1994).
۲. نورومدولاتورها نقش کلیدی در تنظیم یادگیری دارند: دوپامین خطای پیشبینی پاداش را رمزگذاری میکند، استیلکولین نرخ یادگیری را کنترل میکند، سروتونین افق زمانی را تنظیم میکند، و نورآدرنالین تعادل اکتشاف-بهرهبرداری را حفظ میکند (Doya, 1999; Mei et al., 2025).
۳. یادگیری خودنظارتی (SSL) پیشرفتهترین شکل یادگیری بدون نظارت است که در آن برچسبها از خود دادهها استخراج میشوند. کدگذاری پیشبین یک چارچوب نظری است که توضیح میدهد چگونه مغز از خطای پیشبینی برای یادگیری نمایشهای عمیق استفاده میکند (Nejad et al., 2025).
۴. پیامدها برای یادگیری عمیق شامل پیشآموزش بدون نظارت، نمایشهای عمیق و تنظیم نرخ یادگیری تطبیقی است — مفاهیمی که امروزه در مدلهای زبانی بزرگ (مانند BERT و GPT) و مدلهای بینایی (مانند SimCLR و MAE) پیادهسازی شدهاند.
۵. چالشها شامل پیچیدگی تنظیم، کارایی محاسباتی، قابلیت تفسیر و عدم تطابق کامل با زیستشناسی است.
پیام مدیریتی کلیدی: در مسائلی که دادههای برچسبدار کمیاب هستند — مانند کشف الگوهای جدید تقلب، خوشهبندی مشتریان یا تشخیص ناهنجاری در سیستمهای پیچیده — یادگیری خودنظارتی میتواند بدون نیاز به برچسبگذاری دستی، نمایشهای عمیق را از دادههای خام استخراج کند. مدلهای پیشآموزشدیده (مانند BERT و GPT) نمونههای عملی این رویکرد هستند: آنها ابتدا روی دادههای بدون برچسب آموزش میبینند و سپس با تنظیم دقیق روی وظایف خاص مدیریتی — مانند تحلیل احساسات مشتریان، دستهبندی اسناد مالی یا پیشبینی روند بازار — به کار میروند.
در بخش بعدی، به درس ششم میپردازیم: ادغام اطلاعات در سطح کلان: ریتمها و همگامسازی — یعنی چگونه مغز اطلاعات را از نواحی مختلف ترکیب میکند و چگونه این اصول در معماریهای مصنوعی الهامبخش مکانیزمهای توجه و حافظه کاری هستند.
منابع این بخش
Bednar, J. A., Kelkar, A., & Miikkulainen, R. (2004). Scaling self-organizing maps to model large cortical networks. Neuroinformatics, 2(3), 275–302. https: //doi.org/10.1385/NI: 2: 3: 275
Cone, I., Clopath, C., & Shouval, H. Z. (2024). Learning to express reward prediction error-like dopaminergic activity requires plastic representations of time. Nature Communications, 15, Article 5852. https: //doi.org/10.1038/s41467-024-50205-3
Doya, K. (1999). Metalearning, neuromodulation, and emotion. Abstract of the 13th Toyota Conference on Affective Minds, 1–6.
Gorgan, M. A., Halvagal, M. S., & Zenke, F. (2026). Understanding neural circuit principles for representation learning through joint-embedding predictive architectures. bioRxiv. https: //doi.org/10.1101/2025.11.25.690220
Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley.
Illing, B., Ventura, J., Bellec, G., & Gerstner, W. (2021). Local plasticity rules can learn deep representations using self-supervised contrastive predictions. Advances in Neural Information Processing Systems, 34, 30365–30379.
Mei, J., Rodriguez-Garcia, A., Takeuchi, D., Wainstein, G., Hubig, N., Mohsenzadeh, Y., & Ramaswamy, S. (2025). Improving the adaptive and continuous learning capabilities of artificial neural networks: Lessons from multi-neuromodulatory dynamics. arXiv. https: //arxiv.org/abs/2501.06762
Nejad, K. K., Anastasiades, P., Hertäg, L., & Costa, R. P. (2025). Self-supervised predictive learning accounts for cortical layer-specificity. Nature Communications, 16, Article 6178. https: //doi.org/10.1038/s41467-025-61399-5
Sirosh, J., & Miikkulainen, R. (1994). Cooperative self-organization of afferent and lateral connections in cortical maps. Biological Cybernetics, 71(1), 65–78. https: //doi.org/10.1007/BF00198918
Theses. (2024). Computational models of acetylcholine function in learning and memory [Doctoral thesis, University of Bristol]. https: //research-information.bris.ac.uk
۴.۷ درس ۶ — ادغام اطلاعات در سطح کلان: ریتمها و همگامسازی
۴.۷.۰ چگونه مغز اطلاعات پراکنده را به یک تجربه واحد تبدیل میکند؟
تا اینجا در این فصل، درباره دندریتها، پلاستیسیتی، کدگذاری زمانی، بهرهوری انرژی و یادگیری خودنظارتی صحبت کردیم. اما یک پرسش بنیادین باقی مانده است که علوم اعصاب را برای دههها به چالش کشیده: مغز چگونه اطلاعاتی که در نواحی مختلف و بهطور موازی پردازش میشوند را به یک تجربه واحد و منسجم تبدیل میکند؟
بیایید با یک مثال مدیریتی شروع کنیم. تصور کنید یک شرکت خودروسازی در حال تصمیمگیری درباره عرضه یک خودروی برقی جدید است. بخش مالی هزینهها و بازده سرمایهگذاری را تحلیل میکند. سپس بخش فنی قابلیتهای باتری و برد خودرو را ارزیابی میکند. در بخش بازاریابی پیشبینی تقاضا و رقابت را بررسی میکند. بخش زنجیره تأمین دسترسی به مواد اولیه را ارزیابی میکند. هر بخش دادههای متفاوت را در زمانهای متفاوت پردازش میکند. اما در نهایت، مدیرعامل باید یک تصمیم واحد بگیرد: عرضه یا عدم عرضه؟
این مسئله در علوم اعصاب به «مسئله اتصال» (Binding Problem) معروف است: مغز چگونه اطلاعاتی را که در نواحی مختلف پردازش شدهاند، به یک نمایش واحد و منسجم تبدیل میکند؟ (Singer & Gray, 1995; von der Malsburg, 1999). پاسخ — حداقل بخشی از آن — در همگامسازی (Synchronization) نهفته است.
فرضیه کلیدی این است: نورونهایی که یک شیء یا مفهوم خاص را رمزگذاری میکنند، فعالیت خود را با هم هماهنگ میکنند — یعنی در بازههای زمانی مشترک شلیک میکنند. این همگامسازی موقت، به مغز علامت میدهد که این نورونها به یک شیء تعلق دارند و باید بهعنوان یک واحد پردازش شوند (Singer & Gray, 1995).
مثال تاریخی: در دهه ۱۹۸۰، گروهی به رهبری ولف سینگر در آلمان، فعالیت نورونهای قشر بینایی گربه را ثبت کردند. آنها کشف کردند که وقتی گربه یک شیء متحرک را میبیند، نورونهایی که به ویژگیهای متفاوت آن شیء (لبه، جهت، رنگ) پاسخ میدهند، بهطور همزمان با فرکانس حدود ۴۰ هرتز شلیک میکنند — حتی اگر این نورونها در نواحی مختلف قشر بینایی قرار داشته باشند (Gray et al., 1989). این کشف، یک پارادایم جدید در علوم اعصاب محاسباتی ایجاد کرد: اطلاعات نه فقط در «کدام نورون فعال است»، بلکه در «کدام نورونها با هم فعال هستند» رمزگذاری میشود.
در این بخش، به بررسی عمیق این ایده میپردازیم: چگونه ریتمهای مغزی ارتباط بین نواحی مختلف را ممکن میسازند، همگامسازی چگونه اطلاعات را ادغام میکند، و این اصول چه الهامهایی برای معماریهای مصنوعی — بهویژه مکانیزمهای توجه و حافظه کاری — دارند.
۴.۷.۱ نقش ریتمها در اتصال موقت نواحی مغزی
ریتمهای مغزی: یک ارکستر هماهنگ
مغز انسان بهطور مداوم در حال نوسان است: گروههای نورونها با فرکانسهای مختلف شلیک میکنند — از کمتر از ۱ هرتز تا بیشتر از ۵۰۰ هرتز (Canolty et al., 2006, p. 1626). این نوسانات که به ریتمهای مغزی (Brain Rhythms) یا نوسانات عصبی (Neural Oscillations) معروف هستند، تصادفی نیستند؛ آنها الگوهای منظم دارند و نقش عملکردی ایفا میکنند.
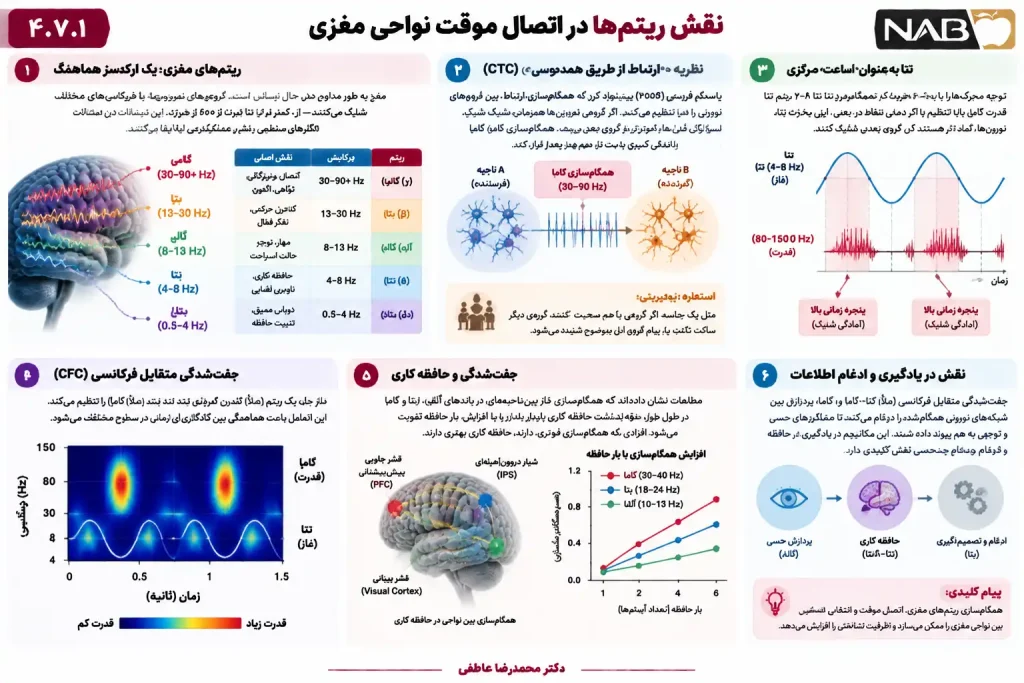
مهمترین ریتمهای مغزی عبارتند از:
| ریتم | فرکانس | نقش اصلی |
| دلتا (δ) | ۰.۵–۴ هرتز | خواب عمیق، تثبیت حافظه |
| تتا (θ) | ۴–۸ هرتز | حافظه کاری، ناوبری فضایی |
| آلفا (α) | ۸–۱۳ هرتز | مهار توجه، حالت استراحت |
| بتا (β) | ۱۳–۳۰ هرتز | کنترل حرکتی، تفکر فعال |
| گاما (γ) | ۳۰–۹۰+ هرتز | اتصال ویژگیها، توجه، آگاهی |
این ریتمها مستقل از هم نیستند؛ آنها با هم تعامل دارند. یکی از مهمترین این تعاملات، جفتشدگی متقابل فرکانسی (Cross-Frequency Coupling — CFC) است: فاز یک ریتم کند (مثلاً تتا) قدرت یک ریتم تند (مثلاً گاما) را تنظیم میکند (Canolty et al., 2006, p. 1626).
نظریه «ارتباط از طریق همدوسی» (CTC)
در سال ۲۰۰۵، پاسکال فریس نظریهای ارائه داد که یکی از تأثیرگذارترین چارچوبها در علوم اعصاب محاسباتی مدرن شده است: ارتباط از طریق همدوسی (Communication Through Coherence — CTC). ایده اصلی این نظریه ساده اما عمیق است: همگامسازی، ارتباط بین گروههای نورونی را تنظیم میکند (Fries, 2005; Fries, 2015, p. 7).
فریس توضیح میدهد که همگامسازی باند گاما (۳۰–۹۰ هرتز) بهاندازه کافی سریع عمل میکند تا از مهار بعدی فرار کند و نورونهای پسسیناپسی را بهطور مؤثر فعال کند (Fries, 2015, p. 7). به بیان دیگر، اگر یک گروه نورونی همزمان شلیک کند، سیگنال آنها قویتر به گروه بعدی میرسد. در مقابل، اگر گروهی پراکنده شلیک کند، سیگنال آنها ضعیف میشود و ممکن است نادیده گرفته شود.
استعاره مدیریتی: تصور کنید یک جلسه با ۲۰ نفر دارید. اگر همه با هم صحبت کنند، هیچکس چیزی نمیفهمد. اگر هر کس جداگانه صحبت کند، زمان کافی برای شنیدن همه وجود ندارد. اما اگر گروهی با هم صحبت کنند و گروهی دیگر ساکت باشند، آنگاه پیام گروه اول بهوضوح شنیده میشود. همگامسازی در مغز دقیقاً همین کار را میکند: گروههای نورونی نوبتگیری میکنند و از طریق هماهنگی زمانی، ارتباط انتخابی و کارآمد ایجاد میکنند.
ریتم تتا بهعنوان «ساعت مرکزی»
مطالعات نشان دادهاند که ریتم تتا (۴–۸ هرتز) نقش ویژهای در هماهنگی ارتباط بین نواحی مغزی دارد. Fries (2015) اشاره میکند که توجه خودش محرکها را با ریتم ۷–۸ هرتز تتا نمونهبرداری میکند (Fries, 2015, p. 20). این یعنی توجه پیوسته نیست؛ بلکه دورهای است و در هر دوره، یک پنجره زمانی برای پردازش یک محرک فراهم میشود.
- مطالعه کلیدی: Canolty و همکاران (۲۰۰۶) با ثبت مستقیم از قشر انسان (Electrocorticography) نشان دادند که فاز ریتم تتا (۴–۸ هرتز) قدرت گاما بالا (۸۰–۱۵۰ هرتز) را تنظیم میکند (Canolty et al., 2006, p. 1626). یعنی در نقاط خاصی از چرخه تتا، نورونها آمادهتر هستند که در باند گاما شلیک کنند. آنها همچنین نشان دادند که وظایف رفتاری مختلف الگوهای متفاوتی از این جفتشدگی تتا-گاما را در قشر ایجاد میکنند (Canolty et al., 2006, p. 1627).
- تفسیر شهودی: تتا مانند ضربان قلب یک ارکستر است: هر ضربه، یک پنجره زمانی ایجاد میکند که در آن نوازندگان (گروههای نورونی) میتوانند همزمان بنوازند. بدون این ضربان، هر نوازنده مستقل مینوازد و نتیجه هرجومرج میشود.
جفتشدگی متقابل فرکانسی و حافظه کاری
- یکی از حوزههایی که نقش همگامسازی در آن بهخوبی مستند شده است، حافظه کاری (Working Memory) است — یعنی توانایی نگهداشتن و دستکاری اطلاعات در ذهن برای دورههای کوتاه.
- مطالعه کلیدی: Palva و همکاران (۲۰۱۰) با استفاده از MEG و EEG نشان دادند که همگامسازی فاز بینناحیهای در باندهای آلفا (۱۰–۱۳ هرتز)، بتا (۱۸–۲۴ هرتز) و گاما (۳۰–۴۰ هرتز) در طول دوره نگهداشت حافظه کاری بینایی پایدار است (Palva et al., 2010, p. 7580). آنها همچنین کشف کردند که همگامسازی با افزایش بار حافظه تقویت میشود — یعنی هرچه تعداد آیتمهایی که باید به خاطر سپرده شوند بیشتر باشد، همگامسازی قویتر است (Palva et al., 2010, p. 7581).
- نکته مهم: Palva و همکاران نشان دادند که ظرفیت حافظه کاری فردی با قدرت همگامسازی در شبکهای که شیار درونآهیانهای (Intraparietal Sulcus) مرکز آن است، پیشبینی میشود (Palva et al., 2010, p. 7582). یعنی افرادی که همگامسازی قویتری دارند، حافظه کاری بهتری دارند. این یافته نشان میدهد که همگامسازی نه فقط یک پدیده جانبی، بلکه مکانیزم اصلی ظرفیت شناختی است.
- مطالعه مکمل: Siebenhühner و همکاران (۲۰۲۰) نشان دادند که همگامسازی متقابل فرکانسی (CFS) بین تتا و آلفا-گاما و بین آلفا و بتا/گاما در طول نگهداشت حافظه کاری بینایی بهطور وابسته به بار تقویت میشود (Siebenhühner et al., 2020, p. 1). آنها پیشنهاد کردند که CFS پردازش بین شبکههای نورونی همگامشده از تتا تا گاما را ادغام میکند تا عملکردهای حسی و توجهی را به هم پیوند دهد (Siebenhühner et al., 2020, p. 1).
۴.۷.۲ پیامدها برای معماریهای مصنوعی
حالا که فهمیدیم مغز چگونه از ریتمها و همگامسازی برای ادغام اطلاعات استفاده میکند، بیایید به این پرسش بپردازیم: این اصول چه الهامهایی برای معماریهای مصنوعی دارند؟ دو حوزه اصلی که در آنها این الهامگیری بهطور مستقیم دیده میشود، مکانیزمهای توجه و حافظه کاری هستند.
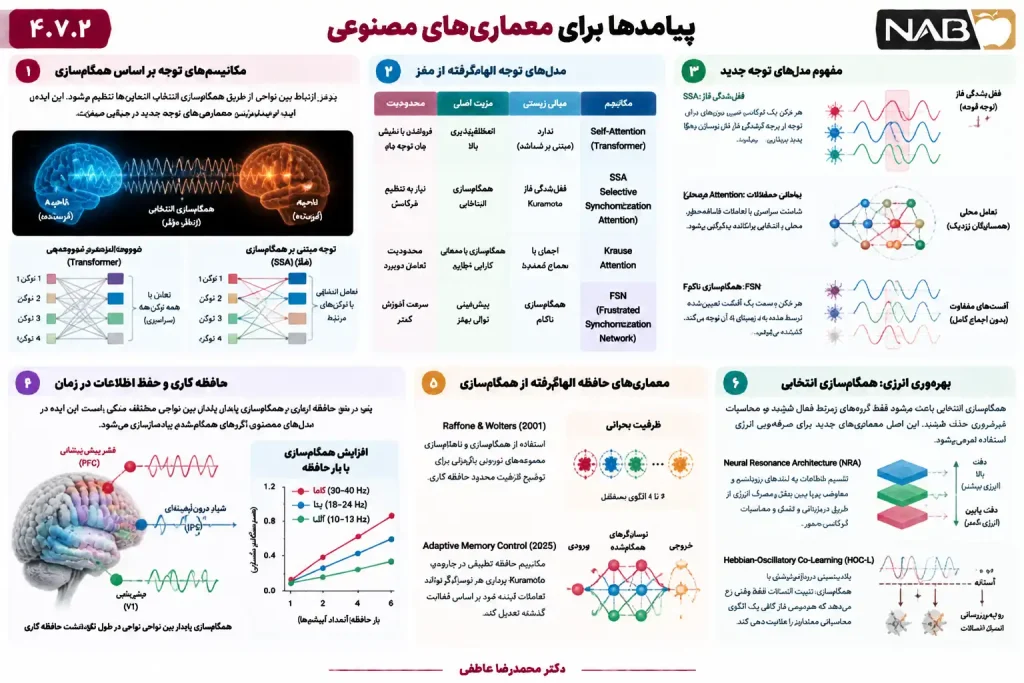
الف) مکانیزمهای توجه بر اساس همگامسازی
- توجه (Attention) در شبکههای عصبی مصنوعی مدرن، ستون فقرات معماری Transformer است. مکانیزم خودتوجهی (Self-Attention) که در Transformer استفاده میشود، به هر توکن اجازه میدهد با همه توکنهای دیگر تعامل کند و وزنهای توجه را بر اساس شباهت (معمولاً ضرب داخلی Query و Key) محاسبه کند (Vaswani et al., 2017).
- مشکل خودتوجهی استاندارد: همانطور که Liu و همکاران (۲۰۲۶) نشان دادند، خودتوجهی استاندارد از وزنهای Softmax بهطور سراسری نرمالشده استفاده میکند که باعث میشود همه توکنها در هر لایه برای تأثیر رقابت کنند. وقتی این الگو در عمق ترکیب میشود، دینامیک همگامسازی قوی ایجاد میکند که به همگرایی به یک حالت غالب منجر میشود — پدیدهای که به «فروپاشی نمایش» (Representation Collapse) و «چاه توجه» (Attention Sink) معروف است (Liu et al., 2026, p. 4).
- راهحل الهامگرفته از مغز: محققان در حال توسعه مکانیزمهای توجهی هستند که بهجای همگامسازی سراسری، همگامسازی محلی و ساختاریافته را ترویج میکنند. این رویکرد دقیقاً مشابه همگامسازی انتخابی در مغز است: نورونها با همه همگام نمیشوند؛ آنها با گروههای خاصی همگام میشوند.
- مدل Selective Synchronization Attention (SSA): یک مکانیزم توجه نوآورانه که ضرب داخلی استاندارد را با دینامیک قفلشدگی فاز Kuramoto جایگزین میکند (Hays, 2026, p. 3). در SSA، هر توکن یک فرکانس ذاتی قابلیادگیری دارد و وزنهای توجه از درجه قفلشدگی فاز بین نوسانگرهای توکن پدیدار میشوند — نه از ضرب داخلی در فضای Query-Key (Hays, 2026, p. 4).
- مدل Krause Attention: یک مکانیزم توجه دیگر که شباهت سراسری را با تعاملات فاصلهمحور، محلی و انتخابی پراکنده جایگزین میکند و همگامسازی محلی ساختاریافته را بهجای ترکیب سراسری ترویج میدهد (Liu et al., 2026, p. 5). این رویکرد پیچیدگی اجرا را از درجه دوم به خطی در طول دنباله کاهش میدهد و «چاههای توجه» را تسکین میدهد (Liu et al., 2026, p. 6).
- مدل Frustrated Synchronization Network (FSN): یک لایه توجه مبتنی بر نوسانگر که همگامسازی را با «ناکامی» (Frustration) جایگزین میکند — یعنی هر توکن بهجای همگرایی به اجماع، به سمت یک آفست تعیینشده توسط داده از زمینهای که به آن توجه میکند، کشیده میشود (Nunley, 2026, p. 2). این مدل در یک میلیون پارامتر به تلفات اعتبارسنجی پایینتر از Transformer تنظیمشده دست مییابد (Nunley, 2026, p. 3).
جدول مقایسه مکانیزمهای توجه:
| مکانیزم | مبانی زیستی | مزیت اصلی | محدودیت |
| Self-Attention | ندارد (مبتنی بر شباهت) | انعطافپذیری بالا | فروپاشی نمایش، چاه توجه |
| SSA | قفلشدگی فاز Kuramoto | همگامسازی انتخابی | نیاز به تنظیم فرکانس |
| Krause Attention | اجماع با اعتماد محدود | همگامسازی محلی، کارایی خطی | محدودیت تعامل دوربرد |
| FSN | همگامسازی ناکام | پیشبینی توالی بهتر | سرعت آموزش کمتر |
ب) حافظه کاری و حفظ اطلاعات در زمان
- حافظه کاری در مغز، همانطور که دیدیم، بر همگامسازی پایدار بین نواحی مختلف متکی است. Palva و همکاران (۲۰۱۰) نشان دادند که همگامسازی فاز در طول دوره نگهداشت حافظه کاری پایدار میماند و ظرفیت فردی را پیشبینی میکند (Palva et al., 2010, p. 7580).
- مطالعه مدلسازی: Raffone و Wolters (۲۰۰۱) یک مدل محاسباتی مبتنی بر همگامسازی و ناهمگامسازی مجموعههای نورونی بازگشتی ارائه کردند که میتواند ظرفیت محدود حافظه کاری بینایی را توضیح دهد (Raffone & Wolters, 2001, p. 1). در شبیهسازیهای آنها، ظرفیت بحرانی حدود سه تا چهار الگوی مستقل ظاهر شد — مطابق با نتایج تجربی Luck و Vogel در مورد ظرفیت حافظه کاری انسان (Raffone & Wolters, 2001, p. 2).
- معماریهای مصنوعی الهامگرفته: در شبکههای عصبی مصنوعی، حافظه کاری معمولاً از طریق شبکههای بازگشتی (RNN) و مکانیزمهای توجه پیادهسازی میشود. اما این مکانیزمها مشکل حفظ اطلاعات در دورههای طولانی را دارند: گرادیانها محو میشوند یا منفجر میشوند.
- راهحل الهامگرفته از همگامسازی: یک رویکرد نوظهور استفاده از نوسانگرهای همگامشده بهعنوان حافظه کاری است. در این رویکرد، الگوهای همگامسازی پایدار بین نوسانگرها اطلاعات را نگه میدارند — دقیقاً مشابه مغز. مزیت این رویکرد پایداری ذاتی آن است: همگامسازی یک حالت جاذب است که در برابر نویز و اختلالات کوچک مقاوم است.
- مطالعه موردی: مدل Adaptive Memory Control که توسط Liu و همکاران (۲۰۲۵) ارائه شد، یک مکانیزم حافظه تطبیقی را در چارچوب Kuramoto برداری معرفی میکند. در این مدل، هر نوسانگر میتواند تعاملات آینده خود را بر اساس فعالیت نورونی گذشته بهطور انتخابی تعدیل کند (Liu et al., 2025, p. 2). این مکانیزم دقیقاً مشابه حافظه کاری مغز است: اطلاعات گذشته فعالانه در پویایی فعلی ادغام میشوند.
ج) بهرهوری انرژی: همگامسازی انتخابی بهعنوان صرفهجویی
یکی از پیامدهای مهم همگامسازی انتخابی در مغز، بهرهوری انرژی است. اگر نورونها فقط با گروههای خاصی همگام شوند — نه با همه — آنگاه محاسبات غیرضروری حذف میشوند.
- معماری Neural Resonance Architecture (NRA): یک چارچوب محاسباتی الهامگرفته از مغز که اطلاعات را به باندهای رزونانس تقسیم میکند. هر باند در سطح متعادلی از انرژی و دقت عمل میکند .(Firoda, 2025, p. 1) برخلاف شبکههای عصبی سنتی که از دقت یکسان و حداکثر انرژی برای همه مسیرهای فعالسازی استفاده میکنند، NRA معاوضههای پویا بین دقت و مصرف انرژی از طریق دروازهبانی دقت و محاسبات فرکانس-محور فراهم میکند .(Firoda, 2025, p. 2)
- معماری Hebbian-Oscillatory Co-Learning (HOC-L): یک چارچوب دوطیف زمانی برای پلاستیسیتی ساختاری و همگامسازی فاز در معماریهای پراکنده الهامگرفته از مغز (Hays, 2026, p. 5). مکانیزم کلیدی آن پلاستیسیتی دروازهبانیشده با همگامسازی است: پارامتر نظم ماکروسکوپی r(t) مجموعه نوسانگرها بهروزرسانیهای ساختاری هبی را دروازهبانی میکند — یعنی تثبیت اتصالات فقط زمانی رخ میدهد که همدوسی فاز کافی یک الگوی محاسباتی معنادار را علامتدهی کند (Hays, 2026, p. 5). این معماری پیچیدگی O(n⋅k) با k≪nk≪n دست مییابد و پراکندگی هر دو چارچوب والد را حفظ میکند (Hays, 2026, p. 6).
۴.۷.۳ چالشها و محدودیتها
با وجود پتانسیل عظیم، معماریهای مبتنی بر همگامسازی با چالشهایی نیز مواجهند:
- چالش اول — پیچیدگی تنظیم: مکانیزمهای همگامسازی پارامترهای بیشتری از مکانیزمهای استاندارد دارند (فرکانس، دامنه، فاز، نرخ جفتشدگی). تنظیم این پارامترها دشوار است و نیازمند تخصص در نظریه سیستمهای دینامیکی است.
- چالش دوم — ناپایداری عددی: حل معادلات دیفرانسیل مرتبط با نوسانگرها (مانند معادله Kuramoto) میتواند ناپایدار باشد، بهویژه در گامهای زمانی بزرگ یا شبکههای بزرگ.
- چالش سوم — عدم تطابق کامل با زیستشناسی: حتی پیشرفتهترین مدلهای همگامسازی نیز سادهسازیهایی انجام میدهند. برای مثال، بسیاری از آنها نقش سلولهای گلیا را در تنظیم همگامسازی نادیده میگیرند.
- چالش چهارم — تفسیرپذیری: اگرچه قفلشدگی فاز یک مفهوم قابل تفسیر است، اما پویاییهای پیچیده نوسانگرها میتوانند به رفتارهای پیشبینینشدنی منجر شوند که تحلیل آنها دشوار است.
جمعبندی: از ریتمها تا هوش هماهنگ
در این بخش دیدیم که:
۱. مسئله اتصال (Binding Problem) یک پرسش بنیادین در علوم اعصاب است: مغز چگونه اطلاعات پراکنده را به یک تجربه واحد تبدیل میکند؟ پاسخ — حداقل بخشی از آن — در همگامسازی نهفته است (Singer & Gray, 1995).
۲. نظریه «ارتباط از طریق همدوسی» (CTC) توضیح میدهد که همگامسازی ارتباط بین گروههای نورونی را تنظیم میکند: نورونهایی که همزمان شلیک میکنند، سیگنال قویتری ارسال میکنند (Fries, 2015).
۳. ریتم تتا نقش «ساعت مرکزی» را ایفا میکند: فاز تتا قدرت گاما را تنظیم میکند و پنجرههای زمانی برای پردازش ایجاد میکند (Canolty et al., 2006).
۴. همگامسازی در حافظه کاری نقش کلیدی دارد: همگامسازی پایدار بین نواحی مختلف، ظرفیت حافظه کاری را پیشبینی میکند (Palva et al., 2010).
۵. معماریهای مصنوعی الهامگرفته از همگامسازی — مانند SSA، Krause Attention، FSN و HOC-L — نشان میدهند که جایگزینی مکانیزمهای مبتنی بر شباهت با مکانیزمهای مبتنی بر همگامسازی میتواند کارایی، پایداری و تفسیرپذیری را بهبود بخشد.
پیام مدیریتی کلیدی: در مسائلی که نیازمند ادغام اطلاعات از منابع مختلف هستند — مانند تصمیمگیری چندمعیاره، پیشبینی بازار با دادههای چندوجهی، یا مدیریت زنجیره تأمین پیچیده — معماریهای مبتنی بر همگامسازی میتوانند اطلاعات را بهطور انتخابی ادغام کنند. در این معماریها، توجه نه از شباهت بلکه از هماهنگی زمانی ناشی میشود: کدام اطلاعات با هم «هماهنگ» هستند، نه فقط «مشابه». این رویکرد، انعطافپذیری و دقت بیشتری در محیطهای پویا فراهم میکند.
در بخش بعدی، به درس هفتم میپردازیم: سلولهای گلیا و نقش آنها در یادگیری — یعنی چگونه آستروسیتها و میکروگلیا — که سالها بهعنوان «چسب عصبی» نادیده گرفته میشدند — اجزای فعال پردازش اطلاعات و یادگیری هستند.
منابع بخش
Canolty, R. T., Edwards, E., Dalal, S. S., Soltani, M., Nagarajan, S. S., Kirsch, H. E., Berger, M. S., Barbaro, N. M., & Knight, R. T. (2006). High gamma power is phase-locked to theta oscillations in human neocortex. Science, 313(5793), 1626–1628. https: //doi.org/10.1126/science.1128115
Firoda, M. (2025). Neural Resonance Architecture (NRA): Toward self-regulating energy-efficient intelligence. Zenodo. https: //zenodo.org/records/17976161
Fries, P. (2005). A mechanism for cognitive dynamics: Neuronal communication through neuronal coherence. Trends in Cognitive Sciences, 9(10), 474–480. https: //doi.org/10.1016/j.tics.2005.08.011
Fries, P. (2015). Rhythms for cognition: Communication through coherence. Neuron, 88(1), 220–235. https: //doi.org/10.1016/j.neuron.2015.09.034
Gray, C. M., König, P., Engel, A. K., & Singer, W. (1989). Oscillatory responses in cat visual cortex exhibit inter-columnar synchronization which reflects global stimulus properties. Nature, 338(6213), 334–337. https: //doi.org/10.1038/338334a0
Hays, H. (2026). Hebbian-Oscillatory Co-Learning. arXiv. https: //arxiv.org/pdf/2603.08731
Liu, J., Yue, Y., Welling, M., & Song, Y. (2026). Krause Synchronization Transformers. arXiv. https: //browse-export.arxiv.org/pdf/2602.11534
Liu, Y., Slotine, J.-J., & Barabási, A.-L. (2025). Adaptive Memory Control Mechanism. AAAI Conference on Artificial Intelligence. https: //ojs.aaai.org/index.php/AAAI/article/view/37156
Nunley, J. (2026). Attention as Frustrated Synchronization. arXiv. https: //browse-export.arxiv.org/pdf/2606.18694
Palva, J. M., Monto, S., Kulashekhar, S., & Palva, S. (2010). Neuronal synchrony reveals working memory networks and predicts individual memory capacity. Proceedings of the National Academy of Sciences, 107(16), 7580–7585. https: //doi.org/10.1073/pnas.0913113107
Raffone, A., & Wolters, G. (2001). A cortical mechanism for binding in visual working memory. Journal of Cognitive Neuroscience, 13(6), 766–785. https: //doi.org/10.1162/08989290152541430
Siebenhühner, F., Wang, S. H., Palva, J. M., & Palva, S. (2020). Cross-frequency synchronization connects networks of fast and slow oscillations during visual working memory maintenance. eLife, 9, e58058. https: //doi.org/10.7554/eLife.58058
Singer, W., & Gray, C. M. (1995). Visual feature integration and the temporal correlation hypothesis. Annual Review of Neuroscience, 18, 555–586. https: //doi.org/10.1146/annurev.ne.18.030195.003011
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998–6008.
von der Malsburg, C. (1999). The what and why of binding: The modeler’s perspective. Neuron, 24(1), 95–104. https: //doi.org/10.1016/S0896-6273(00)80825-9