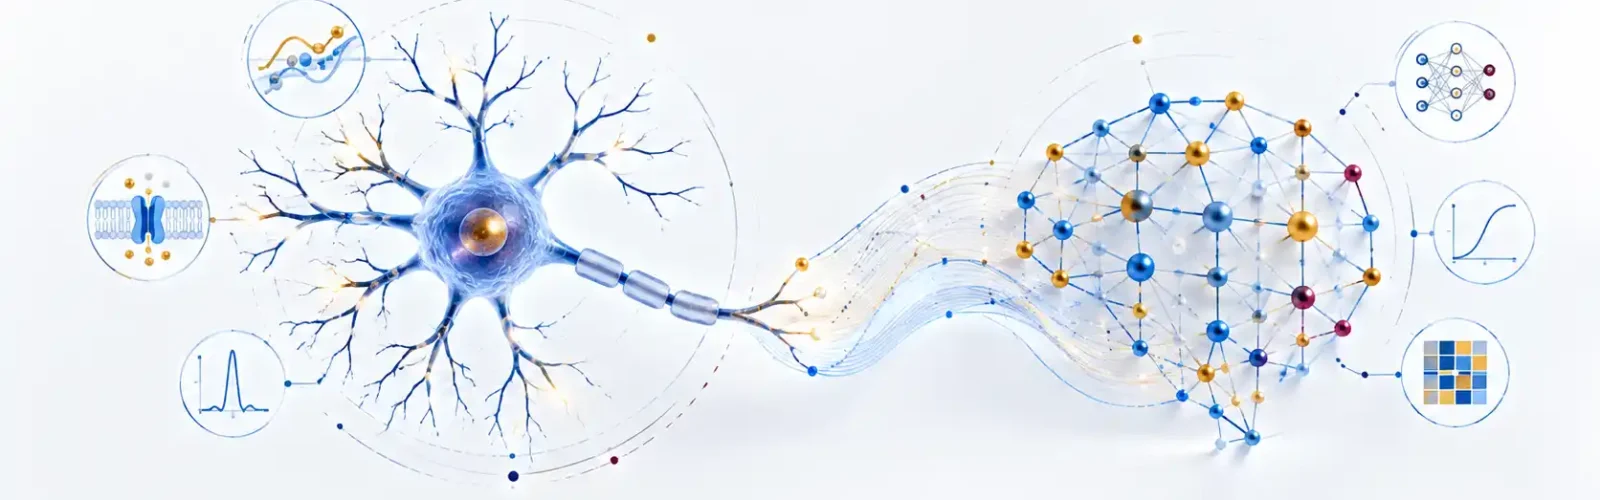
این فصل، پل مستقیم بین زیستشناسی و محاسبات است.
۴.۱ مقدمه: چرا نورون زیستی از نورون مصنوعی بسیار پیچیدهتر است؟
۴.۱.۰ چرا باید درباره نورون زیستی بدانیم؟
پیش از ورود به بحث اصلی، بگذارید با یک سؤال ساده شروع کنیم: چرا یک دانشجوی مدیریت یا اقتصاد باید درباره نورون زیستی و تفاوت آن با نورون مصنوعی بداند؟ مگر نه این است که ما میخواهیم شبکههای عصبی مصنوعی را برای پیشبینی فروش، تحلیل ریسک اعتباری یا بهینهسازی زنجیره تأمین به کار ببریم؟ چه اهمیتی دارد که نورون زیستی پیچیدهتر از نورون مصنوعی است؟
پاسخ این است: هر معماری یادگیری عمیقی که امروز استفاده میکنیم، روزی از دل تلاش برای درک مغز بیرون آمده است. مدل نورون مصنوعی که در فصلهای قبل آموختید — همان واحد سادهای که ورودیها را در وزن ضرب میکند، جمع میزند و از یک تابع فعالسازی عبور میدهد — در واقع سادهسازی شدید نورون زیستی است. این سادهسازی در بسیاری از مسائل مدیریتی کار میکند، اما در برخی شرایط — بهویژه وقتی با دادههای پویا، محیطهای متغیر و تصمیمگیریهای زمانمحور سروکار داریم — محدودیتهایی ایجاد میکند.
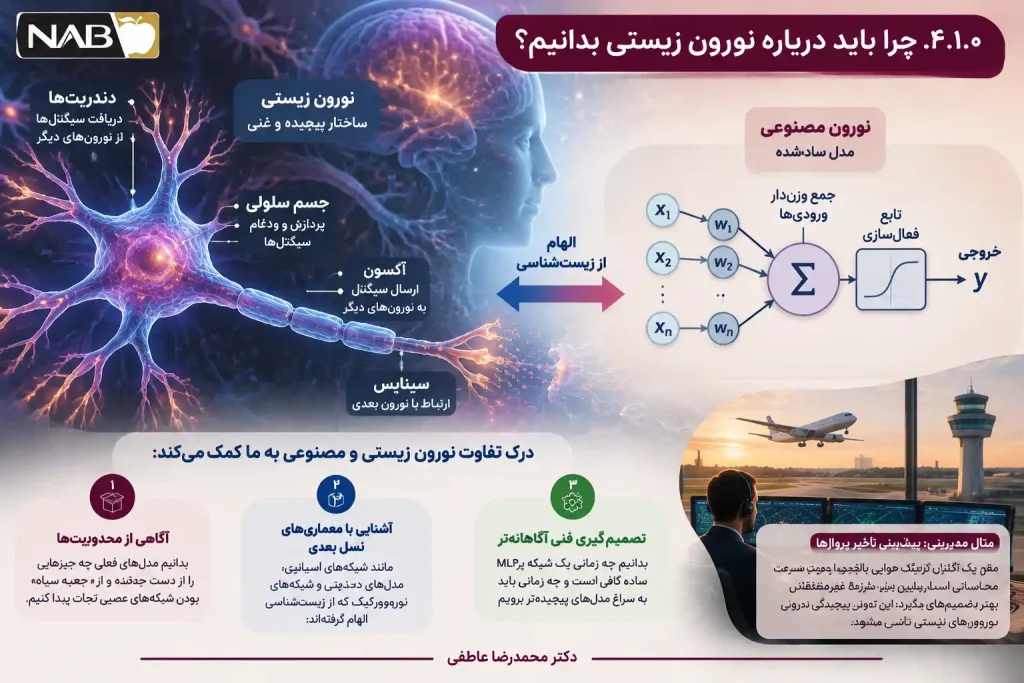
به بیان دیگر، درک شکاف بین نورون زیستی و مصنوعی به ما کمک میکند:
۱. بدانیم مدلهای فعلی چه چیزهایی را از دست میدهند — و این آگاهی ما را از «جعبه سیاه» بودن شبکههای عصبی نجات میدهد.
۲. معماریهای نسل بعدی را بشناسیم — معماریهایی مانند شبکههای اسپایکی، مدلهای دندریتی و شبکههای نورومورفیک که مستقیماً از زیستشناسی الهام گرفتهاند.
۳. تصمیمهای فنی آگاهانهتری بگیریم — بدانیم چه زمانی یک شبکه MLP ساده کافی است و چه زمانی باید به سراغ مدلهای پیچیدهتر برویم.
بیایید با یک مثال مدیریتی این اهمیت را روشنتر کنیم. تصور کنید یک شرکت هواپیمایی میخواهد تأخیر پروازها را پیشبینی کند. دادهها شامل آبوهوا، ترافیک هوایی، سابقه پرواز و تعداد خدمه است. یک شبکه عصبی مصنوعی استاندارد میتواند این کار را با دقت خوبی انجام دهد. اما مغز یک کنترلر ترافیک هوایی باتجربه، با وجود سرعت محاسباتی بسیار پایینتر، در شرایط غیرمنتظره (مانند وزش باد شدید یا نقص فنی ناگهانی) بهتر تصمیم میگیرد. این تفاوت از کجا ناشی میشود؟ بخش عمدهای از آن در پیچیدگی درونی نورونهای زیستی نهفته است — پیچیدگیای که در مدلهای مصنوعی نادیده گرفته میشود.
با این مقدمه، حالا آمادهایم تا به مقایسه دقیق مدل McCulloch-Pitts با نورون زیستی بپردازیم.
۴.۱.۱ مقایسه مدل McCulloch-Pitts با نورون زیستی
تاریخچه کوتاه: چگونه مدل McCulloch-Pitts متولد شد؟
در سال ۱۹۴۳، دو پژوهشگر — وارن مککالوک، عصبشناس، و والتر پیتس، ریاضیدان — مقالهای منتشر کردند که نقطه عطفی در تاریخ هوش مصنوعی بود. آنها در مقاله «حساب منطقی ایدههای ذاتی در فعالیت عصبی» (A Logical Calculus of the Ideas Immanent in Nervous Activity) مدلی ریاضی از نورون ارائه دادند که بعدها پایهگذار تمام شبکههای عصبی مصنوعی شد (McCulloch & Pitts, 1943).
نکته جالبی که بسیاری از آن بیخبرند این است که خود مککالوک و پیتس به محدودیتهای مدلشان آگاه بودند. آنها در مقاله خود صریحاً دو پدیده را ذکر کردند که مدلشان نمیتواند توضیح دهد: تسهیل (Facilitation) و انقراض — (Extinction)پدیدههایی که در آن فعالیت قبلی نورون، پاسخ آن به محرک بعدی را تغییر میدهد. آنها همچنین اشاره کردند که پدیده یادگیری «ظاهراً نیازمند امکان تغییرات دائمی در ساختار شبکهها» است (McCulloch & Pitts, 1943).
پس مدل McCulloch-Pitts چیست؟ و چه تفاوتی با نورون واقعی دارد؟
مدل McCulloch-Pitts: یک نورون سادهشده
مدل McCulloch-Pitts بر چند فرض بنیادین استوار است:
۱. ورودیها و خروجیها دودویی هستند — یعنی هر ورودی یا ۰ است یا ۱. هیچ مقدار میانی وجود ندارد.
۲. زمان انتشار ثابت است — سیگنالها در زمان ثابتی از یک نورون به نورون دیگر میرسند.
۳. ورودیها یا تحریکی هستند یا مهارکننده — ورودیهای تحریکی سعی میکنند نورون را فعال کنند، ورودیهای مهارکننده مانع فعال شدن آن میشوند.
۴. ورودیهای تحریکی در یک پنجره زمانی کوچک جمع میشوند — اگر مجموع ورودیهای تحریکی در این پنجره از یک آستانه فراتر رود، نورون فعال میشود.
۵. ورودیهای مهارکننده حق وتو دارند — یک ورودی مهارکننده فعال، صرفنظر از میزان ورودیهای تحریکی، از فعال شدن نورون جلوگیری میکند.
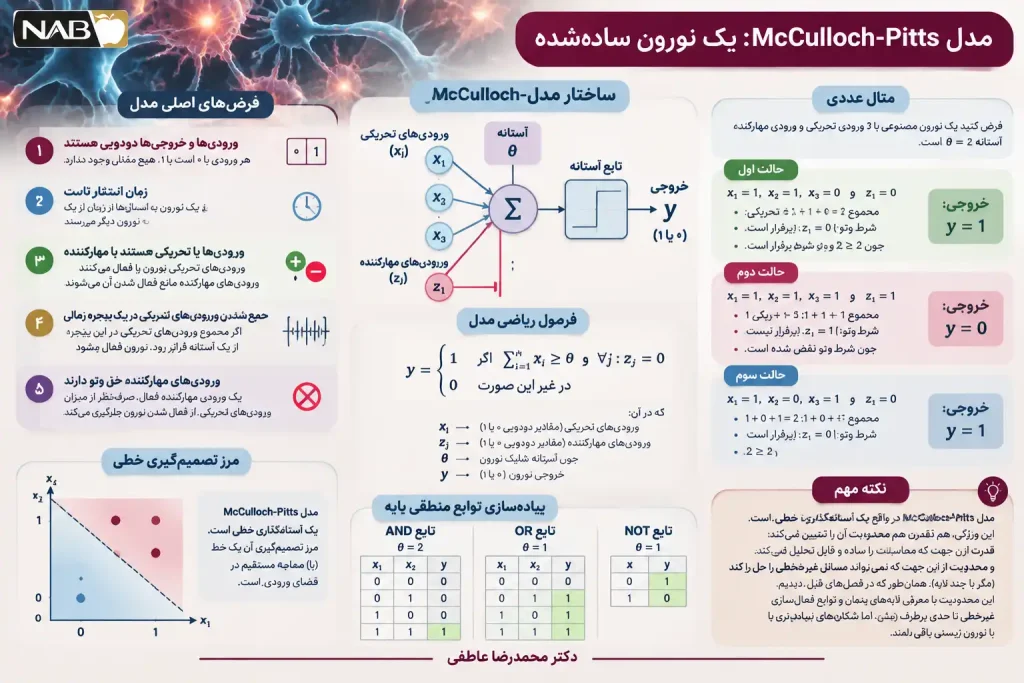
فرمول ریاضی این مدل به شکل زیر است:
که در آن:
- xi— ورودیهای تحریکی (مقادیر دودویی ۰ یا ۱)
- zj— ورودیهای مهارکننده (مقادیر دودویی ۰ یا ۱)
- θ— آستانه شلیک نورون
- y—خروجی نورون (۰ یا ۱)
بیایید با یک مثال عددی این مدل را روشن کنیم:
مثال ۴-۱: فرض کنید یک نورون مصنوعی با ۳ ورودی تحریکی و ۱ ورودی مهارکننده داریم. آستانه θ=2 است.
حالت اول: ورودیهای تحریکی x1=1,x2=1,x3=0 و ورودی مهارکننده z1=0.
- مجموع تحریکی: 1+1+0=2
- شرط وتو: z1=0 (برقرار است)
- چون 2≥2 و شرط وتو برقرار است: خروجی y=1 (نورون شلیک میکند)
سپس حالت دوم: ورودیهای تحریکی x1=1,x2=1,x3=1 و ورودی مهارکننده z1=1.
- مجموع تحریکی: 1+1+1=3
- شرط وتو: z1=1 (برقرار نیست)
- چون شرط وتو نقض شده است: خروجی y=0 (نورون شلیک نمیکند)
حالت سوم: ورودیهای تحریکی x1=1,x2=0,x3=1 و ورودی مهارکننده .z1=0
- مجموع تحریکی: 1+0+1=2
- شرط وتو: برقرار است
- چون 2≥2: خروجی y=1
این مدل — با وجود سادگیاش — قادر است توابع منطقی پایه مانند AND، OR و NOT را پیادهسازی کند. مثلاً تابع AND با دو ورودی x1 و x2 و آستانه θ=2 بهدست میآید: تنها زمانی خروجی ۱ است که هر دو ورودی ۱ باشند.
نکته مهم: مدل McCulloch-Pitts در واقع یک آستانهگذاری خطی است. این یعنی مرز تصمیمگیری آن یک خط (یا صفحه) مستقیم در فضای ورودی است. این ویژگی، هم قدرت و هم محدودیت آن را تعیین میکند: قدرت از این جهت که محاسبات را ساده و قابل تحلیل میکند، و محدودیت از این جهت که نمیتواند مسائل غیرخطی را حل کند (مگر با چند لایه). همانطور که در فصلهای قبل دیدیم، این محدودیت با معرفی لایههای پنهان و توابع فعالسازی غیرخطی تا حدی برطرف شد، اما شکافهای بنیادینتری با نورون زیستی باقی ماند.
نورون زیستی: واقعیتی بسیار پیچیدهتر
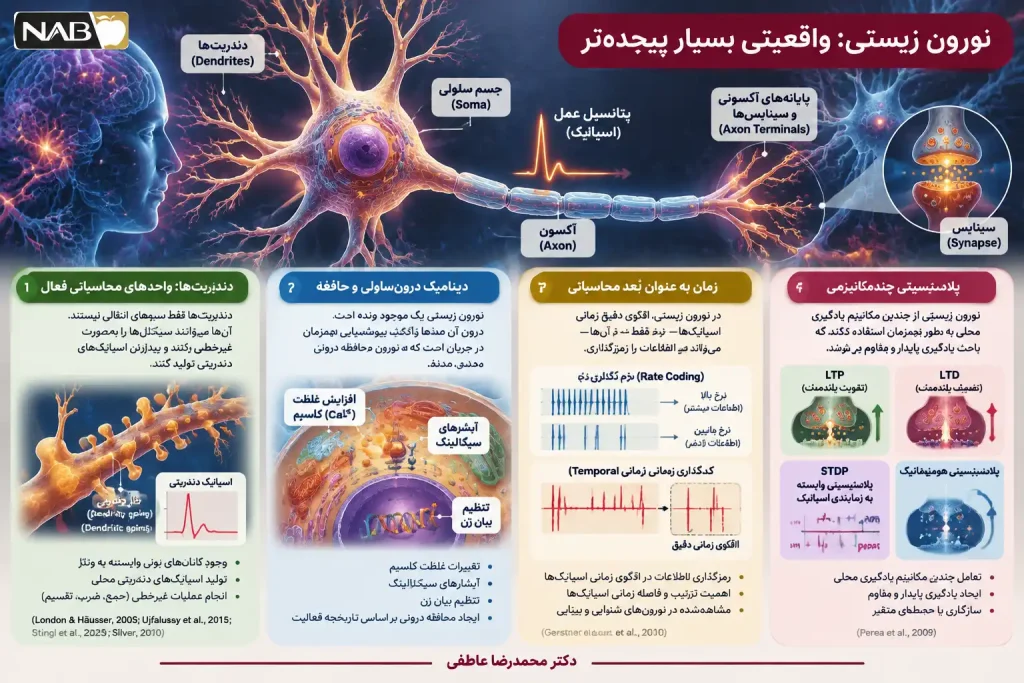
حالا بیایید به نورون زیستی نگاه کنیم. یک نورون واقعی در مغز انسان، از چند بخش اصلی تشکیل شده است:
۱. دندریتها (Dendrites): شاخههای درختیشکلی که سیگنالهای ورودی را دریافت میکنند. برخلاف تصور رایج، دندریتها فقط سیمهای انتقالی نیستند؛ آنها واحدهای محاسباتی فعال هستند که میتوانند سیگنالها را بهصورت غیرخطی پردازش کنند (London & Häusser, 2005; Ujfalussy et al., 2015).
۲. جسم سلولی (Soma): مرکز متابولیک نورون که سیگنالهای پردازششده دندریتی را جمعبندی میکند.
۳. آکسون (Axon): رشته بلندی که پتانسیل عمل (اسپایک) را از جسم سلولی به نورونهای دیگر منتقل میکند.
۴. پایانههای آکسونی (Axon Terminals) و سیناپسها: نقاطی که نورون با نورونهای دیگر ارتباط برقرار میکند.
اما تفاوتهای بنیادین بین نورون زیستی و مدل McCulloch-Pitts فقط در این ساختار ظاهری نیست. تفاوتهای عمیقتری در نحوه پردازش اطلاعات وجود دارد:
- تفاوت اول — پردازش در دندریتها: در مدل McCulloch-Pitts، تمام ورودیها به یک اندازه و بهصورت خطی جمع میشوند. اما در نورون زیستی، دندریتها دارای کانالهای یونی وابسته به ولتاژ هستند که به آنها اجازه میدهد اسپایکهای دندریتی تولید کنند .(Stingl et al., 2025) این اسپایکهای محلی، حتی بدون شلیک جسم سلولی، میتوانند بر پردازش بعدی تأثیر بگذارند. به بیان ساده، دندریتها بهجای جمع ساده، عملیات غیرخطی روی ورودیها انجام میدهند — و این عملیات شامل جمع، ضرب و تقسیم است (Silver, 2010).
- تفاوت دوم — دینامیک درونسلولی: نورون زیستی یک موجود زنده است. درون آن، صدها واکنش بیوشیمیایی همزمان در جریان است: تغییرات غلظت کلسیم، آبشارهای سیگنالینگ، تنظیم بیان ژن. این فرآیندها به نورون حافظه درونی میدهند — یعنی وضعیت فعلی نورون تحت تأثیر تاریخچه فعالیت قبلی آن است. در مدل McCulloch-Pitts (و حتی در نورونهای مصنوعی مدرن)، هیچکدام از این ویژگیها وجود ندارد: نورون مصنوعی یک تابع ریاضی بدون حالت است.
- تفاوت سوم — زمان بهعنوان بُعد محاسباتی: در نورون زیستی، زمان فقط یک متغیر نیست؛ مکانیزم اصلی رمزگذاری اطلاعات است. الگوی دقیق زمانی اسپایکها — نه فقط نرخ آنها — میتواند اطلاعات را رمزگذاری کند. این پدیده که به کدگذاری زمانی (Temporal Coding) معروف است، در نورونهای شنوایی و بینایی بهخوبی مستند شده است .(Gerstner et al., 2010) در مدل McCulloch-Pitts، زمان نقشی ندارد: همه ورودیها در یک لحظه جمع میشوند.
- تفاوت چهارم — پلاستیسیتی چندمکانیزمی: در مدل McCulloch-Pitts، وزنهای سیناپسی ثابتاند (یا از بیرون تغییر میکنند). اما نورون زیستی از چندین مکانیزم یادگیری محلی بهطور همزمان استفاده میکند: LTP (تقویت بلندمدت)، LTD (تضعیف بلندمدت)، STDP (پلاستیسیتی وابسته به زمانبندی اسپایک) و پلاستیسیتی هومئوستاتیک (Perea et al., 2009). این مکانیزمها با هم تعامل دارند تا یادگیری پایدار و مقاوم ایجاد کنند.
جدول زیر این تفاوتها را خلاصه میکند:
| بُعد مقایسه | نورون مصنوعی (McCulloch-Pitts) | نورون زیستی |
| ورودیها | دودویی (۰ یا ۱) | پیوسته، با دینامیک زمانی |
| پردازش دندریتی | جمع خطی ساده | پردازش غیرخطی (جمع، ضرب، تقسیم) |
| زمان | بدون بُعد زمانی | رمزگذاری زمانی (میلیثانیه) |
| حافظه درونی | ندارد (تابع بدون حالت) | دارد (وضعیت یونی و بیوشیمیایی) |
| پلاستیسیتی | یک قاعده سراسری (مثلاً Backprop) | چندین مکانیزم محلی همزمان |
| سلولهای پشتیبان | ندارد | آستروسیتها و میکروگلیا در پردازش نقش دارند |
| انرژی | وات بالا در مقیاس صنعتی | ~۲۰ وات برای کل مغز |
مثال عددی برای درک بهتر: فرض کنید یک نورون مصنوعی را دو بار با ورودی یکسان (x=0.5) تحریک میکنیم. خروجی هر دو بار دقیقاً یکسان خواهد بود. اما اگر یک نورون زیستی را دو بار با ورودی یکسان تحریک کنیم، ممکن است بار دوم پاسخ متفاوتی بدهد — زیرا وضعیت درونی نورون (غلظت یونها، سطح کلسیم، وضعیت کانالهای یونی) بین دو تحریک تغییر کرده است. این ویژگی که «تاریخچه فعالیت» نورون بر پاسخ آیندهاش تأثیر میگذارد، به نورون زیستی امکان یادگیری و انطباق پویا میدهد که در نورون مصنوعی غایب است.
این مثال به ما یک پیام مدیریتی مهم میدهد: اگر میخواهیم سیستمهای هوش مصنوعی برای مسائل تصمیمگیری پویا در محیطهای متغیر (مانند بازارهای مالی یا زنجیره تأمین) طراحی کنیم، باید به فکر معماریهایی باشیم که بتوانند حافظه درونی و انطباق پویا داشته باشند — ویژگیهایی که در نورونهای زیستی وجود دارند اما در مدلهای استاندارد مصنوعی غایب هستند.
۴.۱.۲ شکاف بین مدلهای فعلی و زیستشناسی
حالا که تفاوتهای اصلی را دیدیم، بیایید به شکافهای بنیادین بین نورون مصنوعی و زیستی نگاه دقیقتری بیندازیم. این شکافها در چهار محور اصلی خلاصه میشوند:
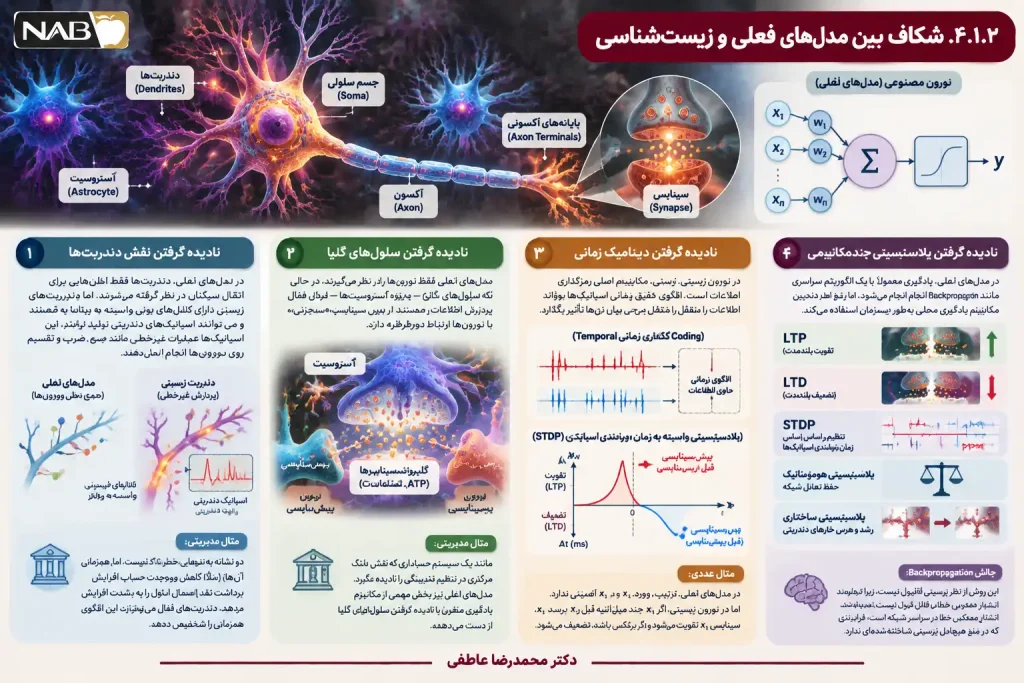
محور اول — نادیده گرفتن نقش دندریتها
در مدلهای استاندارد یادگیری عمیق، دندریتها صرفاً کابلهایی برای انتقال سیگنال به جسم سلولی در نظر گرفته میشوند. اما تحقیقات چند دهه اخیر نشان دادهاند که این تصویر کاملاً نادرست است.
دندریتهای نورونهای قشری دارای کانالهای یونی وابسته به ولتاژ هستند — یعنی کانالهایی که با تغییر ولتاژ غشا باز و بسته میشوند. این کانالها به دندریتها اجازه میدهند اسپایکهای دندریتی (Dendritic Spikes) تولید کنند. این اسپایکها از اسپایکهای جسم سلولی کوچکتر و پهنتر هستند، اما نقش مهمی در پردازش اطلاعات دارند (Stingl et al., 2025).
چرا این مهم است؟ زیرا اسپایکهای دندریتی به نورون اجازه میدهند عملیات غیرخطی انجام دهد. بهعنوان مثال، اگر دو ورودی همزمان به یک شاخه دندریتی برسند، ممکن است یک اسپایک دندریتی تولید کنند — حتی اگر هر ورودی بهتنهایی کافی نباشد. این پدیده که به جمعبندی فوقخطی (Supralinear Summation) معروف است، به نورون امکان میدهد الگوهای خاصی از ورودیها را تشخیص دهد .(Ujfalussy et al., 2015)
مثال مدیریتی: فرض کنید یک بانک میخواهد مشتریانی را که احتمال نکول وام دارند شناسایی کند. دو نشانه — کاهش موجودی حساب و افزایش برداشتهای نقدی — هر کدام بهتنهایی ممکن است نشانه خطر نباشند. اما همزمانی این دو نشانه در یک بازه کوتاه، احتمال نکول را بهشدت افزایش میدهد. یک نورون زیستی با دندریتهای فعال میتواند این «همزمانی» را تشخیص دهد؛ یک نورون مصنوعی ساده نمیتواند.
نکته تحقیقاتی: مطالعهای در سال ۲۰۲۱ که در مجله Neuron منتشر شد، نشان داد که یک نورون قشری منفرد را میتوان با یک شبکه عصبی عمیق مصنوعی با ۵ تا ۸ لایه مدلسازی کرد .(Beniaguev et al., 2021) این یعنی یک نورون زیستی بهتنهایی، به اندازه یک شبکه عمیق مصنوعی قدرت محاسباتی دارد. تحلیل ماتریسهای وزنی این شبکهها نشان داد که ادغام سیناپسی در شاخههای دندریتی میتواند بهعنوان «تطبیق الگو» از مجموعهای از قالبهای فضایی-زمانی درک شود .(Beniaguev et al., 2021)
محور دوم — نادیده گرفتن سلولهای گلیا
برای بیش از یک قرن، سلولهای گلیا —(Glia) که حدود نیمی از حجم مغز را تشکیل میدهند — بهعنوان «چسب عصبی» صرفاً بافت پشتیبان در نظر گرفته میشدند. تصور میشد که آنها فقط نورونها را کنار هم نگه میدارند و مواد مغذی را منتقل میکنند. اما تحقیقات دو دهه اخیر این تصور را کاملاً دگرگون کرده است.
امروز میدانیم که آستروسیتها(Astrocytes)— فراوانترین سلولهای گلیا در سیستم عصبی مرکزی — اجزای فعال پردازش اطلاعات هستند. آنها از طریق مفهوم «سیناپس سهجزئی» (Tripartite Synapse) با نورونها ارتباط دوطرفه دارند (Perea et al., 2009). در این مدل، سیناپس نه فقط از دو جزء (پیشسیناپسی و پسسیناپسی) بلکه از سه جزء تشکیل شده است: نورون پیشسیناپسی، نورون پسسیناپسی و آستروسیت مجاور.
آستروسیتها چگونه عمل میکنند؟ آنها گیرندههای گلوتامات دارند — یعنی میتوانند انتشار ناقلهای عصبی از نورون پیشسیناپسی را «بشنوند». وقتی آستروسیت فعالیت سیناپسی را تشخیص میدهد، موج کلسیمی در آن ایجاد میشود که میتواند به آزادسازی گلیوترانسمیترها (مانند گلوتامات و ATP) منجر شود. این مواد بهنوبه خود بر قدرت سیناپسی تأثیر میگذارند (Perea et al., 2009).
پیامد مدیریتی: اگر آستروسیتها بتوانند پلاستیسیتی سیناپسی را تنظیم کنند، پس مدلهای مصنوعی که فقط نورونها را در نظر میگیرند، بخش مهمی از مکانیزم یادگیری مغز را نادیده میگیرند. این مانند طراحی یک سیستم حسابداری است که فقط تراکنشهای اصلی را ثبت میکند و نقش بانک مرکزی در تنظیم نقدینگی را نادیده میگیرد.
محور سوم — نادیده گرفتن دینامیک زمانی
در نورون زیستی، زمان فقط یک بُعد اضافی نیست؛ بلکه مکانیزم اصلی رمزگذاری اطلاعات است. الگوهای دقیق زمانی شلیکها در نورونهای هیپوکامپ، از طریق مسیرهای سیگنالینگ درونسلولی رمزگشایی میشوند و ژنهای خاصی را فعال یا غیرفعال میکنند.
پلاستیسیتی وابسته به زمانبندی اسپایک (STDP) یکی از مهمترین مکانیزمهایی است که نقش زمان را نشان میدهد. در STDP، اگر یک نورون پیشسیناپسی چند میلیثانیه قبل از نورون پسسیناپسی شلیک کند، سیناپس تقویت میشود. (LTP) اما اگر ترتیب برعکس باشد — یعنی نورون پسسیناپسی اول شلیک کند و نورون پیشسیناپسی بعد — سیناپس تضعیف میشود (LTD) (Gerstner et al., 2010).
این یعنی ترتیب زمانی شلیکها — نه فقط نرخ آنها — اطلاعات را رمزگذاری میکند. در شبکههای مصنوعی استاندارد، این بُعد کاملاً غایب است: همه ورودیها در یک لحظه جمع میشوند و ترتیب آنها اهمیتی ندارد.
مثال عددی: فرض کنید دو ورودی داریم: x1 و . x2در یک شبکه مصنوعی استاندارد، فرقی نمیکند که x1 قبل از x2 بیاید یا بعد از آن — خروجی یکسان است. اما در یک نورون زیستی، اگر x1 چند میلیثانیه قبل از x2 برسد و سپس نورون شلیک کند، سیناپس x1 تقویت میشود. اگر برعکس باشد، سیناپس x1 تضعیف میشود. این تفاوت بنیادین، به نورون زیستی امکان یادگیری روابط علّی را میدهد — چیزی که در شبکههای مصنوعی استاندارد بسیار دشوار است.
محور چهارم — نادیده گرفتن پلاستیسیتی چندمکانیزمی
در شبکههای عصبی مصنوعی، یادگیری معمولاً از طریق یک الگوریتم سراسری )مانند Backpropagation) انجام میشود. اما مغز از چندین مکانیزم یادگیری محلی بهطور همزمان استفاده میکند:
- LTP (Long-Term Potentiation): تقویت بلندمدت سیناپسهایی که مکرراً فعال میشوند.
- LTD (Long-Term Depression): تضعیف بلندمدت سیناپسهایی که کمفعالیت هستند.
- STDP: تنظیم دقیق وزن سیناپسی بر اساس زمانبندی اسپایکها.
- پلاستیسیتی هومئوستاتیک: حفظ تعادل کلی بین تحریک و مهار در شبکه.
- پلاستیسیتی ساختاری: رشد و هرس خارهای دندریتی.
این مکانیزمها با هم تعامل دارند تا یادگیری پایدار، مقاوم و انعطافپذیر ایجاد کنند. بهعنوان مثال، پلاستیسیتی هومئوستاتیک از اشباع شدن سیناپسها جلوگیری میکند — یعنی مانع از آن میشود که یک سیناپس آنقدر تقویت شود که دیگر نتواند تغییر کند.
چالش Backpropagation: یکی از انتقادات اصلی به Backpropagation این است که از نظر زیستی قابل قبول نیست. چرا؟ زیرا Backpropagation نیازمند انتشار معکوس خطا از لایههای بالایی به لایههای پایینی است — فرآیندی که در مغز هیچ معادل زیستی شناختهشدهای ندارد. نورونهای زیستی فقط اطلاعات محلی در دسترس دارند: آنها میدانند چه سیگنالی دریافت میکنند و چه سیگنالی ارسال میکنند، اما «خطای کلی شبکه» را نمیدانند.
این محدودیت انگیزهای برای توسعه قواعد یادگیری محلی (Local Learning Rules) شده است که فقط از اطلاعات در دسترس هر نورون استفاده میکنند. STDP یکی از این قواعد است — و همانطور که دیدیم، مستقیماً از زیستشناسی الهام گرفته شده است.
جمعبندی: از شکاف تا فرصت
در این مقدمه، چارچوب کلی فصل را ترسیم کردیم. دیدیم که:
۱. مدل McCulloch-Pitts (۱۹۴۳) پایهگذار شبکههای عصبی مصنوعی بود، اما خود بنیانگذاران آن از محدودیتهای مدلشان آگاه بودند.
۲. چهار شکاف بنیادین بین نورون مصنوعی و زیستی وجود دارد: نادیده گرفتن دندریتها، گلیا، دینامیک زمانی، و پلاستیسیتی چندمکانیزمی.
۳. درک این شکافها نه فقط یک بحث دانشگاهی، بلکه پیشنیازی برای طراحی معماریهای نوین یادگیری عمیق است که بتوانند در مسائل پیچیده و پویا عملکرد بهتری داشته باشند.
یک نکته مهم: این شکافها را نباید فقط بهعنوان محدودیت دید. بلکه باید آنها را بهعنوان فرصت در نظر گرفت. هر شکاف، یک جهت تحقیقاتی جدید را نشان میدهد:
- شکاف دندریتی → معماریهای دندریتی (فصل ۴.۲)
- شکاف پلاستیسیتی → یادگیری محلی و چندمکانیزمی (فصل ۴.۳)
- شکاف زمانی → شبکههای اسپایکی (فصل ۴.۴)
- شکاف انرژی → محاسبات نورومورفیک (فصل ۴.۵)
در بخشهای بعدی این فصل، هر یک از این درسها را به تفصیل بررسی خواهیم کرد و نشان خواهیم داد که چگونه زیستشناسی میتواند الهامبخش نسل بعدی معماریهای هوش مصنوعی برای کاربردهای مدیریتی باشد.
پرسش برای تفکر: قبل از رفتن به بخش بعدی، لحظهای تأمل کنید: اگر مغز انسان با تنها ۲۰ وات انرژی میتواند کارهایی انجام دهد که ابررایانهها با مگاوات انرژی از انجام دقیق آنها عاجزند (Human Brain Project, 2023)، چه چیزی در طراحی مغز وجود دارد که ما در طراحی سیستمهای مصنوعی نادیده گرفتهایم؟ این پرسش، روح حاکم بر تمام فصل پیش روست.
منابع این بخش
Beniaguev, D., Segev, I., & London, M. (2021). Single cortical neurons as deep artificial neural networks. Neuron, 109(17), 2727–2739. https: //doi.org/10.1016/j.neuron.2021.07.002
Gerstner, W., Ritz, R., & van Hemmen, J. L. (2010). Why spikes? Hebbian learning and retrieval of time-resolved excitation patterns. Biological Cybernetics, 103(5), 379–391. https: //doi.org/10.1007/s00422-010-0401-7
Human Brain Project. (2023, September 4). Learning from the brain to make AI more energy-efficient. https: //www.humanbrainproject.eu/en/follow-hbp/news/2023/09/04/learning-brain-make-ai-more-energy-efficient/
London, M., & Häusser, M. (2005). Dendritic computation. Annual Review of Neuroscience, 28, 503–532. https: //doi.org/10.1146/annurev.neuro.28.061604.135703
McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. Bulletin of Mathematical Biophysics, 5(4), 115–133. https: //doi.org/10.1007/BF02478259
Perea, G., Navarrete, M., & Araque, A. (2009). Tripartite synapses: Astrocytes process and control synaptic information. Trends in Neurosciences, 32(8), 421–431. https: //doi.org/10.1016/j.tins.2009.05.001
Silver, R. A. (2010). Neuronal arithmetic. Nature Reviews Neuroscience, 11(7), 474–489. https: //doi.org/10.1038/nrn2864
Stingl, M., Draguhn, A., & Both, M. (2025). A dendrite is a dendrite is a dendrite? Dendritic signal integration beyond the “antenna” model. Pflügers Archiv — European Journal of Physiology, 477(1), 9–16. https: //doi.org/10.1007/s00424-024-03004-0
Ujfalussy, B. B., Makara, J. K., Branco, T., & Lengyel, M. (2015). Dendritic nonlinearities are tuned for efficient spike-based computations in cortical circuits. eLife, 4, e10056. https: //doi.org/10.7554/eLife.10056
۴.۲ درس ۱ — قدرت محاسباتی دندریتها
۴.۲.۰ چرا دندریتها مهم هستند؟
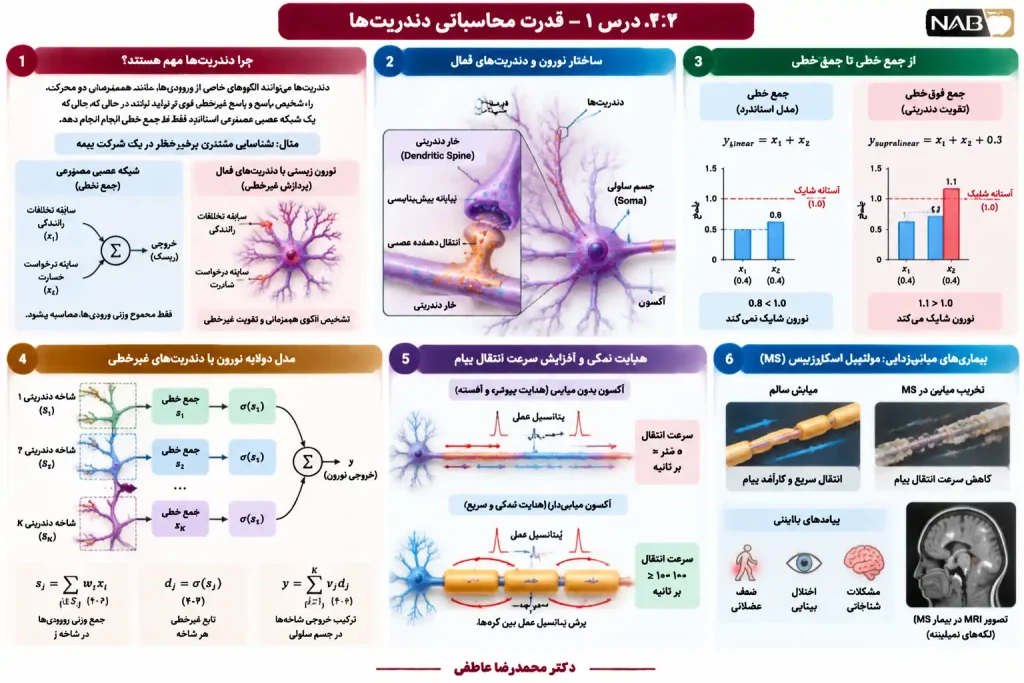
در بخش قبل دیدیم که یکی از شکافهای اصلی بین نورون مصنوعی و زیستی، نادیده گرفتن نقش دندریتهاست. اما این «نادیده گرفتن» دقیقاً به چه معناست؟ و اگر دندریتها را جدی بگیریم، چه چیزی به دست میآوریم؟
بگذارید با یک مثال ملموس شروع کنیم. فرض کنید یک شرکت بیمه میخواهد مشتریانی را که احتمال بالای تصادف دارند شناسایی کند. دو نشانه وجود دارد: (۱) سابقه تخلفات رانندگی و (۲) سابقه درخواست خسارت. یک شبکه عصبی مصنوعی استاندارد این دو نشانه را بهصورت خطی جمع میکند: اگر مجموع وزنی از آستانهای فراتر رود، مشتری «پرخطر» برچسب میخورد. اما یک نورون زیستی با دندریتهای فعال، میتواند الگوهای خاصی از همزمانی را تشخیص دهد — مثلاً «اگر مشتری هم تخلف داشته باشد و هم درخواست خسارت، آنگاه ریسک بهشدت بالا میرود، حتی اگر هر یک از این دو بهتنهایی چندان نگرانکننده نباشد.» این قابلیت، ناشی از پردازش غیرخطی در دندریتها است.
در این بخش، بهطور عمیق به این پرسش میپردازیم که دندریتها چگونه بهعنوان واحدهای محاسباتی غیرخطی عمل میکنند، چه پیامدهایی برای شبکههای عصبی مصنوعی دارند، و چه معماریهای الهامگرفته از دندریت تاکنون توسعه یافتهاند.
۴.۲.۱ دندریتها بهعنوان واحدهای محاسباتی غیرخطی
از جمع خطی تا جمع فوقخطی
در مدلهای استاندارد شبکههای عصبی، ورودیهای سیناپسی بهصورت خطی جمع میشوند: اگر دو ورودی با مقادیر x1 و x2 داشته باشیم، پاسخ کل برابر است با . x1+x2 این فرض که به جمعبندی خطی (Linear Summation) معروف است، پایه و اساس مدل McCulloch-Pitts و تمام شبکههای عصبی مصنوعی مدرن است (Acharya et al., 2022, pp. 3–4).
اما شواهد تجربی چند دهه اخیر نشان میدهد که دندریتهای نورونهای قشری، کانالهای یونی وابسته به ولتاژ دارند — یعنی کانالهایی که با تغییر ولتاژ غشا باز و بسته میشوند. این کانالها به دندریتها اجازه میدهند اسپایکهای دندریتی (Dendritic Spikes) تولید کنند. نتیجه این است که جمع ورودیهای سیناپسی در دندریتها غیرخطی است: اگر دو ورودی همزمان به یک شاخه دندریتی برسند، پاسخ کل میتواند بیشتر از جمع حسابی آن دو باشد. این پدیده که به جمعبندی فوقخطی (Supralinear Summation) معروف است، به نورون امکان میدهد الگوهای خاصی از ورودیها را تشخیص دهد (London & Häusser, 2005; Silver, 2010).
برای درک بهتر، بیایید یک مثال ساده بیاوریم:
مثال ۴-۲: فرض کنید دو ورودی سیناپسی داریم: x1=0.4 و x2=0.4. در جمعبندی خطی، پاسخ کل برابر است با:
اما در جمعبندی فوقخطی، پاسخ کل میتواند بهطور قابلتوجهی بیشتر باشد:
که در آن 0.3 ناشی از تقویت غیرخطی در دندریت است. اگر آستانه شلیک نورون 1.0 باشد، در حالت خطی نورون شلیک نمیکند (0.8<1.0)، اما در حالت فوقخطی شلیک میکند .(1.1>1.0) این تفاوت، همان قدرت محاسباتی افزوده دندریتهاست.
مدل دولایه نورون
این یافتههای تجربی، محققان را به سمت مدلسازی نورون بهعنوان یک واحد محاسباتی دولایه سوق داده است. در این مدل که به «مدل دولایه» (Two-Layer Model) معروف است، سیناپسها ابتدا بهصورت خطی در شاخههای دندریتی جمع میشوند، و سپس هر شاخه یک تابع غیرخطی (معمولاً سیگموئید) روی مجموع خود اعمال میکند. خروجی نهایی نورون، ترکیبی از خروجی این شاخههاست (Acharya et al., 2022, p. 4; Poirazi et al., 2003).
فرمولبندی ساده این مدل به شکل زیر است:
برای یک نورون با K شاخه دندریتی، ابتدا مجموع وزنی ورودیها در هر شاخه محاسبه میشود:
که در آن Sj مجموعه سیناپسهای متصل به شاخه j است. سپس هر شاخه یک تابع غیرخطی σ روی مجموع خود اعمال میکند:
و در نهایت، خروجی نورون از ترکیب خروجی شاخهها بهدست میآید:
که در آن vj وزن اتصال شاخه j به جسم سلولی است. این ساختار در واقع یک شبکه عصبی دو لایه درون یک نورون منفرد است: لایه اول شامل شاخههای دندریتی با تابع فعالسازی غیرخطی، و لایه دوم شامل جمع خروجی شاخهها در جسم سلولی. این مدل توضیح میدهد که چرا یک نورون منفرد میتواند محاسباتی پیچیدهتر از یک واحد خطی ساده انجام دهد (Acharya et al., 2022; Beniaguev et al., 2021).
شواهد تجربی
شواهد تجربی متعددی از این مدل پشتیبانی میکنند. برای مثال، مطالعهای در سال ۲۰۲۱ نشان داد که یک نورون قشری منفرد را میتوان با یک شبکه عصبی عمیق مصنوعی با ۵ تا ۸ لایه مدلسازی کرد .(Beniaguev et al., 2021) این یعنی یک نورون زیستی بهتنهایی، به اندازه یک شبکه عمیق مصنوعی قدرت محاسباتی دارد. تحلیل ماتریسهای وزنی این شبکهها نشان داد که ادغام سیناپسی در شاخههای دندریتی میتواند بهعنوان «تطبیق الگو» از مجموعهای از قالبهای فضایی-زمانی درک شود (Beniaguev et al., 2021, p. 2727).
مطالعه دیگری نشان داد که نورونهای هرمی قشری میتوانند از دندریتهای خود برای انجام عملیات منطقی مانند AND، OR و XOR استفاده کنند (Acharya et al., 2022, p. 3). این عملیات، پایهای برای تصمیمگیریهای پیچیدهتر هستند. برای مثال، تشخیص «مشتری پرخطر» در مثال بیمه، در واقع یک عملیات AND غیرخطی است: هم تخلف داشته باشد و هم خسارت.
چرا این مهم است؟ پیامدهای مدیریتی
درک نقش محاسباتی دندریتها، پیامدهای مستقیمی برای طراحی سیستمهای هوش مصنوعی در مسائل مدیریتی دارد. در بسیاری از مسائل کسبوکار، تعاملات غیرخطی بین متغیرها نقش کلیدی ایفا میکنند. برای مثال:
- بازاریابی: احتمال خرید یک محصول نه فقط به قیمت و کیفیت آن، بلکه به همزمانی تبلیغ و تخفیف بستگی دارد.
- مدیریت ریسک: احتمال نکول وام نه فقط به درآمد مشتری، بلکه به تغییر ناگهانی در وضعیت شغلی او بستگی دارد.
- زنجیره تأمین: احتمال اختلال در زنجیره، نه فقط به تأخیر یک تأمینکننده، بلکه به همزمانی تأخیر چند تأمینکننده کلیدی بستگی دارد.
شبکههای عصبی استاندارد میتوانند این تعاملات را با اضافه کردن لایههای پنهان مدل کنند. اما این کار نیازمند پارامترهای بیشتر و دادههای بیشتر است. شبکههای الهامگرفته از دندریت، این تعاملات را بهصورت ذاتی مدل میکنند — یعنی نیازی به لایههای اضافی ندارند.
۴.۲.۲ پیامدهای برای شبکههای عصبی مصنوعی
حالا که فهمیدیم دندریتها چگونه محاسبه میکنند، بیایید به این پرسش بپردازیم: اگر این مکانیزم را به شبکههای عصبی مصنوعی اضافه کنیم، چه چیزی به دست میآوریم؟ تحقیقات چهار پیامد اصلی را شناسایی کردهاند (Acharya et al., 2022, pp. 1–2):
الف) افزایش بیانپذیری
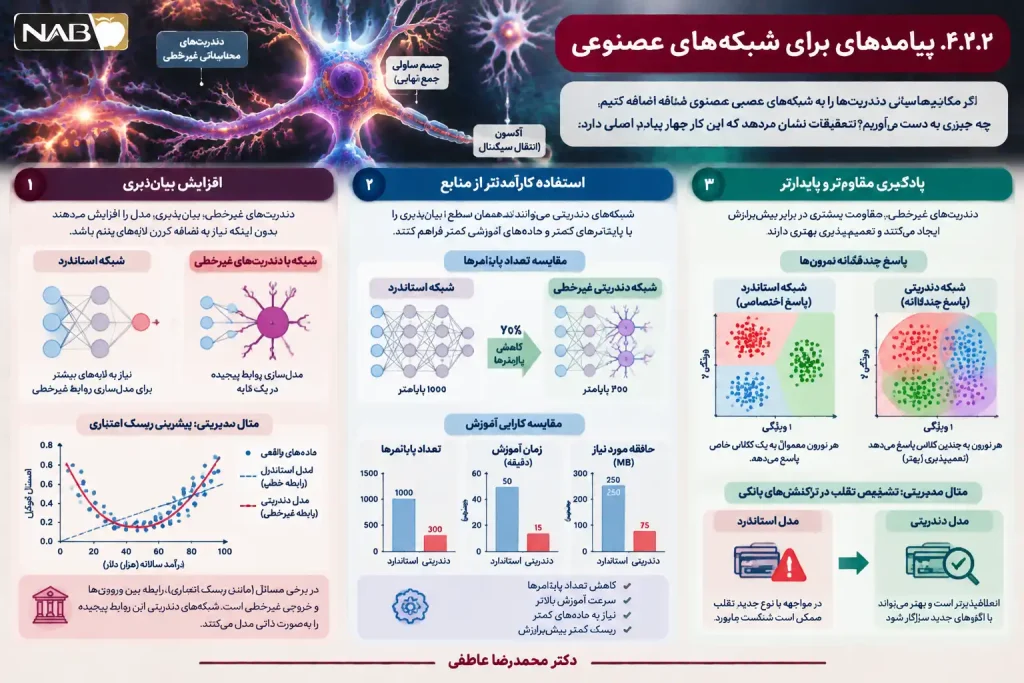
بیانپذیری (Expressivity) به توانایی یک مدل برای تقریب توابع پیچیده اشاره دارد. یک مدل با بیانپذیری بالاتر، میتواند الگوهای پیچیدهتری را از دادهها یاد بگیرد. دندریتهای غیرخطی، بیانپذیری مدل را افزایش میدهند بدون اینکه نیاز به اضافه کردن لایههای پنهان باشد (Wu et al., 2018, p. 1).
برای درک این موضوع، یک مثال مدیریتی بیاوریم. فرض کنید یک بانک میخواهد ریسک اعتباری مشتریان را پیشبینی کند. یک شبکه عصبی استاندارد با یک لایه پنهان، میتواند رابطه بین درآمد و احتمال نکول را یاد بگیرد. اما اگر این رابطه غیرخطی باشد — مثلاً احتمال نکول در درآمدهای بسیار پایین و بسیار بالا بیشتر باشد (به دلیل بیثباتی شغلی) — شبکه استاندارد نیازمند لایههای پنهان بیشتری است. شبکه با دندریتهای غیرخطی، این رابطه غیرخطی را بهصورت ذاتی مدل میکند.
مطالعهای که در کنفرانس NeurIPS 2018 منتشر شد، نشان داد که شبکههای عصبی دندریتی (DENN) بیانپذیری بالاتری نسبت به شبکههای استاندارد دارند و در ۱۲۱ وظیفه طبقهبندی از مخزن یادگیری ماشین UCI، عملکرد بهتری از خود نشان دادند (Wu et al., 2018, p. 3).
ب) استفاده کارآمدتر از منابع
ممکن است این سؤال پیش بیاید: اگر شبکههای استاندارد نیز (با لایههای کافی) میتوانند هر تابعی را تقریب بزنند، پس چه نیازی به دندریتها داریم؟ پاسخ این است: مسئله فقط بیانپذیری نیست؛ مسئله کارایی است. شبکههای استاندارد برای دستیابی به بیانپذیری بالا، نیازمند پارامترهای بسیار بیشتر و دادههای آموزشی بیشتر هستند. دندریتهای غیرخطی میتوانند همان سطح از بیانپذیری را با منابع کمتر فراهم کنند (Acharya et al., 2022, p. 5).
مثال عددی: فرض کنید یک شبکه استاندارد برای حل یک مسئله طبقهبندی، نیازمند ۱۰۰۰ پارامتر است. یک شبکه با دندریتهای غیرخطی، ممکن است همان مسئله را با ۳۰۰ پارامتر حل کند — یعنی ۷۰٪ کاهش در تعداد پارامترها. این کاهش، نه فقط حافظه کمتر بلکه سرعت آموزش بالاتر و ریسک کمتر بیشبرازش را به همراه دارد.
ج) یادگیری مقاومتر و پایدارتر
یکی از چالشهای اصلی شبکههای عصبی مصنوعی، بیشبرازش (Overfitting) است: مدل روی دادههای آموزشی عملکرد خوبی دارد اما روی دادههای جدید ضعیف عمل میکند. تحقیقات نشان میدهد که دندریتهای غیرخطی، مقاومت بیشتری در برابر بیشبرازش ایجاد میکنند (Chavlis & Poirazi, 2025, p. 1).
دلیل این پدیده چیست؟ وقتی دندریتها ورودیها را بهصورت محلی و غیرخطی پردازش میکنند، هر نورون به چندین کلاس پاسخ میدهد — برخلاف شبکههای استاندارد که هر نورون معمولاً به یک کلاس خاص پاسخ میدهد. این ویژگی که به «پاسخ چندگانه» (Multi-Class Response) معروف است، باعث میشود مدل تعمیمپذیری بهتری داشته باشد (Chavlis & Poirazi, 2025, p. 1).
مثال مدیریتی: فرض کنید یک سیستم تشخیص تقلب در تراکنشهای بانکی طراحی میکنید. اگر مدل شما هر نورون را به یک نوع تقلب خاص اختصاص دهد، در مواجهه با نوع جدیدی از تقلب ممکن است شکست بخورد. اما اگر نورونها به چندین نوع تقلب پاسخ دهند، مدل انعطافپذیرتر خواهد بود و بهتر میتواند با الگوهای جدید سازگار شود.
۴.۲.۳ معماریهای الهامگرفته از دندریت
تا اینجا درباره چرایی و چگونگی دندریتها صحبت کردیم. حالا بیایید به معماریهای عملی بپردازیم که این اصول را در شبکههای عصبی مصنوعی پیادهسازی میکنند.
شبکه عصبی دندریتی (Dendritic Neural Network — DENN)
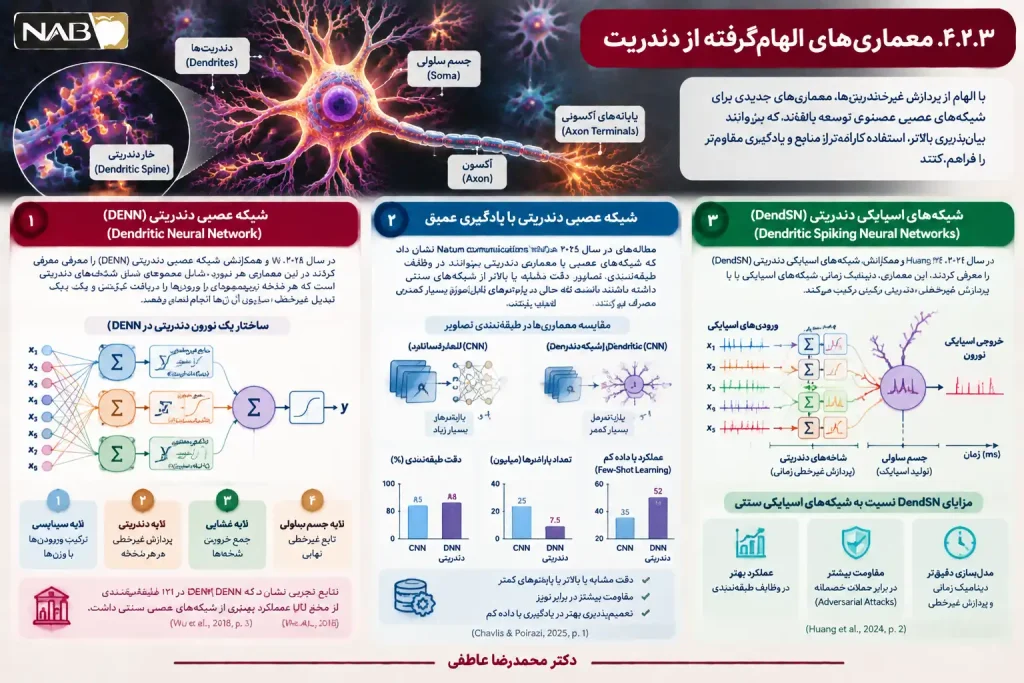
در سال ۲۰۱۸، Wu و همکارانش شبکه عصبی دندریتی (DENN) را معرفی کردند. در این معماری، هر نورون نه یک واحد ساده، بلکه مجموعهای از شاخههای دندریتی است. هر شاخه، زیرمجموعهای از ورودیهای لایه قبلی را دریافت میکند و یک تبدیل غیرخطی محلی روی آنها انجام میدهد (Wu et al., 2018, p. 2).
ساختار DENN به این شکل است:
۱. لایه سیناپسی: ورودیها با وزنهای سیناپسی ترکیب میشوند.
۲. لایه دندریتی: هر شاخه دندریتی، خروجی لایه سیناپسی را با یک تابع غیرخطی (مثلاً سیگموئید) پردازش میکند.
۳. لایه غشایی: خروجی شاخهها در جسم سلولی جمع میشود.
۴. لایه جسم سلولی: یک تابع غیرخطی نهایی روی مجموع اعمال میشود.
این ساختار در واقع یک شبکه دو لایه درون یک نورون است. نتایج تجربی نشان داد که DENN در ۱۲۱ وظیفه طبقهبندی از مخزن UCI، عملکرد بهتری از شبکههای عصبی سنتی داشت (Wu et al., 2018, p. 3).
شبکه عصبی دندریتی با یادگیری عمیق
مطالعهای در سال ۲۰۲۵ که در Nature Communications منتشر شد، نشان داد که شبکههای عصبی مصنوعی با معماری دندریتی میتوانند در وظایف طبقهبندی تصاویر، دقت مشابه یا بالاتر از شبکههای سنتی داشته باشند، در حالی که پارامترهای قابلآموزش بسیار کمتری مصرف میکنند .(Chavlis & Poirazi, 2025, p. 1) این مطالعه همچنین نشان داد که این شبکهها مقاومت بیشتری در برابر نویز و تعمیمپذیری بهتری در شرایط یادگیری با داده کم (Few-Shot Learning) دارند.
شبکههای اسپایکی دندریتی (Dendritic Spiking Neural Networks)
یکی از پیشرفتهترین معماریها، شبکههای اسپایکی دندریتی (DendSN) هستند که در سال ۲۰۲۴ معرفی شدند. این معماری، دینامیک زمانی شبکههای اسپایکی را با پردازش غیرخطی دندریتی ترکیب میکند .(Huang et al., 2024, p. 1)
در این معماری، هر نورون اسپایکی نه فقط یک واحد جمعکننده، بلکه مجموعهای از شاخههای دندریتی غیرخطی است. نتایج تجربی نشان داد که DendSN در وظایف طبقهبندی، عملکرد بهتری از شبکههای اسپایکی سنتی دارد و مقاومت بیشتری در برابر حملات خصمانه (Adversarial Attacks) از خود نشان میدهد .(Huang et al., 2024, p. 2)
مقایسه معماریها
جدول زیر معماریهای اصلی الهامگرفته از دندریت را مقایسه میکند:
| معماری | ویژگی کلیدی | کاربرد اصلی | مزیت اصلی |
| DENN | شاخههای دندریتی با تابع غیرخطی محلی | طبقهبندی عمومی | بیانپذیری بالاتر |
| Dendritic ANN | اتصال ساختاریافته و نمونهبرداری محدود | طبقهبندی تصاویر | پارامتر کمتر، مقاومت بیشتر |
| DendSN | ترکیب دندریت با اسپایک | طبقهبندی و یادگیری پیوسته | مقاومت در برابر نویز |
| DendSOM | دندریت + نقشه خودسازمانده | یادگیری پیوسته | کاهش فراموشی فاجعهبار |
۴.۲.۴ چالشها و محدودیتها
با وجود مزایای قابلتوجه، معماریهای الهامگرفته از دندریت با چالشهایی نیز مواجه هستند که باید آگاهانه به آنها پرداخت:
- چالش اول — پیچیدگی محاسباتی: مدلسازی دقیق دندریتها نیازمند محاسبات بیشتری است. هر شاخه دندریتی یک واحد محاسباتی مستقل است، و اگر تعداد شاخهها زیاد باشد، هزینه محاسباتی بهسرعت افزایش مییابد. برای رفع این مشکل، محققان مدلهای کاهشیافته (Reduced Models) را توسعه دادهاند که تعادلی بین دقت زیستی و کارایی محاسباتی برقرار میکنند (Pagkalos et al., 2023, p. 1).
- چالش دوم — دشواری آموزش: آموزش شبکههای دندریتی پیچیدهتر از شبکههای استاندارد است. الگوریتم Backpropagation استاندارد برای این معماریها بهینه نیست، زیرا دندریتها دینامیک محلی دارند. محققان در حال توسعه الگوریتمهای یادگیری محلی (Local Learning Rules) هستند که با ساختار دندریتی سازگارتر باشند (Acharya et al., 2022, p. 10).
- چالش سوم — عدم تطابق کامل با زیستشناسی: حتی پیشرفتهترین مدلهای دندریتی نیز سادهسازیهایی انجام میدهند. برای مثال، بسیاری از آنها دینامیک دقیق کانالهای یونی را نادیده میگیرند یا نقش سلولهای گلیا را در نظر نمیگیرند. این سادهسازیها اگرچه برای کارایی محاسباتی ضروری هستند، اما به معنای فاصله گرفتن از زیستشناسی واقعی نیز هستند.
- چالش چهارم — تعمیمپذیری به مسائل مدیریتی: اکثر مطالعات تجربی روی دندریتها در وظایف بینایی (مانند MNIST و CIFAR) انجام شده است. تعمیم این نتایج به مسائل مدیریتی (مانند پیشبینی فروش، تحلیل ریسک، بهینهسازی زنجیره تأمین) نیازمند تحقیقات بیشتر است. با این حال، اصول پایه — تعاملات غیرخطی، کارایی پارامتری، و مقاومت در برابر بیشبرازش — در همه این حوزهها کاربرد دارند.
جمعبندی: از دندریت تا تصمیمگیری بهتر
در این بخش دیدیم که:
۱. دندریتها واحدهای محاسباتی غیرخطی هستند که میتوانند الگوهای خاصی از ورودیها را تشخیص دهند — قابلیتی که در نورونهای مصنوعی استاندارد غایب است.
۲. مدل دولایه نورون توضیح میدهد که چگونه یک نورون منفرد میتواند محاسباتی پیچیدهتر از یک واحد خطی ساده انجام دهد.
۳. چهار پیامد اصلی برای شبکههای عصبی مصنوعی وجود دارد: افزایش بیانپذیری، استفاده کارآمدتر از منابع، یادگیری مقاومتر، و توانایی یادگیری پیوسته.
۴. معماریهای الهامگرفته از دندریت مانند DENN، Dendritic ANN و DendSN نشان میدهند که این اصول را میتوان در عمل پیادهسازی کرد.
۵. چالشهایی مانند پیچیدگی محاسباتی، دشواری آموزش و عدم تطابق کامل با زیستشناسی وجود دارد که باید آگاهانه به آنها پرداخت.
پیام مدیریتی کلیدی: در مسائل تصمیمگیری پیچیده که در آنها تعاملات غیرخطی بین متغیرها نقش کلیدی ایفا میکند، معماریهای الهامگرفته از دندریت میتوانند دقت بالاتر، پارامتر کمتر و مقاومت بیشتر ارائه دهند. این معماریها بهویژه در شرایطی که دادههای آموزشی محدود هستند یا محیط در حال تغییر است، مزیت خود را نشان میدهند.
در بخش بعدی، به درس دوم میپردازیم: پلاستیسیتی چندمکانیزمی — یعنی چگونه مغز از چندین مکانیزم یادگیری همزمان استفاده میکند تا یادگیری پایدار و مقاوم ایجاد کند.
منابع این بخش
Acharya, J., Basu, A., Legenstein, R., Limbacher, T., Poirazi, P., & Wu, X. (2022). Dendritic computing: Branching deeper into machine learning. Neuroscience, 489, 262–274. https: //doi.org/10.1016/j.neuroscience.2021.10.022
Beniaguev, D., Segev, I., & London, M. (2021). Single cortical neurons as deep artificial neural networks. Neuron, 109(17), 2727–2739. https: //doi.org/10.1016/j.neuron.2021.07.002
Chavlis, S., & Poirazi, P. (2025). Dendrites endow artificial neural networks with accurate, robust and parameter-efficient learning. Nature Communications, 16, Article 56297. https: //doi.org/10.1038/s41467-025-56297-9
Huang, Y., Fang, W., Ma, Z., Li, G., & Tian, Y. (2024). Scalable dendritic modeling advances expressive and robust deep spiking neural networks. arXiv. https: //arxiv.org/abs/2412.06355
London, M., & Häusser, M. (2005). Dendritic computation. Annual Review of Neuroscience, 28, 503–532. https: //doi.org/10.1146/annurev.neuro.28.061604.135703
Pagkalos, M., Makarov, R., & Poirazi, P. (2023). Introducing the Dendrify framework for incorporating dendrites to spiking neural networks. Nature Communications, 14, Article 131. https: //doi.org/10.1038/s41467-022-35747-8
Pinitas, K., Chavlis, S., & Poirazi, P. (2021). Dendritic self-organizing maps for continual learning. arXiv. https: //arxiv.org/abs/2110.13611
Poirazi, P., Brannon, T., & Mel, B. W. (2003). Pyramidal neuron as two-layer neural network. Neuron, 37(6), 989–999. https: //doi.org/10.1016/S0896-6273(03)00149-1
Silver, R. A. (2010). Neuronal arithmetic. Nature Reviews Neuroscience, 11(7), 474–489. https: //doi.org/10.1038/nrn2864
Wu, X., Liu, X., Li, W., & Wu, Q. (2018). Improved expressivity through dendritic neural networks. Advances in Neural Information Processing Systems, 31, 8057–8068.
۴.۳ درس ۲ — پلاستیسیتی چندمکانیزمی
۴.۳.۰ چرا یک مکانیزم یادگیری کافی نیست؟
در بخش قبل دیدیم که دندریتها چگونه بهعنوان واحدهای محاسباتی غیرخطی عمل میکنند. اما پرسش مهمتری مطرح است: وقتی دندریتها سیگنالها را پردازش کردند، چگونه وزن سیناپسها تغییر میکند؟ به بیان دیگر، مکانیزم یادگیری در مغز چیست؟
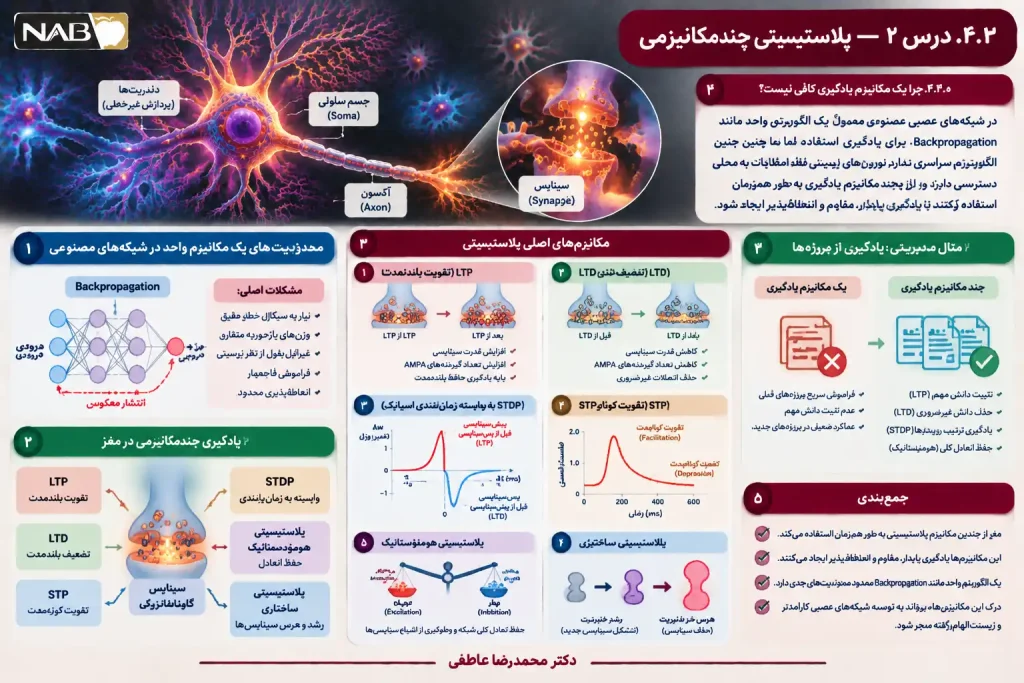
در شبکههای عصبی مصنوعی، پاسخ این پرسش معمولاً یک الگوریتم واحد است: Backpropagation. این الگوریتم از یک تابع خطا در خروجی شبکه شروع میکند، گرادیان آن را به عقب منتشر میکند و وزنها را در جهت کاهش خطا تغییر میدهد. اما مغز چنین الگوریتم سراسریای ندارد. همانطور که Lillicrap و همکاران (۲۰۲۰) نشان دادند، Backpropagation به اطلاعاتی نیاز دارد که در سیستم زیستی در دسترس نیست: سیگنالهای خطای دقیق و وزنهای بازخوردی متقارن (Symmetrical Feedback Weights). نورونهای زیستی فقط به اطلاعات محلی دسترسی دارند — آنها میدانند چه سیگنالی دریافت میکنند و چه سیگنالی ارسال میکنند، اما «خطای کلی شبکه» را نمیدانند.
این محدودیت، مغز را به سمت راهحل متفاوتی سوق داده است: استفاده همزمان از چندین مکانیزم یادگیری محلی. Lisman (۲۰۱۷) در مطالعهای جامع نشان داد که سیناپسهای گلوتاماترژیک حداقل شش شکل مختلف پلاستیسیتی را بهطور همزمان انجام میدهند: LTP، LTD، STP (تقویت کوتاهمدت)، مقیاسبندی سیناپسی، پلاستیسیتی هتروسیناپسی و پلاستیسیتی ساختاری. این مکانیزمها با هم تعامل دارند تا یادگیری پایدار، مقاوم و انعطافپذیر ایجاد کنند.
بیایید با یک مثال مدیریتی این اهمیت را روشن کنیم. تصور کنید یک شرکت مشاورهای میخواهد سیستمی طراحی کند که بهطور مستمر از پروژههای جدید یاد بگیرد. اگر این سیستم فقط از یک مکانیزم یادگیری استفاده کند — مثلاً فقط وزنها را برای پروژه جدید بهروزرسانی کند — پس از چند پروژه، دانش پروژههای قبلی کاملاً فراموش میشود (فراموشی فاجعهبار). اما یک سیستم با چند مکانیزم میتواند همزمان: وزنهای مهم را تثبیت کند (LTP)، وزنهای غیرضروری را تضعیف کند (LTD)، ترتیب زمانی رویدادها را یاد بگیرد (STDP)، و تعادل کلی شبکه را حفظ کند (پلاستیسیتی هومئوستاتیک).
در این بخش، به بررسی عمیق این مکانیزمها میپردازیم: LTP، LTD و STDP بهعنوان مکانیزمهای مکمل، پلاستیسیتی ساختاری، پلاستیسیتی هومئوستاتیک، و در نهایت، پیامدهای آنها برای یادگیری عمیق.
۴.۳.۱ LTP، LTD و STDP بهعنوان مکانیزمهای مکمل
LTP— تقویت اتصالات مرتبط
LTP— (Long-Term Potentiation تقویت بلندمدت) اولین بار در سال ۱۹۷۳ توسط Bliss و Lømo در هیپوکامپ خرگوش کشف شد. آنها نشان دادند که تحریک پرتکرار و پرفرکانس (High-Frequency Stimulation) یک مسیر عصبی، باعث افزایش پایدار در قدرت سیناپسهای آن مسیر میشود (Bliss & Lømo, 1973). این پدیده بعدها بهعنوان مکانیزم سلولی یادگیری و حافظه شناخته شد.
ایده ساده: وقتی دو نورون مکرراً با هم فعال میشوند، ارتباط بین آنها تقویت میشود. این همان اصل معروف «نورونهایی که با هم شلیک میکنند، با هم سیمکشی میشوند» (Neurons that fire together, wire together) است که توسط دونالد هب در سال ۱۹۴۹ پیشنهاد شد.
فرمول ساده LTP:
که در آن:
- Δwij— تغییر وزن سیناپس بین نورون i و نورون j
- η— نرخ یادگیری (Learning Rate)
- xi— فعالیت نورون پیشسیناپسی
- xj— فعالیت نورون پسسیناپسی
این فرمول ساده (که به قاعده هب معروف است) بیان میکند: اگر هر دو نورون همزمان فعال باشند، وزن سیناپس افزایش مییابد.
مکانیزم سلولی LTP: در سطح بیوشیمیایی، LTP از طریق گیرندههای NMDA عمل میکند. این گیرندهها کانالهای یونی هستند که فقط زمانی باز میشوند که دو شرط همزمان برقرار باشد: (۱) نورون پیشسیناپسی گلوتامات آزاد کند، و (۲) غشای پسسیناپسی بهاندازه کافی دپلاریزه شود. وقتی این دو شرط برقرار شود، یونهای کلسیم وارد نورون پسسیناپسی میشوند و آبشاری از واکنشهای بیوشیمیایی را فعال میکنند که در نهایت به افزایش تعداد گیرندههای AMPA در غشا و تقویت سیناپس منجر میشود (Lisman, 2017, p. 2).
مثال مدیریتی: فرض کنید یک تیم فروش بهطور مکرر در جلسات هفتگی دادههای فروش و بازخورد مشتریان را همزمان بررسی میکند. LTP باعث میشود که ارتباط بین این دو دسته اطلاعات در ذهن اعضای تیم تقویت شود. پس از چند هفته، آنها بهطور خودکار هنگام دیدن دادههای فروش، به بازخورد مشتریان فکر میکنند — این همان یادگیری است.
LTD— تضعیف و هرس اتصالات غیرضروری
LTD (Long-Term Depression —تضعیف بلندمدت) مکانیزم مخالف LTP است. اگر LTP سیناپسها را تقویت میکند، LTD آنها را تضعیف میکند. LTD معمولاً با تحریک کمفرکانس (Low-Frequency Stimulation، ۱ تا ۵ هرتز) القا میشود (EPFL, 2023).
چرا LTD مهم است؟ اگر فقط LTP وجود داشت، همه سیناپسها بهتدریج اشباع میشدند و شبکه دیگر نمیتوانست اطلاعات جدید را یاد بگیرد. LTD با تضعیف اتصالات غیرضروری، ظرفیت یادگیری را آزاد میکند و از بیشبرازش جلوگیری میکند.
مکانیزم سلولی LTD: برخلاف LTP که نیازمند افزایش سطح کلسیم است، LTD با افزایش متوسط و پایدار کلسیم القا میشود. این سطح متوسط کلسیم، فسفاتازها (مانند Calcineurin) را فعال میکند که برخلاف کینازها (در LTP)، باعث کاهش تعداد گیرندههای AMPA در غشا میشوند (Lisman, 2017, p. 3).
مثال مدیریتی: یک شرکت مشاورهای پس از چند سال متوجه میشود که برخی از روشهای قدیمی دیگر کارآمد نیستند. LTD در اینجا بهعنوان هرس شناختی عمل میکند: اتصالات مربوط به روشهای قدیمی تضعیف میشوند تا فضای ذهنی برای یادگیری روشهای جدید آزاد شود.
STDP— دقت زمانی در یادگیری
STDP (Spike-Timing-Dependent Plasticity— پلاستیسیتی وابسته به زمانبندی اسپایک)پیشرفتهترین شکل پلاستیسیتی هبی است. در STDP، ترتیب زمانی شلیکهای پیشسیناپسی و پسسیناپسی تعیین میکند که سیناپس تقویت شود یا تضعیف.
قاعده STDP:
که در آن:
- Δt=tpost−tpre— اختلاف زمان بین شلیک پسسیناپسی و پیشسیناپسی
- A+ و —A− — دامنه تقویت و تضعیف
- τ+ و —τ− — ثابتهای زمانی (معمولاً ۱۰ تا ۲۰ میلیثانیه)
تفسیر شهودی: اگر نورون پیشسیناپسی چند میلیثانیه قبل از نورون پسسیناپسی شلیک کند، سیناپس تقویت میشود (LTP). اگر ترتیب برعکس باشد — یعنی نورون پسسیناپسی اول شلیک کند و نورون پیشسیناپسی بعد — سیناپس تضعیف میشود (LTD) (Gerstner et al., 2010; EPFL, 2023).
چرا STDP مهم است؟ STDP به نورون امکان میدهد روابط علّی را یاد بگیرد. اگر رویداد A قبل از رویداد B اتفاق بیفتد، و این الگو مکرراً تکرار شود، نورون یاد میگیرد که A علت B است. این قابلیت در شبکههای مصنوعی استاندارد غایب است، زیرا آنها ترتیب زمانی ورودیها را نادیده میگیرند.
مثال مدیریتی: فرض کنید یک سیستم تشخیص تقلب در تراکنشهای بانکی طراحی میکنید. الگوی معمول تقلب این است: ابتدا یک تراکنش کوچک (برای تست کارت) انجام میشود، و چند دقیقه بعد یک تراکنش بزرگ. STDP این الگو را یاد میگیرد: «اگر تراکنش کوچک قبل از تراکنش بزرگ باشد، احتمال تقلب بالاست.» یک شبکه مصنوعی استاندارد نمیتواند این رابطه علّی زمانی را بهسادگی یاد بگیرد، زیرا ترتیب زمانی را نادیده میگیرد.
مکمل بودن LTP، LTD و STDP
نکته کلیدی این است که این سه مکانیزم مکمل یکدیگر هستند، نه رقیب. جدول زیر نقش هر یک را خلاصه میکند:
| مکانیزم | محرک اصلی | اثر | نقش در یادگیری |
| LTP | تحریک پرفرکانس | تقویت سیناپس | یادگیری الگوهای مهم |
| LTD | تحریک کمفرکانس | تضعیف سیناپس | حذف اطلاعات غیرضروری |
| STDP | ترتیب زمانی شلیک | تقویت یا تضعیف وابسته به زمان | یادگیری روابط علّی |
همانطور که Bailey و Kandel (۲۰۰۰)نشان دادند، مکانیزمهای هبی (مانند LTP و STDP) عمدتاً برای یادگیری و حافظه کوتاهمدت استفاده میشوند، اما بهتنهایی نمیتوانند حافظه بلندمدت را حفظ کنند. در مقابل، مکانیزمهای هتروسیناپسی (مانند LTD ناشی از ورودیهای تنظیمی) مکانیزمهای حافظه بلندمدت را فراخوانی میکنند که به رونویسی و رشد سیناپسی منجر میشود. وقتی این دو دسته مکانیزم همزمان فراخوانی شوند، یادگیری بهطور مؤثر تثبیت میشود و حافظه حفظ میگردد.
۴.۳.۲ پلاستیسیتی ساختاری (Structural Plasticity)
رشد و هرس خارهای دندریتی
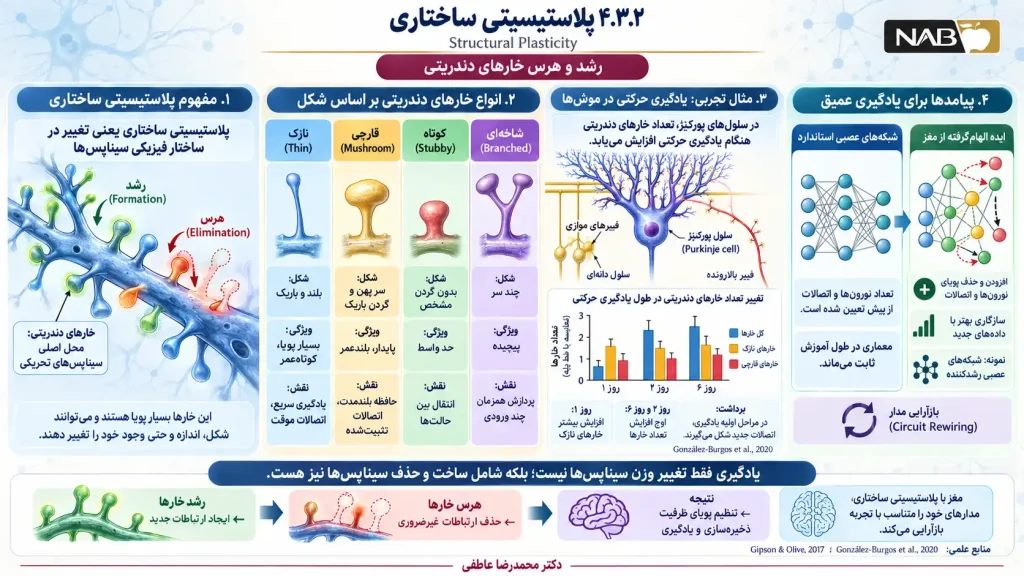
تا اینجا درباره تغییر قدرت سیناپسهای موجود صحبت کردیم. اما مغز فراتر از این میرود: ساختار فیزیکی سیناپسها نیز تغییر میکند. این پدیده که به پلاستیسیتی ساختاری (Structural Plasticity) معروف است، شامل رشد (Formation) و هرس (Elimination) خارهای دندریتی (Dendritic Spines) است.
خارهای دندریتی برجستگیهای کوچکی روی دندریتها هستند که محل اصلی سیناپسهای تحریکی در مغز محسوب میشوند (Gipson & Olive, 2017, p. 101). این خارها بسیار پویا هستند: در عرض چند دقیقه میتوانند شکل، اندازه و حتی وجود خود را تغییر دهند (Gipson & Olive, 2017, p. 101).
انواع خارها بر اساس شکل:
| نوع خار | شکل | ویژگی | نقش |
| نازک (Thin) | بلند و باریک | بسیار پویا، کوتاهعمر | یادگیری سریع، اتصالات موقت |
| قارچی (Mushroom) | سر پهن و گردن باریک | پایدار، بلندعمر | حافظه بلندمدت، اتصالات تثبیتشده |
| کوتاه (Stubby) | بدون گردن مشخص | حد واسط | انتقال بین حالتها |
| شاخهای (Branched) | چند سر | پیچیده | پردازش همزمان چند ورودی |
- مثال تجربی: مطالعهای در سال ۲۰۲۰ نشان داد که در جریان یادگیری حرکتی در موشها، تعداد خارهای دندریتی در سلولهای پورکنژ (نورونهای اصلی مخچه) بهطور قابلتوجهی افزایش مییابد. این افزایش در روز ۲ و روز ۶ یادگیری اوج میگیرد، و بهویژه خارهای نازک در روز اول بیشتر میشوند — که نشاندهنده شکلگیری اتصالات جدید در مراحل اولیه یادگیری است (González-Burgos et al., 2020).
- تفسیر: این یافته نشان میدهد که یادگیری فقط تغییر وزن سیناپسهای موجود نیست، بلکه شامل ساخت سیناپسهای جدید و حذف سیناپسهای غیرضروری نیز میشود. این فرآیند بازآرایی مدار (Circuit Rewiring) نام دارد و به مغز امکان میدهد ظرفیت ذخیرهسازی خود را بهطور پویا تنظیم کند (Gipson & Olive, 2017, p. 101).
پیامدهای برای یادگیری عمیق
شبکههای عصبی مصنوعی استاندارد معماری ثابت دارند: تعداد نورونها و اتصالات از قبل تعیین شده است و در طول آموزش تغییر نمیکند. در مقابل، مغز از پلاستیسیتی ساختاری برای افزودن نورونها و اتصالات جدید در پاسخ به یادگیری استفاده میکند.
ایده برای معماریهای مصنوعی: اگر شبکههای عصبی مصنوعی بتوانند بهطور پویا نورونها و اتصالات جدید اضافه کنند، میتوانند با دادههای جدید بهتر سازگار شوند. این ایده در معماریهایی مانند شبکههای عصبی رشدکننده (Growing Neural Networks) پیادهسازی شده است، اما هنوز فاصله زیادی با کارایی مغز دارد.
۴.۳.۳ پلاستیسیتی هومئوستاتیک
حفظ تعادل تحریک و مهار
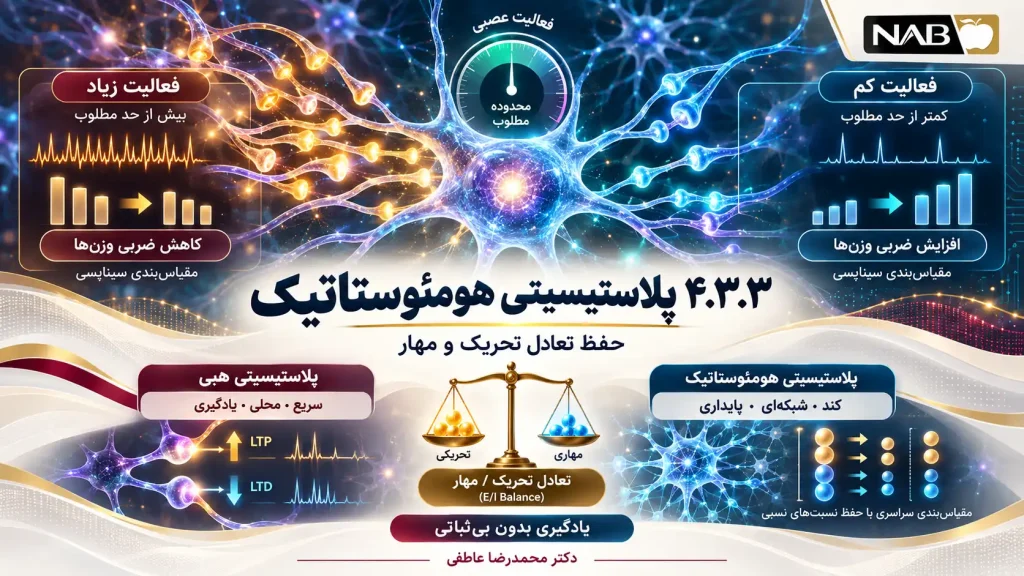
تا اینجا درباره مکانیزمهایی صحبت کردیم که قدرت سیناپسها را تغییر میدهند. اما اگر این تغییرات کنترلنشده باشند، چه اتفاقی میافتد؟ اگر LTP بیوقفه ادامه یابد، سیناپسها اشباع میشوند. اگر LTD بیوقفه ادامه یابد، سیناپسها نابود میشوند. مغز چگونه از این بیثباتی جلوگیری میکند؟
پاسخ: پلاستیسیتی هومئوستاتیک (Homeostatic Plasticity). این مکانیزم کندتر از LTP و LTD عمل میکند (از چند ساعت تا چند روز) و هدف آن حفظ فعالیت کلی نورون در یک محدوده پایدار است (Turrigiano & Nelson, 2004). به بیان دیگر، پلاستیسیتی هومئوستاتیک مانند یک ترموستات عمل میکند: اگر فعالیت نورون بیش از حد بالا رود، آن را کاهش میدهد؛ اگر بیش از حد پایین بیاید، آن را افزایش میدهد.
- مکانیزم اصلی: مقیاسبندی سیناپسی (Synaptic Scaling). اگر یک نورون برای مدت طولانی فعالیت بیش از حد داشته باشد، پلاستیسیتی هومئوستاتیک همه وزنهای سیناپسی آن را بهطور ضربی کاهش میدهد — بدون تغییر نسبت بین آنها. برعکس، اگر فعالیت نورون بیش از حد کم باشد، همه وزنها بهطور ضربی افزایش مییابند (Lisman, 2017, p. 4).
- چرا این مهم است؟ مقیاسبندی سیناپسی اطلاعات ذخیرهشده در نسبت وزنها را حفظ میکند، در حالی که فعالیت کلی را در محدوده عملکردی نگه میدارد. به بیان ساده، پلاستیسیتی هومئوستاتیک حافظه را حفظ میکند در حالی که از اشباع جلوگیری میکند.
- تعادل تحریک-مهار (E/I Balance): پلاستیسیتی هومئوستاتیک نه فقط فعالیت کلی نورون، بلکه تعادل بین ورودیهای تحریکی و مهارکننده را نیز حفظ میکند. همانطور که Chen و Li (۲۰۲۲) نشان دادند، این تعادل برای عملکرد طبیعی شبکه عصبی حیاتی است. اگر تعادل E/I بههم بریزد، نورونها ممکن است بیشفعال شوند (منجر به صرع) یا کمفعال شوند (منجر به از دست دادن عملکرد).
- مثال مدیریتی: فرض کنید یک تیم تحلیل داده دارید که هم دادههای کیفی (مصاحبه با مشتریان) و هم دادههای کمی (فروش، سود) را تحلیل میکند. اگر تیم بیش از حد به دادههای کمی توجه کند، تصویر کاملی از وضعیت بازار بهدست نمیآورد. اگر بیش از حد به دادههای کیفی توجه کند، ممکن است تعمیمپذیری تحلیل کاهش یابد. پلاستیسیتی هومئوستاتیک در اینجا بهعنوان مکانیزم تعادل عمل میکند: هر دو نوع داده را در نسبت مناسب نگه میدارد تا تصمیمگیری بهینه باشد.
رابطه بین پلاستیسیتی هبی و هومئوستاتیک
یک نکته ظریف: پلاستیسیتی هبی (LTP/LTD/STDP) و پلاستیسیتی هومئوستاتیک متناقض به نظر میرسند. هبی میخواهد تغییر ایجاد کند؛ هومئوستاتیک میخواهد ثبات حفظ کند. اما این تناقض ظاهری است. همانطور که Lisman (۲۰۱۷) توضیح میدهد، این دو مکانیزم در سطوح زمانی و مکانی متفاوت عمل میکنند: پلاستیسیتی هبی سریع (میلیثانیه تا دقیقه) است، در حالی که هومئوستاتیک کند (ساعت تا روز) است. همچنین هبی محلی (در سطح سیناپس) است، در حالی که هومئوستاتیک شبکهای (در سطح نورون یا مدار) است.
این تفکیک زمانی و مکانی به مغز اجازه میدهد هم یاد بگیرد و هم پایدار بماند.
۴.۳.۴ پیامدهای برای یادگیری عمیق
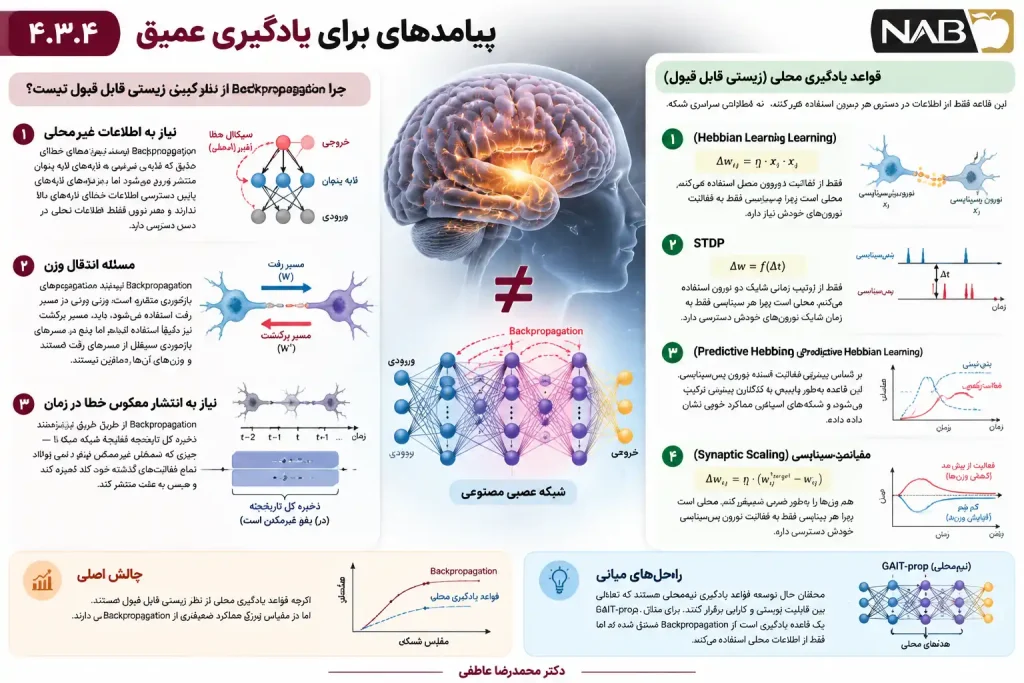
چرا Backpropagation از نظر زیستی قابل قبول نیست
حالا که مکانیزمهای پلاستیسیتی مغز را بررسی کردیم، بیایید به این پرسش بپردازیم: چرا Backpropagation — الگوریتم اصلی یادگیری در شبکههای عصبی مصنوعی — از نظر زیستی قابل قبول نیست؟
- دلیل اول: نیاز به اطلاعات غیرمحلی. Backpropagation نیازمند سیگنال خطای دقیق است که از لایه خروجی به لایههای پنهان منتشر میشود. اما در مغز، نورونهای لایههای پایین دسترسی به اطلاعات خطای لایههای بالا ندارند. هر نورون فقط اطلاعات محلی در دسترس دارد: چه سیگنالی دریافت میکند و چه سیگنالی ارسال میکند (Lillicrap et al., 2020).
- دلیل دوم: مسئله انتقال وزن (Weight Transport Problem). Backpropagation نیازمند وزنهای بازخوردی متقارن است: وزنی که در مسیر رفت استفاده میشود، باید در مسیر برگشت نیز دقیقاً استفاده شود. اما در مغز، مسیرهای بازخوردی مستقل از مسیرهای رفت هستند و وزنهای آنها متقارن نیستند (Lillicrap et al., 2020).
- دلیل سوم: نیاز به انتشار معکوس خطا در زمان. Backpropagation از طریق زمان (Backpropagation Through Time) نیازمند ذخیره کل تاریخچه فعالیت شبکه است — چیزی که در مغز غیرممکن است. مغز نمیتواند تمام فعالیتهای گذشته خود را ذخیره کند و سپس به عقب منتشر کند (Baldi & Sadowski, 2016).
نیاز به قواعد یادگیری محلی
این محدودیتها انگیزهای برای توسعه قواعد یادگیری محلی (Local Learning Rules) شده است. قواعد یادگیری محلی فقط از اطلاعات در دسترس هر نورون استفاده میکنند — نه اطلاعات سراسری شبکه. نمونههایی از این قواعد:
۱. قاعده هب (Hebbian Learning): فقط از فعالیت دو نورون متصل استفاده میکند. محلی است زیرا هر سیناپس فقط به فعالیت نورونهای خودش نیاز دارد.
۲. STDP: فقط از ترتیب زمانی شلیک دو نورون استفاده میکند. محلی است زیرا هر سیناپس فقط به زمان شلیک نورونهای خودش دسترسی دارد.
۳. یادگیری هب پیشبین (Predictive Hebbian Learning): بر اساس پیشبینی فعالیت آینده نورون پسسیناپسی. این قاعده بهطور طبیعی با کدگذاری پیشبین (Predictive Coding) ترکیب میشود و در شبکههای اسپایکی عملکرد خوبی نشان داده است.
۴. مقیاسبندی سیناپسی: همه وزنها را بهطور ضربی تنظیم میکند. محلی است زیرا هر سیناپس فقط به فعالیت نورون پسسیناپسی خودش دسترسی دارد.
چالش اصلی: اگرچه قواعد یادگیری محلی از نظر زیستی قابل قبول هستند، اما در مقیاس بزرگ عملکرد ضعیفتری از Backpropagation دارند. همانطور که Illing و همکاران (۲۰۲۱) نشان دادند، «هیچ مجموعهای از قواعد یادگیری کاملاً محلی، همراه با معماریهای مناسب، تاکنون نتوانسته است به مقیاس شبکههای بزرگ و وظایف پیچیدهای که برای هوش بیولوژیکی یا یادگیری ماشین پیشرفته لازم است، دست یابد». این چالش، یکی از مسائل باز در یادگیری عمیق است.
راهحلهای میانی: محققان در حال توسعه قواعد یادگیری نیمهمحلی هستند که تعادلی بین قابلیت زیستی و کارایی برقرار میکنند. برای مثال، GAIT-prop (Gradient-based And Iterative Target Propagation) یک قاعده یادگیری است که از Backpropagation مشتق شده اما فقط از اطلاعات محلی استفاده میکند (Ahmad et al., 2020). این قاعده در شبکههای عمیق عملکرد نزدیک به Backpropagation دارد، در حالی که از نظر زیستی قابل قبولتر است.
جمعبندی: از مکانیزمهای زیستی تا یادگیری پایدار
در این بخش دیدیم که:
۱. مغز از چندین مکانیزم یادگیری همزمان استفاده میکند — نه فقط یک الگوریتم سراسری. LTP، LTD، STDP، پلاستیسیتی ساختاری و پلاستیسیتی هومئوستاتیک مکمل یکدیگر هستند.
۲. LTP و LTD بهعنوان مکانیزمهای تقویت و تضعیف عمل میکنند: LTP اتصالات مرتبط را تقویت میکند، LTD اتصالات غیرضروری را هرس میکند.
۳. STDP به نورون امکان میدهد روابط علّی را از طریق ترتیب زمانی شلیکها یاد بگیرد — قابلیتی که در شبکههای مصنوعی استاندارد غایب است.
۴. پلاستیسیتی ساختاری شامل رشد و هرس خارهای دندریتی است و به مغز امکان میدهد ظرفیت ذخیرهسازی خود را بهطور پویا تنظیم کند.
۵. پلاستیسیتی هومئوستاتیک بهعنوان ترموستات عمل میکند: فعالیت کلی نورون را در محدوده پایدار نگه میدارد و از اشباع یا نابودی سیناپسها جلوگیری میکند.
۶. Backpropagation از نظر زیستی قابل قبول نیست زیرا نیازمند اطلاعات غیرمحلی، وزنهای متقارن و ذخیره تاریخچه کامل است — هیچکدام از اینها در مغز غایب هستند.
۷. قواعد یادگیری محلی از نظر زیستی قابل قبولتر هستند، اما در مقیاس بزرگ با چالشهای کارایی مواجهند.
پیام مدیریتی کلیدی: در مسائلی که نیازمند یادگیری مستمر و انطباق با محیطهای متغیر هستند — مانند پیشبینی تقاضا در بازارهای پویا، تشخیص تقلب در تراکنشهای در حال تکامل، یا مدیریت زنجیره تأمین در شرایط بحرانی — مکانیزمهای یادگیری چندگانه میتوانند پایداری و انعطافپذیری را همزمان فراهم کنند. مدلهای فعلی یادگیری عمیق عمدتاً بر یک مکانیزم واحد (Backpropagation) تکیه میکنند و بنابراین در مواجهه با تغییرات تدریجی یا وظایف متوالی آسیبپذیرند. درک مکانیزمهای زیستی — از LTP و LTD تا پلاستیسیتی هومئوستاتیک — میتواند الهامبخش معماریهای نسل بعدی باشد که هم پایدار و هم انعطافپذیر هستند.
در بخش بعدی، به درس سوم میپردازیم: کدگذاری و دینامیک زمانی — یعنی چگونه اطلاعات در زمان شلیک رمزگذاری میشود، نه فقط در نرخ آن، و چگونه شبکههای عصبی اسپایکی (SNN) این اصل را پیادهسازی میکنند.
منابع این بخش
Ahmad, N., van Gerven, M. A. J., & Ambrogioni, L. (2020). GAIT-prop: A biologically plausible learning rule derived from backpropagation of error. Advances in Neural Information Processing Systems, 33, 11261–11271.
Bailey, C. H., & Kandel, E. R. (2000). Is heterosynaptic modulation essential for stabilizing Hebbian plasticity and memory? Nature Reviews Neuroscience, 1(1), 11–20. https: //doi.org/10.1038/35036191
Baldi, P., & Sadowski, P. (2016). A theory of local learning, the learning channel, and the optimality of backpropagation. Neural Networks, 83, 51–74. https: //doi.org/10.1016/j.neunet.2016.07.006
Bliss, T. V. P., & Lømo, T. (1973). Long-lasting potentiation of synaptic transmission in the dentate area of the anaesthetized rabbit following stimulation of the perforant path. The Journal of Physiology, 232(2), 331–356. https: //doi.org/10.1113/jphysiol.1973.sp010273
Chen, L., & Li, X. (2022). Homeostatic plasticity and excitation-inhibition balance: The good, the bad, and the ugly. Current Opinion in Neurobiology, 75, 102553. https: //doi.org/10.1016/j.conb.2022.102553
EPFL. (2023). Synaptic plasticity: Mechanisms and functions [Lecture notes]. Graph Search. https: //graphsearch.epfl.ch/en/lecture/0_koqo6p20
Gerstner, W., Ritz, R., & van Hemmen, J. L. (2010). Why spikes? Hebbian learning and retrieval of time-resolved excitation patterns. Biological Cybernetics, 103(5), 379–391. https: //doi.org/10.1007/s00422-010-0401-7
Gipson, C. D., & Olive, M. F. (2017). Structural and functional plasticity of dendritic spines – root or result of behavior? Genes, Brain and Behavior, 16(1), 101–117. https: //doi.org/10.1111/gbb.12324
González-Burgos, I., Velázquez-Zamora, D. A., & González-Tapia, D. C. (2020). Motor learning induces plastic changes in Purkinje cell dendritic spines in the rat cerebellum. Neurología (English Edition), 35(7), 451–459. https: //doi.org/10.1016/j.nrleng.2017.05.005
Illing, B., Ventura, J., Bellec, G., & Gerstner, W. (2021). Local plasticity rules can learn deep representations using self-supervised contrastive predictions. Advances in Neural Information Processing Systems, 34, 30365–30379.
Lillicrap, T. P., Santoro, A., Marris, L., Akerman, C. J., & Hinton, G. (2020). Backpropagation and the brain. Nature Reviews Neuroscience, 21(6), 335–346. https: //doi.org/10.1038/s41583-020-0277-3
Lisman, J. (2017). Glutamatergic synapses are structurally and biochemically complex because of multiple plasticity processes: Long-term potentiation, long-term depression, short-term potentiation and scaling. Philosophical Transactions of the Royal Society B: Biological Sciences, 372(1715), 20160260. https: //doi.org/10.1098/rstb.2016.0260
Turrigiano, G. G., & Nelson, S. B. (2004). Homeostatic plasticity in the developing nervous system. Nature Reviews Neuroscience, 5(2), 97–107. https: //doi.org/10.1038/nrn1327