۳.۱ ساختار کلی مغز: از نورون تا سیستم
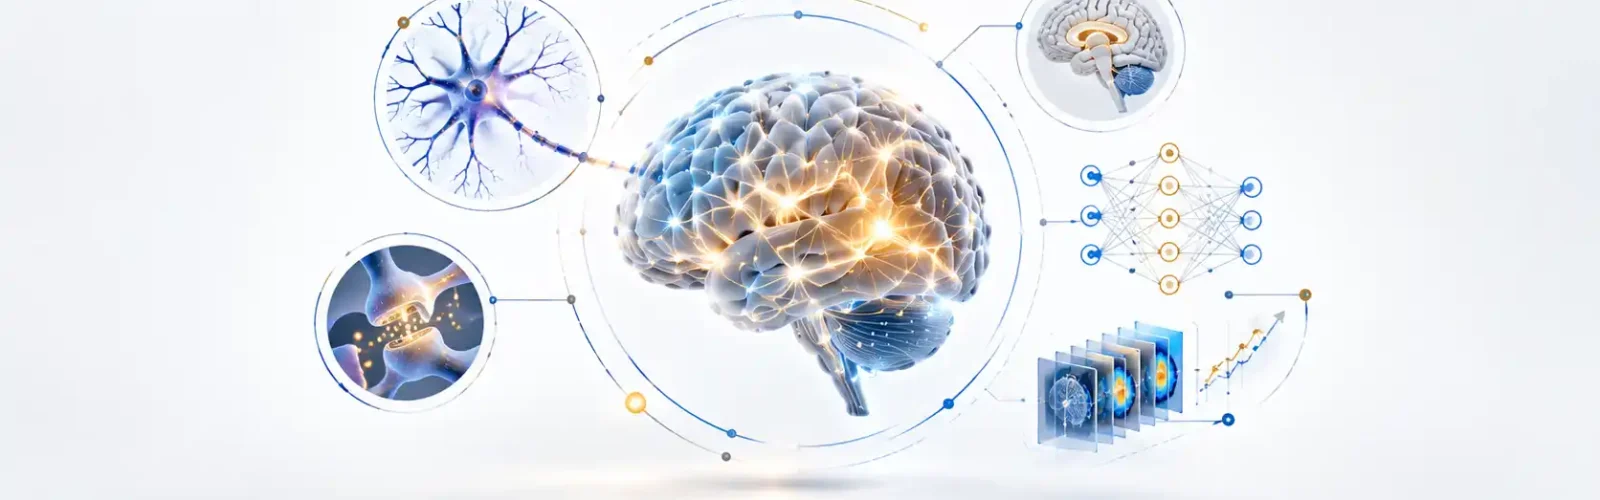
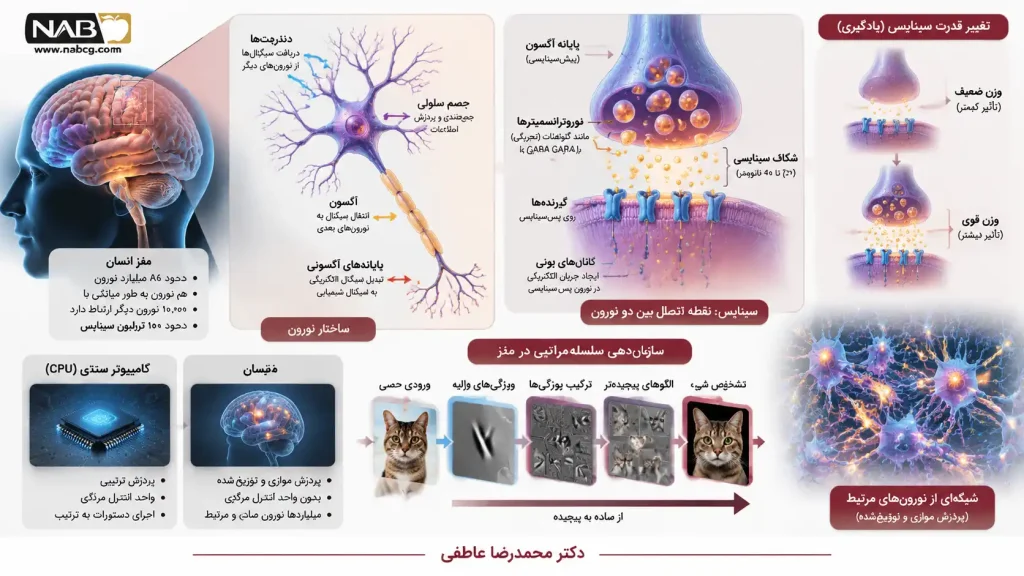
مسئله آغازین: فرض کنید مدیرعامل یک شرکت بزرگ هستید و از شما میپرسند: «چرا شبکههای عصبی مصنوعی اینقدر مؤثرند؟» پاسخ سطحی میتواند این باشد: «چون از مغز الهام گرفتهاند.» اما این پاسخ، شبیه این است که بگوییم «یک هواپیما پرواز میکند چون پرندگان پرواز میکنند.» حقیقت این است که مغز انسان، پیچیدهترین ساختار شناختهشده در جهان است: حدود ۸۶ میلیارد نورون که هر یک بهطور میانگین با ۱۰٬۰۰۰ نورون دیگر ارتباط دارند — یعنی حدود ۱۰۰ تریلیون سیناپس.
اگر بخواهیم این عدد را در قالب یک شبکه مصنوعی تصور کنیم، به فضایی نیاز داریم که میلیونها برابر بزرگتر از بزرگترین مدلهای امروزی است. پس چرا شبکههای مصنوعی — که در مقایسه با مغز، ذرهای در برابر کوه هستند — اینقدر مؤثر عمل میکنند؟ پاسخ این پرسش در فهم سازماندهی مغز نهفته است: مغز نه فقط از تعداد زیاد نورون، بلکه از اصول سازماندهی سلسلهمراتبی، پردازش موازی و توزیعشده، و یادگیری چندلایه بهره میبرد. در این بخش، به بررسی این اصول میپردازیم — نه بهعنوان یک درس عصبشناسی محض، بلکه بهعنوان راهنمایی برای درک عمیقتر معماری شبکههای عصبی مصنوعی و کاربردهای آنها در تصمیمگیری سازمانی.
۳.۱.۱ نورون، سیناپس، و شبکههای عصبی زیستی
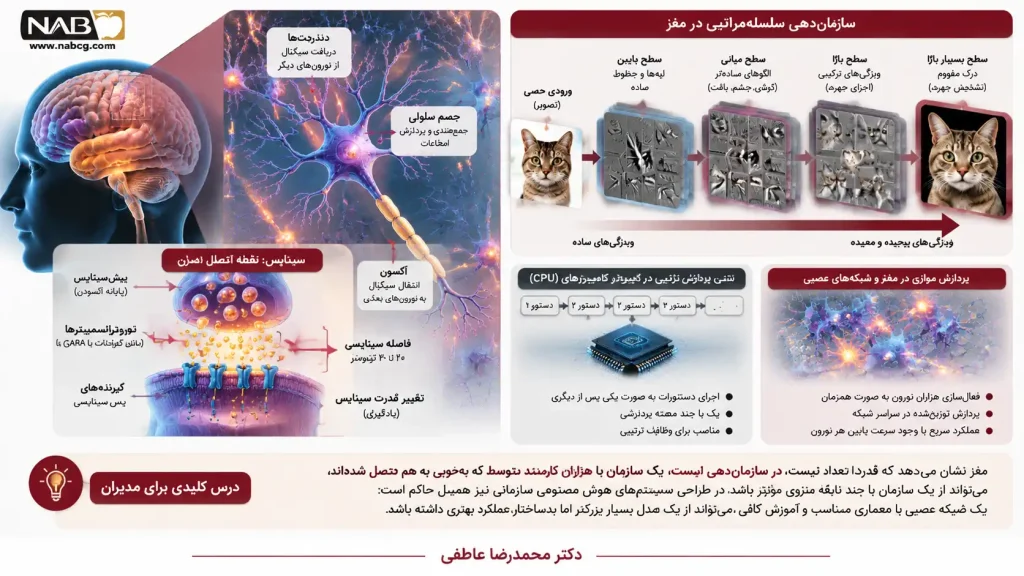
بگذارید با یک سؤال ساده شروع کنیم: اگر بخواهید یک کامپیوتر بسازید که مثل مغز کار کند، از کجا شروع میکنید؟ کامپیوترهای سنتی که امروز میشناسیم، بر پایه واحد پردازش مرکزی (CPU) ساخته شدهاند که دستورات را یکی پس از دیگری اجرا میکند. اما مغز، چنین ساختار مرکزیای ندارد. هیچ بخشی از مغز نیست که «همه چیز» را کنترل کند. در عوض، مغز از میلیاردها واحد ساده ساخته شده است که هر یک بهطور موازی و توزیعشده عمل میکنند. این تفاوت بنیادین، نه فقط یک جزئیات فنی، بلکه یک فلسفه طراحی متفاوت است که بعدها الهامبخش معماری شبکههای عصبی مصنوعی شد.
نورون: واحد محاسباتی مغز
نورون، سلول اصلی مغز است که مسئولیت دریافت، پردازش، و انتقال اطلاعات را بر عهده دارد. اما نورون، برخلاف تصور رایج، فقط یک «سیم» نیست. یک نورون سه بخش اصلی دارد:
دندریتها (Dendrites) که سیگنالها را از نورونهای دیگر دریافت میکنند. دندریتها ساختاری درختی دارند و سطح وسیعی را برای برقراری ارتباط با هزاران نورون فراهم میکنند. جسم سلولی (Soma) که سیگنالهای دریافتی را جمعبندی و پردازش میکند. این بخش، هسته سلول و ماشینآلات مولکولی لازم برای حیات سلول را در خود جای داده است. آکسون (Axon) که سیگنال خروجی را به نورونهای بعدی انتقال میدهد. آکسون میتواند بسیار بلند باشد — در برخی نورونهای حرکتی، طول آکسون به بیش از یک متر میرسد (مثلاً از نخاع تا انگشت پا). در انتهای آکسون، پایانههای آکسونی قرار دارند که سیگنال الکتریکی را به سیگنال شیمیایی تبدیل میکنند.
اگر بخواهیم این ساختار را با یک مثال مدیریتی مقایسه کنیم: یک نورون شبیه یک مدیر پروژه است. دندریتها، «ایمیلها و گزارشهایی» هستند که از بخشهای مختلف سازمان دریافت میکند. جسم سلولی، «مغز مدیر» است که این اطلاعات را تحلیل و جمعبندی میکند. و آکسون، «دستور و تصمیمی» است که مدیر به تیم خود ابلاغ میکند. اما نکته کلیدی این است که مدیر (نورون) بهتنهایی تصمیم نمیگیرد؛ او بخشی از یک شبکه سازمانی عظیم است که در آن هر مدیر با هزاران مدیر دیگر در ارتباط است.
سیناپس: نقطه اتصال
نقطهای که یک نورون به نورون دیگر متصل میشود، سیناپس نام دارد. سیناپس، فاصله کوچکی بین پایانه آکسون یک نورون (پیشسیناپسی) و دندریت نورون بعدی (پسسیناپسی) است — حدود ۲۰ تا ۴۰ نانومتر، یعنی حدود یکهزارم ضخامت موی انسان. وقتی یک سیگنال الکتریکی به پایانه آکسون میرسد، نوروترانسمیترها — مواد شیمیایی مانند گلوتامات (تحریکی) یا GABA (مهاری) — از پیشسیناپس آزاد میشوند و به گیرندههای روی پسسیناپس متصل میگردند. این اتصال، باعث باز شدن کانالهای یونی میشود که جریان الکتریکی ضعیفی در نورون پسسیناپسی ایجاد میکنند. اگر این جریان بهاندازه کافی قوی باشد، نورون پسسیناپسی شلیک میکند و سیگنال به نورونهای بعدی منتقل میشود.
نکته حیاتی در مورد سیناپسها این است که قدرت آنها ثابت نیست. هر سیناپس، یک وزن دارد که تعیین میکند آن سیگنال چقدر روی نورون پسسیناپسی تأثیر میگذارد. و این وزن، در طول زمان و بر اساس تجربه تغییر میکند — این همان چیزی است که یادگیری نامیده میشود. در شبکههای عصبی مصنوعی، این وزنها همان پارامترهایی هستند که در طول آموزش تنظیم میشوند.
مثال مدیریتی: شبکه ارتباطات سازمانی بهعنوان شبکه عصبی
یک سازمان با ۱۰۰ کارمند را تصور کنید. هر کارمند (نورون) با تعدادی از همکاران خود (نورونهای دیگر) ارتباط دارد. هر ارتباط (سیناپس) یک قدرت دارد: ارتباط قوی به معنای تبادل اطلاعات مکرر و مؤثر است؛ ارتباط ضعیف به معنای ارتباط نادر و کمتأثیر. اگر یک کارمند اطلاعاتی را از چند همکار دریافت کند (دندریتها)، آن را با دانش و تجربه خود ترکیب کند (جسم سلولی)، و سپس به همکاران دیگر منتقل کند (آکسون)، او دقیقاً نقش یک نورون را ایفا میکند.
حالا فرض کنید سازمان میخواهد یک تیم نوآوری تشکیل دهد. در یک سازمان سنتی، مدیرعامل تصمیم میگیرد که چه کسانی در تیم باشند. اما در یک سازمان شبکهای که از اصول مغز الهام گرفته، تیم نوآوری از خودسازماندهی شکل میگیرد: کارمندانی که بیشترین تعامل را با یکدیگر دارند و اطلاعات را بهطور مؤثر مبادله میکنند (سیناپسهای قوی)، بهطور طبیعی به یک خوشه تبدیل میشوند. این خوشه، دقیقاً مشابه یک مجموعه سلولی (Cell Assembly) در مغز است که هب آن را پیشنهاد کرد. نکته مهم این است که این خوشه، لزوماً از افرادی با بالاترین سمت سازمانی تشکیل نمیشود؛ بلکه از افرادی شکل میگیرد که الگوهای ارتباطی آنها با یکدیگر قویتر است.
شبکههای عصبی زیستی: از نورون تا سیستم
نورونها بهتنهایی کار نمیکنند. آنها بهصورت شبکههای پیچیده سازمان یافتهاند که در آنها، هر نورون به هزاران نورون دیگر متصل است. این شبکهها، سلسلهمراتبی هستند: نورونهای سطح پایین، اطلاعات سادهتری را پردازش میکنند (مثلاً لبههای یک تصویر)، و نورونهای سطح بالا، اطلاعات پیچیدهتری را (مثلاً تشخیص چهره یک شخص). این ساختار سلسلهمراتبی، یکی از اصول بنیادین سازماندهی مغز است که بعدها در معماری شبکههای عصبی عمیق (Deep Learning) بازتولید شد.
نکته دیگری که باید به آن توجه کنیم، پردازش موازی است. در مغز، برخلاف کامپیوترهای سنتی که دستورات را یکی پس از دیگری اجرا میکنند، هزاران نورون بهطور همزمان فعال میشوند. این پردازش موازی، مغز را قادر میسازد که با وجود سرعت پایین هر نورون (حدود ۱ میلیثانیه برای هر شلیک)، در کارهایی مانند تشخیص چهره یا درک زبان، بسیار سریع عمل کند. در شبکههای عصبی مصنوعی، این اصل به محاسبات موازی روی GPU ترجمه شده است — همان چیزی که در فصل ۲ دیدیم چگونه انقلاب یادگیری عمیق را ممکن ساخت.
درس کلیدی برای مدیران: مغز نشان میدهد که قدرت در تعداد نیست، در سازماندهی است. یک سازمان با هزاران کارمند متوسط که بهخوبی به هم متصل شدهاند، میتواند از یک سازمان با چند نابغه منزوی مؤثرتر باشد. در طراحی سیستمهای هوش مصنوعی سازمانی نیز همین اصل حاکم است: یک شبکه عصبی با معماری مناسب و آموزش کافی، میتواند از یک مدل بسیار بزرگتر اما بدساختار، عملکرد بهتری داشته باشد.
۳.۱.۲ قشر مغز و مناطق تخصصی
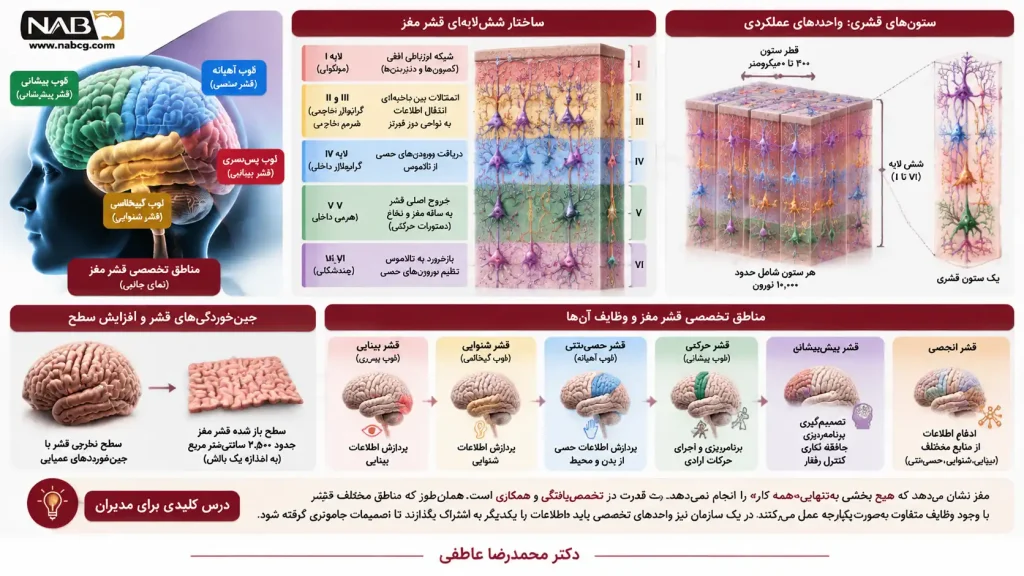
اگر مغز را یک سازمان عظیم در نظر بگیریم، قشر مغز (Cerebral Cortex) نقش «دفتر مرکزی» را ایفا میکند. قشر مغز، لایهای نازک — حدود ۴ میلیمتر ضخامت در انسان — است که سطح خارجی مغز را پوشانده است. اما این لایه نازک، حدود ۲۰ میلیارد نورون را در خود جای داده است — یعنی حدود یکچهارم کل نورونهای مغز. اگر قشر مغز را باز کنید و به سطح آن نگاه کنید، چینخوردگیهای عمیقی میبینید که سطح آن را بهشدت افزایش میدهند. اگر این چینخوردگیها را باز کنید، سطح قشر مغز حدود ۲٬۵۰۰ سانتیمتر مربع — به اندازه یک بالش — میشود.
ساختار ششلایهای قشر
قشر مغز، برخلاف ظاهر یکنواختش، ساختاری بسیار منظم دارد. از نظر بافتشناسی، قشر به شش لایه افقی تقسیم میشود که هر یک، انواع خاصی از نورونها و الگوهای اتصالی مخصوص به خود را دارند:
- لایه I (لایه مولکولی): نازکترین لایه، عمدتاً از آکسونها و دندریتهای نورونهای لایههای زیرین تشکیل شده است. این لایه، نقش «شبکه ارتباطی افقی» را ایفا میکند و اطلاعات را بین نواحی مختلف قشر توزیع میکند.
- لایه II و III (لایههای گرانولار خارجی و هرمی خارجی): این لایهها شامل نورونهای هرمی هستند که اتصالات بینناحیهای برقرار میکنند. آکسونهای این نورونها به نواحی دورتر قشر میروند و اطلاعات پردازششده را به آنها منتقل میکنند. این لایهها، مشابه «مدیران میانی» سازمان هستند که اطلاعات را بین بخشهای مختلف هماهنگ میکنند.
- لایه IV (لایه گرانولار داخلی): این لایه، ایستگاه دریافت ورودیهای حسی است. بیشتر ورودیهای قشر از تالاموس — مرکز پردازش و توزیع اطلاعات حسی مغز — به این لایه میرسند. اگر سازمان را در نظر بگیریم، لایه IV شبیه «بخش دریافت و ثبت اطلاعات» است که دادههای خام را از محیط بیرون دریافت میکند.
- لایه V (لایه هرمی داخلی): این لایه، خروجی اصلی قشر را تولید میکند. نورونهای هرمی بزرگ در این لایه، آکسونهای خود را به ساقه مغز و نخاع میفرستند و دستورات حرکتی را صادر میکنند. این لایه، مشابه «مدیران ارشد» سازمان است که تصمیمات نهایی را به اجرا میگذارند.
- لایه VI (لایه چندشکلی): این لایه، بازخورد به تالاموس را فراهم میکند. نورونهای این لایه، اطلاعاتی را به تالاموس میفرستند که به تنظیم ورودیهای حسی کمک میکند. این مکانیزم، مشابه یک سیستم کنترل کیفیت است که بررسی میکند آیا اطلاعات ورودی معتبر و مرتبط هستند یا خیر.
این ساختار ششلایه، یکی از شگفتانگیزترین ویژگیهای قشر مغز است: تقریباً تمام نواحی قشر، از قشر بینایی تا قشر شنوایی تا قشر حرکتی، این ساختار ششلایه را دارند. این یکنواختی ساختاری، نشان میدهد که مغز از یک الگوی پردازشی مشترک در سراسر قشر استفاده میکند — الگویی که بعدها الهامبخش ایده «ستونهای قشری» (Cortical Columns) شد.
ستونهای قشری: واحدهای عملکردی
در دهه ۱۹۵۰، ورنون مانتکاسل (Vernon Mountcastle)، عصبشناس آمریکایی، کشف کرد که نورونهای قشر، نه بهصورت تصادفی، بلکه در ستونهای عمودی سازمان یافتهاند. هر ستون، گروهی از نورونهاست که از لایه I تا VI امتداد دارند و به یک ویژگی خاص پاسخ میدهند. قطر هر ستون حدود ۳۰۰ تا ۵۰۰ میکرومتر است و شامل حدود ۱۰٬۰۰۰ نورون میشود.
مانتکاسل این ستونها را «واحدهای عملکردی» قشر نامید. ایده او این بود: قشر مغز از تکرار هزاران ستون مشابه ساخته شده است، که هر ستون یک «ماژول» پردازشی مستقل است. این ایده، انقلابی بود، زیرا نشان میداد که قشر — با وجود پیچیدگی ظاهریاش — از یک الگوی تکراری ساده تبعیت میکند. بعدها، این ایده در معماری شبکههای عصبی مصنوعی، بهویژه در شبکههای کانولوشنی (CNN)، بازتولید شد: در CNN، هر «فیلتر» (Filter) نقش مشابهی با یک ستون قشری ایفا میکند — یک ویژگی خاص (مثلاً یک لبه در جهت خاص) را در سراسر تصویر تشخیص میدهد.
مناطق تخصصی قشر
اگرچه ساختار ششلایه قشر در سراسر آن یکنواخت است، عملکرد نواحی مختلف قشر بسیار متفاوت است. قشر مغز به مناطق تخصصی تقسیم میشود که هر یک، مسئول پردازش نوع خاصی از اطلاعات است:
- قشر حسی (Sensory Cortex): شامل قشر بینایی (در لوب پسسری)، قشر شنوایی (در لوب گیجگاهی)، و قشر حسیتنی (در لوب آهیانه) است. این نواحی، اطلاعات حسی خام را از اندامهای حسی دریافت و پردازش میکنند.
- قشر حرکتی (Motor Cortex): در لوب پیشانی قرار دارد و مسئول برنامهریزی و اجرای حرکات ارادی است. نورونهای این ناحیه، دستورات حرکتی را به عضلات میفرستند.
- قشر پیشپیشانی (Prefrontal Cortex): پیشرفتهترین ناحیه قشر است و مسئول عملکردهای شناختی عالی مانند تصمیمگیری، برنامهریزی، حافظه کاری، و کنترل رفتار است. این ناحیه، مشابه «دفتر مدیرعامل» در سازمان است.
- قشر انجمنی (Association Cortex): نواحیای که بین مناطق حسی و حرکتی قرار دارند و مسئول ادغام اطلاعات از منابع مختلف هستند. برای مثال، قشر انجمنی تمپورال-پاریتال، اطلاعات بینایی، شنوایی، و حسیتنی را برای درک فضایی و توجه ترکیب میکند.
- این تخصصیافتگی، یکی از اصول بنیادین مغز است: پردازش توزیعشده و تخصصی. در شبکههای عصبی مصنوعی، این اصل به لایههای مخفی مختلف ترجمه شده است: لایههای اولیه، ویژگیهای ساده (لبهها، بافتها) را تشخیص میدهند، و لایههای عمیقتر، ویژگیهای پیچیدهتر (اجزای اشیاء، الگوهای کلان) را.
- درس کلیدی برای مدیران: تخصصیافتگی مناطق قشر، نشان میدهد که یک سازمان مؤثر، نیازمند تخصصهای مختلف است که با یکدیگر همکاری میکنند. هیچ بخشی از مغز نیست که «همه کار» را انجام دهد. به همین ترتیب، در یک سازمان، واحدهای تخصصی (مالی، بازاریابی، تولید، تحقیق و توسعه) باید اطلاعات را با یکدیگر به اشتراک بگذارند تا تصمیمات جامعتری گرفته شود. این اصل، در طراحی سیستمهای هوش مصنوعی سازمانی نیز حاکم است: یک مدل واحد که همه وظایف را انجام دهد، معمولاً از چند مدل تخصصی که خروجیهایشان ترکیب میشود، ضعیفتر عمل میکند.
۳.۱.۳ پردازش سیگنال در مغز: از پتانسیل استراحت تا پتانسیل عمل
تا اینجا دیدیم که مغز از نورونهایی ساخته شده که بهصورت شبکههای سلسلهمراتبی و تخصصی سازمان یافتهاند. اما یک پرسش بنیادین باقی میماند: این نورونها دقیقاً چگونه با یکدیگر «صحبت» میکنند؟ زبان مغز، زبان سیگنالهای الکتریکی است. در این بخش، به بررسی این زبان میپردازیم — از لحظهای که یک نورون در حالت استراحت است، تا لحظهای که شلیک میکند و سیگنال را به نورون بعدی منتقل میکند.
پتانسیل استراحت: حالت پایه نورون
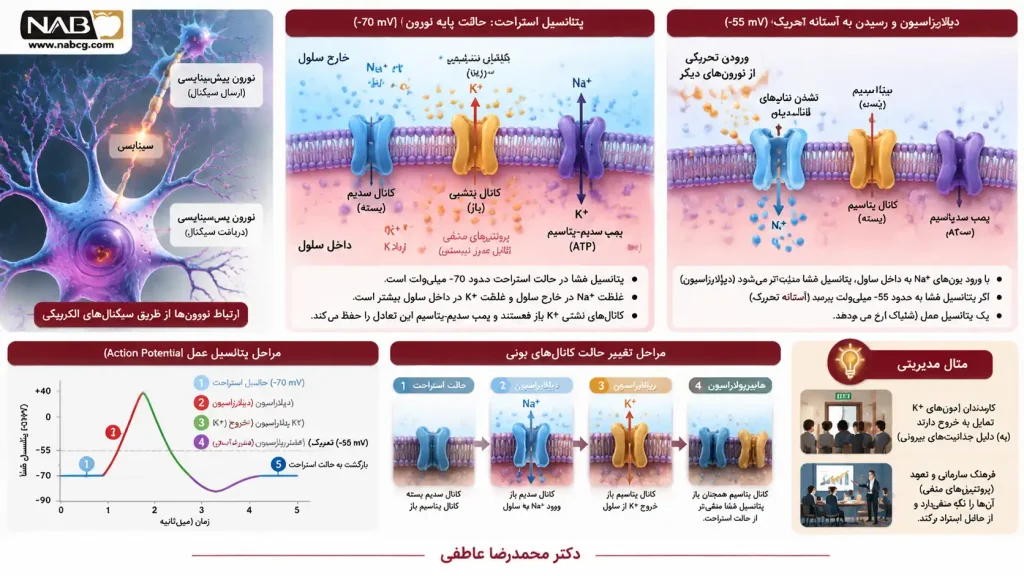
وقتی یک نورون فعال نیست، در حالت استراحت قرار دارد. در این حالت، پتانسیل غشا (Membrane Potential) — یعنی اختلاف پتانسیل الکتریکی بین داخل و خارج سلول — حدود ۷۰– میلیولت است. این بدان معناست که داخل سلول نسبت به خارج آن، بار منفیتری دارد. این اختلاف پتانسیل، چگونه ایجاد میشود؟
پاسخ در توزیع نامتقارن یونها در دو طرف غشا نهفته است. غشا سلول، شبیه یک سد نیمهنفوذپذیر است: به برخی یونها اجازه عبور میدهد و به برخی دیگر نه. در خارج سلول، غلظت یون سدیم (Na⁺) بالا است و در داخل سلول، غلظت یون پتاسیم (K⁺) بالا است. علاوه بر این، داخل سلول مولکولهای پروتئین با بار منفی وجود دارند که نمیتوانند از غشا عبور کنند.
در حالت استراحت، کانالهای نشتی پتاسیم باز هستند و یونهای K⁺ میتوانند از سلول خارج شوند. اما این خروج، به دلیل جاذبه الکتریکی پروتئینهای منفی داخل سلول، محدود میشود. در نتیجه، یک تعادل دینامیک برقرار میشود: یونهای K⁺ تمایل دارند خارج شوند (به دلیل گرادیان غلظت) اما جاذبه الکتریکی آنها را نگه میدارد. این تعادل، پتانسیل استراحت ۷۰- میلیولت را ایجاد میکند.
برای درک شهودی، یک مثال مدیریتی میزنیم: فرض کنید یک شرکت در حالت پایدار قرار دارد. کارمندان (یونهای K⁺) تمایل دارند شرکت را ترک کنند (به دلیل گرادیان غلظت، یعنی جذابیتهای بیرونی)، اما فرهنگ سازمانی و تعهد (جاذبه الکتریکی، یعنی پروتئینهای منفی) آنها را نگه میدارد. تعادل بین این دو نیرو، حالت پایه شرکت را تعیین میکند — نه خیلی پرانرژی، نه خیلی بیروح.
آستانه تحریک: نقطه تصمیم
حالا فرض کنید یک سیگنال تحریکی از نورونهای دیگر به این نورون میرسد. این سیگنال، باعث باز شدن کانالهای سدیم میشود و یونهای Na⁺ به داخل سلول سرازیر میشوند. این ورود یونهای مثبت، پتانسیل غشا را مثبتتر میکند — فرآیندی که دپلاریزاسیون نامیده میشود.
اگر دپلاریزاسیون بهاندازه کافی قوی باشد و پتانسیل غشا به آستانه تحریک — حدود ۵۵– میلیولت — برسد، آنگاه یک پتانسیل عمل (Action Potential) یا شلیک رخ میدهد. آستانه تحریک، دقیقاً شبیه نقطه تصمیمگیری در یک سازمان است: اگر مجموع شواهد ورودی بهاندازه کافی قوی باشد، تصمیم گرفته میشود؛ در غیر این صورت، هیچ اقدامی انجام نمیشود.
مثال مدیریتی: آستانه تحریک بهعنوان آستانه تصمیمگیری
فرض کنید یک مدیر فروش باید تصمیم بگیرد که آیا یک پیشنهاد تخفیف ویژه را به یک مشتری بزرگ ارائه دهد یا خیر. او چهار عامل را در نظر میگیرد: سابقه خرید مشتری (وزن ۳)، حجم سفارش فعلی (وزن ۲)، رقابت در بازار (وزن ۲)، و حاشیه سود (وزن ۱). اگر مجموع وزنی این عوامل از یک آستانه مشخص (مثلاً ۵) عبور کند، مدیر تخفیف را ارائه میدهد.
- اگر مشتری سابقه عالی (۱)، سفارش بزرگ (۱)، رقابت شدید (۱)، و حاشیه سود کم (۰) داشته باشد: مجموع = ۳+۲+۲+۰ = ۷ ≥ ۵ → تخفیف ارائه میشود.
- اگر مشتری سابقه ضعیف (۰)، سفارش کوچک (۰)، رقابت کم (۱)، و حاشیه سود بالا (۱) داشته باشد: مجموع = ۰+۰+۲+۱ = ۳ < ۵ → تخفیف ارائه نمیشود.
این دقیقاً همان منطق نورون مککالوک-پیتس است که در فصل ۲ بررسی کردیم. آستانه تحریک، قاعده تصمیمگیری نورون را تعریف میکند — دقیقاً همانطور که یک سازمان، آستانههای تصمیمگیری خود را تعریف میکند.
پتانسیل عمل: شلیک نورون
وقتی پتانسیل غشا به آستانه تحریک میرسد، کانالهای سدیم وابسته به ولتاژ باز میشوند. این کانالها، برخلاف کانالهای نشتی، بهصورت حساس به ولتاژ عمل میکنند: وقتی پتانسیل غشا به آستانه میرسد، باز میشوند و اجازه ورود انبوه Na⁺ را میدهند. این ورود، پتانسیل غشا را بهسرعت مثبتتر میکند — تا حدود ۴۰+ میلیولت (یعنی تغییر حدود ۱۱۰ میلیولتی).
این فرآیند، دپلاریزاسیون نامیده میشود و حدود ۱ تا ۲ میلیثانیه طول میکشد. پتانسیل عمل، یک پدیده «همه یا هیچ» است: اگر آستانه تحریک عبور کند، پتانسیل عمل همیشه با دامنه کامل رخ میدهد؛ اگر عبور نکند، هیچ پتانسیل عملی رخ نمیدهد. این ویژگی، مشابه تصمیمگیری سازمانی است: یک تصمیم یا گرفته میشود یا نه — نمیتوان «نیمهتصمیم» گرفت.
پس از دپلاریزاسیون، کانالهای پتاسیم وابسته به ولتاژ باز میشوند. این کانالها، کندتر از کانالهای سدیم عمل میکنند، اما وقتی باز شوند، یونهای K⁺ به خارج سلول سرازیر میشوند و پتانسیل غشا را به حالت منفی برمیگردانند — فرآیندی که رپلاریزاسیون نامیده میشود. در واقع، باز شدن کانالهای پتاسیم، یک حلقه بازخورد منفی ایجاد میکند که غشا را به حالت استراحت بازمیگرداند. این بازخورد منفی، مشابه مکانیزمهای کنترل کیفیت در سازمان است که پس از یک تصمیم بزرگ، سیستم را به حالت تعادل بازمیگردانند.
پس از رپلاریزاسیون، یک دوره هایپرپلاریزاسیون رخ میدهد که در آن، پتانسیل غشا کمی منفیتر از حالت استراحت میشود (حدود ۸۰- میلیولت). این دوره، دوره مقاوم (Refractory Period) نامیده میشود و حدود ۱۰ میلیثانیه طول میکشد. در این دوره، نورون نمیتواند پتانسیل عمل جدیدی تولید کند. این مکانیزم، از شلیکهای پیاپی و بیوقفه جلوگیری میکند و به نورون اجازه میدهد که بازیابی شود. در سازمان، این مشابه دوره سکون پس از یک تصمیم بزرگ است: پس از یک تصمیم استراتژیک مهم، سازمان نیاز به زمان دارد تا منابع خود را بازسازی کند و برای تصمیم بعدی آماده شود.
مثال مدیریتی: مقایسه پتانسیل عمل با یک تصمیم سازمانی بزرگ
فرض کنید یک شرکت تولیدی با بحران کاهش تقاضا مواجه است. مدیرعامل جلسهای اضطراری تشکیل میدهد و از مدیران میخواهد که شواهد را ارائه دهند:
- مدیر فروش: کاهش ۳۰٪ فروش در سه ماه گذشته (دپلاریزاسیون قوی).
- مدیر مالی: کاهش سود و افزایش بدهی (دپلاریزاسیون متوسط).
- مدیر تولید: ظرفیت خالی کارخانه (دپلاریزاسیون متوسط).
- مدیر منابع انسانی: نگرانی کارکنان از اخراج (دپلاریزاسیون ضعیف).
مجموع شواهد از آستانه تصمیمگیری عبور میکند. مدیرعامل تصمیم میگیرد: «خط تولید محصول X متوقف شود و منابع به محصول Y منتقل شود.» این تصمیم، پتانسیل عمل سازمان است: یک اقدام قاطع، با دامنه کامل، که مسیر سازمان را تغییر میدهد.
پس از اجرای تصمیم، سازمان وارد دوره مقاوم میشود: مدیران و کارکنان نیاز به زمان دارند تا با تغییرات سازگار شوند. در این دوره، تصمیمهای بزرگ جدید به تعویق میافتند تا سازمان بازیابی شود. اگر سازمان در این دوره تصمیم بزرگ دیگری بگیرد، ممکن است با فرسودگی و سردرگمی مواجه شود.
هدایت نمکی: افزایش سرعت انتقال
پتانسیل عمل، در امتداد آکسون منتشر میشود — دقیقاً مشابه موجی که در یک طناب منتشر میشود. اما این انتشار، در آکسونهای بدون میلین، کند است (حدود ۱ متر بر ثانیه). برای افزایش سرعت، بسیاری از آکسونها با میلین پوشیده شدهاند — لایهای چربی که مانند عایق سیم برق عمل میکند. در آکسونهای میلیندار، پتانسیل عمل بهصورت پرشی (Saltatory Conduction) منتشر میشود: از یک گره رانویه (Node of Ranvier) به گره بعدی میپرد و بخشهای میلیندار را «رد میکند». این مکانیزم، سرعت انتقال را تا ۱۰۰ متر بر ثانیه یا بیشتر افزایش میدهد.
برای درک اهمیت این سرعت، یک مثال مدیریتی میزنیم: فرض کنید دو سازمان دارید. در سازمان اول، هر تصمیم باید از طریق زنجیره فرماندهی سنتی (مدیرعامل → معاون → مدیر → سرپرست → کارمند) منتقل شود. این فرآیند، کند است و ممکن است روزها طول بکشد. در سازمان دوم، شبکههای ارتباطی مستقیم بین واحدهای مختلف وجود دارد (مثلاً کارمند میتواند مستقیماً با مدیرعامل ارتباط برقرار کند). این فرآیند، سریع است و ممکن است ساعتها طول بکشد. میلین، دقیقاً مانند کانالهای ارتباطی مستقیم عمل میکند: با «پرش» کردن از گرههای میانی، سرعت انتقال را بهشدت افزایش میدهد.
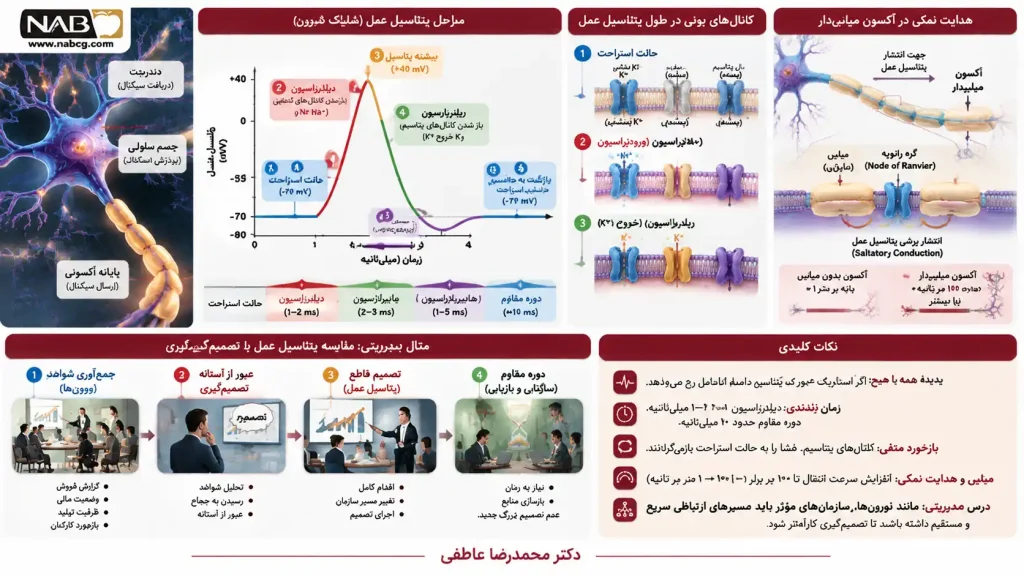
درس کلیدی برای مدیران: سرعت تصمیمگیری سازمانی، به معماری ارتباطی آن بستگی دارد. سازمانهایی که مسیرهای ارتباطی مستقیم بین واحدهای تصمیمگیری دارند (مشابه آکسونهای میلیندار)، سریعتر از سازمانهایی عمل میکنند که زنجیره فرماندهی طولانی دارند. این اصل، در طراحی سیستمهای هوش مصنوعی سازمانی نیز حاکم است: شبکههای عمیق با اتصالات کوتاه (مانند ResNet) میتوانند سریعتر از شبکههای با اتصالات طولانی آموزش ببینند.
۳.۱.۴ یادگیری در سطح سیستم
تا اینجا، عمدتاً بر نورون منفرد و سازماندهی قشر متمرکز بودهایم. اما یادگیری، در سطح سیستم اتفاق میافتد — یعنی در سطح شبکهای از میلیونها نورون که با یکدیگر تعامل دارند. در این بخش، به بررسی اصول یادگیری در سطح سیستم میپردازیم: چگونه مغز از تجربه یاد میگیرد، چگونه خاطرات را ذخیره میکند، و چگونه این اصول در شبکههای عصبی مصنوعی بازتولید شدهاند.
پلاستیسیتی سیناپسی: مکانیزم بنیادی یادگیری
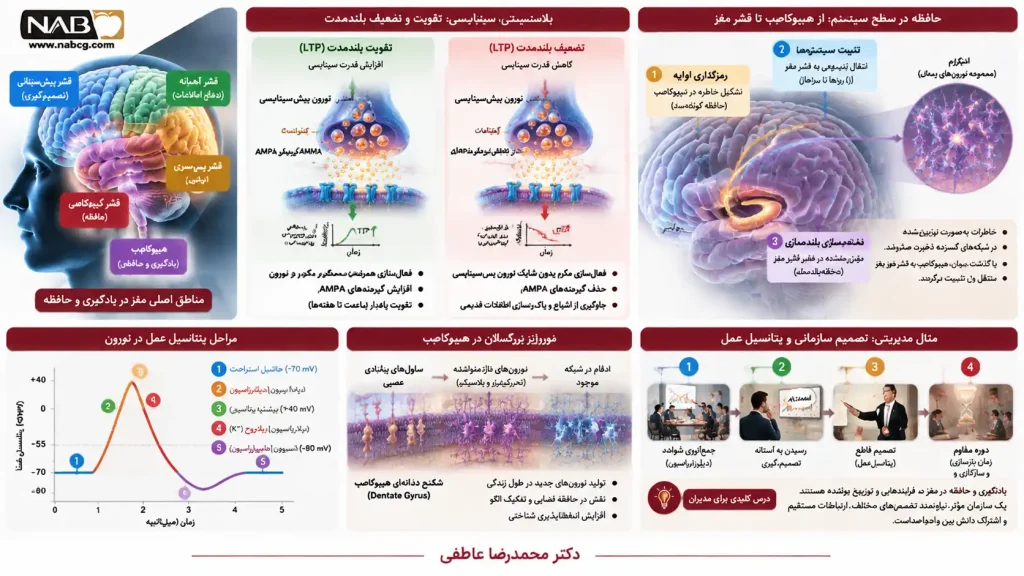
پایهایترین مکانیزم یادگیری در مغز، پلاستیسیتی سیناپسی (Synaptic Plasticity) است. این اصطلاح، به توانایی سیناپسها برای تغییر قدرت خود اشاره دارد. وقتی دو نورون بهطور مکرر با هم فعال میشوند، سیناپس بین آنها قویتر میشود؛ وقتی فعالیت آنها همزمان نیست، سیناپس ضعیفتر میشود. این مکانیزم، در فصل ۲ بهعنوان قانون هب معرفی شد: «نورونهایی که با هم شلیک میکنند، با هم سیمکشی میشوند.»
اما پلاستیسیتی سیناپسی، فقط یک مفهوم نظری نیست. تحقیقات تجربی نشان داده است که پلاستیسیتی سیناپسی، پایه فیزیولوژیک یادگیری و حافظه است. در سطح مولکولی، وقتی یک سیناپس تقویت میشود، گیرندههای — AMPA که مسئول دریافت گلوتامات هستند — بهطور افزایشی در غشای پسسیناپسی قرار میگیرند. این افزایش گیرندهها، باعث میشود که برای فعال شدن نورون پسسیناپسی، به گلوتامات کمتری نیاز باشد. این فرآیند، که تقویت بلندمدت (LTP) نامیده میشود، میتواند ساعتها تا هفتهها دوام داشته باشد.
مکانیزم مقابل LTP، تضعیف بلندمدت (LTD) است: وقتی یک سیناپس بهطور مکرر بدون فعالیت نورون پسسیناپسی فعال میشود، قدرت آن کاهش مییابد. LTD، نقش حیاتی در پاک کردن اطلاعات قدیمی و جلوگیری از اشباع شبکه دارد. تعادل بین LTP و LTD، به مغز اجازه میدهد که انعطافپذیر بماند: نه همه چیز را فراموش کند (که باعث از دست رفتن دانش میشود)، نه همه چیز را حفظ کند (که باعث اشباع و ناتوانی در یادگیری جدید میشود).
حافظه در سطح سیستم: انگرامها و تثبیت
یادگیری در سطح سیستم، فراتر از یک سیناپس منفرد است. وقتی شما یک خاطره را به یاد میآورید — مثلاً اولین روز کاریتان — این خاطره، در توزیعشده در سراسر مغز ذخیره شده است. مجموعه نورونهایی که این خاطره را کد میکنند، انگرام (Engram) نامیده میشوند. تحقیقات نشان داده است که انگرامها، مجموعههای پراکنده از نورونها هستند که در سراسر مناطق مختلف مغز پراکندهاند.
پس از شکلگیری اولیه یک خاطره در هیپوکامپ — ناحیهای که برای حافظه کوتاهمدت حیاتی است — خاطره بهتدریج به قشر مغز منتقل میشود. این فرآیند، تثبیت سیستمها (Systems Consolidation) نامیده میشود و ممکن است روزها تا سالها طول بکشد. در طول این فرآیند، خاطره دوباره سازماندهی میشود: از یک خاطره اختصاصی و جزئی (مثلاً «دیروز چه ناهار خوردم») به یک خاطره عمومی و قابل تعمیم (مثلاً «غذای مورد علاقهام چیست») تبدیل میشود.
نوروژنز بزرگسالان: تولید نورونهای جدید
تا دهه ۱۹۹۰، باور غالب این بود که مغز بالغ نمیتواند نورونهای جدید تولید کند. اما تحقیقات نشان داد که در شکنج دندانهای هیپوکامپ (Dentate Gyrus of Hippocampus)، نورونهای جدید در طول زندگی تولید میشوند. این فرآیند، نوروژنز بزرگسالان (Adult Neurogenesis) نامیده میشود و نقش مهمی در حافظه فضایی، تفکیک الگو (تمایز بین خاطرات مشابه)، و انعطافپذیری شناختی دارد.
نورونهای تازهمتولدشده، ویژگیهای فیزیولوژیکی منحصربهفردی دارند که آنها را از نورونهای بالغ متمایز میکند: آنها تحریکپذیرتر هستند و پلاستیسیتی بالاتری دارند. این ویژگیها، به آنها اجازه میدهد که سریعتر یاد بگیرند و آسانتر در شبکههای موجود ادغام شوند. در یک مثال مدیریتی، نورونهای جدید مانند کارکنان تازهاستخدامشده هستند: آنها انعطافپذیرتر از کارکنان قدیمی هستند و میتوانند ایدههای جدید را سریعتر جذب کنند. اما در عین حال، نظم و انسجام سازمان را نیز به چالش میکشند.
درس کلیدی برای مدیران: یادگیری در سطح سیستم، نشان میدهد که حافظه و یادگیری، فرآیندهایی پویا و توزیعشده هستند. خاطرات، در یک مکان مشخص ذخیره نمیشوند؛ آنها در شبکههای توزیعشده شکل میگیرند و در طول زمان تثبیت میشوند. برای سازمانها، این درس به این معناست که دانش سازمانی نیز نباید در یک واحد متمرکز شود؛ بلکه باید در شبکههای ارتباطی توزیع شود تا انعطافپذیری و تابآوری سازمان افزایش یابد.
۳.۱.۵ مثال گسترده: مسیر بینایی از شبکیه تا قشر بینایی V1
برای اینکه همه مفاهیم این بخش را بهصورت یکپارچه ببینیم، بیایید یک مثال کامل و گامبهگام را مرور کنیم: مسیر بینایی از شبکیه تا قشر بینایی V1. این مسیر، یکی از بهترین درکشدهترین سیستمهای پردازش اطلاعات در مغز است و اصول آن، مستقیماً در شبکههای کانولوشنی (CNN) بازتولید شده است. با دنبال کردن این مسیر، خواهیم دید که چگونه مغز از سلولهای ساده در شبکیه شروع میکند و به درک پیچیده از اشیاء میرسد — دقیقاً همان مسیری که یک CNN طی میکند.
مرحله اول: شبکیه — دریافت نور و تبدیل به سیگنال
ماجرا از شبکیه (Retina) شروع میشود — لایهای نازک در پشت چشم که حدود ۱۲۰ میلیون سلول گیرنده نور دارد: مخروطها (برای رنگ و دقت بالا) و میلهها (برای نور کم و دید شبانه). وقتی نور به این سلولها میرسد، آنها سیگنال الکتریکی تولید میکنند. این سیگنال، سپس به سلولهای دوقطبی (Bipolar Cells) و از آنها به سلولهای گانگلیونی (Ganglion Cells) منتقل میشود. سلولهای گانگلیونی، خروجی نهایی شبکیه هستند: آکسونهای آنها، عصب بینایی را تشکیل میدهند که اطلاعات را به مغز میفرستد.
نکته کلیدی این است که سلولهای گانگلیونی، فقط به نور خام پاسخ نمیدهند. آنها میدانهای گیرنده (Receptive Fields) دارند — یعنی هر سلول گانگلیونی، به ناحیه خاصی از میدان بینایی پاسخ میدهد. برخی سلولها مرکز-روشن (On-Center) هستند: وقتی نور در مرکز میدان گیرنده باشد، فعال میشوند؛ وقتی نور در حاشیه باشد، مهار میشوند. برخی دیگر مرکز-خاموش (Off-Center) هستند: برعکس. این ساختار، اولین مرحله پردازش در مسیر بینایی است: شبکیه، نور خام را به الگوهای لبهای ساده تبدیل میکند.
مثال مدیریتی: شبکیه بهعنوان بخش جمعآوری داده سازمان
فرض کنید یک شرکت خردهفروشی، دادههای فروش روزانه خود را از هزاران فروشگاه جمعآوری میکند. در روش سنتی، هر فروشگاه تمام دادهها را به مرکز ارسال میکند و مرکز باید همه را پردازش کند. اما در روش الهامگرفته از شبکیه، هر فروشگاه ابتدا دادهها را فیلتر میکند: فقط الگوهای مهم (مثلاً افزایش ناگهانی فروش، یا کاهش در یک محصول خاص) را استخراج میکند و به مرکز میفرستد. این پیشپردازش، بار محاسباتی مرکز را بهشدت کاهش میدهد. شبکیه دقیقاً همین کار را میکند: بهجای فرستادن تمام اطلاعات نوری (میلیونها پیکسل) به مغز، فقط الگوهای لبهای را استخراج و ارسال میکند.
مرحله دوم: هسته زانویی جانبی — (LGN)ایستگاه رله
اطلاعات بینایی از شبکیه، از طریق عصب بینایی، به هسته زانویی جانبی (Lateral Geniculate Nucleus, LGN) در تالاموس میرسد. LGN، یک ایستگاه رله است: اطلاعات را از شبکیه دریافت میکند و به قشر بینایی میفرستد. اما LGN، فقط یک «پاسدهنده» ساده نیست. تحقیقات نشان داده است که فقط حدود ۱۰٪ از ورودیهای LGN از شبکیه میآید؛ حدود ۳۰٪ از بازخورد قشر بینایی V1 میآید. این بدان معناست که LGN، تحت تأثیر شدید قشر است: اطلاعات را فیلتر و تنظیم میکند، بر اساس آنچه که قشر انتظار دارد ببیند.
این مکانیزم، اولین نشانه از پردازش پیشبینانه (Predictive Processing) در مسیر بینایی است: مغز فقط اطلاعاتی را تقویت میکند که با انتظارات آن همخوانی دارد. در یک مثال مدیریتی، LGN مانند یک مدیر میانی است که اطلاعات را از کارکنان خط مقدم (شبکیه) دریافت میکند، اما دستورالعملهایی از مدیران ارشد (قشر V1) دارد که تعیین میکند چه اطلاعاتی مهم است و باید تقویت شود.
مرحله سوم: قشر بینایی — V1 استخراج لبهها و جهتها
اطلاعات از LGN به قشر بینایی اولیه — (V1)که در لوب پسسری قرار دارد — میرسد. اینجاست که دیوید هوبل و تورستن ویزل، دو عصبشناس برجسته، در دهه ۱۹۶۰ کشف انقلابی خود را انجام دادند. آنها با ثبت فعالیت نورونهای V1 در گربهها، نشان دادند که برخی نورونها فقط به لبههای با جهت خاص پاسخ میدهند. برای مثال، یک نورون ممکن است فقط به لبهای که از پایین-چپ به بالا-راست میرود پاسخ دهد، و هیچ پاسخی به لبهای در جهت مخالف ندهد.
هوبل و ویزل دو نوع سلول در V1 شناسایی کردند: سلولهای ساده (Simple Cells) که به جهت دقیق لبه در موقعیت مشخص پاسخ میدهند، و سلولهای پیچیده (Complex Cells) که به جهت لبه پاسخ میدهند صرفنظر از موقعیت آن. سلولهای پیچیده، از همگرایی خروجی چندین سلول ساده ساخته شدهاند: هر سلول ساده به یک لبه در یک موقعیت خاص پاسخ میدهد، و سلول پیچیده، اطلاعات آنها را جمعبندی میکند تا به ناوردایی نسبت به موقعیت (Position Invariance) برسد.
این ساختار، دقیقاً همان چیزی است که در شبکههای کانولوشنی (CNN) بازتولید شده است: در CNN، لایههای کانولوشنی نقش سلولهای ساده را ایفا میکنند (تشخیص لبه در موقعیتهای مختلف)، و لایههای ادغام (Pooling Layers) نقش سلولهای پیچیده را ایفا میکنند (ادغام اطلاعات برای ایجاد ناوردایی).
مرحله چهارم: نقشه توپوگرافیک — حفظ ساختار فضایی
یکی از شگفتانگیزترین ویژگیهای مسیر بینایی، حفظ ساختار فضایی در سراسر مسیر است. این بدان معناست که نورونهایی که در شبکیه مجاور هم هستند، در LGN و V1 نیز مجاور هم میمانند. این ویژگی، نقشه توپوگرافیک (Topographic Map) یا رتینوتوپی (Retinotopy) نامیده میشود. برای مثال، اگر دو نقطه در میدان بینایی، نزدیک به هم باشند، نورونهای متناظر آنها در V1 نیز نزدیک به هم خواهند بود.
مزیت این سازماندهی توپوگرافیک چیست؟ پاسخ در کمینهسازی طول اتصالات نهفته است. اگر نورونهای متناظر با نقاط مجاور میدان بینایی، در نواحی دور از هم قرار میگرفتند، برای ادغام اطلاعات آنها، به آکسونهای بسیار بلند نیاز بود — که هم فضای زیادی اشغال میکرد و هم زمان انتقال را افزایش میداد. با سازماندهی توپوگرافیک، نورونهای مجاور میتوانند مستقیماً با یکدیگر ارتباط برقرار کنند، که هم کارآمدتر است و هم سریعتر.
مثال مدیریتی: نقشه توپوگرافیک در سازماندهی تیمها
فرض کنید یک شرکت نرمافزاری میخواهد تیمهای توسعه خود را سازماندهی کند. اگر تیمهایی که روی ماژولهای مرتبط کار میکنند، در اتاقهای جداگانه و طبقات مختلف قرار گیرند، ارتباط بین آنها کند و پرهزینه خواهد بود. اما اگر تیمهای مرتبط در فضاهای مجاور قرار گیرند، ارتباط سریعتر و مؤثرتر میشود. نقشه توپوگرافیک مغز، دقیقاً همین اصل را پیادهسازی میکند: سازماندهی فضایی بر اساس ارتباط عملکردی.
مرحله پنجم: از V1 تا V2، V4، و فراتر — سلسلهمراتب پیچیدگی
اطلاعات از V1 به نواحی بالاتر بینایی میرود: V2، V4، و سپس قشر تمپورال تحتانی (IT). در هر مرحله، پیچیدگی ویژگیهایی که نورونها تشخیص میدهند، افزایش مییابد:
- V1: لبهها و جهتها.
- V2: بافتها، الگوهای پیچیدهتر، و خطوط مرزی ذهنی (Illusory Contours).
- V4: رنگ و شکلهای ساده.
- IT: اشیاء کامل (چهره، ماشین، حیوانات).
این سلسلهمراتب، دقیقاً مشابه لایههای یک CNN است: لایههای اولیه ویژگیهای ساده (لبهها) را یاد میگیرند، لایههای میانی ویژگیهای پیچیدهتر (اجزای اشیاء)، و لایههای آخر، اشیاء کامل. این همگرایی بین مغز و شبکههای مصنوعی، یکی از قویترین شواهد برای این است که اصول سازماندهی مغز، اصول بهینه برای پردازش اطلاعات هستند.
جمعبندی مسیر بینایی: درسهایی برای طراحی سیستمهای هوش مصنوعی
مسیر بینایی، چندین اصل کلیدی را نشان میدهد که مستقیماً در طراحی شبکههای عصبی مصنوعی به کار گرفته شدهاند:
۱. پردازش سلسلهمراتبی: اطلاعات از ساده به پیچیده، در لایههای متوالی پردازش میشود. این اصل، اساس یادگیری عمیق است.
۲. پیشپردازش در سطح پایین: شبکیه، قبل از ارسال اطلاعات به مغز، آن را فیلتر و فشرده میکند. این اصل، در لایههای اولیه CNN (که لبهها را استخراج میکنند) بازتولید شده است.
۳. ناوردایی تدریجی: در هر مرحله، نورونها به تغییرات جزئی (مثل جابهجایی) ناورداتر میشوند. این اصل، در لایههای ادغام (Pooling) CNN پیادهسازی شده است.
۴. پردازش پیشبینانه: LGN تحت تأثیر بازخورد از V1 است و اطلاعات را بر اساس انتظارات فیلتر میکند. این اصل، در شبکههای بازگشتی و مدلهای پیشبینانه بازتولید شده است.
۵. نقشه توپوگرافیک: سازماندهی فضایی بر اساس ارتباط عملکردی، برای کمینهسازی طول اتصالات و افزایش سرعت. این اصل، در معماریهای سلسلهمراتبی CNN دیده میشود.
مثال مدیریتی نهایی: طراحی یک سیستم بینایی ماشین برای کنترل کیفیت
فرض کنید یک کارخانه تولید قطعات الکترونیکی میخواهد یک سیستم بینایی ماشین راهاندازی کند که عیوب سطحی را تشخیص دهد. با الهام از مسیر بینایی:
- مرحله اول (شبکیه): دوربینهایی که تصاویر خام را میگیرند و پیشپردازش ساده (تنظیم روشنایی، حذف نویز) انجام میدهند.
- مرحله دوم (LGN): یک لایه فیلتر که تصاویر را فشرده میکند و فقط نواحی مشکوک را به مرحله بعد میفرستد.
- مرحله سوم (V1): یک شبکه کانولوشنی که لبهها و بافتهای ساده را تشخیص میدهد — مثلاً لبههای یک ترک.
- مرحله چهارم (V2/V4): لایههای عمیقتر که الگوهای پیچیدهتر را تشخیص میدهند — مثلاً شکل کلی یک خش یا تغییر رنگ.
- مرحله پنجم (IT): یک طبقهبند نهایی که تصمیم میگیرد: «قطعه سالم» یا «قطعه معیوب».
این سیستم، دقیقاً همان اصولی را دنبال میکند که مغز در پردازش بینایی به کار میبرد — و به همین دلیل، کارآمدتر و دقیقتر از سیستمهای سنتی است که تمام تصویر را بهطور همزمان پردازش میکنند.
جمعبندی بخش ۳.۱: چه چیزی از مغز میآموزیم؟
در این بخش، ساختار کلی مغز را از نورون منفرد تا سیستمهای توزیعشده بررسی کردیم. آنچه دیدیم، فراتر از یک درس عصبشناسی بود؛ ما شاهد اصول طراحی بودیم که مستقیماً در معماری شبکههای عصبی مصنوعی بازتولید شدهاند:
۱. قدرت در سازماندهی است، نه در تعداد. مغز با وجود ۸۶ میلیارد نورون، از اصول ساده تبعیت میکند: نورونها بهصورت سلسلهمراتبی سازمان یافتهاند، تخصصیافتگی دارند، و در ستونهای عملکردی کار میکنند. این اصول، به شبکههای مصنوعی — که بسیار کوچکتر از مغز هستند — اجازه میدهد که کارآمد و مؤثر باشند.
۲. پردازش موازی و توزیعشده. برخلاف کامپیوترهای سنتی که ترتیبی عمل میکنند، مغز اطلاعات را موازی و توزیعشده پردازش میکند. این اصل، در محاسبات موازی GPU و معماریهای توزیعشده شبکههای عصبی بازتولید شده است.
۳. یادگیری در سطح سیستم. یادگیری، نه فقط در یک نورون یا سیناپس، بلکه در سطح شبکههای توزیعشده اتفاق میافتد. خاطرات در انگرامها ذخیره میشوند و در طول زمان تثبیت میشوند. این اصول، در آموزش شبکههای عمیق و یادگیری انتقالی (Transfer Learning) بازتولید شدهاند.
۴. پردازش پیشبینانه. مغز، یک ماشین پیشبینی است: اطلاعات را بر اساس انتظارات فیلتر میکند و فقط خطاهای پیشبینی را به لایههای بالاتر میفرستد. این اصل، در مدلهای پیشبینانه و شبکههای بازگشتی بازتولید شده است.
۵. نقشههای توپوگرافیک. سازماندهی فضایی بر اساس ارتباط عملکردی، برای کمینهسازی طول اتصالات و افزایش سرعت. این اصل، در معماریهای سلسلهمراتبی و شبکههای کانولوشنی دیده میشود.
درس نهایی برای مدیران: مغز، نه فقط یک الگوی بیولوژیکی، بلکه یک راهنمای طراحی برای سیستمهای هوش مصنوعی سازمانی است. سازمانهایی که اصول سازماندهی مغز — تخصصیافتگی، پردازش موازی، یادگیری توزیعشده، و پیشبینی — را در معماری سازمانی و سیستمهای تصمیمگیری خود پیادهسازی کنند، میتوانند انعطافپذیرتر، سریعتر، و مؤثرتر از رقبای خود عمل کنند.
منابع بخش ۳.۱
Brown, T. H., Kairiss, E. W., & Keenan, C. L. (1990). Hebbian synapses: Biophysical mechanisms and algorithms. Annual Review of Neuroscience, *13*, 475–511. https://doi.org/10.1146/annurev.ne.13.030190.002355
Caporale, N., & Dan, Y. (2008). Spike timing-dependent plasticity: A Hebbian learning rule. Annual Review of Neuroscience, *31*, 25–46. https://doi.org/10.1146/annurev.neuro.31.060407.125639
Gómez, C. M., Arjona, A., Ruiz-Martínez, F. J., Muñoz-Caracuel, M., Muñoz, V., & Rodriguez-Martínez, E. I. (2026). An event-related potentials account of brain predictive coding. Cognitive Neurodynamics, *20*, Article 10491. https://doi.org/10.1007/s11571-026-10491-7
Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley.
Hermann, G. (n.d.). The models introduced in this thesis depict idealized and simplified neuronal networks [Doctoral thesis, INRIA]. http://www-sop.inria.fr/members/Geoffroy.Hermann/Thesis_Hermann.pdf
Hodgkin, A. L., & Huxley, A. F. (1952). A quantitative description of membrane current and its application to conduction and excitation in nerve. The Journal of Physiology, *117*(4), 500–544. https://doi.org/10.1113/jphysiol.1952.sp004764
Horton, J. C., & Adams, D. L. (2005). The cortical column: A structure without a function. Philosophical Transactions of the Royal Society B: Biological Sciences, *360*(1456), 837–862. https://doi.org/10.1098/rstb.2005.1623
Hubel, D. H., & Wiesel, T. N. (1962). Receptive fields, binocular interaction and functional architecture in the cat’s visual cortex. The Journal of Physiology, *160*(1), 106–154. https://doi.org/10.1113/jphysiol.1962.sp006837
Hubel, D. H., & Wiesel, T. N. (1959). Receptive fields of single neurones in the cat’s striate cortex. The Journal of Physiology, *148*(3), 574–591. https://doi.org/10.1113/jphysiol.1959.sp006308
Kandel, E. R., Koester, J. D., Mack, S. H., & Siegelbaum, S. A. (2021). Principles of neural science (6th ed.). McGraw-Hill.
Magee, J. C., & Grienberger, C. (2020). Synaptic plasticity forms and functions. Annual Review of Neuroscience, *43*, 95–117. https://doi.org/10.1146/annurev-neuro-090919-022842
Mountcastle, V. B. (1957). Modality and topographic properties of single neurons of cat’s somatic sensory cortex. Journal of Neurophysiology, *20*(4), 408–434. https://doi.org/10.1152/jn.1957.20.4.408
Mountcastle, V. B. (1997). The columnar organization of the neocortex. Brain, *120*(4), 701–722. https://doi.org/10.1093/brain/120.4.701
Purves, D., Augustine, G. J., Fitzpatrick, D., Hall, W. C., LaMantia, A.-S., Mooney, R. D., Platt, M. L., & White, L. E. (2018). Neuroscience (6th ed.). Oxford University Press.
Rakic, P. (2008). Confusing cortical columns. Proceedings of the National Academy of Sciences, *105*(34), 12099–12100. https://doi.org/10.1073/pnas.0807271105
Stingl, M., Draguhn, A., & Both, M. (2025). A dendrite is a dendrite is a dendrite? Dendritic signal integration beyond the “antenna” model. Pflügers Archiv – European Journal of Physiology, *477*, 9–16. https://doi.org/10.1007/s00424-024-03004-0
Torcini, A. (2015). The Hodgkin-Huxley model [Lecture notes]. Université d’Aix-Marseille. https://perso.u-cergy.fr/~atorcini/MATDID/NEURO/HH15.pdf
Vasseur, F. (2013). Étude de l’organisation en hypercolonnes du cortex visuel [Doctoral thesis, Université Paris-Sud]. https://theses.hal.science/tel-00948588v1
Zaki, Y., & Cai, D. J. (2024). Memory engram stability and flexibility. Neuropsychopharmacology, *49*, 1–10. https://doi.org/10.1038/s41386-024-01940-0
Zhang, X., et al. (2026). Physical mechanisms governing generalization and hallucination in deep learning for imaging through scattering media. Nature Communications, *17*, Article 72304. https://doi.org/10.1038/s41467-026-72304-z
۳.۲ نورون زیستی: کالبدشناسی و عملکرد
مسئله آغازین: فرض کنید یک مدیر ارشد فناوری در سازمانی بزرگ هستید و از شما میپرسند: «چرا شبکههای عصبی مصنوعی اینقدر قدرتمندند، در حالی که هر واحد محاسباتی آنها — یک نورون مصنوعی — فقط یک جمع وزنی ساده انجام میدهد؟» پاسخ کوتاه این است: «قدرت در خود واحد نیست؛ در سازماندهی و اتصالات آن است.» اما برای درک عمیقتر این پاسخ، باید بفهمیم که نورون زیستی — الگوی اصلی نورون مصنوعی — دقیقاً چگونه کار میکند. آیا نورون زیستی واقعاً یک «جمعکننده ساده» است؟ یا ساختاری بسیار پیچیدهتر دارد که هنوز هم دانشمندان در حال کشف رمزورازهای آن هستند؟ در این بخش، به کالبدشناسی و عملکرد نورون زیستی میپردازیم — نه بهعنوان یک درس عصبشناسی خشک، بلکه بهعنوان راهنمایی برای فهم چه چیزی در نورون زیستی وجود دارد که نورون مصنوعی فاقد آن است و چگونه میتوان از این تفاوتها برای طراحی بهتر سیستمهای هوش مصنوعی سازمانی الهام گرفت.
۳.۲.۱ اجزای نورون: از جسم سلولی تا پایانههای آکسونی
یک نورون زیستی، اگرچه در نگاه اول شبیه یک سلول ساده است، در واقع یکی از پیچیدهترین سلولهای بدن است. این سلول، سه بخش اصلی دارد که هر یک، نقش مشخصی در پردازش اطلاعات ایفا میکند: جسم سلولی (Soma)، دندریتها (Dendrites)، و آکسون (Axon). در ادامه، هر یک را بهتفصیل بررسی میکنیم.
۳.۲.۱.۱ جسم سلولی (Soma): مرکز پردازش و سنتز
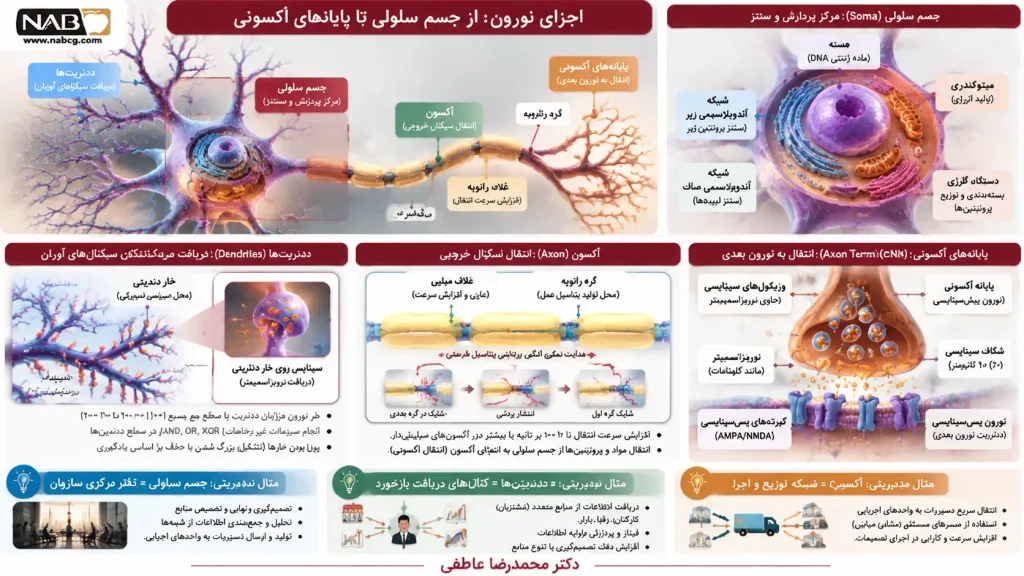
جسم سلولی، که به آن پریکاریون (Perikaryon) نیز میگویند، بخش مرکزی نورون است که هسته سلول و اندامکهای سیتوپلاسمی را در خود جای داده است. قطر جسم سلولی معمولاً بین ۱۰ تا ۱۰۰ میکرومتر است — یعنی حدود یکدهم میلیمتر. اگرچه این اندازه در مقایسه با بسیاری از سلولهای بدن کوچک است، اما جسم سلولی نورون، ماشین متابولیکی بسیار فعالی است.
درون جسم سلولی، چه میگذرد؟ اول از همه، هسته قرار دارد که ماده ژنتیکی (DNA) را در خود جای داده است. این هسته، دستورالعملهای ساخت پروتئینهای مختلف را صادر میکند — پروتئینهایی که برای ساخت غشا، گیرندههای سیناپسی، کانالهای یونی، و نوروترانسمیترها ضروری هستند. علاوه بر هسته، جسم سلولی دارای میتوکندری (برای تولید انرژی)، شبکه آندوپلاسمی صاف و زبر (برای سنتز لیپیدها و پروتئینها)، و دستگاه گلژی (برای بستهبندی و توزیع پروتئینها) است.
نکته کلیدی در مورد جسم سلولی این است که تمام پروتئینهای نورون در همین جا ساخته میشوند — حتی پروتئینهایی که در دورترین نقاط آکسون یا دندریتها مورد نیاز هستند. این پروتئینها سپس از طریق انتقال آکسونی (Axonal Transport) — که میتواند آهسته (حدود ۱ میلیمتر در روز) یا سریع (حدود ۱۰۰ تا ۴۰۰ میلیمتر در روز) باشد — به مقصد خود منتقل میشوند. این فرآیند، مشابه یک زنجیره تأمین سازمانی است: مواد اولیه در کارخانه مرکزی (جسم سلولی) تولید میشوند و سپس از طریق مسیرهای حملونقل (میکروتوبولها و پروتئینهای موتوری) به شعبههای دورافتاده (آکسون و دندریتها) ارسال میگردند.
از نظر پردازش اطلاعات، جسم سلولی نقش جمعبندی و ادغام سیگنالهای دریافتی از دندریتها را ایفا میکند. سیگنالهای الکتریکی که از دندریتها میآیند، در جسم سلولی جمع میشوند و اگر مجموع آنها از آستانه تحریک عبور کند، نورون شلیک میکند. این فرآیند، که ادغام سیناپسی (Synaptic Integration) نامیده میشود، در بخش ۳.۲.۳ بهتفصیل بررسی خواهد شد.
مثال مدیریتی: جسم سلولی بهعنوان دفتر مرکزی سازمان
فرض کنید یک شرکت چندملیتی، دفاتر خود را در سراسر جهان پراکنده کرده است. دفتر مرکزی (جسم سلولی) مسئول تصمیمگیری نهایی، تخصیص منابع، و هماهنگی بین دفاتر است. اطلاعات از شعبههای محلی (دندریتها) به دفتر مرکزی میرسد، در آنجا تحلیل و جمعبندی میشود، و سپس دستورات (آکسون) به واحدهای اجرایی (پایانههای آکسونی) صادر میگردد. نکته مهم این است که دفتر مرکزی، فقط یک پاسدهنده نیست؛ بلکه اطلاعات را پردازش میکند، اولویتبندی انجام میدهد، و تصمیمات راهبردی میگیرد. اگر دفتر مرکزی از کار بیفتد (مثلاً در اثر سکته مغزی)، تمام سازمان (نورون) فلج میشود — حتی اگر دندریتها و آکسون سالم باشند.
۳.۲.۱.۲ دندریتها (Dendrites): دریافتکنندگان سیگنالهای آوران
دندریتها، شاخههای درختیشکل نورون هستند که از جسم سلولی خارج میشوند و سیگنالهای ورودی (آوران) را از نورونهای دیگر دریافت میکنند. واژه «دندریت» از کلمه یونانی δένδρον (دندرون) به معنای «درخت» گرفته شده است — و این نامگذاری بسیار مناسب است، زیرا دندریتها ساختاری درختی با شاخههای متعدد دارند که سطح تماس نورون را بهشدت افزایش میدهند.
یک نورون معمولی در قشر مغز، هزاران دندریت دارد که مجموعاً سطحی معادل ۱۰٬۰۰۰ تا ۱۰۰٬۰۰۰ میکرومتر مربع را پوشش میدهند. این سطح وسیع، به نورون اجازه میدهد که با هزاران نورون دیگر ارتباط برقرار کند. در واقع، اگر دندریتها نبودند، نورون فقط میتوانست با تعداد محدودی از نورونهای مجاور ارتباط داشته باشد — و این، قدرت پردازش مغز را بهشدت کاهش میداد.
دندریتها، برخلاف تصور قدیمی که آنها را فقط «سیمهای غیرفعال» میدانستند، خواص محاسباتی فعالی دارند. تحقیقات دهههای اخیر نشان داده است که دندریتها میتوانند عملیات غیرخطی مانند AND، OR، و حتی XOR را در سطح خود انجام دهند — چیزی که یک نورون مصنوعی ساده قادر به انجام آن نیست. این کشف، که در بخش ۳.۳ بهتفصیل بررسی خواهد شد، نشان میدهد که نورون زیستی، بسیار قدرتمندتر از یک جمعکننده خطی ساده است.
روی سطح دندریتها، ساختارهای کوچکی به نام خارهای دندریتی (Dendritic Spines) قرار دارند. این خارها، محل اصلی سیناپسهای تحریکی هستند و نقش حیاتی در پلاستیسیتی سیناپسی (یادگیری) ایفا میکنند. تعداد و شکل خارها، پویا است: با یادگیری، خارهای جدید تشکیل میشوند و خارهای موجود بزرگتر میشوند؛ با فراموشی یا عدم استفاده، خارها کوچک یا حذف میشوند. این پویایی ساختاری، پایه حافظه بلندمدت را تشکیل میدهد.
مثال مدیریتی: دندریتها بهعنوان کانالهای دریافت بازخورد سازمانی
یک سازمان مؤثر، نیازمند کانالهای متعدد دریافت بازخورد از محیط است: بازخورد مشتریان، نظرات کارکنان، تحلیل رقبا، و تغییرات بازار. دندریتها دقیقاً نقش همین کانالها را ایفا میکنند: هر دندریت، یک منبع اطلاعاتی است که سیگنالهای خاصی را به نورون (مدیر تصمیمگیرنده) میرساند. اگر سازمان فقط یک کانال بازخورد داشته باشد (مثلاً فقط نظرسنجی مشتری)، دید آن محدود خواهد بود. اما اگر کانالهای متعدد (دندریتهای متعدد) داشته باشد، میتواند تصمیمات جامعتری بگیرد. نکته مهم این است که این کانالها غیرفعال نیستند؛ آنها سیگنالها را فیلتر، تقویت، و ادغام میکنند — دقیقاً همانطور که دندریتها سیگنالهای ورودی را پردازش میکنند.
۳.۲.۱.۳ آکسون (Axon): انتقالدهنده سیگنالهای وابران
آکسون، زائده بلند و نازکی است که از تپه آکسونی (Axon Hillock) — ناحیهای در محل اتصال جسم سلولی به آکسون — شروع میشود و سیگنال خروجی نورون را به نورونهای بعدی، عضلات، یا غدد منتقل میکند. آکسون، برخلاف دندریتها که ساختاری درختی و انشعابی دارند، معمولاً یک زائده واحد است که میتواند بسیار بلند باشد. در برخی نورونهای حرکتی نخاع، طول آکسون به بیش از یک متر میرسد — مثلاً از نخاع تا انگشت پا.
آکسون از سه بخش اصلی تشکیل شده است:
۱. تپه آکسونی و قطعه اولیه: این ناحیه، محل شروع پتانسیل عمل است. تپه آکسونی، بالاترین چگالی کانالهای سدیم وابسته به ولتاژ را در کل نورون دارد. به همین دلیل، آستانه تحریک در این ناحیه پایینتر از سایر نقاط نورون است. اگر مجموع سیگنالهای تحریکی و مهاری که به تپه آکسونی میرسند، از این آستانه عبور کند، پتانسیل عمل در قطعه اولیه آکسون تولید میشود و در امتداد آکسون منتشر میگردد.
۲. غشای آکسون: غشای آکسون، کانالهای یونی متعددی دارد که مسئول دپلاریزاسیون و رپلاریزاسیون هستند. در آکسونهای بدون میلین، این کانالها در سراسر غشا پخش شدهاند و پتانسیل عمل بهصورت پیوسته (Continuous Conduction) منتشر میشود. سرعت این انتشار، حدود ۱ تا ۱۰ متر بر ثانیه است — که برای بسیاری از کاربردها کند محسوب میشود.
۳. غلاف میلین و گرههای رانویه: در بسیاری از آکسونها، سلولهای گلیا (الیگودندروسیتها در سیستم عصبی مرکزی و سلولهای شوان در سیستم عصبی محیطی) غلافی چربی به نام میلین را دور آکسون میپیچند. این غلاف، عایق الکتریکی است و از نشت جریان جلوگیری میکند. اما میلین، پیوسته نیست: در فواصل منظم، گرههای رانویه (Nodes of Ranvier) قرار دارند — نواحی کوچکی (حدود ۱ تا ۲ میکرومتر) که بدون میلین هستند و کانالهای سدیم و پتاسیم در آنها متمرکز شدهاند. پتانسیل عمل، در آکسونهای میلیندار، بهصورت پرشی (Saltatory Conduction) منتشر میشود: از یک گره رانویه به گره بعدی میپرد و بخشهای میلیندار را رد میکند. این مکانیزم، سرعت انتقال را تا ۱۰۰ متر بر ثانیه یا بیشتر افزایش میدهد.
مثال مدیریتی: میلین بهعنوان زیرساخت ارتباطی سریع
فرض کنید یک سازمان با شعبههای متعدد در شهرهای مختلف دارد. اگر ارتباط بین شعبهها از طریق پست سنتی (آکسون بدون میلین) انجام شود، انتقال اطلاعات روزها طول میکشد. اما اگر سازمان از فیبر نوری (آکسون میلیندار) استفاده کند، اطلاعات در کمتر از یک ثانیه منتقل میشوند. تفاوت میلین و عدم میلین، دقیقاً همان تفاوت زیرساخت ارتباطی کند و سریع است. برای مدیران، این درس به این معناست که سرمایهگذاری در زیرساختهای ارتباطی سریع (مانند سیستمهای اطلاعاتی یکپارچه، شبکههای ارتباطی ابری) میتواند سرعت تصمیمگیری سازمان را بهشدت افزایش دهد.
۳.۲.۱.۴ پایانههای آکسونی: تبدیل سیگنال الکتریکی به شیمیایی
در انتهای آکسون، پایانههای آکسونی (Axon Terminals) یا دکمههای سیناپسی (Synaptic Boutons) قرار دارند. این ساختارهای کوچک (حدود ۱ تا ۲ میکرومتر) نقطه اتصال نورون به نورون بعدی هستند. درون هر پایانه آکسونی، وزیکولهای سیناپسی (Synaptic Vesicles) قرار دارند — کیسههای کوچکی که نوروترانسمیترها (مواد شیمیایی انتقالدهنده پیام) را در خود ذخیره میکنند. هر وزیکول، حدود ۱٬۰۰۰ تا ۱۰٬۰۰۰ مولکول نوروترانسمیتر را در خود جای میدهد.
وقتی پتانسیل عمل به پایانه آکسونی میرسد، کانالهای کلسیمی وابسته به ولتاژ باز میشوند و یونهای کلسیم (Ca²⁺) به داخل پایانه سرازیر میشوند. افزایش کلسیم داخل سلولی، باعث ادغام وزیکولها با غشای پایانه و آزادسازی نوروترانسمیترها به شکاف سیناپسی (Synaptic Cleft) میشود. شکاف سیناپسی، فضایی به عرض ۲۰ تا ۴۰ نانومتر بین دو نورون است. نوروترانسمیترها از این شکاف عبور میکنند و به گیرندههای روی غشای نورون پسسیناپسی متصل میشوند. این اتصال، باعث باز شدن کانالهای یونی در نورون پسسیناپسی و تولید سیگنال الکتریکی جدید میشود.
این فرآیند — تبدیل سیگنال الکتریکی به سیگنال شیمیایی و سپس دوباره به سیگنال الکتریکی — یکی از شگفتانگیزترین مکانیزمهای مغز است. چرا مغز از این روش پیچیده استفاده میکند، در حالی که میتوانست سیگنال الکتریکی را مستقیماً منتقل کند؟ پاسخ در انعطافپذیری و تنظیمپذیری این روش نهفته است: با تغییر مقدار نوروترانسمیتر آزادشده، تعداد گیرندههای پسسیناپسی، یا مدت زمان باقی ماندن نوروترانسمیتر در شکاف، میتوان قدرت سیناپس را تنظیم کرد. این تنظیمپذیری، پایه یادگیری و حافظه است.
مثال مدیریتی: پایانه آکسونی بهعنوان واحد ترجمه و انتقال پیام
در یک سازمان، مدیرعامل (نورون پیشسیناپسی) تصمیمی میگیرد و آن را به مدیران میانی (نورون پسسیناپسی) ابلاغ میکند. اما این ابلاغ، مستقیم نیست: مدیرعامل، تصمیم خود را به زبان سازمانی (سیگنال الکتریکی) بیان میکند، سپس واحد ارتباطات (پایانه آکسونی) آن را به زبان قابل فهم برای مدیران میانی (نوروترانسمیتر) ترجمه میکند. مدیران میانی، این پیام را تفسیر میکنند (اتصال به گیرندهها) و بر اساس آن، تصمیمات عملیاتی میگیرند (سیگنال الکتریکی جدید). اگر واحد ارتباطات، پیام را نادرست ترجمه کند (مثلاً مقدار ناکافی نوروترانسمیتر آزاد کند)، تصمیم مدیرعامل بهدرستی اجرا نمیشود. این مثال نشان میدهد که انتقال پیام در سازمان، بهاندازه خود پیام اهمیت دارد.
۳.۲.۲ سیناپس: ساختار و انواع
سیناپس، نقطه اتصال بین دو نورون است — جایی که اطلاعات از یک سلول به سلول دیگر منتقل میشود. واژه «سیناپس» از کلمه یونانی σύναψις (سیناپسیس) به معنای «اتصال» یا «بستن» گرفته شده است. سیناپسها، واحدهای بنیادین پردازش اطلاعات در مغز هستند و قدرت آنها، تعیینکننده وزن اتصالات در شبکههای عصبی است. در این بخش، به بررسی ساختار و انواع سیناپسها میپردازیم.
ساختار سیناپس شیمیایی
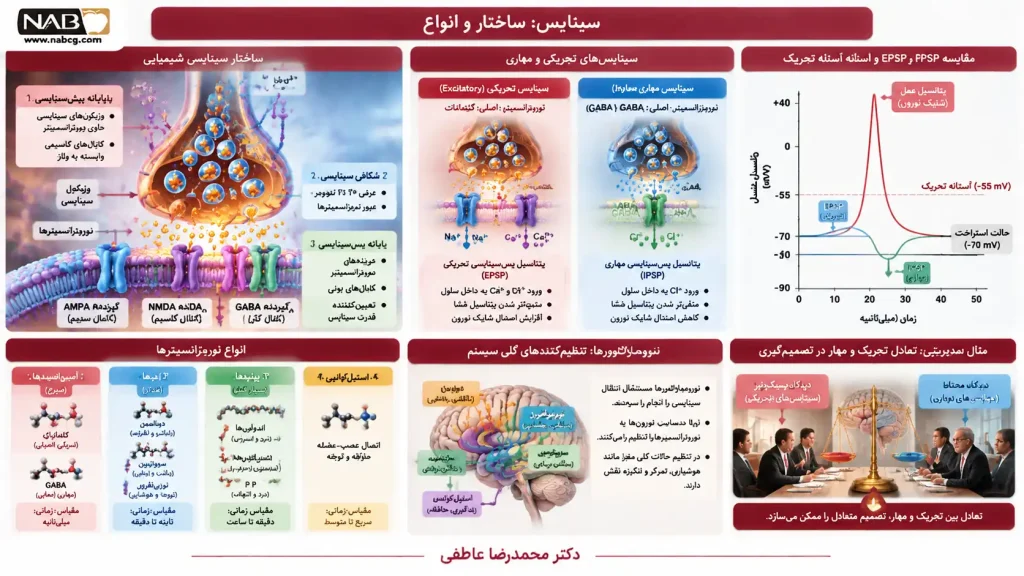
سیناپس شیمیایی، از سه بخش اصلی تشکیل شده است:
۱. پایانه پیشسیناپسی: این بخش، انتهای آکسون نورون فرستنده است که وزیکولهای سیناپسی حاوی نوروترانسمیتر را در خود جای داده است. غشای پیشسیناپسی، کانالهای کلسیمی وابسته به ولتاژ دارد که در پاسخ به دپلاریزاسیون باز میشوند و ورود Ca²⁺ را ممکن میسازند.
۲. شکاف سیناپسی: فضای باریک (۲۰ تا ۴۰ نانومتر) بین دو نورون که نوروترانسمیترها از آن عبور میکنند. عرض شکاف، تعیینکننده سرعت انتقال است: شکاف باریکتر، انتقال سریعتر.
۳. پایانه پسسیناپسی: این بخش، غشای نورون گیرنده است که گیرندههای نوروترانسمیتر را در خود جای داده است. این گیرندهها، کانالهای یونی هستند که در پاسخ به اتصال نوروترانسمیتر باز میشوند و جریان یونی ایجاد میکنند. چگالی گیرندهها در پایانه پسسیناپسی، قدرت سیناپس را تعیین میکند: گیرندههای بیشتر، پاسخ قویتر.
سیناپسهای تحریکی و مهاری
سیناپسها، بر اساس اثر آنها بر نورون پسسیناپسی، به دو دسته اصلی تقسیم میشوند:
- سیناپسهای تحریکی (Excitatory Synapses): این سیناپسها، احتمال شلیک نورون پسسیناپسی را افزایش میدهند. نوروترانسمیتر اصلی آنها گلوتامات است. وقتی گلوتامات به گیرندههای AMPA و NMDA متصل میشود، کانالهای یونی باز میشوند و یونهای سدیم (Na⁺) به داخل سلول سرازیر میشوند. این ورود یونهای مثبت، پتانسیل غشا را مثبتتر میکند — فرآیندی که پتانسیل پسسیناپسی تحریکی (EPSP) نامیده میشود. اگر مجموع EPSPها به آستانه تحریک برسد، نورون شلیک میکند.
- سیناپسهای مهاری (Inhibitory Synapses): این سیناپسها، احتمال شلیک نورون پسسیناپسی را کاهش میدهند. نوروترانسمیتر اصلی آنها GABA (در مغز) و گلیسین (در نخاع و ساقه مغز) است. وقتی GABA به گیرندههای GABA_A متصل میشود، کانالهای کلر (Cl⁻) باز میشوند و یونهای کلر به داخل سلول سرازیر میشوند. این ورود یونهای منفی، پتانسیل غشا را منفیتر میکند — فرآیندی که پتانسیل پسسیناپسی مهاری (IPSP) نامیده میشود. IPSPها، آستانه تحریک را دورتر میکنند و شلیک نورون را دشوارتر میسازند.
تعادل بین تحریک و مهار، حیاتی است. اگر تحریک بیش از حد باشد، نورون ممکن است بیوقفه شلیک کند و باعث صرع شود. اگر مهار بیش از حد باشد، نورون خاموش میماند و فلج میشود. در مغز سالم، این تعادل، دقیقاً تنظیم شده است — مشابه تعادل بین ریسکپذیری و احتیاط در تصمیمگیری سازمانی.
مثال مدیریتی: تعادل تحریک و مهار در تصمیمگیری سازمانی
فرض کنید یک کمیته سرمایهگذاری در یک صندوق بازنشستگی، باید درباره یک پروژه پرریسک تصمیم بگیرد. مدیران ریسکپذیر (سیناپسهای تحریکی) استدلال میکنند که پروژه پتانسیل بازده بالا دارد. مدیران محتاط (سیناپسهای مهاری) هشدار میدهند که پروژه ریسک از دست دادن سرمایه را دارد. اگر فقط مدیران ریسکپذیر در جلسه باشند، کمیته ممکن است تصمیم عجولانه بگیرد. اگر فقط مدیران محتاط باشند، کمیته ممکن است فرصت را از دست بدهد. تعادل بین این دو دیدگاه، تصمیم متعادل را ممکن میسازد. در مغز، همین تعادل بین سیناپسهای تحریکی و مهاری، از شلیکهای بیمورد و خاموشی کامل جلوگیری میکند.
نوروترانسمیترها و نورومدولاتورها
نوروترانسمیترها، مواد شیمیایی هستند که مستقیماً انتقال سیناپسی را انجام میدهند. آنها را میتوان به چند دسته تقسیم کرد:
۱. آمینواسیدها: گلوتامات (تحریکی اصلی) و GABA (مهاری اصلی). این نوروترانسمیترها، سریع عمل میکنند (در مقیاس میلیثانیه) و اکثر سیناپسهای مغز را تشکیل میدهند.
۲. آمینها: دوپامین، سروتونین، نوراپینفرین، هیستامین. این نوروترانسمیترها، کندتر عمل میکنند (در مقیاس ثانیه تا دقیقه) و حالات روانی، انگیزه، و توجه را تنظیم میکنند.
۳. پپتیدها: اندورفینها، انکفالینها، ماده P. این نوروترانسمیترها، بسیار کند عمل میکنند (در مقیاس دقیقه تا ساعت) و درد، استرس، و پاداش را تنظیم میکنند.
۴. استیلکولین: در اتصال عصب-عضله، حافظه، و توجه نقش دارد.
نورومدولاتورها، مواد شیمیایی هستند که بهطور غیرمستقیم بر انتقال سیناپسی تأثیر میگذارند. آنها گیرندههای خود را ندارند، بلکه حساسیت نورونها به نوروترانسمیترها را تنظیم میکنند. برای مثال، دوپامین میتواند حساسیت نورونها به گلوتامات را افزایش یا کاهش دهد. این ویژگی، به نورومدولاتورها اجازه میدهد که حالات کلی مغز (مانند هوشیاری، تمرکز، انگیزه) را تنظیم کنند.
مثال مدیریتی: نورومدولاتورها بهعنوان فرهنگ سازمانی
در یک سازمان، نوروترانسمیترها مانند دستورات مستقیم مدیران هستند: «این کار را انجام بده.» اما نورومدولاتورها مانند فرهنگ سازمانی هستند: «در این سازمان، ما به نوآوری اهمیت میدهیم» یا «ما محتاط و دقیق هستیم.» فرهنگ سازمانی، دستور مستقیم نمیدهد، اما رفتار کارکنان را تنظیم میکند: کارکنان در فرهنگی که نوآوری را تشویق میکند، ریسکپذیرتر هستند؛ در فرهنگی که محتاط است، محتاطتر عمل میکنند. به همین ترتیب، نورومدولاتورها حالت کلی مغز را تنظیم میکنند و تعیین میکنند که نورونها چگونه به نوروترانسمیترها پاسخ دهند.
۳.۲.۳ انتقال سیگنال: الکتریکی و شیمیایی
انتقال سیگنال در نورون، دو مرحله متمایز دارد: انتقال الکتریکی در طول آکسون، و انتقال شیمیایی در سیناپس. در این بخش، به بررسی این دو مرحله و مکانیزمهای مولکولی آنها میپردازیم.
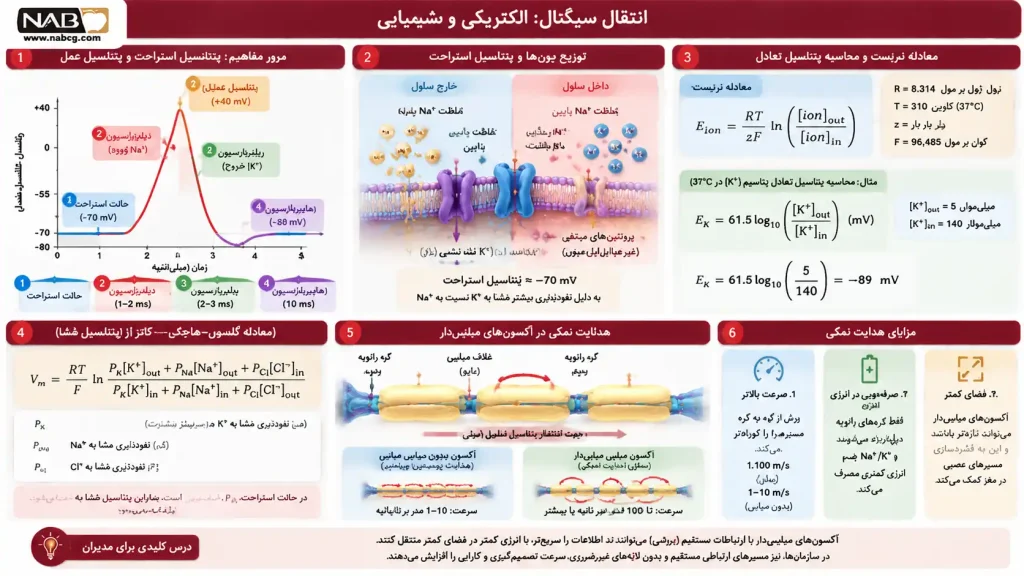
پتانسیل استراحت و پتانسیل عمل: مروری بر مفاهیم
در بخش ۳.۱.۳، مفاهیم پتانسیل استراحت، آستانه تحریک، دپلاریزاسیون، و رپلاریزاسیون را معرفی کردیم. در اینجا، به مکانیزم مولکولی این فرآیندها میپردازیم.
پتانسیل استراحت (حدود ۷۰- میلیولت) نتیجه توزیع نامتقارن یونها در دو طرف غشا و نفوذپذیری انتخابی غشا به یونهای مختلف است. در حالت استراحت، غشا به یونهای پتاسیم (K⁺) نفوذپذیرتر از یونهای سدیم (Na⁺) است. این بدان معناست که K⁺ میتواند آزادانهتر از غشا عبور کند، در حالی که Na⁺ بهسختی عبور میکند. در نتیجه، پتانسیل استراحت به پتانسیل تعادل پتاسیم نزدیکتر است.
معادله نرنست (Nernst Equation) پتانسیل تعادل یک یون را محاسبه میکند:
که در آن:
- Eion پتانسیل تعادل یون (بر حسب ولت) است.
- R ثابت گازها (۸.۳۱۴ ژول بر مول-کلوین) است.
- TT دمای مطلق (بر حسب کلوین) است.
- z بار یون (برای K⁺ و Na⁺ برابر ۱+، برای Cl⁻ برابر ۱-) است.
- F ثابت فارادی (۹۶٬۴۸۵ کولن بر مول) است.
- [ion]out و [ion]in غلظت یون در خارج و داخل سلول هستند.
برای یون پتاسیم در دمای ۳۷ درجه سانتیگراد (۳۱۰ کلوین)، این معادله به شکل سادهتر زیر درمیآید:
اگر غلظت K⁺ در خارج سلول ۵ میلیمولار و در داخل سلول ۱۴۰ میلیمولار باشد، آنگاه:
این مقدار، پتانسیل تعادل پتاسیم است — یعنی پتانسیلی که در آن، نیروی الکتریکی و نیروی غلظتی بر یونهای K⁺ تعادل برقرار میکنند. پتانسیل استراحت نورون (۷۰- میلیولت) نزدیک به این مقدار است، اما دقیقاً برابر آن نیست، زیرا غشا به یونهای دیگر (مانند Na⁺ و Cl⁻) نیز نفوذپذیری جزئی دارد.
معادله گلدمن-هاجکین-کاتز (Goldman-Hodgkin-Katz Equation) پتانسیل غشا را با در نظر گرفتن نفوذپذیری نسبی یونهای مختلف محاسبه میکند:
که در آن PK، PNa، و PCl نفوذپذیری غشا به یونهای پتاسیم، سدیم، و کلر هستند. در حالت استراحت، PK بسیار بیشتر از PNa است، بنابراین پتانسیل غشا به EK نزدیک میشود.
پتانسیل عمل، زمانی رخ میدهد که کانالهای سدیم وابسته به ولتاژ باز شوند و PNa بهشدت افزایش یابد. در این حالت، پتانسیل غشا به سمت ENa (حدود ۵۵+ میلیولت)حرکت میکند. این دپلاریزاسیون سریع، پتانسیل عمل را تولید میکند. سپس، کانالهای پتاسیم وابسته به ولتاژ باز میشوند و PK افزایش مییابد، که باعث رپلاریزاسیون و بازگشت به حالت استراحت میشود.
هدایت نمکی در آکسونهای میلیندار
همانطور که در بخش ۳.۲.۱.۳ اشاره کردیم، میلین سرعت انتقال پتانسیل عمل را بهشدت افزایش میدهد. در آکسونهای بدون میلین، پتانسیل عمل باید تمام طول آکسون را بهصورت پیوسته طی کند — فرآیندی کند و پرهزینه از نظر انرژی. در آکسونهای میلیندار، پتانسیل عمل از یک گره رانویه به گره بعدی میپرد — فرآیندی که هدایت نمکی (Saltatory Conduction) نامیده میشود.
مزایای هدایت نمکی:
۱. سرعت بالاتر: پرش از گره به گره، مسیر مؤثر را کوتاهتر میکند. سرعت انتقال در آکسونهای میلیندار، تا ۱۰۰ متر بر ثانیه یا بیشتر میرسد — در حالی که در آکسونهای بدون میلین، حداکثر ۱ تا ۱۰ متر بر ثانیه است.
۲. صرفهجویی در انرژی: در هدایت پیوسته، تمام غشا باید دپلاریزه و رپلاریزه شود — که به پمپ سدیم-پتاسیم (که ATP مصرف میکند) انرژی زیادی نیاز دارد. در هدایت نمکی، فقط گرههای رانویه دپلاریزه میشوند — که انرژی کمتری مصرف میکند.
۳. فضای کمتر: آکسونهای میلیندار میتوانند نازکتر باشند، زیرا میلین عایق است و نیاز به قطر زیاد برای هدایت سریع را کاهش میدهد. این ویژگی، به فشردهسازی مسیرهای عصبی در مغز کمک میکند.
مثال مدیریتی: هدایت نمکی بهعنوان تصمیمگیری سریع در بحران
فرض کنید یک شرکت با بحران ناگهانی (مانند حمله سایبری) مواجه است. در یک سازمان سنتی با زنجیره فرماندهی طولانی (آکسون بدون میلین)، اطلاعرسانی بحران به تمام سطوح زمان میبرد و تصمیمگیری کند میشود. در یک سازمان چابک با کانالهای ارتباطی مستقیم (آکسون میلیندار)، مدیرعامل میتواند مستقیماً با تیم فنی و تیم حقوقی ارتباط برقرار کند و در کمترین زمان تصمیم بگیرد. هدایت نمکی، دقیقاً همین پرش از سطوح میانی را ممکن میسازد و سرعت پاسخ را چند برابر میکند.
انتقال سیناپسی: از سیگنال الکتریکی تا شیمیایی و بازگشت
انتقال سیناپسی، زنجیرهای از رویدادها است که سیگنال الکتریکی را به سیگنال شیمیایی و سپس دوباره به سیگنال الکتریکی تبدیل میکند. این زنجیره، شامل مراحل زیر است:
- گام ۱: ورود کلسیم. پتانسیل عمل به پایانه پیشسیناپسی میرسد و کانالهای کلسیمی وابسته به ولتاژ را باز میکند. یونهای Ca²⁺ به داخل پایانه سرازیر میشوند.
- گام ۲: ادغام وزیکول. افزایش Ca²⁺ داخل سلولی، وزیکولهای سیناپسی را به غشای پیشسیناپسی نزدیک میکند و ادغام آنها را ممکن میسازد. این فرآیند، برونریزی (Exocytosis) نامیده میشود.
- گام ۳: آزادسازی نوروترانسمیتر. نوروترانسمیترها به شکاف سیناپسی آزاد میشوند و منتشر میگردند.
- گام ۴: اتصال به گیرنده. نوروترانسمیترها به گیرندههای روی غشای پسسیناپسی متصل میشوند. این اتصال، کانالهای یونی را باز میکند.
- گام ۵: جریان یونی و تولید EPSP/IPSP. ورود یا خروج یونها، پتانسیل غشا را تغییر میدهد. اگر جریان مثبت باشد، EPSP (تحریکی) تولید میشود؛ اگر منفی باشد، IPSP (مهاری) تولید میشود.
- گام ۶: ادغام سیناپسی. EPSPها و IPSPها در جسم سلولی و تپه آکسونی جمع میشوند. اگر مجموع به آستانه تحریک برسد، پتانسیل عمل جدید تولید میشود.
- گام ۷: بازجذب یا تجزیه نوروترانسمیتر. نوروترانسمیترهای باقیمانده در شکاف، بازجذب (Reuptake) میشوند یا توسط آنزیمها تجزیه میگردند. این فرآیند، پاکسازی سیناپسی را ممکن میسازد و از تحریک مداوم جلوگیری میکند.
این زنجیره، دقیقاً مشابه یک فرآیند تصمیمگیری سازمانی است: دریافت اطلاعات (ورود کلسیم)، تحلیل و تفسیر (ادغام وزیکول)، ابلاغ (آزادسازی نوروترانسمیتر)، اجرا (اتصال به گیرنده)، و بازخورد (ادغام سیناپسی). هر اختلال در این زنجیره — مانند کمبود کلسیم، نقص در وزیکولها، یا کمبود گیرندهها — میتواند به اختلال در انتقال پیام و بیماریهای عصبی منجر شود.
۳.۲.۴ انواع نورونها: چندقطبی، دوقطبی، شبهتکقطبی، و بیآکسون
نورونها، برخلاف ظاهر مشابهشان، تنوع ساختاری قابلتوجهی دارند. این تنوع، انطباق آنها با وظایف خاص در نقاط مختلف مغز و بدن را ممکن میسازد. در این بخش، چهار نوع اصلی نورون را بررسی میکنیم.
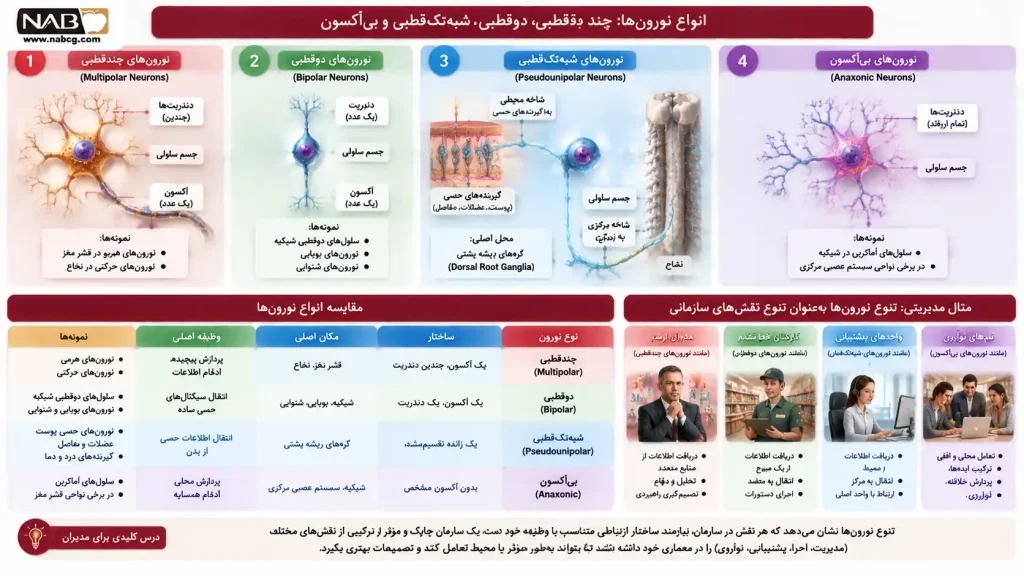
۱. نورونهای چندقطبی (Multipolar Neurons): این نورونها یک آکسون و چندین دندریت دارند. این نوع، رایجترین نوع نورون در مغز و نخاع است. نورونهای هرمی (Pyramidal Cells) در قشر مغز و نورونهای حرکتی در نخاع، نمونههایی از این دسته هستند. نورونهای چندقطبی، مسئول پردازش پیچیده و ادغام اطلاعات از منابع متعدد هستند.
۲. نورونهای دوقطبی (Bipolar Neurons): این نورونها یک آکسون و یک دندریت دارند که از دو طرف مقابل جسم سلولی خارج میشوند. این نوع، نادر است و عمدتاً در سیستمهای حسی ویژه یافت میشود: سلولهای دوقطبی شبکیه (که اطلاعات را از گیرندههای نوری به سلولهای گانگلیونی منتقل میکنند)، نورونهای بویایی، و نورونهای شنوایی. نورونهای دوقطبی، مسئول انتقال سیگنالهای حسی ساده هستند.
۳. نورونهای شبهتکقطبی (Pseudounipolar Neurons): این نورونها یک زائده دارند که از جسم سلولی خارج میشود و سپس به دو شاخه تقسیم میگردد: یکی به محیط (پوست، عضلات، مفاصل) و دیگری به نخاع. این نوع، در گرههای ریشه پشتی (Dorsal Root Ganglia) یافت میشود و مسئول انتقال اطلاعات حسی از بدن به نخاع است. جالب است که این نورونها دندریت واقعی ندارند؛ شاخه محیطی آنها مستقیماً به گیرندههای حسی متصل است و شاخه مرکزی آنها به نخاع میرود.
۴. نورونهای بیآکسون (Anaxonic Neurons): این نورونها آکسون قابل تشخیصی ندارند و تمام زوائد آنها شبیه دندریت هستند. این نوع، نادر است و عمدتاً در شبکیه و سیستم عصبی مرکزی یافت میشود. سلولهای آماکرین (Amacrine Cells) در شبکیه، نمونهای از این دسته هستند. این نورونها، مسئول پردازش محلی و ادغام سیگنالهای همسایه هستند.
| نوع نورون | ساختار | مکان اصلی | وظیفه اصلی |
| چندقطبی | یک آکسون، چندین دندریت | قشر مغز، نخاع | پردازش پیچیده، ادغام اطلاعات |
| دوقطبی | یک آکسون، یک دندریت | شبکیه، بویایی، شنوایی | انتقال سیگنالهای حسی ساده |
| شبهتکقطبی | یک زائده تقسیمشده | گرههای ریشه پشتی | انتقال اطلاعات حسی از بدن |
| بیآکسون | بدون آکسون مشخص | شبکیه، سیستم عصبی مرکزی | پردازش محلی، ادغام همسایه |
مثال مدیریتی: تنوع نورونها بهعنوان تنوع نقشهای سازمانی
در یک سازمان، نقشهای مختلف نیازمند ساختارهای ارتباطی متفاوت هستند. مدیران ارشد (نورونهای چندقطبی) نیازمند دریافت اطلاعات از منابع متعدد و ادغام آنها هستند. کارکنان خط مقدم (نورونهای دوقطبی) اطلاعات را از یک منبع دریافت و به یک مقصد منتقل میکنند. واحدهای پشتیبانی (نورونهای شبهتکقطبی) اطلاعات را از محیط دریافت و به مرکز منتقل میکنند. تیمهای نوآوری (نورونهای بیآکسون) بهصورت محلی و افقی با یکدیگر تعامل دارند و ایدهها را ترکیب میکنند. تنوع نورونها، آینهای از تنوع نقشهای سازمانی است — و هر سازمانی که میخواهد چابک و مؤثر باشد، باید تنوع ساختاری را در معماری سازمانی خود بگنجاند.
۳.۲.۵ مثال گسترده: محاسبه تعداد سیناپسها و مقایسه با شبکههای مصنوعی
برای درک مقیاس شبکههای عصبی زیستی و تفاوت آنها با شبکههای مصنوعی، بیایید یک محاسبه ساده اما روشنگر انجام دهیم.
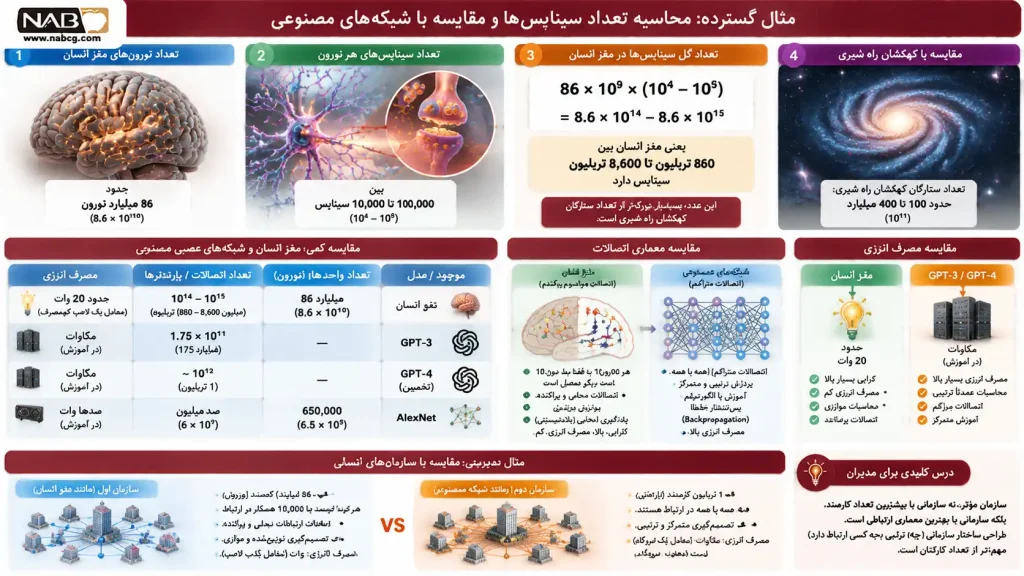
محاسبه تعداد سیناپسها در مغز انسان:
- تعداد نورونهای مغز انسان: حدود ۸۶ میلیارد.
- تعداد سیناپسهای هر نورون: بین ۱۰٬۰۰۰ تا ۱۰۰٬۰۰۰.
- بنابراین، تعداد کل سیناپسها:
یعنی مغز انسان بین ۸۶۰ تریلیون تا ۸٬۶۰۰ تریلیون سیناپس دارد. این عدد، بسیار بزرگتر از تعداد ستارگان کهکشان راه شیری (حدود ۱۰۰ تا ۴۰۰ میلیارد) است.
مقایسه با شبکههای عصبی مصنوعی:
بزرگترین مدلهای زبانی امروزی، مانند GPT-3، حدود ۱۷۵ میلیارد پارامتر (۱.۷۵ × ۱۰¹¹) دارند GPT-4. احتمالاً حدود ۱ تریلیون پارامتر (۱۰¹²) دارد. حتی با این اعداد، مغز انسان حدود ۱۰۰ تا ۱۰٬۰۰۰ برابر پارامتر بیشتری دارد.
| موجود/مدل | تعداد واحدها | تعداد اتصالات/پارامترها | مصرف انرژی |
| مغز انسان | ۸۶ میلیارد نورون | ۱۰¹⁴–۱۰¹⁵ سیناپس | حدود ۲۰ وات |
| GPT-3 | — | ۱.۷۵ × ۱۰¹¹ پارامتر | مگاوات (در آموزش) |
| GPT-4 | — | ~۱۰¹² پارامتر | مگاوات (در آموزش) |
| AlexNet | ۶۵۰٬۰۰۰ نورون | ۶۰ میلیون پارامتر | صدها وات |
نکته کلیدی: مغز انسان، با وجود ۱۰۰ تا ۱۰٬۰۰۰ برابر اتصالات بیشتر، تنها ۲۰ وات انرژی مصرف میکند — معادل یک لامپ کممصرف. در مقابل، آموزش GPT-3 به مگاوات انرژی نیاز داشت. این کارایی خیرهکننده مغز، نتیجه معماری بهینه آن است: اتصالات پراکنده (هر نورون فقط به کسری کوچک از نورونهای دیگر متصل است)، پردازش موازی، و یادگیری محلی (پلاستیسیتی سیناپسی). در شبکههای مصنوعی، اتصالات متراکم (Dense) و آموزش متمرکز (Backpropagation) باعث مصرف انرژی بالا میشود.
مثال مدیریتی: مقایسه مغز و شبکه مصنوعی با سازمانهای انسانی
فرض کنید دو سازمان را مقایسه میکنیم:
- سازمان اول (مغز): ۸۶ میلیارد کارمند (نورون) دارد که هر یک با ۱۰٬۰۰۰ همکار مستقیماً در ارتباط است. اما این ارتباطات محلی و پراکنده هستند: هر کارمند فقط با کسری کوچک از ۸۶ میلیارد همکار (یعنی ۱۰٬۰۰۰ نفر) ارتباط دارد. تصمیمگیری توزیعشده و موازی است. مصرف انرژی سازمان: ۲۰ وات (معادل یک لامپ).
- سازمان دوم (شبکه مصنوعی): ۱ تریلیون کارمند (پارامتر) دارد که همه با همه در ارتباط هستند (اتصالات متراکم). تصمیمگیری متمرکز و ترتیبی است. مصرف انرژی: مگاوات (معادل یک نیروگاه کوچک).
درس: سازمان مؤثر، نه سازمانی با بیشترین تعداد کارمند، بلکه سازمانی با بهترین معماری ارتباطی است. مغز، با اتصالات پراکنده و محلی، به کارایی بینظیری دست یافته است. برای مدیران، این درس به این معناست که طراحی ساختار سازمانی (چه کسی با چه کسی ارتباط دارد) مهمتر از تعداد کارکنان است.
جمعبندی بخش ۳.۲: چه چیزی از نورون زیستی میآموزیم؟
در این بخش، کالبدشناسی و عملکرد نورون زیستی را از جسم سلولی تا پایانههای آکسونی، از سیناپسهای تحریکی و مهاری تا نوروترانسمیترها و نورومدولاتورها، و از پتانسیل استراحت تا هدایت نمکی بررسی کردیم. آنچه دیدیم، فراتر از یک درس عصبشناسی بود؛ ما شاهد اصول طراحی بودیم که میتوانند الهامبخش طراحی سیستمهای هوش مصنوعی و معماری سازمانی باشند:
۱. نورون، یک جمعکننده ساده نیست. نورون زیستی، دارای دندریتهای غیرخطی، سیناپسهای پویا، و مکانیزمهای تنظیمی متعدد است. این پیچیدگی، به آن قدرت پردازشی بسیار بیشتری از یک نورون مصنوعی ساده میدهد.
۲. تعادل تحریک و مهار، حیاتی است. بدون مهار، شبکه بیثبات میشود؛ بدون تحریک، شبکه خاموش میماند. این اصل، در طراحی شبکههای عصبی مصنوعی (با نرخ یادگیری مناسب و منظمسازی) و مدیریت سازمانی (با تعادل ریسک و احتیاط) کاربرد دارد.
۳. انتقال سیگنال، چندمرحلهای و تنظیمپذیر است. از پتانسیل عمل تا آزادسازی نوروترانسمیتر تا اتصال به گیرنده، هر مرحله فرصتی برای تنظیم فراهم میکند. این انعطافپذیری، پایه یادگیری و حافظه است.
۴. تنوع نورونها، آینه تنوع وظایف است. نورونهای چندقطبی، دوقطبی، شبهتکقطبی، و بیآکسون، هر یک برای وظیفه خاصی تخصص یافتهاند. این تخصصیافتگی، در معماریهای شبکههای عصبی مصنوعی (مانند CNN برای تصویر، RNN برای توالی، Transformer برای زبان) بازتولید شده است.
۵. مقیاس مغز، الهامبخش اما هشداردهنده است. مغز با ۱۰¹⁵ سیناپس و ۲۰ وات انرژی، کارایی بینظیری دارد. شبکههای مصنوعی، با وجود پارامترهای کمتر، انرژی بیشتری مصرف میکنند. این تفاوت، نشان میدهد که معماری بهینه — نه فقط مقیاس — کلید کارایی است.
درس نهایی برای مدیران: نورون زیستی، یک مدل کوچک از یک سازمان ایدهآل است: دریافت اطلاعات از منابع متعدد (دندریتها)، ادغام و پردازش (جسم سلولی)، انتقال تصمیم (آکسون)، ترجمه به زبان قابل فهم (پایانه آکسونی)، و تنظیم دقیق (سیناپسها). سازمانهایی که این اصول را در معماری ارتباطی، فرآیندهای تصمیمگیری، و فرهنگ یادگیری خود پیادهسازی کنند، میتوانند چابکتر، مؤثرتر، و پایدارتر از رقبای خود عمل کنند.
منابع بخش ۳.۲
Alberts, B., Johnson, A., Lewis, J., Morgan, D., Raff, M., Roberts, K., & Walter, P. (2022). Molecular biology of the cell (7th ed.). W. W. Norton & Company.
Bear, M. F., Connors, B. W., & Paradiso, M. A. (2016). Neuroscience: Exploring the brain (4th ed.). Wolters Kluwer.
Bliss, T. V. P., & Lømo, T. (1973). Long-lasting potentiation of synaptic transmission in the dentate area of the anaesthetized rabbit following stimulation of the perforant path. The Journal of Physiology, *232*(2), 331–356. https://doi.org/10.1113/jphysiol.1973.sp010273
Brown, T. H., Kairiss, E. W., & Keenan, C. L. (1990). Hebbian synapses: Biophysical mechanisms and algorithms. Annual Review of Neuroscience, *13*, 475–511. https://doi.org/10.1146/annurev.ne.13.030190.002355
Caporale, N., & Dan, Y. (2008). Spike timing-dependent plasticity: A Hebbian learning rule. Annual Review of Neuroscience, *31*, 25–46. https://doi.org/10.1146/annurev.neuro.31.060407.125639
Dan, Y., & Poo, M.-M. (2006). Spike timing-dependent plasticity: From synapse to perception. Physiological Reviews, *86*(3), 1033–1048. https://doi.org/10.1152/physrev.00030.2005
Dayan, P., & Abbott, L. F. (2001). Theoretical neuroscience: Computational and mathematical modeling of neural systems. MIT Press.
Destexhe, A., & Paré, D. (1999). Impact of network activity on the integrative properties of neocortical pyramidal neurons in vivo. Journal of Neurophysiology, *81*(4), 1531–1547. https://doi.org/10.1152/jn.1999.81.4.1531
Eccles, J. C. (1964). The physiology of synapses. Springer.
Fatt, P., & Katz, B. (1951). An analysis of the end-plate potential recorded with an intracellular electrode. The Journal of Physiology, *115*(3), 320–370. https://doi.org/10.1113/jphysiol.1951.sp004675
Gerstner, W., Kistler, W. M., Naud, R., & Paninski, L. (2014). Neuronal dynamics: From single neurons to networks and models of cognition. Cambridge University Press.
Gómez, C. M., Arjona, A., Ruiz-Martínez, F. J., Muñoz-Caracuel, M., Muñoz, V., & Rodriguez-Martínez, E. I. (2026). An event-related potentials account of brain predictive coding. Cognitive Neurodynamics, *20*, Article 10491. https://doi.org/10.1007/s11571-026-10491-7
Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley.
Hodgkin, A. L., & Huxley, A. F. (1952). A quantitative description of membrane current and its application to conduction and excitation in nerve. The Journal of Physiology, *117*(4), 500–544. https://doi.org/10.1113/jphysiol.1952.sp004764
Hubel, D. H., & Wiesel, T. N. (1962). Receptive fields, binocular interaction and functional architecture in the cat’s visual cortex. The Journal of Physiology, *160*(1), 106–154. https://doi.org/10.1113/jphysiol.1962.sp006837
Kandel, E. R., Koester, J. D., Mack, S. H., & Siegelbaum, S. A. (2021). Principles of neural science (6th ed.). McGraw-Hill.
Katz, B., & Miledi, R. (1967). The timing of calcium action during neuromuscular transmission. The Journal of Physiology, *189*(3), 535–544. https://doi.org/10.1113/jphysiol.1967.sp008183
Lodish, H., Berk, A., Kaiser, C. A., Krieger, M., Bretscher, A., Ploegh, H., Amon, A., & Martin, K. C. (2021). Molecular cell biology (9th ed.). W. H. Freeman.
Magee, J. C., & Grienberger, C. (2020). Synaptic plasticity forms and functions. Annual Review of Neuroscience, *43*, 95–117. https://doi.org/10.1146/annurev-neuro-090919-022842
Malenka, R. C., & Bear, M. F. (2004). LTP and LTD: An embarrassment of riches. Neuron, *44*(1), 5–21. https://doi.org/10.1016/j.neuron.2004.09.012
Montague, P. R., Dayan, P., & Sejnowski, T. J. (1996). A framework for mesencephalic dopamine systems based on predictive Hebbian learning. Journal of Neuroscience, *16*(5), 1936–1947. https://doi.org/10.1523/JNEUROSCI.16-05-01936.1996
Mountcastle, V. B. (1957). Modality and topographic properties of single neurons of cat’s somatic sensory cortex. Journal of Neurophysiology, *20*(4), 408–434. https://doi.org/10.1152/jn.1957.20.4.408
Neher, E., & Sakmann, B. (1976). Single-channel currents recorded from membrane of denervated frog muscle fibres. Nature, *260*(5554), 799–802. https://doi.org/10.1038/260799a0
Nicholls, J. G., Martin, A. R., Fuchs, P. A., Brown, D. A., Diamond, M. E., & Weisblat, D. A. (2012). From neuron to brain (5th ed.). Sinauer Associates.
Purves, D., Augustine, G. J., Fitzpatrick, D., Hall, W. C., LaMantia, A.-S., Mooney, R. D., Platt, M. L., & White, L. E. (2018). Neuroscience (6th ed.). Oxford University Press.
Schultz, W. (1998). Predictive reward signal of dopamine neurons. Journal of Neurophysiology, *80*(1), 1–27. https://doi.org/10.1152/jn.1998.80.1.1
Squire, L. R., Berg, D., Bloom, F. E., du Lac, S., Ghosh, A., & Spitzer, N. C. (2013). Fundamental neuroscience (4th ed.). Academic Press.
Sterratt, D., Graham, B., Gillies, A., & Willshaw, D. (2011). Principles of computational modelling in neuroscience. Cambridge University Press.
Stingl, M., Draguhn, A., & Both, M. (2025). A dendrite is a dendrite is a dendrite? Dendritic signal integration beyond the “antenna” model. Pflügers Archiv – European Journal of Physiology, *477*, 9–16. https://doi.org/10.1007/s00424-024-03004-0
Torcini, A. (2015). The Hodgkin-Huxley model [Lecture notes]. Université d’Aix-Marseille. https://perso.u-cergy.fr/~atorcini/MATDID/NEURO/HH15.pdf
Zaki, Y., & Cai, D. J. (2024). Memory engram stability and flexibility. Neuropsychopharmacology, *49*, 1–10. https://doi.org/10.1038/s41386-024-01940-0