۳.۳ دندریتها: کامپیوترهای غیرخطی
مسئله آغازین: فرض کنید یک مدیرعامل میخواهد بداند چرا یک پروژه خاص در سازمانش موفق شده است. او دادههای مربوط به دهها عامل را جمعآوری میکند: بودجه، تعداد نیروی انسانی، مهارت تیم، زمانبندی، حمایت مدیریت ارشد، شرایط بازار، و دهها عامل دیگر. سپس از یک تحلیلگر میخواهد که «همه را با هم جمع کند» و بگوید کدام ترکیب از عوامل، به موفقیت منجر شده است.
تحلیلگر، همه دادهها را در یک مدل خطی ساده وارد میکند و به مدیر میگوید: «عواملی که وزن بالاتری دارند، مهمترند.» اما مدیر احساس میکند چیزی درست نیست. او میداند که موفقیت پروژه، حاصل ترکیب خاصی از عوامل بوده است — نه صرفاً جمع ساده آنها. مثلاً پروژه فقط زمانی موفق میشود که هم حمایت مدیریت ارشد باشد و هم تیم مهارت کافی داشته باشد؛ اگر یکی از این دو نباشد، پروژه شکست میخورد. این یک رابطه غیرخطی است — و مدل خطی ساده، از عهده آن برنمیآید.
دقیقاً همین مشکل، در نورونهای مصنوعی ساده (Point Neurons) وجود دارد. نورون نقطهای، تمام ورودیها را با یک جمع وزنی ساده ترکیب میکند و اگر از آستانه عبور کرد، شلیک میکند. اما نورونهای زیستی، اینگونه نیستند. آنها ساختار پیچیدهای به نام دندریت دارند که به آنها اجازه میدهد محاسبات غیرخطی انجام دهند — محاسباتی که درست مانند همان مدیرعامل، ترکیبهای خاص را تشخیص میدهند، نه فقط جمع ساده را. در این بخش، به بررسی این «کامپیوترهای غیرخطی» میپردازیم و میبینیم که چگونه کشف نقش محاسباتی دندریتها، درک ما از نورون و شبکههای عصبی را برای همیشه تغییر داده است.
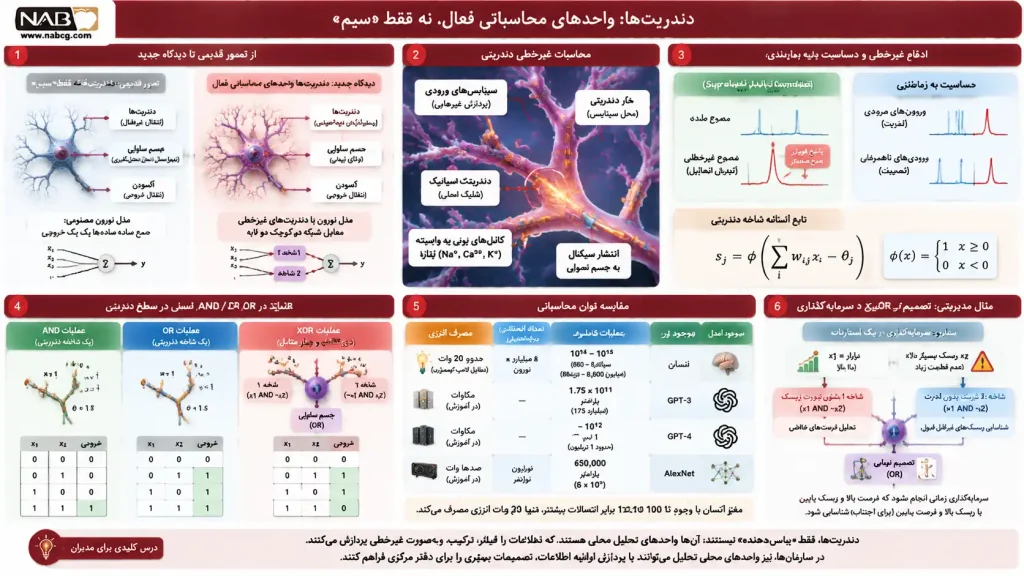
۳.۳.۱ مقدمه: چرا دندریتها فقط «سیم» نیستند
برای دههها، تصور غالب در عصبشناسی این بود که دندریتها فقط سیمهای غیرفعال هستند: سیگنالهای الکتریکی را از سیناپسها دریافت میکنند و آنها را به جسم سلولی میرسانند، بدون اینکه هیچ پردازش معناداری انجام دهند. در این تصویر، نورون شبیه یک مرکز تلفن قدیمی بود: دندریتها مانند سیمهای تلفن، فقط سیگنال را منتقل میکردند و جسم سلولی، تنها جایی بود که «تصمیم» گرفته میشد. این تصویر، در مدلهای اولیه شبکههای عصبی مصنوعی — از پرسپترون روزنبلات تا مدلهای امروزی — بازتولید شد. در این مدلها، هر نورون مصنوعی یک واحد ساده است که تمام ورودیها را جمع میکند و یک خروجی تولید میکند. هیچ ساختار میانی، هیچ پردازش محلی، و هیچ غیرخطیبودن در سطح ورودی وجود ندارد.
اما از دهه ۱۹۶۰، شواهد تجربی شروع به چالش کشیدن این تصویر کرد. ویلفرد رال (Wilfred Rall)، ریاضیدان و عصبشناس، با مدلسازی ریاضی دندریتها نشان داد که شکل و هندسه دندریت بر نحوه ادغام سیگنالها تأثیر میگذارد (Rall, 1964). رال دریافت که دندریتها، برخلاف سیمهای ساده، مقاومت و ظرفیت الکتریکی دارند و این خواص، سیگنالها را تضعیف و تأخیر میکنند. اما کشف بزرگتر، در دهه ۱۹۸۰ و ۱۹۹۰ رخ داد: دندریتها کانالهای یونی وابسته به ولتاژ دارند — همان کانالهایی که در آکسون پتانسیل عمل تولید میکنند. این بدان معناست که دندریتها میتوانند خودشان شلیک کنند (دندریتیک اسپایک) و سیگنالهای ورودی را بهصورت غیرخطی ترکیب کنند (Koch et al., 1983; London & Häusser, 2005).
این کشف، انقلابی بود. اگر دندریتها فقط سیم نیستند، بلکه واحدهای محاسباتی فعال هستند، آنگاه یک نورون منفرد، بسیار قدرتمندتر از یک جمعکننده ساده است. یک نورون هرمی قشری، با دندریتهای پیچیدهاش، میتواند معادل یک شبکه کوچک دو لایه باشد (Poirazi et al., 2003). این بدان معناست که مغز، با ۸۶ میلیارد نورون، در واقع دارای ۸۶ میلیارد شبکه کوچک است — نه ۸۶ میلیارد واحد ساده. این کشف، درک ما از توان محاسباتی مغز را بهشدت افزایش داد و الهامبخش نسل جدیدی از شبکههای عصبی مصنوعی شد که از دندریتهای غیرخطی استفاده میکنند.
مثال مدیریتی: دندریتها بهعنوان واحدهای تحلیل محلی
در یک سازمان بزرگ، دفتر مرکزی (جسم سلولی) نمیتواند تمام اطلاعات خام را از تمام شعبهها دریافت کند و همه را در یک جلسه بررسی کند. اگر چنین کند، سیل اطلاعات او را غرق میکند. در عوض، سازمانهای مؤثر، واحدهای تحلیل محلی (دندریتها) دارند: هر واحد، اطلاعات محدوده خود را جمعآوری، فیلتر، و تحلیل میکند و سپس خلاصهای معنادار به دفتر مرکزی میفرستد. این واحدها، فقط «پاسدهنده» نیستند؛ آنها الگوهای محلی را تشخیص میدهند و سیگنالهای مهم را تقویت میکنند. دندریتها دقیقاً همین نقش را در نورون ایفا میکنند: آنها واحدهای تحلیل محلی هستند که قبل از رسیدن اطلاعات به جسم سلولی، آن را پردازش غیرخطی میکنند.
۳.۳.۲ محاسبات غیرخطی دندریتی
حالا به قلب ماجرا میرسیم: دندریتها چگونه محاسبات غیرخطی انجام میدهند؟ برای پاسخ، ابتدا باید بفهمیم که غیرخطی یعنی چه. یک عملیات خطی، مانند جمع ساده، ویژگی جمعپذیری دارد: f(x+y)=f(x)+f(y). یک عملیات غیرخطی، این ویژگی را ندارد. برای مثال، تابع آستانه (Threshold) غیرخطی است: اگر ورودی از آستانه عبور کند، خروجی ۱ میدهد؛ در غیر این صورت ۰. این تابع، جمعپذیر نیست: f(0.6)=0 و f(0.6)=0، اما f(0.6+0.6)=f(1.2)=1. این غیرخطی بودن، همان چیزی است که به نورون اجازه میدهد تصمیمگیری کند — نه فقط جمعکردن.
دندریتها، به چند طریق غیرخطی عمل میکنند:
۱. کانالهای یونی وابسته به ولتاژ: دندریتها دارای کانالهای سدیم، کلسیم، و پتاسیم هستند. وقتی سیگنالهای تحریکی متعدد به یک شاخه دندریتی میرسند، میتوانند پتانسیل غشا را به آستانه برسانند و یک دندریتیک اسپایک تولید کنند. این اسپایک، یک پدیده همهیاهیچ است — دقیقاً مانند پتانسیل عمل در آکسون. بنابراین، دندریت بهعنوان یک واحد تصمیم محلی عمل میکند: اگر ورودیهای کافی (و همزمان) دریافت کند، شلیک میکند.
۲. ادغام غیرخطی ورودیها: وقتی دو ورودی به یک شاخه دندریتی میرسند، اثر آنها جمع ساده نیست. اگر همزمان باشند، میتوانند تقویت متقابل کنند (Supralinear Summation)؛ اگر با فاصله زمانی باشند، ممکن است تضعیف شوند. این حساسیت به زمانبندی، به دندریت اجازه میدهد که الگوهای زمانی را تشخیص دهد — چیزی که یک جمعکننده ساده قادر به انجام آن نیست.
۳. مهار متقابل بین شاخهها: شاخههای دندریتی میتوانند یکدیگر را مهار کنند. اگر یک شاخه فعال شود، ممکن است شاخه دیگر را خاموش کند. این مهار متقابل، به دندریتها اجازه میدهد که رقابت بین الگوهای مختلف را مدلسازی کنند — دقیقاً مشابه رقابت بین گزینهها در تصمیمگیری سازمانی.
عملیات منطقی AND/OR/XOR در سطح دندریت
برای درک بهتر، بیایید ببینیم چگونه یک نورون با دندریتهای غیرخطی میتواند عملیات منطقی را انجام دهد. فرض کنید یک نورون با دو شاخه دندریتی داریم و هر شاخه، دو ورودی دریافت میکند. خروجی هر شاخه، تابعی آستانهای از مجموع ورودیهایش است:
که در آن:
- sj خروجی شاخه دندریتی jj است.
- xi ورودی i است.
- wij وزن اتصال ورودی i به شاخه j است.
- θj آستانه شاخه j است.
- ϕ تابع آستانه است: اگر آرگومان بزرگتر یا مساوی صفر باشد، ۱؛ در غیر این صورت ۰.
و خروجی نهایی نورون (جسم سلولی) به این صورت است:
که در آن vj وزن اتصال شاخه j به جسم سلولی و θy آستانه جسم سلولی است.
- عملیاتAND: برای پیادهسازی AND، کافی است یک شاخه با آستانه بالا داشته باشیم. اگر هر دو ورودی ۱ باشند، مجموع =2و از آستانه 1.5 عبور میکند؛ اگر فقط یکی ۱ باشد، مجموع 1= و از آستانه عبور نمیکند. بنابراین، شاخه فقط زمانی شلیک میکند که هر دو ورودی فعال باشند.
- عملیاتOR: برای OR، آستانه را پایین میگذاریم. اگر آستانه 0.5 باشد، حتی یکی از ورودیها (با وزن ۱) کافی است تا شاخه شلیک کند.
- عملیاتXOR: این عملیات غیرخطی است و با یک شاخه قابل پیادهسازی نیست. اما با دو شاخه و مهار متقابل، میتوان XOR را ساخت. شاخه اول، ترکیب (x1 AND NOT x2) را تشخیص میدهد؛ شاخه دوم، (NOT x1 AND x2) را. سپس جسم سلولی، خروجی این دو شاخه را با OR ترکیب میکند. این ساختار، دقیقاً همان چیزی است که یک شبکه دو لایه انجام میدهد: لایه اول (شاخههای دندریتی) ویژگیهای غیرخطی میسازد؛ لایه دوم (جسم سلولی) آنها را ترکیب میکند.
مثال مدیریتی: تصمیمگیری XOR در سرمایهگذاری
فرض کنید یک صندوق سرمایهگذاری میخواهد تصمیم بگیرد که آیا در یک استارتاپ سرمایهگذاری کند یا خیر. دو معیار اصلی وجود دارد: نوآوری فناوری (x1) و توان تیم مدیریتی. (x2) قاعده صندوق این است: سرمایهگذاری فقط زمانی انجام میشود که دقیقاً یکی از این دو معیار بالا باشد — یا نوآوری بالا و تیم ضعیف (که صندوق میتواند تیم را تقویت کند)، یا نوآوری پایین و تیم قوی (که صندوق میتواند فناوری را وارد کند). اگر هر دو بالا باشند، استارتاپ بیشازحد ارزشگذاری میشود و صندوق وارد نمیشود؛ اگر هیچکدام بالا نباشند، ریسک بیشازحد است.
این دقیقاً الگوی XOR است. یک نورون نقطهای ساده نمیتواند این قاعده را یاد بگیرد. اما یک نورون با دو شاخه دندریتی میتواند: شاخه اول، «نوآوری بالا و تیم ضعیف» را تشخیص میدهد؛ شاخه دوم، «نوآوری پایین و تیم قوی» را. جسم سلولی، خروجی این دو شاخه را با OR ترکیب میکند و تصمیم نهایی را میگیرد. این مثال نشان میدهد که دندریتها، توان تصمیمگیری نورون را از خطی به غیرخطی ارتقا میدهند — و همین، تفاوت بین یک مدل ساده و یک مدل قدرتمند است.
تقویت سیگنال و ادغام ورودیها
دندریتها، علاوه بر محاسبات غیرخطی، نقش تقویت سیگنال را نیز ایفا میکنند. سیگنالی که از یک سیناپس دور از جسم سلولی میآید، در طول مسیر تضعیف میشود. اما دندریتها با کانالهای یونی وابسته به ولتاژ، این تضعیف را جبران میکنند. اگر سیگنال بهاندازه کافی قوی باشد، میتواند یک دندریتیک اسپایک تولید کند که بدون تضعیف به جسم سلولی میرسد. این مکانیزم، مشابه تقویتکنندههای سیگنال در شبکههای مخابراتی است: سیگنال ضعیف، در ایستگاههای میانی تقویت میشود تا به مقصد برسد.
علاوه بر این، دندریتها ورودیهای متعدد را ادغام میکنند. این ادغام، نه فقط جمع ساده، بلکه ترکیب هوشمندانه است: ورودیهایی که همزمان میرسند، تقویت میشوند؛ ورودیهایی که پراکنده هستند، تضعیف میشوند. این حساسیت به همزمانی، به نورون اجازه میدهد که الگوهای معنادار را از نویز تشخیص دهد. در یک مثال مدیریتی، این مانند تشخیص همزمانی چند نشانه در یک بحران است: اگر کاهش فروش، افزایش هزینهها، و نارضایتی مشتری همزمان رخ دهند، مدیر بحران را تشخیص میدهد؛ اما اگر هر یک بهتنهایی و در زمانهای مختلف رخ دهند، ممکن است نادیده گرفته شوند.
۳.۳.۳ خواص محاسباتی دندریتها
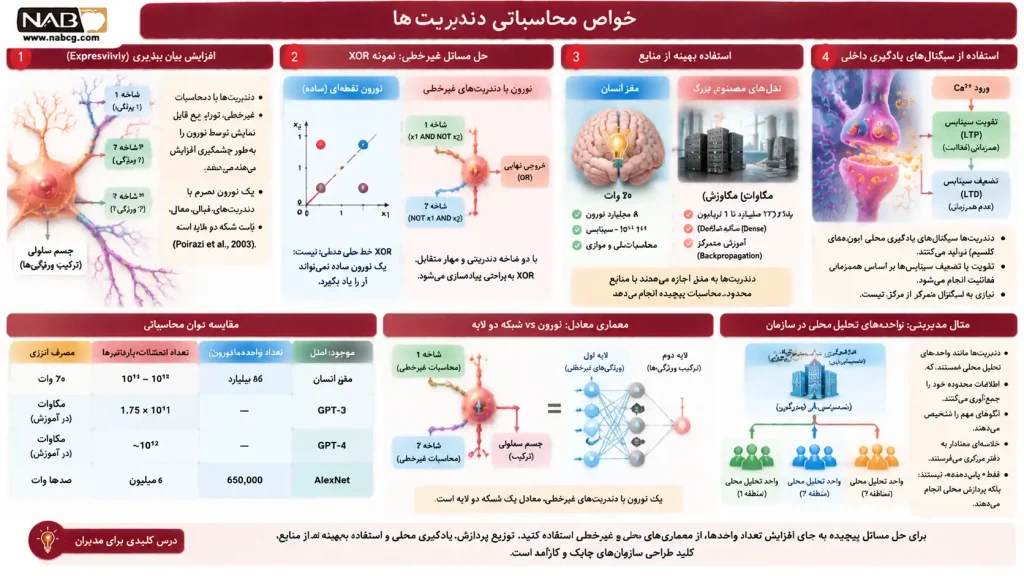
دندریتها، نورون را به یک واحد محاسباتی بسیار قدرتمند تبدیل میکنند. در این بخش، چهار خاصیت کلیدی آنها را بررسی میکنیم.
افزایش بیانپذیری (Expressivity)
بیانپذیری یک مدل، به تنوع توابعی اشاره دارد که آن مدل میتواند نمایش دهد. یک نورون نقطهای ساده، فقط میتواند توابع خطی (یا خطی-آستانهای) را نمایش دهد. اما یک نورون با دندریتهای غیرخطی، میتواند توابع غیرخطی پیچیده را نمایش دهد. در واقع، پویرازی، برانون و مل (۲۰۰۳) نشان دادند که یک نورون هرمی با دندریتهای فعال، معادل یک شبکه دو لایه است. این بدان معناست که بیانپذیری یک نورون دندریتی، بسیار بیشتر از یک نورون نقطهای است.
برای درک این موضوع، یک مثال ساده بزنیم. فرض کنید میخواهیم تابع XOR را یاد بگیریم. یک نورون نقطهای نمیتواند این کار را انجام دهد، زیرا XOR خطی جداشدنی نیست. اما یک نورون با دو شاخه دندریتی میتواند XOR را بهراحتی پیادهسازی کند. این افزایش بیانپذیری، به مغز اجازه میدهد که با تعداد کمتری نورون، مسائل پیچیدهتری را حل کند. در شبکههای عصبی مصنوعی، این ایده به معماریهای دندریتی الهام بخشیده است که در آنها، هر واحد مخفی، خودش یک شبکه کوچک است (Poirazi & Mel, 2001).
استفاده بهینه از منابع
مغز، با وجود ۸۶ میلیارد نورون، تنها ۲۰ وات انرژی مصرف میکند. این کارایی خیرهکننده، تا حد زیادی مدیون دندریتها است. اگر هر نورون فقط یک جمعکننده ساده بود، مغز برای حل مسائل پیچیده، به نورونهای بسیار بیشتری نیاز داشت — و این، هم فضای بیشتری اشغال میکرد و هم انرژی بیشتری مصرف میکرد. دندریتها با پردازش محلی و غیرخطی، به مغز اجازه میدهند که با منابع محدود، محاسبات پیچیده انجام دهد.
این اصل، در طراحی سیستمهای هوش مصنوعی سازمانی نیز کاربرد دارد. بهجای ساختن مدلهای غولپیکر با میلیاردها پارامتر، میتوان از معماریهای دندریتی استفاده کرد که در آنها، هر واحد، محاسبات محلی انجام میدهد و فقط خروجی نهایی را به لایه بعدی میفرستد. این رویکرد، مصرف انرژی و هزینه محاسباتی را بهشدت کاهش میدهد — دقیقاً همانطور که مغز انجام میدهد.
استفاده از سیگنالهای یادگیری داخلی
یکی از چالشهای اصلی در آموزش شبکههای عصبی مصنوعی، مسئله تخصیص اعتبار (Credit Assignment) است: وقتی شبکه خطا میکند، کدام وزنها باید تغییر کنند؟ در پسانتشار خطا، این مسئله با انتشار خطا از خروجی به عقب حل میشود. اما در مغز، هیچ الگوریتم متمرکزی برای پسانتشار وجود ندارد. پس مغز چگونه یاد میگیرد؟
پاسخ در یادگیری محلی دندریتی نهفته است. دندریتها، سیگنالهای یادگیری داخلی تولید میکنند: یونهای کلسیم که در اثر فعالیت سیناپسی وارد میشوند، بهعنوان پیامهای یادگیری محلی عمل میکنند. اگر یک سیناپس همزمان با فعالیت دندریتی فعال شود، وزن آن تقویت میشود (LTP)؛ اگر غیرهمزمان باشد، تضعیف میشود (LTD). این یادگیری محلی، نیازی به سیگنال متمرکز از مرکز ندارد و به همین دلیل، کارآمد و مقیاسپذیر است (Guerguiev et al., 2017; Richards & Lillicrap, 2019).
مثال مدیریتی: یادگیری محلی در سازمانهای توزیعشده
در یک سازمان متمرکز، تمام تصمیمات یادگیری از دفتر مرکزی صادر میشود: «این فرآیند را تغییر دهید، آن وزن را کم کنید.» این رویکرد، کند و شکننده است. در یک سازمان توزیعشده، واحدهای محلی (دندریتها) خودشان یاد میگیرند و بهبود مییابند، بدون نیاز به دستور مستقیم از مرکز. دفتر مرکزی، فقط چارچوب کلی را تعیین میکند و نتایج نهایی را میسنجد. این رویکرد، سریعتر، انعطافپذیرتر، و مقاومتر است. دندریتها، دقیقاً همین یادگیری توزیعشده را در مغز ممکن میسازند.
امکان یادگیری مستمر
یکی از محدودیتهای شبکههای عصبی مصنوعی، فراموشی فاجعهبار (Catastrophic Forgetting) است: وقتی شبکه روی دادههای جدید آموزش میبیند، دانش قبلی خود را از دست میدهد. مغز، برخلاف شبکههای مصنوعی، میتواند بدون فراموشی فاجعهبار یاد بگیرد. یکی از دلایل این توانایی، یادگیری خوشهای (Clustered Plasticity) در دندریتهاست: ورودیهای مرتبط، روی یک شاخه دندریتی خوشه میشوند و بهصورت محلی یاد میگیرند. این خوشهبندی، از تداخل بین خاطرات مختلف جلوگیری میکند و به مغز اجازه میدهد که دانش جدید را بدون پاک کردن دانش قدیم بیاموزد (Kastellakis et al., 2015; Govindarajan et al., 2011).
۳.۳.۴ شواهد تجربی: حل MNIST با دندریتهای تکنورونی
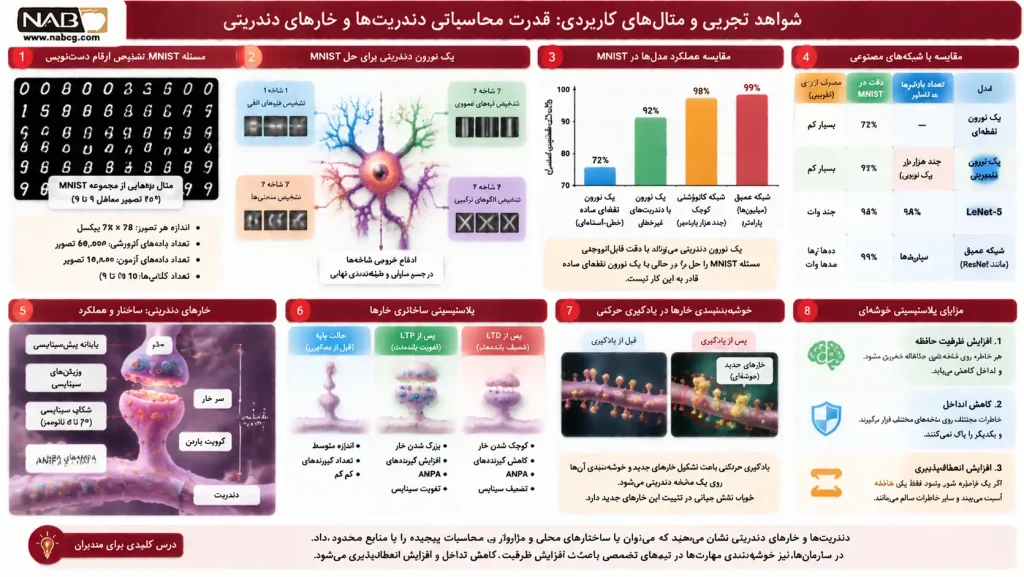
برای اینکه ببینیم قدرت محاسباتی دندریتها چقدر است، بیایید یک مثال تجربی را مرور کنیم: حل مسئله MNIST با یک نورون منفرد. MNIST، مجموعهدادهای از ۷۰٬۰۰۰ تصویر از ارقام دستنویس (۰ تا ۹) است که هر تصویر، ۲۸×۲۸ پیکسل دارد. این مسئله، یکی از استانداردهای طلایی در یادگیری ماشین است و معمولاً با شبکههای عمیق با میلیونها پارامتر حل میشود.
اما پژوهشهای شبیهسازی نشان دادهاند که یک نورون منفرد با دندریتهای غیرخطی میتواند در این مسئله به دقت قابلتوجهی دست یابد — چیزی که با یک نورون نقطهای ساده غیرممکن است. در این مدلها، هر شاخه دندریتی بهعنوان یک طبقهبند محلی عمل میکند: یک شاخه، لبههای افقی را تشخیص میدهد؛ شاخه دیگر، لبههای عمودی؛ شاخه سوم، منحنیها. سپس، جسم سلولی، خروجی این شاخهها را ترکیب میکند و رقم را طبقهبندی مینماید. این ساختار، دقیقاً مشابه یک شبکه کانولوشنی کوچک است — اما در مقیاس یک نورون منفرد (Poirazi & Mel, 2001; Gidon et al., 2020).
این نتیجه، پیامدهای عمیقی برای طراحی شبکههای عصبی مصنوعی دارد. اگر یک نورون منفرد با دندریتهای غیرخطی میتواند چنین کاری انجام دهد، آنگاه شبکههای بزرگ میتوانند با نورونهای دندریتی، بسیار کارآمدتر و کمهزینهتر ساخته شوند. این ایده، در معماریهای جدید مانند شبکههای دندریتی عمیق (Deep Dendritic Networks) و نورونهای چندبخشی (Multi-Compartment Neurons) در حال توسعه است.
مثال مدیریتی: یک کارشناس خبره در برابر یک تیم بزرگ
فرض کنید یک سازمان میخواهد یک سیستم تشخیص تقلب در تراکنشهای بانکی بسازد. در روش سنتی، یک تیم بزرگ از تحلیلگران (شبکه عمیق با میلیونها پارامتر) استخدام میشود. هر تحلیلگر، یک ویژگی خاص را بررسی میکند. اما در روش الهامگرفته از دندریتها، یک کارشناس خبره (نورون دندریتی) استخدام میشود که خودش چند شاخه تخصصی در ذهن دارد: یک شاخه برای الگوهای زمانی، یک شاخه برای مبالغ غیرعادی، یک شاخه برای مکانهای پرخطر. این کارشناس، محلی تحلیل میکند و نتیجه نهایی را ارائه میدهد. این رویکرد، سریعتر، ارزانتر، و قابل تفسیرتر است.
۳.۳.۵ خارهای دندریتی (Dendritic Spines)
روی سطح دندریتها، ساختارهای کوچکی به نام خارهای دندریتی قرار دارند. این خارها، محل اصلی سیناپسهای تحریکی هستند و نقش حیاتی در یادگیری و حافظه ایفا میکنند. هر خار، یک برآمدگی کوچک (حدود ۰.۵ تا ۲ میکرومتر) است که با گردن باریک به دندریت متصل میشود. این ساختار خاص، به خار اجازه میدهد که سیگنالهای ورودی را ایزوله کند و محاسبات محلی انجام دهد.
ساختار و پلاستیسیتی ساختاری
خارهای دندریتی، ثابت نیستند؛ آنها پویا هستند. با یادگیری، خارهای جدید تشکیل میشوند و خارهای موجود بزرگتر میشوند. با فراموشی یا عدم استفاده، خارها کوچک یا حذف میشوند. این پلاستیسیتی ساختاری، پایه حافظه بلندمدت را تشکیل میدهد. تحقیقات نشان داده است که LTP (تقویت بلندمدت) باعث بزرگ شدن خارها و افزایش تعداد گیرندههای AMPA میشود؛ LTD (تضعیف بلندمدت) باعث کوچک شدن خارها و کاهش گیرندهها میگردد (Magee & Grienberger, 2020).
افزایش تراکم خارها در یادگیری حرکتی
فو و همکاران (۲۰۱۲) نشان دادند که یادگیری حرکتی — مانند یادگیری یک مهارت جدید — باعث تشکیل خارهای جدید در قشر حرکتی میشود. این خارها، خوشهای هستند: خارهای جدید، نزدیک به هم روی یک شاخه دندریتی تشکیل میشوند. این خوشهبندی، به ادغام سیگنالهای مرتبط کمک میکند و یادگیری را تقویت مینماید. یانگ و همکاران (۲۰۱۴) نیز نشان دادند که خواب، نقش حیاتی در تثبیت این خارهای جدید دارد: در طول خواب، خارهای تشکیلشده در طول روز تقویت میشوند و حافظه حرکتی تثبیت میگردد.
فرضیه پلاستیسیتی خوشهای (Clustered Plasticity)
فرضیه پلاستیسیتی خوشهای، که توسط کاستلاکیس و همکاران (۲۰۱۵) مطرح شده است، میگوید: ورودیهایی که همزمان فعال میشوند، روی یک شاخه دندریتی خوشه میشوند و بهصورت محلی یاد میگیرند. این خوشهبندی، چند مزیت دارد:
۱. افزایش ظرفیت حافظه: اگر هر خاطره، روی یک شاخه جداگانه ذخیره شود، تداخل بین خاطرات کاهش مییابد و ظرفیت حافظه افزایش مییابد.
۲. کاهش تداخل: خاطرات مختلف، روی شاخههای مختلف ذخیره میشوند و یکدیگر را پاک نمیکنند.
۳. افزایش انعطافپذیری: اگر یک خاطره فراموش شود، فقط یک شاخه آسیب میبیند و سایر خاطرات سالم میمانند.
مثال مدیریتی: خوشهبندی مهارتها در تیمهای سازمانی
فرض کنید یک شرکت مشاوره، تیمهای تخصصی مختلفی دارد: تیم مالی، تیم بازاریابی، تیم فناوری. اگر هر تیم، دانش خود را جداگانه نگه دارد، تداخل بین دانشها کم است و هر تیم عمیقاً در حوزه خود تخصص پیدا میکند. اما اگر همه دانشها در یک مکان متمرکز شوند، تداخل افزایش مییابد و تخصص کاهش مییابد. خوشهبندی دندریتی، دقیقاً همین اصل را در مغز پیادهسازی میکند: دانشهای مرتبط، در خوشههای جداگانه ذخیره میشوند تا تداخل کاهش یابد و ظرفیت افزایش یابد.
۳.۳.۶ مثال گسترده: مدلسازی نورون با دندریت غیرخطی در برابر نورون نقطهای
برای جمعبندی این بخش، بیایید یک مثال کامل را مرور کنیم که تفاوت بین نورون نقطهای و نورون دندریتی را نشان میدهد.
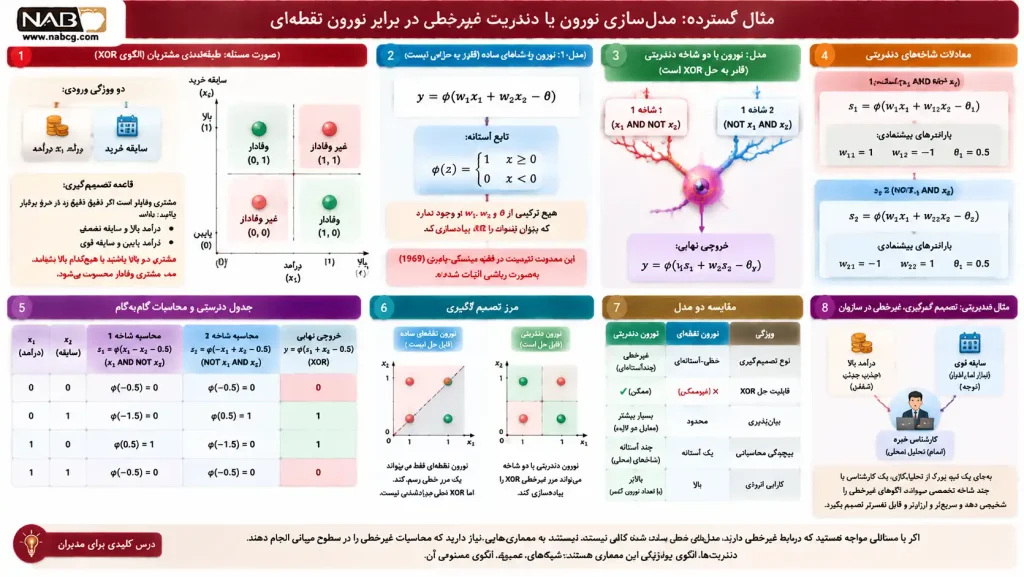
صورت مسئله: یک شرکت میخواهد یک سیستم طبقهبندی مشتریان بسازد که بر اساس دو ویژگی — درآمد (x1) و سابقه(x2) —خرید تصمیم بگیرد که آیا مشتری وفادار است یا خیر. قاعده شرکت این است: مشتری وفادار است اگر دقیقاً یکی از دو شرط برقرار باشد: یا درآمد بالا و سابقه ضعیف (که میتوان با تخفیف جذبش کرد)، یا درآمد پایین و سابقه قوی (که وفادار است اما نیاز به توجه دارد). اگر هر دو بالا باشند (مشتری ایدهآل اما احتمالاً از رقبا هم پیشنهاد دارد)، یا هیچکدام بالا نباشند، مشتری وفادار محسوب نمیشود.
این دقیقاً الگوی XOR است.
مدل ۱: نورون نقطهای ساده
یک نورون نقطهای، خروجی را به این صورت محاسبه میکند:
هیچ ترکیبی از w1، w2، و θ وجود ندارد که بتواند XOR را پیادهسازی کند. این محدودیت، در قضیه مینسکی-پاپرت (۱۹۶۹( بهصورت ریاضی اثبات شده است. بنابراین، نورون نقطهای نمیتواند این مسئله را حل کند.
مدل ۲: نورون با دو شاخه دندریتی
حالا یک نورون با دو شاخه دندریتی در نظر بگیرید. شاخه اول، ترکیب (x1 AND NOT x2) را تشخیص میدهد؛ شاخه دوم، (NOT x1 AND x2) را. خروجی هر شاخه به این صورت است:
و خروجی نهایی:
بررسی میکنیم:
• (0,0): s1 = φ(−0.5) = 0، s2 = φ(−0.5) = 0، y = φ(−0.5) = 0 → وفادار نیست ✓
• (0,1): s1 = φ(−1.5) = 0، s2 = φ(0.5) = 1، y = φ(0.5) = 1 → وفادار است ✓
• (1,0): s1 = φ(0.5) = 1، s2 = φ(−1.5) = 0، y = φ(0.5) = 1 → وفادار است ✓
• (1,1): s1 = φ(−0.5) = 0، s2 = φ(−0.5) = 0، y = φ(−0.5) = 0 → وفادار نیست ✓
همانطور که میبینید، نورون دندریتی بهراحتی XOR را حل میکند. این تفاوت بنیادین، نشان میدهد که دندریتها، نورون را از یک طبقهبند خطی به یک طبقهبند غیرخطی تبدیل میکنند — و همین، کلید قدرت محاسباتی مغز است.
درس مدیریتی: اگر سازمان شما با مسائلی مواجه است که روابط غیرخطی دارند — مانند تشخیص فرصتهای سرمایهگذاری که فقط در ترکیب خاصی از شرایط رخ میدهند — استفاده از مدلهای خطی ساده کافی نیست. شما به معماریهایی نیاز دارید که محاسبات غیرخطی را در سطوح میانی انجام دهند. دندریتها، الگوی بیولوژیکی این معماری هستند؛ شبکههای عمیق، الگوی مصنوعی آن.
جمعبندی بخش ۳.۳: چه چیزی از دندریتها میآموزیم؟
در این بخش، کشف کردیم که دندریتها فقط سیم نیستند؛ آنها کامپیوترهای غیرخطی هستند که نورون را به یک واحد محاسباتی بسیار قدرتمند تبدیل میکنند. درسهای کلیدی این بخش عبارتند از:
۱. غیرخطیبودن، کلید قدرت است. دندریتها با کانالهای یونی وابسته به ولتاژ، ادغام غیرخطی، و مهار متقابل، به نورون اجازه میدهند که مسائل غیرخطی مانند XOR را حل کند.
۲. یک نورون، یک شبکه کوچک است. پویرازی و همکاران (۲۰۰۳) نشان دادند که یک نورون با دندریتهای فعال، معادل یک شبکه دو لایه است. این بدان معناست که مغز، ۸۶ میلیارد شبکه کوچک در خود جای داده است.
۳. کارایی از طریق محاسبات محلی. دندریتها با پردازش محلی و یادگیری خوشهای، به مغز اجازه میدهند که با منابع محدود، محاسبات پیچیده انجام دهد.
۴. پلاستیسیتی ساختاری، پایه حافظه است. خارهای دندریتی با تشکیل، بزرگ شدن، و حذف شدن، حافظه بلندمدت را ممکن میسازند.
۵. الهام برای شبکههای مصنوعی. معماریهای دندریتی — مانند نورونهای چندبخشی و شبکههای دندریتی عمیق — در حال توسعه هستند تا کارایی و توان شبکههای عصبی مصنوعی را افزایش دهند.
درس نهایی برای مدیران: دندریتها به ما میآموزند که قدرت در سادگی نیست؛ در سازماندهی هوشمندانه است. یک واحد ساده، اگر ساختار داخلی مناسبی داشته باشد، میتواند کارهای پیچیدهای انجام دهد. سازمانهایی که به واحدهای محلی خود استقلال و ابزارهای تحلیل میدهند، میتوانند سریعتر، کارآمدتر، و انعطافپذیرتر از سازمانهایی باشند که همه تصمیمات را به مرکز ارجاع میدهند.
منابع بخش ۳.۳
Bittner, K. C., Milstein, A. D., Grienberger, C., Romani, S., & Magee, J. C. (2017). Behavioral time scale synaptic plasticity underlies CA1 place fields. Science, *357*(6355), 1033–1036. https://doi.org/10.1126/science.aan3846
Bono, J., & Clopath, C. (2017). Modeling somatic and dendritic spike mediated plasticity at the single neuron level. PLoS Computational Biology, *13*(10), e1005731. https://doi.org/10.1371/journal.pcbi.1005731
Branco, T., Clark, B. A., & Häusser, M. (2010). Dendritic discrimination of temporal input sequences in cortical neurons. Science, *329*(5999), 1671–1675. https://doi.org/10.1126/science.1189664
Branco, T., & Häusser, M. (2010). The single dendritic branch as a fundamental functional unit in the nervous system. Current Opinion in Neurobiology, *20*(4), 494–502. https://doi.org/10.1016/j.conb.2010.07.009
Fu, M., Yu, X., Lu, J., & Zuo, Y. (2012). Repetitive motor learning induces coordinated formation of clustered dendritic spines in vivo. Nature, *483*(7387), 92–95. https://doi.org/10.1038/nature10844
Gidon, A., Zolnik, T. A., Fidzinski, P., Bolduan, F., Papoutsi, A., Poirazi, P., Holtkamp, M., Vida, I., & Larkum, M. E. (2020). A dendritic mechanism for decoding temporal sequences. Science, *367*(6473), 83–87. https://doi.org/10.1126/science.aax6239
Govindarajan, A., Israely, I., Huang, S. Y., & Tonegawa, S. (2011). The dendritic branch is the preferred integrative unit for protein synthesis-dependent LTP. Neuron, *69*(1), 132–146. https://doi.org/10.1016/j.neuron.2010.12.008
Guerguiev, J., Lillicrap, T. P., & Richards, B. A. (2017). Towards deep learning with segregated dendrites. eLife, *6*, e22901. https://doi.org/10.7554/eLife.22901
Häusser, M., & Mel, B. (2003). Dendrites: Bug or feature? Current Opinion in Neurobiology, *13*(3), 372–383. https://doi.org/10.1016/S0959-4388(03)00075-8
Kastellakis, G., Cai, D. J., Mednick, S. C., Silva, A. J., & Poirazi, P. (2015). Synaptic clustering within dendrites: An emerging theory of memory formation. Progress in Neurobiology, *126*, 19–35. https://doi.org/10.1016/j.pneurobio.2014.12.002
Koch, C., Poggio, T., & Torre, V. (1983). Nonlinear interactions in a dendritic tree: Localization, timing, and role in information processing. Proceedings of the National Academy of Sciences, *80*(9), 2799–2802. https://doi.org/10.1073/pnas.80.9.2799
Kording, K. P., & König, P. (2001). Supervised and unsupervised learning with two sites of synaptic integration. Journal of Computational Neuroscience, *11*(3), 207–215. https://doi.org/10.1023/A:1013774117661
Larkum, M. E., Nevian, T., Sandler, M., Polsky, A., & Schiller, J. (2009). Synaptic integration in tuft dendrites of layer 5 pyramidal neurons: A new unifying principle. Science, *325*(5941), 756–760. https://doi.org/10.1126/science.1171958
London, M., & Häusser, M. (2005). Dendritic computation. Annual Review of Neuroscience, *28*, 503–532. https://doi.org/10.1146/annurev.neuro.28.061604.135703
Losonczy, A., & Magee, J. C. (2006). Integrative properties of radial oblique dendrites in hippocampal CA1 pyramidal neurons. Neuron, *50*(2), 291–307. https://doi.org/10.1016/j.neuron.2006.03.016
Magee, J. C. (2000). Dendritic integration of excitatory synaptic input. Nature Reviews Neuroscience, *1*(3), 181–190. https://doi.org/10.1038/35044552
Magee, J. C., & Grienberger, C. (2020). Synaptic plasticity forms and functions. Annual Review of Neuroscience, *43*, 95–117. https://doi.org/10.1146/annurev-neuro-090919-022842
Mel, B. W. (1994). Information processing in dendritic trees. Neural Computation, *6*(6), 1031–1085. https://doi.org/10.1162/neco.1994.6.6.1031
Nevian, T., Larkum, M. E., Polsky, A., & Schiller, J. (2007). Properties of basal dendrites of layer 5 pyramidal neurons: A direct patch-clamp study. Nature Neuroscience, *10*(2), 206–214. https://doi.org/10.1038/nn1846
Payeur, A., Guerguiev, J., Zenke, F., Richards, B. A., & Naud, R. (2021). Burst-dependent synaptic plasticity can coordinate learning in hierarchical circuits. Nature Neuroscience, *24*(7), 1010–1019. https://doi.org/10.1038/s41593-021-00857-x
Poirazi, P., Brannon, T., & Mel, B. W. (2003). Pyramidal neuron as two-layer neural network. Neuron, *37*(6), 989–999. https://doi.org/10.1016/S0896-6273(03)00149-1
Poirazi, P., & Mel, B. W. (2001). Impact of active dendrites and structural plasticity on the memory capacity of neural tissue. Neuron, *29*(3), 779–796. https://doi.org/10.1016/S0896-6273(01)00252-5
Polsky, A., Mel, B. W., & Schiller, J. (2004). Computational subunits in thin dendrites of pyramidal cells. Nature Neuroscience, *7*(6), 621–627. https://doi.org/10.1038/nn1253
Rall, W. (1964). Theoretical significance of dendritic trees for neuronal input-output relations. In R. F. Reiss (Ed.), Neural theory and modeling (pp. 73–97). Stanford University Press.
Richards, B. A., & Lillicrap, T. P. (2019). Dendritic solutions to the credit assignment problem. Current Opinion in Neurobiology, *54*, 28–36. https://doi.org/10.1016/j.conb.2018.08.003
Sacramento, J., Costa, R. P., Bengio, Y., & Senn, W. (2018). Dendritic cortical microcircuits approximate the backpropagation algorithm. Advances in Neural Information Processing Systems, *31*, 8721–8732.
Segev, I., & London, M. (2000). Untangling dendrites with quantitative models. Science, *290*(5492), 744–750. https://doi.org/10.1126/science.290.5492.744
Stuart, G. J., & Spruston, N. (2015). Dendritic integration: 60 years of progress. Nature Neuroscience, *18*(12), 1713–1721. https://doi.org/10.1038/nn.4157
Ujfalussy, B. B., Makara, J. K., Lengyel, M., & Branco, T. (2018). Global and multiplexed dendritic computations under in vivo-like conditions. Neuron, *100*(3), 579–592. https://doi.org/10.1016/j.neuron.2018.10.004
Williams, S. R., & Stuart, G. J. (2003). Role of dendritic synapse location in the control of action potential output. Trends in Neurosciences, *26*(3), 147–154. https://doi.org/10.1016/S0166-2236(03)00035-3
Yang, G., Lai, C. S. W., Cichon, J., Ma, L., Li, W., & Gan, W. B. (2014). Sleep promotes branch-specific formation of dendritic spines after learning. Science, *344*(6188), 1173–1178. https://doi.org/10.1126/science.1249098
۳.۴ چگونه مغز یاد میگیرد؟
مسئله آغازین: فرض کنید یک مدیرعامل هستید که ده سال پیش، یک درس بزرگ از شکست یک پروژه گرفته است. امروز، در موقعیتی مشابه قرار گرفتهاید و بدون اینکه آگاهانه فکر کنید، احساس میکنید که «این مسیر درست نیست.» شما نمیتوانید دقیقاً بگویید چرا، اما میدانید که باید مسیر دیگری را انتخاب کنید. این دانش شهودی، از کجا آمده است؟ پاسخ ساده این است: «از تجربه.» اما این پاسخ، پرسش را عمیقتر میکند: تجربه چگونه در مغز ذخیره میشود؟ وقتی شما چیزی یاد میگیرید — یک مهارت، یک واقعیت، یک الگوی تصمیمگیری — دقیقاً چه چیزی در مغز تغییر میکند؟ آیا مغز، مانند یک هارد دیسک، اطلاعات را در مکان مشخصی ذخیره میکند؟ یا فرآیند یادگیری، چیزی بنیادینتر و توزیعشدهتر است؟
در این بخش، به بررسی مکانیزمهای یادگیری مغز میپردازیم — از سطح سیناپس تا سطح سیستم. خواهیم دید که یادگیری، نه یک ذخیرهسازی ساده، بلکه یک تغییر پویا در قدرت اتصالات بین میلیاردها نورون است. و مهمتر از آن، خواهیم دید که مغز، نه یک، بلکه چندین مکانیزم یادگیری متفاوت دارد: یادگیری هبی، تقویت و تضعیف بلندمدت، پلاستیسیتی وابسته به زمان شلیک، یادگیری تقویتی، یادگیری بدون نظارت، و یادگیری نظارتشده. هر یک از این مکانیزمها، برای نوع خاصی از یادگیری تخصص یافته است — دقیقاً همانطور که یک سازمان، برای انواع مختلف تصمیمگیری، فرآیندهای متفاوتی دارد.
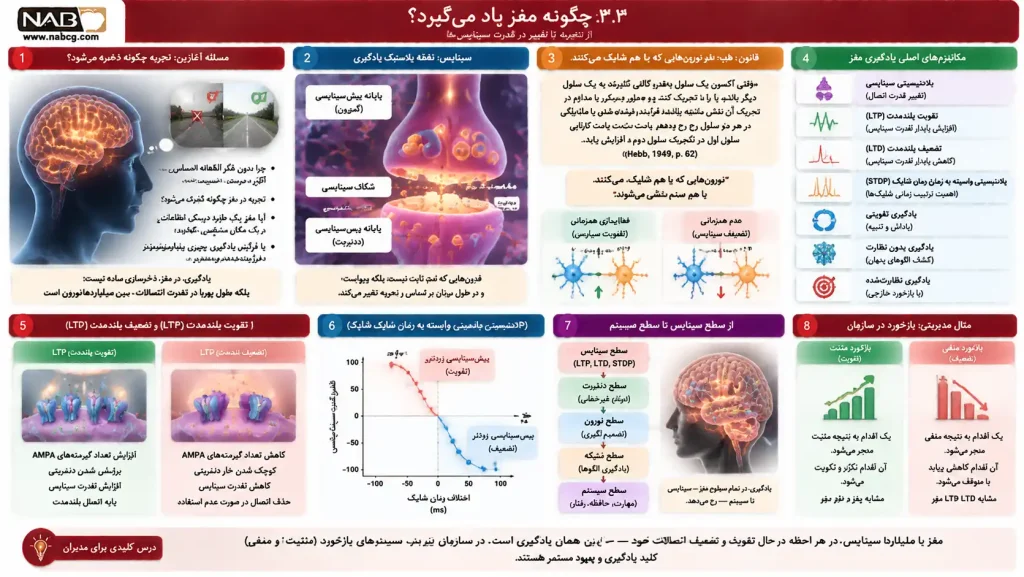
۳.۴.۱ یادگیری سیناپسی: پلاستیسیتی بهعنوان مکانیزم بنیادی
در بخش ۳.۲ دیدیم که سیناپس، نقطه اتصال بین دو نورون است و قدرت آن، تعیین میکند که سیگنال چقدر مؤثر منتقل شود. اما پرسش کلیدی این است: آیا قدرت سیناپس ثابت است؟ پاسخ، قاطعانه خیر است. سیناپسها پویا هستند: قدرت آنها در طول زمان و بر اساس تجربه تغییر میکند. این ویژگی، پلاستیسیتی سیناپسی (Synaptic Plasticity) نامیده میشود و پایه بنیادین یادگیری در مغز است.
واژه پلاستیسیتی از کلمه یونانی πλαστικός (پلاستیکوس) به معنای «قابل شکلدهی» گرفته شده است. در زمینه مغز، این واژه به توانایی تغییر اشاره دارد: مغز، برخلاف یک کامپیوتر که سختافزار آن ثابت است، سختافزار خود را تغییر میدهد — و این تغییر، همان یادگیری است. دونالد هب، روانشناس کانادایی، در کتاب «سازمان رفتار» (۱۹۴۹) این ایده را بهشکل زیر بیان کرد:
«وقتی آکسون یک سلول بهقدر کافی نزدیک به یک سلول دیگر باشد تا آن را تحریک کند، و بهطور مکرر یا مداوم در تحریک آن نقش داشته باشد، فرآیندهای رشد یا متابولیکی در هر دو سلول رخ میدهد که باعث میشود کارایی سلول اول در تحریک سلول دوم افزایش یابد.» (Hebb, 1949, p. 62)
این جمله، که به قانون هب معروف شد، مبنای نظری تمام مکانیزمهای یادگیری سیناپسی است. خلاصه آن در یک جمله سادهتر: «نورونهایی که با هم شلیک میکنند، با هم سیمکشی میشوند.» این قانون، دو جنبه دارد:
۱. تقویت همزمانی: اگر نورون پیشسیناپسی و پسسیناپسی همزمان فعال شوند، سیناپس بین آنها تقویت میشود.
۲. تضعیف عدمهمزمانی: اگر نورون پیشسیناپسی فعال شود اما پسسیناپسی فعال نشود، سیناپس تضعیف میشود.
این دو جنبه، دقیقاً مشابه دو نوع بازخورد در سازمان است: بازخورد مثبت (وقتی یک اقدام به نتیجه مثبت منجر میشود، آن اقدام تقویت میشود) و بازخورد منفی (وقتی یک اقدام به نتیجه منفی منجر میشود، آن اقدام تضعیف میشود). مغز، با میلیاردها سیناپس، در هر لحظه در حال تقویت و تضعیف اتصالات خود است — و این، همان یادگیری است.
اما قانون هب بهتنهایی کافی نیست. این قانون، مکانیزم دقیق تقویت و تضعیف را توضیح نمیدهد. آیا تقویت سیناپس، یک پدیده لحظهای است یا بلندمدت؟ آیا ترتیب زمانی شلیکها مهم است؟ پاسخ این پرسشها، در دهههای ۱۹۷۰ تا ۱۹۹۰ و با کشف LTP، LTD، و STDP داده شد.
مثال مدیریتی: پلاستیسیتی سیناپسی بهعنوان یادگیری سازمانی
فرض کنید یک شرکت تولیدی، یک فرآیند جدید برای کنترل کیفیت معرفی کرده است. در ابتدا، این فرآیند جدید و ناآشنا است و کارکنان به کندی آن را اجرا میکنند. اما پس از ماهها تمرین، این فرآیند نهادینه میشود: کارکنان بدون فکر کردن آن را اجرا میکنند. در این مثال، فرآیند جدید مانند یک سیناپس تازهتشکیلشده است: در ابتدا ضعیف است، اما با تکرار، تقویت میشود. اگر شرکت فرآیند را متوقف کند و به روش قدیمی بازگردد، سیناپس (فرآیند جدید) تضعیف میشود و فراموش میگردد. این، دقیقاً پلاستیسیتی سیناپسی در سطح سازمانی است: اتصالاتی که استفاده میشوند، تقویت میشوند؛ اتصالاتی که استفاده نمیشوند، تضعیف میشوند.
۳.۴.۲ تقویت بلندمدت (LTP) و تضعیف بلندمدت (LTD)
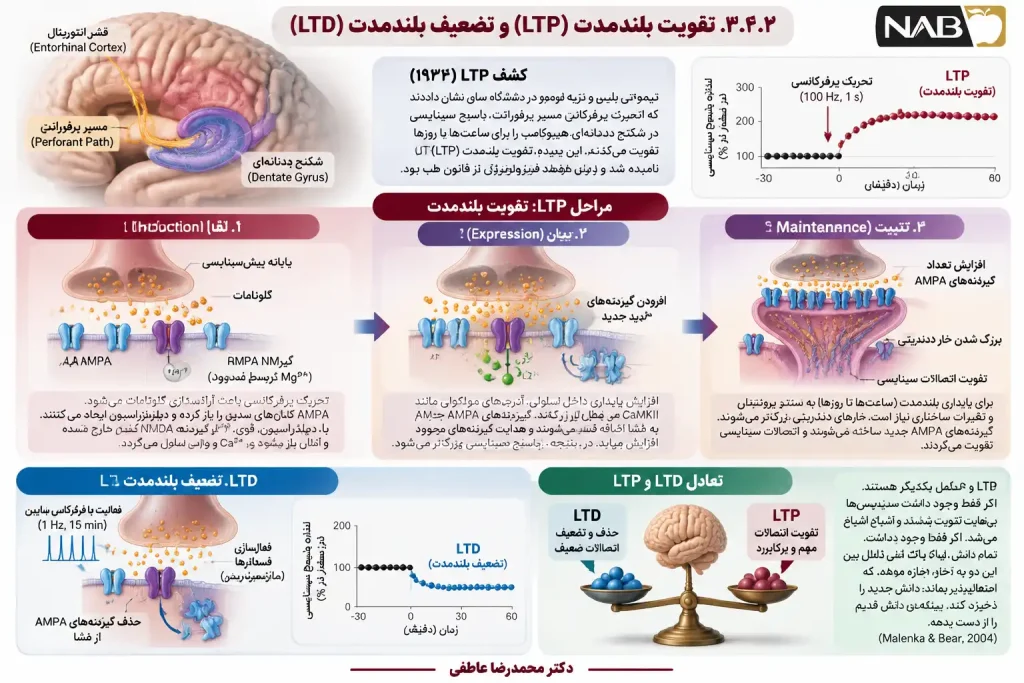
قانون هب، اگرچه چارچوب نظری مهمی بود، تا دهه ۱۹۷۰ شواهد تجربی محکمی نداشت. این شواهد، در سال ۱۹۷۳ و با کشف LTP توسط تیموتی بلیس و تریه لوومو در دانشگاه اسلو بهدست آمد.
LTP: تقویت بلندمدت
بلیس و لوومو (۱۹۷۳) نشان دادند که اگر مسیر پرفورانت (Perforant Path) — مسیری که از قشر انتورینال به شکنج دندانهای هیپوکامپ میرود — با تحریکات پرفرکانس (مثلاً ۱۰۰ هرتز برای یک ثانیه) تحریک شود، پاسخ سیناپسی برای ساعتها یا روزها تقویت میشود. این پدیده، تقویت بلندمدت (Long-Term Potentiation, LTP) نامیده شد. LTP، اولین شواهد فیزیولوژیک از قانون هب بود: سیناپسهایی که بهطور مکرر و شدید فعال میشوند، قدرت آنها افزایش مییابد.
LTP در سه مرحله رخ میدهد:
- مرحله ۱: القا (Induction).تحریک پرفرکانس، باعث آزادسازی گلوتامات از پایانه پیشسیناپسی میشود. گلوتامات به دو نوع گیرنده متصل میشود: AMPA و . NMDA گیرندههای AMPA، کانالهای سدیم را باز میکنند و باعث دپلاریزاسیون میشوند. گیرندههای NMDA، در حالت استراحت مسدود هستند (به دلیل وجود یون منیزیم در کانال). اما وقتی دپلاریزاسیون بهاندازه کافی قوی باشد، منیزیم از کانال NMDA خارج میشود و کانال باز میگردد. سپس، کلسیم (Ca²⁺) به داخل سلول پسسیناپسی سرازیر میشود.
- مرحله ۲: بیان (Expression). افزایش کلسیم داخل سلولی، آبشاری از رویدادهای مولکولی را فعال میکند: CaMKII (آنزیم کلسیم-کالمودولین کیناز II) فعال میشود، گیرندههای AMPA جدید به غشا اضافه میشوند، و هدایت گیرندههای موجود افزایش مییابد. نتیجه: پاسخ سیناپسی به همان مقدار گلوتامات، بزرگتر میشود.
- مرحله ۳: تثبیت. (Maintenance)برای اینکه LTP بلندمدت شود (ساعتها تا روزها)، به سنتز پروتئین و تغییرات ساختاری نیاز است. خارهای دندریتی بزرگتر میشوند، گیرندههای AMPA جدید ساخته میشوند، و اتصالات سیناپسی تقویت میگردند.
LTD: تضعیف بلندمدت
مکانیزم مقابل LTP، تضعیف بلندمدت (Long-Term Depression, LTD) است LTD .زمانی رخ میدهد که سیناپس با فرکانس پایین (مثلاً ۱ هرتز برای ۱۵ دقیقه) تحریک شود، یا زمانی که فعالیت پیشسیناپسی با فعالیت پسسیناپسی ضعیف همراه باشد. در LTD، افزایش کلسیم داخل سلولی کم و آهسته است، که فسفاتازها (مانند کلسینورین) را فعال میکند. این فسفاتازها، گیرندههای AMPA را حذف میکنند و قدرت سیناپس را کاهش میدهند.
تعادل LTP و LTD
LTP و LTD، مکمل یکدیگر هستند. اگر فقط LTP وجود داشت، سیناپسها بینهایت تقویت میشدند و شبکه اشباع میشد — دیگر ظرفیتی برای یادگیری جدید باقی نمیماند. اگر فقط LTD وجود داشت، تمام دانش قبلی پاک میشد. تعادل بین این دو، به مغز اجازه میدهد که انعطافپذیر بماند: دانش جدید را ذخیره کند بدون اینکه دانش قدیم را از دست بدهد (Malenka & Bear, 2004).
مثال مدیریتی: تعادل LTP و LTD در یادگیری سازمانی
فرض کنید یک شرکت مشاوره، روشهای قدیمی خود را دارد که سالها موفق بودهاند. حالا بازار تغییر کرده و شرکت باید روشهای جدید را یاد بگیرد. اگر شرکت فقط روشهای قدیمی را تقویت کند (LTP افراطی)، نمیتواند با تغییرات بازار سازگار شود. اگر فقط روشهای جدید را تقویت کند (LTD افراطی)، دانش ارزشمند قبلی خود را از دست میدهد. تعادل بین LTP و LTD، به این معناست که شرکت روشهای جدید را یاد بگیرد بدون اینکه روشهای قدیمی را کاملاً فراموش کند. این تعادل، کلید انطباقپذیری سازمانی است.
نقش LTP و LTD در حافظه فضایی
LTP و LTD، نه فقط در سطح سیناپسی، بلکه در سطح سیستم نیز نقش حیاتی دارند. هیپوکامپ — ناحیهای که برای حافظه فضایی (توانایی یادگیری و بهخاطر سپردن مسیرها) حیاتی است — دارای نورونهای مکان (Place Cells) است که به مکانهای خاص در محیط پاسخ میدهند. تحقیقات نشان داده است که LTP در هیپوکامپ، تشکیل حافظه فضایی را تسهیل میکند، در حالی که LTD به بهروزرسانی و تمایز جزئیات کمک میکند. نقش مکمل LTP و LTD، به مغز اجازه میدهد که محیط را دقیق و بهروز نمایش دهد (Magee & Grienberger, 2020).
پایداری LTP و LTD در in vivo
یکی از پرسشهای مهم در مورد LTP و LTD این است: آیا این پدیدهها در مغز زنده (in vivo) نیز پایدار هستند؟ تحقیقات نشان داده است که LTP و LTD، در in vivo میتوانند روزها تا هفتهها دوام داشته باشند — به شرطی که سنتز پروتئین و تغییرات ساختاری رخ دهند. این پایداری، پایه فیزیولوژیک حافظه بلندمدت را تشکیل میدهد.
۳.۴.۳ پلاستیسیتی وابسته به زمان شلیک (STDP)
قانون هب، همزمانی فعالیت پیشسیناپسی و پسسیناپسی را شرط تقویت سیناپس میدانست. اما دقت زمانی شلیکها چقدر مهم است؟ آیا ترتیب شلیکها — اینکه کدام نورون اول شلیک کند — بر نوع تغییر (تقویت یا تضعیف) تأثیر میگذارد؟ پاسخ این پرسش، در دهه ۱۹۹۰ و با کشف پلاستیسیتی وابسته به زمان شلیک (Spike-Timing-Dependent Plasticity, STDP) داده شد.
STDP، که توسط هنری مارکوویچ و همکاران (۱۹۹۷) و گو-کیانگ بی و مو-مینگ پو (۱۹۹۸) کشف شد، نشان میدهد که ترتیب زمانی شلیکهای پیشسیناپسی و پسسیناپسی، نوع تغییر سیناپس را تعیین میکند:
- اگر نورون پیشسیناپسی قبل از نورون پسسیناپسی شلیک کند (ترتیب پیش → پس)، سیناپس تقویت میشود. (LTP) این منطقی است: نورون پیشسیناپسی، علت شلیک نورون پسسیناپسی بوده است.
- اگر نورون پسسیناپسی قبل از نورون پیشسیناپسی شلیک کند (ترتیب پس → پیش)، سیناپس تضعیف میشود. (LTD) این نیز منطقی است: نورون پیشسیناپسی، نقشی در شلیک نورون پسسیناپسی نداشته است.
این رابطه، پنجره زمانی حدود ۲۰ تا ۵۰ میلیثانیه دارد: اگر فاصله بین دو شلیک بیشتر از این مقدار باشد، تغییری رخ نمیدهد. STDP، قانون هب را دقیقتر میکند: نه فقط همزمانی، بلکه ترتیب زمانی شلیکها مهم است. این دقت زمانی، به مغز اجازه میدهد که روابط علّی بین رویدادها را یاد بگیرد — چیزی که در یادگیری تداعیگر (Associative Learning) حیاتی است (Caporale & Dan, 2008).
مثال مدیریتی: STDP در یادگیری روابط علّی در سازمان
فرض کنید یک سازمان میخواهد روابط علّی بین اقدامات و نتایج را یاد بگیرد. اگر یک کمپین بازاریابی (پیشسیناپسی) قبل از افزایش فروش (پسسیناپسی) رخ دهد، سازمان یاد میگیرد که کمپین مؤثر بوده است. اما اگر افزایش فروش قبل از کمپین رخ دهد (مثلاً به دلیل فصلی بودن)، سازمان یاد نمیگیرد که کمپین مؤثر بوده — بلکه میفهمد که عامل دیگری (فصلی بودن) علت افزایش فروش بوده است. STDP، دقیقاً همین منطق علّی را در سطح سیناپسی پیادهسازی میکند: ترتیب زمانی، تعیینکننده یادگیری است.
تعامل STDP با ریتمهای مغزی و سلولهای گلیا
STDP، در خلأ رخ نمیدهد. این مکانیزم، با ریتمهای مغزی(مانند ریتم تتا در هیپوکامپ) و سلولهای گلیا (مانند آستروسیتها) تعامل دارد. ریتمهای مغزی، پنجرههای زمانی برای STDP ایجاد میکنند: نورونها در فازهای خاص ریتم، آمادهتر برای یادگیری هستند. آستروسیتها نیز، با تنظیم غلظت نوروترانسمیترها و یونها، بر STDP تأثیر میگذارند. این تعامل چندلایه، نشان میدهد که یادگیری، یک فرآیند توزیعشده است که در آن نورونها، گلیا، و ریتمها همگی نقش دارند.
۳.۴.۴ یادگیری تقویتی در مغز: دوپامین بهعنوان سیگنال خطای پیشبینی پاداش
تا اینجا، عمدتاً بر یادگیری هبی و STDP متمرکز بودهایم — مکانیزمهایی که بر همزمانی و ترتیب شلیکها استوارند. اما مغز، مکانیزم دیگری نیز دارد: یادگیری تقویتی . (Reinforcement Learning) در این نوع یادگیری، پاداش و تنبیه، رفتار را شکل میدهند. پرسش کلیدی این است: مغز چگونه پاداش را نمایش میدهد؟ و چگونه از پاداش برای یادگیری استفاده میکند؟
پاسخ این پرسش، در دوپامین نهفته است. دوپامین، یک نوروترانسمیتر است که توسط نورونهای دوپامینرژیک در مغز میانی (Mesencephalon) تولید میشود. این نورونها، به نواحی مختلف مغز — از جمله جسم مخطط (Striatum)، قشر پیشپیشانی، و آمیگدال — فرافکنی میکنند. ولفرام شولتز و همکاران (۱۹۹۷)، با ثبت فعالیت نورونهای دوپامینرژیک در میمونها، کشف کردند که این نورونها نه به پاداش خود، بلکه به خطای پیشبینی پاداش (Reward Prediction Error, RPE) پاسخ میدهند.
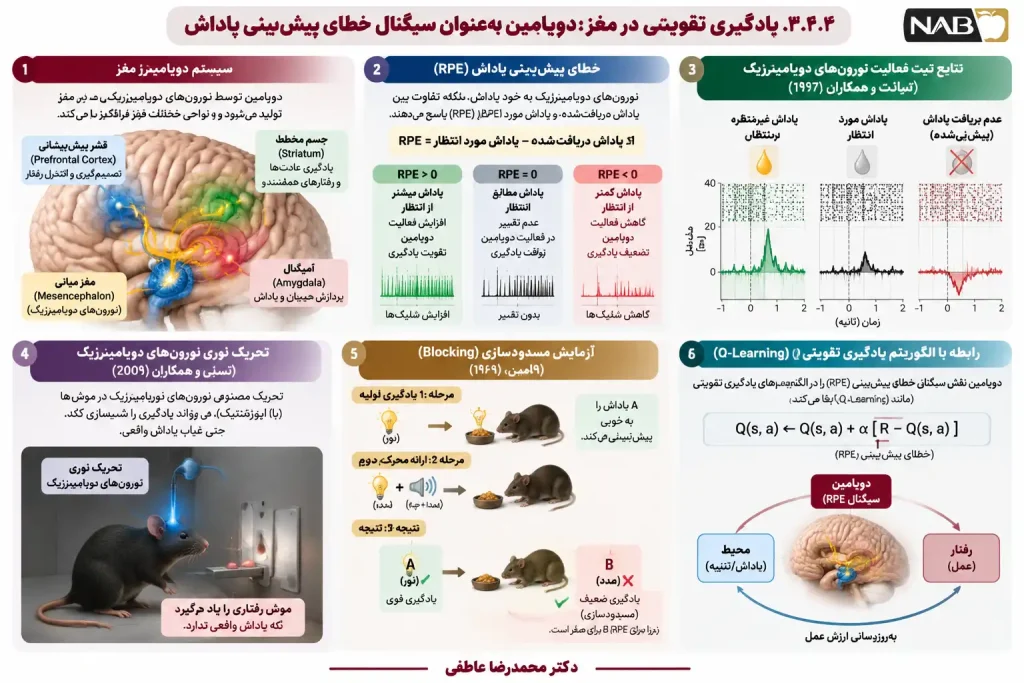
RPE، تفاوت بین پاداش دریافتشده و پاداش مورد انتظار است:
- اگر پاداش دریافتشده بیشتر از انتظار باشد (RPE > 0)، نورونهای دوپامینرژیک فعال میشوند و یادگیری تقویت میشود.
- اگر پاداش دریافتشده کمتر از انتظار باشد (RPE < 0)، فعالیت نورونهای دوپامینرژیک کاهش مییابد و یادگیری تضعیف میشود.
- اگر پاداش دقیقاً مطابق انتظار باشد (RPE = 0)، تغییری در فعالیت دوپامین رخ نمیدهد و یادگیری متوقف میشود.
این مکانیزم، دقیقاً با الگوریتم یادگیری تقویتی (مانند Q-Learning) مطابقت دارد. در Q-Learning، ارزش یک عمل در یک حالت، بر اساس خطای پیشبینی بهروزرسانی میشود. دوپامین، نقش سیگنال RPE را ایفا میکند: افزایش آن، تقویت یادگیری؛ کاهش آن، تضعیف یادگیری (Schultz et al., 1997; Montague et al., 1996).
مثال مدیریتی: دوپامین بهعنوان پاداش و انتظار در سازمان
فرض کنید یک شرکت به کارکنان خود پاداش میدهد. اگر پاداش بیشتر از انتظار کارکنان باشد (مثلاً پاداش سالانه ۲۰٪ بیشتر از سال قبل)، کارکنان انگیزه بیشتری پیدا میکنند و رفتار خود را تقویت میکنند. پس اگر پاداش کمتر از انتظار باشد، کارکنان دلسرد میشوند و رفتار خود را تغییر میدهند. اگر پاداش دقیقاً مطابق انتظار باشد، کارکنان بیتفاوت میمانند و رفتار خود را تغییر نمیدهند. دوپامین، دقیقاً همین منطق را در مغز پیادهسازی میکند: پاداش غیرمنتظره، یادگیری را تقویت میکند؛ پاداش مورد انتظار، یادگیری را متوقف میکند. برای مدیران، این درس به این معناست که پاداشهای غیرمنتظره و متغیر، انگیزه بیشتری از پاداشهای ثابت و قابلپیشبینی ایجاد میکنند.
شواهد علّی: تحریک نورونهای دوپامینرژیک
شولتز و همکاران، نه فقط همبستگی بین دوپامین و RPE را نشان دادند، بلکه رابطه علّی را نیز اثبات کردند. تسای و همکاران (۲۰۰۹) با تحریک نوری (Optogenetic) نورونهای دوپامینرژیک در موشها، نشان دادند که تحریک مصنوعی این نورونها، یادگیری را شبیهسازی میکند: موشها، رفتاری را یاد میگیرند که هیچ پاداش واقعی نداشته است. این شواهد علّی، نقش محوری دوپامین در یادگیری تقویتی را تأیید میکند.
تمایز دوپامین بهعنوان RPE در برابر سیگنال ارزش
نکته مهمی که باید به آن توجه کرد این است که دوپامین، نه یک سیگنال پاداش ساده، بلکه یک سیگنال خطای پیشبینی است. این تمایز، حیاتی است: اگر دوپامین فقط پاداش را نشان میداد، یادگیری متوقف میشد زمانی که پاداش دریافت میشد. اما چون دوپامین خطای پیشبینی را نشان میدهد، یادگیری ادامه مییابد تا زمانی که پاداش دقیقاً مطابق انتظار شود. این ویژگی، به مغز اجازه میدهد که بهطور مداوم رفتار خود را بهبود دهد (Schultz, 1998).
مثال گسترده: آزمایشهای مسدودسازی (Blocking) و نقش دوپامین
آزمایشهای مسدودسازی، که اولین بار توسط لئون کامین (۱۹۶۹) انجام شد، شواهد قوی برای نقش دوپامین بهعنوان RPE فراهم میکنند. در این آزمایشها، حیوان ابتدا یاد میگیرد که یک محرک (مثلاً نور) با پاداش (مثلاً غذا) همراه است. سپس، یک محرک دوم (مثلاً صدا) همزمان با محرک اول ارائه میشود. نتیجه: حیوان یاد نمیگیرد که صدا با پاداش همراه است — زیرا محرک اول، پاداش را بهطور کامل پیشبینی میکند و RPE برای محرک دوم صفر است. این پدیده، مسدودسازی نامیده میشود و دقیقاً با پیشبینی مدل RPE مطابقت دارد.
مثال مدیریتی: مسدودسازی در یادگیری سازمانی
فرض کنید یک شرکت، پاداش سالانه را دقیقاً مطابق عملکرد کارکنان پرداخت میکند. حالا مدیرعامل تصمیم میگیرد یک پاداش جدید (مثلاً سهام شرکت) نیز معرفی کند. اگر پاداش سالانه بهخوبی عملکرد را پیشبینی کند، کارکنان یاد نمیگیرند که سهام با عملکرد مرتبط است — زیرا پاداش سالانه، پاداش را بهطور کامل پیشبینی میکند و RPE برای سهام صفر است. این، دقیقاً مسدودسازی است. برای یادگیری مؤثر، پاداش جدید باید غیرمنتظره و متمایز از پاداشهای قبلی باشد.
۳.۴.۵ نورومدولاتورها و کنترل یادگیری
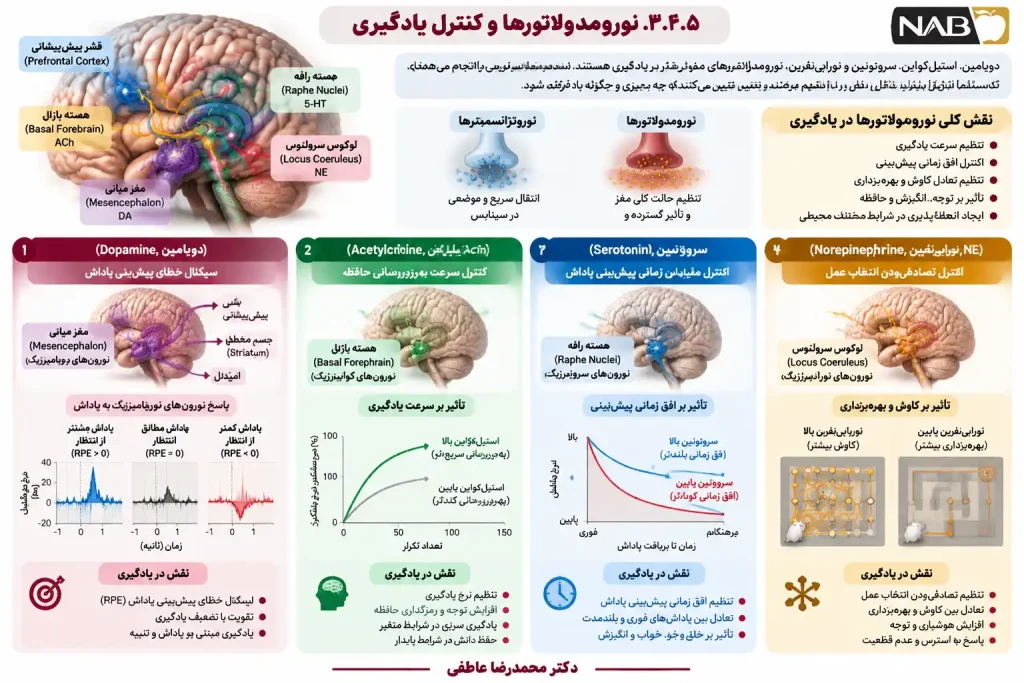
دوپامین، تنها نورومدولاتور مؤثر بر یادگیری نیست. سه نورومدولاتور دیگر — استیلکولین، سروتونین، و نوراپینفرین — نیز نقشهای کلیدی در تنظیم یادگیری ایفا میکنند. این نورومدولاتورها، برخلاف نوروترانسمیترها که مستقیماً انتقال سیناپسی را انجام میدهند، حالت کلی مغز را تنظیم میکنند و تعیین میکنند که چه چیزی و چگونه یاد گرفته شود.
استیلکولین: کنترل سرعت بهروزرسانی حافظه
استیلکولین (Acetylcholine, ACh)، که توسط نورونهای کولینرژیک در هسته بازال (Basal Forebrain) و ساقه مغز تولید میشود، نقش حیاتی در توجه، یادگیری، و حافظه دارد. تحقیقات نشان داده است که استیلکولین، نرخ یادگیری را تنظیم میکند: افزایش استیلکولین، سرعت بهروزرسانی حافظه را افزایش میدهد؛ کاهش آن، سرعت بهروزرسانی را کاهش میدهد. این مکانیزم، به مغز اجازه میدهد که در شرایط متغیر، سریعتر یاد بگیرد و در شرایط پایدار، دانش قبلی را حفظ کند (Hasselmo, 2006).
سروتونین: کنترل مقیاس زمانی پیشبینی پاداش
سروتونین (Serotonin, 5-HT)، که توسط نورونهای سروتونرژیک در هسته رافه (Raphe Nuclei) تولید میشود، نقش مهمی در تنظیم خلقوخو، خواب، و اشتها دارد. اما تحقیقات جدید نشان داده است که سروتونین، مقیاس زمانی پیشبینی پاداش را نیز تنظیم میکند: افزایش سروتونین، افق زمانی پیشبینی را طولانیتر میکند (یعنی پاداشهای بلندمدت مهمتر میشوند)؛ کاهش آن، افق زمانی را کوتاهتر میکند (یعنی پاداشهای فوری مهمتر میشوند). این مکانیزم، به مغز اجازه میدهد که بین پاداشهای فوری و پاداشهای بلندمدت تعادل برقرار کند (Doya, 2002).
نوراپینفرین: کنترل تصادفیبودن انتخاب عمل
نوراپینفرین (Norepinephrine, NE)، که توسط نورونهای نورآدرنرژیک در لوکوس سرولئوس (Locus Coeruleus) تولید میشود، نقش حیاتی در هوشیاری، توجه، و پاسخ به استرس دارد. تحقیقات نشان داده است که نوراپینفرین، تصادفیبودن (Stochasticity) انتخاب عمل را تنظیم میکند: افزایش نوراپینفرین، تنوع رفتار را افزایش میدهد (یعنی کاوش بیشتر)؛ کاهش آن، تنوع را کاهش میدهد (یعنی بهرهبرداری بیشتر). این مکانیزم، به مغز اجازه میدهد که بین کاوش (Exploration) و بهرهبرداری (Exploitation) تعادل برقرار کند (Aston-Jones & Cohen, 2005).
مثال مدیریتی: نقش استیلکولین در توجه و یادگیری از خطاها
فرض کنید یک سازمان، سیستم بازخورد خود را بهبود داده است. استیلکولین، نقش مشابه توجه در سازمان را ایفا میکند: اگر سازمان توجه خود را بر خطاهای پیشبینی متمرکز کند (مثلاً تحلیل شکستهای پروژهها)، یادگیری سریعتر رخ میدهد. اگر توجه پراکنده باشد، یادگیری کند و ناکارآمد میشود. استیلکولین، دقیقاً همین نقش را در مغز ایفا میکند: افزایش آن، توجه به خطاها را افزایش میدهد و یادگیری را تسریع میکند.
۳.۴.۶ یادگیری بدون نظارت و خودسازماندهی در قشر
تا اینجا، عمدتاً بر یادگیری با نظارت (Supervised Learning) و یادگیری تقویتی متمرکز بودهایم — مکانیزمهایی که به سیگنال خطا یا پاداش نیاز دارند. اما مغز، مکانیزم سومی نیز دارد: یادگیری بدون نظارت.(Unsupervised Learning) در این نوع یادگیری، هیچ برچسب یا پاداشی وجود ندارد؛ مغز خودش الگوها را کشف میکند و سازماندهی درونی دادهها را میآموزد.
سازماندهی خودکار نقشههای قشری
یکی از شگفتانگیزترین نمونههای یادگیری بدون نظارت، نقشههای توپوگرافیک در قشر است. در قشر بینایی، نورونهای مجاور به نقاط مجاور میدان بینایی پاسخ میدهند. پس در قشر شنوایی، نورونهای مجاور به فرکانسهای مجاور پاسخ میدهند. در قشر حسیتنی، نورونهای مجاور به نقاط مجاور بدن پاسخ میدهند. این نقشهها، بهطور خودکار و بدون نظارت شکل میگیرند: مغز، الگوهای همبستگی در ورودیهای حسی را کشف میکند و نورونهای مشابه را کنار هم قرار میدهد.
مدل کوهونن: سازماندهی خودساز
تویو کوهونن (Teuvo Kohonen)، دانشمند فنلاندی، در دهه ۱۹۸۰ مدل ریاضی سازماندهی خودساز (Self-Organizing Map, SOM) را ارائه کرد که دقیقاً همین فرآیند را شبیهسازی میکند. در SOM، نورونها در یک شبکه دوبعدی قرار میگیرند و هر نورون، یک بردار وزن دارد. در هر گام، ورودی به شبکه ارائه میشود و نورونی که وزن آن بیشترین شباهت را به ورودی دارد (برنده)، انتخاب میشود. سپس، وزن نورون برنده و همسایگان آن، به سمت ورودی حرکت میکنند. این فرآیند، باعث میشود که نورونهای مجاور، ویژگیهای مشابه را نمایش دهند و نقشههای توپوگرافیک شکل بگیرند (Kohonen, 1982).
مثال مدیریتی: یادگیری بدون نظارت در تحلیل مشتریان
فرض کنید یک شرکت خردهفروشی، دادههای خرید مشتریان را جمعآوری کرده است، اما هیچ برچسبی برای دستهبندی مشتریان ندارد. با یادگیری بدون نظارت (مانند SOM یا خوشهبندی)، شرکت میتواند الگوهای پنهان در رفتار مشتریان را کشف کند: مثلاً مشتریانی که محصولات مشابه میخرند، در یک خوشه قرار میگیرند. این خوشهها، بدون هیچ برچسب از پیش تعیینشده، شکل میگیرند و به شرکت کمک میکنند که استراتژیهای بازاریابی خود را بهتر طراحی کند.
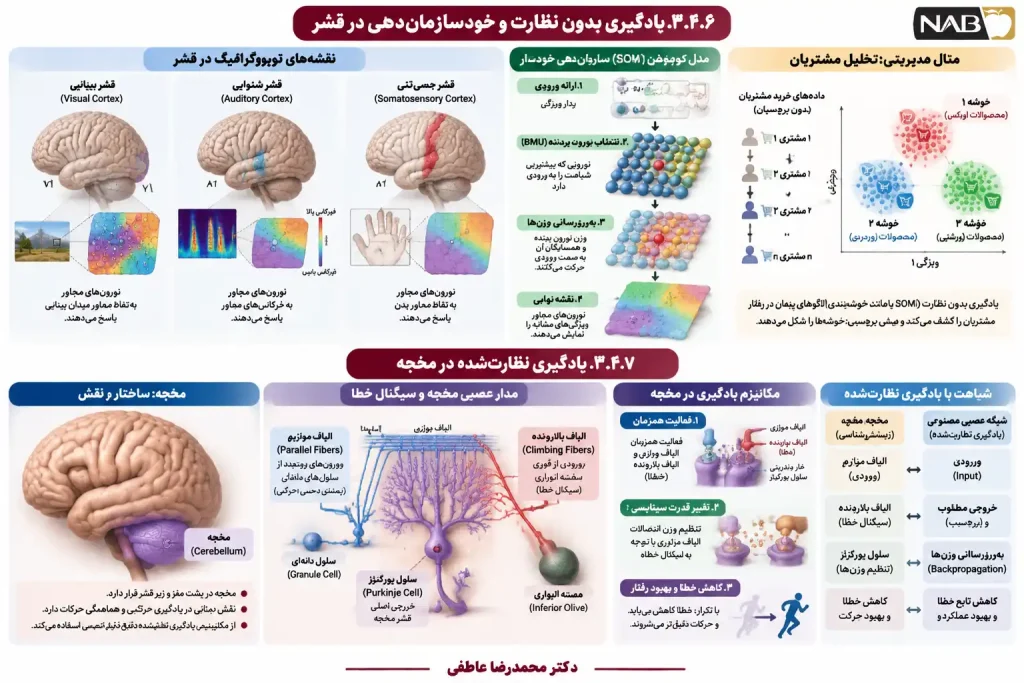
۳.۴.۷ یادگیری نظارتشده در مخچه
مخچه (Cerebellum)، که در پشت مغز و زیر قشر قرار دارد، نقش حیاتی در یادگیری حرکتی و هماهنگی حرکات ایفا میکند. برخلاف قشر، که عمدتاً یادگیری بدون نظارت و تقویتی دارد، مخچه مکانیزم یادگیری نظارتشده (Supervised Learning) دقیق و تخصصی دارد.
سلولهای پورکنژ و یادگیری حرکتی
سلولهای پورکنژ (Purkinje Cells)، نورونهای بزرگ و پیچیده مخچه هستند که خروجی اصلی قشر مخچه را تشکیل میدهند. این سلولها، دو نوع ورودی دریافت میکنند:
۱. الیاف موازی (Parallel Fibers): ورودیهای متعدد از سلولهای دانهای (Granule Cells). این ورودیها، زمینه حسی و حرکتی را نمایش میدهند.
۲. الیاف بالارونده (Climbing Fibers): ورودیهای قوی از هسته الیواری(Inferior Olive). این ورودیها، سیگنال خطا را منتقل میکنند.
یادگیری در مخچه، بر اساس تعامل این دو ورودی است: الیاف بالارونده، سیگنال خطا را ارسال میکنند و سلول پورکنژ، وزن اتصالات خود با الیاف موازی را تنظیم میکند تا خطا کاهش یابد. این مکانیزم، دقیقاً مشابه یادگیری نظارتشده در شبکههای عصبی مصنوعی است: سیگنال خطا، وزنها را تنظیم میکند (Ito, 2000).
مثال گسترده: یادگیری پرتاب توپ بسکتبال
برای درک بهتر یادگیری مخچه، مثال یادگیری پرتاب توپ بسکتبال را مرور میکنیم:
- مرحله ۱: کنترل حرکتی ناخودآگاه. وقتی شما برای اولین بار توپ بسکتبال را پرتاب میکنید، حرکات شما ناخودآگاه و ناهماهنگ است. مخچه، هنوز یاد نگرفته است که چگونه نیروی بازو، زاویه پرتاب، و زمان رهاسازی را تنظیم کند.
- مرحله ۲: دریافت خطا. وقتی توپ به حلقه نمیرسد (یا از حلقه عبور میکند)، الیاف بالارونده سیگنال خطا را به سلولهای پورکنژ ارسال میکنند.
- مرحله ۳: تنظیم وزن. سلولهای پورکنژ، وزن اتصالات خود با الیاف موازی را تنظیم میکنند تا خطا کاهش یابد.
- مرحله ۴: تکرار و خودکارشدگی. با تکرار این فرآیند، مخچه بهتدریج یاد میگیرد که چه ترکیبی از ورودیهای حسی و حرکتی، به پرتاب موفق منجر میشود. پس از سالها تمرین، پرتاب توپ برای شما خودکار میشود — بدون نیاز به فکر آگاهانه.
این فرآیند، دقیقاً مشابه آموزش یک شبکه عصبی مصنوعی با الگوریتم پسانتشار خطا است: سیگنال خطا، وزنها را تنظیم میکند و شبکه بهتدریج عملکرد خود را بهبود میدهد.
درس مدیریتی: یادگیری مخچه، نشان میدهد که بازخورد دقیق و بلافاصله، کلید یادگیری مهارتهای حرکتی و فرآیندهای عملیاتی است. در سازمانها، سیستمهای بازخورد سریع (مانند داشبوردهای عملکرد لحظهای) میتوانند یادگیری سازمانی را تسریع کنند — دقیقاً همانطور که الیاف بالارونده، یادگیری حرکتی را تسریع میکنند.
جمعبندی بخش ۳.۴: چه چیزی از یادگیری مغز میآموزیم؟
در این بخش، مکانیزمهای یادگیری مغز را از سطح سیناپسی تا سطح سیستم بررسی کردیم. آنچه دیدیم، تنوع شگفتانگیز مکانیزمهای یادگیری در مغز است — هر مکانیزم، برای نوع خاصی از یادگیری تخصص یافته است:
۱. یادگیری هبی وSTDP: مکانیزمهای بنیادین که بر همزمانی و ترتیب زمانی شلیکها استوارند. این مکانیزمها، پایه یادگیری تداعیگر (Associative Learning) را تشکیل میدهند.
۲. LTP وLTD: مکانیزمهای بلندمدت که تعادل بین تقویت و تضعیف سیناپسها را ممکن میسازند. این تعادل، کلید انعطافپذیری مغز است.
۳. یادگیری تقویتی و دوپامین: مکانیزمی که بر خطای پیشبینی پاداش استوار است و رفتار را بر اساس پاداش و تنبیه شکل میدهد.
۴. نورومدولاتورها: استیلکولین، سروتونین، و نوراپینفرین، حالت کلی مغز را تنظیم میکنند و تعیین میکنند که چه چیزی و چگونه یاد گرفته شود.
۵. یادگیری بدون نظارت: مکانیزمی که بدون برچسب یا پاداش، الگوهای پنهان در دادهها را کشف میکند و نقشههای توپوگرافیک را شکل میدهد.
۶. یادگیری نظارتشده در مخچه: مکانیزمی که با سیگنال خطا، مهارتهای حرکتی را به صورت دقیق یاد میگیرد و به خودکارشدگی میرساند.
درس نهایی برای مدیران: مغز، یک مکانیزم یادگیری واحد ندارد؛ بلکه مجموعهای از مکانیزمهای مکمل دارد که هر یک، برای نوع خاصی از یادگیری مناسب است. سازمانهای مؤثر نیز باید همین تنوع را در فرآیندهای یادگیری خود داشته باشند: یادگیری از تجربه (هبی)، یادگیری از پاداش (تقویتی)، یادگیری از خطا (نظارتشده)، و یادگیری بدون نظارت (کشف الگوهای پنهان). ترکیب این مکانیزمها، یادگیری سازمانی عمیق و پایدار را ممکن میسازد.
منابع بخش ۳.۴
Aston-Jones, G., & Cohen, J. D. (2005). An integrative theory of locus coeruleus-norepinephrine function: Adaptive gain and optimal performance. Annual Review of Neuroscience, *28*, 403–450. https://doi.org/10.1146/annurev.neuro.28.061604.135709
Bi, G. Q., & Poo, M. M. (1998). Synaptic modifications in cultured hippocampal neurons: Dependence on spike timing, synaptic strength, and postsynaptic cell type. Journal of Neuroscience, *18*(24), 10464–10472. https://doi.org/10.1523/JNEUROSCI.18-24-10464.1998
Bliss, T. V. P., & Lømo, T. (1973). Long-lasting potentiation of synaptic transmission in the dentate area of the anaesthetized rabbit following stimulation of the perforant path. The Journal of Physiology, *232*(2), 331–356. https://doi.org/10.1113/jphysiol.1973.sp010273
Caporale, N., & Dan, Y. (2008). Spike timing-dependent plasticity: A Hebbian learning rule. Annual Review of Neuroscience, *31*, 25–46. https://doi.org/10.1146/annurev.neuro.31.060407.125639
Doya, K. (2002). Metalearning and neuromodulation. Neural Networks, *15*(4–6), 495–506. https://doi.org/10.1016/S0893-6080(02)00044-8
Fiorillo, C. D., Tobler, P. N., & Schultz, W. (2003). Discrete coding of reward probability and uncertainty by dopamine neurons. Science, *299*(5614), 1898–1902. https://doi.org/10.1126/science.1077349
Frey, U., & Morris, R. G. M. (1997). Synaptic tagging and long-term potentiation. Nature, *385*(6616), 533–536. https://doi.org/10.1038/385533a0
Gerstner, W., Kistler, W. M., Naud, R., & Paninski, L. (2014). Neuronal dynamics: From single neurons to networks and models of cognition. Cambridge University Press.
Hasselmo, M. E. (2006). The role of acetylcholine in learning and memory. Current Opinion in Neurobiology, *16*(6), 710–715. https://doi.org/10.1016/j.conb.2006.09.002
Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley.
Ito, M. (2000). Mechanisms of motor learning in the cerebellum. Brain Research, *886*(1–2), 237–245. https://doi.org/10.1016/S0006-8993(00)03142-5
Kamin, L. J. (1969). Predictability, surprise, attention, and conditioning. In B. A. Campbell & R. M. Church (Eds.), Punishment and aversive behavior (pp. 279–296). Appleton-Century-Crofts.
Kohonen, T. (1982). Self-organized formation of topologically correct feature maps. Biological Cybernetics, *43*(1), 59–69. https://doi.org/10.1007/BF00337288
Magee, J. C., & Grienberger, C. (2020). Synaptic plasticity forms and functions. Annual Review of Neuroscience, *43*, 95–117. https://doi.org/10.1146/annurev-neuro-090919-022842
Malenka, R. C., & Bear, M. F. (2004). LTP and LTD: An embarrassment of riches. Neuron, *44*(1), 5–21. https://doi.org/10.1016/j.neuron.2004.09.012
Markram, H., Lübke, J., Frotscher, M., & Sakmann, B. (1997). Regulation of synaptic efficacy by coincidence of postsynaptic APs and EPSPs. Science, *275*(5297), 213–215. https://doi.org/10.1126/science.275.5297.213
Montague, P. R., Dayan, P., & Sejnowski, T. J. (1996). A framework for mesencephalic dopamine systems based on predictive Hebbian learning. Journal of Neuroscience, *16*(5), 1936–1947. https://doi.org/10.1523/JNEUROSCI.16-05-01936.1996
Niv, Y., Daw, N. D., Joel, D., & Dayan, P. (2007). Tonic dopamine: Opportunity costs and the control of response vigor. Psychopharmacology, *191*(3), 507–520. https://doi.org/10.1007/s00213-006-0502-4
Schultz, W. (1998). Predictive reward signal of dopamine neurons. Journal of Neurophysiology, *80*(1), 1–27. https://doi.org/10.1152/jn.1998.80.1.1
Schultz, W., Dayan, P., & Montague, P. R. (1997). A neural substrate of prediction and reward. Science, *275*(5306), 1593–1599. https://doi.org/10.1126/science.275.5306.1593
Tsai, H. C., Zhang, F., Adamantidis, A., Stuber, G. D., Bonci, A., de Lecea, L., & Deisseroth, K. (2009). Phasic firing in dopaminergic neurons is sufficient for behavioral conditioning. Science, *324*(5930), 1080–1084. https://doi.org/10.1126/science.1168878
Waelti, P., Dickinson, A., & Schultz, W. (2001). Dopamine responses comply with basic assumptions of formal learning theory. Nature, *412*(6842), 43–48. https://doi.org/10.1038/35083500