۴.۸ درس ۷ — سلولهای گلیا و نقش آنها در یادگیری
۴.۸.۰ چرا نیمی از مغز نادیده گرفته شده است؟
تا اینجا در این فصل، درباره نورونها، دندریتها، پلاستیسیتی، کدگذاری زمانی، بهرهوری انرژی، یادگیری خودنظارتی و همگامسازی صحبت کردیم. اما یک حقیقت تکاندهنده وجود دارد که باید با آن روبرو شویم: نورونها فقط حدود نیمی از سلولهای مغز را تشکیل میدهند. نیم دیگر — که برای بیش از یک قرن بهعنوان «چسب عصبی» صرفاً بافت پشتیبان در نظر گرفته میشد — سلولهای گلیا (Glia) هستند (Kruyer et al., 2023, p. 21).
بیایید با یک مثال مدیریتی شروع کنیم. تصور کنید یک شرکت بزرگ تولیدی را در نظر بگیرید. نورونها مانند کارکنان خط تولید هستند: آنها محصول را میسازند و اطلاعات را پردازش میکنند. سلولهای گلیا مانند مدیران میانی، واحد کنترل کیفیت، بخش لجستیک و تیم نگهداری هستند: آنها مستقیماً محصول تولید نمیکنند، اما بدون آنها خط تولید متوقف میشود. اگر مدیران میانی نتوانند ارتباط بین بخشها را هماهنگ کنند، اگر کنترل کیفیت محصولات معیوب را حذف نکند، و اگر لجستیک مواد اولیه را بهموقع نرساند، بهترین کارکنان خط تولید هم نمیتوانند عملکرد مطلوبی داشته باشند.
مغز دقیقاً همین ساختار را دارد. سلولهای گلیا — که حدود ۸۵ میلیارد سلول در مغز انسان هستند — نه فقط نورونها را «کنار هم نگه میدارند»، بلکه فعالانه در پردازش اطلاعات، تنظیم پلاستیسیتی، هرس سیناپسی و تثبیت حافظه نقش دارند (Escalada et al., 2024, p. 1; Kruyer et al., 2023, p. 21).
مهمترین انواع سلولهای گلیا:
| نوع سلول گلیا | فراوانی | نقش اصلی |
| آستروسیت (Astrocyte) | ~۲۰–۴۰٪ سلولهای گلیا | تنظیم سیناپس، پلاستیسیتی، متابولیسم |
| میکروگلیا (Microglia) | ~۵–۱۰٪ | ایمنی، هرس سیناپسی، ترمیم |
| الیگودندروسیت (Oligodendrocyte) | ~۵–۱۰٪ | میلینسازی، تسریع انتقال سیگنال |
در این بخش، به بررسی دو نوع اصلی — آستروسیتها و میکروگلیا — میپردازیم و نشان میدهیم که چگونه این سلولها — که سالها نادیده گرفته میشدند — اجزای فعال یادگیری و حافظه هستند. سپس پیامدهای آنها برای مدلسازی شبکههای عصبی مصنوعی را بررسی میکنیم.
۴.۸.۱ آستروسیتها بهعنوان تنظیمکنندههای پلاستیسیتی
سیناپس سهجزئی: کشف مجدد آستروسیتها
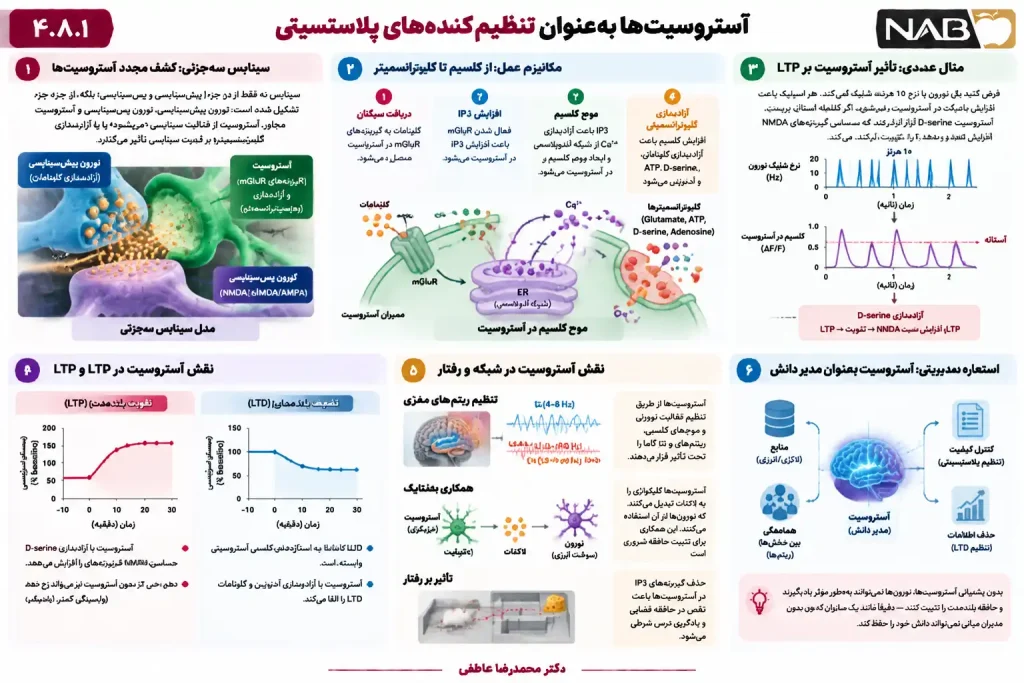
برای بیش از یک قرن، از زمان کشف آستروسیتها در حدود سال ۱۸۷۰، این سلولها بهعنوان «بستهبندی» برای نورونها در نظر گرفته میشدند. تصور میشد که آنها فقط مواد مغذی را منتقل میکنند و نورونها را کنار هم نگه میدارند. اما در دهه ۱۹۹۰، پارادایم تغییر کرد. محققان کشف کردند که آستروسیتها گیرندههای نوروترانسمیتر دارند و میتوانند به فعالیت سیناپسی پاسخ دهند. در سال ۱۹۹۹، اصطلاح «سیناپس سهجزئی» (Tripartite Synapse) توسط Araque و همکارانش ابداع شد تا این واقعیت را به رسمیت بشناسد که سیناپس نه از دو جزء (پیشسیناپسی و پسسیناپسی)، بلکه از سه جزء تشکیل شده است: نورون پیشسیناپسی، نورون پسسیناپسی و آستروسیت مجاور (Kruyer et al., 2023, p. 22; Escalada et al., 2024, p. 1).
ایده ساده: آستروسیت مانند یک «شنونده» و «تنظیمکننده» عمل میکند: از یک طرف انتشار نوروترانسمیترها از نورون پیشسیناپسی را «میشنود»، و از طرف دیگر با آزادسازی گلیوترانسمیترها بر قدرت سیناپسی تأثیر میگذارد (Kruyer et al., 2023, p. 22).
مکانیزم عمل: از کلسیم تا گلیوترانسمیتر
آستروسیتها چگونه این کار را انجام میدهند؟ مکانیزم اصلی موج کلسیم است:
۱. دریافت سیگنال: وقتی نورون پیشسیناپسی فعال میشود، گلوتامات آزاد میکند. آستروسیتهای مجاور گیرندههای mGluR (گیرندههای متابوتروپیک گلوتامات) دارند که این گلوتامات را تشخیص میدهند.
۲. موج کلسیم: فعال شدن این گیرندهها باعث افزایش IP3 (اینوزیتول تریفسفات) در آستروسیت میشود. IP3 باعث آزادسازی کلسیم از شبکه آندوپلاسمی (ER) میشود. این افزایش کلسیم میتواند بهصورت موج (Calcium Wave) در شبکه آستروسیتی منتشر شود.
۳. آزادسازی گلیوترانسمیتر: افزایش کلسیم باعث آزادسازی گلیوترانسمیترها (مانند گلوتامات، ATP، D-serine و آدنوزین) از آستروسیت میشود (Escalada et al., 2024, p. 2).
۴. تنظیم سیناپس: این گلیوترانسمیترها بر نورون پیشسیناپسی (تنظیم آزادسازی نوروترانسمیتر) و نورون پسسیناپسی (تنظیم حساسیت گیرندهها) تأثیر میگذارند.
مثال عددی: فرض کنید یک آستروسیت به نورونی متصل است که با نرخ ۱۰ هرتز شلیک میکند. هر اسپایک باعث آزادسازی گلوتامات و افزایش کلسیم در آستروسیت میشود. اگر این افزایش کلسیم به آستانهای برسد، آستروسیت D-serine آزاد میکند — که یک کوانونوروترانسمیتر برای گیرندههای NMDA است. این D-serine باعث افزایش حساسیت گیرندههای NMDA به گلوتامات میشود و بنابراین LTP را تقویت میکند (Escalada et al., 2024, p. 2).
نکته مهم: مطالعات نشان دادهاند که LTD (تضعیف بلندمدت) — برخلاف LTP — کاملاً به آستروسیتها وابسته است. مطالعات نشان دادند که LTD، اما نه LTP، به سیگنالدهی کلسیم آستروسیتی وابسته است. این یعنی حذف اطلاعات (LTD) نیز توسط آستروسیتها تنظیم میشود — نه فقط یادگیری (LTP) (Escalada et al., 2024, p. 2).
پیامدهای برای یادگیری و حافظه
آستروسیتها نه فقط در سطح سیناپس، بلکه در سطح شبکه نیز بر یادگیری و حافظه تأثیر میگذارند:
۱. تنظیم ریتمهای مغزی: همانطور که در بخش ۴.۷ دیدیم، همگامسازی بین نواحی مغزی برای حافظه کاری و ادغام اطلاعات حیاتی است. آستروسیتها از طریق تنظیم فعالیت نورونی و انتشار موجهای کلسیم، ریتمهای گاما و تتا را تحت تأثیر قرار میدهند (Escalada et al., 2024, p. 5). حذف آستروسیتها از هیپوکامپ باعث اختلال در ریتم تتا و نقص در حافظه فضایی میشود.
۲. همکاری متابولیک: آستروسیتها گلیکوژن ذخیره میکنند و آن را به لاکتات تبدیل میکنند که نورونها میتوانند بهعنوان سوخت استفاده کنند. این همکاری متابولیک برای تثبیت حافظه (Memory Consolidation) ضروری است (Escalada et al., 2024, p. 4). مطالعات نشان دادهاند که مسدود کردن انتقال لاکتات از آستروسیت به نورون، تثبیت حافظه بلندمدت را مختل میکند.
۳. تنظیم رفتار: مطالعات رفتاری نشان دادهاند که دستکاری آستروسیتها بر یادگیری و حافظه در الگوهای رفتاری مختلف تأثیر میگذارد. برای مثال، حذف گیرندههای IP3 در آستروسیتها باعث نقص در حافظه فضایی و یادگیری ترس شرطی میشود (Escalada et al., 2024, p. 3).
مثال مدیریتی: فرض کنید یک شرکت مشاورهای میخواهد دانش جمعی تیم خود را تثبیت کند. آستروسیتها در اینجا نقش «مدیر دانش» را ایفا میکنند: آنها متابولیتها (لاکتات) را به نورونها میرسانند — مانند منابع (زمان، بودجه، پشتیبانی مدیریت) که به تیمها داده میشود. اگر این همکاری متابولیک (منابع) مختل شود، تثبیت حافظه (دانش سازمانی) نیز مختل میشود. یک سازمان بدون پشتیبانی متابولیک (منابع کافی) نمیتواند دانش خود را تثبیت کند — دقیقاً مشابه مغزی که بدون آستروسیتها نمیتواند حافظه بلندمدت بسازد.
۴.۸.۲ میکروگلیا و هرس سیناپسی
میکروگلیا: نه فقط سیستم ایمنی
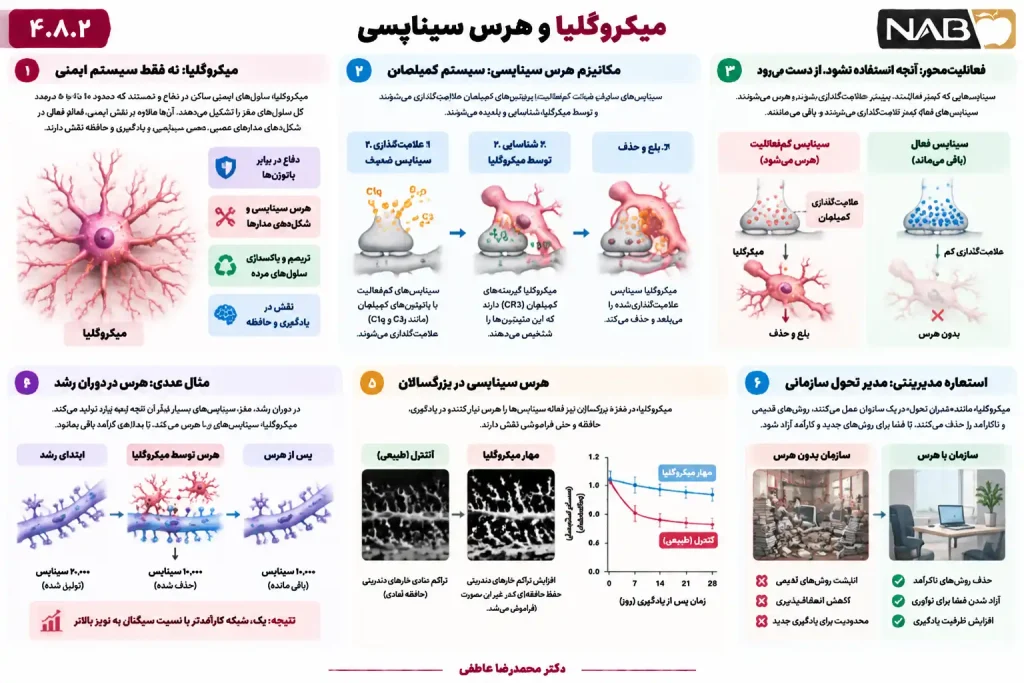
میکروگلیا (Microglia) سلولهای ایمنی ساکن در مغز و نخاع هستند. آنها حدود ۵ تا ۱۰ درصد کل سلولهای مغز را تشکیل میدهند و نقش اولیه آنها دفاع در برابر پاتوژنها و پاکسازی سلولهای مرده است (Kruyer et al., 2023, p. 23). اما تحقیقات دو دهه اخیر نشان دادهاند که میکروگلیا فراتر از یک سلول ایمنی ساده عمل میکنند: آنها فعالانه در شکلدهی مدارهای عصبی، هرس سیناپسی و یادگیری و حافظه نقش دارند (Kruyer et al., 2023, p. 23; Miyanishi et al., 2021).
ایده کلیدی: مغز در دوران رشد، سیناپسهای بسیار بیشتری از آنچه نیاز دارد تولید میکند. سپس میکروگلیا — مانند یک باغبان — سیناپسهای ضعیف و غیرضروری را هرس میکند تا مدارهای کارآمد باقی بمانند. این فرآیند هر سیناپسی (Synaptic Pruning) نام دارد.
مکانیزم هرس: سیستم کمپلمان
میکروگلیا چگونه تشخیص میدهد که کدام سیناپس باید هرس شود؟ پاسخ در سیستم کمپلمان (Complement System) نهفته است — همان سیستمی که در سیستم ایمنی برای شناسایی و حذف پاتوژنها استفاده میشود (Stephan et al., 2012, p. 1).
مراحل هرس سیناپسی:
۱. علامتگذاری: سیناپسهای ضعیف و کمفعالیت با پروتئینهای کمپلمان (مانند C1q و C3) علامتگذاری میشوند (Stephan et al., 2012, p. 1; Kruyer et al., 2023, p. 23).
۲. شناسایی: میکروگلیا گیرندههای کمپلمان (CR3) دارند که این پروتئینها را تشخیص میدهند (Stephan et al., 2012, p. 1).
۳. بلع: میکروگلیا سیناپس علامتگذاریشده را میبلعد و حذف میکند (Stephan et al., 2012, p. 1).
نکته مهم: این فرآیند فعالیتمحور (Activity-Dependent) است. سیناپسهایی که کمتر فعال هستند، بیشتر علامتگذاری میشوند و بیشتر هرس میشوند. در مقابل، سیناپسهای فعال کمتر علامتگذاری میشوند و باقی میمانند (Stephan et al., 2012, p. 1). این یعنی هرس سیناپسی یک مکانیزم یادگیری است: «آنچه استفاده نشود، از دست میرود.»
مثال عددی: فرض کنید یک نورون با ۱۰,۰۰۰ سیناپس متصل است. در دوران رشد، ۲۰,۰۰۰ سیناپس تولید میشود. میکروگلیا ۱۰,۰۰۰ سیناپس (آنهایی که کمتر فعال هستند) را هرس میکند و ۱۰,۰۰۰ سیناپس (آنهایی که بیشتر فعال هستند) را باقی میگذارد. نتیجه یک شبکه کارآمدتر با نسبت سیگنال به نویز بالاتر است (Stephan et al., 2012, p. 1).
هرس سیناپسی در یادگیری بزرگسالان
برای مدتی تصور میشد که هرس سیناپسی فقط در دوران رشد رخ میدهد. اما تحقیقات اخیر نشان دادهاند که میکروگلیا در مغز بزرگسال نیز فعالانه سیناپسها را هرس میکنند و این فرآیند در یادگیری و حافظه نقش دارد (Miyanishi et al., 2021; Kruyer et al., 2023, p. 23).
مطالعه کلیدی: Miyanishi و همکاران (۲۰۲۱) نشان دادند که بلع سیناپسها توسط میکروگلیا در بزرگسالان در یادگیری و حافظه نقش دارد. آنها کشف کردند که مهار فارماکولوژیک میکروگلیا باعث افزایش تراکم خارهای دندریتی و حفظ حافظهای که در غیر این صورت فراموش میشد میشود (Miyanishi et al., 2021; Kruyer et al., 2023, p. 23). این یعنی میکروگلیا نه فقط هرس میکنند، بلکه فراموشی را نیز تنظیم میکنند.
نکته مهم: در بزرگسالان، هرس سیناپسی میتواند فراموشی را تسهیل کند — که برای یادگیری جدید ضروری است. اگر مغز نتواند اطلاعات قدیمی را هرس کند، ظرفیت برای یادگیری جدید محدود میشود. این دقیقاً مشابه فراموشی فاجعهبار در شبکههای مصنوعی است — که در بخش ۴.۹ به آن خواهیم پرداخت.
مثال مدیریتی: فرض کنید یک سازمان میخواهد روشهای قدیمی را کنار بگذارد و روشهای جدید را بپذیرد. میکروگلیا در اینجا نقش «مدیر تحول» را ایفا میکنند: آنها روشهای قدیمی (سیناپسهای ضعیف) را حذف میکنند تا فضا برای روشهای جدید (سیناپسهای فعال) آزاد شود. سازمانی که نتواند دانش قدیمی را هرس کند، ظرفیت برای یادگیری جدید ندارد — دقیقاً مشابه مغزی که بدون میکروگلیا نمیتواند مدارهای جدید بسازد.
۴.۸.۳ پیامدها: نیاز به مدلسازی سلولهای غیرعصبی در شبکههای مصنوعی
چرا شبکههای مصنوعی فقط نورون دارند؟
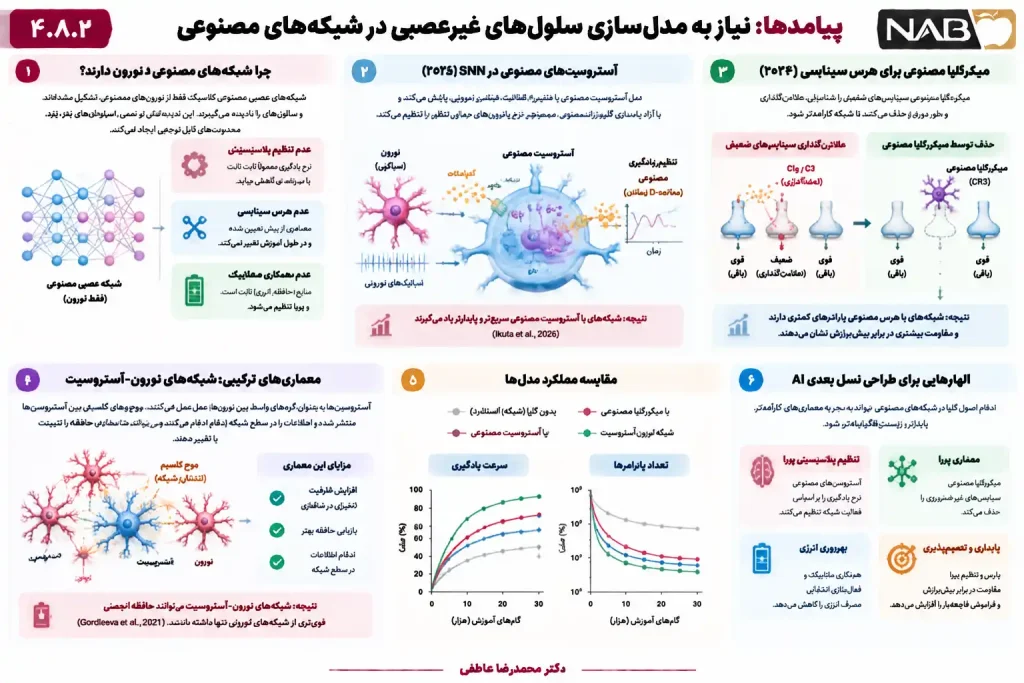
شبکههای عصبی مصنوعی کلاسیک — از پرسپترون تا Transformer — فقط از نورونهای مصنوعی تشکیل شدهاند. آنها سلولهای گلیا ندارند. این نادیده گرفتن نیمی از سلولهای مغز، محدودیتهای قابلتوجهی ایجاد میکند:
۱. عدم تنظیم پلاستیسیتی: در شبکههای مصنوعی، نرخ یادگیری معمولاً ثابت است یا با برنامه (Schedule) کاهش مییابد. اما در مغز، آستروسیتها نرخ یادگیری را پویا تنظیم میکنند (Escalada et al., 2024, p. 3).
۲. عدم هرس سیناپسی: در شبکههای مصنوعی، معماری از پیش تعیین میشود و در طول آموزش تغییر نمیکند. اما در مغز، میکروگلیا پویا سیناپسها را هرس میکنند و معماری را بهبود میدهند (Stephan et al., 2012, p. 1).
۳. عدم همکاری متابولیک: در شبکههای مصنوعی، منابع (حافظه، انرژی) ثابت است. اما در مغز، آستروسیتها متابولیتها را پویا بین نورونها توزیع میکنند (Escalada et al., 2024, p. 4).
مدلهای مصنوعی الهامگرفته از گلیا
محققان در حال توسعه مدلهای مصنوعی هستند که سلولهای گلیا را شبیهسازی میکنند. دو رویکرد اصلی وجود دارد:
الف) آستروسیتهای مصنوعی در SNN
مطالعهای در سال ۲۰۲۶ که در Neurocomputing منتشر شد، آستروسیتهای مصنوعی را به یک شبکه عصبی اسپایکی اضافه کرد و تأثیر آنها بر یادگیری را ارزیابی کرد (Ikuta et al., 2026). در این مدل:
- آستروسیت مصنوعی یک متغیر کلسیم دارد که با فعالیت نورونی افزایش مییابد.
- وقتی کلسیم از آستانه فراتر رود، آستروسیت گلیوترانسمیتر مصنوعی آزاد میکند.
- این گلیوترانسمیتر نرخ یادگیری نورونهای مجاور را تنظیم میکند.
نتیجه: شبکههای با آستروسیت مصنوعی سریعتر و پایدارتر از شبکههای بدون آستروسیت یاد میگیرند (Ikuta et al., 2026).
ب) میکروگلیا مصنوعی برای هرس سیناپسی
مطالعه دیگری در سال ۲۰۲۴، یک مکانیزم هرس مصنوعی الهامگرفته از میکروگلیا را به یک شبکه عصبی مصنوعی اضافه کرد. در این مدل:
- سیناپسهای ضعیف (با وزن کمتر از آستانه) علامتگذاری میشوند.
- میکروگلیا مصنوعی این سیناپسها را حذف میکند.
- هرس بهطور دورهای (مثلاً هر ۱۰۰۰ گام آموزش) انجام میشود.
نتیجه: شبکههای با هرس مصنوعی پارامترهای کمتری دارند و مقاومت بیشتری در برابر بیشبرازش نشان میدهند.
معماریهای ترکیبی: Neuron-Astrocyte Networks
یکی از پیشرفتهترین مدلهای الهامگرفته از گلیا، شبکههای نورون-آستروسیت (Neuron-Astrocyte Networks) است. در این معماری:
- آستروسیتها بهعنوان گرههای واسط بین نورونها عمل میکنند.
- موجهای کلسیم بین آستروسیتها منتشر میشوند و اطلاعات را در سطح شبکه ادغام میکنند.
- این موجها میتوانند حالتهای حافظه را تثبیت یا تغییر دهند (Gordleeva et al., 2021).
مطالعه کلیدی: Gordleeva و همکاران (۲۰۲۱) نشان دادند که شبکههای نورون-آستروسیت میتوانند حافظه انجمنی (Associative Memory) قویتری از شبکههای نورونی تنها داشته باشند. آستروسیتها ظرفیت ذخیرهسازی را افزایش میدهند و بازیابی حافظه را تسهیل میکنند (Gordleeva et al., 2021).
جدول مقایسه مدلهای گلیا:
| مدل | نوع گلیا | مکانیزم | مزیت اصلی |
| SNN + Astrocyte | آستروسیت مصنوعی | تنظیم نرخ یادگیری | یادگیری سریعتر |
| ANN + Microglia | میکروگلیا مصنوعی | هرس سیناپسی | مقاومت در برابر بیشبرازش |
| Neuron-Astrocyte Network | آستروسیت + نورون | موج کلسیم و ادغام | حافظه انجمنی قویتر |
۴.۸.۴ چالشها و محدودیتها
با وجود پتانسیل عظیم، مدلسازی سلولهای گلیا در شبکههای مصنوعی با چالشهایی مواجه است:
- چالش اول — پیچیدگی محاسباتی: مدلسازی موجهای کلسیم و دینامیک آستروسیت نیازمند معادلات دیفرانسیل پیچیده است که هزینه محاسباتی را افزایش میدهد.
- چالش دوم — عدم تطابق کامل با زیستشناسی: حتی پیشرفتهترین مدلهای گلیا سادهسازیهایی انجام میدهند. برای مثال، بسیاری از آنها نقش الیگودندروسیتها را نادیده میگیرند یا تعامل بین انواع مختلف گلیا را در نظر نمیگیرند.
- چالش سوم — دشواری آموزش: مکانیزمهای هرس و تنظیم نرخ یادگیری توسط گلیا، آموزش شبکه را پیچیدهتر میکنند. تنظیم دقیق پارامترهای گلیا (آستانه کلسیم، نرخ هرس) دشوار است.
- چالش چهارم — فقدان بنچمارک: مجموعههای داده و وظایف استاندارد برای ارزیابی مدلهای گلیا کمیاب هستند. اکثر مطالعات از وظایف ساده (مانند MNIST) استفاده میکنند و تعمیم به مسائل پیچیده مدیریتی نیازمند تحقیقات بیشتر است.
جمعبندی: از نیمی از مغز تا هوش کاملتر
در این بخش دیدیم که:
۱. سلولهای گلیا — که حدود نیمی از سلولهای مغز را تشکیل میدهند — اجزای فعال پردازش اطلاعات، پلاستیسیتی و یادگیری هستند، نه فقط بافت پشتیبان.
۲. آستروسیتها از طریق سیناپس سهجزئی، موجهای کلسیم و گلیوترانسمیترها، پلاستیسیتی سیناپسی (هم LTP و هم LTD) را تنظیم میکنند و همکاری متابولیک لازم برای تثبیت حافظه را فراهم میکنند (Escalada et al., 2024).
۳. میکروگلیا از طریق سیستم کمپلمان، سیناپسهای ضعیف را هرس میکنند و نسبت سیگنال به نویز را بهبود میدهند. این فرآیند در بزرگسالان نیز فعال است و فراموشی را تنظیم میکند (Stephan et al., 2012; Miyanishi et al., 2021).
۴. مدلهای مصنوعی الهامگرفته — مانند SNN + Astrocyte، ANN + Microglia و Neuron-Astrocyte Networks — نشان میدهند که افزودن سلولهای گلیا به شبکههای مصنوعی میتواند یادگیری سریعتر، مقاومت بیشتر در برابر بیشبرازش و حافظه انجمنی قویتر ایجاد کند.
۵. چالشها شامل پیچیدگی محاسباتی، عدم تطابق کامل با زیستشناسی، دشواری آموزش و فقدان بنچمارک است.
پیام مدیریتی کلیدی: در مسائلی که نیازمند تنظیم پویا و هرس اطلاعات هستند — مانند مدیریت دانش سازمانی، بهروزرسانی مداوم مدلهای ریسک، یا سیستمهای توصیهگر که باید اطلاعات قدیمی را کنار بگذارند — مدلهای الهامگرفته از گلیا میتوانند عملکرد بهتری ارائه دهند. در این مدلها، آستروسیتها نقش «تنظیمکننده نرخ یادگیری» و میکروگلیا نقش «هرسکننده اطلاعات غیرضروری» را ایفا میکنند. نادیده گرفتن نیمی از مغز — یعنی سلولهای گلیا — به معنای نادیده گرفتن نیمی از مکانیزمهای یادگیری است. شبکههای مصنوعی نسل بعدی باید این نیمه را نیز در نظر بگیرند.
در بخش بعدی، به درس هشتم میپردازیم: یادگیری مستمر و مقابله با فراموشی فاجعهبار — یعنی چگونه مغز بدون فراموش کردن اطلاعات قدیمی، اطلاعات جدید را یاد میگیرد، و چگونه این اصول در یادگیری ماشین — بهویژه Elastic Weight Consolidation (EWC) و یادگیری پیوسته — پیادهسازی میشوند.
منابع این بخش
Escalada, P., Delgado, L., & Perea, G. (2024). Essential role of astrocytes in learning and memory. International Journal of Molecular Sciences, 25(3), 1899. https: //doi.org/10.3390/ijms25031899
Gordleeva, S. Y., Tsybina, Y. A., Krivonosov, M. I., Ivanchenko, M. V., Zaikin, A. A., & Kazantsev, V. B. (2021). Modeling working memory in a spiking neuron network accompanied by astrocytes. Frontiers in Cellular Neuroscience, 15, 631485. https: //doi.org/10.3389/fncel.2021.631485
Ikuta, T., et al. (2026). Characterizing learning in spiking neural networks with artificial astrocytes. Neurocomputing, 132805. https: //doi.org/10.1016/j.neucom.2026.132805
Kruyer, A., Kalivas, P. W., & Scofield, M. D. (2023). Astrocyte regulation of synaptic signaling in psychiatric disorders. Neuropsychopharmacology, 48(1), 21–36. https: //doi.org/10.1038/s41386-022-01338-w
Miyanishi, K., Sato, M., & Hashimoto, Y. (2021). Microglial phagocytosis of synapses is involved in learning and memory in adults. Journal of Neuroscience, 41(48), 9920–9932. https: //doi.org/10.1523/JNEUROSCI.0987-21.2021
Stephan, A. H., Barres, B. A., & Stevens, B. (2012). The complement system: An unexpected role in synaptic pruning during development and disease. Annual Review of Neuroscience, 35, 369–389. https: //doi.org/10.1146/annurev-neuro-061010-113810
۴.۹ درس ۸ — یادگیری مستمر و مقابله با فراموشی فاجعهبار
۴.۹.۰ چرا شبکههای مصنوعی دانش قبلی خود را از دست میدهند؟
در بخشهای پیشین این فصل، درسهای متعددی از نورون زیستی گرفتیم: از قدرت محاسباتی دندریتها تا پلاستیسیتی چندمکانیزمی، از کدگذاری زمانی تا بهرهوری انرژی، از یادگیری خودنظارتی تا همگامسازی، و از سلولهای گلیا تا تنظیم پلاستیسیتی. اما یک پرسش بنیادین باقی مانده است که شاید مهمترین چالش عملی در بهکارگیری شبکههای عصبی در مسائل واقعی مدیریتی باشد: چگونه میتوان بهطور مستمر یاد گرفت بدون اینکه دانش قبلی از دست برود؟
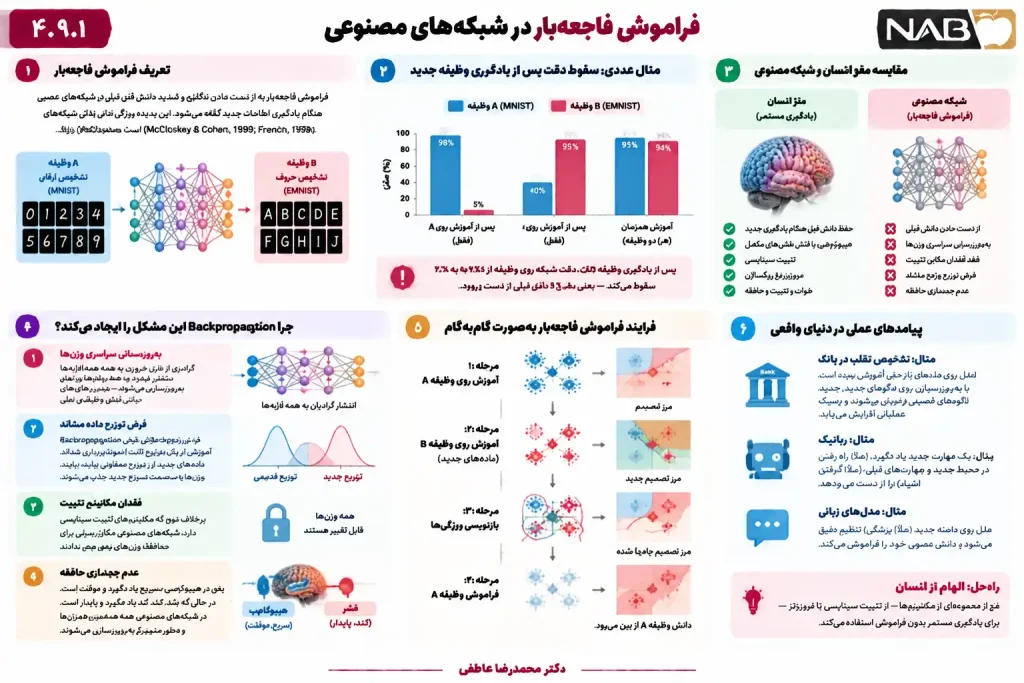
بیایید با یک مثال مدیریتی ملموس شروع کنیم. تصور کنید یک بانک یک مدل یادگیری ماشین برای تشخیص تقلب در تراکنشهای بانکی توسعه داده است. این مدل روی دادههای دو سال گذشته آموزش دیده و به دقت بالایی رسیده است. حالا بانک میخواهد مدل را با الگوهای تقلب جدید که در شش ماه اخیر ظهور کردهاند بهروزرسانی کند. اگر مدل را فقط روی دادههای جدید آموزش دهد، چه اتفاقی میافتد؟ مدل الگوهای تقلب قدیمی را فراموش میکند — پدیدهای که به «فراموشی فاجعهبار» (Catastrophic Forgetting) معروف است .(McCloskey & Cohen, 1989; French, 1999)
این پدیده فقط یک مشکل فنی نیست؛ یک ریسک عملیاتی جدی است. اگر مدل تشخیص تقلب بانک، الگوهای قدیمی را فراموش کند، مجرمان میتوانند با استفاده از روشهای قدیمی که دیگر توسط مدل شناسایی نمیشوند، به فعالیت خود ادامه دهند. به همین دلیل، بانک مجبور میشود هر بار مدل را از صفر روی تمام دادههای تاریخی دوباره آموزش دهد — فرآیندی بسیار پرهزینه و زمانبر.
مغز انسان این مشکل را ندارد. ما میتوانیم زبان جدیدی یاد بگیریم بدون اینکه زبان مادری خود را فراموش کنیم. میتوانیم یک مهارت جدید را در محیط کار بیاموزیم بدون اینکه مهارتهای قبلی را از دست بدهیم. این توانایی که به «یادگیری مستمر» (Continual Learning) یا «یادگیری مادامالعمر» (Lifelong Learning) معروف است، یکی از شگفتانگیزترین ویژگیهای مغز است (Parisi et al., 2019).
چرا شبکههای مصنوعی این مشکل را دارند؟
ریشه این مشکل در الگوریتم Backpropagation نهفته است. وقتی شبکه روی دادههای جدید آموزش میبیند، همه وزنها بهروزرسانی میشوند — از جمله وزنهایی که برای دانش قبلی حیاتی هستند. نتیجه این است که دانش جدید، دانش قدیمی را «بازنویسی» میکند .(Kirkpatrick et al., 2017, p. 1) به بیان دیگر، شبکه مصنوعی حافظه بلندمدت ندارد؛ هر آموزش جدید، کل شبکه را تحت تأثیر قرار میدهد.
مغز، اما، از مجموعهای از مکانیزمها برای حل این مشکل استفاده میکند که هر یک بهطور مستقل قابل الهامگیری هستند. در این بخش، به بررسی عمیق این مکانیزمها میپردازیم: نظریه سیستمهای یادگیری مکمل (Complementary Learning Systems)، تثبیت سیناپسی (Synaptic Consolidation)، نوروژنز بزرگسالان (Adult Neurogenesis)، و خواب و تثبیت حافظه. سپس نشان میدهیم که چگونه این اصول در یادگیری ماشین — بهویژه Elastic Weight Consolidation (EWC) و یادگیری پیوسته — پیادهسازی شدهاند.
۴.۹.۱ چالش فراموشی فاجعهبار در شبکههای مصنوعی
تعریف و تاریخچه
فراموشی فاجعهبار اصطلاحی است که نخستین بار توسط McCloskey و Cohen در سال ۱۹۸۹ برای توصیف از دست دادن ناگهانی و شدید دانش قبلی در شبکههای عصبی مصنوعی هنگام یادگیری اطلاعات جدید معرفی شد (McCloskey & Cohen, 1989). French (۱۹۹۹) در مروری جامع نشان داد که این پدیده نه یک نقص جانبی، بلکه ویژگی ذاتی شبکههای عصبی مصنوعی است (French, 1999).
مثال عددی: فرض کنید یک شبکه عصبی ساده با دو وظیفه مواجه است: وظیفه A (تشخیص ارقام MNIST) و وظیفه B (تشخیص حروف EMNIST). اگر شبکه ابتدا روی وظیفه A آموزش ببیند و به دقت ۹۸٪ برسد، و سپس فقط روی وظیفه B آموزش ببیند، دقت آن روی وظیفه A ممکن است به ۴۰٪ یا حتی کمتر سقوط کند (Parisi et al., 2019). این یعنی شبکه ۵۸٪ از دانش خود را از دست داده است — فراموشیای فاجعهبار به معنای واقعی کلمه.
چرا Backpropagation این مشکل را ایجاد میکند؟
ریشه این مشکل در ویژگیهای ذاتی Backpropagation نهفته است:
۱. بهروزرسانی سراسری وزنها: در Backpropagation، گرادیان خطا از لایه خروجی به همه لایهها منتشر میشود و همه وزنها بهروزرسانی میشوند. این بدان معناست که حتی وزنهایی که برای وظایف قبلی حیاتی هستند، ممکن است تغییر کنند (Kirkpatrick et al., 2017, p. 1).
۲. فرض توزیع داده مشابه: Backpropagation فرض میکند که دادههای آموزش از یک توزیع ثابت نمونهبرداری شدهاند. وقتی دادههای جدید از توزیع متفاوتی بیایند، وزنها به سمت توزیع جدید جذب میشوند و دانش توزیع قدیمی از دست میرود (Parisi et al., 2019).
۳. فقدان مکانیزم تثبیت: برخلاف مغز که مکانیزمهای تثبیت سیناپسی دارد، شبکههای مصنوعی مکانیزمی برای محافظت از وزنهای مهم ندارند. هر وزن، قابل تغییر است، صرفنظر از اهمیت آن برای دانش قبلی.
۴. عدم جداسازی حافظه: در مغز، هیپوکامپ و قشر نقشهای مکمل دارند: هیپوکامپ سریع یاد میگیرد و موقت است، در حالی که قشر کند یاد میگیرد و پایدار است (McClelland et al., 1995). در شبکههای مصنوعی، همه وزنها همزمان و بهطور متمرکز بهروزرسانی میشوند.
جدول مقایسه: مغز در برابر شبکه مصنوعی
| ویژگی | مغز | شبکه مصنوعی استاندارد |
| یادگیری مستمر | بله | خیر |
| حافظه بلندمدت | پایدار | ناپایدار |
| محافظت از دانش قبلی | تثبیت سیناپسی | ندارد |
| سیستمهای یادگیری | هیپوکامپ + قشر (مکمل) | تکسیستم متمرکز |
| نوروژنز | فعال در هیپوکامپ بزرگسال | ندارد |
| تثبیت در خواب | بله | ندارد |
۴.۹.۲راهحلهای مغز
مغز برای حل معضل (پایداری-انعطافپذیری )Stability-Plasticity Dilemma — یعنی نیاز به یادگیری اطلاعات جدید بدون از دست دادن اطلاعات قدیمی — از مجموعهای از مکانیزمهای مکمل استفاده میکند. در این بخش، چهار مکانیزم اصلی را بررسی میکنیم.
الف) نظریه سیستمهای یادگیری مکمل
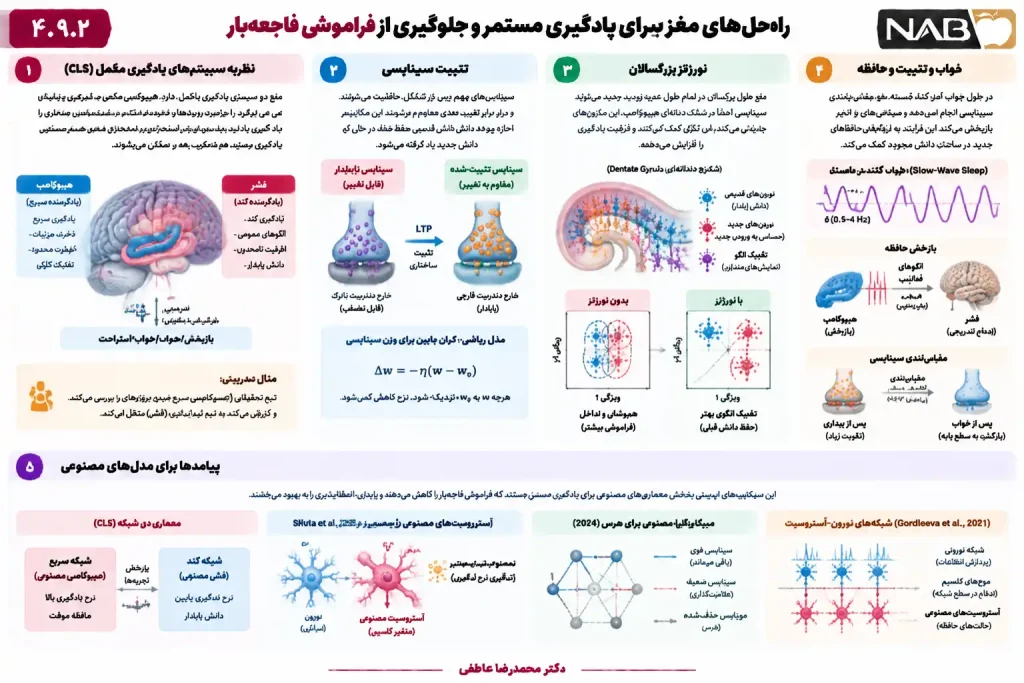
- نظریه سیستمهای یادگیری مکمل (Complementary Learning Systems — CLS) که نخستین بار توسط McClelland، McNaughton و O’Reilly در سال ۱۹۹۵ ارائه شد، یکی از تأثیرگذارترین چارچوبها در علوم اعصاب محاسباتی است (McClelland et al., 1995). ایده اصلی این نظریه ساده اما عمیق است: مغز دو سیستم یادگیری با ویژگیهای متضاد دارد که مکمل یکدیگرند.
- سیستم اول — هیپوکامپ (یادگیرنده سریع): هیپوکامپ سریع یاد میگیرد، جزئیات خاص رویدادها را ذخیره میکند، و ظرفیت محدود دارد. این سیستم الگوهای خاص را از هم تفکیک میکند (Pattern Separation) و اجازه میدهد تجربههای منحصربهفرد بدون تداخل با یکدیگر ذخیره شوند (McClelland et al., 1995; Atallah et al., 2004, p. 1).
- سیستم دوم — قشر (یادگیرنده کند): قشر کند یاد میگیرد، الگوهای عمومی را استخراج میکند، و ظرفیت نامحدود دارد. این سیستم ساختار آماری محیط را یاد میگیرد و دانش پایدار را ذخیره میکند (McClelland et al., 1995).
- نحوه همکاری: هیپوکامپ سریع رویدادهای جدید را ذخیره میکند. سپس در خواب یا استراحت، هیپوکامپ این رویدادها را بازپخش (Replay) میکند و بهتدریج آنها را به قشر منتقل میکند. قشر این اطلاعات را بهآرامی در ساختار دانش موجود ادغام میکند — بدون اینکه دانش قبلی را مختل کند (McClelland et al., 1995, p. 419; Atallah et al., 2004).
- مثال مدیریتی: تصور کنید یک شرکت مشاورهای یک تیم تحقیقاتی (هیپوکامپ) دارد که سریع پروژههای جدید را بررسی میکند و گزارشهای موقت تهیه میکند. سپس این گزارشها به تیم استراتژی (قشر) منتقل میشود که بهآرامی آنها را در دانش سازمانی ادغام میکند. اگر همه اطلاعات مستقیماً به تیم استراتژی میرفت، این تیم اشباع میشد و دانش قبلی خود را از دست میداد. تفکیک سیستم سریع و سیستم کند، یادگیری مستمر را ممکن میسازد.
- پیامد برای یادگیری ماشین: این نظریه الهامبخش معماریهایی است که دو شبکه مجزا دارند: یک شبکه سریع (مانند یک شبکه کوچک با نرخ یادگیری بالا) و یک شبکه کند (مانند یک شبکه بزرگ با نرخ یادگیری پایین). شبکه سریع تجربههای جدید را ذخیره میکند و شبکه کند دانش پایدار را. بازپخش (Replay) تجربهها از شبکه سریع به شبکه کند، فراموشی فاجعهبار را کاهش میدهد (Parisi et al., 2019).
ب) تثبیت سیناپسی
- تثبیت سیناپسی (Synaptic Consolidation) مکانیزمی است که در آن سیناپسهای مهم پس از تشکیل حافظه، تثبیت میشوند و در برابر تغییرات بعدی مقاوم میشوند (Zenke & Laborieux, 2024; Shaham et al., 2022, p. 1). این مکانیزم به مغز امکان میدهد دانش قدیمی را حفظ کند در حالی که دانش جدید را یاد میگیرد.
- مکانیزم تثبیت: تثبیت سیناپسی از طریق تغییرات ساختاری در سیناپس رخ میدهد. سیناپسهایی که مکرراً فعال میشوند، گیرندههای AMPA بیشتری در غشا جایگذاری میکنند و خارهای دندریتی پایدارتر (مانند خارهای قارچی) ایجاد میکنند. این تغییرات ساختاری، سیناپس را در برابر تضعیف (LTD) مقاوم میکنند .(Zenke & Laborieux, 2024)
- مدل ریاضی: در مدلهای محاسباتی، تثبیت سیناپسی معمولاً بهصورت کران پایین (Lower Soft-Bound) برای وزن سیناپسی مدل میشود. فرض کنید وزن سیناپسی w داریم که به سمت کران پایین w0 میل میکند. هرچه w به w0 نزدیکتر شود، نرخ کاهش (Depression) آن کمتر میشود:
این یعنی سیناپسهای تثبیتشده (با w نزدیک به w0) بهسختی تضعیف میشوند — دقیقاً همان چیزی که برای حفظ حافظه لازم است .(Shaham et al., 2022, p. 1; PLoS Computational Biology, 2024, p. 1).
- مطالعه کلیدی: Shaham و همکاران (۲۰۲۲) یک مدل یادگیری مستمر در یک شبکه عصبی بازگشتی ارائه کردند که یادگیری هبی، زوال سیناپسی و تثبیت سیناپسی را ترکیب میکند. در این مدل، حافظهها بازپخش تصادفی (Stochastic Rehearsal) میشوند و عمر حافظه بسیار بیشتر از زمان زوال سیناپسی است .(Shaham et al., 2022, p. 1) این یعنی تثبیت سیناپسی به حافظهها عمر طولانی میدهد.
ج) نوروژنز بزرگسالان
- نوروژنز بزرگسالان (Adult Neurogenesis) فرآیند تولید نورونهای جدید در مغز بزرگسال است. برخلاف تصور قدیمی که مغز بزرگسال نمیتواند نورون جدید تولید کند، تحقیقات دو دهه اخیر نشان دادهاند که مغز پستانداران — از جمله انسان — در تمام طول عمر نورونهای جدید تولید میکند. این فرآیند عمدتاً در شکنج دندانهای (Dentate Gyrus) هیپوکامپ رخ میدهد (Gu et al., 2013, p. 1; Aimone et al., 2009, p. 187).
- نقش نوروژنز در یادگیری مستمر: نورونهای جدید هیپوکامپ نقش کلیدی در تفکیک الگو (Pattern Separation) دارند — یعنی توانایی تفکیک تجربههای مشابه از یکدیگر (Aimone et al., 2009, p. 187; Oomen et al., 2014). این قابلیت برای یادگیری مستمر حیاتی است: اگر تجربههای جدید مشابه تجربههای قدیمی باشند، مغز باید بتواند آنها را از هم تفکیک کند تا تداخل ایجاد نشود.
- مطالعه کلیدی: Aimone و همکاران (۲۰۰۹) با مدلسازی محاسباتی نشان دادند که نوروژنز بزرگسالان به تفکیک الگو در شکنج دندانهای کمک میکند. نورونهای جدید حساسیت به ورودیهای جدید دارند و نمایشهای متمایز برای تجربههای مشابه ایجاد میکنند .(Aimone et al., 2009, p. 187) این یعنی نوروژنز ظرفیت یادگیری را افزایش میدهد بدون اینکه حافظههای قدیمی را مختل کند.
- پیامد مدیریتی: نوروژنز مانند «استخدام نیروهای جدید» در یک سازمان است. نیروهای جدید ایدههای تازه و حساسیت به روندهای جدید دارند، در حالی که کارکنان باتجربه دانش سازمانی را حفظ میکنند. ترکیب نیروهای جدید و باتجربه، سازمان را نوآور و پایدار نگه میدارد.
- معماریهای مصنوعی الهامگرفته: در شبکههای عصبی مصنوعی، نوروژنز بهصورت افزودن نورونهای جدید به شبکه در طول آموزش مدل میشود. معماریهای رشدکننده (Growing Neural Networks) از این ایده استفاده میکنند. مطالعهای در سال ۲۰۲۶ یک استراتژی تفکیک الگو برای شبکههای اسپایکی قابلتوسعه (PS-SNN) ارائه کرد که در آن مراکز کلاس متعامد از پیش تعریف میشوند و ساختار شبکه بهطور پویا گسترش مییابد تا نوروژنز را شبیهسازی کند. این رویکرد به کاهش فراموشی فاجعهبار و حفظ سازگاری با وظایف جدید منجر شد (Hu et al., 2026, p. 2).
د) خواب و تثبیت حافظه
- خواب یکی از مهمترین مکانیزمهای مغز برای تثبیت حافظه و جلوگیری از فراموشی فاجعهبار است. بر اساس فرضیه هومئوستاز سیناپسی (Synaptic Homeostasis Hypothesis — SHY) که توسط Tononi و Cirelli ارائه شد، در طول بیداری، سیناپسها از طریق LTP تقویت میشوند و اطلاعات را رمزگذاری میکنند. اما این تقویت پایدار نیست: اگر سیناپسها بیوقفه تقویت شوند، اشباع میشوند و ظرفیت یادگیری از بین میرود (Tononi & Cirelli, 2014, p. 12).
- نقش خواب: در طول خواب موجکند آهسته (Slow-Wave Sleep)، مغز مقیاسبندی سیناپسی (Synaptic Scaling) انجام میدهد: همه سیناپسها بهطور ضربی تضعیف میشوند — اما نسبت بین آنها حفظ میشود. این یعنی اطلاعات (نسبت وزنها) حفظ میشود در حالی که فعالیت کلی به سطح پایه بازمیگردد (Tononi & Cirelli, 2014, p. 12; European Journal of Neuroscience, 2024).
- بازپخش و ادغام: علاوه بر مقیاسبندی، خواب بازپخش (Replay) تجربههای اخیر را تسهیل میکند. در طول خواب، هیپوکامپ الگوهای فعالیت بیداری را بازپخش میکند و این الگوها به قشر منتقل میشوند. این فرآیند به ادغام حافظههای جدید در ساختار دانش موجود کمک میکند — بدون مختل کردن دانش قبلی (González et al., 2020, p. 1; Tadros et al., 2022).
- مطالعه کلیدی: González و همکاران (۲۰۲۰) با یک مدل تالامو-قشری نشان دادند که خواب میتواند آسیب ناشی از تداخل حافظه جدید با حافظه قدیمی را معکوس کند. در این مدل، بازپخش خواب ردپای سیناپسی حافظه قدیمی را تغییر داد تا جمعیتهای نورونی همپوشان بتوانند چندین حافظه متداخل را ذخیره کنند (González et al., 2020, p. 1).
- مطالعه کلیدی دوم: Tadros و همکاران (۲۰۲۲) نشان دادند که بازپخش شبیهسازیشده خواب در شبکههای عصبی مصنوعی میتواند فراموشی فاجعهبار را کاهش دهد. در این مطالعه، بازپخش خودنظارتی (Unsupervised Replay) — که در آن شبکه الگوهای فعالیت را بدون برچسب بازپخش میکند — به حفظ حافظههای قدیمی کمک کرد (Tadros et al., 2022, p. 1).
جدول جمعبندی مکانیزمهای مغزی:
| مکانیزم | نقش در یادگیری مستمر | معادل مصنوعی |
| سیستمهای مکمل | تفکیک یادگیری سریع و کند | دو شبکه مجزا + بازپخش |
| تثبیت سیناپسی | محافظت از وزنهای مهم | تنظیمسازی وزنها |
| نوروژنز | تفکیک الگوهای مشابه | گسترش پویا شبکه |
| خواب و بازپخش | ادغام و تثبیت حافظه | بازپخش تجربهها |
4.9.3.پیامدها برای یادگیری ماشین
حالا که مکانیزمهای مغزی برای مقابله با فراموشی فاجعهبار را بررسی کردیم، بیایید به پیامدهای عملی آنها برای یادگیری ماشین بپردازیم. سه رویکرد اصلی وجود دارد که هر یک از یک مکانیزم مغزی الهام گرفته است.
الف) Elastic Weight Consolidation (EWC)
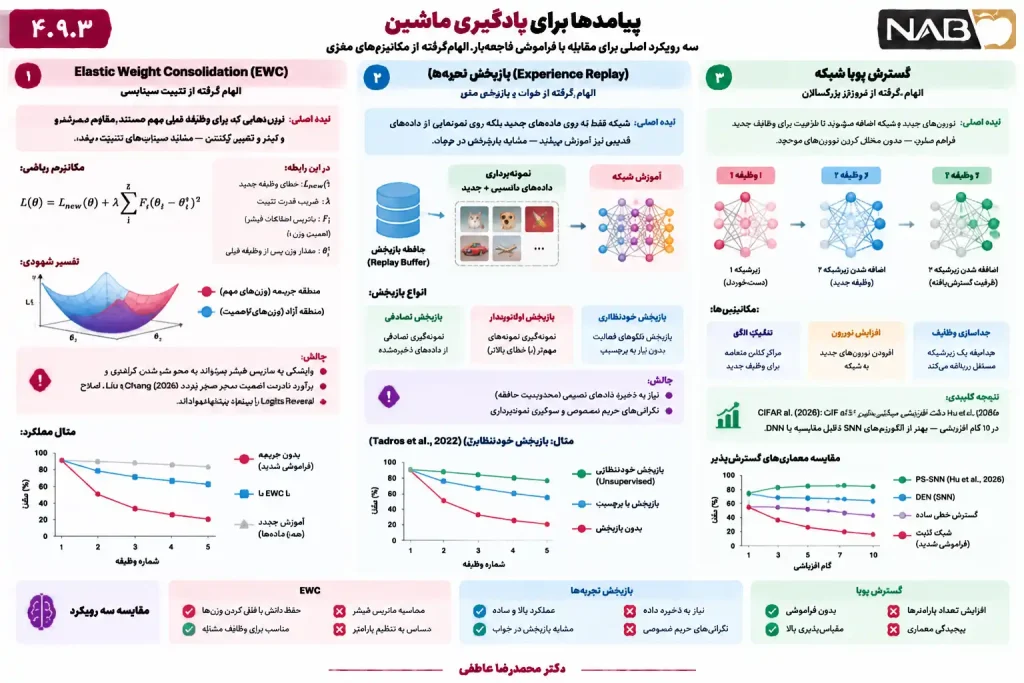
Elastic Weight Consolidation (EWC) که در سال ۲۰۱۷ توسط Kirkpatrick و همکارانش در DeepMind معرفی شد، یکی از تأثیرگذارترین روشهای یادگیری پیوسته است .(Kirkpatrick et al., 2017) این روش از تثبیت سیناپسی مغز الهام گرفته و بر تنظیمسازی وزنها (Weight Regularization) تمرکز دارد.
ایده اصلی: در مغز، سیناپسهایی که برای دانش قبلی مهم هستند، تثبیت میشوند و در برابر تغییر مقاوم میمانند. EWC همین ایده را به شبکههای مصنوعی منتقل میکند: وزنهایی که برای وظایف قبلی مهم هستند، مقاوم میشوند و کمتر تغییر میکنند.
مکانیزم ریاضی: EWC یک جریمه (Penalty) به تابع خطا اضافه میکند که تغییر وزنهای مهم را جریمه میکند:
که در آن:
- Lnew(θ)— خطای وظیفه جدید
- λ— ضریب قدرت تثبیت
- Fi— ماتریس اطلاعات فیشر (Fisher Information Matrix) برای وزن i — که اهمیت آن وزن را اندازهگیری میکند
- θi∗— مقدار وزن i پس از آموزش وظیفه قبلی
- تفسیر شهودی: ماتریس Fi اهمیت هر وزن را تعیین میکند. اگر Fi بزرگ باشد، یعنی وزن i برای وظیفه قبلی حیاتی است. در این حالت، جریمه 2λFi(θi−θi∗)2 بزرگ میشود و شبکه مجبور میشود وزن i را نزدیک به مقدار قبلی نگه دارد. اگر Fi کوچک باشد، وزن i آزاد است که تغییر کند.
- چالش EWC: با وجود محبوبیت، EWC با مشکلاتی مواجه است. Liu و Chang (۲۰۲۶) نشان دادند که وابستگی EWC به ماتریس فیشر میتواند به محو شدن گرادیان (Gradient Vanishing) و برآورد نادرست اهمیت منجر شود. آنها یک اصلاح پیشنهاد کردند: معکوسسازی لوجیتها (Logits Reversal) در محاسبه ماتریس فیشر، که این مشکلات را برطرف میکند .(Liu & Chang, 2026, p. 1).
- مثال مدیریتی: EWC مانند «قفل کردن» برخی از فرآیندهای حیاتی یک سازمان است. وقتی سازمان میخواهد روشهای جدید را بپذیرد، فرآیندهای حیاتی (مانند کنترل کیفیت یا ایمنی) قفل میشوند و تغییر نمیکنند. این قفل، دانش حیاتی را حفظ میکند در حالی که سازمان یاد میگیرد.
ب) بازپخش تجربهها (Experience Replay)
- بازپخش تجربهها (Experience Replay) روشی است که مستقیماً از خواب و بازپخش مغز الهام گرفته است. در این روش، شبکه نه فقط روی دادههای جدید، بلکه روی نمونههایی از دادههای قدیمی نیز آموزش میبیند. این نمونهها در یک حافظه بازپخش (Replay Buffer) ذخیره میشوند و بهطور دورهای در آموزش استفاده میشوند (Parisi et al., 2019; Tadros et al., 2022).
- مزیت اصلی: بازپخش تجربهها فراموشی فاجعهبار را بهطور مؤثر کاهش میدهد، زیرا شبکه مداوم با دادههای قدیمی مواجه میشود و وزنهای مهم فرصت تثبیت پیدا میکنند.
- چالش اصلی: بازپخش نیازمند ذخیره دادههای قدیمی است، که محدودیت حافظه، نگرانیهای حریم خصوصی و سوگیری نمونهبرداری ایجاد میکند (Liu & Chang, 2026, p. 1).
- مطالعه کلیدی: Tadros و همکاران (۲۰۲۲) نشان دادند که بازپخش خودنظارتی (Unsupervised Replay) — که در آن شبکه الگوهای فعالیت را بدون نیاز به برچسب بازپخش میکند — میتواند فراموشی فاجعهبار را کاهش دهد. این رویکرد دقیقاً مشابه بازپخش خواب در مغز است: در خواب، مغز الگوهای فعالیت را بدون برچسب بازپخش میکند و آنها را در حافظه بلندمدت ادغام میکند .(Tadros et al., 2022, p. 1).
- مثال مدیریتی: بازپخش تجربهها مانند «جلسات مرور دورهای» در یک سازمان است. یک شرکت مشاورهای که پروژههای جدید را مداوم میپذیرد، جلسات مرور برگزار میکند که در آن درسهای آموختهشده از پروژههای قدیمی مرور میشوند. این مرور دورهای، دانش سازمانی را حفظ میکند در حالی که پروژههای جدید یاد گرفته میشوند.
ج) گسترش پویا شبکه
گسترش پویا (Dynamic Expansion) روشی است که از نوروژنز بزرگسالان الهام گرفته است. در این روش، نورونهای جدید به شبکه اضافه میشوند تا ظرفیت برای وظایف جدید فراهم شود — بدون مختل کردن نورونهای موجود که دانش قبلی را ذخیره کردهاند (Hu et al., 2026, p. 2; Parisi et al., 2019).
مکانیزم: در معماریهای گسترشپذیر، هر وظیفه جدید یک زیرشبکه جدید دریافت میکند، در حالی که زیرشبکههای قدیمی دستنخورده باقی میمانند. این جداسازی، تداخل بین وظایف را حذف میکند.
مطالعه کلیدی: Hu و همکاران (۲۰۲۶) معماری PS-SNN را معرفی کردند که از تفکیک الگو و گسترش پویا برای یادگیری افزایشی کلاس (Class-Incremental Learning) استفاده میکند. در این معماری، مراکز کلاس متعامد از پیش تعریف میشوند و ساختار شبکه بهطور پویا گسترش مییابد تا نوروژنز را شبیهسازی کند. نتایج نشان داد که PS-SNN به دقت افزایشی میانگین ۷۶.۴۲٪ روی CIFAR100-B0 در ۱۰ گام افزایشی دست یافت — بهتر از الگوریتمهای یادگیری پیوسته SNN و قابل مقایسه با روشهای مبتنی بر DNN (Hu et al., 2026, p. 1).
مثال مدیریتی: گسترش پویا مانند «ایجاد واحدهای جدید» در یک سازمان است. وقتی یک شرکت خط تولید جدید راهاندازی میکند، واحد جدیدی ایجاد میشود که متخصص آن خط تولید است. واحدهای موجود دستنخورده باقی میمانند و دانش قبلی خود را حفظ میکنند. این جداسازی، تداخل بین خطوط تولید را حذف میکند.
جدول مقایسه روشهای یادگیری پیوسته
| روش | مبانی زیستی | مزیت | محدودیت |
| EWC | تثبیت سیناپسی | بدون نیاز به داده قدیمی | برآورد نادرست اهمیت |
| بازپخش تجربه | خواب و بازپخش | اثربخشی بالا | نیاز به ذخیره داده |
| گسترش پویا | نوروژنز | بدون تداخل | رشد نامحدود شبکه |
| سیستمهای مکمل | هیپوکامپ + قشر | یادگیری سریع و پایدار | پیچیدگی معماری |
۴.۹.۴ چالشها و محدودیتها
با وجود پیشرفتهای چشمگیر، یادگیری پیوسته و مقابله با فراموشی فاجعهبار با چالشهایی مواجه است:
- چالش اول — معضل پایداری-انعطافپذیری: هر روشی که پایداری را افزایش دهد، انعطافپذیری را کاهش میدهد و برعکس. EWC با جریمه کردن تغییر وزنهای مهم، انعطافپذیری شبکه را برای یادگیری وظایف جدید محدود میکند. گسترش پویا با افزودن نورونهای جدید، پارامترهای شبکه را افزایش میدهد. هیچ روشی نمیتواند همزمان پایداری کامل و انعطافپذیری کامل را فراهم کند.
- چالش دوم — مقیاسپذیری: EWC با ماتریس فیشر برای هر وزن، حافظه و محاسبات را افزایش میدهد. برای مدلهای بزرگ (مانند مدلهای زبانی با میلیاردها پارامتر)، ذخیره ماتریس فیشر غیرعملی است.
- چالش سوم — عدم تطابق کامل با زیستشناسی: روشهای موجود سادهسازیهایی انجام میدهند. برای مثال، EWC فرض میکند که اهمیت وزنها ثابت است، در حالی که در مغز، اهمیت سیناپسها پویا و وابسته به زمینه است.
- چالش چهارم — ارزیابی: مجموعههای داده استاندارد برای یادگیری پیوسته محدود هستند. اکثر مطالعات از وظایف ساده (مانند توالی MNIST) استفاده میکنند و تعمیم به مسائل پیچیده مدیریتی نیازمند تحقیقات بیشتر است.
جمعبندی: از فراموشی فاجعهبار تا یادگیری مادامالعمر
در این بخش دیدیم که:
۱. فراموشی فاجعهبار یکی از چالشهای بنیادین شبکههای عصبی مصنوعی است: وقتی شبکه روی دادههای جدید آموزش میبیند، دانش قبلی خود را از دست میدهد. این پدیده ناشی از بهروزرسانی سراسری وزنها در Backpropagation است (McCloskey & Cohen, 1989; Kirkpatrick et al., 2017).
۲. نظریه سیستمهای یادگیری مکمل توضیح میدهد که مغز از دو سیستم استفاده میکند: هیپوکامپ (یادگیرنده سریع، ذخیرهکننده جزئیات) و قشر (یادگیرنده کند، استخراجکننده الگوهای عمومی). بازپخش از هیپوکامپ به قشر، ادغام حافظههای جدید در دانش موجود را ممکن میسازد (McClelland et al., 1995).
۳. تثبیت سیناپسی مکانیزمی است که سیناپسهای مهم را مقاوم میکند و از پاک شدن حافظههای قدیمی جلوگیری میکند (Shaham et al., 2022).
۴. نوروژنز بزرگسالان با تفکیک الگو، به تمایز تجربههای مشابه کمک میکند و ظرفیت یادگیری را افزایش میدهد بدون مختل کردن حافظههای قدیمی (Aimone et al., 2009).
۵. خواب از طریق مقیاسبندی سیناپسی و بازپخش، حافظهها را تثبیت میکند و فراموشی فاجعهبار را کاهش میدهد (Tononi & Cirelli, 2014; González et al., 2020).
۶. روشهای یادگیری پیوسته — مانند EWC، بازپخش تجربهها و گسترش پویا — هر یک از یک مکانیزم مغزی الهام گرفتهاند و فراموشی فاجعهبار را کاهش میدهند، اما هر یک محدودیتهای خاص خود را دارند.
پیام مدیریتی کلیدی: در مسائلی که نیازمند یادگیری مستمر از دادههای در حال تغییر هستند — مانند تشخیص تقلب در الگوهای در حال تکامل، پیشبینی تقاضا در بازارهای پویا، یا سیستمهای توصیهگر که باید سلیقههای جدید را یاد بگیرند — روشهای یادگیری پیوسته میتوانند عملکرد بهتری ارائه دهند. انتخاب روش مناسب بستگی به ماهیت مسئله دارد: اگر دادههای قدیمی قابل ذخیره هستند، بازپخش تجربهها ممکن است بهترین گزینه باشد. اگر حریم خصوصی مهم است، EWC مناسبتر است. اگر وظایف کاملاً متمایز هستند، گسترش پویا ممکن است بهترین انتخاب باشد. درک عمیق مکانیزمهای مغزی — از سیستمهای مکمل تا نوروژنز — میتواند الهامبخش معماریهای نسل بعدی باشد که هم یاد میگیرند و هم به یاد میآورند.
منابع این بخش
Aimone, J. B., Wiles, J., & Gage, F. H. (2009). Computational influence of adult neurogenesis on memory encoding. Neuron, 61(2), 187–202. https: //doi.org/10.1016/j.neuron.2008.11.026
Atallah, H. E., Frank, M. J., & O’Reilly, R. C. (2004). Hippocampus, cortex, and basal ganglia: Insights from computational models of complementary learning systems. Neurobiology of Learning and Memory, 82(3), 253–267. https: //doi.org/10.1016/j.nlm.2004.06.004
French, R. M. (1999). Catastrophic forgetting in connectionist networks. Trends in Cognitive Sciences, 3(4), 128–135. https: //doi.org/10.1016/S1364-6613(99)01294-2
González, O. C., Sokolov, Y., Krishnan, G. P., Delanois, J. E., & Bazhenov, M. (2020). Can sleep protect memories from catastrophic forgetting? eLife, 9, e51005. https: //doi.org/10.7554/eLife.51005
Gu, Y., Janoschka, S., & Ge, S. (2013). Neurogenesis and hippocampal plasticity in adult brain. Current Topics in Behavioral Neurosciences, 15, 31–48. https: //doi.org/10.1007/7854_2012_217
Hu, K., Wen, L., Zhang, T., & Zhang, H. (2026). PS-SNN: Pattern separation learning for expandable spiking neural networks in class-incremental learning. Scientific Reports, 16, Article 42970. https: //doi.org/10.1038/s41598-026-42970-6
Kirkpatrick, J., Pascanu, R., Rabinowitz, N., Veness, J., Desjardins, G., Rusu, A. A., Milan, K., Quan, J., Ramalho, T., Grabska-Barwinska, A., Hassabis, D., Clopath, C., Kumaran, D., & Hadsell, R. (2017). Overcoming catastrophic forgetting in neural networks. Proceedings of the National Academy of Sciences, 114(13), 3521–3526. https: //doi.org/10.1073/pnas.1611835114
Liu, X., & Chang, X. (2026). Elastic weight consolidation done right for continual learning. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).
McClelland, J. L., McNaughton, B. L., & O’Reilly, R. C. (1995). Why there are complementary learning systems in the hippocampus and neocortex: Insights from the successes and failures of connectionist models of learning and memory. Psychological Review, 102(3), 419–457. https: //doi.org/10.1037/0033-295X.102.3.419
McCloskey, M., & Cohen, N. J. (1989). Catastrophic interference in connectionist networks: The sequential learning problem. Psychology of Learning and Motivation, 24, 109–165. https: //doi.org/10.1016/S0079-7421(08)60536-8
Oomen, C. A., Bekinschtein, P., Kent, B. A., Saksida, L. M., & Bussey, T. J. (2014). Adult hippocampal neurogenesis and its role in cognition. Wiley Interdisciplinary Reviews: Cognitive Science, 5(5), 573–587. https: //doi.org/10.1002/wcs.1308
Parisi, G. I., Kemker, R., Part, J. L., Kanan, C., & Wermter, S. (2019). Continual lifelong learning with neural networks: A review. Neural Networks, 113, 54–71. https: //doi.org/10.1016/j.neunet.2019.01.012
Shaham, N., Chandra, J., Kreiman, G., & Sompolinsky, H. (2022). Stochastic consolidation of lifelong memory. Scientific Reports, 12, Article 16407. https: //doi.org/10.1038/s41598-022-16407-9
Tadros, T., Krishnan, G. P., Ramyaa, R., & Bazhenov, M. (2022). Sleep-like unsupervised replay reduces catastrophic forgetting in artificial neural networks. Nature Communications, 13, Article 7742. https: //doi.org/10.1038/s41467-022-34938-7
Tononi, G., & Cirelli, C. (2014). Sleep and the price of plasticity: From synaptic and cellular homeostasis to memory consolidation and integration. Neuron, 81(1), 12–34. https: //doi.org/10.1016/j.neuron.2013.12.025
Zenke, F., & Laborieux, A. (2024). Theories of synaptic memory consolidation and intelligent plasticity for continual learning. arXiv. https: //arxiv.org/abs/2405.16922
۴.۱۰ جمعبندی فصل: از زیستشناسی تا معماری
۴.۱۰.۰ مقدمه: سفری از زیستشناسی تا معماری
در این فصل، سفری طولانی را از زیستشناسی نورون تا معماری شبکههای عصبی مصنوعی آغاز کردیم. دیدیم که نورون زیستی — برخلاف مدل ساده McCulloch-Pitts — یک سیستم محاسباتی چندوجهی است که در آن دندریتها پردازش غیرخطی انجام میدهند، پلاستیسیتی چندمکانیزمی یادگیری را پایدار میسازد، زمان بهعنوان بُعد اصلی رمزگذاری اطلاعات عمل میکند، انرژی بهطرز شگفتانگیزی کارآمد مصرف میشود، یادگیری بدون نظارت خودسازماندهی را ممکن میسازد، همگامسازی اطلاعات پراکنده را ادغام میکند، سلولهای گلیا پلاستیسیتی را تنظیم میکنند، و مکانیزمهای متعدد از فراموشی فاجعهبار جلوگیری میکنند.
در این بخش پایانی، میخواهیم درسهای کلیدی این فصل را مرور کنیم، پیامدهای آنها برای طراحی شبکههای عصبی را جمعبندی کنیم، و افقهای آینده را ترسیم نماییم. سپس پرسشهای پایان فصل را ارائه میدهیم تا شما بتوانید درک خود را محک بزنید و تفکر انتقادی خود را توسعه دهید.
۴.۱۰.۱ درسهای کلیدی فصل
در این فصل، هشت درس اصلی از نورون زیستی گرفتیم که هر یک به یک شکاف بین نورون مصنوعی و زیستی پاسخ میدهد:
- درس اول — قدرت محاسباتی دندریتها (بخش ۴.۲): دندریتها فقط سیم انتقالی نیستند؛ آنها واحدهای محاسباتی غیرخطی هستند که میتوانند الگوهای خاص از ورودیها را تشخیص دهند. این قابلیت، بیانپذیری شبکه را افزایش میدهد و پارامترهای کمتری برای عملکرد مشابه نیاز دارد (Beniaguev et al., 2021; Poirazi et al., 2003).
- درس دوم — پلاستیسیتی چندمکانیزمی (بخش ۴.۳): مغز از چندین مکانیزم یادگیری همزمان استفاده میکند: LTP (تقویت)، LTD (تضعیف)، STDP (یادگیری روابط علّی)، پلاستیسیتی ساختاری (رشد و هرس خارها) و پلاستیسیتی هومئوستاتیک (حفظ تعادل). این مکانیزمها مکمل یکدیگرند و یادگیری پایدار را ممکن میسازند (Lisman, 2017; Turrigiano & Nelson, 2004).
- درس سوم — کدگذاری و دینامیک زمانی (بخش ۴.۴): اطلاعات در مغز نه فقط در نرخ شلیک، بلکه در زمان دقیق اسپایکها رمزگذاری میشود. شبکههای عصبی اسپایکی (SNN) این اصل را پیادهسازی میکنند و با محاسبات رویدادمحور، به بهرهوری انرژی قابلتوجهی دست مییابند (Maass, 1997; Gerstner et al., 2010).
- درس چهارم — بهرهوری انرژی (بخش ۴.۵): مغز با ۲۰ وات توان، کارهایی انجام میدهد که ابررایانهها با مگاوات از انجام دقیق آنها عاجزند. این کارایی ناشی از شلیک پراکنده، محاسبات رویدادمحور و استفاده مجدد از مدارها است. سختافزار نورومورفیک — مانند IBM TrueNorth — این اصول را پیادهسازی میکند (IBM Research, 2014; The Conversation, 2026).
- درس پنجم — یادگیری بدون نظارت و خودسازماندهی (بخش ۴.۶): قشر بهعنوان یک سیستم خودسازمانده عمل میکند که بدون برچسب، نقشههای توپوگرافیک را از ورودیهای خام استخراج میکند. نورومدولاتورها — مانند دوپامین و استیلکولین — نرخ یادگیری و توجه را تنظیم میکنند (Doya, 1999; Sirosh & Miikkulainen, 1994).
- درس ششم — ادغام اطلاعات در سطح کلان (بخش ۴.۷): مغز از ریتمها و همگامسازی برای ادغام اطلاعات از نواحی مختلف استفاده میکند. نظریه ارتباط از طریق همدوسی (CTC) توضیح میدهد که همگامسازی ارتباط بین گروههای نورونی را تنظیم میکند (Fries, 2015; Singer & Gray, 1995).
- درس هفتم — سلولهای گلیا (بخش ۴.۸): آستروسیتها و میکروگلیا — که نیمی از سلولهای مغز را تشکیل میدهند — اجزای فعال پردازش اطلاعات، تنظیم پلاستیسیتی و هرس سیناپسی هستند. نادیده گرفتن آنها در شبکههای مصنوعی، به معنای نادیده گرفتن نیمی از مکانیزمهای یادگیری است (Escalada et al., 2024; Stephan et al., 2012).
- درس هشتم — یادگیری مستمر و مقابله با فراموشی فاجعهبار (بخش ۴.۹): مغز از سیستمهای یادگیری مکمل (هیپوکامپ + قشر)، تثبیت سیناپسی، نوروژنز و خواب برای یادگیری مستمر بدون فراموشی فاجعهبار استفاده میکند. این اصول در Elastic Weight Consolidation (EWC)، بازپخش تجربهها و گسترش پویا پیادهسازی شدهاند (Kirkpatrick et al., 2017; McClelland et al., 1995).
۴.۱۰.۲ از زیستشناسی تا معماری: پیامدهای برای طراحی شبکههای عصبی
درسهای این فصل، جهتهای مشخصی برای معماریهای نسل بعدی ترسیم میکنند. در جدول زیر، هر درس زیستی را به یک پیامد معماری نگاشت کردهایم:
| درس زیستی | پیامد معماری | نمونه |
| دندریتهای غیرخطی | شاخههای محاسباتی در نورون | DENN، DendSN |
| پلاستیسیتی چندمکانیزمی | قواعد یادگیری محلی و ترکیبی | STDP، EWC |
| کدگذاری زمانی | شبکههای اسپایکی و رویدادمحور | SNN، Loihi |
| بهرهوری انرژی | فعالسازی پراکنده و محاسبات رویدادمحور | TrueNorth، NRA |
| خودسازماندهی | یادگیری بدون نظارت و خودنظارتی | LISSOM، SSL |
| همگامسازی | مکانیزمهای توجه مبتنی بر همگامسازی | SSA، FSN |
| سلولهای گلیا | تنظیم پویا و هرس سیناپسی | SNN + Astrocyte |
| یادگیری مستمر | بازپخش، تثبیت وزن و گسترش پویا | EWC، PS-SNN |
این نگاشت نشان میدهد که زیستشناسی فقط یک الهامبخش نیست؛ بلکه یک نقشه راه برای طراحی معماریهای آینده است. هر شکاف بین نورون مصنوعی و زیستی، یک فرصت برای نوآوری است.
۴.۱۰.۳ پیامدها برای مدیریت و تصمیمگیری
اگرچه این فصل فنی به نظر میرسد، اما پیامدهای عملی آن برای مدیریت و تصمیمگیری غیرقابل انکار است. در جدول زیر، هر درس را به یک کاربرد مدیریتی نگاشت کردهایم:
| درس زیستی | کاربرد مدیریتی | مثال |
| دندریتهای غیرخطی | تشخیص تعاملات پیچیده بین متغیرها | ریسک اعتباری، تقلب |
| پلاستیسیتی چندمکانیزمی | یادگیری تطبیقی و پایدار | پیشبینی تقاضا، قیمتگذاری پویا |
| کدگذاری زمانی | تحلیل سریهای زمانی و رویدادها | بازارهای مالی، زنجیره تأمین |
| بهرهوری انرژی | کاهش هزینههای محاسباتی | سیستمهای لبهای، IoT |
| خودسازماندهی | کشف الگوهای پنهان بدون برچسب | خوشهبندی مشتریان، تحلیل احساسات |
| همگامسازی | ادغام اطلاعات از منابع مختلف | تصمیمگیری چندمعیاره |
| سلولهای گلیا | مدیریت دانش و هرس اطلاعات قدیمی | سیستمهای توصیهگر، مدیریت دانش |
| یادگیری مستمر | بهروزرسانی مداوم بدون فراموشی | تشخیص تقلب، پایش ریسک |
نکته کلیدی: در محیطهای پویا که دادهها مداوم تغییر میکنند و تصمیمها باید سریع و دقیق باشند، معماریهای الهامگرفته از مغز میتوانند مزیت رقابتی ایجاد کنند. این معماریها نه فقط از نظر دقت، بلکه از نظر کارایی، پایداری و انعطافپذیری برتر هستند.
۴.۱۰.۴ افقهای آینده
این فصل، پایان یک سفر نیست؛ آغاز یک مسیر است. زیستشناسی هنوز درسهای زیادی برای یادگیری عمیق دارد. در زیر، چند جهت برای تحقیقات آینده پیشنهاد میشود:
۱. ادغام چند درس: تاکنون، هر معماری عمدتاً یک درس را پیادهسازی کرده است. آینده در ادغام چند درس نهفته است: دندریتهای غیرخطی + کدگذاری زمانی + همگامسازی + سلولهای گلیا. چنین معماری ترکیبی میتواند تواناییهای مغز را بهطور کاملتر شبیهسازی کند.
۲. یادگیری محلی در مقیاس بزرگ: قواعد یادگیری محلی — مانند STDP و قاعده هب — از نظر زیستی قابل قبول هستند، اما در مقیاس بزرگ ضعیف عمل میکنند. چالش آینده، توسعه قواعد محلی است که هم قابلیت زیستی و هم کارایی را داشته باشند (Illing et al., 2021).
۳. سختافزار نورومورفیک بالغ: سختافزار نورومورفیک — مانند TrueNorth و— Loihi پتانسیل عظیمی دارد، اما ابزارها، مجموعهدادهها و دسترسی به آن محدود است. آینده نیازمند استانداردسازی، توسعه ابزار و دسترسی گستردهتر است.
۴. تفسیرپذیری: معماریهای الهامگرفته از مغز — بهویژه آنهایی که همگامسازی و گلیا را مدل میکنند — قابلیت تفسیر بالاتری از شبکههای استاندارد دارند. آینده میتواند تفسیرپذیری را به یک ویژگی اصلی این معماریها تبدیل کند.
۵. کاربرد در مدیریت: اکثر مطالعات تجربی روی وظایف بینایی (MNIST، CIFAR) متمرکز بودهاند. آینده نیازمند تعمیم این معماریها به مسائل مدیریتی — مانند پیشبینی فروش، تحلیل ریسک، بهینهسازی زنجیره تأمین و تصمیمگیری چندمعیاره — است.
۴.۱۰.۵ جمعبندی نهایی
در این فصل، از مدل ساده McCulloch-Pitts شروع کردیم و به معماریهای پیچیده الهامگرفته از مغز رسیدیم. دیدیم که نورون زیستی — برخلاف تصور رایج — بسیار پیچیدهتر از نورون مصنوعی است. این پیچیدگی نه اتفاقی است و نه غیرقابلمدلسازی؛ بلکه نتیجه میلیونها سال تکامل است که راهحلهای بهینه برای یادگیری، حافظه و تصمیمگیری ایجاد کرده است.
درس نهایی این فصل: زیستشناسی و هوش مصنوعی دو روی یک سکه هستند. زیستشناسی به ما میآموزد که چگونه یاد بگیریم، و هوش مصنوعی به ما امکان میدهد که این یادگیری را در مقیاس و سرعت پیادهسازی کنیم. آینده در همگرایی این دو نهفته است: معماریهایی که هم از نظر زیستی قابل قبول و هم از نظر محاسباتی کارآمد باشند.
در فصل بعدی، به درسهای نورون زیستی در سطح شبکه — یعنی معماریهای شبکههای عصبی مصنوعی — خواهیم پرداخت و نشان خواهیم داد که چگونه این درسها در طراحی شبکههای عمیق بهکار میروند.
پرسشهای پایان فصل
پرسشهای مفهومی
۱. مدل McCulloch-Pitts چه فرضهایی درباره نورون دارد؟ چه تفاوتهای بنیادینی بین این مدل و نورون زیستی وجود دارد؟
۲. دندریتها چگونه بهعنوان واحدهای محاسباتی غیرخطی عمل میکنند؟ این قابلیت چه پیامدی برای بیانپذیری شبکههای عصبی مصنوعی دارد؟
۳. LTP، LTD و STDP را تعریف کنید و نقش هر یک را در یادگیری توضیح دهید. چرا این سه مکانیزم مکمل یکدیگرند؟
۴. کدگذاری نرخ و کدگذاری زمانی چه تفاوتی دارند؟ با یک مثال نشان دهید که چرا کدگذاری زمانی میتواند اطلاعات بیشتری را رمزگذاری کند.
۵. سه استراتژی اصلی مغز برای بهرهوری انرژی چیست؟ هر یک را توضیح دهید و نشان دهید که چگونه در سختافزار نورومورفیک پیادهسازی شدهاند.
۶. نظریه «ارتباط از طریق همدوسی» (CTC) چه چیزی را توضیح میدهد؟ نقش ریتم تتا در این نظریه چیست؟
۷. فراموشی فاجعهبار چیست و چرا در شبکههای عصبی مصنوعی رخ میدهد؟ مغز از چه مکانیزمهایی برای مقابله با آن استفاده میکند؟
پرسشهای تحلیلی
۱. فرض کنید یک شرکت بیمه میخواهد یک سیستم هوش مصنوعی برای تشخیص تقلب در خسارتها طراحی کند. با توجه به درسهای این فصل، چه معماریای پیشنهاد میدهید؟ چرا؟ چه درسهایی از زیستشناسی را در طراحی خود لحاظ میکنید؟ محدودیتهای پیشنهاد خود را نیز تحلیل کنید.
۲. مقایسهای بین Backpropagation و قواعد یادگیری محلی (مانند STDP و قاعده هب) انجام دهید. چرا Backpropagation از نظر زیستی قابل قبول نیست؟ چه راهحلهای میانی برای ترکیب قابلیت زیستی و کارایی پیشنهاد شده است؟ کدام رویکرد را برای مسائل مدیریتی مناسبتر میدانید و چرا؟
۳. در این فصل دیدیم که سلولهای گلیا — بهویژه آستروسیتها و میکروگلیا — نقش فعالی در یادگیری و حافظه دارند. اگر بخواهید یک مدل مصنوعی طراحی کنید که از این سلولها الهام بگیرد، چه اجزایی را در آن میگنجانید؟ این مدل چه مزایایی نسبت به مدلهای فعلی خواهد داشت؟ چه چالشهایی در پیادهسازی آن پیشبینی میکنید؟
منابع فصل 4
Acharya, J., Basu, A., Legenstein, R., Limbacher, T., Poirazi, P., & Wu, X. (2022). Dendritic computing: Branching deeper into machine learning. Neuroscience, 489, 262–274. https: //doi.org/10.1016/j.neuroscience.2021.10.022
Ahmad, N., van Gerven, M. A. J., & Ambrogioni, L. (2020). GAIT-prop: A biologically plausible learning rule derived from backpropagation of error. Advances in Neural Information Processing Systems, 33, 11261–11271.
Aimone, J. B., Wiles, J., & Gage, F. H. (2009). Computational influence of adult neurogenesis on memory encoding. Neuron, 61(2), 187–202. https: //doi.org/10.1016/j.neuron.2008.11.026
Atallah, H. E., Frank, M. J., & O’Reilly, R. C. (2004). Hippocampus, cortex, and basal ganglia: Insights from computational models of complementary learning systems. Neurobiology of Learning and Memory, 82(3), 253–267. https: //doi.org/10.1016/j.nlm.2004.06.004
Ayasi, B., Carmona, C. J., Saleh, M., & García-Vico, A. M. (2025). A practical tutorial on spiking neural networks: Comprehensive review, models, experiments, software tools, and implementation guidelines. Eng, 6(11), 304. https: //doi.org/10.3390/eng6110304
Bailey, C. H., & Kandel, E. R. (2000). Is heterosynaptic modulation essential for stabilizing Hebbian plasticity and memory? Nature Reviews Neuroscience, 1(1), 11–20. https: //doi.org/10.1038/35036191
Baldi, P., & Sadowski, P. (2016). A theory of local learning, the learning channel, and the optimality of backpropagation. Neural Networks, 83, 51–74. https: //doi.org/10.1016/j.neunet.2016.07.006
Bednar, J. A., Kelkar, A., & Miikkulainen, R. (2004). Scaling self-organizing maps to model large cortical networks. Neuroinformatics, 2(3), 275–302. https: //doi.org/10.1385/NI: 2: 3: 275
Beniaguev, D., Segev, I., & London, M. (2021). Single cortical neurons as deep artificial neural networks. Neuron, 109(17), 2727–2739. https: //doi.org/10.1016/j.neuron.2021.07.002
Bliss, T. V. P., & Lømo, T. (1973). Long-lasting potentiation of synaptic transmission in the dentate area of the anaesthetized rabbit following stimulation of the perforant path. The Journal of Physiology, 232(2), 331–356. https: //doi.org/10.1113/jphysiol.1973.sp010273
Canolty, R. T., Edwards, E., Dalal, S. S., Soltani, M., Nagarajan, S. S., Kirsch, H. E., Berger, M. S., Barbaro, N. M., & Knight, R. T. (2006). High gamma power is phase-locked to theta oscillations in human neocortex. Science, 313(5793), 1626–1628. https: //doi.org/10.1126/science.1128115
Chavlis, S., & Poirazi, P. (2025). Dendrites endow artificial neural networks with accurate, robust and parameter-efficient learning. Nature Communications, 16, Article 56297. https: //doi.org/10.1038/s41467-025-56297-9
Chen, L., & Li, X. (2022). Homeostatic plasticity and excitation-inhibition balance: The good, the bad, and the ugly. Current Opinion in Neurobiology, 75, 102553. https: //doi.org/10.1016/j.conb.2022.102553
Cone, I., Clopath, C., & Shouval, H. Z. (2024). Learning to express reward prediction error-like dopaminergic activity requires plastic representations of time. Nature Communications, 15, Article 5852. https: //doi.org/10.1038/s41467-024-50205-3
Doya, K. (1999). Metalearning, neuromodulation, and emotion. Abstract of the 13th Toyota Conference on Affective Minds, 1–6.
EPFL. (2023). Synaptic plasticity: Mechanisms and functions [Lecture notes]. Graph Search. https: //graphsearch.epfl.ch/en/lecture/0_koqo6p20
Escalada, P., Delgado, L., & Perea, G. (2024). Essential role of astrocytes in learning and memory. International Journal of Molecular Sciences, 25(3), 1899. https: //doi.org/10.3390/ijms25031899
Firoda, M. (2025). Neural Resonance Architecture (NRA): Toward self-regulating energy-efficient intelligence. Zenodo. https: //zenodo.org/records/17976161
French, R. M. (1999). Catastrophic forgetting in connectionist networks. Trends in Cognitive Sciences, 3(4), 128–135. https: //doi.org/10.1016/S1364-6613(99)01294-2
Fries, P. (2005). A mechanism for cognitive dynamics: Neuronal communication through neuronal coherence. Trends in Cognitive Sciences, 9(10), 474–480. https: //doi.org/10.1016/j.tics.2005.08.011
Fries, P. (2015). Rhythms for cognition: Communication through coherence. Neuron, 88(1), 220–235. https: //doi.org/10.1016/j.neuron.2015.09.034
Gerstner, W., Ritz, R., & van Hemmen, J. L. (2010). Why spikes? Hebbian learning and retrieval of time-resolved excitation patterns. Biological Cybernetics, 103(5), 379–391. https: //doi.org/10.1007/s00422-010-0401-7
Gipson, C. D., & Olive, M. F. (2017). Structural and functional plasticity of dendritic spines – root or result of behavior? Genes, Brain and Behavior, 16(1), 101–117. https: //doi.org/10.1111/gbb.12324
González, O. C., Sokolov, Y., Krishnan, G. P., Delanois, J. E., & Bazhenov, M. (2020). Can sleep protect memories from catastrophic forgetting? eLife, 9, e51005. https: //doi.org/10.7554/eLife.51005
González-Burgos, I., Velázquez-Zamora, D. A., & González-Tapia, D. C. (2020). Motor learning induces plastic changes in Purkinje cell dendritic spines in the rat cerebellum. Neurología (English Edition), 35(7), 451–459. https: //doi.org/10.1016/j.nrleng.2017.05.005
Gordleeva, S. Y., Tsybina, Y. A., Krivonosov, M. I., Ivanchenko, M. V., Zaikin, A. A., & Kazantsev, V. B. (2021). Modeling working memory in a spiking neuron network accompanied by astrocytes. Frontiers in Cellular Neuroscience, 15, 631485. https: //doi.org/10.3389/fncel.2021.631485
Gorgan, M. A., Halvagal, M. S., & Zenke, F. (2026). Understanding neural circuit principles for representation learning through joint-embedding predictive architectures. bioRxiv. https: //doi.org/10.1101/2025.11.25.690220
Gray, C. M., König, P., Engel, A. K., & Singer, W. (1989). Oscillatory responses in cat visual cortex exhibit inter-columnar synchronization which reflects global stimulus properties. Nature, 338(6213), 334–337. https: //doi.org/10.1038/338334a0
Gu, Y., Janoschka, S., & Ge, S. (2013). Neurogenesis and hippocampal plasticity in adult brain. Current Topics in Behavioral Neurosciences, 15, 31–48. https: //doi.org/10.1007/7854_2012_217
Hayadan. (2025, December 5). Narrowing the energy efficiency gap between the brain and artificial intelligence. https: //en.hayadan.org.il
Hays, H. (2026). Hebbian-Oscillatory Co-Learning. arXiv. https: //arxiv.org/pdf/2603.08731
Hebb, D. O. (1949). The organization of behavior: A neuropsychological theory. Wiley.
Hu, K., Wen, L., Zhang, T., & Zhang, H. (2026). PS-SNN: Pattern separation learning for expandable spiking neural networks in class-incremental learning. Scientific Reports, 16, Article 42970. https: //doi.org/10.1038/s41598-026-42970-6
Huang, Y., Fang, W., Ma, Z., Li, G., & Tian, Y. (2024). Scalable dendritic modeling advances expressive and robust deep spiking neural networks. arXiv. https: //arxiv.org/abs/2412.06355
Human Brain Project. (2023, September 4). Learning from the brain to make AI more energy-efficient. https: //www.humanbrainproject.eu/en/follow-hbp/news/2023/09/04/learning-brain-make-ai-more-energy-efficient/
IBM Research. (2014). TrueNorth: A million-neuron chip. IBM.
IBM Research. (2016). TrueNorth: Energy-efficient neuromorphic computing. IBM.
Ikuta, T., et al. (2026). Characterizing learning in spiking neural networks with artificial astrocytes. Neurocomputing, 132805. https: //doi.org/10.1016/j.neucom.2026.132805
Illing, B., Ventura, J., Bellec, G., & Gerstner, W. (2021). Local plasticity rules can learn deep representations using self-supervised contrastive predictions. Advances in Neural Information Processing Systems, 34, 30365–30379.
KIT. (2023). Biological neurons are estimated to spike on average with a frequency of 0.16 Hz. Karlsruhe Institute of Technology.
Kirkpatrick, J., Pascanu, R., Rabinowitz, N., Veness, J., Desjardins, G., Rusu, A. A., Milan, K., Quan, J., Ramalho, T., Grabska-Barwinska, A., Hassabis, D., Clopath, C., Kumaran, D., & Hadsell, R. (2017). Overcoming catastrophic forgetting in neural networks. Proceedings of the National Academy of Sciences, 114(13), 3521–3526. https: //doi.org/10.1073/pnas.1611835114
Kruyer, A., Kalivas, P. W., & Scofield, M. D. (2023). Astrocyte regulation of synaptic signaling in psychiatric disorders. Neuropsychopharmacology, 48(1), 21–36. https: //doi.org/10.1038/s41386-022-01338-w
Levy, W. B., & Baxter, R. A. (1996). Energy efficient neural codes. Neural Computation, 8(3), 531–543. https: //doi.org/10.1162/neco.1996.8.3.531
Lillicrap, T. P., Santoro, A., Marris, L., Akerman, C. J., & Hinton, G. (2020). Backpropagation and the brain. Nature Reviews Neuroscience, 21(6), 335–346. https: //doi.org/10.1038/s41583-020-0277-3
Lisman, J. (2017). Glutamatergic synapses are structurally and biochemically complex because of multiple plasticity processes: Long-term potentiation, long-term depression, short-term potentiation and scaling. Philosophical Transactions of the Royal Society B: Biological Sciences, 372(1715), 20160260. https: //doi.org/10.1098/rstb.2016.0260
Liu, J., Yue, Y., Welling, M., & Song, Y. (2026). Krause Synchronization Transformers. arXiv. https: //browse-export.arxiv.org/pdf/2602.11534
Liu, X., & Chang, X. (2026). Elastic weight consolidation done right for continual learning. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).
Liu, Y., Slotine, J.-J., & Barabási, A.-L. (2025). Adaptive Memory Control Mechanism. AAAI Conference on Artificial Intelligence. https: //ojs.aaai.org/index.php/AAAI/article/view/37156
London, M., & Häusser, M. (2005). Dendritic computation. Annual Review of Neuroscience, 28, 503–532. https: //doi.org/10.1146/annurev.neuro.28.061604.135703
Maass, W. (1997). Networks of spiking neurons: The third generation of neural network models. Neural Networks, 10(9), 1659–1671. https: //doi.org/10.1016/S0893-6080(97)00011-7
McClelland, J. L., McNaughton, B. L., & O’Reilly, R. C. (1995). Why there are complementary learning systems in the hippocampus and neocortex: Insights from the successes and failures of connectionist models of learning and memory. Psychological Review, 102(3), 419–457. https: //doi.org/10.1037/0033-295X.102.3.419
McCloskey, M., & Cohen, N. J. (1989). Catastrophic interference in connectionist networks: The sequential learning problem. Psychology of Learning and Motivation, 24, 109–165. https: //doi.org/10.1016/S0079-7421(08)60536-8
McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. Bulletin of Mathematical Biophysics, 5(4), 115–133. https: //doi.org/10.1007/BF02478259
Mei, J., Rodriguez-Garcia, A., Takeuchi, D., Wainstein, G., Hubig, N., Mohsenzadeh, Y., & Ramaswamy, S. (2025). Improving the adaptive and continuous learning capabilities of artificial neural networks: Lessons from multi-neuromodulatory dynamics. arXiv. https: //arxiv.org/abs/2501.06762
Miyanishi, K., Sato, M., & Hashimoto, Y. (2021). Microglial phagocytosis of synapses is involved in learning and memory in adults. Journal of Neuroscience, 41(48), 9920–9932. https: //doi.org/10.1523/JNEUROSCI.0987-21.2021
Nejad, K. K., Anastasiades, P., Hertäg, L., & Costa, R. P. (2025). Self-supervised predictive learning accounts for cortical layer-specificity. Nature Communications, 16, Article 6178. https: //doi.org/10.1038/s41467-025-61399-5
Nunley, J. (2026). Attention as Frustrated Synchronization. arXiv. https: //browse-export.arxiv.org/pdf/2606.18694
Oomen, C. A., Bekinschtein, P., Kent, B. A., Saksida, L. M., & Bussey, T. J. (2014). Adult hippocampal neurogenesis and its role in cognition. Wiley Interdisciplinary Reviews: Cognitive Science, 5(5), 573–587. https: //doi.org/10.1002/wcs.1308
Pagkalos, M., Makarov, R., & Poirazi, P. (2023). Introducing the Dendrify framework for incorporating dendrites to spiking neural networks. Nature Communications, 14, Article 131. https: //doi.org/10.1038/s41467-022-35747-8
Palva, J. M., Monto, S., Kulashekhar, S., & Palva, S. (2010). Neuronal synchrony reveals working memory networks and predicts individual memory capacity. Proceedings of the National Academy of Sciences, 107(16), 7580–7585. https: //doi.org/10.1073/pnas.0913113107
Parisi, G. I., Kemker, R., Part, J. L., Kanan, C., & Wermter, S. (2019). Continual lifelong learning with neural networks: A review. Neural Networks, 113, 54–71. https: //doi.org/10.1016/j.neunet.2019.01.012
Perea, G., Navarrete, M., & Araque, A. (2009). Tripartite synapses: Astrocytes process and control synaptic information. Trends in Neurosciences, 32(8), 421–431. https: //doi.org/10.1016/j.tins.2009.05.001
Pinitas, K., Chavlis, S., & Poirazi, P. (2021). Dendritic self-organizing maps for continual learning. arXiv. https: //arxiv.org/abs/2110.13611
PLOS Computational Biology. (2022). Efficient coding hypothesis and sparse coding. PLOS Computational Biology, 18(7), e1009642. https: //doi.org/10.1371/journal.pcbi.1009642
Poirazi, P., Brannon, T., & Mel, B. W. (2003). Pyramidal neuron as two-layer neural network. Neuron, 37(6), 989–999. https: //doi.org/10.1016/S0896-6273(03)00149-1
Quantum Zeitgeist. (2025, August 6). Neural spheres reveal brain’s energy efficiency. https: //quantumzeitgeist.com
Raffone, A., & Wolters, G. (2001). A cortical mechanism for binding in visual working memory. Journal of Cognitive Neuroscience, 13(6), 766–785. https: //doi.org/10.1162/08989290152541430
Shaham, N., Chandra, J., Kreiman, G., & Sompolinsky, H. (2022). Stochastic consolidation of lifelong memory. Scientific Reports, 12, Article 16407. https: //doi.org/10.1038/s41598-022-16407-9
Siebenhühner, F., Wang, S. H., Palva, J. M., & Palva, S. (2020). Cross-frequency synchronization connects networks of fast and slow oscillations during visual working memory maintenance. eLife, 9, e58058. https: //doi.org/10.7554/eLife.58058
Silver, R. A. (2010). Neuronal arithmetic. Nature Reviews Neuroscience, 11(7), 474–489. https: //doi.org/10.1038/nrn2864
Singer, W., & Gray, C. M. (1995). Visual feature integration and the temporal correlation hypothesis. Annual Review of Neuroscience, 18, 555–586. https: //doi.org/10.1146/annurev.ne.18.030195.003011
Sirosh, J., & Miikkulainen, R. (1994). Cooperative self-organization of afferent and lateral connections in cortical maps. Biological Cybernetics, 71(1), 65–78. https: //doi.org/10.1007/BF00198918
Stephan, A. H., Barres, B. A., & Stevens, B. (2012). The complement system: An unexpected role in synaptic pruning during development and disease. Annual Review of Neuroscience, 35, 369–389. https: //doi.org/10.1146/annurev-neuro-061010-113810
Stingl, M., Draguhn, A., & Both, M. (2025). A dendrite is a dendrite is a dendrite? Dendritic signal integration beyond the “antenna” model. Pflügers Archiv — European Journal of Physiology, 477(1), 9–16. https: //doi.org/10.1007/s00424-024-03004-0
Tadros, T., Krishnan, G. P., Ramyaa, R., & Bazhenov, M. (2022). Sleep-like unsupervised replay reduces catastrophic forgetting in artificial neural networks. Nature Communications, 13, Article 7742. https: //doi.org/10.1038/s41467-022-34938-7
The Conversation. (2026, September 16). Your brain runs on 20 watts. Could brain-inspired computing do the same? https: //theconversation.com
Theses. (2024). Computational models of acetylcholine function in learning and memory [Doctoral thesis, University of Bristol]. https: //research-information.bris.ac.uk
Tononi, G., & Cirelli, C. (2014). Sleep and the price of plasticity: From synaptic and cellular homeostasis to memory consolidation and integration. Neuron, 81(1), 12–34. https: //doi.org/10.1016/j.neuron.2013.12.025
Turrigiano, G. G., & Nelson, S. B. (2004). Homeostatic plasticity in the developing nervous system. Nature Reviews Neuroscience, 5(2), 97–107. https: //doi.org/10.1038/nrn1327
Ujfalussy, B. B., Makara, J. K., Branco, T., & Lengyel, M. (2015). Dendritic nonlinearities are tuned for efficient spike-based computations in cortical circuits. eLife, 4, e10056. https: //doi.org/10.7554/eLife.10056
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998–6008.
von der Malsburg, C. (1999). The what and why of binding: The modeler’s perspective. Neuron, 24(1), 95–104. https: //doi.org/10.1016/S0896-6273(00)80825-9
Wu, X., Liu, X., Li, W., & Wu, Q. (2018). Improved expressivity through dendritic neural networks. Advances in Neural Information Processing Systems, 31, 8057–8068.
Zenke, F., & Laborieux, A. (2024). Theories of synaptic memory consolidation and intelligent plasticity for continual learning. arXiv. https: //arxiv.org/abs/2405.16922