در بخشهای پیشین، اجزای اصلی نورون مصنوعی را بهتدریج شناختیم. ابتدا دریافتیم که ورودیهای نورون باید بهصورت عددی نمایش داده شوند. سپس بررسی کردیم که وزنها چگونه میزان و جهت تأثیر هر ورودی را تعیین میکنند و بایاس چگونه امکان جابهجایی مقدار پایه محاسبه و مرز تصمیم را فراهم میسازد.
اکنون باید این اجزا را در قالب یک سازوکار محاسباتی منسجم قرار دهیم.
ممکن است جمع وزندار در نگاه نخست عملیاتی بسیار ساده به نظر برسد: هر ورودی را در وزن متناظر ضرب میکنیم، حاصلضربها را جمع میکنیم و بایاس را به نتیجه میافزاییم. از نظر حسابی، این توضیح درست است؛ اما برای طراحی شبکه عصبی، تنها دانستن این دستورالعمل کافی نیست.
باید بتوانیم به پرسشهای دقیقتری پاسخ دهیم. اگر تعداد ورودیها از سه به هزار افزایش یابد، چگونه محاسبات را سازماندهی میکنیم؟ اگر بهجای یک نمونه، هزاران نمونه در اختیار داشته باشیم، آیا لازم است محاسبات را برای تکتک نمونهها جداگانه برنامهنویسی کنیم؟ چگونه میتوانیم درستی ابعاد بردارها و ماتریسها را بررسی کنیم؟ آیا همه روشهای محاسبه یک نتیجه ریاضی، در رایانه رفتار عددی و کارایی یکسانی دارند؟
پاسخ این پرسشها، مسیر حرکت از یک رابطه جبری ساده به پیادهسازی مهندسی نورون مصنوعی را روشن میکند.
در این بخش، جمع وزندار را در چهار سطح مطالعه خواهیم کرد: محاسبات اسکالر، نمایش برداری، پردازش مجموعهای از نمونهها و پیادهسازی رایانهای. همچنین تفاوت میان مدل ریاضی و نمایش عددی آن در رایانه، مسائل مربوط به ابعاد و محدودیتهای محاسباتی را بررسی میکنیم.
هدف آن است که خواننده در پایان بخش بتواند مقدار پیشفعالسازی یک نورون را برای تعداد دلخواهی از ویژگیها و نمونهها محاسبه کند، صحت عملیات را بررسی کند و ارتباط میان روابط ریاضی و کد پایتون را توضیح دهد.
۱. از اجزای مستقل نورون تا یک محاسبه واحد
برای شروع، به مسئله پایش وضعیت یک دستگاه صنعتی بازمیگردیم؛ مسئلهای که در بخشهای پیشین برای معرفی ورودیها، وزنها و بایاس استفاده کردیم.
فرض کنید سه ویژگی عددی و از پیش مقیاسبندیشده از وضعیت یک دستگاه در اختیار داریم: دما، شدت ارتعاش و جریان الکتریکی. هدف، محاسبه یک امتیاز فرضی است که بعدها میتواند برای تصمیمگیری مورد استفاده قرار گیرد.
تأکید میکنیم که در این مثال، نه ویژگیها از یک مجموعه داده صنعتی واقعی استخراج شدهاند و نه وزنهای انتخابشده حاصل آموزش یا کالیبراسیون معتبر هستند. این مثال صرفاً برای بررسی سازوکار محاسبات نورون طراحی شده است.
مقادیر ورودی را چنین در نظر میگیریم:
وزنهای متناظر عبارتاند از:
همچنین بایاس را برابر ۰٫۳− قرار میدهیم.
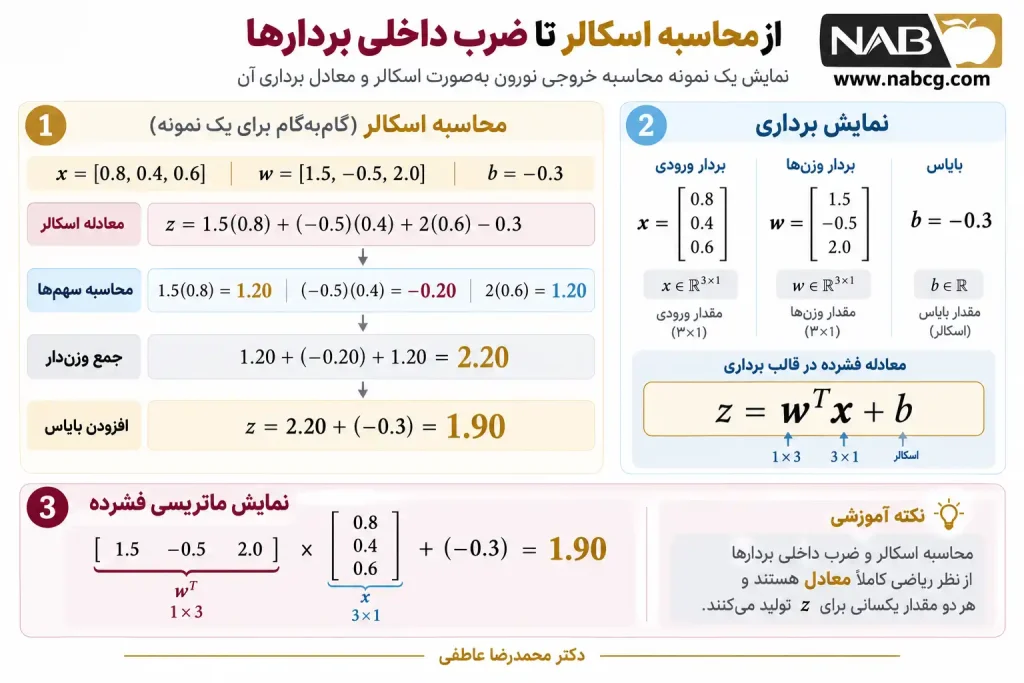
برای محاسبه مقدار پیشفعالسازی باید ابتدا هر ورودی در وزن متناظر ضرب شود، حاصلضربها با یکدیگر جمع شوند و سپس بایاس اضافه شود.
حاصلضربهای سه ورودی بهترتیب برابر ۱٫۲، ۰٫۲− و ۱٫۲ هستند. بنابراین، مجموع وزندار برابر ۲٫۲ میشود و با اضافه کردن بایاس خواهیم داشت:
در این محاسبه، هر وزن نقش مستقل خود را ایفا کرده است. ورودی دوم به دلیل منفی بودن وزن متناظر، سهم منفی در مجموع دارد؛ ورودیهای اول و سوم سهم مثبت ایجاد کردهاند؛ و بایاس مقدار نهایی را ۰٫۳ واحد کاهش داده است.
نکته مهم آن است که مقدار ۱٫۹ هنوز الزاماً پیشبینی، احتمال یا برچسب تصمیم نیست. این عدد فقط مقدار پیشفعالسازی (Pre-activation) نورون است. نحوه تبدیل آن به خروجی نهایی به تابع فعالسازی وابسته خواهد بود.
۱.۱. مراحل محاسبه و قابلیت ردیابی نتایج
برای جلوگیری از خطا، بهتر است محاسبه را به مراحلی تفکیک کنیم که هرکدام مستقل از مراحل دیگر قابل بررسی باشند.
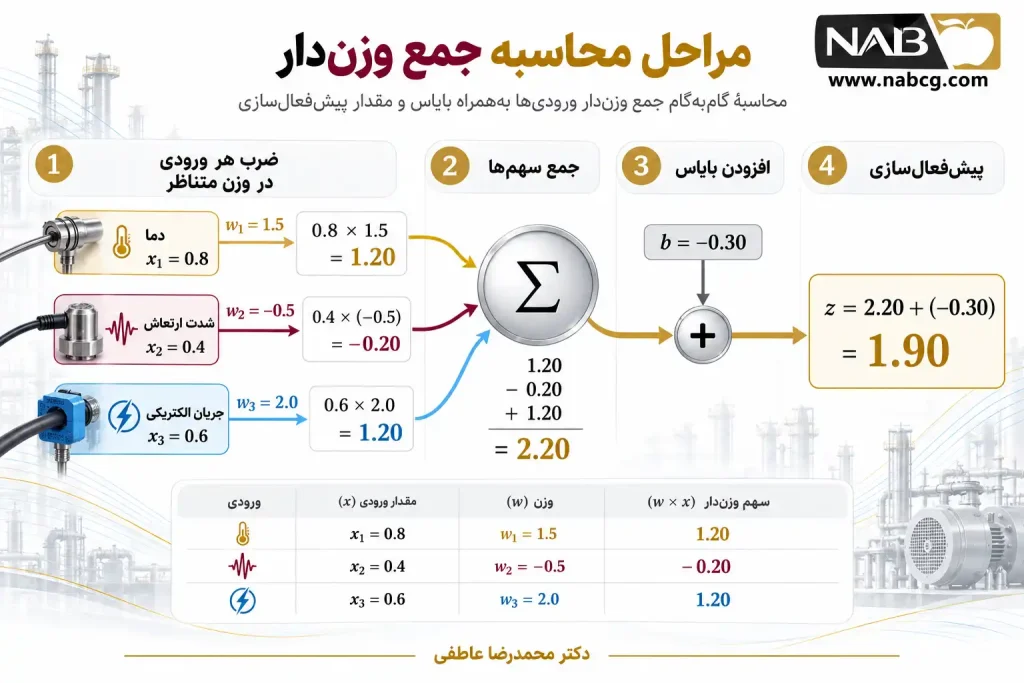
شکل 1.۱ — مسیر محاسبه پیشفعالسازی یک نورون سهورودی: ضرب هر ورودی در وزن متناظر، جمع سهمها و افزودن بایاس. شکل اختصاصی آموزشی است.
در شکل 1.۱، هر ورودی ابتدا یک سهم عددی ایجاد میکند. این سهمها در واحد جمعکننده با یکدیگر ترکیب میشوند و سپس بایاس به مجموع افزوده میشود.
اگر هنگام پیادهسازی خروجی مورد انتظار به دست نیاید، این تفکیک به ما کمک میکند منشأ خطا را تشخیص دهیم. ممکن است ورودی اشتباه ثبت شده باشد، وزن نامناسبی به آن اختصاص یافته باشد، ترتیب ویژگیها تغییر کرده باشد یا بایاس بهدرستی اضافه نشده باشد.
در نتیجه، ردیابی محاسبات صرفاً یک روش آموزشی نیست؛ بلکه در آزمون و خطایابی پیادهسازیهای عددی نیز کاربرد دارد.
مثال تکمیلی بخش ۱: تجزیه مقدار پیشفعالسازی به سهم هر ورودی
برای درک دقیقتر سازوکار جمع وزندار، میتوان مقدار پیشفعالسازی را به سهم مستقل هر ویژگی تجزیه کرد.
فرض کنید نورونی سه ورودی با مقادیر زیر دریافت کند:
جدول زیر سهم هر ویژگی را نشان میدهد.
| ویژگی | ورودی | وزن | سهم در مجموع |
| ویژگی اول | 0.8 | 1.5 | +1.20 |
| ویژگی دوم | 0.4 | -0.5 | -0.20 |
| ویژگی سوم | 0.6 | 2.0 | +1.20 |
| مجموع وزندار | 2.20 | ||
| بایاس | -0.30 | ||
| پیشفعالسازی | 1.90 |
نکته مهم آن است که علامت و اندازه هر سهم به حاصلضرب ورودی در وزن متناظر وابسته است. برای مثال، یک وزن منفی لزوماً به معنای سهم منفی نیست؛ اگر ورودی و وزن هر دو منفی باشند، حاصلضرب آنها مثبت خواهد شد.
این تفکیک برای بررسی صحت کد و شناسایی خطاهای مربوط به ترتیب ویژگیها نیز مفید است.
۲. صورتبندی عمومی جمع وزندار برای تعداد دلخواه ورودیها
در مثال قبل، تعداد ورودیها سه بود. اما یک نورون مصنوعی میتواند تعداد دلخواهی ورودی داشته باشد، مشروط بر اینکه ساختار ریاضی و منابع محاسباتی موردنیاز فراهم باشند.
اگر تعداد ویژگیها را با (d) نشان دهیم، مقدار پیشفعالسازی بهصورت زیر تعریف میشود:
معادله ۱ — صورت عمومی پیشفعالسازی نورون با (d) ورودی
در معادله ۱، نماد (i) اندیس ویژگی است و از یک تا (d) تغییر میکند. مقدار (xi) ویژگی شماره (i)، مقدار (wi) وزن متناظر آن، (b) بایاس و (z) مقدار پیشفعالسازی است.
فرضهای این رابطه آن است که ورودیها و پارامترها در فضای اعداد حقیقی تعریف شده باشند و هر ورودی دقیقاً با وزن متناظر خود ترکیب شود. همچنین بایاس در این مدل اسکالر است.
این معادله دارای (d+1) پارامتر مستقل بالقوه قابل تنظیم است: (d) وزن و یک بایاس. البته قابل تنظیم بودن پارامترها به معنای آن نیست که الگوریتم یادگیری برای آنها تعریف شده است.
اگر نورون ۱۰ ورودی داشته باشد، تعداد پارامترهای آن ۱۱ خواهد بود. برای ۱۰۰ ورودی، این تعداد به ۱۰۱ میرسد. بنابراین، تعداد پارامترهای یک نورون پایه با تعداد ویژگیهای ورودی رابطهای خطی دارد.
۲.۱. چرا جمع وزندار یک تابع آفین است؟
از دیدگاه جبر خطی، تابع
برای وزن ثابت، یک تابع خطی از ورودی است. این تابع دو خاصیت مهم دارد: جمعپذیری و همگنی.
به بیان ریاضی، برای بردارهای 𝐱 و 𝐮 و اسکالر c:
اما با افزودن بایاس غیرصفر، تابع جدید
دیگر در حالت عمومی این دو خاصیت را به شکل خطی خالص حفظ نمیکند.
برای مثال، در ورودی صفر داریم:
درحالیکه هر تبدیل خطی باید بردار صفر را به صفر نگاشت کند.
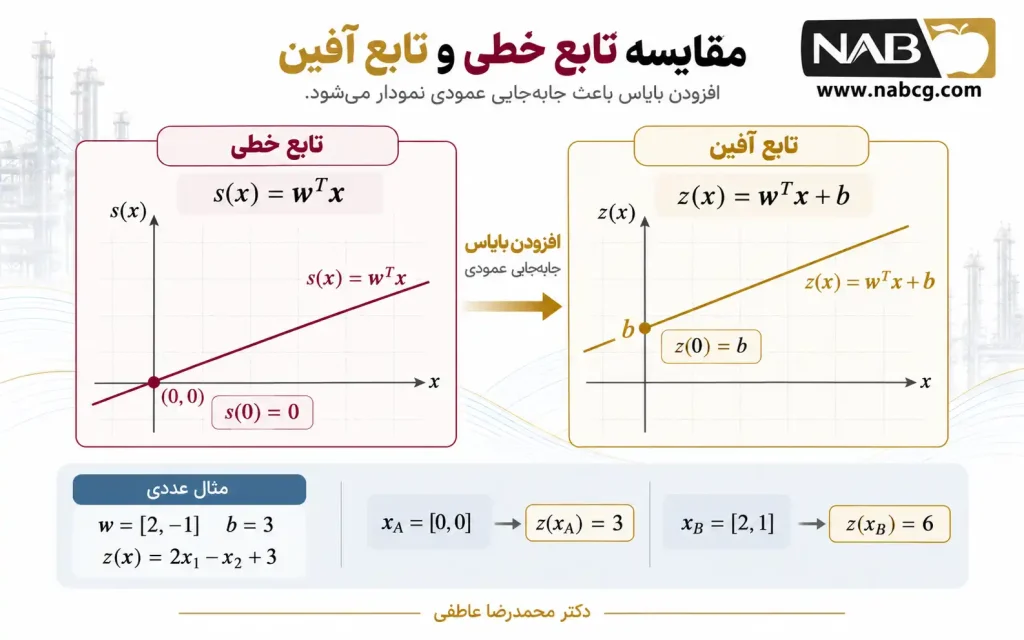
بنابراین، z(𝐱) یک تابع آفین محسوب میشود. این تمایز در طراحی شبکههای عصبی اهمیت دارد، زیرا لایههای متداول کاملاً متصل ابتدا یک تبدیل آفین را محاسبه میکنند و سپس تابع فعالسازی را روی نتیجه اعمال میکنند (Deisenroth et al., 2020; Goodfellow et al., 2016).
بااینحال، در ادبیات یادگیری ماشین اصطلاح «لایه خطی» گاهی برای لایهای استفاده میشود که بایاس نیز دارد. هنگام مطالعه مستندات نرمافزاری، باید به این تفاوت اصطلاحی توجه کرد.
مثال تکمیلی بخش ۲: تفاوت تابع خطی و تابع آفین
فرض کنید:
و تابع پیشفعالسازی برابر باشد با:
برای دو ورودی مختلف داریم:
این مثال نشان میدهد که تابع حتی در ورودی صفر نیز ممکن است مقدار غیرصفر تولید کند.
اگر بایاس حذف شود:
آنگاه:
بنابراین، مجموع وزندار بدون بایاس یک تابع خطی است، اما افزودن بایاس غیرصفر آن را به تابع آفین تبدیل میکند.
نکته تکمیلی: اگر بایاس مقدار صفر داشته باشد، تابع آفین به حالت خاص تابع خطی تبدیل میشود.
۳. گذار از محاسبه اسکالر به ضرب داخلی بردارها
برای نورونی با سه ورودی، نوشتن همه حاصلضربها دشوار نیست. اما اگر تعداد ویژگیها بسیار زیاد شود، نمایش اسکالر طولانی و نامناسب خواهد شد.
به همین دلیل، در محاسبات شبکههای عصبی از نمایش برداری استفاده میشود.
بردار ورودی و بردار وزن را به ترتیب چنین تعریف میکنیم:
هر دو بردار دارای (d) مؤلفه هستند. با استفاده از ضرب داخلی میتوان مجموع وزندار را محاسبه کرد:
معادله ۲ — صورت برداری پیشفعالسازی نورون مصنوعی
معادله ۲ از نظر ریاضی با معادله ۱ معادل است. در واقع، ضرب داخلی 𝐰^T 𝐱 همان مجموع حاصلضربهای مؤلفههای متناظر را محاسبه میکند.
مزیت نمایش برداری تنها کوتاهتر شدن فرمول نیست. این روش امکان استفاده از الگوریتمهای جبر خطی و عملیات بهینهشده عددی را فراهم میکند.
همچنین ساختار برداری با قراردادهای متداول شبکههای عصبی سازگار است و توسعه از یک نورون به چند نورون را سادهتر میکند.
۳.۱. نقش ابعاد در صحت ضرب داخلی
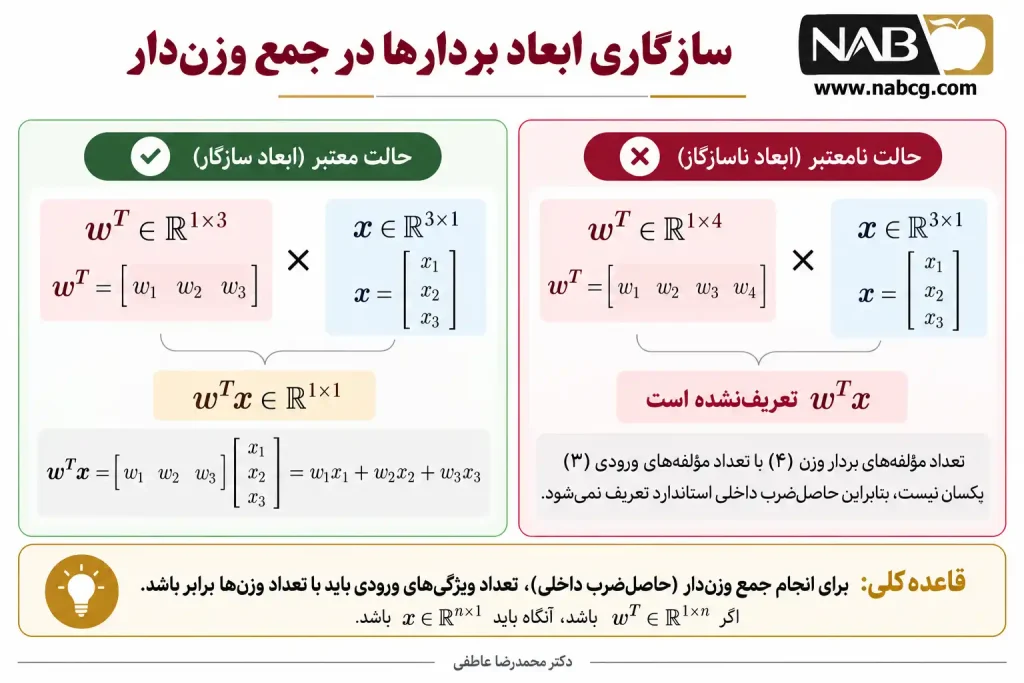
فرض کنید بردار ورودی سه مؤلفه داشته باشد:
اگر بردار وزن نیز سه مؤلفه داشته باشد:
میتوان ضرب داخلی آنها را محاسبه کرد.
از نظر نمایش ستونی، داریم:
بنابراین، حاصل ضرب برابر یک مقدار اسکالر با شکل ماتریسی ۱×۱ خواهد بود.
اما اگر بردار وزن دارای چهار مؤلفه باشد، ضرب داخلی استاندارد میان آن و بردار سهمؤلفهای تعریف نمیشود.
این موضوع از نظر طراحی نرمافزار بسیار مهم است. یک برنامه معتبر باید پیش از محاسبه، سازگاری ابعاد را بررسی کند.
مثال حلشده ۱ — محاسبه یک نورون پنجورودی
فرض کنید بردار ورودی و وزن به شکل زیر باشند:
بایاس را برابر ۱− در نظر میگیریم.
برای محاسبه ضرب داخلی:
در نتیجه:
با اضافه کردن بایاس:
این مثال چند نکته مهم دارد. وزن سوم منفی است و ورودی سوم مثبت؛ بنابراین سهم آن منفی خواهد بود. ورودی چهارم صفر است؛ در نتیجه، صرفنظر از وزن آن، سهمی در محاسبه این نمونه ندارد. همچنین مقدار بایاس به مجموع همه سهمها افزوده میشود، نه به یکی از ویژگیها.
این جزئیات هنگام برنامهنویسی باید دقیقاً رعایت شوند.
مثال تکمیلی بخش ۳: اهمیت ترتیب ویژگیها در ضرب داخلی
یکی از خطاهای مهم هنگام استفاده از بردارها، تغییر ترتیب ویژگیها بدون تغییر متناظر ترتیب وزنهاست.
فرض کنید:
نتیجه صحیح برابر است با:
حال اگر ترتیب ویژگی اول و دوم اشتباه جابهجا شود:
با ثابت ماندن وزنها خواهیم داشت:
اختلاف دو نتیجه:
در این مثال، ابعاد دو بردار کاملاً سازگار است و اجرای ضرب داخلی هیچ خطایی تولید نمیکند؛ بااینحال، نتیجه به دلیل جابهجایی معنای ویژگیها نادرست خواهد بود.
پس کنترل ابعاد شرط لازم است، اما برای تضمین صحت معنایی محاسبات کافی نیست.
۴. چرا باید محاسبه یک نمونه را از محاسبه مجموعهای از نمونهها جدا کنیم؟
در بخشهای قبلی، هر بار یک بردار ورودی را به نورون ارائه میکردیم. این روش برای درک سازوکار نورون مناسب است، اما هنگام کار با مجموعه دادههای واقعی کافی نیست.
فرض کنید مجموعه دادهای شامل ۱۰ هزار نمونه داریم و هر نمونه با ۲۰ ویژگی توصیف شده است. اگر بخواهیم مقدار پیشفعالسازی تمام نمونهها را محاسبه کنیم، میتوانیم محاسبه یک نورون را ۱۰ هزار بار تکرار کنیم.
این روش از نظر منطقی صحیح است، اما تنها راه انجام محاسبه نیست.
راه دیگر، سازماندهی دادهها بهصورت یک ماتریس و محاسبه تمام خروجیها با استفاده از عملیات ماتریسی است. این روش مبنای بسیاری از پیادهسازیهای عددی شبکههای عصبی محسوب میشود.
۴.۱. ساخت ماتریس داده
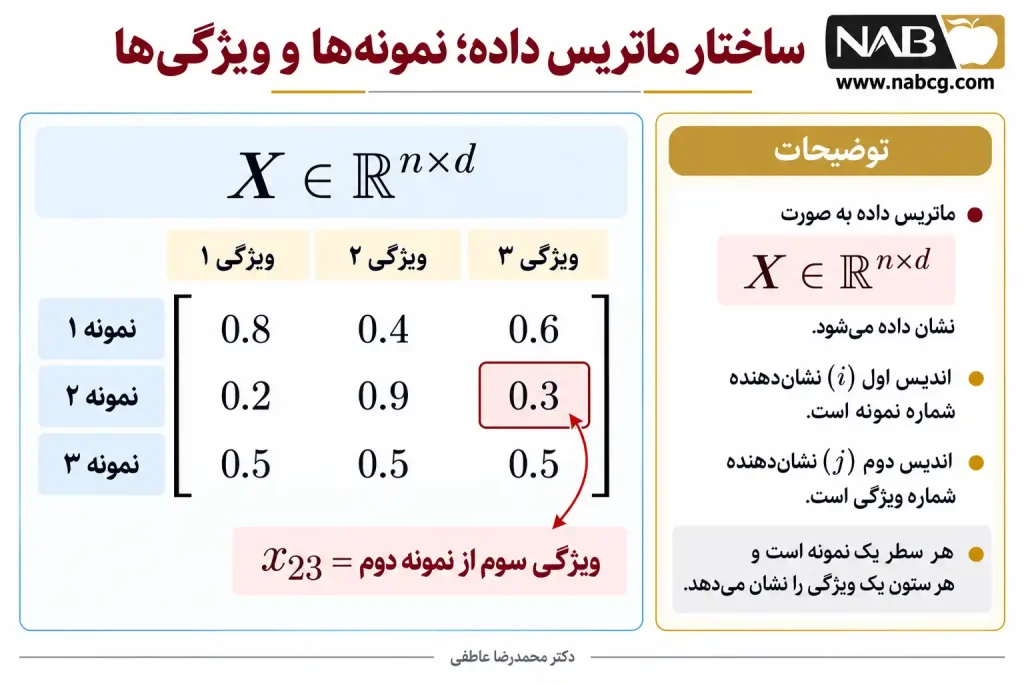
فرض کنید (n) نمونه و (d) ویژگی داریم.
ماتریس ورودی را با نماد (X) نمایش میدهیم:
معادله ۳ — نمایش ماتریسی مجموعه داده با (n) نمونه و (d) ویژگی
در این ماتریس، اندیس نخست شماره نمونه و اندیس دوم شماره ویژگی را مشخص میکند.
بهعنوان مثال، x₂₃ مقدار ویژگی سوم برای نمونه دوم است.
این قرارداد با بخش سوم فصل سازگار است: هر سطر یک نمونه و هر ستون یک ویژگی را نمایش میدهد.
۴.۲. محاسبه همزمان پیشفعالسازی تمام نمونهها
بردار وزن را بهصورت 𝐰 ∈ ℝ^d و بایاس را بهصورت اسکالر b در نظر میگیریم.
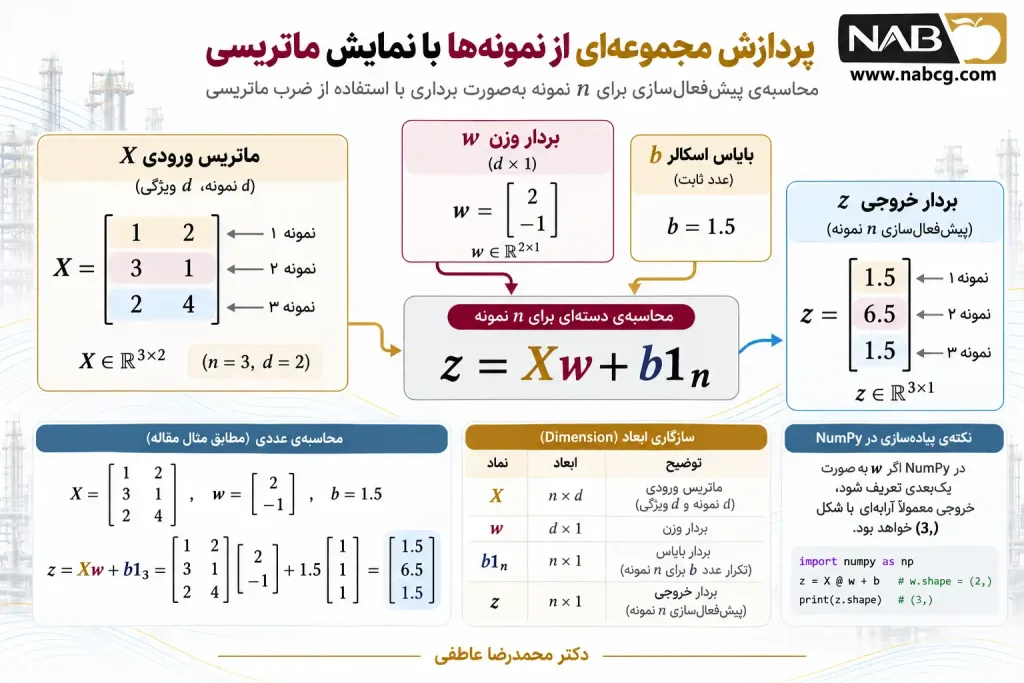
برای محاسبه مقدار پیشفعالسازی تمام نمونهها میتوان نوشت:
معادله ۴ — محاسبه دستهای پیشفعالسازی یک نورون برای (n) نمونه
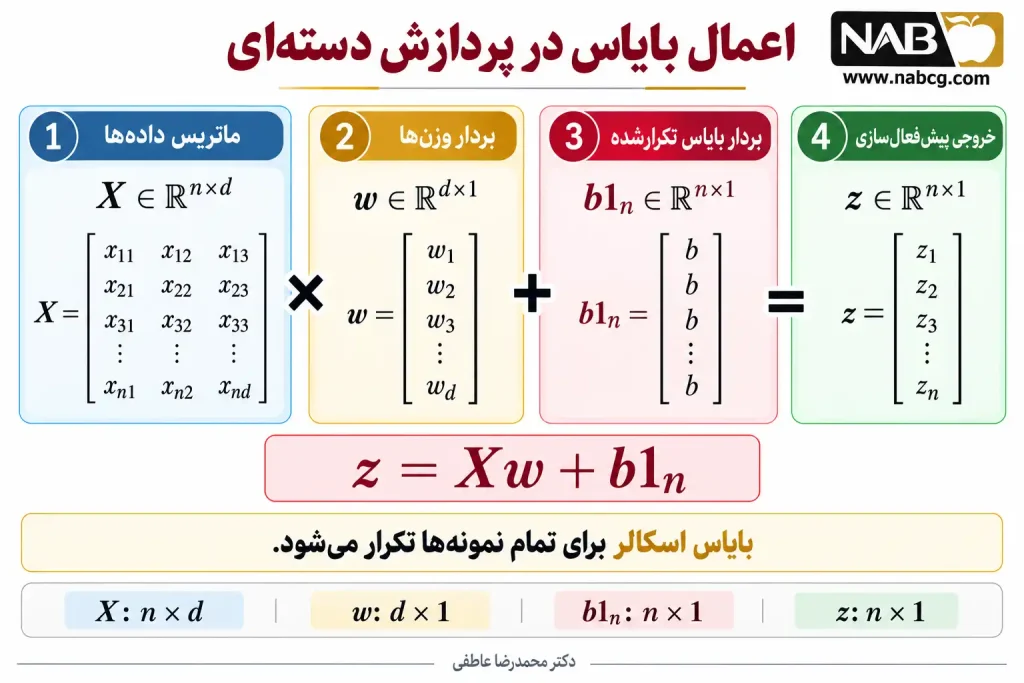
در این رابطه، 𝟏ₙ بردار ستونی شامل n عدد یک است. حاصل ضرب X𝐰 نیز برداری با n مؤلفه تولید میکند. افزودن b𝟏ₙ سبب میشود بایاس به خروجی هر نمونه اضافه شود.
از نظر ابعاد، خواهیم داشت:
این بررسی ابعاد نشان میدهد که عملیات از نظر ریاضی سازگار است.
در نمایش ریاضی، 𝐳 یک بردار ستونی است؛ اما در NumPy، در صورت استفاده از بردار وزن یکبعدی، خروجی معمولاً آرایهای با شکل (n,) خواهد بود. این تفاوت باید در برنامهنویسی آگاهانه مدیریت شود.
مثال حلشده ۲ — محاسبه سه نمونه با یک نورون
فرض کنید مجموعه داده زیر را در اختیار داریم:
وزن و بایاس نورون عبارتاند از:
ابتدا ضرب ماتریسی را محاسبه میکنیم:
اکنون بایاس را به هر مؤلفه اضافه میکنیم:
نتیجه این است که یک نورون با وزنها و بایاس ثابت، برای سه نمونه متفاوت مقادیر پیشفعالسازی ۱٫۵، ۶٫۵ و ۱٫۵ تولید میکند.
این تفاوتها ناشی از ویژگیهای نمونههاست، نه تغییر پارامترهای نورون.
مثال تکمیلی بخش ۴: محاسبه ماتریسی با سه ویژگی
فرض کنید چهار مشاهده و سه ویژگی داریم:
و پارامترهای نورون به شکل زیر باشند:
خروجی هر نمونه از رابطه zᵢ = Σⱼ xᵢⱼwⱼ + b محاسبه میشود.
| نمونه | مجموع وزندار | بایاس | پیشفعالسازی |
| اول | 0 | 0.5- | 0.5- |
| دوم | 2.5- | 0.5- | 3- |
| سوم | 5 | 0.5- | 4.5 |
| چهارم | 7 | 0.5- | 6.5 |
بنابراین:
این محاسبه یک نکته اساسی دارد: برای چهار مشاهده، تنها یک بردار وزن سهعضوی و یک بایاس استفاده شده است. تعداد نمونهها تعداد پارامترهای نورون را تغییر نمیدهد.
۵. مفهوم بردارسازی در محاسبات شبکههای عصبی
بردارسازی (Vectorization) به سازماندهی محاسبات در قالب عملیات برداری و ماتریسی گفته میشود، بهگونهای که نیاز به نوشتن حلقههای صریح در سطح کد کاربر کاهش یابد.
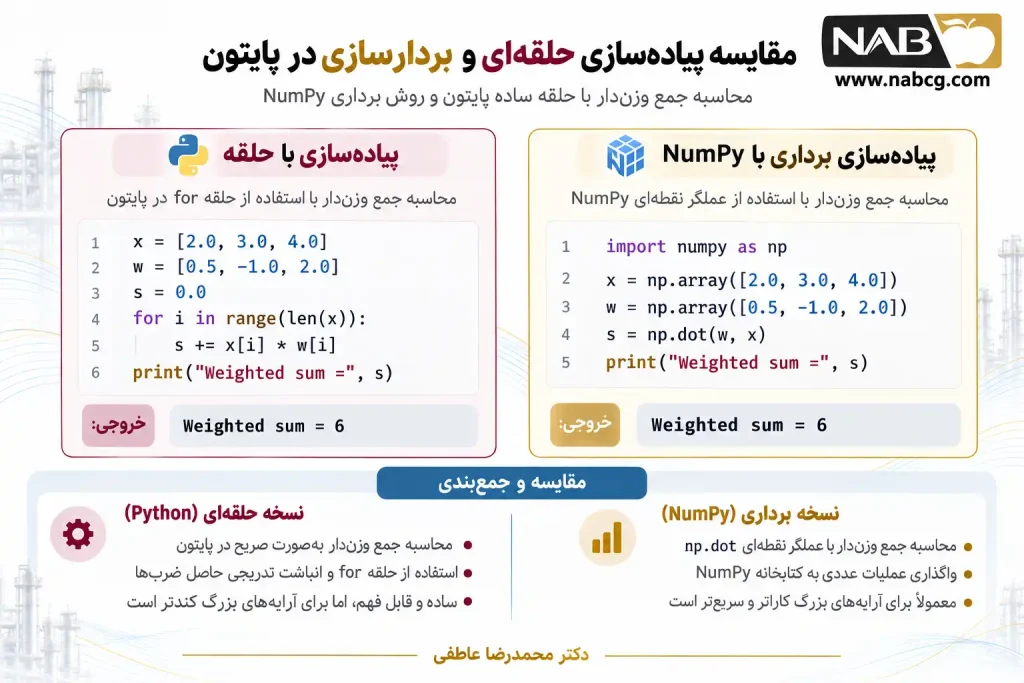
برای مثال، اگر بخواهیم ضرب داخلی دو بردار را با پایتون معمولی محاسبه کنیم، میتوانیم از حلقه استفاده کنیم:
x = [2.0, 3.0, 4.0]
w = [0.5, -1.0, 2.0]

s = 0.0

for i in range(len(x)):
    s += x[i] * w[i]

print("Weighted sum:", s)
این کد خروجی ۶ را تولید میکند.
همان محاسبه را میتوان با NumPy انجام داد:
import numpy as np

x = np.array([2.0, 3.0, 4.0])
w = np.array([0.5, -1.0, 2.0])

s = np.dot(w, x)

print("Weighted sum:", s)
در هر دو حالت، نتیجه ریاضی یکسان است.
اما تفاوت ساختاری مهمی وجود دارد: در حالت نخست، حلقه جمع و ضرب را در سطح برنامه پایتون اجرا میکند. در حالت دوم، عملیات به پیادهسازی عددی NumPy واگذار میشود.
NumPy از آرایههای همگن و عملیات عددی بهینهشده استفاده میکند و در بسیاری از شرایط میتواند محاسبات بزرگ را کارآمدتر از حلقههای صریح پایتون انجام دهد. بااینحال، مقدار واقعی افزایش سرعت به اندازه آرایه، نوع داده، ساختار حافظه، سختافزار و پیادهسازی عددی وابسته است (Harris et al., 2020).
در نتیجه، این ادعا که «بردارسازی در تمام شرایط سریعتر است» دقیق نیست. برای دادههای بسیار کوچک، هزینه آمادهسازی آرایهها و فراخوانی توابع ممکن است مزیت عملکردی بردارسازی را کاهش دهد یا از بین ببرد.
با وجود این محدودیت، یادگیری بردارسازی برای ورود به شبکههای عصبی چندلایه ضروری است؛ زیرا لایههای عصبی معمولاً بر مجموعههای بزرگی از دادهها و پارامترها اعمال میشوند.
۵.۱. تفاوت محاسبه یک نمونه و پردازش دستهای
برای یک نمونه، معمولاً از بردار 𝐱 استفاده میکنیم و مقدار پیشفعالسازی یک عدد است.
برای مجموعهای از (n) نمونه، از ماتریس (X) استفاده میکنیم و حاصل یک بردار با (n) مقدار خواهد بود.
| ویژگی | محاسبه یک نمونه | محاسبه دستهای |
| ورودی | 𝐱 ∈ ℝ^d | X ∈ ℝ^(n×d) |
| وزن | 𝐰 ∈ ℝ^d | همان بردار وزن |
| بایاس | یک اسکالر | همان اسکالر برای همه نمونهها |
| خروجی | یک اسکالر | بردار (n)-مؤلفهای |
| عملیات اصلی | ضرب داخلی | ضرب ماتریس در بردار |
| کاربرد | پردازش یک مشاهده | پردازش چند مشاهده |
جدول ۱ — مقایسه ساختار محاسباتی پیشفعالسازی برای یک نمونه و مجموعهای از نمونهها
نکته کلیدی جدول ۱ این است که در هر دو حالت، مدل همان نورون است. تغییر تنها در نحوه سازماندهی نمونههای ورودی و اجرای محاسبات است.
این مسئله از اشتباه رایجی جلوگیری میکند: پردازش ۱۰۰ نمونه با یک نورون، به معنای داشتن ۱۰۰ نورون متفاوت نیست.
6. پیچیدگی محاسباتی جمع وزندار
تا این مرحله، درباره صحت ریاضی محاسبات صحبت کردیم. اکنون باید به هزینه محاسبه نیز توجه کنیم.
برای نورونی با d ورودی، محاسبه مجموع وزندار بهصورت مستقیم به d ضرب و تقریباً d جمع نیاز دارد؛ اگر جمع کردن بایاس نیز در نظر گرفته شود، تعداد کل جمعها برای d ≥ ۱ برابر d خواهد بود.
بنابراین، تعداد عملیات حسابی اصلی متناسب با تعداد ورودیها افزایش مییابد.
در تحلیل الگوریتمها، مرتبه زمانی محاسبه را میتوان چنین نوشت:
در این رابطه، (T(d)) هزینه محاسباتی در وابستگی به تعداد ویژگیهاست و نماد (O(d)) نشان میدهد که در پیادهسازی متعارف جمع وزندار متراکم، تعداد عملیات با (d) رشد خطی دارد.
اگر (n) نمونه و (d) ویژگی داشته باشیم، محاسبه مستقیم پیشفعالسازی تمام نمونهها دارای مرتبه زمانی زیر است:
این بیان، تعداد عملیات حسابی را در نظر میگیرد؛ نه زمان واقعی اجرا روی یک سختافزار مشخص.
برای مثال، اجرای عملیات روی پردازنده مرکزی، پردازنده گرافیکی یا سامانههای محاسباتی موازی ممکن است زمانهای متفاوتی داشته باشد، حتی اگر تعداد عملیات ریاضی مشابه باشد.
از نظر حافظه نیز، ذخیره ماتریس متراکم (X) به فضایی متناسب با (nd) نیاز دارد. بردار وزن فضایی متناسب با (d) اشغال میکند و بردار خروجی به (n) مقدار نیاز دارد.
بنابراین، برای دادههای بزرگ، هزینه ذخیرهسازی دادهها میتواند بسیار بیشتر از هزینه ذخیره وزنهای یک نورون باشد.
این تحلیل مقدماتی، زمینهای برای شناخت هزینه حافظه و محاسبات در شبکههای عصبی چندلایه فراهم میکند.
مثال تکمیلی بخش ۶: محاسبه تعداد عملیات و حافظه موردنیاز
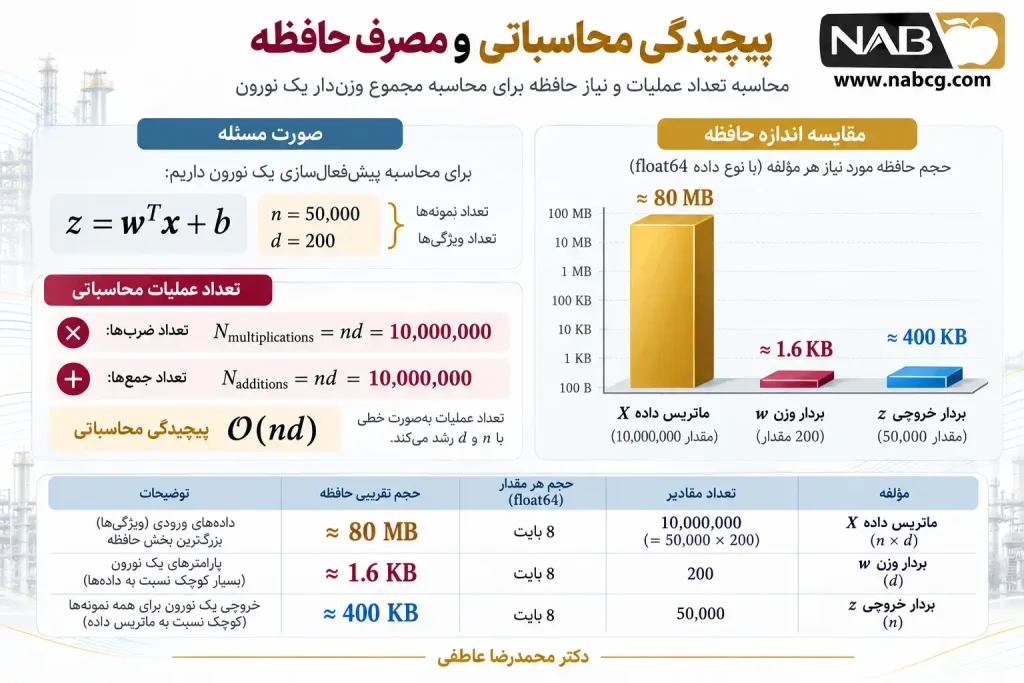
فرض کنید مجموعه دادهای شامل ۵۰٬۰۰۰ مشاهده و ۲۰۰ ویژگی باشد.
بنابراین:
برای محاسبه مستقیم پیشفعالسازی یک نورون، برای هر نمونه به ۲۰۰ ضرب و ۲۰۰ جمع، با احتساب افزودن بایاس، نیاز داریم.
پس:
اگر ماتریس داده بهصورت متراکم و با نوع float64 ذخیره شود، هر مقدار ۸ بایت فضا نیاز دارد.
| بخش | تعداد مقدار | حافظه تقریبی |
| ماتریس X | 10,000,000 | 80 MB |
| بردار وزن | 200 | 1.6 KB |
| بردار خروجی | 50,000 | 400 KB |
بنابراین، ماتریس داده بسیار بیشتر از پارامترهای یک نورون فضا اشغال میکند.
این محاسبه فقط حجم آرایههای اصلی را نشان میدهد؛ حافظه موقت، سربار نرمافزار و کپیهای احتمالی داده در آن منظور نشده است.
۷. پیادهسازی جمع وزندار بدون کتابخانه یادگیری عمیق
یکی از اهداف اصلی این فصل آن است که خواننده عملکرد نورون را مستقل از کتابخانههای یادگیری عمیق درک کند. به همین دلیل، پیش از ورود به پیادهسازی کامل نورون در بخش دهم، باید جمع وزندار را به شیوهای قابل بررسی و آزمونپذیر پیادهسازی کنیم.
ابتدا نسخهای با پایتون استاندارد میسازیم. سپس آن را با NumPy بازنویسی میکنیم و درستی هر دو پیادهسازی را بررسی خواهیم کرد.
۷.۱. پیادهسازی مرحلهای با پایتون استاندارد
def weighted_sum(x, w, b=0.0):
    if len(x) != len(w):
        raise ValueError(
            "Number of inputs and weights must match."
        )

    total = 0.0

    for xi, wi in zip(x, w):
        total += xi * wi

    return total + b


inputs = [0.8, 0.4, 0.6]
weights = [1.5, -0.5, 2.0]
bias = -0.3

z = weighted_sum(inputs, weights, bias)

print(f"Pre-activation: {z:.2f}")
خروجی:
Pre-activation: 1.90این تابع دقیقاً همان عملیات معادله ۱ را انجام میدهد.
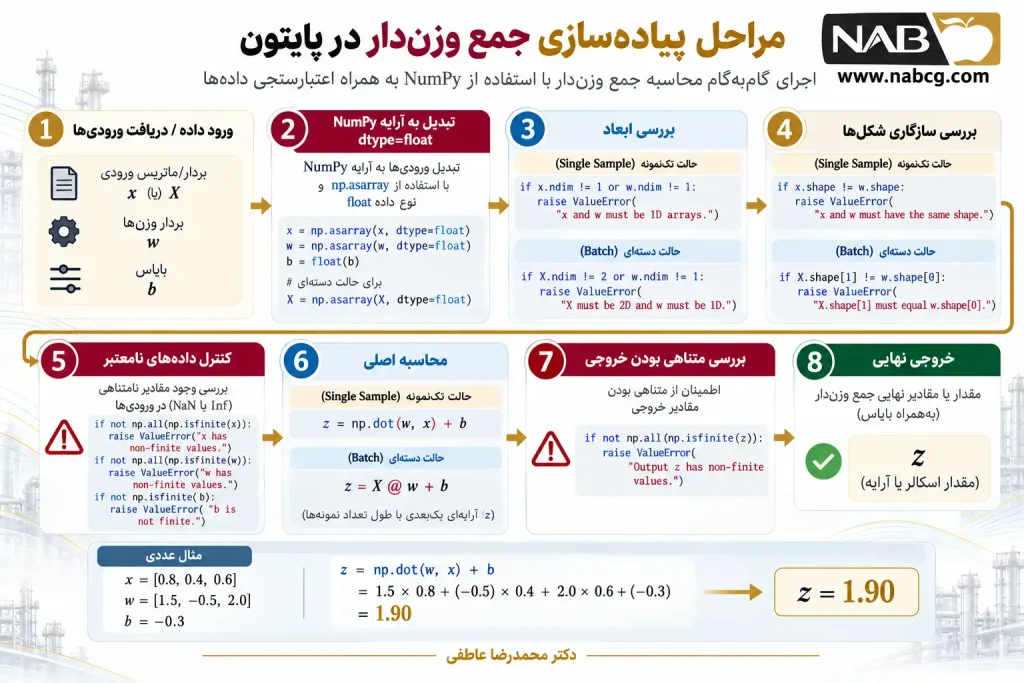
ابتدا سازگاری تعداد ورودیها و وزنها بررسی میشود. سپس متغیر total با مقدار صفر مقداردهی میشود. حلقه for هر ورودی را در وزن متناظر ضرب میکند و حاصل را به مجموع میافزاید.
پس از پایان حلقه، بایاس به مجموع اضافه میشود.
تابع فوق برای آموزش مناسب است، اما هنوز یک پیادهسازی مقاوم در برابر تمام ورودیهای نامعتبر نیست. برای مثال، انواع داده غیرعددی یا مقادیر نامتناهی باید جداگانه بررسی شوند. این قابلیتها را در نسخه مهندسی کامل نورون توسعه خواهیم داد.
۷.۲. پیادهسازی با NumPy و کنترل ابعاد
import numpy as np

def weighted_sum_numpy(x, w, b=0.0):
    x = np.asarray(x, dtype=float)
    w = np.asarray(w, dtype=float)

    if x.ndim != 1 or w.ndim != 1:
        raise ValueError(
            "Inputs and weights must be 1D."
        )

    if x.shape != w.shape:
        raise ValueError(
            "Input and weight shapes do not match."
        )

    if x.size == 0:
        raise ValueError(
            "At least one input is required."
        )

    if not np.isfinite(x).all():
        raise ValueError(
            "Inputs must be finite."
        )

    if not np.isfinite(w).all():
        raise ValueError(
            "Weights must be finite."
        )

    b = float(b)

    if not np.isfinite(b):
        raise ValueError(
            "Bias must be finite."
        )

    with np.errstate(over="ignore", invalid="ignore"):
        z = np.dot(w, x) + b

    if not np.isfinite(z):
        raise ArithmeticError(
            "Non-finite pre-activation result."
        )

    return float(z)


x = [0.8, 0.4, 0.6]
w = [1.5, -0.5, 2.0]
b = -0.3

z = weighted_sum_numpy(x, w, b)

print("Pre-activation:", round(z, 2))
این نسخه علاوه بر محاسبه ضرب داخلی، شکل ورودیها و معتبر بودن مقادیر عددی را بررسی میکند.
استفاده از np.isfinite کمک میکند مقادیر NaN و بینهایت شناسایی شوند. بااینحال، حتی اگر تمام ورودیها و وزنها متناهی باشند، در محاسبات با مقادیر بسیار بزرگ امکان سرریز عددی (Overflow) وجود دارد؛ به همین دلیل، خروجی نهایی نیز بررسی شده است.
این کنترلها برای ساخت یک پیادهسازی آموزشی قابل اعتماد مناسباند، هرچند برای سامانههای تولیدی ممکن است مدیریت دقیقتر نوع داده، دامنه مقادیر و استثناها لازم باشد.
۸. پیادهسازی پردازش دستهای بدون حلقه صریح
اکنون همان نورون را برای مجموعهای از نمونهها اجرا میکنیم.
import numpy as np


def batch_pre_activation(X, w, b=0.0):
    X = np.asarray(X, dtype=float)
    w = np.asarray(w, dtype=float)

    if X.ndim != 2:
        raise ValueError(
            "X must be a 2D matrix."
        )

    if w.ndim != 1:
        raise ValueError(
            "w must be a 1D vector."
        )

    if X.shape[1] != w.shape[0]:
        raise ValueError(
            "Feature count does not match weight count."
        )

    if w.size == 0:
        raise ValueError(
            "At least one feature is required."
        )

    b = float(b)

    if not (
        np.isfinite(X).all()
        and np.isfinite(w).all()
        and np.isfinite(b)
    ):
        raise ValueError(
            "All values must be finite."
        )

    with np.errstate(over="ignore", invalid="ignore"):
        z = X @ w + b

    if not np.isfinite(z).all():
        raise ArithmeticError(
            "Non-finite result."
        )

    return z


X = np.array([
    [1.0, 2.0],
    [3.0, 1.0],
    [2.0, 4.0]
])

w = np.array([2.0, -1.0])
b = 1.5

z = batch_pre_activation(X, w, b)

print("Pre-activation:", z)
print("Output shape:", z.shape)
خروجی:
[1.5 6.5 1.5]
Output shape: (3,)
در این پیادهسازی، عملیات X @ w حاصل ضرب ماتریس در بردار است و NumPy محاسبات لازم برای تمام سطرهای ماتریس را انجام میدهد.
بایاس اسکالر نیز به کمک قواعد انتشار ابعاد NumPy به همه مؤلفههای بردار خروجی افزوده میشود.
برای فهم عملکرد این کد، باید در نظر داشت که بردارسازی محاسبات، یک الگوریتم یادگیری ایجاد نمیکند. وزنها و بایاس همچنان ثابت هستند و برنامه فقط محاسبه پیشرو (Forward Computation) انجام میدهد.
۹. آیا نتیجه محاسبات رایانهای همیشه دقیقاً با ریاضیات یکسان است؟
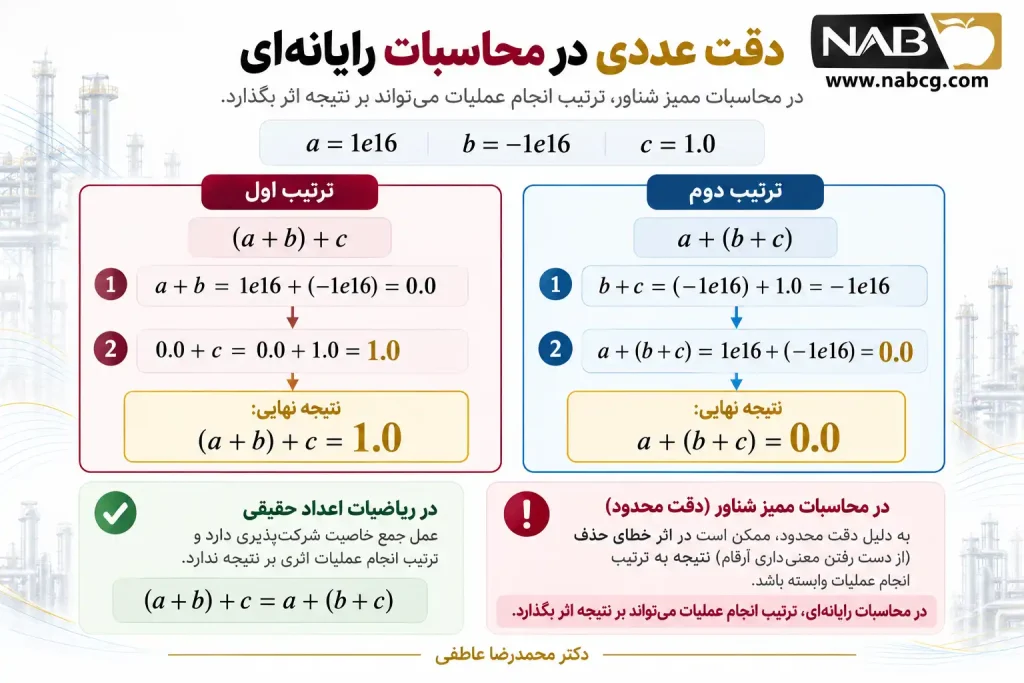
در ریاضیات حقیقی، جمع و ضرب دارای خواص جبری مشخصی هستند. برای مثال، جمع اعداد حقیقی شرکتپذیر است:
اما در محاسبات رایانهای، بسیاری از اعداد اعشاری با دقت محدود نمایش داده میشوند. بنابراین، ترتیب انجام عملیات ممکن است بر نتیجه نهایی اثر بگذارد.
برای مثال:
a = 1e16
b = -1e16
c = 1.0

result_1 = (a + b) + c
result_2 = a + (b + c)

print("First order:", result_1)
print("Second order:", result_2)
در محاسبات معمول با اعداد ممیز شناور ۶۴ بیتی، نتیجه چنین خواهد بود:
1.0
0.0
از نظر ریاضی، دو عبارت برابرند؛ اما بهدلیل گرد کردن در نمایش ممیز شناور، نتیجه محاسبات رایانهای یکسان نیست.
این ویژگی برای پیادهسازی شبکههای عصبی اهمیت دارد، زیرا جمع وزندار ممکن است شامل تعداد زیادی حاصلضرب با اندازههای عددی بسیار متفاوت باشد.
در بسیاری از کاربردهای آموزشی و عملی، این اختلافهای کوچک مشکلی ایجاد نمیکنند. اما در محاسبات حساس، استفاده از دقت عددی مناسب، روشهای پایدارتر جمع و آزمونهای مبتنی بر تلورانس ضروری است.
برای مثال، هنگام مقایسه دو نتیجه اعشاری بهتر است بهجای برابری دقیق، از تابعی مانند np.allclose استفاده کنیم:
import numpy as np

a = 0.1 + 0.2
b = 0.3

print("Exact equality:", a == b)
print("Close enough:", np.isclose(a, b))
خروجی معمول:
False
True
این مثال به معنای نادرست بودن حساب رایانهای نیست؛ بلکه نشان میدهد مدل محاسباتی اعداد ممیز شناور با اعداد حقیقی ریاضی تفاوتهایی دارد.
در طراحی شبکههای بزرگتر، این موضوع با مباحث پایداری عددی (Numerical Stability)، دقت محاسبات و بهینهسازی عملکرد ارتباط پیدا میکند (Higham, 2002).
۱۰. آزمایشهای کنترلشده
آزمایش ۱ — مقایسه محاسبه حلقهای و برداری
پرسش علمی: آیا دو شیوه محاسبه مجموع وزندار، نتایج عددی سازگاری تولید میکنند؟
فرضیه آن است که هر دو روش باید از نظر ریاضی معادل باشند و نتایج آنها تا محدوده خطای عددی با یکدیگر مطابقت داشته باشند.
برای این آزمایش، بردارهای ورودی و وزن را بهصورت ثابت تعریف میکنیم.
import numpy as np

x = np.array([2.0, -1.0, 3.0, 4.0])
w = np.array([0.5, 2.0, -1.0, 0.25])
b = -0.5

manual = b

for xi, wi in zip(x, w):
    manual += xi * wi

vectorized = np.dot(w, x) + b

print("Manual:", manual)
print("Vectorized:", vectorized)

print(
    "Equivalent:",
    np.isclose(manual, vectorized)
)
خروجی:
Manual: -3.5
Vectorized: -3.5
Equivalent: True
این نتیجه نشان میدهد که در نمونه انتخابشده، هر دو روش مقدار یکسانی تولید کردهاند.
اما از این آزمایش نمیتوان نتیجه گرفت که تمام پیادهسازیها برای تمام ورودیهای ممیز شناور نتیجه دقیقاً یکسان خواهند داشت؛ زیرا ترتیب جمعها و جزئیات محاسبات عددی ممکن است متفاوت باشد.
آزمایش ۲ — مقایسه زمان اجرای روش حلقهای و برداری
پرسش علمی: آیا استفاده از عملیات ماتریسی NumPy در پردازش تعداد زیادی نمونه میتواند زمان اجرا را کاهش دهد؟
برای پاسخ، یک مجموعه داده مصنوعی و وزنهای ثابت تولید میکنیم و میانگین زمان اجرای دو روش را اندازه میگیریم.
import numpy as np
from time import perf_counter
import platform

rng = np.random.default_rng(42)

n = 20000
d = 100

X = rng.normal(size=(n, d))
w = rng.normal(size=d)
b = 0.5


def loop_method(X, w, b):
    result = []

    for row in X:
        total = b

        for xi, wi in zip(row, w):
            total += xi * wi

        result.append(total)

    return np.array(result)


def vector_method(X, w, b):
    return X @ w + b


def benchmark(func, repeats=5):
    durations = []

    for _ in range(repeats):
        start = perf_counter()
        func()
        end = perf_counter()

        durations.append(end - start)

    return np.median(durations)


# Warm-up
loop_method(X[:10], w, b)
vector_method(X[:10], w, b)

# Verify numerical equivalence
z_loop = loop_method(X, w, b)
z_vector = vector_method(X, w, b)

assert np.allclose(z_loop, z_vector)

# Measure execution times
loop_time = benchmark(
    lambda: loop_method(X, w, b)
)

vector_time = benchmark(
    lambda: vector_method(X, w, b)
)

speedup = loop_time / vector_time

print("Python:", platform.python_version())
print("NumPy:", np.__version__)
print("Processor:", platform.processor())

print(f"Loop time: {loop_time:.6f} s")
print(f"Vector time: {vector_time:.6f} s")
print(f"Speedup: {speedup:.2f}x")

print(
    "Results match:",
    np.allclose(z_loop, z_vector)
در این آزمایش، داده و وزنها برای دو روش یکساناند. از مولد اعداد تصادفی NumPy با بذر ثابت ۴۲ استفاده شده است تا دادههای تولیدشده در یک محیط سازگار قابل بازتولید باشند.
مشاهده مورد انتظار: در بسیاری از محیطهای محاسباتی، روش برداری برای این اندازه داده سریعتر خواهد بود. بااینحال، نسبت افزایش سرعت را نباید از قبل قطعی دانست. این نسبت به نسخه NumPy، کتابخانههای جبر خطی، تعداد رشتههای پردازشی، پردازنده و سایر شرایط اجرا بستگی دارد.
برای گزارش علمی نتیجه، باید نسخه Python و NumPy، مشخصات سختافزار، سیستمعامل و شرایط اجرای آزمون ثبت شوند.
محدودیت آزمایش: این مقایسه تنها عملکرد دو پیادهسازی از یک عملیات مشخص را بررسی میکند و نمیتواند بهتنهایی نشاندهنده سرعت آموزش یا استنتاج یک شبکه عصبی کامل باشد.
آزمایش ۳ — بررسی حساسیت نتیجه به مقیاس عددی
در این آزمایش، سه مقدار با اندازههای بسیار متفاوت را جمع میکنیم:
import numpy as np

values = np.array(
    [1e16, 1.0, -1e16],
    dtype=np.float64
)

forward = float(sum(values))
reverse = float(sum(values[::-1]))

alternative = float(
    values[0] + (values[2] + values[1])
)

print("Forward:", forward)
print("Reverse:", reverse)
print("Alternative grouping:", alternative)
برای این داده و ترتیبها، هر دو نتیجه ممکن است صفر باشند. هدف اصلی نشان دادن این است که دقت محاسبات میتواند بر اثر اختلاف شدید اندازه اعداد محدود شود؛ برای مشاهده قطعی تفاوت دو ترتیب، نمونه بخش ۹ مناسبتر است.
پژوهشگر باید نتیجه واقعی اجرای کد را ثبت کند و صرفاً بر اساس انتظار اولیه، اختلاف عددی گزارش نکند.
این آزمایش مقدمهای برای بررسی پایداری عددی در محاسبات شبکههای عصبی است.
۱۱. پروژه جامع: طراحی و اعتبارسنجی موتور محاسباتی پیشفعالسازی یک نورون مصنوعی
۱۱.۱. تعریف مسئله و هدف پروژه
در این پروژه، یک موتور محاسباتی طراحی میکنیم که بتواند مقدار پیشفعالسازی یک نورون مصنوعی را برای یک نمونه یا مجموعهای از نمونهها محاسبه کند.
این موتور باید رابطه زیر را پیادهسازی کند:
و برای مجموعهای از نمونهها:
هدف پروژه، ایجاد ساختاری قابل استفاده مجدد است که محاسبات ریاضی را بهصورت صحیح و آزمونپذیر انجام دهد.
این پروژه بر محاسبه پیشرو با وزنها و بایاس ثابت تمرکز دارد؛ هیچ الگوریتم یادگیری در آن پیادهسازی نمیشود.
۱۱.۲. الزامات پروژه
برنامه باید بتواند ورودی یکبعدی و دوبعدی را تشخیص دهد، تعداد ویژگیها را با تعداد وزنها مقایسه کند، وجود مقادیر نامعتبر را بررسی کند و خروجی متناسب با ابعاد ورودی برگرداند.
همچنین باید امکان مشاهده سهم عددی هر ویژگی، مقایسه نتایج محاسبه دستی و برداری و کنترل صحت نتایج را فراهم کند.
برای این منظور یک کلاس به نام LinearNeuronCore تعریف میکنیم.
۱۱.۳. پیادهسازی کامل موتور محاسباتی
import numpy as np


class LinearNeuronCore:
    """
    Compute the pre-activation of a single neuron.

    z = X @ w + b

    No activation function or learning algorithm.
    """

    def __init__(self, weights, bias=0.0):
        self.weights = np.asarray(
            weights,
            dtype=np.float64
        ).copy()

        if self.weights.ndim != 1:
            raise ValueError(
                "Weights must be a 1D vector."
            )

        if self.weights.size == 0:
            raise ValueError(
                "At least one weight is required."
            )

        if not np.isfinite(self.weights).all():
            raise ValueError(
                "Weights must be finite."
            )

        self.bias = float(bias)

        if not np.isfinite(self.bias):
            raise ValueError(
                "Bias must be finite."
            )

        self.n_features = self.weights.size

    def _validate_input(self, X):
        X = np.asarray(
            X,
            dtype=np.float64
        )

        if X.ndim not in (1, 2):
            raise ValueError(
                "Input must be 1D or 2D."
            )

        feature_count = (
            X.size if X.ndim == 1
            else X.shape[1]
        )

        if feature_count != self.n_features:
            raise ValueError(
                "Input feature count does not "
                "match the number of weights."
            )

        if not np.isfinite(X).all():
            raise ValueError(
                "Input contains NaN or infinity."
            )

        return X

    def forward(self, X):
        X = self._validate_input(X)

        with np.errstate(
            over="ignore",
            invalid="ignore"
        ):
            z = X @ self.weights + self.bias

        if not np.isfinite(z).all():
            raise ArithmeticError(
                "Non-finite pre-activation result."
            )

        if X.ndim == 1:
            return float(z)

        return z

    def contributions(self, x):
        x = self._validate_input(x)

        if x.ndim != 1:
            raise ValueError(
                "Contributions require one sample."
            )

        with np.errstate(
            over="ignore",
            invalid="ignore"
        ):
            parts = x * self.weights
            total = parts.sum() + self.bias

        if not (
            np.isfinite(parts).all()
            and np.isfinite(total)
        ):
            raise ArithmeticError(
                "Non-finite contribution result."
            )

        return {
            "contributions": parts,
            "weighted_sum": float(parts.sum()),
            "bias": self.bias,
            "pre_activation": float(total)
        }
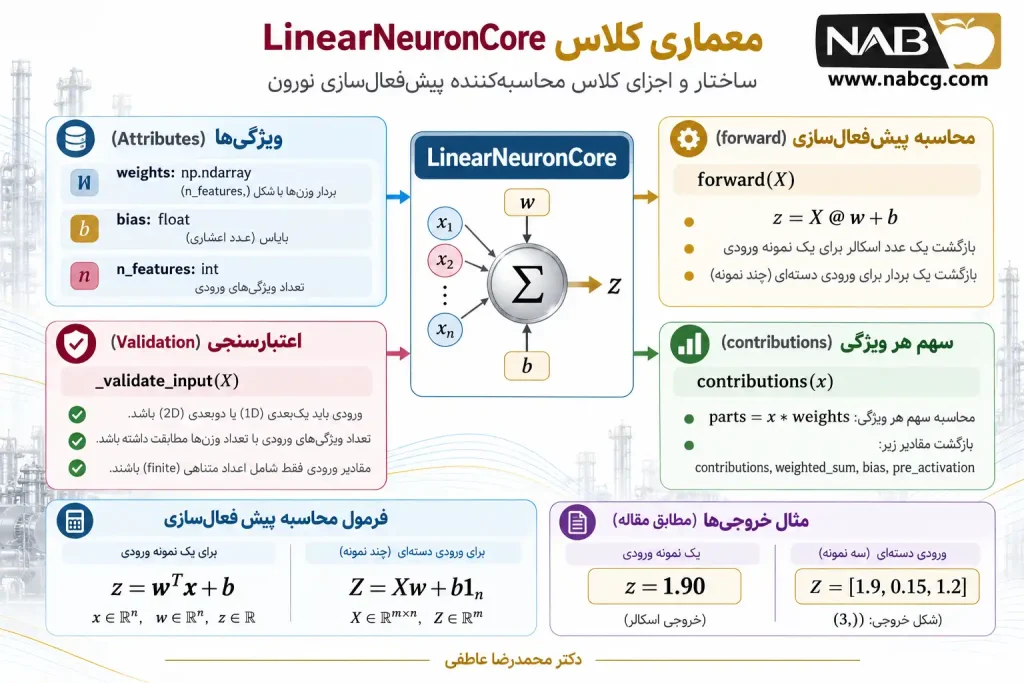
در این کلاس، وزنها هنگام ساخت شیء یکبار دریافت و بررسی میشوند. تابع _validate_input ابعاد و معتبر بودن ورودی را کنترل میکند. تابع forward مقدار پیشفعالسازی را محاسبه میکند و تابع contributions سهم مستقل ویژگیهای یک نمونه را برمیگرداند.
این جداسازی باعث میشود هر بخش از برنامه قابلیت بررسی و آزمون مستقل داشته باشد.
۱۱.۴. اجرای موتور برای یک نمونه و چند نمونه
کد زیر باید پس از تعریف کلاس قبلی اجرا شود.
import numpy as np

neuron = LinearNeuronCore(
    weights=[1.5, -0.5, 2.0],
    bias=-0.3
)

single_sample = np.array([
    0.8, 0.4, 0.6
])

batch = np.array([
    [0.8, 0.4, 0.6],
    [0.2, 0.9, 0.3],
    [0.5, 0.5, 0.5]
])

single_result = neuron.forward(
    single_sample
)

batch_result = neuron.forward(batch)

print(f"Single sample: {single_result:.2f}")

print(
    "Batch:",
    np.round(batch_result, 2)
)

print(
    "Batch output shape:",
    batch_result.shape
)
خروجی:
Single sample: 1.90
Batch: [1.9  0.15 1.2 ]
Batch output shape: (3,)
۱۱.۵. بررسی گامبهگام سهم ویژگیها
details = neuron.contributions(
    single_sample
)

print(
    "Contributions:",
    details["contributions"]
)

print(
    "Weighted sum:",
    round(details["weighted_sum"], 2)
)

print("Bias:", details["bias"])

print(
    "Pre-activation:",
    round(details["pre_activation"], 2)
خروجی:
Contributions: [ 1.2 -0.2  1.2]
Weighted sum: 2.2
Bias: -0.3
Pre-activation: 1.9
بررسی سهم هر ویژگی نشان میدهد که جمع وزندار از مجموع سه مقدار تشکیل شده است. افزودن بایاس در پایان، مقدار پیشفعالسازی را تولید میکند.
۱۱.۶. آزمون صحت پیادهسازی
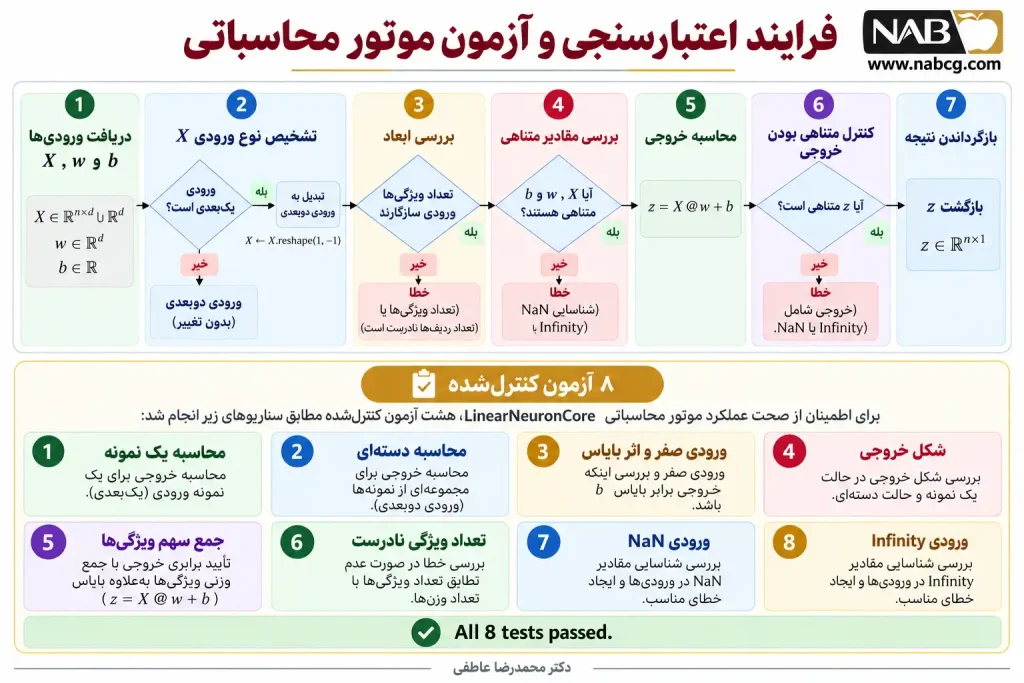
برای اطمینان از صحت موتور محاسباتی، لازم است علاوه بر یک ورودی معمولی، چند حالت مرزی و نامعتبر بررسی شوند.
import numpy as np

neuron = LinearNeuronCore(
    [1.5, -0.5, 2.0],
    -0.3
)

# Test 1: Single sample
assert np.isclose(
    neuron.forward([0.8, 0.4, 0.6]),
    1.9
)

# Test 2: Batch
X = np.array([
    [0.8, 0.4, 0.6],
    [0.2, 0.9, 0.3],
    [0.5, 0.5, 0.5]
])

expected = np.array([1.9, 0.15, 1.2])

assert np.allclose(
    neuron.forward(X),
    expected
)

# Test 3: Zero input
assert np.isclose(
    neuron.forward([0, 0, 0]),
    -0.3
)

# Test 4: Output dimensions
assert neuron.forward(X).shape == (3,)

# Test 5: Contribution sum
details = neuron.contributions(
    [0.8, 0.4, 0.6]
)

assert np.isclose(
    details["pre_activation"],
    1.9
)


def expect_value_error(function):
    try:
        function()
    except ValueError:
        return

    raise AssertionError(
        "Expected ValueError was not raised."
    )


# Test 6: Incorrect feature count
expect_value_error(
    lambda: neuron.forward([1.0, 2.0])
)

# Test 7: NaN input
expect_value_error(
    lambda: neuron.forward(
        [0.1, np.nan, 0.2]
    )
)

# Test 8: Infinite input
expect_value_error(
    lambda: neuron.forward(
        [0.1, np.inf, 0.2]
    )
)

print("All 8 tests passed.")
خروجی:
All 8 tests passed.این آزمونها صحت چند رفتار کلیدی را بررسی میکنند: محاسبه نمونه واحد، محاسبه دستهای، اثر بایاس در ورودی صفر، شکل خروجی و نحوه برخورد با داده نامعتبر.
البته عبور از این آزمونها به معنای اثبات درستی برنامه در تمام حالتهای ممکن نیست؛ بلکه اطمینان مشخصی درباره رفتارهای آزمودهشده ایجاد میکند.
۱۱.۷. افزودن قابلیت پردازش فایل CSV
یکی از کاربردهای عملی موتور محاسباتی، دریافت داده از یک فایل و تولید مقدار پیشفعالسازی برای همه سطرهاست.
برای اینکه پروژه مستقل از کتابخانههای یادگیری عمیق باقی بماند، از ماژول استاندارد csv پایتون استفاده میکنیم.
import csv
import numpy as np

# Create a sample CSV file
rows = [
    [0.8, 0.4, 0.6],
    [0.2, 0.9, 0.3],
    [0.5, 0.5, 0.5]
]

with open(
    "input_samples.csv",
    "w",
    newline="",
    encoding="utf-8"
) as file:
    writer = csv.writer(file)
    writer.writerow(["x1", "x2", "x3"])
    writer.writerows(rows)


# Read data
X = np.loadtxt(
    "input_samples.csv",
    delimiter=",",
    skiprows=1,
    ndmin=2
)

# Compute pre-activation
neuron = LinearNeuronCore(
    [1.5, -0.5, 2.0],
    -0.3
)

z = neuron.forward(X)

# Save results
with open(
    "pre_activation_results.csv",
    "w",
    newline="",
    encoding="utf-8"
) as file:
    writer = csv.writer(file)

    writer.writerow([
        "x1", "x2", "x3", "z"
    ])

    for row, value in zip(X, z):
        writer.writerow([
            *row,
            float(value)
        ])

print("Results saved successfully.")
فایل خروجی شامل سه ویژگی اصلی و یک ستون جدید به نام z خواهد بود. این ستون مقدار پیشفعالسازی نورون برای هر مشاهده را نشان میدهد.
۱۱.۸. تحلیل نتایج پروژه
این پروژه نشان میدهد که یک فرمول نسبتاً ساده ریاضی چگونه میتواند به یک مؤلفه نرمافزاری قابل استفاده مجدد تبدیل شود.
سه نکته مهم از اجرای پروژه به دست میآید.
نخست، محاسبه یک مشاهده و محاسبه یک مجموعه از مشاهدات، دو مدل متفاوت نیستند؛ هر دو از وزنها و بایاس یکسان استفاده میکنند.
دوم، صحت ظاهری نتیجه کافی نیست. بررسی ابعاد، اعتبارسنجی مقدارهای ورودی، کنترل خروجی و آزمونهای عددی، بخش مهمی از پیادهسازی معتبر محسوب میشوند.
سوم، استفاده از عملیات برداری امکان پردازش تعداد زیادی نمونه را فراهم میکند، بدون آنکه منطق اصلی محاسبه تغییر کند.
۱۱.۹. محدودیتهای پروژه
موتور طراحیشده دارای محدودیتهای مشخصی است.
وزنها و بایاس بهصورت ثابت تعریف میشوند و در طول اجرای محاسبات تغییر نمیکنند. همچنین موتور تنها مقدار پیشفعالسازی را محاسبه میکند و درباره معنای آن تصمیم نمیگیرد.
این ساختار برای بررسی سازوکار محاسبه نورون مناسب است، اما نباید آن را بهعنوان یک مدل آموزشدیده یا سیستم پیشبینی معتبر معرفی کرد.
۱۲. تمرینهای پایان بخش
تمرینهای مفهومی و ریاضی
- تمرین ۱ — تفکیک محاسبات: تفاوت میان مجموع وزندار (s)، مقدار پیشفعالسازی (z) و خروجی نهایی نورون را توضیح دهید. مشخص کنید کدامیک در این بخش بهصورت کامل محاسبه شده است.
- تمرین ۲ — محاسبه دستی: نورونی با چهار ورودی (x=(2,-1,3,5)^T)، وزنهای (w=(0.5,2,-1,0.2)^T) و بایاس ۲− در نظر بگیرید. مقدار پیشفعالسازی را محاسبه کنید.
- تمرین ۳ — شمارش پارامترها: یک نورون با ۱۵۰ ویژگی ورودی چند وزن و چند بایاس دارد؟ تعداد کل پارامترها را مشخص کنید.
- تمرین ۴ — ابعاد: اگر ماتریس داده دارای ۸۰۰ سطر و ۲۵ ستون باشد، بردار وزن و بردار پیشفعالسازی باید چه ابعادی داشته باشند؟
- تمرین ۵ — ضرب ماتریسی: برای ماتریس و بردار زیر، مقدار X𝐰 را دستی محاسبه کنید:
سپس بایاس ۱٫۵ را به خروجی همه نمونهها اضافه کنید.
- تمرین ۶ — تحلیل مدل آفین: توضیح دهید چرا افزودن بایاس غیرصفر، تابع خطی را به تابع آفین تبدیل میکند. پاسخ خود را با بررسی مقدار تابع در بردار صفر نشان دهید.
- تمرین ۷ — تفاوت نمونه و نورون: اگر یک نورون برای هزار نمونه اجرا شود، آیا تعداد وزنهای آن هزار برابر میشود؟ با استفاده از ابعاد ماتریس داده و بردار وزن پاسخ دهید.
- تمرین ۸ — محاسبه چند نورون: اگر پنج نورون مستقل داشته باشیم که هرکدام ده ورودی دریافت میکنند، تعداد کل وزنها و بایاسها چقدر خواهد بود؟ فرض کنید هر نورون وزنها و بایاس اختصاصی دارد.
تمرینهای برنامهنویسی
- تمرین ۹ — پیادهسازی دستی: محاسبه جمع وزندار را فقط با حلقه for و بدون NumPy پیادهسازی کنید. برنامه باید ورودیهای ناسازگار را شناسایی کند.
- تمرین ۱۰ — بررسی نتیجه: برای ۲۰ نمونه فرضی، پیشفعالسازی را با روش حلقهای و NumPy محاسبه کنید و با np.allclose نتایج را مقایسه کنید.
- تمرین ۱۱ — پردازش دستهای: ماتریسی با ۱۰۰ سطر و ۸ ستون تولید کنید و خروجی یک نورون هشتورودی را برای تمام نمونهها محاسبه کنید.
- تمرین ۱۲ — اعتبارسنجی: کلاس LinearNeuronCore را توسعه دهید تا نوع خطاهای ورودی را در پیامهایی مجزا گزارش کند؛ برای مثال، ناسازگاری ابعاد، وجود مقدار نامتناهی و نبود ویژگی.
- تمرین ۱۳ — بررسی زمان اجرا: زمان اجرای محاسبه حلقهای و برداری را برای مجموعه دادههایی با ۱۰۰، ۱۰۰۰ و ۱۰ هزار نمونه مقایسه کنید. نتایج را در جدول ثبت کنید و توضیح دهید آیا نسبت سرعت در هر سه حالت یکسان است.
- تمرین ۱۴ — رسم نتایج: برای مجموعهای از نمونههای دوبعدی، پیشفعالسازی یک نورون را محاسبه کنید و توزیع مقادیر حاصل را با یک هیستوگرام نمایش دهید.
- تمرین ۱۵ — آزمون واحد: حداقل شش آزمون برای کلاس LinearNeuronCore بنویسید؛ شامل ورودی معتبر، بردار وزن ناسازگار، داده دوبعدی، بایاس صفر، مقدار NaN و مقدار inf.
- تمرین ۱۶ — مستندسازی تابع: برای تابع محاسبه پیشفعالسازی، مستنداتی بنویسید که شکل ورودی، شکل خروجی، نوع داده، محدودیتها و خطاهای احتمالی را توضیح دهد.
تمرینهای تحلیلی پیشرفتهتر
- تمرین ۱۷ — اثر ترتیب جمع: با استفاده از اعداد دارای اندازه بسیار متفاوت، نمونهای بسازید که تغییر ترتیب جمع در محاسبات ممیز شناور باعث تغییر خروجی شود. سپس توضیح دهید چرا این اختلاف در ریاضیات حقیقی وجود ندارد.
- تمرین ۱۸ — تحلیل پیچیدگی: تعداد عملیات ضرب و جمع لازم برای محاسبه مستقیم پیشفعالسازی یک نورون با (d) ورودی را تعیین کنید. سپس آن را برای (n) نمونه تعمیم دهید.
- تمرین ۱۹ — اثر نوع داده: محاسبه یکسانی را با آرایههای float32 و float64 انجام دهید. اختلاف نتایج و میزان حافظه مصرفی آرایهها را بررسی کنید.
- تمرین ۲۰ — طراحی پروژه: برنامهای بسازید که فایل CSV شامل دادههای عددی را بخواند، تعداد ویژگیها را بررسی کند، وزنها و بایاس را از کاربر دریافت کند و مقدار پیشفعالسازی همه نمونهها را در یک فایل جدید ذخیره کند. در گزارش پروژه توضیح دهید که خروجی تولیدشده هنوز نتیجه یک مدل آموزشدیده نیست.
۱۳. جمعبندی علمی و آمادهسازی برای تابع فعالسازی
در آغاز بخش ، با سه ویژگی ورودی، سه وزن و یک بایاس، مقدار پیشفعالسازی یک نورون را محاسبه کردیم. همان محاسبه ساده را سپس به ساختارهای عمومیتر توسعه دادیم.
نخست نشان دادیم که جمع وزندار را میتوان برای تعداد دلخواهی از ویژگیها بهصورت یک مجموع ریاضی بیان کرد. سپس آن را به ضرب داخلی دو بردار تبدیل کردیم و با افزودن بایاس، صورت آفین محاسبه نورون را به دست آوردیم.
در مرحله بعد، با معرفی ماتریس داده، محاسبه یک نمونه را به پردازش مجموعهای از نمونهها گسترش دادیم. همچنین مشخص شد که تعداد عملیات حسابی برای یک نورون متراکم، متناسب با تعداد ویژگیها و تعداد نمونهها رشد میکند.
در بخش عملی، دو پیادهسازی متفاوت با پایتون و NumPy ارائه شد. دیدیم که چگونه میتوان محاسبات را بردارسازی کرد، ابعاد آرایهها را کنترل کرد و با استفاده از آزمونهای عددی، صحت نتایج را بررسی کرد.
اما مهمترین محدودیت ساختاری هنوز باقی است.
اکنون میتوانیم برای هر ورودی، مقداری حقیقی به نام (z) محاسبه کنیم:
این رابطه بهتنهایی مشخص نمیکند که آیا نورون باید خروجی دودویی، مقدار مثبت، عددی بین صفر و یک یا خروجی دیگری تولید کند.
همچنین ترکیب چند تبدیل آفین بدون استفاده از غیرخطیسازی، همچنان یک تبدیل آفین ایجاد خواهد کرد. بنابراین، برای ساخت شبکههایی که بتوانند خانواده گستردهتری از روابط غیرخطی را نمایش دهند، باید سازوکار دیگری به محاسبه اضافه کنیم.
این سازوکار، تابع فعالسازی (Activation Function) است.
در بخش هفتم خواهیم دید که چگونه تابع پلهای، سیگموید، تانژانت هیپربولیک و ReLU مقدار پیشفعالسازی را به خروجی تبدیل میکنند؛ چه تفاوتی میان خروجی دودویی و پیوسته وجود دارد؛ و چرا انتخاب تابع فعالسازی بر رفتار و ظرفیت نمایش مدل اثر میگذارد.
منابع
Deisenroth, M. P., Faisal, A. A., & Ong, C. S. (2020). Mathematics for machine learning. Cambridge University Press. https://doi.org/10.1017/9781108679930
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. https://www.deeplearningbook.org/
Harris, C. R., Millman, K. J., van der Walt, S. J., et al. (2020). Array programming with NumPy. Nature, 585, 357–362. https://doi.org/10.1038/s41586-020-2649-2
Higham, N. J. (2002). Accuracy and stability of numerical algorithms (2nd ed.). Society for Industrial and Applied Mathematics. https://doi.org/10.1137/1.9780898718027
NumPy Developers. (n.d.). NumPy reference documentation. https://numpy.org/doc/stable/reference/