درآمد: چرا محاسبه جمع وزندار پایان کار نورون نیست؟
در بخش قبلی، ساختار ریاضی و محاسباتی نورون مصنوعی را تا مرحله پیشفعالسازی توسعه دادیم. اکنون میتوانیم برای یک نمونه، بردار ورودی را در بردار وزن ضرب کنیم، بایاس را به حاصل بیفزاییم و یک مقدار عددی به دست آوریم. همچنین یاد گرفتیم که چگونه همین محاسبه را برای هزاران نمونه بهصورت برداری انجام دهیم.
رابطه حاصل چنین بود:
این رابطه بهتنهایی یک مدل محاسباتی معتبر است. برای مثال، اگر بخواهیم کمیتی پیوسته را با یک رابطه آفین برآورد کنیم، ممکن است مقدار (z) مستقیماً همان خروجی موردنظر باشد.
اما در بسیاری از مسائل، چنین خروجیای کافی نیست.
فرض کنید نورونی برای تصمیمگیری درباره روشن یا خاموش شدن یک سامانه طراحی شده است. اگر پیشفعالسازی آن برابر ۲٫1 باشد، این عدد بهخودیخود مشخص نمیکند که سامانه باید روشن شود یا خاموش بماند. همچنین اگر مقدار پیشفعالسازی ۰٫۳− باشد، باید بدانیم مدل قرار است این عدد را چگونه تفسیر کند.
.
در مسئلهای دیگر، ممکن است بخواهیم خروجی نورون همیشه بین صفر و یک قرار گیرد. در چنین حالتی، خروجی مستقیم یک تبدیل آفین میتواند نامناسب باشد؛ زیرا مقدار 𝐰^T 𝐱 + bدر حالت عمومی به بازه مشخصی محدود نیست.
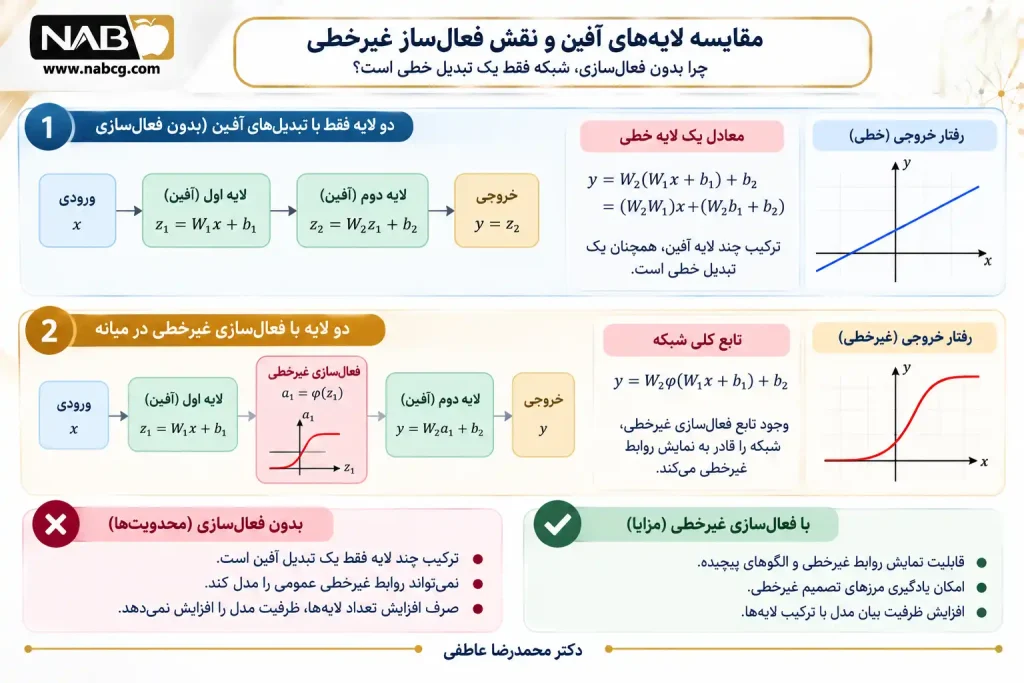
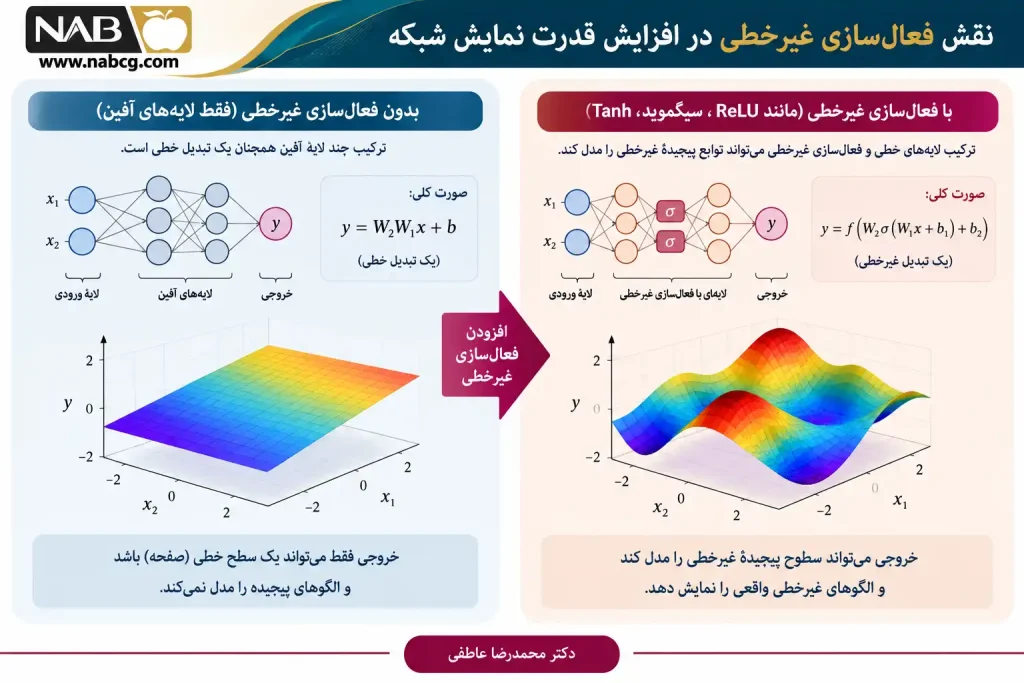
مسئله سوم زمانی ظاهر میشود که چندین نورون را در لایههای متوالی ترکیب کنیم. اگر تمام لایهها فقط تبدیلهای آفین انجام دهند، ترکیب آنها نیز یک تبدیل آفین خواهد بود. در نتیجه، صرف افزایش تعداد لایهها، بدون افزودن سازوکارهای مناسب، امکان نمایش روابط غیرخطی عمومی را فراهم نمیکند (Goodfellow et al., 2016; Prince, 2023).
برای رفع این محدودیتها، در بسیاری از معماریهای شبکه عصبی از تابع فعالسازی (Activation Function) استفاده میشود.
تابع فعالسازی مشخص میکند مقدار پیشفعالسازی چگونه به خروجی نورون تبدیل شود. انتخاب این تابع میتواند دامنه خروجی، پیوستگی، رفتار آستانهای و ظرفیت نمایش غیرخطی مدل را تحت تأثیر قرار دهد.
بااینحال، یک نکته باید از ابتدا روشن باشد: هیچ تابع فعالسازی واحدی برای تمام مسائل بهترین انتخاب نیست. مناسب بودن یک تابع به وظیفه مدل، ساختار شبکه و روش آموزش وابسته است.
در این بخش، پنج تابع مهم را از پایه بررسی میکنیم: همانی، پلهای، سیگموید، تانژانت هیپربولیک و ReLU. برای هر تابع، ابتدا مسئلهای که میتواند حل کند را توضیح میدهیم، سپس تعریف ریاضی، رفتار عددی، محدودیتها و پیادهسازی پایتونی آن را بررسی میکنیم.
1. تابع فعالسازی دقیقاً چه کاری انجام میدهد؟
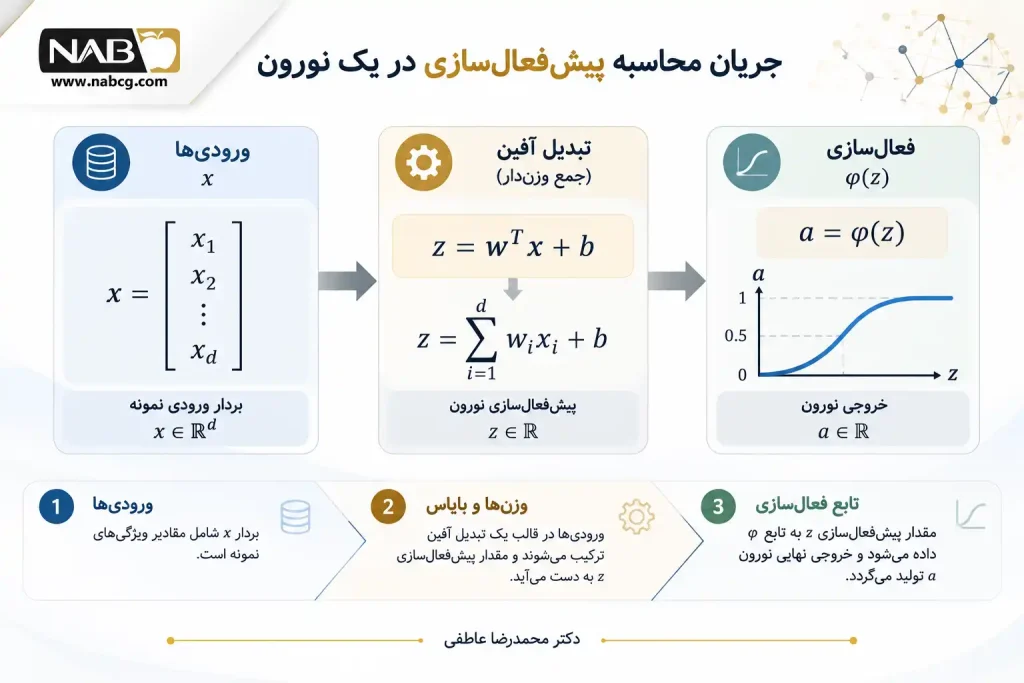
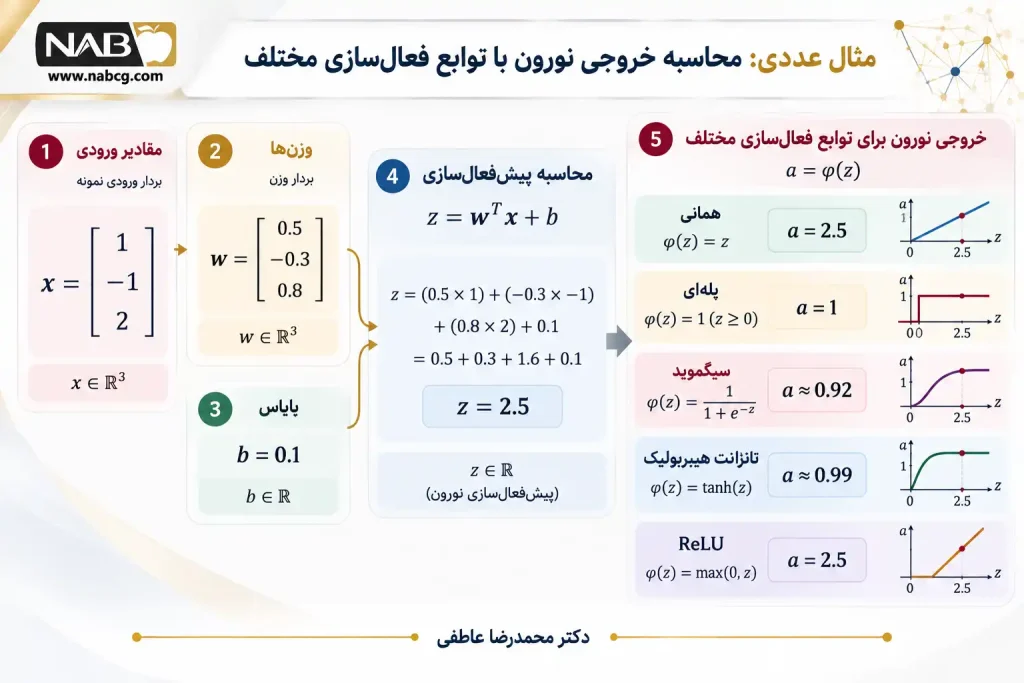
در یک نورون پایه، ابتدا مقدار پیشفعالسازی (z) محاسبه میشود. سپس این مقدار به تابعی با نماد (φ) ارائه میشود و خروجی نهایی نورون تولید میشود.
با جایگذاری رابطه پیشفعالسازی، ساختار کامل نورون چنین خواهد شد:
در معادلات ۱.۱ و ۱.۲، 𝐱 ∈ ℝ^d بردار ورودی، 𝐰 ∈ ℝ^d بردار وزن، b ∈ ℝ بایاس و z ∈ ℝ مقدار پیشفعالسازی است. نماد a خروجی نورون پس از اعمال تابع φ را نشان میدهد.
در این فصل، توابع فعالسازی را بهصورت نگاشت اسکالر به اسکالر مطالعه میکنیم. دامنه و برد دقیق تابع به نوع فعالسازی بستگی دارد.
برای مثال، اگر مقدار پیشفعالسازی برابر ۲ باشد، تابع همانی مقدار ۲، تابع پلهای تعریفشده با آستانه صفر مقدار ۱، تابع سیگموید مقداری نزدیک ۰٫۸۸ و تابع ReLU مقدار ۲ تولید میکند.
پس یک مقدار پیشفعالسازی ثابت، بسته به نوع تابع فعالسازی، میتواند به خروجیهای متفاوتی تبدیل شود.
1.۱. تمایز سه مرحله در مسیر محاسبات نورون
برای فهم درست عملکرد نورون، باید سه مفهوم را از یکدیگر جدا کنیم.
نخست، ورودیها مقادیری هستند که اطلاعات نمونه را نمایش میدهند. دوم، وزنها و بایاس این مقادیر را در قالب یک تبدیل آفین ترکیب میکنند. سوم، تابع فعالسازی نتیجه این تبدیل را به خروجی نهایی تبدیل میکند.
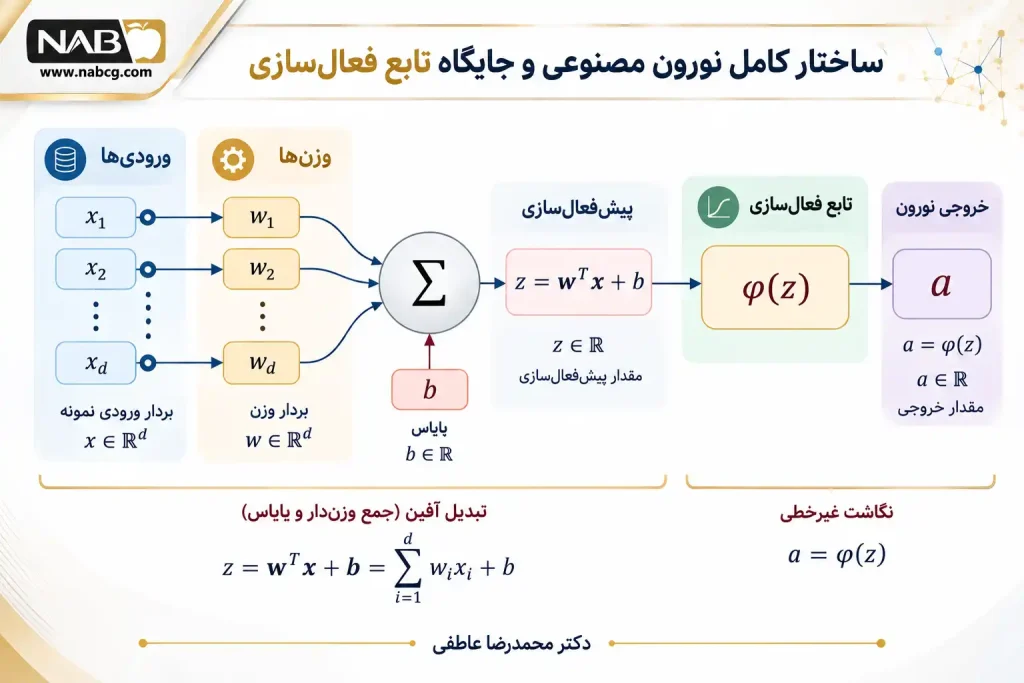
شکل 1.۱ نشان میدهد که تابع فعالسازی پس از محاسبه پیشفعالسازی قرار میگیرد. در نتیجه، تغییر تابع فعالسازی الزاماً به تغییر وزنها و بایاس نیاز ندارد؛ هرچند در یک مدل آموزشدیده، تغییر تابع فعالسازی میتواند ضرورت آموزش مجدد پارامترها را ایجاد کند.
1.۲. آیا تابع فعالسازی همیشه باید غیرخطی باشد؟
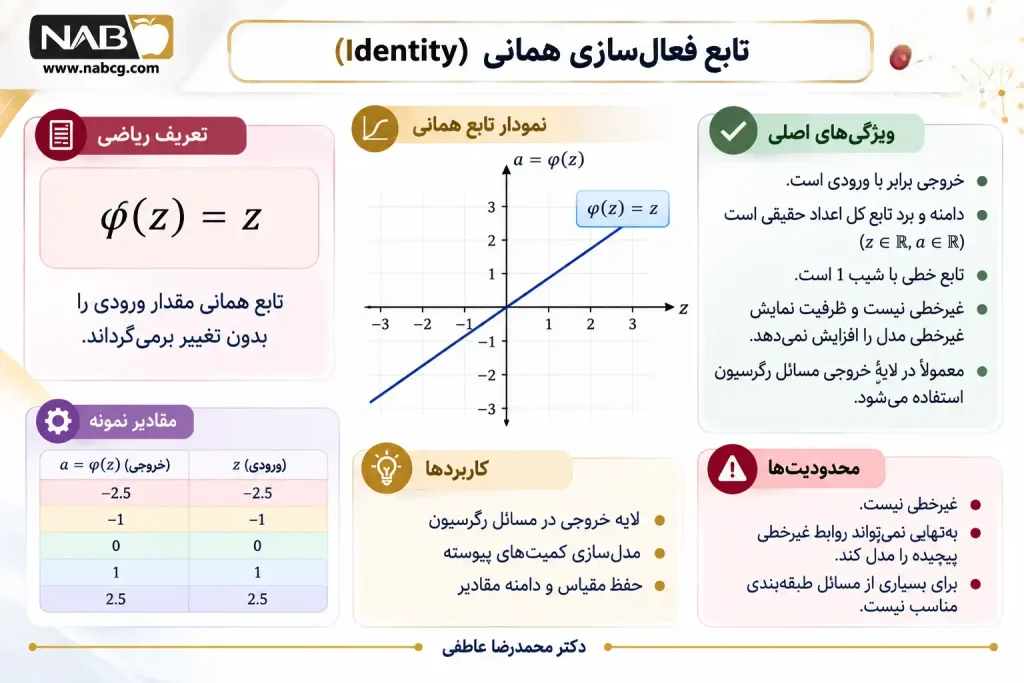
خیر. تابع همانی که خروجی آن برابر ورودی است، یک تابع فعالسازی خطی محسوب میشود.
همچنین بسته به مسئله، ممکن است یک لایه خروجی عملاً فعالسازی همانی داشته باشد. برای مثال، در بعضی مدلهای رگرسیون که خروجی یک مقدار حقیقی نامحدود است، این انتخاب مناسب خواهد بود.
اما برای افزایش قدرت نمایش غیرخطی در شبکههای متوالی، استفاده از فعالسازی غیرخطی میان تبدیلهای آفین اهمیت اساسی دارد.
پس باید میان دو هدف تفاوت قائل شویم: تبدیل مقدار پیشفعالسازی به شکل خروجی موردنظر و ایجاد قابلیت نمایش روابط غیرخطی در یک شبکه.
این دو هدف همیشه یکسان نیستند.
۲. تابع همانی: وقتی خروجی خام مناسب است
سادهترین تابع فعالسازی، تابع همانی (Identity Function) است.
این تابع مقدار ورودی را بدون تغییر برمیگرداند:
در نتیجه، اگر تابع همانی برای نورون انتخاب شود، خروجی نهایی برابر مقدار پیشفعالسازی خواهد بود:
این ساختار معادل یک نگاشت آفین است.
۲.۱. مثال عددی
فرض کنید یک نورون دارای دو ورودی و پارامترهای زیر باشد:
مقدار پیشفعالسازی برابر است با:
چون تابع فعالسازی همانی است:
بنابراین، خروجی نورون هیچ تفاوتی با مقدار پیشفعالسازی ندارد.
این رفتار در مسائلی مفید است که خروجی مدل باید یک مقدار پیوسته حقیقی باشد و محدود کردن آن به بازهای مشخص، بخشی از تعریف مسئله نباشد.
برای مثال، در یک مدل ساده برآورد هزینه، ممکن است خروجی خام عددی پیوسته باشد. البته اگر کمیت موردنظر ذاتاً نامنفی باشد، استفاده مستقیم از خروجی نامحدود ممکن است نیازمند بررسی و طراحی مناسبتری باشد.
۲.۲. محدودیت تابع همانی در شبکههای چندلایه
اگر دو لایه آفین بهصورت متوالی به یکدیگر متصل شوند و بین آنها فقط تابع همانی قرار گیرد، ترکیب حاصل همچنان آفین خواهد بود.
برای نمایش این موضوع، فرض کنید لایه نخست چنین محاسبه کند:
و لایه دوم خروجی آن را دریافت کند:
با جایگذاری رابطه نخست در رابطه دوم:
با باز کردن پرانتز:
اگر ماتریس جدید را W = W₂W₁ و بایاس جدید را 𝐛 = W₂𝐛₁ + 𝐛₂ تعریف کنیم، رابطه نهایی چنین میشود:
بنابراین، دو لایه آفین متوالی بدون فعالسازی غیرخطی را میتوان از نظر تابع ورودی–خروجی به یک لایه آفین معادل تبدیل کرد، مشروط بر آنکه ابعاد ماتریسها سازگار باشند.
این نتیجه، یک دلیل ریاضی روشن برای اهمیت توابع فعالسازی غیرخطی در شبکههای عصبی چندلایه فراهم میکند (Goodfellow et al., 2016).
در این مرحله نیازی نیست معماری چندلایه را بهصورت کامل مطالعه کنیم؛ هدف فقط درک این واقعیت است که افزایش تعداد مراحل محاسبه، بدون تغییر ماهیت روابط، الزاماً قدرت نمایش غیرخطی ایجاد نمیکند.
۳. تابع پلهای: چگونه یک عدد به تصمیم دودویی تبدیل میشود؟
در بسیاری از مسائل، خروجی موردنظر فقط دو وضعیت دارد. برای مثال، میخواهیم مشخص کنیم یک شرط برقرار است یا برقرار نیست، یک قطعه در گروه اول قرار میگیرد یا گروه دوم، یا مقدار یک متغیر از آستانه تعیینشده عبور کرده است یا خیر.
برای چنین خروجیهایی، میتوان از تابع پلهای (Step Function) استفاده کرد.
در قرارداد این کتاب، تابع پلهای دودویی به شکل زیر تعریف میشود:
این تابع، تمام مقادیر منفی را به صفر و تمام مقادیر غیرمنفی را به یک تبدیل میکند.
انتخاب خروجی یک برای (z=0) بخشی از قرارداد این کتاب است. در برخی منابع ممکن است مقدار تابع در صفر به شکل دیگری تعریف شود؛ بنابراین، هنگام مطالعه یا پیادهسازی یک الگوریتم باید قرارداد نقطه آستانه مشخص باشد.
۳.۱. مثال عددی
فرض کنید سه نمونه با مقدار پیشفعالسازی زیر در اختیار داریم:
پس از اعمال تابع پلهای:
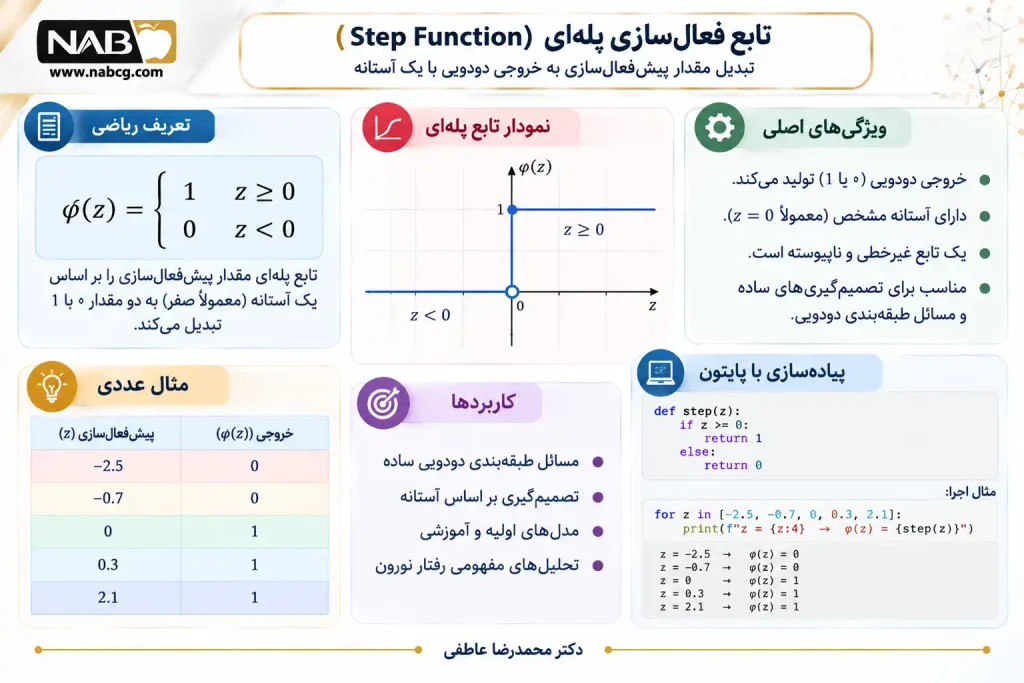
شکل 1.۲ — نمودار تابع پلهای دودویی با آستانه صفر. دایره توخالی در خروجی صفر و دایره پر در خروجی یک، قرارداد مقدار تابع در نقطه (z=0) را نشان میدهند.
تابع پلهای یک تغییر ناگهانی در خروجی ایجاد میکند. برای مثال، دو مقدار بسیار نزدیک به صفر، مانند ۰٫۰۰۰۱− و ۰٫۰۰۰۱، به خروجیهای متفاوت صفر و یک تبدیل میشوند.
این ویژگی میتواند برای تصمیمگیری آستانهای مناسب باشد، اما پیامدهایی نیز دارد.
نخست، خروجی تابع پلهای اطلاعات مربوط به اندازه مقدار پیشفعالسازی را حفظ نمیکند. برای نمونه، مقدارهای ۰٫۱ و ۱۰۰ هر دو به خروجی یک تبدیل میشوند.
دوم، تغییرات کوچک ورودی در نزدیکی آستانه میتواند خروجی را بهصورت ناگهانی تغییر دهد.
سوم، تابع پلهای در نقطه صفر ناپیوسته است و مشتق معمولی آن در این نقطه تعریف نمیشود. همچنین در سایر نقاط مشتق آن صفر است. این موضوع استفاده مستقیم از آن را در روشهای متداول آموزش مبتنی بر گرادیان دشوار میکند.
تحلیل مشتق و پسانتشار در فصلهای مربوط به آموزش شبکههای چندلایه ارائه خواهد شد؛ در این مرحله کافی است تفاوت تابع پلهای با توابع پیوسته را درک کنیم.
۳.۲. پیادهسازی تابع پلهای
def step(z):
    if z >= 0:
        return 1
    return 0

values = [-2.5, -0.1, 0.0, 0.1, 2.5]

for z in values:
    print(f"z={z:5.1f}, output={step(z)}")
خروجی:
z= -2.5, output=0
z= -0.1, output=0
z=  0.0, output=1
z=  0.1, output=1
z=  2.5, output=1
این پیادهسازی برای ورودیهای اسکالر مناسب است. اگر بخواهیم تابع را بهصورت یکجا روی آرایهای از نمونهها اعمال کنیم، میتوانیم از NumPy استفاده کنیم:
import numpy as np

def step_numpy(z):
    z = np.asarray(z, dtype=float)
    return (z >= 0).astype(int)

z = np.array([-2.5, -0.1, 0.0, 0.1, 2.5])

print(step_numpy(z))
خروجی:
[0 0 1 1 1]در این نسخه، مقایسه z >= 0 ابتدا آرایهای از مقادیر منطقی تولید میکند. سپس astype(int) مقادیر True را به یک و False را به صفر تبدیل میکند.
در این پیادهسازی، فرض بر معتبر و متناهی بودن ورودیهاست؛ نسخه نهایی نورون باید بررسی دادههای نامعتبر را نیز انجام دهد.
۴. تابع سیگموید: تبدیل مقادیر حقیقی به بازه صفر و یک
تابع پلهای خروجی دودویی تولید میکند، اما این خروجی ناگهانی است و اطلاعات مربوط به فاصله مقدار پیشفعالسازی از آستانه را از بین میبرد.
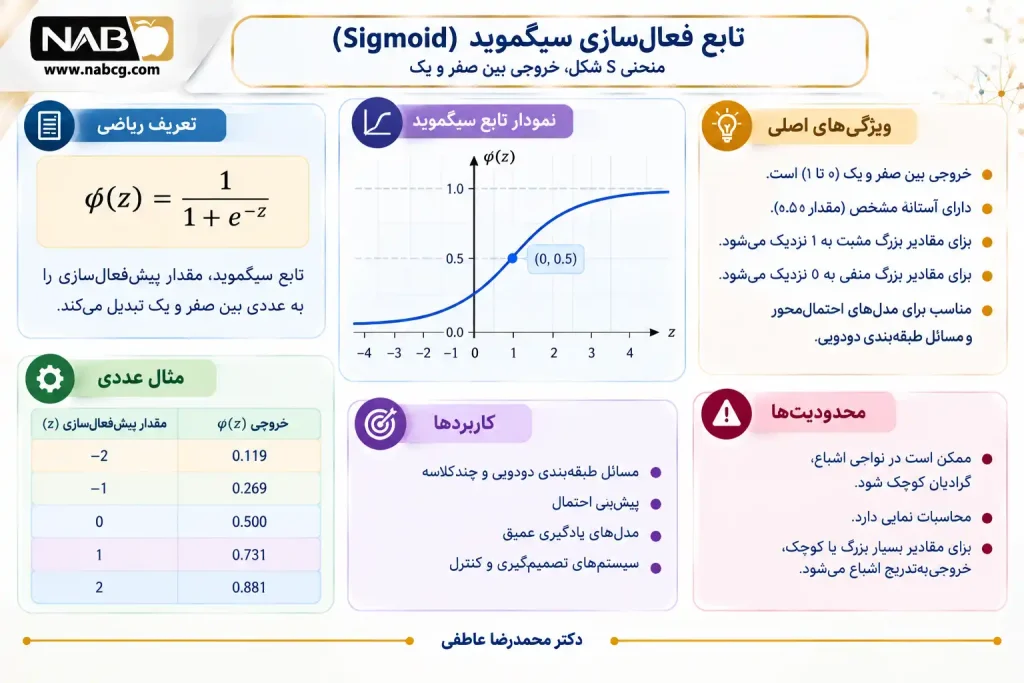
اگر بخواهیم خروجی تابع بهصورت پیوسته تغییر کند و همواره در بازه صفر و یک قرار گیرد، یکی از گزینههای شناختهشده، تابع سیگموید لجستیک (Logistic Sigmoid) است.
این تابع به شکل زیر تعریف میشود:
در معادله 1.۵، (e) عدد نپر، پایه لگاریتم طبیعی، و (z) یک عدد حقیقی است.
برای هر مقدار حقیقی و متناهی (z)، خروجی تابع سیگموید بهطور دقیق بین صفر و یک قرار میگیرد:
مقدار تابع در صفر برابر ۰٫۵ است:
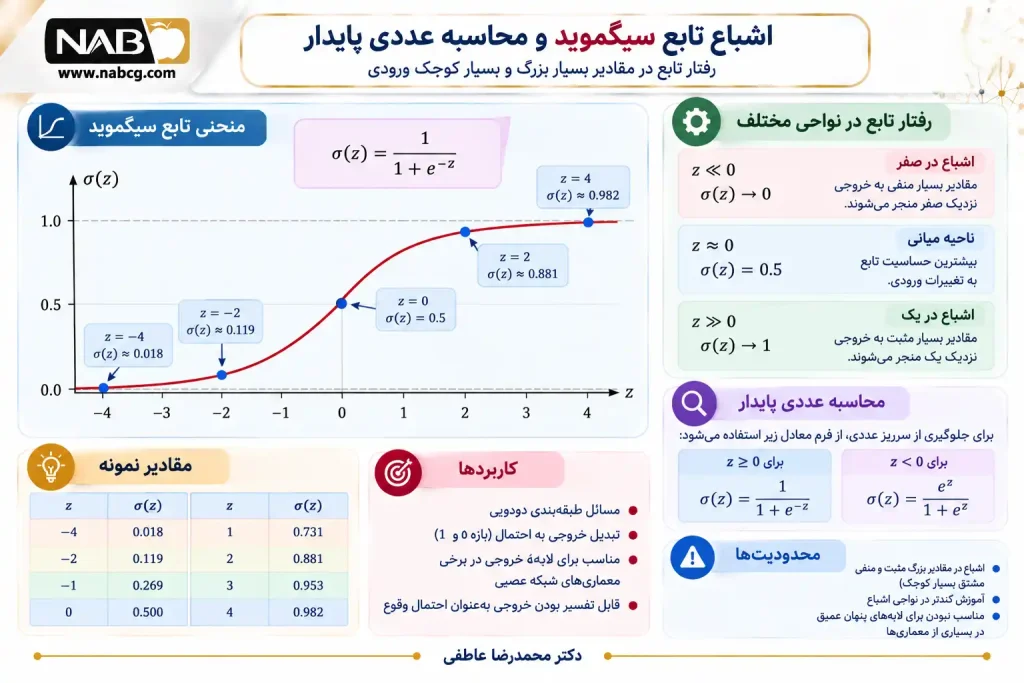
هرچه مقدار (z) بزرگتر شود، خروجی به یک نزدیکتر میشود. هرچه (z) منفیتر شود، خروجی به صفر نزدیکتر خواهد شد.
اما تابع برای هیچ ورودی حقیقی متناهی، دقیقاً صفر یا یک تولید نمیکند؛ این دو مقدار حدهای تابع هستند.
۴.۱. محاسبه دستی سیگموید
برای (z=2) داریم:
با تقریب e^(−۲) ≈ ۰٫۱۳۵۳، خواهیم داشت:
برای (z=-2):
و برای (z=0)، خروجی دقیقاً ۰٫۵ است.
| مقدار (z) | خروجی تقریبی سیگموید |
| ۶− | ۰٫۰۰۲۵ |
| ۳− | ۰٫۰۴1۴ |
| ۱− | ۰٫۲۶۸۹ |
| ۰ | ۰٫۵۰۰۰ |
| ۱ | ۰٫1۳۱۱ |
| ۳ | ۰٫۹۵۲۶ |
| ۶ | ۰٫۹۹1۵ |
جدول 1.۱ نشان میدهد که سیگموید برخلاف تابع پلهای، تغییرات خروجی را به شکل پیوسته انجام میدهد. همچنین میتوان دید که برای مقادیر بزرگ مثبت یا منفی، تغییرات تابع کندتر میشود.
۴.۲. آیا خروجی سیگموید همیشه احتمال است؟
یکی از خطاهای رایج این است که هر خروجی بین صفر و یک را بهصورت خودکار «احتمال» تفسیر کنیم.
تابع سیگموید بهتنهایی فقط یک نگاشت ریاضی از اعداد حقیقی به بازه صفر و یک است. اگر این تابع در یک مدل طبقهبندی احتمالاتی مناسب استفاده شود و مدل بر اساس هدف و داده مناسب آموزش ببیند، میتوان خروجی را در چارچوب آن مدل بهعنوان برآورد احتمال تفسیر کرد.
اما صرف اعمال سیگموید به یک عدد، اعتبار احتمالاتی یا کالیبراسیون خروجی را تضمین نمیکند (Bishop, 2006; Murphy, 2022).
برای مثال، اگر وزنها و بایاس یک نورون را بهصورت دلخواه انتخاب کنیم و سیگموید خروجی ۰٫۹ تولید کند، حق نداریم بدون تعریف و اعتبارسنجی مدل ادعا کنیم که احتمال وقوع رویداد دقیقاً ۹۰ درصد است.
در این فصل، خروجی سیگموید را در درجه نخست یک مقدار عددی پیوسته و محدود میدانیم. تفسیر احتمالاتی آن در فصلهای طبقهبندی و ارزیابی مدل بررسی خواهد شد.
۴.۳. پیادهسازی عددی پایدار سیگموید
فرمول ریاضی سیگموید ساده است، اما پیادهسازی مستقیم آن میتواند برای بعضی ورودیهای بسیار منفی با مسئله سرریز در تابع نمایی روبهرو شود.
برای مثال، محاسبه (e^(−z)) هنگامی که (z) عدد منفی بسیار بزرگی باشد، ممکن است از دامنه قابل نمایش نوع داده فراتر رود.
سپس برای کاهش این مشکل، میتوان سیگموید را به شکل قطعهای و از نظر جبری معادل پیادهسازی کرد:
برای شاخه منفی، صورت و مخرج رابطه اصلی در (e^z) ضرب شدهاند؛ بنابراین، دو فرم از نظر جبری معادل هستند.
پیادهسازی پایتون:
import math

def sigmoid(z):
    z = float(z)

    if not math.isfinite(z):
        raise ValueError("Input must be finite.")

    if z >= 0:
        return 1.0 / (1.0 + math.exp(-z))

    exp_z = math.exp(z)
    return exp_z / (1.0 + exp_z)

for z in [-1000, -3, 0, 3, 1000]:
    print(z, sigmoid(z))
در این برنامه، حتی برای ورودیهای بسیار بزرگ از نظر قدرمطلق، از شکل مناسب محاسبه استفاده میشود تا نیاز به محاسبه نمایی بسیار بزرگ کاهش یابد.
البته در حساب ممیز شناور، خروجی برای مقادیر بسیار بزرگ ممکن است دقیقاً به صفر یا یک گرد شود. این رفتار عددی را باید از برد ریاضی تابع برای ورودیهای متناهی متمایز کرد.
۵. تابع تانژانت هیپربولیک: خروجی پیوسته با مقادیر مثبت و منفی
تابع سیگموید، مقدار پیشفعالسازی را به خروجیای در بازه صفر و یک تبدیل میکند. این ویژگی برای برخی کاربردها مطلوب است، اما گاهی لازم است خروجی نورون هم مقادیر مثبت و هم مقادیر منفی داشته باشد.
فرض کنید میخواهیم خروجی یک نورون، جهت و شدت یک اثر را نشان دهد. مقدار مثبت میتواند بیانگر اثر افزایشی و مقدار منفی نشاندهنده اثر کاهشی باشد. اگر تابع فعالسازی تنها خروجیهای مثبت تولید کند، این نمایش مستقیم ممکن نخواهد بود.
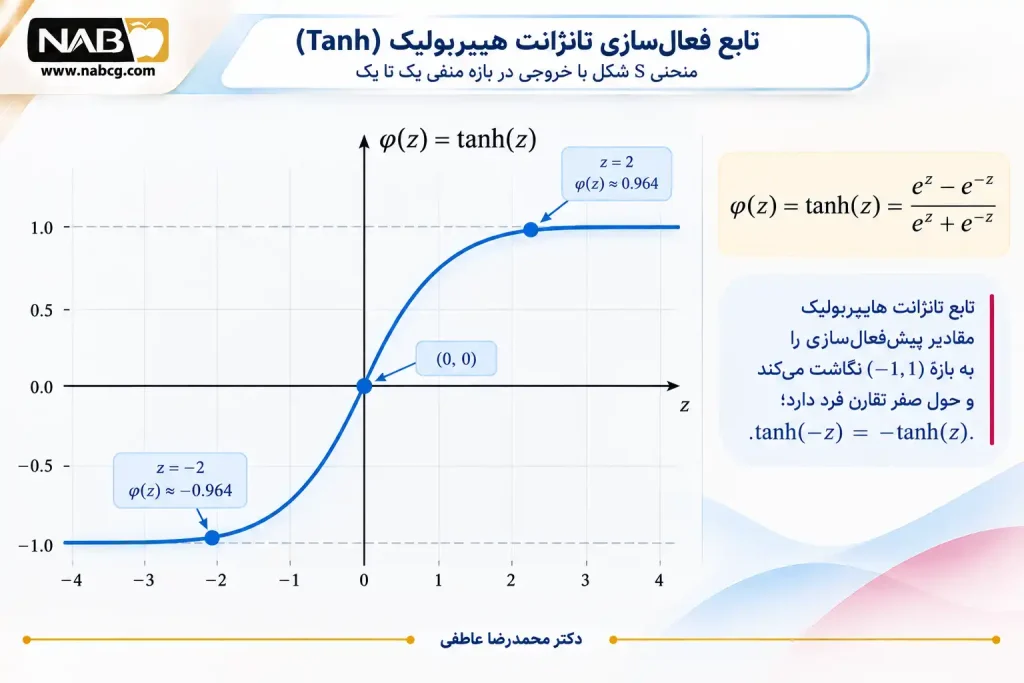
یکی از توابعی که چنین امکانی فراهم میکند، تانژانت هیپربولیک (Hyperbolic Tangent) یا بهاختصار Tanh است.
این تابع به شکل زیر تعریف میشود:
تابع Tanh برای هر ورودی حقیقی متناهی، خروجیای بین منفی یک و مثبت یک تولید میکند:
همچنین:
این ویژگی، یکی از تفاوتهای اساسی Tanh با سیگموید است. در سیگموید، ورودی صفر به خروجی ۰٫۵ تبدیل میشود؛ درحالیکه خروجی Tanh برای همان ورودی برابر صفر است.
۵.۱. تقارن نسبت به مبدأ
تابع Tanh یک تابع فرد (Odd Function) است. به این معنا که:
در معادله 1.۸، مقدار ورودی از (z) به (-z) تغییر میکند و خروجی نیز قرینه میشود. این خاصیت نشان میدهد نمودار تابع نسبت به مبدأ مختصات تقارن دارد.
برای مثال، اگر:
آنگاه:
این تقارن، امکان نمایش خروجیهای مثبت و منفی را با رفتاری متوازن از نظر ریاضی فراهم میکند.
۵.۲. محاسبه مقادیر Tanh
| مقدار (z) | مقدار تقریبی Tanh |
| ۴− | ۰٫۹۹۹۳− |
| ۲− | ۰٫۹۶۴۰− |
| ۱− | ۰٫1۶۱۶− |
| ۰ | ۰ |
| ۱ | ۰٫1۶۱۶ |
| ۲ | ۰٫۹۶۴۰ |
| ۴ | ۰٫۹۹۹۳ |
جدول 1.۲ — مقادیر تابع تانژانت هیپربولیک برای چند ورودی منتخب
با بررسی جدول 1.۲، میتوان مشاهده کرد که Tanh در نزدیکی صفر به تغییرات ورودی پاسخ محسوسی میدهد، اما با بزرگ شدن قدرمطلق ورودی، خروجی به یکی از دو حد منفی یک یا مثبت یک نزدیک میشود.
این رفتار را اشباع (Saturation) مینامند.
اشباع به معنای آن است که با افزایش بیشتر قدرمطلق ورودی، مقدار خروجی به حدی نزدیک میشود و تغییرات آن کوچکتر میشود.
در شبکههای عصبی چندلایه، اشباع برخی توابع فعالسازی میتواند بر جریان گرادیان و فرایند آموزش اثر بگذارد. این مسئله در بخشهای مربوط به مشتق و پسانتشار بررسی خواهد شد. در اینجا، هدف صرفاً شناخت رفتار عددی تابع است.
۵.۳. رابطه میان سیگموید و Tanh
سیگموید و Tanh دو تابع مستقل و بیارتباط نیستند؛ میان آنها رابطه ریاضی مشخصی وجود دارد:
برای بررسی رابطه 1.۹، از تعریف سیگموید استفاده میکنیم:
با یکسان کردن مخرج:
اگر صورت و مخرج را در (e^z) ضرب کنیم:
بنابراین، دو تابع از نظر جبری با یکدیگر مرتبطاند.
این رابطه توضیح میدهد چرا نمودارهای آنها از نظر شکل کلی شباهت دارند، اما دامنه خروجی و مقدارشان در صفر متفاوت است.
۵.۴. پیادهسازی Tanh در پایتون
import math

def tanh_activation(z):
    z = float(z)

    if not math.isfinite(z):
        raise ValueError("Input must be finite.")

    return math.tanh(z)

values = [-4, -2, -1, 0, 1, 2, 4]

for z in values:
    print(f"z={z:3}, tanh={tanh_activation(z):.4f}")
در این پیادهسازی از math.tanh استفاده شده است. مزیت آن، کاهش نیاز به بازنویسی مستقیم عبارتهای نمایی است که میتوانند برای ورودیهای بزرگ از نظر عددی نامناسب باشند.
هنگام استفاده از NumPy نیز میتوان تابع را بهصورت برداری اعمال کرد:
import numpy as np

z = np.array([-4, -2, -1, 0, 1, 2, 4],
             dtype=float)

a = np.tanh(z)

print(np.round(a, 4))
در هر دو پیادهسازی، محاسبه تابع فعالسازی مستقل از وزنها و بایاس انجام شده است. در مرحله ساخت نورون کامل، خروجی بخش آفین به این تابع ارائه خواهد شد.
۶. تابع: ReLU حفظ مقادیر مثبت و حذف مقادیر منفی
سه تابعی که تا اینجا بررسی کردیم، رفتارهای متفاوتی دارند. تابع پلهای خروجی دودویی تولید میکند؛ سیگموید یک مقدار پیوسته بین صفر و یک میسازد؛ و Tanh مقادیر پیوسته بین منفی یک و مثبت یک تولید میکند.
اکنون تابعی را بررسی میکنیم که در بسیاری از معماریهای شبکه عصبی عمیق اهمیت زیادی پیدا کرده است: واحد خطی یکسوشده (Rectified Linear Unit) که با نام ReLU شناخته میشود.
تابع ReLU به شکل زیر تعریف میشود:
این رابطه را میتوان بهصورت قطعهای نیز نوشت:
بنابراین، ReLU تمام مقادیر منفی را به صفر تبدیل میکند و مقادیر مثبت را بدون تغییر نگه میدارد.
برخلاف سیگموید و Tanh، خروجی ReLU از بالا محدود نیست. برای مثال، اگر ورودی آن ۱۰۰ باشد، خروجی نیز ۱۰۰ خواهد بود.
۶.۱. مثال عددی
| پیشفعالسازی (z) | خروجی ReLU |
| ۵− | ۰ |
| ۱− | ۰ |
| ۰ | ۰ |
| ۰٫۵ | ۰٫۵ |
| ۲ | ۲ |
| ۱۰ | ۱۰ |
جدول 1.۳ — رفتار تابع ReLU برای ورودیهای منفی، صفر و مثبت
یکی از ویژگیهای قابل مشاهده ReLU آن است که در نیممحور مثبت، تابع همانی است؛ اما در نیممحور منفی، خروجی ثابت صفر تولید میکند.
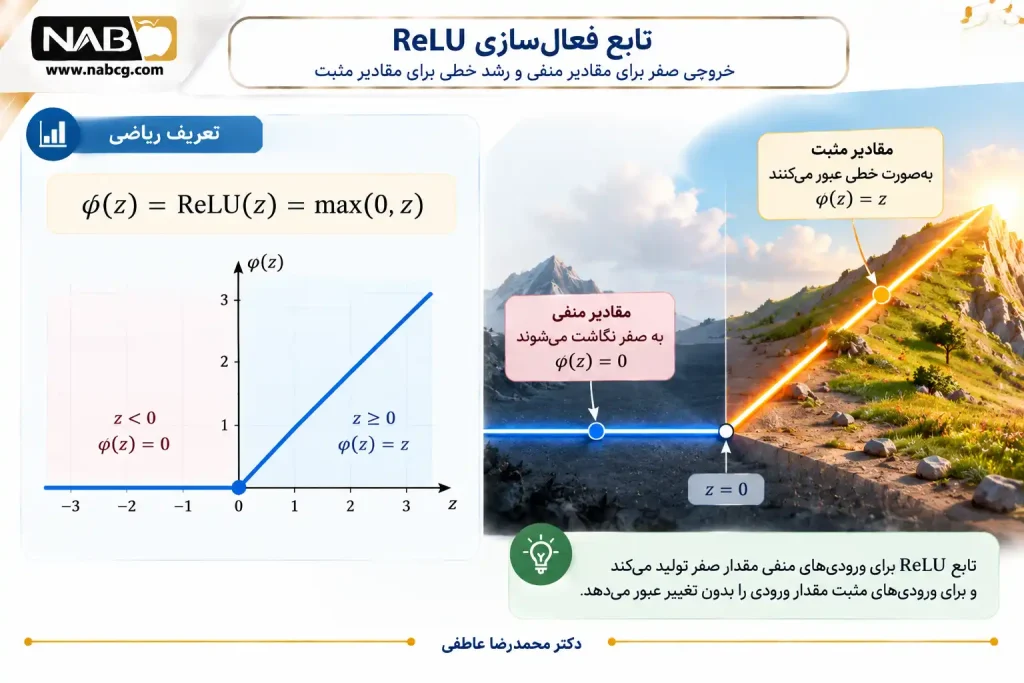
شکل 1.۳ — نمودار تابع ReLU. برای ورودیهای منفی خروجی صفر است و برای ورودیهای مثبت، خروجی برابر مقدار ورودی خواهد بود. نمودار اختصاصی آموزشی است.
تابع ReLU در نقطه صفر پیوسته است، اما مشتق معمولی آن در این نقطه تعریف نمیشود. این وضعیت با تابع پلهای تفاوت دارد؛ زیرا تابع پلهای در آستانه خود ناپیوسته است.
برای بسیاری از روشهای آموزش مبتنی بر گرادیان، مشتق ReLU در نواحی منفی و مثبت رفتار سادهای دارد. این ویژگی، در کنار عوامل دیگری، از دلایل کاربرد گسترده آن در شبکههای عمیق بوده است (Nair & Hinton, 2010; Glorot et al., 2011).
بااینحال، ReLU نیز محدودیتهایی دارد. هنگامی که پیشفعالسازی یک نورون برای همه نمونههای مورد بررسی منفی باشد، خروجی آن نورون صفر خواهد بود. در آموزش مبتنی بر گرادیان، این وضعیت در برخی شرایط میتواند موجب کاهش یا توقف بهروزرسانی پارامترهای مرتبط شود؛ پدیدهای که در ادبیات شبکههای عصبی با عنوان مسئله ReLU غیرفعال یا Dying ReLU شناخته میشود.
توضیح کامل علت این پدیده به شناخت گرادیان و الگوریتم بهینهسازی نیاز دارد و در فصلهای آموزش شبکهها بررسی خواهد شد.
۶.۲. پیادهسازی ReLU
def relu(z):
    return max(0.0, float(z))

values = [-5, -1, 0, 0.5, 2, 10]

for z in values:
    print(f"{z:5} -> {relu(z)}")
برای محاسبه برداری:
import numpy as np

def relu_numpy(z):
    z = np.asarray(z, dtype=float)
    return np.maximum(0.0, z)

z = np.array([-5, -1, 0, 0.5, 2, 10])

print(relu_numpy(z))
خروجی:
[ 0. 0. 0. 0.5 2. 10. ]در این کد، np.maximum هر عنصر را با صفر مقایسه و مقدار بزرگتر را انتخاب میکند.
نکته مهم آن است که ReLU با تابع پلهای تفاوت اساسی دارد. تابع پلهای همه ورودیهای غیرمنفی را به یک تبدیل میکند، اما ReLU مقادیر مثبت را حفظ میکند. بنابراین، خروجی ReLU معمولاً دودویی نیست.
7. مقایسه پنج تابع فعالسازی از نظر رفتار ریاضی
اکنون که پنج تابع را بهصورت جداگانه بررسی کردیم، میتوانیم ویژگیهای آنها را در یک چارچوب مشترک مقایسه کنیم.
| تابع | برد ریاضی | پیوستگی | غیرخطی؟ | رفتار ورودی منفی |
| همانی | ℝ | پیوسته | خیر | بدون تغییر |
| پلهای | ({0,1}) | ناپیوسته در صفر | بله | صفر |
| سیگموید | ((0,1)) | پیوسته | بله | عددی بین صفر و ۰٫۵ |
| Tanh | ((-1,1)) | پیوسته | بله | عددی بین ۱− و صفر |
| ReLU | [۰، ∞) | پیوسته | بله | صفر |
جدول 1.۴ — مقایسه ریاضی پنج تابع فعالسازی پایه، بر اساس قراردادهای معرفیشده در این فصل
تفسیر جدول 1.۴: نخستین نکته آن است که غیرخطی بودن لزوماً به معنای خروجی محدود نیست. برای مثال، ReLU غیرخطی است، اما خروجی آن از بالا کران ندارد.
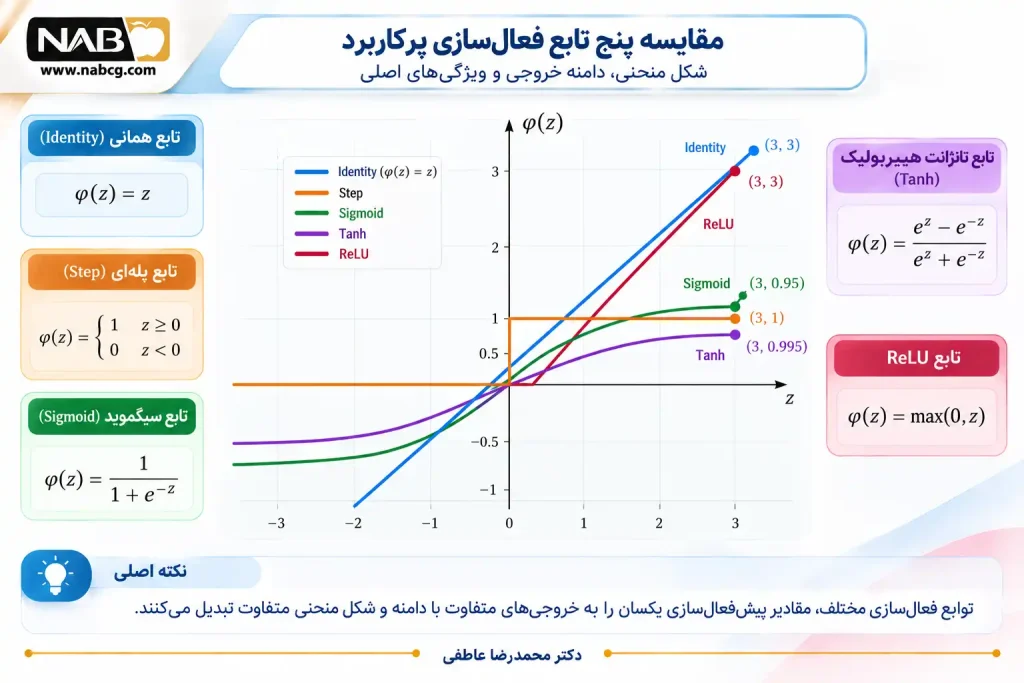
دوم اینکه پیوستگی نیز با خطی بودن یکسان نیست. سیگموید، Tanh و ReLU هر سه پیوسته هستند، اما هیچکدام یک تابع خطی سراسری به معنای جبر خطی نیستند.
سوم اینکه انتخاب تابع باید متناسب با هدف خروجی باشد. برای یک تصمیم آستانهای ساده، تابع پلهای قابل فهم است. سپس برای خروجی پیوسته محدود، سیگموید یا Tanh ممکن است مناسب باشند. برای بعضی لایههای پنهان شبکههای عمیق، ReLU انتخاب رایجی است.
اما نباید این نمونهها را به قانون قطعی انتخاب تابع تبدیل کرد. عملکرد واقعی هر انتخاب به ساختار مدل، داده، تابع هدف و الگوریتم آموزش بستگی دارد.
7.۱. مقایسه خروجی توابع در ورودی یکسان
فرض کنید مقدار پیشفعالسازی یک نورون برابر ۲ باشد. خروجی پنج تابع چنین خواهد بود:
| تابع | خروجی برای (z=2) |
| همانی | ۲ |
| پلهای | ۱ |
| سیگموید | ۰٫۸۸۰۸ |
| Tanh | ۰٫۹۶۴۰ |
| ReLU | ۲ |
جدول 1.۵ — خروجی پنج فعالسازی مختلف برای پیشفعالسازی یکسان
این جدول نشان میدهد که یک نورون با ورودیها، وزنها و بایاس یکسان میتواند صرفاً با تغییر تابع فعالسازی، خروجی متفاوتی تولید کند.
در نتیجه، تابع فعالسازی بخشی از تعریف معماری مدل است؛ نه صرفاً یک مرحله تزئینی پس از محاسبه.
۸. چرا غیرخطی بودن تابع فعالسازی برای طراحی شبکه عصبی اهمیت دارد؟
تا اینجا دیدیم که تابع فعالسازی میتواند دامنه خروجی نورون را تغییر دهد یا رفتار آستانهای ایجاد کند. بااینحال، اهمیت آن در طراحی شبکههای عصبی فراتر از تبدیل یک عدد به عددی دیگر است.
برای درک این موضوع، مسئلهای را در نظر بگیرید که در آن خروجی به رابطهای غیرخطی از ورودی وابسته است. فرض کنید بخواهیم تابع زیر را برای ورودیهای حقیقی نمایش دهیم:
آیا میتوان با یک نورون دارای فعالسازی همانی، این رابطه را برای تمام مقادیر حقیقی (x) بهصورت دقیق نمایش داد؟
چنین نورونی تابعی به شکل (wx+b) تولید میکند. برای آنکه این تابع برای تمام (x) با (x^2) برابر باشد، باید رابطه زیر برقرار شود:
با قرار دادن (x=0)، به دست میآوریم (b=0). با قرار دادن (x=1)، مقدار (w=1) لازم خواهد بود. اما اکنون اگر (x=2) قرار دهیم، سمت چپ برابر ۲ و سمت راست برابر ۴ میشود.
بنابراین، هیچ انتخاب ثابتی از (w) و (b) نمیتواند تابع (x^2) را روی تمام اعداد حقیقی دقیقاً نمایش دهد.
این محدودیت ناشی از آن است که یک تابع آفین، شکل ریاضی مشخصی دارد و نمیتواند هر نوع خمیدگی یا رابطه غیرخطی را بازنمایی کند.
۸.۱. ترکیب چند نورون چه تغییری ایجاد میکند؟
اگر خروجی چند تبدیل آفین را بهصورت متوالی به یکدیگر ارائه کنیم، حاصل همچنان آفین خواهد بود. اما با قرار دادن یک تابع غیرخطی مناسب میان آنها، ممکن است تابع حاصل دیگر به یک تبدیل آفین قابل فروکاست نباشد.
برای مثال، تابع ساده زیر را در نظر بگیرید:
این تابع برای (x ≤ ۱) برابر صفر و برای (x>1) برابر (x-1) است. بنابراین، در نقطه (x=1) رفتار آن تغییر میکند.
هیچ تابع آفین سراسری نمیتواند دقیقاً همین رفتار قطعهای را برای تمام مقادیر حقیقی ایجاد کند.
با ترکیب چند واحد دارای ReLU، میتوان توابع قطعهای خطی پیچیدهتری ساخت. این قابلیت یکی از پایههای قدرت نمایش شبکههای عصبی دارای لایههای پنهان است (Goodfellow et al., 2016; Montúfar et al., 2014).
البته غیرخطی بودن بهتنهایی کافی نیست تا هر معماری دلخواه قادر به نمایش هر تابعی باشد. تعداد نورونها، نحوه اتصال، عمق شبکه و ویژگیهای تابع فعالسازی نیز اهمیت دارند.
در این فصل، هدف اثبات قضایای تقریب توابع نیست؛ بلکه باید دلیل نیاز به غیرخطیسازی در مسیر ساخت شبکه چندلایه روشن شود.
۸.۲. تفاوت قدرت نمایش و توانایی یادگیری
لازم است میان دو موضوع مهم تمایز قائل شویم.
قدرت نمایش (Representational Capacity) به خانواده توابعی مربوط است که یک معماری میتواند با انتخاب مناسب پارامترها تولید کند.
در مقابل، توانایی یادگیری عملی به این موضوع وابسته است که آیا الگوریتم آموزش میتواند با استفاده از دادهها، پارامترهای مناسبی برای مسئله پیدا کند یا خیر.
ممکن است یک معماری از نظر نظری قادر به نمایش تابعی معین باشد، اما آموزش آن در عمل دشوار باشد. همچنین ممکن است یک مدل روی دادههای آموزشی بهخوبی عمل کند، اما روی دادههای جدید عملکرد مطلوبی نداشته باشد.
بنابراین، استفاده از تابع فعالسازی غیرخطی ظرفیت مدل را تغییر میدهد، ولی موفقیت آموزش و تعمیمپذیری را تضمین نمیکند.
این تمایز در فصلهای بعد، هنگام مطالعه شبکههای چندلایه و روشهای بهینهسازی، نقش مهمی خواهد داشت.
۹. آزمایش اول: مشاهده رفتار پنج تابع روی ورودیهای یکسان
اکنون میخواهیم پنج تابع بررسیشده را با استفاده از پایتون رسم کنیم و رفتار آنها را روی یک دامنه مشترک مقایسه کنیم.
پرسش علمی آزمایش: اگر مقدار پیشفعالسازی برای همه توابع یکسان باشد، شکل خروجی، دامنه تغییر و رفتار اطراف صفر چه تفاوتهایی خواهد داشت؟
فرضیه آن است که تابع همانی خروجی نامحدود، پلهای خروجی دودویی، سیگموید و Tanh خروجی محدود، و ReLU خروجی نامنفی تولید میکند.
برای آزمون، دامنه پیشفعالسازی را از ۶− تا ۶ در نظر میگیریم و ۶۰۱ نقطه با فاصله مساوی تولید میکنیم.
import numpy as np
import matplotlib.pyplot as plt

z = np.linspace(-6, 6, 601)

identity = z
step = (z >= 0).astype(float)

sigmoid = np.empty_like(z)
positive = z >= 0

sigmoid[positive] = 1 / (
    1 + np.exp(-z[positive])
)

exp_z = np.exp(z[~positive])
sigmoid[~positive] = exp_z / (1 + exp_z)

tanh = np.tanh(z)
relu = np.maximum(0, z)

activations = {
    "Identity": identity,
    "Step": step,
    "Sigmoid": sigmoid,
    "Tanh": tanh,
    "ReLU": relu
}

plt.figure(figsize=(10, 6))

for name, values in activations.items():
    plt.plot(z, values, label=name)

plt.axhline(0, linewidth=0.8)
plt.axvline(0, linewidth=0.8)
plt.xlabel("Pre-activation z")
plt.ylabel("Activation output")
plt.title("Comparison of Activation Functions")
plt.legend()
plt.grid(alpha=0.25)
plt.show()
متغیرهای کنترلشده: دامنه ورودی و نقاط نمونهبرداری برای تمام توابع یکساناند. هیچ وزن یا بایاسی در جریان آزمایش تغییر نمیکند، زیرا فقط تبدیل (z) به خروجی بررسی میشود.
متغیر مورد مقایسه: نوع تابع فعالسازی است.
معیار مشاهده: مقدار خروجی، برد تابع، وجود ناپیوستگی و شکل تغییرات در نزدیکی صفر.
انتظار داریم نمودار پلهای جهشی ناگهانی در صفر داشته باشد. سیگموید و Tanh دارای منحنیهای نرم و محدود خواهند بود. تابع همانی یک خط مستقیم و ReLU یک تابع قطعهای با شکست در صفر تولید خواهد کرد.
بااینحال، صرف مشاهده نمودار نمیتواند نشان دهد کدام تابع برای یک مسئله یادگیری مشخص بهترین عملکرد را خواهد داشت. برای چنین نتیجهگیریای باید مدل، داده، تابع هدف و شرایط آموزش تعریف و عملکرد آنها با روش تجربی مناسب مقایسه شود.
۱۰. آزمایش دوم: بررسی تغییر خروجی در نزدیکی آستانه صفر
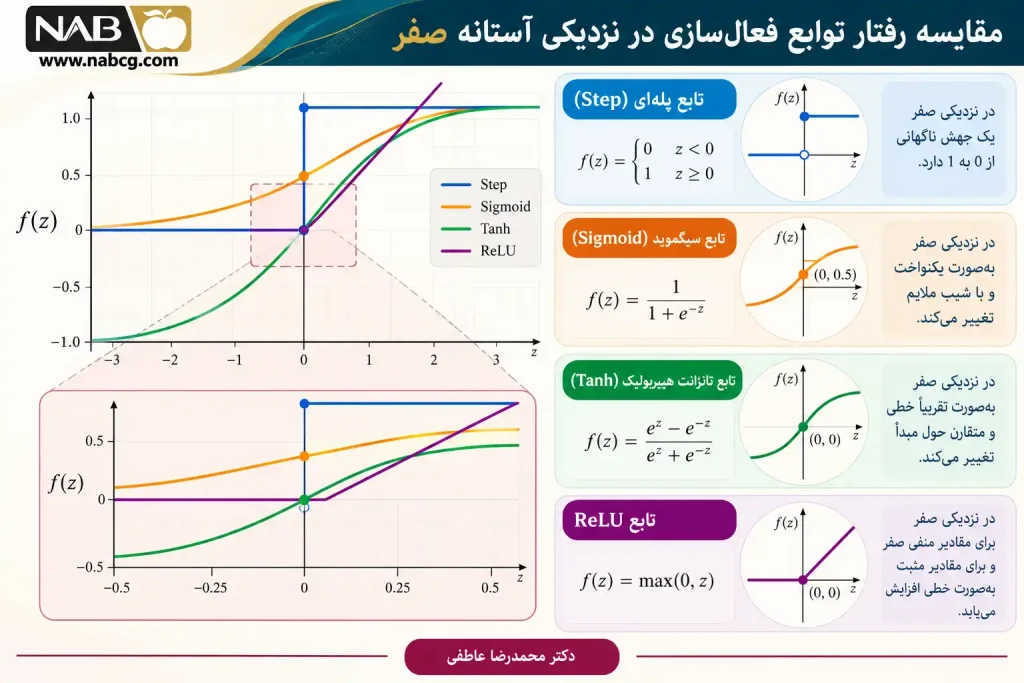
در آزمایش نخست، رفتار کلی توابع را بررسی کردیم. اکنون روی محدوده کوچکی در اطراف صفر تمرکز میکنیم.
پرسش علمی: آیا تغییر بسیار کوچک پیشفعالسازی در نزدیکی صفر، همیشه باعث تغییر کوچک خروجی میشود؟
برای پاسخ، دو ورودی نزدیک به صفر انتخاب میکنیم:
تابع پلهای برای این دو مقدار، خروجیهای صفر و یک تولید میکند. بنابراین، اختلاف خروجی برابر یک است؛ درحالیکه اختلاف ورودی تنها ۰٫۰۰۲ است.
در مقابل، سیگموید و Tanh خروجیهایی نزدیک به یکدیگر خواهند داشت.
برای بررسی عددی:
import math

values = [-0.001, 0.001]

def step(z):
    return int(z >= 0)

def sigmoid(z):
    if z >= 0:
        return 1 / (1 + math.exp(-z))

    e = math.exp(z)
    return e / (1 + e)

for z in values:
    print(f"\nz = {z}")
    print("Step:", step(z))
    print("Sigmoid:", round(sigmoid(z), 6))
    print("Tanh:", round(math.tanh(z), 6))
    print("ReLU:", max(0, z))
خروجی مورد انتظار:
z = -0.001
Step: 0
Sigmoid: 0.49975
Tanh: -0.001
ReLU: 0

z = 0.001
Step: 1
Sigmoid: 0.50025
Tanh: 0.001
ReLU: 0.001
مقایسه نتایج نشان میدهد که تابع پلهای در نزدیکی آستانه، رفتار ناپیوسته دارد، درحالیکه سه تابع سیگموید، Tanh و ReLU در صفر پیوسته هستند.
البته پیوستگی به این معنا نیست که همه توابع نسبت به تغییرات ورودی، حساسیت یکسانی دارند. میزان تغییر خروجی تابع به شکل ریاضی آن وابسته است.
نتیجه مجاز آزمایش: میتوان درباره پیوستگی و رفتار موضعی این توابع نتیجه گرفت.
نتیجه غیرمجاز: نمیتوان فقط بر اساس تغییر خروجی در نزدیکی صفر، درباره پایداری یا دقت یک مدل آموزشدیده قضاوت کرد.
۱۱. آزمایش سوم: اثر انتخاب تابع فعالسازی بر خروجی یک نورون ثابت
در دو آزمایش قبل، مقدار (z) مستقیماً به تابع فعالسازی ارائه شد. اکنون میخواهیم مسیر کامل محاسبه یک نورون را بررسی کنیم.
برای این کار، یک بردار ورودی، وزن و بایاس ثابت تعریف میکنیم:
در بخش قبلی، محاسبه کردیم که مقدار پیشفعالسازی این نورون برابر ۱٫۹ است.
اکنون میخواهیم این مقدار را به پنج تابع فعالسازی مختلف ارائه کنیم.
import math
import numpy as np

x = np.array([0.8, 0.4, 0.6])
w = np.array([1.5, -0.5, 2.0])
b = -0.3

z = float(np.dot(w, x) + b)

results = {
    "Identity": z,
    "Step": int(z >= 0),
    "Sigmoid": 1 / (1 + math.exp(-z)),
    "Tanh": math.tanh(z),
    "ReLU": max(0.0, z)
}

print(f"Pre-activation: {z:.4f}")

for name, value in results.items():
    print(f"{name:10}: {value:.4f}")
نتیجه مورد انتظار، پس از گرد کردن به چهار رقم اعشار:
Pre-activation: 1.9000
Identity  : 1.9000
Step      : 1.0000
Sigmoid   : 0.8699
Tanh      : 0.9562
ReLU      : 1.9000
این آزمایش یک نتیجه روشن دارد: با ثابت ماندن ورودیها، وزنها و بایاس، میتوان تنها با تغییر تابع فعالسازی، خروجیهای متفاوتی ایجاد کرد.
از دیدگاه معماری، این موضوع نشان میدهد انتخاب تابع فعالسازی بخشی مستقل از تعیین وزنها و بایاس است.
اما باید توجه داشت که در شبکههای آموزشدیده، نمیتوان تابع فعالسازی را بدون توجه به شرایط آموزش تغییر داد و انتظار داشت عملکرد مدل حفظ شود. زیرا پارامترهای مدل معمولاً در تعامل با ساختار و تابع فعالسازی آن تنظیم میشوند.
۱۲. پروژه عملی: طراحی یک نورون با تابع فعالسازی قابل انتخاب
در پروژه این بخش، میخواهیم هسته محاسباتی بخش ششم را توسعه دهیم. نورون جدید علاوه بر ورودی، وزن و بایاس، نام تابع فعالسازی را نیز دریافت خواهد کرد.
هدف آن است که ساختار محاسبه پیشرو را به دو مرحله مستقل تقسیم کنیم: نخست محاسبه پیشفعالسازی و سپس اعمال تابع فعالسازی.
این تفکیک در طراحی نرمافزار اهمیت دارد؛ زیرا امکان آزمون و توسعه مستقل هر جزء را فراهم میکند.
۱۲.۱. طراحی ساختار تابع فعالسازی
برای جلوگیری از تکرار کد، ابتدا تابعی تعریف میکنیم که نوع فعالسازی را دریافت و محاسبه مناسب را انجام دهد.
import numpy as np

def apply_activation(z, activation):
    z = np.asarray(z, dtype=float)

    if not np.isfinite(z).all():
        raise ValueError(
            "Activation input must be finite."
        )

    if activation == "identity":
        a = z.copy()

    elif activation == "step":
        a = (z >= 0).astype(float)

    elif activation == "sigmoid":
        a = np.empty_like(z)
        positive = z >= 0

        a[positive] = 1.0 / (
            1.0 + np.exp(-z[positive])
        )

        exp_z = np.exp(z[~positive])
        a[~positive] = exp_z / (1.0 + exp_z)

    elif activation == "tanh":
        a = np.tanh(z)

    elif activation == "relu":
        a = np.maximum(0.0, z)

    else:
        raise ValueError(
            f"Unsupported activation: {activation}"
        )

    return a
در این تابع، از عملیات آرایهای NumPy استفاده شده است. بنابراین، تابع میتواند برای مقدار منفرد یا آرایهای از مقادیر، در شرایط ابعادی سازگار، خروجی تولید کند.
در بخش سیگموید، برای ورودیهای مثبت و منفی دو شکل جبری معادل در نظر گرفته شده است تا از محاسبه بعضی مقادیر نمایی بسیار بزرگ جلوگیری شود.
همچنین تابع نام فعالسازی را بررسی میکند. اگر نام نامعتبری وارد شود، بهجای انتخاب ضمنی یک تابع، خطای مشخصی تولید خواهد شد.
۱۲.۲. ساخت کلاس نورون
اکنون کلاس ArtificialNeuron را طراحی میکنیم. این کلاس دارای وزنها، بایاس و تابع فعالسازی است.
class ArtificialNeuron:
    def __init__(
        self, weights, bias=0.0,
        activation="identity"
    ):
        self.weights = np.asarray(
            weights, dtype=float
        ).copy()
        self.bias = float(bias)
        self.activation = activation

        if self.weights.ndim != 1:
            raise ValueError(
                "Weights must be a 1D vector."
            )

        if self.weights.size == 0:
            raise ValueError(
                "At least one input is required."
            )

        if not np.isfinite(self.weights).all():
            raise ValueError(
                "Weights must be finite."
            )

        if not np.isfinite(self.bias):
            raise ValueError(
                "Bias must be finite."
            )

        valid = {
            "identity", "step", "sigmoid",
            "tanh", "relu"
        }

        if self.activation not in valid:
            raise ValueError(
                "Unsupported activation."
            )

    def forward(self, X):
        X = np.asarray(X, dtype=float)

        if X.ndim == 1:
            if X.shape != self.weights.shape:
                raise ValueError(
                    "Incorrect number of features."
                )

        elif X.ndim == 2:
            if X.shape[1] != self.weights.size:
                raise ValueError(
                    "Incorrect number of features."
                )

        else:
            raise ValueError(
                "Input must be 1D or 2D."
            )

        if not np.isfinite(X).all():
            raise ValueError(
                "Input values must be finite."
            )

        z = X @ self.weights + self.bias

        if not np.isfinite(z).all():
            raise ArithmeticError(
                "Non-finite pre-activation."
            )

        a = apply_activation(z, self.activation)

        if np.ndim(a) == 0:
            return float(a)

        return a
این کلاس محاسبه پیشرو را انجام میدهد، اما هنوز هیچ سازوکار یادگیری ندارد. بنابراین، وزنها و بایاس هنگام اجرای forward تغییر نمیکنند.
۱۲.۳. اجرای یک نمونه با فعالسازیهای مختلف
x = [0.8, 0.4, 0.6]
weights = [1.5, -0.5, 2.0]
bias = -0.3

activation_names = [
    "identity", "step", "sigmoid",
    "tanh", "relu"
]

for name in activation_names:
    neuron = ArtificialNeuron(
        weights=weights,
        bias=bias,
        activation=name
    )

    output = neuron.forward(x)
    print(f"{name:10}: {output:.4f}")
با این برنامه، میتوان خروجی یک نورون را برای پنج تابع فعالسازی بررسی کرد؛ درحالیکه پارامترهای محاسباتی آن یکسان باقی میمانند.
در مرحله بعد، میتوانیم مجموعهای از نمونهها را نیز پردازش کنیم:
X = np.array([
    [0.8, 0.4, 0.6],
    [0.2, 0.9, 0.3],
    [0.5, 0.5, 0.5],
    [1.0, 0.0, 0.2]
])
خروجی:
[1.9 0.15 1.2 1.6 ]این نتیجه با محاسبات پیشفعالسازی سازگار است؛ زیرا برای نمونههای حاضر تمام مقادیر پیشفعالسازی مثبت هستند و ReLU آنها را بدون تغییر نگه میدارد.
اگر نمونهای دارای پیشفعالسازی منفی باشد، خروجی ReLU برای آن صفر خواهد شد.
۱۲.۴. آزمون صحت پیادهسازی
در یک برنامه آموزشی مرجع، اجرای موفق کد بهتنهایی کافی نیست. باید بتوانیم نتایج را با مقادیر شناختهشده بررسی کنیم.
import numpy as np

assert np.isclose(
    apply_activation(0.0, "sigmoid"), 0.5
)

assert np.isclose(
    apply_activation(0.0, "tanh"), 0.0
)

assert np.isclose(
    apply_activation(-3.0, "relu"), 0.0
)

assert np.isclose(
    apply_activation(3.0, "identity"), 3.0
)

assert np.isclose(
    apply_activation(0.0, "step"), 1.0
)

assert np.allclose(
    apply_activation(
        np.array([-2.0, 0.0, 2.0]), "relu"
    ),
    np.array([0.0, 0.0, 2.0])
)

print("All activation tests passed.")
این آزمونها، چند رفتار پایه را بررسی میکنند. بااینحال، برای ارزیابی کاملتر، باید حالتهای مرزی، ورودیهای بسیار بزرگ، ورودیهای نامعتبر و آرایههای چندبعدی نیز بررسی شوند.
بهویژه در تابع سیگموید، ممکن است برای مقادیر بسیار بزرگ مثبت، خروجی عددی دقیقاً به یک گرد شود. بنابراین، آزمون باید تفاوت میان رفتار ریاضی و محدودیت دقت رایانه را در نظر بگیرد.
۱۳. خطاهای رایج در انتخاب و تفسیر تابع فعالسازی
۱۳.۱. فرض اینکه هر نورون باید خروجی صفر یا یک داشته باشد
این تصور احتمالاً از آشنایی اولیه با پرسپترون و توابع آستانهای ناشی میشود.
اما نورونهای مصنوعی میتوانند خروجیهای پیوسته تولید کنند. برای مثال، نورونی با فعالسازی همانی میتواند هر مقدار حقیقی داشته باشد و نورونی با Tanh میتواند مقداری بین منفی یک و مثبت یک تولید کند.
بنابراین، دودویی بودن خروجی ویژگی عمومی همه نورونهای مصنوعی نیست.
۱۳.۲. یکسان دانستن تابع سیگموید با مدل احتمالاتی کامل
سیگموید فقط خروجی را به بازه صفر و یک تبدیل میکند. اینکه این مقدار را بتوان بهعنوان احتمال معتبر تفسیر کرد، به تعریف مدل، روش آموزش و ارزیابی آن وابسته است.
بنابراین، عدد ۰٫۹ حاصل از یک سیگموید دلخواه بهتنهایی به معنای احتمال ۹۰ درصدی یک رویداد نیست.
۱۳.۳. تصور اینکه تابع ReLU خطی است
ReLU در هر یک از دو ناحیه مثبت و منفی رفتار خطی یا ثابت دارد، اما در کل دامنه یک تابع خطی سراسری نیست.
برای مثال:
اما:
درحالیکه مجموع دو خروجی نخست برابر یک است. بنابراین، خاصیت جمعپذیری تابع خطی برقرار نیست.
به همین دلیل، ReLU با وجود سادگی شکل قطعهای، یک فعالسازی غیرخطی است.
۱۳.۴. تصور اینکه تابع پلهای و ReLU معادلاند
هر دو تابع برای ورودیهای منفی خروجی صفر تولید میکنند، اما در ناحیه مثبت تفاوت دارند.
تابع پلهای برای هر ورودی مثبت خروجی یک دارد. ReLU همان مقدار مثبت ورودی را نگه میدارد.
در نتیجه، کاربرد و رفتار این دو تابع یکسان نیست.
۱۳.۵. انتخاب تابع فعالسازی صرفاً بر اساس شکل نمودار
نمودار تابع، اطلاعات مفیدی درباره دامنه، پیوستگی و رفتار آن فراهم میکند، اما برای انتخاب نهایی کافی نیست.
در طراحی شبکه عصبی باید وظیفه مدل، نوع خروجی، روش آموزش، پایداری عددی و عملکرد تجربی نیز بررسی شوند.
همچنین فعالسازی مناسب برای لایه پنهان ممکن است با فعالسازی مناسب برای لایه خروجی متفاوت باشد.
۱۴. تمرینهای پایان بخش
تمرینهای این بخش برای تثبیت مفاهیم و فراهم کردن آمادگی ورود به طراحی نورون کامل تنظیم شدهاند.
14.1.تمرینهای مفهومی
- تمرین 1.۱ — نقش فعالسازی: توضیح دهید چرا محاسبه (𝐰^T 𝐱 + b) همیشه برای تولید خروجی نهایی یک مدل کافی نیست. دو مسئله متفاوت معرفی کنید که در یکی فعالسازی همانی و در دیگری فعالسازی آستانهای مناسب باشد.
- تمرین 1.۲ — مقایسه توابع: تفاوت تابع پلهای و ReLU را از نظر خروجی برای ورودیهای منفی، صفر و مثبت بررسی کنید.
- تمرین 1.۳ — دامنه و برد: برای هر پنج تابع معرفیشده، دامنه و برد ریاضی را مشخص کنید. توضیح دهید چرا برد ریاضی سیگموید شامل صفر و یک نیست.
- تمرین 1.۴ — تفسیر احتمالاتی: فرض کنید نورونی با وزنهای تصادفی و فعالسازی سیگموید، خروجی ۰٫۹۵ تولید میکند. آیا میتوان این عدد را احتمال ۹۵ درصدی وقوع یک رویداد دانست؟ استدلال کنید.
- تمرین 1.۵ — غیرخطی بودن: توضیح دهید چرا ترکیب چند تبدیل آفین بدون فعالسازی غیرخطی همچنان آفین است. سپس بیان کنید افزودن ReLU چه تفاوتی در خانواده توابع قابل نمایش ایجاد میکند.
- تمرین 1.۶ — پیوستگی: پیوستگی تابع پلهای، سیگموید، Tanh و ReLU را در صفر مقایسه کنید.
14.2.تمرینهای محاسباتی
- تمرین 1.1 — محاسبه فعالسازی: برای مقادیر (z=-3,-1,0,1,3)، خروجی هر پنج تابع را محاسبه کنید و نتایج را در یک جدول قرار دهید.
- تمرین 1.۸ — نورون با سیگموید: یک نورون دارای بردار ورودی (x=(1,2)^T)، بردار وزن (w=(0.5,-1)^T) و بایاس ۲ است. ابتدا مقدار پیشفعالسازی و سپس خروجی سیگموید را محاسبه کنید.
- تمرین 1.۹ — نورون با Tanh: برای نورونی با پیشفعالسازی ۱٫۵، خروجی Tanh را به چهار رقم اعشار به دست آورید.
- تمرین 1.۱۰ — رابطه سیگموید و Tanh: با استفاده از رابطه 1.۹، مقدار Tanh را برای (z=1) محاسبه کنید و نتیجه را با محاسبه مستقیم مقایسه کنید.
- تمرین 1.۱۱ — اثر بایاس و ReLU: برای نورونی با تابع ReLU و رابطه (z=2x+b)، دو مقدار متفاوت بایاس انتخاب کنید و محدوده ورودیهایی را تعیین کنید که خروجی آنها صفر میشود.
- تمرین 1.۱۲ — مقایسه خروجی: دو نورون با وزن و بایاس یکسان در نظر بگیرید که یکی از سیگموید و دیگری از Tanh استفاده میکند. بررسی کنید آیا برای (z=0) خروجی آنها برابر است یا خیر.
14.3.تمرینهای برنامهنویسی
- تمرین 1.۱۳ — پیادهسازی دستی: پنج تابع فعالسازی معرفیشده را با پایتون و بدون NumPy برای ورودیهای اسکالر پیادهسازی کنید.
- تمرین 1.۱۴ — بردارسازی: توابع فعالسازی را به شکلی بازنویسی کنید که آرایههای NumPy با ابعاد مختلف را دریافت کنند و خروجی همشکل تولید کنند.
- تمرین 1.۱۵ — رسم نمودار: نمودار سیگموید و Tanh را در بازه ۸− تا ۸ رسم و نواحی نزدیک به اشباع را بررسی کنید.
- تمرین 1.۱۶ — پیوستگی نزدیک صفر: مقادیر ورودی بسیار نزدیک به صفر را برای تابع پلهای و ReLU آزمایش کنید. تفاوت رفتار خروجی را گزارش دهید.
- تمرین 1.۱1 — آزمون واحد: برای هر تابع فعالسازی حداقل پنج آزمون طراحی کنید که مقدار صفر، ورودی مثبت، ورودی منفی، ورودی بزرگ و ورودی نامعتبر را پوشش دهد.
- تمرین 1.۱۸ — توسعه کلاس: کلاس ArtificialNeuron را توسعه دهید تا بتواند علاوه بر خروجی نهایی، مقدار پیشفعالسازی را نیز برای بررسی و خطایابی برگرداند.
- تمرین 1.۱۹ — مقایسه دستهای: یک ماتریس با ۱۰۰ نمونه و پنج ویژگی تولید کنید. وزنها و بایاس را ثابت نگه دارید و خروجی همه نمونهها را برای پنج فعالسازی مختلف محاسبه کنید. سپس توزیع خروجیها را مقایسه کنید.
- تمرین 1.۲۰ — پایداری عددی: سیگموید را با دو روش مستقیم و قطعهای پیادهسازی کنید. برای ورودیهای ۱۰۰۰− و ۱۰۰۰ بررسی کنید کدام روش با هشدار یا سرریز روبهرو میشود. نتایج را با توجه به نوع داده و کتابخانه مورد استفاده تفسیر کنید.
14.4.تمرینهای طراحی و تحلیل
- تمرین 1.۲۱ — طراحی خروجی: برای سه مسئله برآورد یک کمیت پیوسته، تصمیم دودویی و تولید خروجی محدود بین منفی یک و مثبت یک، تابع فعالسازی پیشنهادی خود را مشخص و محدودیتهای آن را توضیح دهید.
- تمرین 1.۲۲ — ساخت تابع غیرخطی: با استفاده از یک نورون دارای ReLU، تابع (f(x)=max(0,x-2)) را پیادهسازی کنید. وزن و بایاس مناسب را تعیین کنید و نمودار حاصل را رسم کنید.
- تمرین 1.۲۳ — مقایسه حساسیت: تغییر خروجی سیگموید را در بازه ۰ تا ۰٫۱ و بازه ۵ تا ۵٫۱ مقایسه کنید. توضیح دهید چرا افزایش یکسان ورودی الزاماً تغییر یکسان خروجی ایجاد نمیکند.
- تمرین 1.۲۴ — محدودیت معماری: آیا یک نورون با تابع ReLU میتواند تابع (x^2) را برای همه اعداد حقیقی دقیقاً نمایش دهد؟ با بررسی شکل تابع نورون و شکل تابع درجهدو پاسخ دهید.
- تمرین 1.۲۵ — پروژه تکمیلی: یک برنامه طراحی کنید که کاربر بتواند وزنها، بایاس و نوع فعالسازی را تغییر دهد. برنامه باید خروجی نورون را برای مجموعهای از نمونهها محاسبه کند و اثر تغییر هر پارامتر را در قالب جدول و نمودار نشان دهد.
۱۵. جمعبندی علمی: از پیشفعالسازی تا خروجی نورون
در آغاز این بخش، مسئله اصلی آن بود که چگونه مقدار عددی حاصل از جمع وزندار و بایاس را به خروجی متناسب با هدف مدل تبدیل کنیم.
برای پاسخ، پنج تابع فعالسازی را بررسی کردیم. تابع همانی مقدار پیشفعالسازی را حفظ میکند؛ تابع پلهای آن را به تصمیم دودویی تبدیل میکند؛ سیگموید خروجی پیوستهای بین صفر و یک ایجاد میکند؛ Tanh مقادیر مثبت و منفی محدود تولید میکند؛ و ReLU مقادیر منفی را صفر و مقادیر مثبت را حفظ میکند.
همچنین روشن شد که انتخاب فعالسازی فقط به دامنه خروجی مربوط نیست. فعالسازیهای غیرخطی در ترکیب لایههای عصبی میتوانند خانواده توابع قابل نمایش شبکه را گسترش دهند.
در بخش عملی، این توابع را مستقل از نورون پیادهسازی کردیم و سپس آنها را به هسته محاسبه پیشرو افزودیم. اکنون برنامه ما میتواند یک بردار ورودی را دریافت کند، مقدار پیشفعالسازی را محاسبه کند و با تابع انتخابشده، خروجی نهایی را تولید کند.
بااینحال، نورون ساختهشده هنوز دو محدودیت مهم دارد.
نخست، وزنها و بایاس را خودمان تعیین کردهایم. بنابراین، مدل هنوز چیزی از دادهها یاد نگرفته است.
دوم، برای طراحی شبکههای پیچیدهتر باید علاوه بر محاسبه یک نورون، ساختار اتصال چند نورون، جریان اطلاعات و ابعاد خروجیها را نیز درک کنیم.
پیش از ورود به بحث یادگیری، لازم است معماری یک نورون را بهصورت یک واحد محاسباتی کامل تحلیل کنیم و تفاوت میان پارامترهای ثابت، مقادیر موقت و خروجی نهایی را در جریان اطلاعات روشن سازیم.
منابع علمی
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Glorot, X., Bordes, A., & Bengio, Y. (2011). Deep sparse rectifier neural networks. In Proceedings of the Fourteenth International Conference on Artificial Intelligence and Statistics (pp. 315–323). PMLR. https://proceedings.mlr.press/v15/glorot11a.html
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. https://www.deeplearningbook.org/
Montúfar, G. F., Pascanu, R., Cho, K., & Bengio, Y. (2014). On the number of linear regions of deep neural networks. Advances in Neural Information Processing Systems, 27. https://arxiv.org/abs/1402.1869
Murphy, K. P. (2022). Probabilistic machine learning: An introduction. MIT Press. https://probml.github.io/pml-book/book1.html
Nair, V., & Hinton, G. E. (2010). Rectified linear units improve restricted Boltzmann machines. In Proceedings of the 27th International Conference on Machine Learning (pp. 807–814). Prince, S. J. D. (2023). Understanding deep learning. MIT Press. https://udlbook.github.io/udlbook/