۱۶. چگونه ظرفیت مدل را در عمل ارزیابی کنیم؟
در کاربردهای واقعی، ظرفیت نظری معمولاً بهطور مستقیم قابل اندازهگیری نیست. بنابراین طراح شبکه از چند شاخص مکمل استفاده میکند.
یکی از مهمترین روشها، مطالعه تغییرات خطای آموزش و اعتبارسنجی هنگام افزایش تدریجی اندازه معماری است.
۱۶.۱. آزمایش افزایش تدریجی ظرفیت
فرض کنید پنج معماری با تعداد نورونهای پنهان متفاوت داریم:
هر پنج مدل روی مجموعه داده یکسان آموزش داده میشوند.
برای مقایسه معتبر، لازم است تقسیم دادهها، پیشپردازش، بودجه آموزش و معیار ارزیابی کنترل شوند. همچنین استفاده از چند مقداردهی اولیه مستقل میتواند به بررسی پایداری نتایج کمک کند.
فرض کنید خروجی یک آزمایش آموزشی بهشکل جدول زیر باشد. اعداد کاملاً فرضی هستند.
| تعداد نورونها | MSE آموزش | MSE اعتبارسنجی |
| ۲ | ۰٫۱۸ | ۰٫۲۰ |
| ۴ | ۰٫۱۲ | ۰٫۱۴ |
| ۸ | ۰٫۰۷ | ۰٫۰۹ |
| ۱۶ | ۰٫۰۴ | ۰٫۰۶ |
| ۳۲ | ۰٫۰۲ | ۰٫۰۸ |
در این مثال، افزایش نورونها تا ۱۶ موجب کاهش هر دو نوع خطا شده است. اما با افزایش عرض به ۳۲، خطای آموزش کاهش یافته و خطای اعتبارسنجی افزایش پیدا کرده است.
این مشاهده میتواند نشانه بیشبرازش یا حساسیت بیشتر مدل به شرایط آموزش باشد. بااینحال، برای تشخیص قطعی، بررسی تکرارهای مستقل و سایر تنظیمات آموزش ضروری است.
۱۶.۲. منحنی ظرفیت و تصمیمگیری معماری
خطای آموزش و اعتبارسنجی برحسب عرض شبکه
مثال فرضی آموزشی؛ مقادیر حاصل آزمایش اجراشده نیستند.
شکل ۵. نمایش فرضی تغییر خطای آموزش و اعتبارسنجی با افزایش ظرفیت شبکه.
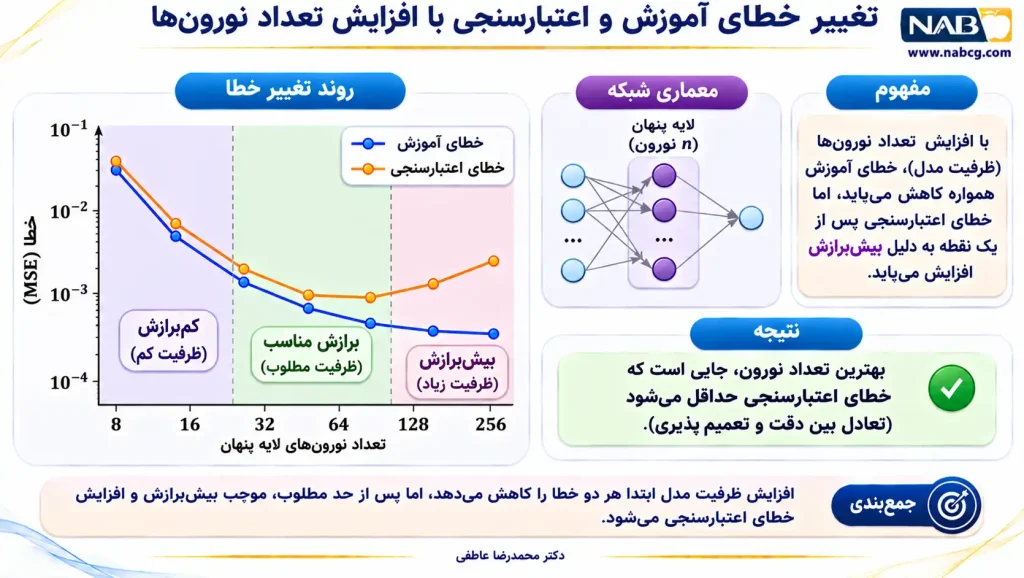
در این نمونه، شبکه دارای ۱۶ نورون کمترین خطای اعتبارسنجی را دارد.
بنابراین انتخاب آن از میان گزینههای بررسیشده، با فرض یکسان بودن سایر شرایط و معیار انتخاب، قابل دفاع است.
اما نتیجه را نباید تعمیم داد که شبکه ۱۶نورونی برای هر مسئله مناسب است.
۱۷. پیوند ظرفیت مدل با انتخاب معماری در پروژههای واقعی
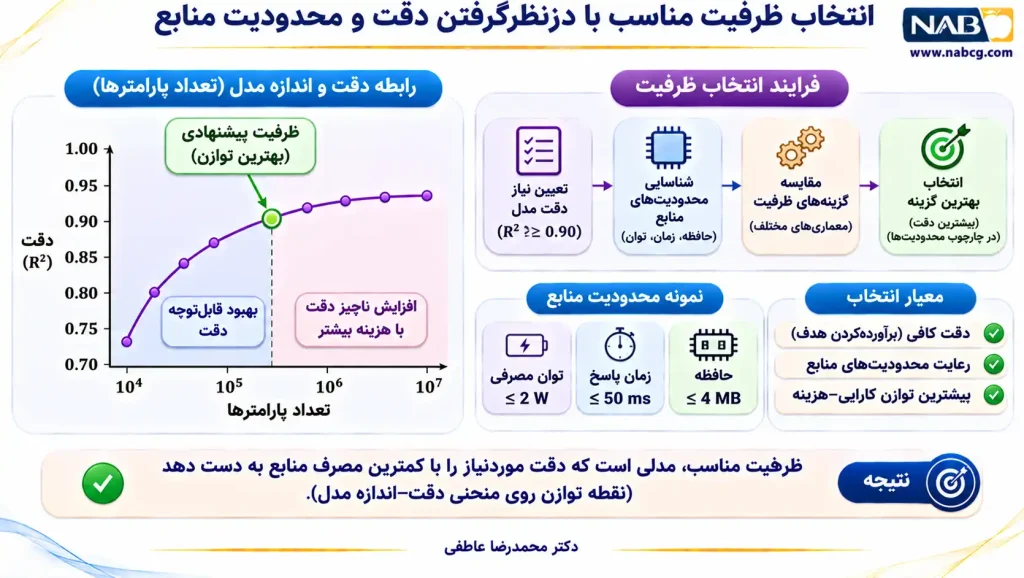
برای طراحی یک شبکه عصبی در محیط عملیاتی، ظرفیت باید همزمان با چند محدودیت دیگر بررسی شود.
برای مثال، یک سامانه هوش مصنوعی آفلاین ممکن است مجبور باشد روی دستگاهی با حافظه و توان پردازشی محدود اجرا شود. در چنین شرایطی، حتی اگر یک شبکه بزرگتر بهبود اندکی در دقت ایجاد کند، هزینه حافظه یا زمان پاسخ آن ممکن است استفاده از آن را نامناسب سازد.
به همین دلیل، ظرفیت را میتوان بخشی از یک مسئله طراحی چندهدفه در نظر گرفت.
فرض کنید (a) معماری شبکه باشد.
هدف کاهش خطای اعتبارسنجی است:
با محدودیتهایی مانند:
که در آن (P(a)) تعداد پارامترها و (T(a)) زمان استنتاج است.
در این مسئله، مطلوبترین معماری الزاماً بزرگترین شبکه یا شبکه دارای کمترین خطای آموزش نیست؛ بلکه شبکهای است که در محدوده منابع موجود، عملکرد مطلوب و قابل اتکایی ارائه دهد.
۱۷.۱. نتیجه مدیریتی
در طراحی سامانههای هوش مصنوعی سازمانی، تصمیمگیری درباره ظرفیت شبکه باید بر اساس نیاز کسبوکار، معیار عملکرد، هزینه زیرساخت و محدودیت پاسخگویی انجام شود.
برای مثال، اگر دو شبکه روی دادههای آزمون عملکردی نزدیک داشته باشند، اما یکی از آنها حافظه بسیار کمتری مصرف کند و سریعتر پاسخ دهد، استفاده از شبکه کوچکتر میتواند از نظر اقتصادی و مهندسی مناسبتر باشد.
البته این تصمیم باید با اندازهگیری واقعی روی سختافزار هدف و با توجه به حساسیت کاربرد اتخاذ شود.
۱۸. جمعبندی علمی این مرحله
در این بخش از نسخه نهایی، سه مرز اساسی ظرفیت مدل روشن شد.
نخست، عرض شبکه علاوه بر تعداد پارامترها، میتواند محدودیت نظری مستقلی بر تقریب عمومی توابع ایجاد کند.
دوم، ظرفیت بازنمایی با ظرفیت مؤثر یکسان نیست. شبکه ممکن است از نظر معماری توانایی کافی داشته باشد، اما در شرایط عملی آموزش به پارامترهای مناسب نرسد.
سوم، ظرفیت آماری و عملکرد تجربی باید جداگانه بررسی شوند. کرانهایی مانند بُعد VC اطلاعات نظری مهمی درباره پیچیدگی کلاس مدل ارائه میکنند، اما جایگزین آزمایشهای اعتبارسنجی و آزمون نیستند.
نتیجه محوری: ظرفیت مطلوب شبکه نه فقط با اندازه آن، بلکه با تناسب معماری با پیچیدگی تابع هدف، توان یادگیری از دادهها و محدودیتهای واقعی اجرا تعیین میشود.
منابع افزودهشده
Hanin, B., & Sellke, M. (2017). Approximating continuous functions by ReLU nets of minimal width [Preprint]. arXiv. https://arxiv.org/abs/1710.11278
Bartlett, P. L., Harvey, N., Liaw, C., & Mehrabian, A. (2019). Nearly-tight VC-dimension and pseudodimension bounds for piecewise linear neural networks. Journal of Machine Learning Research, 20(63), 1–17. https://jmlr.org/papers/v20/17-612.html
۱۹. گلوگاههای معماری؛ چرا تعداد نورونهای یک لایه میتواند کل شبکه را محدود کند؟
در یک شبکه عصبی چندلایه، خروجی هر لایه بهعنوان ورودی لایه بعدی استفاده میشود. بنابراین، اطلاعاتی که در یک لایه از دست میروند، لزوماً در لایههای بعدی قابل بازیابی نیستند.
این موضوع هنگامی اهمیت بیشتری پیدا میکند که یک لایه میانی، تعداد نورون بسیار کمتری از لایههای قبل و بعد داشته باشد.
به چنین لایهای، در شرایط مناسب، گلوگاه بازنمایی (Representational Bottleneck) گفته میشود.
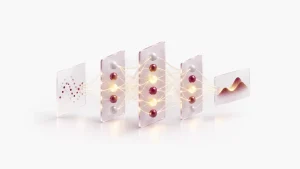
فرض کنید شبکهای با معماری زیر طراحی شده است:
این شبکه در مجموع سه لایه پنهان دارد که عرض آنها بهترتیب ۱۲، ۲ و ۱۲ است.
لایه پنهان دوم فقط دو نورون دارد. بنابراین، خروجی دوازده نورون لایه نخست باید به یک بردار دوبعدی تبدیل شود.
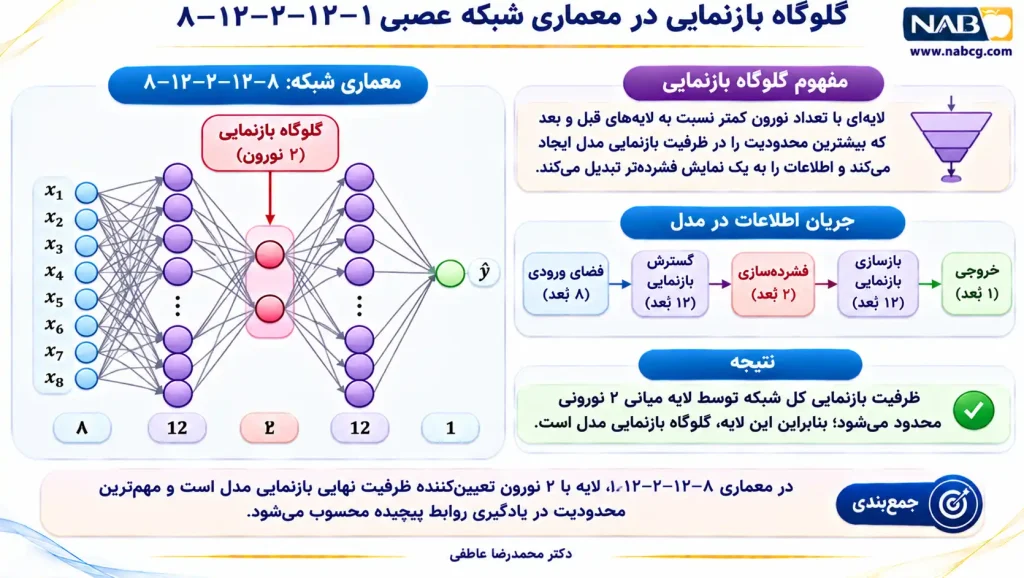
وجود گلوگاه الزاماً نقص معماری نیست. گاهی تابع هدف ذاتاً به تعداد کمی متغیر میانی وابسته است و فشردهسازی بازنمایی میتواند مناسب باشد.
اما اگر اطلاعات لازم برای خروجی قابل فشردهسازی به عرض گلوگاه نباشند، این ساختار ممکن است محدودیت ایجاد کند.
۱۹.۱. تحلیل ریاضی گلوگاه در یک شبکه خطی
برای درک محدودیت، ابتدا یک شبکه خطی ساده با معماری زیر را در نظر میگیریم:
بردار ورودی:
لایه میانی تنها یک مقدار تولید میکند:
خروجی سهبعدی نیز از همین مقدار ساخته میشود:
میتوان کل تبدیل را بهصورت ماتریسی نوشت:
که در آن:
چون A حاصلضرب یک ماتریس ۳×۱ در یک ماتریس ۱×۳ است:
در نتیجه، این معماری نمیتواند تبدیل همانی سهبعدی را بهطور دقیق بازنمایی کند:
زیرا ماتریس همانی سهبعدی دارای رتبه سه است.
این مثال نشان میدهد که عرض یک لایه میانی میتواند ظرفیت یک شبکه خطی را محدود کند، حتی اگر تعداد نورونهای سایر لایهها افزایش یابد.
در شبکههای غیرخطی نیز گلوگاهها میتوانند محدودیت ایجاد کنند، اما تحلیل آنها به ابعاد ورودی، تابع فعالسازی، پیوستگی نگاشت و ویژگیهای تابع هدف وابسته است. بنابراین، استدلال رتبه ماتریس را نمیتوان مستقیماً به تمام شبکههای غیرخطی تعمیم داد.
۱۹.۲. محاسبه پارامترهای یک شبکه دارای گلوگاه
برای معماری زیر:
تعداد پارامترهای هر لایه برابر است با:
بنابراین:
اکنون شبکه دیگری را در نظر بگیرید:
تعداد پارامترهای آن:
شبکه دوم پارامتر بیشتری دارد، اما فاقد گلوگاه دوبعدی است.
بااینحال، نمیتوان صرفاً از این تفاوت نتیجه گرفت که شبکه دوم عملکرد بهتری خواهد داشت. اگر مسئله دارای ساختار کمبُعدی باشد، شبکه دارای گلوگاه ممکن است مناسب یا حتی کارآمدتر باشد.
۲۰. پیچیدگی تابع هدف و ظرفیت موردنیاز شبکه
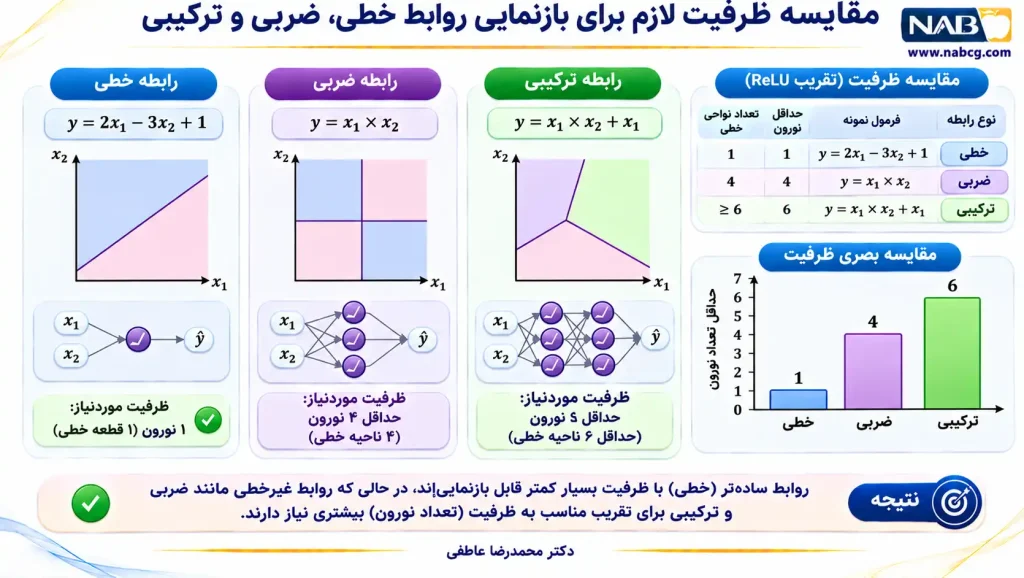
ظرفیت مناسب یک شبکه تنها از روی تعداد ویژگیهای ورودی مشخص نمیشود. ساختار تابعی که قرار است یاد گرفته شود، اهمیت اساسی دارد.
برای توضیح این موضوع، سه مسئله را بررسی میکنیم که همگی دارای دو ورودی هستند.
۲۰.۱. مسئله اول: رابطه خطی
فرض کنید تابع هدف برابر باشد با:
این تابع با یک نورون دارای خروجی خطی قابل بازنمایی دقیق است.
با انتخاب وزنها و بایاس مناسب:
داریم:
بنابراین برای بازنمایی دقیق این رابطه، استفاده از شبکه چندلایه ضروری نیست.
۲۰.۲. مسئله دوم: رابطه غیرخطی
اکنون تابع زیر را در نظر بگیرید:
این رابطه شامل تعامل ضربی میان دو ورودی است.
یک مدل آفین از شکل:
نمیتواند این تابع را روی یک ناحیه باز دوبعدی بهطور دقیق بازنمایی کند.
برای مشاهده علت، میتوان چهار نمونه زیر را بررسی کرد.
| (x_1) | (x_2) | خروجی واقعی |
| ۱ | ۱ | ۱ |
| ۱ | ۲ | ۲ |
| ۲ | ۱ | ۲ |
| ۲ | ۲ | ۴ |
اگر مدل آفین بتواند سه نمونه نخست را دقیقاً بازنمایی کند، از معادلات متناظر نتیجه میشود:
اما برای نمونه چهارم:
درحالیکه مقدار واقعی برابر چهار است.
بنابراین مدل آفین نمیتواند هر چهار نقطه را بهطور همزمان دقیقاً بازنمایی کند.
یک شبکه غیرخطی با ظرفیت مناسب میتواند تابع ضرب را روی یک دامنه فشرده با دقت دلخواه تقریب بزند.
۲۰.۳. مسئله سوم: تابع دارای ساختار ترکیبی
حال فرض کنید تابع هدف چنین باشد:
این تابع شامل چند مرحله محاسباتی است: ضرب دو ورودی، توان دوم حاصل و جمع با یک جمله خطی.
میتوان آن را بهصورت ترکیب توابع نوشت:
ساختار این مسئله از نظر محاسباتی ترکیبی است.
یک شبکه عمیق ممکن است بتواند از چنین ساختاری برای ایجاد بازنمایی کارآمد استفاده کند، اگرچه کارآمدی آن نسبت به شبکه کمعمق به معماری و دقت تقریب موردنیاز وابسته خواهد بود.
این مثال نشان میدهد که ظرفیت موردنیاز را نمیتوان فقط با شمارش ورودیها تعیین کرد.
۲۱. تشخیص ظرفیت ناکافی؛ آیا مشکل شبکه از معماری است یا آموزش؟
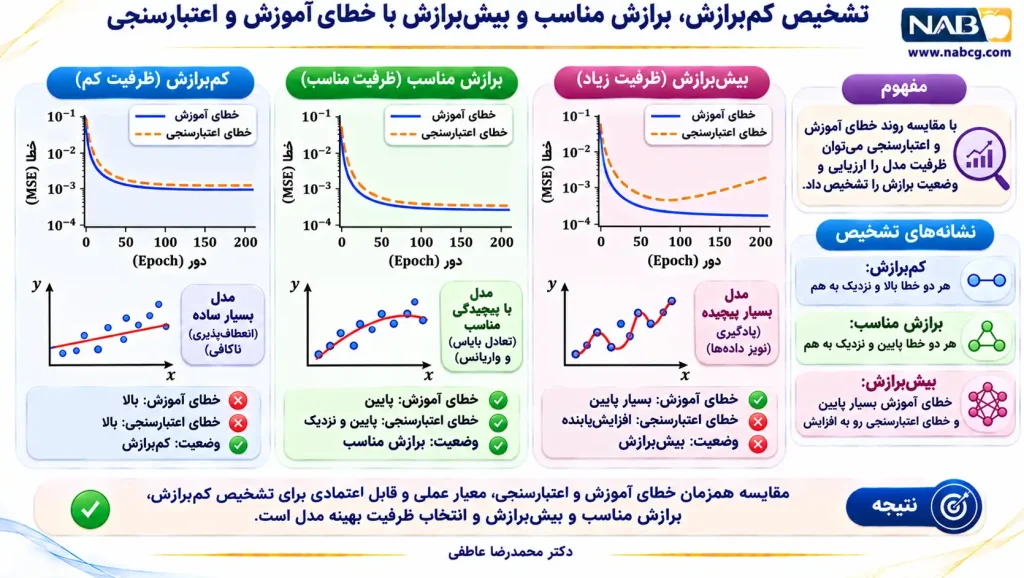
در طراحی شبکههای عصبی، یکی از خطاهای رایج آن است که هرگاه مدل عملکرد ضعیفی داشته باشد، بلافاصله تعداد نورونها یا لایهها افزایش داده میشود.
اما خطای بالای پیشبینی الزاماً به معنی ناکافی بودن ظرفیت معماری نیست. ممکن است مدل ظرفیت لازم را داشته باشد، ولی به دلایلی مانند تنظیم نامناسب نرخ یادگیری، دادههای نامناسب یا توقف زودهنگام آموزش نتواند از آن استفاده کند.
برای تشخیص علت، باید عملکرد مدل را در شرایط کنترلشده بررسی کنیم.
۲۱.۱. مقایسه سه وضعیت متفاوت
فرض کنید سه شبکه روی یک مسئله رگرسیون آموزش داده شدهاند.
جدول زیر نتایج فرضی را نشان میدهد.
| مدل | MSE آموزش | MSE اعتبارسنجی | تفسیر اولیه |
| A | ۰٫۲۵ | ۰٫۲۸ | خطای بالا در هر دو مجموعه |
| B | ۰٫۰۳ | ۰٫۰۴ | خطای پایین و نزدیک |
| C | ۰٫۰۰۵ | ۰٫۱۲ | شکاف قابلتوجه میان آموزش و اعتبارسنجی |
در مدل A، خطای آموزش بالا است. این وضعیت ممکن است به دلیل ظرفیت ناکافی باشد، اما میتواند ناشی از آموزش ناموفق نیز باشد.
در مدل B، هر دو خطا پاییناند. اگر این مقادیر با معیارهای موفقیت مسئله سازگار باشند، لزومی ندارد فقط برای افزایش ظرفیت، شبکه را بزرگتر کنیم.
در مدل C، خطای آموزش بسیار کم است، اما خطای اعتبارسنجی نسبتاً بالا باقی مانده است. این وضعیت نشانهای برای بررسی بیشبرازش، تفاوت توزیع دادهها یا سایر مشکلات تعمیم است.
۲۱.۲. آزمون یادگیری روی مجموعه کوچک
یکی از روشهای تشخیص مشکلات آموزش، بررسی توانایی مدل در یادگیری یک مجموعه کوچک از دادههاست.
فرض کنید تنها ۲۰ نمونه آموزشی انتخاب میکنیم و شبکه را روی همان نمونهها آموزش میدهیم.
اگر شبکه با وجود ظرفیت کافی و تابع زیان مناسب نتواند خطای این نمونهها را کاهش دهد، باید پیادهسازی، مقداردهی اولیه، مقیاس ویژگیها و تنظیمات بهینهسازی را بررسی کنیم.
این آزمون یک ابزار عیبیابی است، نه اثبات ظرفیت نظری.
ممکن است شبکه برای بعضی مجموعههای داده یا الگوهای برچسبگذاری واقعاً ظرفیت کافی نداشته باشد.
۲۱.۳. آزمایش منحنی ظرفیت
روش مکمل آن است که چند معماری با ظرفیتهای متفاوت را تحت شرایط یکسان آموزش دهیم و خطای آنها را مقایسه کنیم.
برای مثال، معماریهای زیر را در نظر بگیرید:
اگر افزایش عرض به کاهش منظم خطای آموزش منجر شود، میتوان نتیجه گرفت که ظرفیت بیشتر در شرایط آزمایش به مدل کمک کرده است.
بااینحال، اگر خطا تغییر نکند، هنوز نمیتوان بهطور قطعی نتیجه گرفت که ظرفیت کافی است. ممکن است فرایند بهینهسازی مانع استفاده از ظرفیت اضافی شده باشد.
این تمایز، یکی از اصول مهم تحلیل تجربی معماری شبکه است.
۲۲. ظرفیت بازنمایی و ظرفیت آماری؛ دو پرسش متفاوت
در مباحث پیشین، ظرفیت بازنمایی را بهعنوان توانایی مدل در ساخت توابع گوناگون تعریف کردیم.
اما در نظریه یادگیری آماری، پرسش دیگری نیز اهمیت دارد: یک خانواده مدل تا چه اندازه میتواند برچسبگذاریهای مختلف نمونههای آموزشی را بازتولید کند؟
برای مطالعه این موضوع از سنجههایی مانند بُعد VC استفاده میشود.
۲۲.۱. توضیح شهودی بُعد VC
فرض کنید یک مجموعه شامل سه نقطه داریم و هر نقطه میتواند یکی از دو برچسب صفر یا یک را دریافت کند.
تعداد برچسبگذاریهای ممکن:
اگر خانوادهای از مدلهای طبقهبندی بتواند برای یک مجموعه سهنقطهای، تمام هشت برچسبگذاری را بازنمایی کند، میگوییم آن مجموعه را خرد میکند (Shatter).
بُعد VC بزرگترین اندازه مجموعهای است که دستکم یک مجموعه با آن اندازه توسط خانواده مدل قابل خرد کردن باشد.
این مفهوم با شمارش مستقیم پارامترها تفاوت دارد.
برای شبکههای دارای فعالسازی تکهایخطی، Bartlett و همکاران (۲۰۱۹) کران بالای زیر را برای بُعد VC اثبات کردهاند:
که در آن (W) تعداد پارامترها و (L) تعداد لایهها در صورتبندی نظری پژوهش است.
این نتیجه نشان میدهد که هم تعداد پارامترها و هم عمق شبکه در کران پیچیدگی آماری نقش دارند.
اما نباید از آن نتیجه گرفت که دو برابر شدن عمق الزاماً بُعد VC یا کیفیت یادگیری را دو برابر میکند. این رابطه یک کران مجانبی است و به شرایط قضیه وابسته است.
۲۲.۲. آیا ظرفیت آماری بیشتر به معنای تعمیم بهتر است؟
خیر.
افزایش ظرفیت آماری میتواند امکان برازش الگوهای متنوعتری را ایجاد کند، اما تضمین نمیکند که مدل روی دادههای جدید بهتر عمل کند.
تعمیمپذیری به عواملی مانند توزیع دادهها، کیفیت نمونهها، نوع مسئله، منظمسازی و رفتار الگوریتم آموزش نیز وابسته است.
ازاینرو، سنجههای نظری ظرفیت باید در کنار آزمایشهای اعتبارسنجی و آزمون نهایی تفسیر شوند.
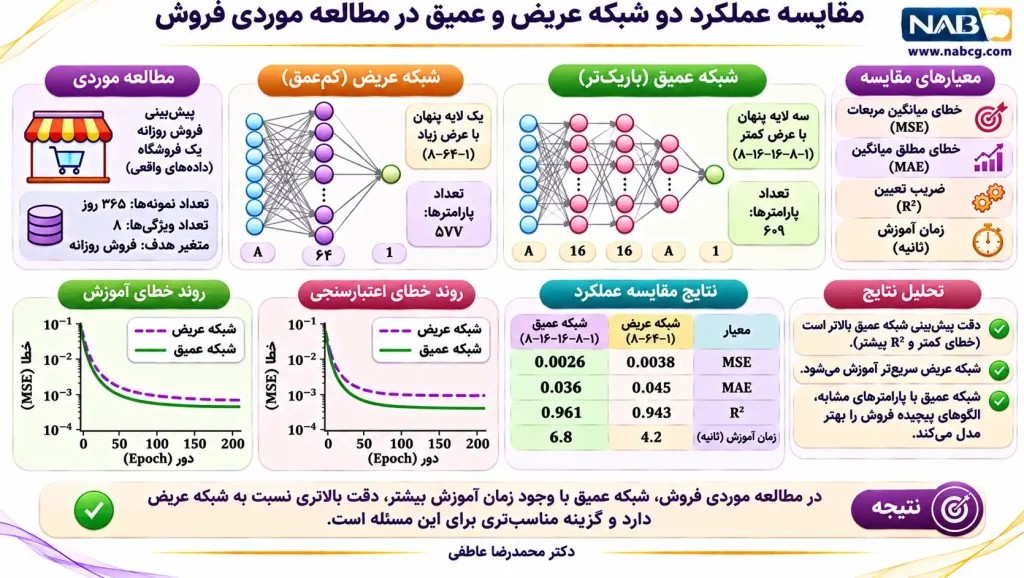
۲۳. مطالعه موردی جامع: انتخاب ظرفیت مناسب برای پیشبینی تقاضای فروش
اکنون مفاهیم ظرفیت بازنمایی، عمق، عرض، تعداد پارامترها و ارزیابی تجربی را در یک مسئله واحد ترکیب میکنیم.
این مطالعه از دادههای مصنوعی استفاده میکند تا بتوان ساختار تابع هدف و شرایط آموزش را کنترل کرد. هدف، بررسی تأثیر معماری است، نه اثبات عملکرد یک مدل در بازار واقعی.
۲۳.۱. تعریف مسئله
فرض کنید خروجی موردنظر به چهار ویژگی ورودی وابسته است:
در این رابطه:
- x₁ و x₂ دارای تعامل غیرخطیاند.
- x₃ یک اثر درجه دوم دارد.
- x₄ دارای اثر خطی است.
- ε نویز تصادفی است.
ویژگیها از توزیع یکنواخت در بازه ([-1,1]) و نویز از توزیع نرمال با انحراف معیار ۰٫۰۸ تولید میشوند.
برای آزمایش، ۹۰۰ نمونه در نظر میگیریم: ۶۰۰ نمونه آموزشی، ۱۵۰ نمونه اعتبارسنجی و ۱۵۰ نمونه آزمون.
۲۳.۲. مقایسه دو معماری
دو شبکه زیر را انتخاب میکنیم:
تعداد پارامترهای مدل A برابر ۸۵ و مدل B برابر ۸۷ است.
بنابراین، دو شبکه از نظر بودجه پارامتر تقریباً برابرند، اما ساختار عمق و عرض متفاوتی دارند.
۲۳.۳. راستیآزمایی محاسباتی
کد پایتون آزمایش پیشین با scikit-learn 1.8.0 مجدداً اجرا و خروجیها بررسی شدند. از سه بذر تصادفی برای مقداردهی اولیه هر مدل استفاده شد.
جدول ۳. نتایج محاسبهشده آزمایش مصنوعی:
| معیار | مدل A | مدل B |
| میانگین MSE آموزش | ۰٫۰۳۱۷۲ | ۰٫۰۲۸۲۱ |
| میانگین MSE اعتبارسنجی | ۰٫۰۴۱۷۴ | ۰٫۰۳۵۷۱ |
| میانگین MSE آزمون | ۰٫۰۴۳۵۳ | ۰٫۰۴۱۹۳ |
مدل B در این آزمایش میانگین خطای اعتبارسنجی کمتری دارد.
اختلاف خطای اعتبارسنجی برابر است با:
کاهش نسبی:
بااینحال، کاهش میانگین خطای آزمون تنها حدود ۳٫۷ درصد است و تعداد تکرارها برای نتیجهگیری آماری قوی کافی نیست.
در نتیجه، این آزمایش نشان میدهد که آرایش متفاوت لایهها میتواند حتی با تعداد پارامتر تقریباً یکسان، به عملکرد متفاوتی منجر شود.
اما از آن نمیتوان نتیجه گرفت که معماری B در همه مسائل برتر است.
۲۳.۴. نتیجه مهندسی مطالعه موردی
برای طراحی شبکه عصبی، انتخاب ظرفیت باید بهصورت یک فرآیند آزمایشی انجام شود.
ابتدا یک معماری ساده طراحی میشود. سپس عملکرد آن روی دادههای آموزش و اعتبارسنجی بررسی میشود. در مراحل بعدی، عرض و عمق با حفظ شرایط ارزیابی تغییر میکنند.
اگر افزایش ظرفیت بهبود معناداری در معیار عملکرد ایجاد نکند، استفاده از معماری بزرگتر ممکن است توجیه نداشته باشد.
از طرف دیگر، اگر افزایش عمق یا عرض موجب کاهش پایدار خطای اعتبارسنجی شود، معماری جدید میتواند گزینه مناسبتری باشد؛ مشروط بر اینکه هزینه محاسباتی و الزامات عملیاتی نیز پذیرفتنی باشند.
۲۴. تمرینهای تلفیقی با پاسخ تشریحی
تمرین اول: محاسبه تعداد پارامترها
شبکهای با معماری زیر داریم:
تعداد پارامترهای قابلآموزش شبکه را محاسبه کنید.
حل:
- لایه اول:
- لایه دوم:
- لایه خروجی:
در نتیجه:
تمرین دوم: اثر عرض بر اندازه شبکه
شبکه زیر را در نظر بگیرید:
رابطه تعداد پارامترها را برحسب (m) استخراج کنید.
حل:
با سادهسازی:
این رابطه نشان میدهد که در این معماری، تعداد پارامترها نسبت به عرض رابطه درجه دوم دارد.
برای مثال، اگر (m=10) باشد:
و اگر (m=20) باشد:
بنابراین دو برابر شدن عرض، تعداد پارامترها را بیش از سه برابر کرده است.
تمرین سوم: ارزیابی گلوگاه
دو معماری زیر را در نظر بگیرید:
آیا میتوان صرفاً از روی تعداد پارامترها تعیین کرد که کدام شبکه ظرفیت بازنمایی بیشتری دارد؟
پاسخ:
خیر. معماری B دارای گلوگاه دوبعدی است، اما مدل A فاقد چنین گلوگاهی است. هر دو خانواده توابع متفاوتی را بازنمایی میکنند.
برای مقایسه، باید تابع هدف و معیار ظرفیت مشخص باشند. تعداد پارامترها برای توصیف اندازه شبکه مفید است، اما معیار کامل توان بازنمایی نیست.
۲۵. نتیجهگیری نهایی بخش ظرفیت مدل
ظرفیت مدل یکی از مفاهیم بنیادی در طراحی شبکههای عصبی است. این مفهوم نشان میدهد معماری شبکه چه خانوادهای از توابع را میتواند بازنمایی کند و چگونه تغییر ساختار آن ممکن است دامنه توابع قابل نمایش را تغییر دهد.
نتایج اصلی این بخش را میتوان در چهار رابطه مفهومی خلاصه کرد:
هیچیک از این روابط بهتنهایی تضمینکننده کیفیت تعمیم نیستند.
شبکه بزرگتر ممکن است توابع پیچیدهتری را بازنمایی کند، اما شبکهای با ظرفیت متناسب با مسئله میتواند از نظر عملکرد، هزینه و پایداری گزینه مناسبتری باشد.
برای طراحی علمی یک MLP باید میان سه مسئله تمایز قائل شد: توان نظری معماری، امکان دستیابی به پارامترهای مناسب هنگام آموزش و عملکرد مدل روی دادههای جدید.
این تمایز، پایه تصمیمگیری آگاهانه درباره تعداد نورونها، تعداد لایهها و اندازه شبکه است.
منابع علمی
Bartlett, P. L., Harvey, N., Liaw, C., & Mehrabian, A. (2019). Nearly-tight VC-dimension and pseudodimension bounds for piecewise linear neural networks. Journal of Machine Learning Research, 20(63), 1–17.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Hanin, B., & Sellke, M. (2017). Approximating continuous functions by ReLU nets of minimal width [Preprint]. arXiv. https://arxiv.org/abs/1710.11278
Montúfar, G., Pascanu, R., Cho, K., & Bengio, Y. (2014). On the number of linear regions of deep neural networks. Advances in Neural Information Processing Systems, 27.
Prince, S. J. D. (2023). Understanding deep learning. MIT Press.
Telgarsky, M. (2016). Benefits of depth in neural networks. Proceedings of Machine Learning Research, 49, 1517–1539.
۲۶. ارزیابی تجربی ظرفیت: از آزمایش آموزشی تا شواهد قابل اتکا
یکی از تفاوتهای مهم میان مطالعه نظری شبکههای عصبی و طراحی عملی آنها، نوع پرسشهایی است که مطرح میکنیم.
در مطالعه نظری، میپرسیم یک معماری چه توابعی را میتواند بازنمایی کند. برای پاسخ به این پرسش، میتوان از اثباتهای ریاضی، بررسی نواحی خطی و نتایج نظریه تقریب استفاده کرد.
اما در طراحی عملی، پرسش متفاوتی داریم: آیا معماری موردنظر میتواند با دادههای موجود و تحت محدودیتهای آموزش، تابع هدف را با دقت قابل قبول یاد بگیرد؟
برای پاسخ به پرسش دوم، باید آزمایشهایی طراحی کنیم که نتیجه آنها قابلبازتولید و قابلمقایسه باشد.
۲۶.۱. راستیآزمایی نتایج آزمایش پیشین
در مطالعه موردی بخش ۲۳، دو معماری را با بودجه پارامتر تقریباً یکسان مقایسه کردیم:
در بازبینی حاضر، کد اصلی آزمایش را با نسخه ۱٫۸٫۰ کتابخانه scikit-learn اجرا کردم. تعداد نمونهها، نحوه تولید داده مصنوعی، بذرهای تصادفی و تنظیمات آموزش مطابق متن قبلی بودند.
نتیجه راستیآزمایی
تأیید محاسبات
| معیار | مدل A | مدل B |
| میانگین MSE آموزش | ۰٫۰۳۱۷۲ | ۰٫۰۲۸۲۱ |
| میانگین MSE اعتبارسنجی | ۰٫۰۴۱۷۴ | ۰٫۰۳۵۷۱ |
| میانگین MSE آزمون | ۰٫۰۴۳۵۳ | ۰٫۰۴۱۹۳ |
جدول ۴. نتایج بازتولیدشده در محیط محاسباتی حاضر با سه مقداردهی اولیه مستقل برای هر مدل.
مقادیر محاسبهشده با جدول قبلی مطابقت دارند. بنابراین میتوان این اعداد را بهعنوان نتایج یک آزمایش مصنوعی اجراشده گزارش کرد.
بااینحال، تفسیر این اعداد باید محدود به طراحی آزمایش باقی بماند. نتیجه نشان نمیدهد که شبکههای دولایه پنهان بهصورت عمومی بهتر از شبکههای تکلایه پنهان هستند.
۲۶.۲. چرا میانگین سه اجرا کافی نیست؟
هنگام آموزش شبکه عصبی، مقداردهی اولیه میتواند بر پارامترهای نهایی و کیفیت پیشبینی اثر بگذارد.
اگر فقط یک اجرای آموزشی انجام دهیم، ممکن است نتیجه مشاهدهشده بیشتر به مقداردهی اولیه مربوط باشد تا تفاوت واقعی معماریها.
استفاده از سه بذر تصادفی این مشکل را تا اندازهای کاهش میدهد، اما برای نتیجهگیری قابل اتکاتر، تکرارهای بیشتری لازم است.
فرض کنید خطای اعتبارسنجی مدل (A) در (R) اجرای مستقل برابر باشد با:
میانگین خطا چنین محاسبه میشود:
انحراف معیار نمونه نیز برابر است با:
این شاخص نشان میدهد نتایج اجراهای مختلف تا چه اندازه پراکندهاند.
در یک مقایسه کنترلشده، بهتر است دو مدل با بذرهای متناظر و دادههای یکسان مقایسه شوند و اختلاف خطای آنها در هر تکرار نیز گزارش شود.
از آنجا که هر دو معماری روی یک مجموعه اعتبارسنجی ارزیابی شدهاند، تحلیل اختلافهای زوجی میتواند مفیدتر از مقایسه دو میانگین بهتنهایی باشد.
۲۶.۳. خطای کمتر، نتیجه آماری قویتر نیست
فرض کنید مدل B میانگین خطای اعتبارسنجی کمتری دارد.
این مشاهده به ما میگوید که در اجراهای بررسیشده، مدل B بهتر عمل کرده است. اما برای نتیجهگیری درباره برتری پایدار آن باید میزان پراکندگی، تعداد تکرارها و حساسیت به مجموعه داده بررسی شود.
حتی تعداد زیاد بذرهای تصادفی روی یک مجموعه داده ثابت نیز تمام عدمقطعیت مسئله را پوشش نمیدهد؛ زیرا فقط بخشی از تغییرپذیری ناشی از آموزش را میسنجد.
برای بررسی پایداری در برابر نمونهگیری داده، میتوان تقسیمبندیهای متفاوت یا مجموعههای داده مستقلی را نیز ارزیابی کرد، مشروط بر آنکه مجموعه آزمون نهایی برای انتخاب مدل مورد استفاده قرار نگیرد.
این تمایز، تفاوت میان یک آزمایش آموزشی و یک مطالعه تجربی پژوهشی را مشخص میکند.
۲۷. انتخاب ظرفیت بر اساس منحنی عملکرد و هزینه
در طراحی واقعی MLP، بهتر است ظرفیت شبکه را بهصورت تدریجی افزایش دهیم و عملکرد آن را اندازهگیری کنیم.
فرض کنید شبکه پایه دارای یک لایه پنهان با هشت نورون است. سپس شبکههایی با ۱۶ و ۳۲ نورون را نیز بررسی میکنیم.
اگر خطای اعتبارسنجی با افزایش عرض کاهش پیدا کند، میتوان افزایش ظرفیت را ادامه داد. اما اگر بهبود بسیار اندک باشد و هزینه محاسباتی بهشدت افزایش یابد، ممکن است ادامه بزرگکردن شبکه مناسب نباشد.
۲۷.۱. تحلیل سود نهایی افزایش ظرفیت
فرض کنید سه معماری دارای نتایج فرضی زیر هستند:
| معماری | پارامترها | MSE اعتبارسنجی |
| A | ۵۰۰ | ۰٫۰۸ |
| B | ۲٬۰۰۰ | ۰٫۰۵ |
| C | ۸٬۰۰۰ | ۰٫۰۴۸ |
کاهش خطای اعتبارسنجی با افزایش تعداد پارامترها
دادههای فرضی برای توضیح بازده نهایی افزایش ظرفیت
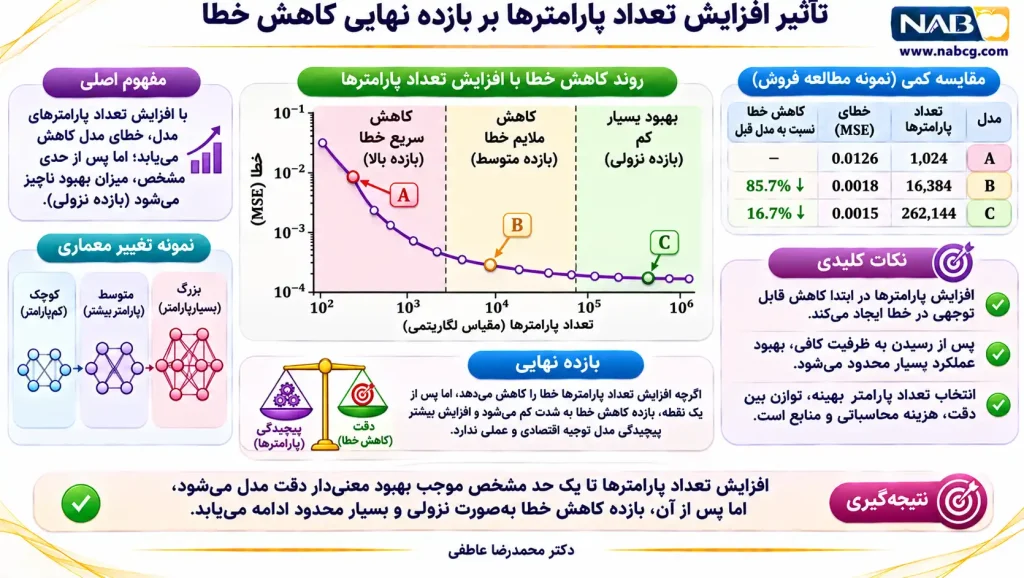
با افزایش تعداد پارامترها از ۵۰۰ به ۲۰۰۰، خطای اعتبارسنجی از ۰٫۰۸ به ۰٫۰۵ کاهش پیدا کرده است.
کاهش خطا:
اما با افزایش پارامترها از ۲۰۰۰ به ۸۰۰۰:
بنابراین، در این مثال، افزایش دوم با وجود اضافهشدن ۶۰۰۰ پارامتر، بهبود بسیار کمتری ایجاد کرده است.
این رفتار را میتوان نمونهای فرضی از کاهش بازده نهایی افزایش ظرفیت دانست. البته این الگو برای تمام مدلها و مجموعهدادهها تضمینشده نیست.
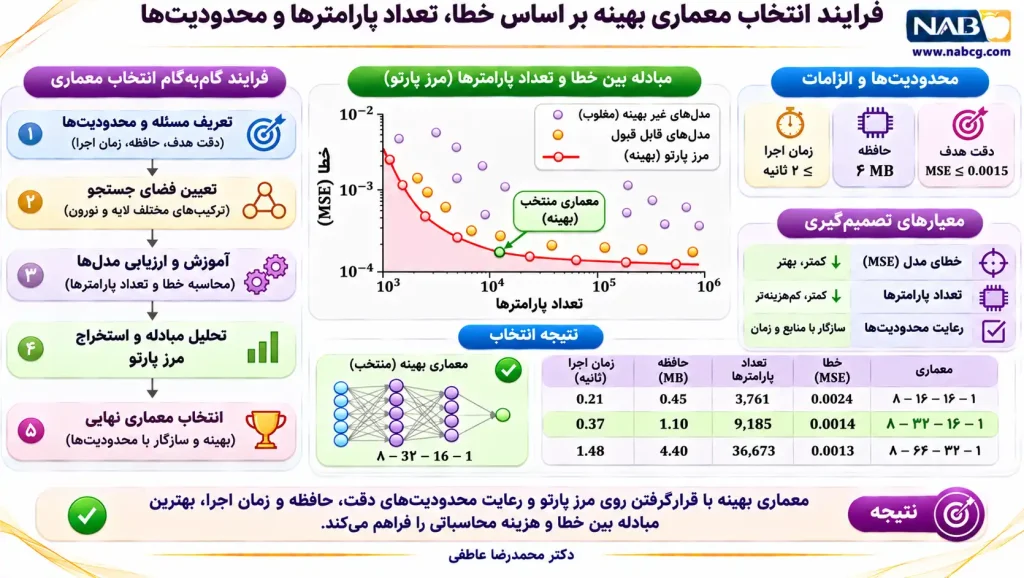
۲۷.۲. انتخاب معماری تحت محدودیت عملکرد
فرض کنید هدف پروژه دستیابی به خطای اعتبارسنجی حداکثر ۰٫۰۵ باشد و ترجیح دهیم کوچکترین مدل واجد شرایط را انتخاب کنیم.
در این صورت، مدل B مناسبترین انتخاب از میان سه معماری جدول است.
مدل A شرط خطا را رعایت نمیکند. مدل C خطای کمتری دارد، اما برای کاهش بسیار محدود خطا، تعداد پارامترهای بیشتری نیاز دارد.
این روش تصمیمگیری را میتوان چنین صورتبندی کرد:
با شرط:
در این رابطه، P(a) تعداد پارامترها و ε_max حداکثر خطای اعتبارسنجی قابل قبول است.
چنین صورتبندیای برای پروژههایی مناسب است که محدودیت سختافزاری اهمیت زیادی دارد و کیفیت موردنیاز از پیش تعیین شده است.
۲۸. بازبینی انتقادی روابط ریاضی و شکلهای فصل
برای تبدیل یک متن آموزشی به منبع دانشگاهی، صحت مفهومی بهاندازه صحت محاسبات اهمیت دارد. در این مرحله، چهار نکته از مطالب پیشین را باید در نسخه نهایی بهدقت اصلاح یا تثبیت کنیم.
۲۸.۱. اصلاح نمایش هندسی نورون ReLU دوبعدی
در بخش ۸، تابع زیر مطرح شد:
مرز فعالسازی آن برابر است با:
بنابراین بخش فعال تابع، جایی است که:
برای اینکه شکل علمی دقیق باشد، محورهای x₁ و x₂ باید با مقیاس عددی مشخص رسم شوند؛ خط مرزی باید نقاط (۰، ۳) و (۳، ۰) را قطع کند و نواحی فعال و غیرفعال بهدرستی مشخص شوند.
شکل شماتیک پیشین این اطلاعات را بهصورت مقیاسدار نشان نمیداد. در نسخه قابل انتشار باید با نمودار مختصاتی جایگزین شود.
۲۸.۲. شرط استفاده از فرمول نواحی خطی
رابطه زیر:
تعداد بیشینه نواحی حاصل از آرایش (m) ابرصفحه در وضعیت عمومی در فضای (d)بعدی را نشان میدهد.
اما برای شبکه عصبی، باید میان تعداد نواحی ناشی از الگوهای فعالسازی و تعداد قطعات آفین متمایز تابع خروجی تفاوت قائل شد.
ممکن است دو ناحیه با الگوهای فعالسازی متفاوت، تابع آفین یکسانی در خروجی تولید کنند. بنابراین شمارش نواحی فعالسازی الزاماً با شمارش قطعات آفین متمایز خروجی برابر نیست.
همچنین نتیجه مربوط به شبکه تکلایه را نمیتوان مستقیماً برای چندین لایه متوالی به کار برد.
۲۸.۳. تفسیر صحیح کرانهای ظرفیت آماری
در بخش ظرفیت آماری، از رابطه زیر استفاده شد:
این رابطه، یک کران بالای مجانبی برای خانوادههای مورد بررسی در پژوهش Bartlett و همکاران است. بهعلاوه، پژوهش مذکور کران پایین از مرتبه Ω(W·L·log(W/L)) را برای ساختارهای مناسب ارائه میکند.
بنابراین نباید عبارت (WLlog W) را فرمول محاسبه دقیق ظرفیت آماری همه شبکهها معرفی کنیم.
برای خواننده مبتدی، توضیح شهودی بُعد VC کافی است؛ تحلیل دقیقتر کرانها باید با ذکر فرضهای معماری و معنای نمادهای مجانبی انجام شود.
۲۸.۴. دقت در قضیه حداقل عرض
نتیجه Hanin و Sellke بیان میکند که برای تقریب یکنواخت توابع پیوسته اسکالر روی مکعب واحد، حداقل عرض شبکههای ReLU با عمق دلخواه برابر (d+1) است.
این قضیه درباره تقریب همه توابع یک کلاس است، نه حداقل تعداد نورون موردنیاز برای هر مسئله مشخص.
در نتیجه، کاربرد آن در طراحی عملی باید همراه با توضیح محدودیتهای قضیه باشد.
۲۹. تمرین نهایی: طراحی شبکه با محدودیت ظرفیت و حافظه
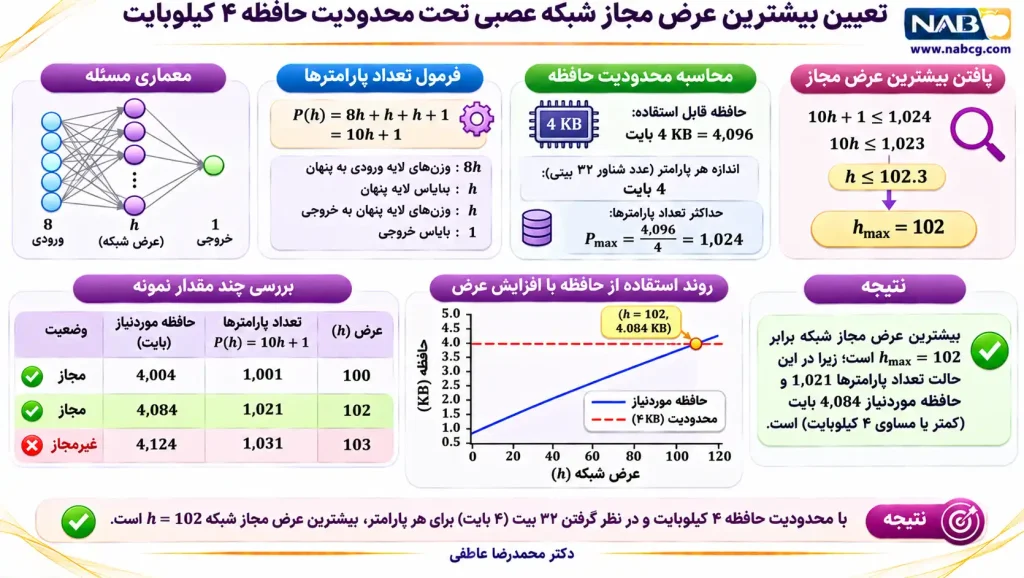
فرض کنید قصد داریم یک شبکه MLP برای یک سامانه آفلاین طراحی کنیم. سامانه دارای ۱۲ ویژگی ورودی و یک خروجی عددی است.
حافظه مجاز برای ذخیره وزنها و بایاسهای شبکه، حداکثر ۴ کیلوبایت در قالب FP32 است. در این تمرین فرض میکنیم هر کیلوبایت برابر ۱۰۲۴ بایت است و فقط حافظه خام پارامترها را محاسبه میکنیم.
میخواهیم شبکه دارای دو لایه پنهان با عرض یکسان (m) باشد:
۲۹.۱. استخراج تعداد پارامترها
- لایه اول:
- لایه دوم:
لایه خروجی:
تعداد کل پارامترها:
۲۹.۲. اعمال محدودیت حافظه
حافظه مجاز برابر است با:
با فرض چهار بایت برای هر پارامتر:
بنابراین:
و در نتیجه:
یا:
ریشه مثبت معادله متناظر:
از آنجا که عرض باید عدد صحیح باشد، بیشترین مقدار مجاز:
خواهد بود.
۲۹.۳. کنترل پاسخ
برای (m=25):
حافظه خام:
این مقدار از ۴۰۹۶ بایت کمتر است.
اما برای (m=26):
و حافظه:
بنابراین عرض ۲۶ محدودیت را نقض میکند.
تفسیر مهندسی: شبکه دارای دو لایه پنهان ۲۵نورونی، بزرگترین شبکه از خانواده تعیینشده است که وزنها و بایاسهای آن در بودجه حافظه خام قرار میگیرند. این نتیجه درباره حافظه فعالسازیها، سربار نرمافزاری یا کیفیت پیشبینی چیزی نمیگوید.
۳۰. جمعبندی نهایی
ظرفیت مدل یکی از مفاهیم بنیادی در طراحی شبکههای عصبی است، زیرا میان ساختار معماری و خانواده توابع قابل بازنمایی ارتباط برقرار میکند.
در این فصل نشان دادیم که تعداد نورونها، تعداد پارامترها، عرض و عمق شبکه، اگرچه مرتبطاند، تأثیر یکسانی بر توان بازنمایی ندارند.
از نظر ریاضی، افزایش عرض میتواند امکان ایجاد پاسخهای غیرخطی بیشتر را فراهم کند و افزایش عمق اجازه میدهد تبدیلها بهصورت متوالی ترکیب شوند. این ترکیب در برخی خانوادههای مشخصی از توابع، بازنمایی کارآمدتری ایجاد میکند؛ اما برتری عمومی شبکههای عمیقتر را تضمین نمیکند.
همچنین مشخص شد که وجود ظرفیت نظری کافی، موفقیت آموزش را تضمین نمیکند. کیفیت دادهها، الگوریتم آموزش، روش مقداردهی اولیه و محدودیتهای منابع بر عملکرد نهایی اثر دارند.
در نتیجه، طراحی شبکه را باید فرایندی مبتنی بر سه محور دانست: توان بازنمایی معماری، قابلیت آموزش و کیفیت عملکرد روی دادههای جدید.