۱. ظرفیت مدل؛ چرا اندازه شبکه عصبی اهمیت دارد؟
تصور کنید میخواهیم شبکهای عصبی بسازیم که میزان فروش روزانه یک فروشگاه اینترنتی را پیشبینی کند. ورودیهای شبکه شامل قیمت محصول، درصد تخفیف، هزینه تبلیغات و تعداد بازدیدکنندگان است.
در نخستین آزمایش، از شبکهای با چهار ورودی، سه نورون پنهان و یک خروجی استفاده میکنیم. ممکن است شبکه بتواند روند کلی فروش را شناسایی کند، اما در بازنمایی روابط پیچیده میان تخفیف، تبلیغات و رفتار مشتریان محدود باشد.
اکنون تعداد نورونهای پنهان را از سه به بیست افزایش میدهیم. شبکه جدید دارای تعداد بیشتری پارامتر قابلآموزش خواهد بود و میتواند خانواده گستردهتری از روابط را بازنمایی کند.
اما آیا پیشبینیهای آن نیز بهتر خواهد شد؟
پاسخ الزاماً مثبت نیست.
اگر رابطه واقعی میان متغیرها ساده باشد، شبکه کوچکتر ممکن است بهاندازه کافی توانمند باشد. حتی اگر رابطه پیچیده باشد، شبکه بزرگتر ممکن است به دلیل آموزش نامناسب، داده ناکافی یا مشکلات تعمیمپذیری عملکرد مطلوبی نداشته باشد.
برای تحلیل این مسئله به مفهوم ظرفیت مدل نیاز داریم.
ظرفیت مدل (Model Capacity) به گستردگی و پیچیدگی خانواده توابعی اشاره دارد که یک مدل میتواند با انتخاب مقادیر مختلف پارامترهایش بازنمایی کند.
در شبکه عصبی، ظرفیت بازنمایی تحت تأثیر عواملی مانند تعداد نورونها، تعداد لایهها، نوع تابع فعالسازی و ساختار اتصالها قرار دارد.
برای درک دقیقتر، ابتدا باید تفاوت میان اندازه شبکه و ظرفیت آن را روشن کنیم.
۱.۱. اندازه شبکه و ظرفیت بازنمایی یکسان نیستند
اندازه شبکه معمولاً با تعداد پارامترهای قابلآموزش یا تعداد نورونها توصیف میشود.
برای مثال، ممکن است شبکهای ۱۰ هزار پارامتر و شبکه دیگری یک میلیون پارامتر داشته باشد.
این اطلاعات نشان میدهند شبکه دوم از نظر تعداد پارامترها بزرگتر است. اما از آنها نمیتوان نتیجه گرفت که شبکه دوم برای هر مسئله عملکرد بهتری دارد یا حتی برای هر خانواده تابعی از شبکه اول کارآمدتر است.
تفاوت در آرایش لایهها ممکن است باعث شود دو شبکه با تعداد پارامتر یکسان، توانایی متفاوتی در نمایش برخی توابع داشته باشند.
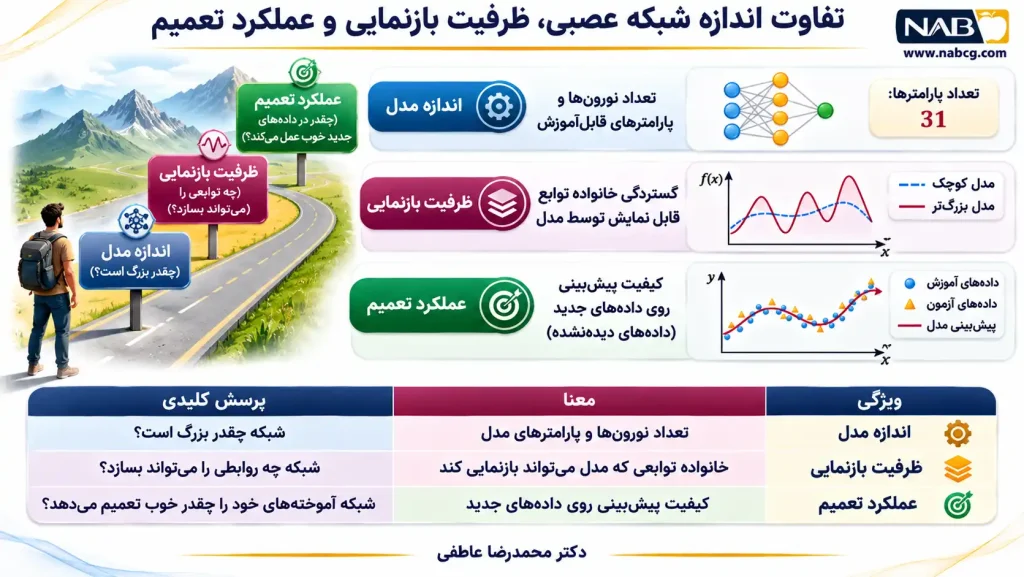
بنابراین، باید میان سه ویژگی تمایز قائل شویم:
| ویژگی | معنا | پرسش اصلی |
| اندازه مدل | تعداد نورونها و پارامترها | شبکه چقدر بزرگ است؟ |
| ظرفیت بازنمایی | خانواده توابع قابل نمایش | شبکه چه روابطی را میتواند بسازد؟ |
| عملکرد تعمیم | کیفیت پیشبینی روی دادههای جدید | شبکه آموختههای خود را چقدر خوب تعمیم میدهد؟ |
این تمایز از مبانی تحلیل معماری شبکههای عصبی است (Goodfellow et al., 2016; Prince, 2023).
۱.۲. از مدل خطی تا شبکه عصبی غیرخطی
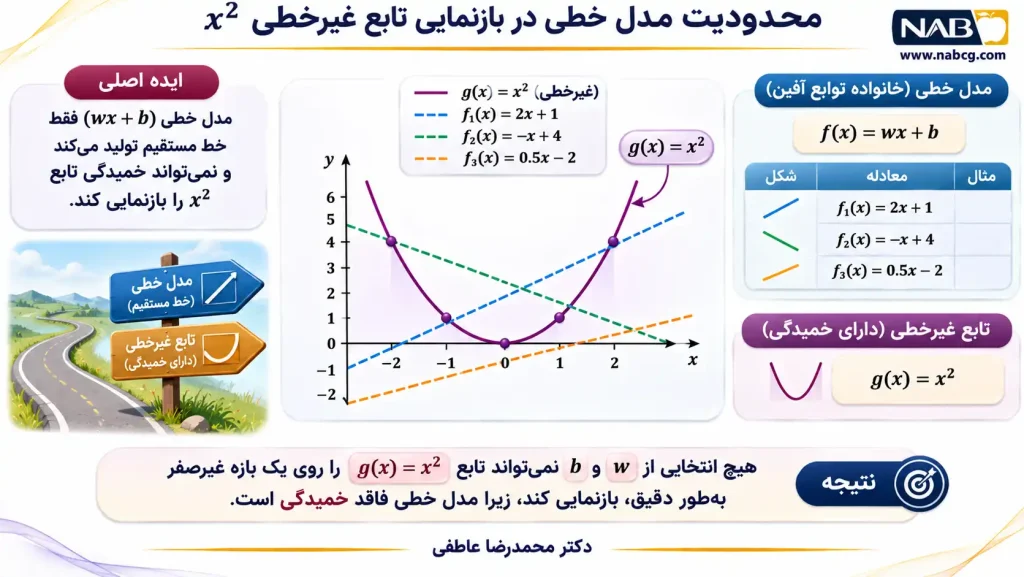
برای مشاهده تفاوت ظرفیت، ابتدا یک تابع خطی ساده را در نظر بگیرید:
با تغییر وزن (w) و بایاس (b)، میتوان خطوط مستقیم متفاوتی تولید کرد.
برای مثال:
هر سه عضو یک خانواده تابعی هستند: توابع آفین تکمتغیره.
اما هیچ انتخابی از (w) و (b) نمیتواند تابع زیر را روی کل یک بازه غیرصفر دقیقاً بازنمایی کند:
علت آن است که (g(x)) دارای خمیدگی است، درحالیکه (wx+b) یک خط مستقیم است.
این محدودیت ناشی از کم بودن دادههای آموزشی نیست؛ بلکه نتیجه ساختار ریاضی مدل است.
حال اگر از یک شبکه عصبی دارای نورونهای غیرخطی استفاده کنیم، میتوانیم توابعی بسازیم که در بخشهای مختلف ورودی رفتار متفاوتی دارند.
در چنین شرایطی، ظرفیت بازنمایی افزایش مییابد.
۲. تعریف ریاضی ظرفیت بازنمایی
شبکه عصبی را میتوان تابعی پارامتری دانست:
در این رابطه، x بردار ورودی، ŷ خروجی شبکه و θ مجموعه پارامترهای قابلآموزش است.
برای معماری معین، همه توابع قابل تولید را میتوان در یک مجموعه قرار داد:
این مجموعه را کلاس فرضیهها (Hypothesis Class) مینامیم.
برای مثال، کلاس تمام توابع آفین یکبعدی برابر است با:
اکنون یک شبکه با یک لایه پنهان ReLU را در نظر بگیرید:
در این رابطه، m تعداد نورونهای پنهان است و aⱼ، wⱼ، bⱼ و c پارامترهای قابلآموزش هستند.
تغییر این پارامترها میتواند توابع تکهایخطی متعددی ایجاد کند.
بنابراین، ظرفیت بازنمایی شبکه به خانواده توابعی ارتباط دارد که این ساختار قادر به تولید آنهاست.
۲.۱. ظرفیت بازنمایی در برابر ظرفیت مؤثر
فرض کنید معماری شبکه میتواند تابع هدف را با خطای بسیار کم تقریب بزند. آیا این به معنای موفقیت قطعی آموزش است؟
خیر.
ممکن است الگوریتم آموزش نتواند پارامترهایی را پیدا کند که این تقریب را محقق میکنند.
ازاینرو باید دو مفهوم را تفکیک کنیم.
ظرفیت بازنمایی (Representational Capacity)، توانایی نظری معماری برای نمایش توابع است.
ظرفیت مؤثر (Effective Capacity)، به پیچیدگی توابعی مربوط میشود که در شرایط عملی آموزش قابل دستیابی هستند؛ از جمله با درنظرگرفتن دادهها، مقداردهی اولیه، بهینهساز و محدودیتهای محاسباتی.
برای مثال، یک شبکه دارای هزاران پارامتر ممکن است از نظر نظری بسیار انعطافپذیر باشد، اما پس از تعداد بسیار کمی گام آموزش، هنوز نتواند حتی یک رابطه ساده را بهخوبی بازنمایی کند.
در این حالت، مشکل الزاماً از ظرفیت نظری نیست.
۳. تعداد نورونها و تأثیر آن بر پیچیدگی تابع
برای درک این موضوع، شبکهای با یک ورودی و یک لایه پنهان دارای نورونهای ReLU را بررسی میکنیم.
تابع ReLU به شکل زیر تعریف میشود:
این تابع، ورودیهای منفی را به صفر تبدیل میکند و ورودیهای مثبت را بدون تغییر عبور میدهد.
۳.۱. مثال اول: یک نورون ReLU
فرض کنید تابع شبکه برابر باشد با:
برای ورودیهای کمتر از دو:
و برای ورودیهای بزرگتر از دو:
بنابراین:
این نورون، تابعی با یک نقطه شکست در (x=2) ایجاد میکند.
۳.۲. مثال دوم: دو نورون ReLU
اکنون تابع زیر را میسازیم:
دو نورون پنهان داریم:
و خروجی آنها ترکیب میشود:
جدول زیر محاسبات را نشان میدهد.
| x | h₁(x) | h₂(x) | f(x) |
|---|---|---|---|
| ۰ | ۰ | ۰ | ۰ |
| ۱ | ۰ | ۰ | ۲ |
| ۱ | ۰ | ۱ | ۳ |
| ۲ | ۰ | ۲ | ۴ |
| ۳ | ۱ | ۲ | ۵ |
| ۴ | ۲ | ۲ | ۵ |
تابع نهایی:
این بار تابع دارای دو نقطه شکست است.
شکل ۱. تابع ساختهشده با دو نورون ReLU؛ دو نقطه شکست، سه ناحیه خطی ایجاد کردهاند.
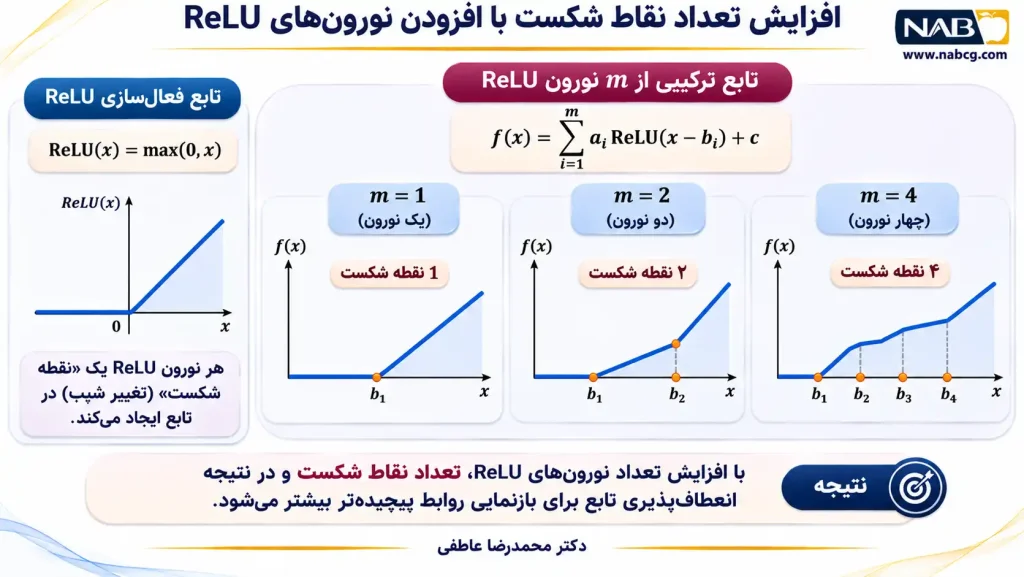
در این مثال، افزایش تعداد نورونها از یک به دو، توانسته تعداد نقاط شکست قابل ایجاد را افزایش دهد.
برای یک شبکه تکورودی دارای یک لایه پنهان با (m) نورون ReLU، تعداد نقاط شکست متمایز حداکثر برابر (m) است.
در نتیجه:
این نتیجه محدود به ساختار ذکرشده است و نباید بدون بررسی به شبکههای چندلایه یا چندورودی تعمیم داده شود.
۴. تعداد پارامترها و رابطه آن با عرض و عمق
تعداد پارامترها، یکی از مهمترین ویژگیهای کمی اندازه شبکه است.
در یک شبکه کاملاً متصل، هر نورون در یک لایه، از تمام خروجیهای لایه قبل وزن دریافت میکند و معمولاً یک بایاس مستقل نیز دارد.
اگر یک لایه دارای n_in ورودی و n_out خروجی باشد، تعداد وزنها برابر است با:
تعداد بایاسها:
پس:
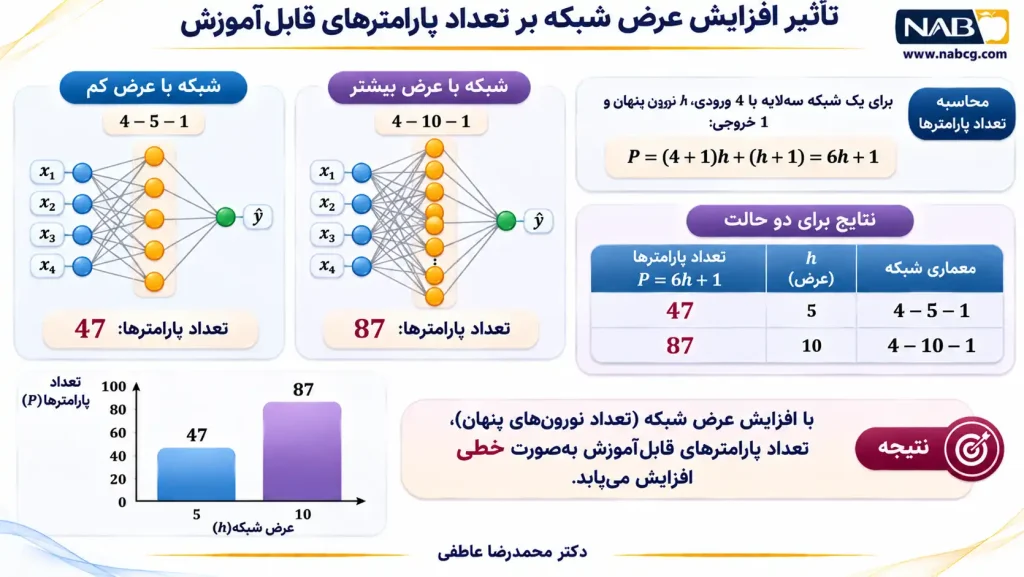
۴.۱. مثال عددی: شبکه پیشبینی فروش
معماری زیر را در نظر بگیرید:
- تعداد پارامترهای لایه اول:
- تعداد پارامترهای لایه دوم:
- تعداد پارامترهای لایه خروجی:
پس:
اکنون عرض لایه اول را از پنج به ده نورون افزایش میدهیم:
تعداد پارامترها:
با افزودن پنج نورون به لایه اول، تعداد پارامترها از ۴۷ به ۸۷ افزایش یافته است.
این موضوع نشان میدهد که افزودن نورون به یک لایه، علاوه بر وزنها و بایاسهای همان لایه، تعداد وزنهای ورودی لایه بعد را نیز تغییر میدهد.
۴.۲. فرمول عمومی برای شبکه چندلایه
اگر عرض لایههای متوالی برابر n₀، n₁، …، n_L باشد، تعداد کل پارامترهای شبکه کاملاً متصل با بایاس مستقل در هر لایه دارای وزن، برابر است با:
در این رابطه:
- n₀: تعداد ویژگیهای ورودی
- n_ℓ: تعداد نورونهای لایه ℓ
- L: تعداد لایههای دارای وزن، شامل لایه خروجی
این رابطه پایه بسیاری از محاسبات مهندسی مربوط به اندازه شبکه است.
۵. چرا عرض و عمق آثار متفاوتی دارند؟
- افزایش عرض (Width) یعنی افزودن نورون به یک یا چند لایه موجود.
- افزایش عمق (Depth) یعنی افزودن لایههای محاسباتی متوالی.
در یک شبکه عریض، نورونهای یک لایه تبدیلهای مختلفی را بهصورت موازی محاسبه میکنند.
در شبکه عمیق، خروجی هر لایه به ورودی لایه بعد تبدیل میشود؛ بنابراین شبکه میتواند ترکیبی از چند تبدیل غیرخطی را محاسبه کند.
برای سه تبدیل متوالی:
در نتیجه:
این ترکیب متوالی، پایه توان بازنمایی ساختارهای عمیق است.
پژوهشهای Montúfar و همکاران (۲۰۱۴) و Telgarsky (۲۰۱۶) نشان دادهاند که برای خانوادههای مشخصی از توابع، عمق میتواند مزایای قابلتوجهی در بازنمایی ایجاد کند.
بااینحال، برای تابعی که ساختار سادهای دارد، افزودن لایههای بیشتر ممکن است هیچ مزیت عملی ایجاد نکند.
در نسخه یکپارچه، تحلیل مقایسهای این دو عامل باید با مثالهایی که بودجه پارامتر مشابه دارند ادامه یابد؛ زیرا مقایسه صرف یک شبکه بزرگ و یک شبکه کوچک، اثر عمق را از اثر تعداد پارامترها جدا نمیکند.
۶. مقایسه عمق و عرض شبکه با تعداد پارامتر تقریباً برابر
در بخش پیشین دریافتیم که عرض و عمق شبکه دو ویژگی متفاوت معماری هستند. افزایش عرض به شبکه اجازه میدهد تبدیلهای بیشتری را بهصورت موازی انجام دهد، درحالیکه افزایش عمق امکان ترکیب متوالی تبدیلها را فراهم میسازد.
اما هنوز یک پرسش مهم باقی مانده است: اگر دو شبکه تقریباً تعداد پارامتر یکسانی داشته باشند، آیا میتوانند توابع متفاوتی را بازنمایی کنند؟
این پرسش از نظر علمی اهمیت فراوانی دارد؛ زیرا اگر یک شبکه ۱۰۰ پارامتر و شبکه دیگر ۱۰ هزار پارامتر داشته باشد، نمیتوان تفاوت توانایی آنها را فقط به عمق نسبت داد. شبکه بزرگتر هم از نظر تعداد لایهها و هم از نظر تعداد پارامترها متفاوت است.
برای مقایسه منصفانهتر، باید دو معماری انتخاب کنیم که بودجه پارامتر تقریباً یکسانی داشته باشند.
۶.۱. مثال حلشده: دو معماری برای پیشبینی فروش
فرض کنید شبکه قرار است فروش یک محصول را با استفاده از چهار متغیر پیشبینی کند:
قیمت محصول، درصد تخفیف، بودجه تبلیغات و تعداد بازدیدکنندگان فروشگاه.
دو شبکه زیر را طراحی میکنیم.
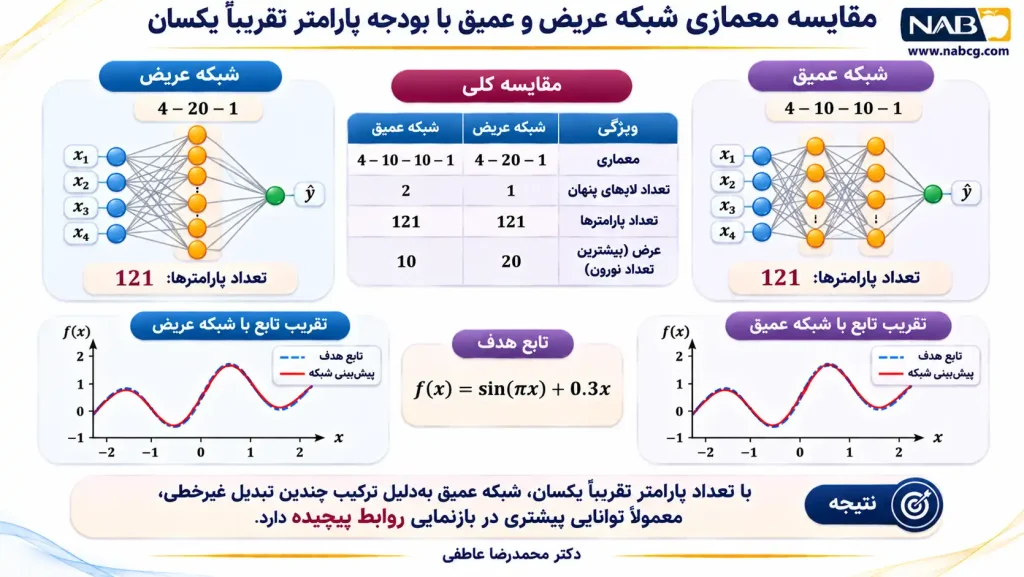
شبکه A: کمعمق و عریض
این شبکه تنها یک لایه پنهان با ۱۴ نورون دارد.
تعداد پارامترها:
شبکه B: عمیقتر و باریکتر
این شبکه دارای دو لایه پنهان است.
- تعداد پارامترهای لایه اول:
- تعداد پارامترهای لایه دوم:
- تعداد پارامترهای لایه خروجی:
بنابراین:
اختلاف تعداد پارامترها برابر است با:
از نظر تعداد پارامتر، دو شبکه بسیار نزدیکاند؛ اما معماری آنها متفاوت است.
۶.۲. تفاوت محاسباتی دو معماری
در شبکه A، هر یک از ۱۴ نورون پنهان مستقیماً روی چهار ویژگی ورودی محاسبه انجام میدهد.
خروجی را میتوان بهشکل زیر نوشت:
اما در شبکه B، لایه دوم روی بازنمایی تولیدشده در لایه اول محاسبه میکند:
به همین دلیل، شبکه دوم قادر است توابعی را بسازد که حاصل ترکیب متوالی دو مجموعه تبدیل غیرخطی هستند.
این دو معماری کلاس توابع متفاوتی دارند. بااینحال، هیچکدام الزاماً برای تمام مسائل از دیگری بهتر نیست.
در طراحی شبکه باید میان توان بازنمایی نظری و عملکرد تجربی پس از آموزش تفاوت قائل شد.
۶.۳. آیا شبکه عمیقتر همیشه ظرفیت بیشتری دارد؟
پاسخ به معنایی که از ظرفیت در نظر میگیریم بستگی دارد.
در برخی خانوادههای مشخصی از توابع، شبکههای عمیق توان بازنمایی کارآمدتری نسبت به شبکههای کمعمق دارند. برای مثال، نتایج Telgarsky (2016) نشان میدهند که برخی توابع با شبکههای عمیق کوچک قابل بازنماییاند، درحالیکه تقریب آنها با شبکههای کمعمق ممکن است به تعداد بسیار بیشتری نورون نیاز داشته باشد.
اما اگر تابع هدف بسیار ساده باشد، شبکه کمعمق ممکن است همان خروجی را با هزینه کمتر تولید کند.
بنابراین، عمق بیشتر یک مزیت ساختاری بالقوه است، نه تضمین عمومی عملکرد بهتر.
۷. چگونه عمق میتواند پیچیدگی تابع خروجی را افزایش دهد؟
برای درک نقش عمق، یک تابع مثلثی ساده را بررسی میکنیم که میتوان آن را با نورونهای ReLU تولید کرد.
تابع را چنین تعریف میکنیم:
برای ورودیهای بازه ([0,1])، این تابع برابر است با:
این تابع ابتدا افزایش مییابد و سپس کاهش پیدا میکند.
۷.۱. محاسبه تابع در چند نقطه
| (x) | (g(x)) |
| ۰ | ۰ |
| ۰٫۲۵ | ۰٫۵ |
| ۰٫۵ | ۱ |
| ۰٫۷۵ | ۰٫۵ |
| ۱ | ۰ |
اکنون بهجای استفاده یکباره از تابع، خروجی آن را دوباره به خودش وارد میکنیم:
برای مثال، اگر (x=0.25) باشد:
اگر (x=0.5) باشد:
جدول زیر مقادیر را نشان میدهد:
| (x) | (g(x)) | (g(g(x))) |
| ۰ | ۰ | ۰ |
| ۰٫۱۲۵ | ۰٫۲۵ | ۰٫۵ |
| ۰٫۲۵ | ۰٫۵ | ۱ |
| ۰٫۳۷۵ | ۰٫۷۵ | ۰٫۵ |
| ۰٫۵ | ۱ | ۰ |
| ۰٫۷۵ | ۰٫۵ | ۱ |
| ۱ | ۰ | ۰ |
تابع اولیه یک قله داشت، اما تابع حاصل از دو بار اعمال (g)، دو قله دارد.
۷.۲. نمایش افزایش تعداد قلهها
شکل ۳. افزایش تعداد قلهها از ۱ به ۲ و سپس ۴ بر اثر ترکیب متوالی تابع مثلثی.
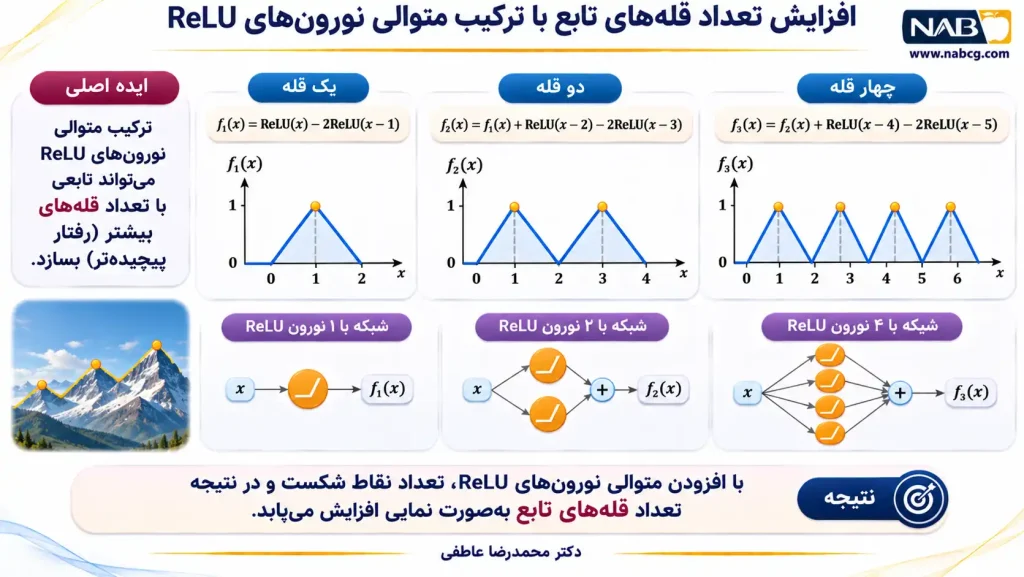
اگر این تابع را (k) بار با خودش ترکیب کنیم، تعداد قلههای آن روی بازه ([0,1]) برابر است با:
و تعداد قطعات خطی آن:
برای مثال، پس از پنج مرحله:
نکته علمی مهم این است که افزایش خطی تعداد مراحل ترکیب، در این مثال خاص باعث افزایش نمایی تعداد قطعات خطی میشود.
این ساختار پایهای برای درک مزیت عمق در برخی خانوادههای توابع است. البته رشد نمایی نواحی خطی برای تمام وزنها و همه معماریها تضمین نمیشود (Montúfar et al., 2014; Telgarsky, 2016).
۸. ظرفیت بازنمایی در فضای چندبعدی؛ از نقاط شکست تا مرزهای تصمیم
در مثالهای پیشین، ورودی شبکه تنها یک متغیر بود. در این حالت، میتوانستیم پیچیدگی تابع را با شمارش نقاط شکست و قطعات خطی بررسی کنیم.
اما در مسائل واقعی، شبکه معمولاً چندین ویژگی ورودی دارد. برای مثال، یک شبکه پیشبینی فروش ممکن است بهطور همزمان قیمت، تخفیف، تبلیغات و تعداد مشتریان را دریافت کند.
در این وضعیت، دیگر فقط با نقاط شکست روی یک محور روبهرو نیستیم؛ بلکه شبکه فضای چندبعدی ورودی را به نواحی مختلف تقسیم میکند.
۸.۱. چگونه یک نورون ReLU فضای ورودی را تقسیم میکند؟
یک نورون با دو ورودی را در نظر بگیرید:
این نورون ابتدا مقدار زیر را محاسبه میکند:
سپس:
مرز تغییر رفتار نورون جایی قرار دارد که:
بنابراین:
این معادله یک خط مستقیم در فضای دوبعدی است.
شکل ۴. نمایش شماتیک دو ناحیه فعال و غیرفعال یک نورون ReLU در فضای دوبعدی. مکان خط برای نمایش مفهومی انتخاب شده است.
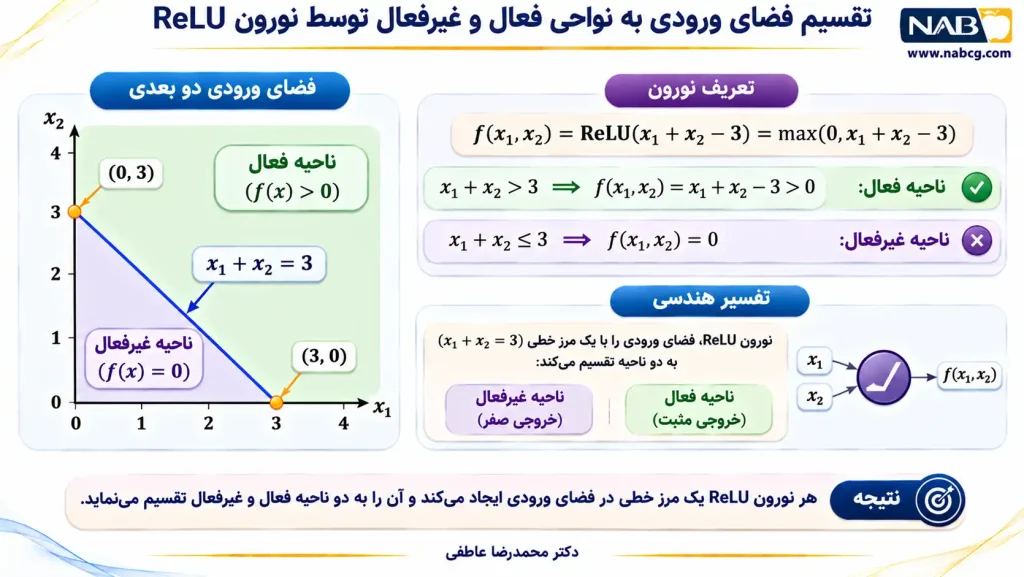
در یک سمت خط، خروجی نورون صفر است. در سمت دیگر، خروجی برابر ترکیبی خطی از ورودیها خواهد بود.
وقتی تعداد نورونها افزایش مییابد، خطوط یا در ابعاد بالاتر، ابرصفحههای بیشتری میتوانند در فضای ورودی ایجاد شوند.
این ابرصفحهها فضا را به نواحی متفاوتی تقسیم میکنند.
۸.۲. حداکثر تعداد نواحی حاصل از ابرصفحهها
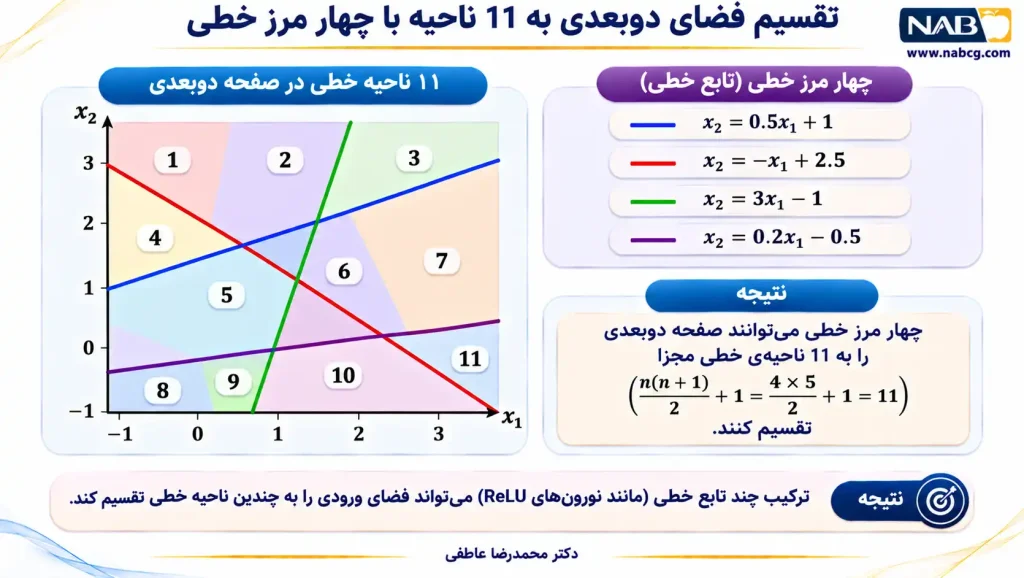
در هندسه محاسباتی، اگر (m) ابرصفحه در فضای (d)بعدی در وضعیت عمومی قرار داشته باشند، حداکثر تعداد نواحی حاصل از تقسیم فضا برابر است با:
که در آن، ضرایب دوجملهای برای (j>m) صفر در نظر گرفته میشوند.
برای یک شبکه تکلایه پنهان ReLU، این رابطه کران بالایی برای تعداد نواحی ناشی از الگوهای فعالسازی نورونها فراهم میکند. تعداد نواحی آفین متمایز تابع خروجی ممکن است کمتر باشد.
برای فضای دوبعدی:
و چهار نورون:
داریم:
بنابراین چهار خط در وضعیت عمومی میتوانند صفحه را حداکثر به ۱۱ ناحیه تقسیم کنند.
این نتیجه نشان میدهد که حتی یک لایه پنهان نیز، با افزایش تعداد نورونها، قادر به ایجاد ساختارهای هندسی متنوعی است.
۸.۳. تأثیر بُعد ورودی بر تعداد نواحی
حال تعداد نورونها را ثابت و برابر چهار در نظر بگیریم، اما بُعد فضای ورودی را تغییر دهیم.
| بُعد فضای ورودی | تعداد نورونها | حداکثر نواحی |
| ۱ | ۴ | ۵ |
| ۲ | ۴ | ۱۱ |
| ۳ | ۴ | ۱۵ |
| ۴ | ۴ | ۱۶ |
این جدول نشان میدهد که ظرفیت هندسی شبکه را نمیتوان مستقل از بُعد ورودی بررسی کرد.
اما بیشتر بودن تعداد نواحی لزوماً به معنای بهتر بودن پیشبینی یا توان بازنمایی تمام توابع نیست. تعداد نواحی تنها یکی از شاخصهای پیچیدگی ساختار تابع شبکه است.
۹. چرا چندلایه بودن میتواند تعداد نواحی را بسیار افزایش دهد؟
در یک شبکه با یک لایه پنهان، نورونهای ReLU فضای ورودی را از طریق ابرصفحهها تقسیم میکنند.
در شبکه چندلایه، اتفاق پیچیدهتری رخ میدهد: لایههای بعدی روی فضایی محاسبه میکنند که پیشتر توسط لایههای قبلی تبدیل شده است.
به این ترتیب، شبکه میتواند نواحی مختلف ورودی را بهصورت متوالی تبدیل، تفکیک و دوباره ترکیب کند.
Montúfar و همکاران (۲۰۱۴) نشان دادهاند که این ساختار ترکیبی میتواند باعث افزایش چشمگیر تعداد نواحی خطی قابل بازنمایی با عمق شود.
برای یک شبکه ReLU با d ورودی و L لایه پنهان که هرکدام عرض n ≥ d دارند، یکی از کرانهای پایین شناختهشده در شرایط مشخص چنین است:
این فرمول نشاندهنده تعداد نواحیای است که دستکم برای برخی انتخابهای پارامترها قابل دستیابی است؛ نه تعداد نواحی ایجادشده توسط هر شبکه آموزشدیده.
برای درک شهودی، فرض کنید:
آنگاه:
و:
این محاسبه به ما میگوید که در خانواده مورد بررسی، معماری دارای سه لایه پنهان با عرض چهار میتواند حداقل ۱۷۶ ناحیه خطی ایجاد کند.
این یک نتیجه درباره توان بازنمایی بالقوه معماری است و هیچ ادعایی درباره دقت یا کیفیت تعمیم شبکه مطرح نمیکند.
۹.۱. نکته پژوهشی
تفاوت کران بالا و پایین اهمیت زیادی دارد.
کران بالا به ما میگوید تعداد نواحی نمیتواند از حد مشخصی فراتر رود.
کران پایین وجود ساختاری با دستکم آن تعداد ناحیه را تضمین میکند.
این دو مفهوم نباید با تعداد واقعی نواحی ایجادشده در یک شبکه آموزشدیده اشتباه گرفته شوند.
۱۰. ارتباط ظرفیت شبکه با سوگیری استقرایی
دو شبکه ممکن است از نظر ظرفیت بازنمایی بسیار قدرتمند باشند، اما هنگام آموزش رفتار متفاوتی نشان دهند.
یکی از دلایل این تفاوت، سوگیری استقرایی (Inductive Bias) است؛ یعنی فرضها و ترجیحهایی که ساختار مدل یا الگوریتم یادگیری درباره شکل پاسخ مناسب ایجاد میکند.
برای مثال، معماری یک شبکه کاملاً متصل با معماری یک شبکه کانولوشنی متفاوت است. شبکه کانولوشنی از اتصالهای موضعی و اشتراک وزن استفاده میکند و در نتیجه نوع خاصی از ساختار را در پردازش دادهها ترجیح میدهد.
اما در همین خانواده MLP نیز عمق، عرض، نحوه مقداردهی اولیه و روش آموزش میتوانند بر توابعی که شبکه عملاً یاد میگیرد اثر بگذارند.
در نتیجه:
شبکهای ممکن است از نظر نظری بتواند چندین تابع متفاوت را نمایش دهد، اما الگوریتم آموزش بهطور مداوم به زیرمجموعهای از آنها گرایش پیدا کند.
این موضوع یکی از دلایلی است که چرا ظرفیت بالاتر، تضمین عملکرد بهتر روی دادههای جدید نیست.
۱۱. انتخاب معماری بر اساس نوع مسئله
اکنون میتوانیم مباحث نظری را به یک تصمیم طراحی متصل کنیم.
- اگر مسئله دارای روابط تقریباً خطی باشد، یک مدل ساده ممکن است کافی باشد.
- اگر تابع هدف دارای تغییرات موضعی متعدد باشد، افزایش عرض میتواند کمک کند.
- اگر ساختار تابع هدف شامل ترکیبهای سلسلهمراتبی باشد، افزایش عمق ممکن است بازنمایی کارآمدتری ایجاد کند.
اما این موارد، اصول راهنمای مهندسی هستند و نه قوانین قطعی.
| ویژگی مسئله | گزینه معماری قابل بررسی | دلیل |
| رابطه تقریباً خطی | مدل خطی یا MLP کوچک | ظرفیت محدود ممکن است کافی باشد |
| روابط غیرخطی با تغییرات متعدد | افزایش عرض | امکان بازنمایی پاسخهای موضعی متنوع |
| ساختار ترکیبی و سلسلهمراتبی | افزایش عمق | استفاده از ترکیب متوالی توابع |
| منابع سختافزاری محدود | MLP فشرده | کاهش پارامتر و هزینه استنتاج |
| عملکرد نامناسب روی دادههای جدید | بررسی تعمیم و آموزش | ظرفیت بیشتر الزاماً راهحل نیست |
در تصمیمگیری نهایی، لازم است چند معماری با پروتکل اعتبارسنجی یکسان مقایسه شوند.
۱۲. تمرین حلشده: محاسبه ظرفیت هندسی یک لایه
فرض کنید لایه پنهان شبکهای دارای پنج نورون ReLU باشد و ورودیها دوبعدی باشند.
میخواهیم حداکثر تعداد نواحی حاصل از الگوهای فعالسازی لایه را محاسبه کنیم.
- مرحله اول: تعیین دادهها
- مرحله دوم: استفاده از فرمول
- مرحله سوم: جایگذاری
- مرحله چهارم: محاسبه ضرایب
- مرحله پنجم: نتیجه نهایی
بنابراین پنج نورون ReLU با ابرصفحههای مرزی در وضعیت عمومی میتوانند فضای ورودی دوبعدی را به حداکثر ۱۶ ناحیه تقسیم کنند.
این مثال، رابطه میان تعداد نورونها، بُعد ورودی و پیچیدگی هندسی بازنمایی را نشان میدهد.
منابع علمی
Montúfar, G., Pascanu, R., Cho, K., & Bengio, Y. (2014). On the number of linear regions of deep neural networks. Advances in Neural Information Processing Systems, 27, 2924–2932.
Telgarsky, M. (2016). Benefits of depth in neural networks. Proceedings of Machine Learning Research, 49, 1517–1539.
۱۳. حداقل عرض شبکه و محدودیتهای تقریب عمومی
در طراحی شبکههای عصبی، معمولاً تصور میشود که اگر تعداد لایهها را بهاندازه کافی افزایش دهیم، محدودیت تعداد نورونها جبران خواهد شد.
این تصور همیشه صحیح نیست.
برای درک علت، باید میان دو مفهوم تفاوت قائل شویم:
تقریب یک تابع مشخص و توانایی تقریب همه توابع یک خانواده معین.
برای مثال، تابع ساده زیر را در نظر بگیرید:
این تابع با یک نورون خروجی خطی، دارای دو وزن و یک بایاس، قابل بازنمایی دقیق است.
اما اگر هدف این باشد که یک خانواده معماری بتواند هر تابع پیوسته دلخواه را روی یک دامنه مشخص با دقت دلخواه تقریب بزند، مسئله بسیار دشوارتر میشود.
۱۳.۱. مفهوم تقریب عمومی
فرض کنید تابع هدف (f) روی یک دامنه بسته و کراندار (K) تعریف شده است و میخواهیم شبکه عصبی (hat f) را چنان انتخاب کنیم که:
برای تمام:
در این رابطه، ε میزان خطای مجاز است.
اگر یک خانواده شبکه بتواند برای هر تابع پیوسته (f) و هر مقدار مثبت (ε)، شبکهای مناسب پیدا کند که شرط بالا برقرار باشد، آن خانواده دارای خاصیت تقریب عمومی یکنواخت روی دامنه موردنظر است.
دقت کنید که «تقریب عمومی» تضمین نمیکند شبکه با تعداد کمی نورون، داده محدود یا هزینه محاسباتی اندک آموزش داده شود.
۱۳.۲. چرا حداقل عرض اهمیت دارد؟
برای شبکههای ReLU، نتایج نظری نشان دادهاند که عرض لایهها میتواند محدودیت بنیادی بر توان تقریب ایجاد کند.
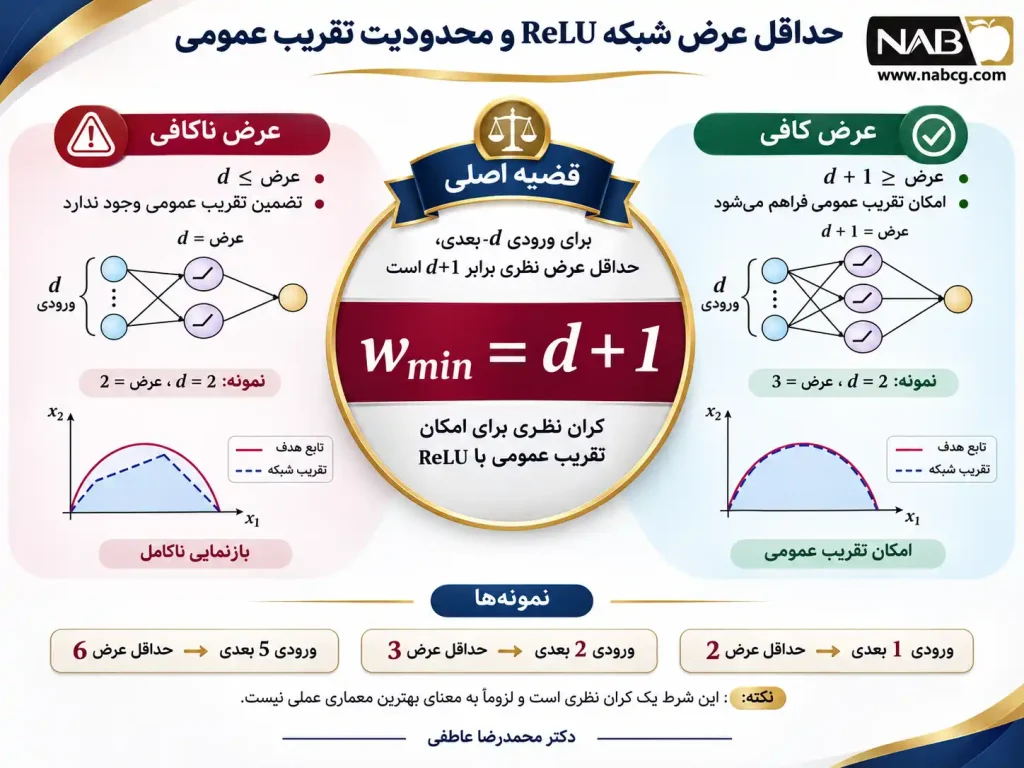
یکی از نتایج شناختهشده در این زمینه متعلق به Hanin و Sellke است. در مسئله تقریب یکنواخت توابع پیوسته اسکالر روی مکعب واحد (d)بعدی، شبکههای ReLU با عرض پنهان حداکثر (d) برای تقریب تمام این توابع کافی نیستند؛ درحالیکه عرض (d+1)، با عمق متغیر و کافی، امکان تقریب عمومی را فراهم میکند (Hanin & Sellke, 2017).
در این صورتبندی:
که (d) تعداد ابعاد ورودی است.
برای مثال، اگر تعداد ویژگیهای ورودی چهار باشد:
حداقل عرض نظری در چارچوب قضیه مذکور:
خواهد بود.
| تعداد ورودیها (d) | حداقل عرض (d+1) |
| ۱ | ۲ |
| ۲ | ۳ |
| ۳ | ۴ |
| ۴ | ۵ |
| ۸ | ۹ |
| ۱۶ | ۱۷ |
جدول ۱. حداقل عرض نظری شبکههای ReLU برای خاصیت تقریب عمومی یکنواخت توابع پیوسته اسکالر روی مکعب واحد در صورتبندی موردبحث.
نباید این نتیجه را به یک دستورالعمل مهندسی عمومی تبدیل کرد. برای مثال، این قضیه نمیگوید شبکهای با ۱۶ ویژگی ورودی الزاماً باید دستکم ۱۷ نورون در هر لایه داشته باشد تا یک مسئله پیشبینی واقعی را حل کند.
یک تابع خاص ممکن است با عرض بسیار کمتر نیز قابل بازنمایی باشد.
همچنین این نتیجه به نوع تابع فعالسازی، نوع خروجی، دامنه و معیار تقریب وابسته است؛ بنابراین تعمیم آن به تمام معماریها صحیح نیست.
۱۳.۳. پیام معماری قضیه حداقل عرض
نتیجه اصلی این است که عمق و عرض قابلیت جایگزینی نامحدود ندارند.
افزایش عمق میتواند برای بازنمایی برخی توابع مزیت ایجاد کند، اما اگر معماری از نظر عرض با محدودیتی بنیادی روبهرو باشد، صرف افزودن لایههای بیشتر لزوماً آن محدودیت را برطرف نمیکند.
این موضوع بهویژه هنگام طراحی شبکههای بسیار باریک و عمیق اهمیت دارد.
۱۴. ظرفیت بازنمایی و ظرفیت مؤثر: از امکان ریاضی تا یادگیری واقعی
تصور کنید شبکهای با ۱۰۰ هزار پارامتر طراحی کردهایم. این شبکه از نظر معماری قادر است توابع بسیار متنوعی را نمایش دهد.
حال فرض کنید آموزش آن را فقط برای چند گام انجام دهیم.
آیا میتوان انتظار داشت صرفاً به دلیل تعداد زیاد پارامترها، تابع مطلوب را یاد گرفته باشد؟
خیر.
ظرفیت بازنمایی به آنچه یک معماری بالقوه میتواند بسازد مربوط است، اما ظرفیت مؤثر به شرایطی ارتباط دارد که در آن مدل عملاً آموزش داده میشود.
۱۴.۱. مثال عددی: یک معماری با ظرفیت کافی، اما آموزش ناکامل
فرض کنید تابع واقعی برابر باشد با:
مدل مورد استفاده:
این مدل از نظر ساختار میتواند تابع هدف را دقیقاً بازنمایی کند؛ کافی است انتخاب کنیم:
اما فرض کنید پارامترهای اولیه چنین باشند:
برای نمونه:
خروجی مدل:
اگر تابع زیان را مربع خطا در نظر بگیریم:
خواهیم داشت:
این خطای بزرگ ناشی از ناکافی بودن خانواده توابع مدل نیست. مسئله این است که پارامترهای مناسب هنوز انتخاب یا یاد گرفته نشدهاند.
حال پارامترها را بهصورت زیر تغییر میدهیم:
خروجی جدید:
و خطا:
اگر پارامترهای صحیح تابع هدف را قرار دهیم:
آنگاه:
در این سه حالت، معماری مدل ثابت است و فقط مقادیر پارامترها تغییر کردهاند.
| وضعیت | وزن (w) | بایاس (b) | پیشبینی | خطا |
| اولیه | ۰ | ۰ | ۰ | ۶۴ |
| میانی | ۲ | ۱ | ۵ | ۹ |
| مطلوب | ۳ | ۲ | ۸ | ۰ |
جدول ۲. تفاوت میان ظرفیت ثابت معماری و کیفیت پارامترهای انتخابشده در یک نمونه.
این محاسبه نشان میدهد که حتی یک مدل بسیار ساده نیز ممکن است با پارامترهای نامناسب عملکرد ضعیفی داشته باشد.
البته صفر شدن خطا برای یک نمونه، بهتنهایی اثبات نمیکند که مدل رابطه واقعی را از دادهها آموخته است. در این مثال، پارامترهای صحیح بهطور مستقیم از تابع هدف معلوم انتخاب شدند.
۱۴.۲. عوامل مؤثر بر ظرفیت عملی
در یک مسئله واقعی، استفاده از ظرفیت بالقوه شبکه به چند عامل وابسته است.
| عامل | اثر احتمالی |
| مقداردهی اولیه وزنها | تغییر نقطه شروع آموزش |
| روش بهینهسازی | تأثیر بر مسیر دستیابی به پارامترها |
| تعداد گامهای آموزش | تعیین فرصت مدل برای کاهش خطا |
| کیفیت دادهها | محدودکردن یا تقویت اطلاعات قابل یادگیری |
| منظمسازی | تغییر ترجیح مدل نسبت به توابع مختلف |
| معماری شبکه | تعیین خانواده توابع و ساختار محاسبات |
| محدودیت سختافزاری | محدودکردن زمان، حافظه و اندازه آموزش |
بنابراین اگر یک شبکه عملکرد ضعیفی داشته باشد، افزایش تعداد نورونها تنها یکی از گزینههای قابل بررسی است، نه نخستین یا قطعیترین راهحل.
۱۵. ظرفیت آماری شبکه؛ از تعداد پارامترها تا پیچیدگی کلاس توابع
در بخشهای قبلی، ظرفیت شبکه را عمدتاً از منظر بازنمایی توابع بررسی کردیم. اکنون باید به جنبه دیگری بپردازیم: یک شبکه عصبی تا چه اندازه میتواند الگوهای متفاوتی را روی دادههای آموزشی بازتولید کند؟
این پرسش به مفهوم ظرفیت آماری (Statistical Capacity) مربوط است.
ظرفیت بازنمایی مشخص میکند شبکه چه توابعی میتواند ایجاد کند، اما ظرفیت آماری پیچیدگی خانواده مدلها را از دیدگاه نظریه یادگیری بررسی میکند.
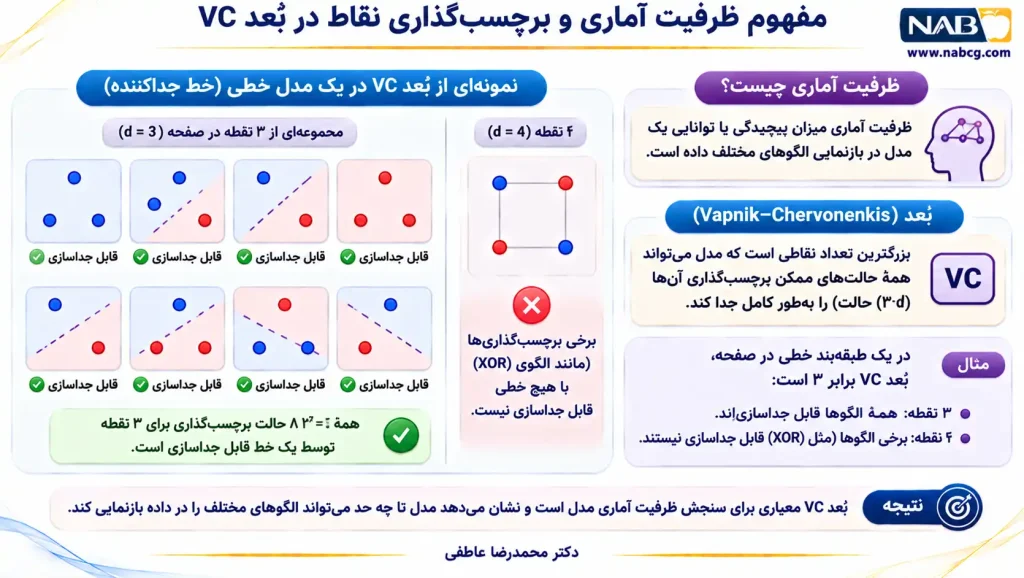
برای مثال، فرض کنید چهار نمونه آموزشی داریم و هر نمونه میتواند در یکی از دو کلاس صفر یا یک قرار گیرد.
تعداد تمام برچسبگذاریهای ممکن برابر است با:
اگر یک خانواده مدل بتواند برای یک مجموعه مشخص از چهار نقطه، هر ۱۶ حالت برچسبگذاری را بازنمایی کند، میگوییم آن مجموعه توسط خانواده مدل خرد میشود (Shattering).
این مفهوم مبنای تعریف بُعد VC است.
۱۵.۱. بُعد VC و رابطه آن با ظرفیت شبکه
بُعد VC یا Vapnik–Chervonenkis Dimension، معیاری نظری برای سنجش ظرفیت خانواده طبقهبندهای دودویی است.
بهطور دقیق، بُعد VC برابر بیشترین تعداد نقاطی است که دستکم یک مجموعه با آن تعداد نقطه بتواند توسط کلاس مدل خرد شود.
در شبکههای عصبی عمیق، محاسبه دقیق بُعد VC معمولاً دشوار است. بااینحال، پژوهشهای نظری کرانهایی برای آن ارائه کردهاند.
Bartlett و همکاران (۲۰۱۹) برای شبکههای دارای فعالسازی تکهایخطی، از جمله ReLU، کران بالایی از مرتبه زیر به دست آوردهاند:
در این رابطه، (W) تعداد پارامترها و (L) تعداد لایههای شبکه در صورتبندی نظری پژوهش است.
این رابطه به معنای آن نیست که میتوان بُعد VC یک معماری دلخواه را با جایگذاری ساده تعداد وزنها و لایهها بهطور دقیق محاسبه کرد؛ بلکه یک کران رشد مجانبی با فروض مشخص است.
۱۵.۲. مثال عددی برای درک مرتبه رشد
دو خانواده معماری فرضی در نظر بگیرید که هر دو دارای ۱۰۰۰ پارامتر هستند، اما یکی از آنها ۲ لایه و دیگری ۵ لایه دارد.
اگر فقط عبارت موجود در کران نظری را بررسی کنیم:
برای شبکه اول:
برای شبکه دوم:
نسبت این دو مقدار برابر است با:
اما این محاسبه صرفاً مقایسه مقدار عبارت W·L·ln W است، نه محاسبه بُعد VC دو شبکه. ثابتهای پنهان در نماد O، ساختار معماری و شرایط اعتبار قضیه مانع از چنین تفسیر مستقیمی میشوند.
هدف مثال این است که نشان دهد در این کران نظری، عمق نیز در کنار تعداد پارامترها حضور دارد.