5. — Backpropagation یک نورون؛ از محاسبه خطا تا اصلاح وزنها
در بخش چهارم، قاعده زنجیرهای را برای گرافهای محاسباتی و شبکههای عصبی بررسی کردیم. اکنون میخواهیم از این دانش برای حل یک مسئله عملی استفاده کنیم: چگونه یک نورون مصنوعی با مشاهده خطای پیشبینی، مقدار وزنها و بایاس خود را اصلاح میکند؟
در این بخش، تمام مراحل آموزش یک نورون را با محاسبات عددی انجام میدهیم. ابتدا خروجی و زیان را محاسبه میکنیم؛ سپس گرادیان هر پارامتر را به دست میآوریم؛ در نهایت یک گام بهروزرسانی انجام میدهیم و بررسی میکنیم آیا زیان واقعاً کاهش یافته است یا خیر.
هدف این است که فرایند یادگیری، بدون وابستگی به PyTorch، TensorFlow یا ابزارهای مشتقگیری خودکار، کاملاً قابلفهم و قابلبازتولید باشد.
۵.۱. مسئله کاربردی: پیشبینی یک شاخص عملکرد
فرض کنید یک شرکت از دو شاخص عملیاتی برای پیشبینی یک امتیاز عملکرد استفاده میکند:
- x₁: شاخص نرمالشده فعالیت بازاریابی؛
- x₂: شاخص نرمالشده کیفیت خدمات؛
- y: امتیاز عملکرد هدف، در بازه صفر تا یک.
برای این مسئله آموزشی، یک نورون با تابع فعالسازی Sigmoid در نظر میگیریم:
که در آن (a) پیشبینی نورون است.
برای سنجش اختلاف پیشبینی و مقدار هدف، از تابع زیان مربعی نصفشده استفاده میکنیم:
این انتخاب برای آموزش محاسبات مشتق مناسب است. در مسائل احتمالاتی طبقهبندی دودویی، معمولاً زیان آنتروپی متقاطع دودویی انتخاب مناسبتری است؛ اما در این مثال تمرکز ما بر سازوکار عمومی Backpropagation است.
دادهها و پارامترهای اولیه
| متغیر | مقدار | نقش |
| x₁ | ۱ | ورودی اول |
| x₂ | ۲ | ورودی دوم |
| w₁ | ۰٫۲ | وزن اول |
| w₂ | ۰٫۳ | وزن دوم |
| (b) | ۰٫۱ | بایاس |
| (y) | ۱ | مقدار هدف |
| η | ۰٫۵ | نرخ یادگیری |
این مقادیر برای نمایش آموزشی انتخاب شدهاند و داده واقعی یک شرکت نیستند.
۵.۲. مرحله اول: انتشار روبهجلو (Forward Propagation)
در انتشار روبهجلو، ابتدا جمع وزندار ورودیها محاسبه میشود.
با جایگذاری مقادیر:
محاسبات میانی:
بنابراین:
اکنون تابع Sigmoid را اعمال میکنیم:
چون:
پس:
پیشبینی نورون تقریباً ۰٫۷۱۱ است؛ درحالیکه مقدار هدف برابر یک است.
اختلاف پیشبینی و هدف:
اکنون مقدار زیان:
شکل ۵-۱. انتشار روبهجلو با تمام مقادیر میانی
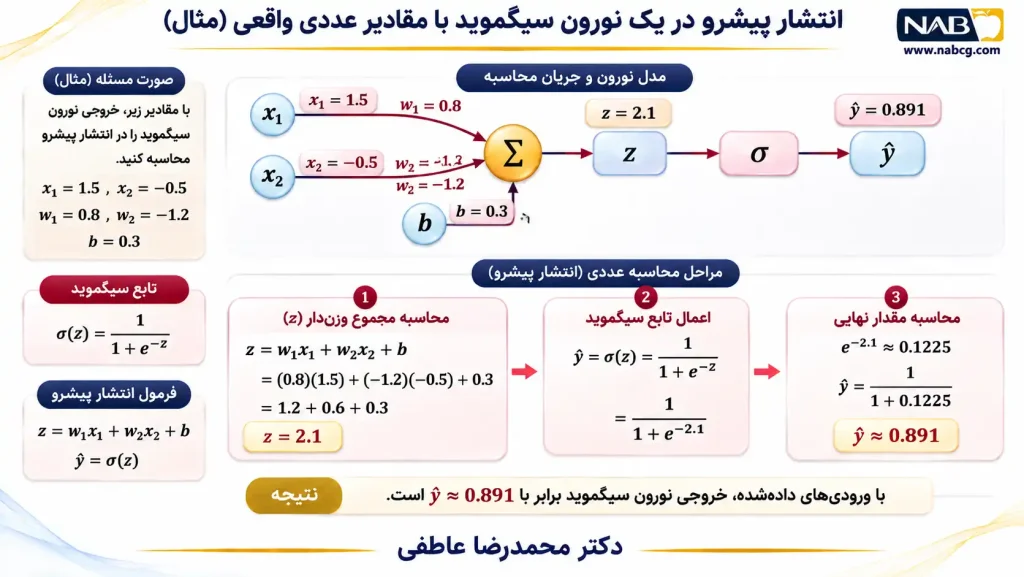
در این مرحله فقط مقدار خروجی و زیان محاسبه شده است. هنوز هیچ پارامتری تغییر نکرده است.
۵.۳. مرحله دوم: انتشار روبهعقب (Backward Propagation)
اکنون باید مشخص کنیم هر پارامتر چه سهمی در زیان دارد.
هدف، محاسبه سه مشتق زیر است:
برای جلوگیری از محاسبات تکراری، Backpropagation را از آخرین عملیات آغاز میکنیم.
۵.۳.۱. مشتق زیان نسبت به خروجی نورون
تابع زیان:
مشتق نسبت به (a):
با جایگذاری:
علامت منفی بیان میکند که افزایش کوچک خروجی (a)، در این نقطه موجب کاهش زیان میشود.
۵.۳.۲. مشتق تابع فعالسازی
برای Sigmoid:
بنابراین:
این مشتق نشان میدهد تغییر کوچک مقدار (z) با چه ضریبی به خروجی نورون منتقل میشود.
۵.۳.۳. محاسبه گرادیان زیان نسبت به (z)
طبق قاعده زنجیرهای:
پس:
این مقدار را سیگنال خطای محلی نورون مینامیم.
نکته مهم آن است که δ یک بار محاسبه میشود و سپس برای به دست آوردن گرادیان تمام وزنها و بایاس مورد استفاده قرار میگیرد.
۵.۳.۴. گرادیان وزن اول
چون:
داریم:
بنابراین:
و چون x₁ = ۱:
۵.۳.۵. گرادیان وزن دوم
برای وزن دوم:
پس:
۵.۳.۶. گرادیان بایاس
چون:
در نتیجه:
اکنون گرادیان تمام پارامترهای قابلآموزش را در اختیار داریم.
شکل ۵-۲. محاسبات کامل انتشار روبهعقب
در شکل ۵-۲. سیگنال خطای محلی (delta) تنها یک بار محاسبه میشود. سپس با ضرب آن در هر ورودی، گرادیان وزن متناظر به دست میآید.
۵.۴. مرحله سوم: بهروزرسانی پارامترها
اکنون باید از گرادیانهای محاسبهشده برای اصلاح پارامترهای نورون استفاده کنیم.
برای این منظور از یک گام گرادیان کاهشی (Gradient Descent) استفاده میکنیم:
در این رابطه:
- • θ یکی از پارامترهای مدل است؛
• η نرخ یادگیری است؛
• ∂ℒ/∂θ گرادیان زیان نسبت به آن پارامتر است.
نرخ یادگیری را برابر ۰٫۵ انتخاب کردهایم:
۵.۴.۱. بهروزرسانی وزن اول
۵.۴.۲. بهروزرسانی وزن دوم
۵.۴.۳. بهروزرسانی بایاس
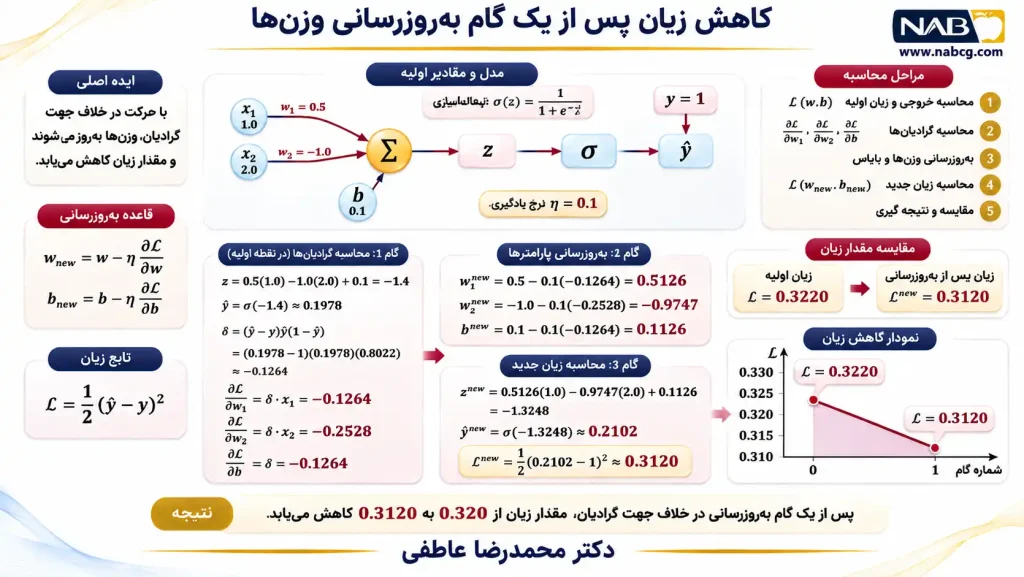
جدول زیر تغییر پارامترها را نشان میدهد.
| پارامتر | مقدار اولیه | گرادیان | مقدار جدید |
| (w₁) | ۰٫۲۰۰۰۰۰ | −۰٫۰۵۹۴۰۰ | ۰٫۲۲۹۷۰۰ |
| (w₂) | ۰٫۳۰۰۰۰۰ | −۰٫۱۱۸۸۰۰ | ۰٫۳۵۹۴۰۰ |
| (b) | ۰٫۱۰۰۰۰۰ | −۰٫۰۵۹۴۰۰ | ۰٫۱۲۹۷۰۰ |
در این مثال، تمام گرادیانها منفیاند. بنابراین کمکردن مقدار منفی از پارامترهای اولیه موجب افزایش آنها شده است.
اما منفیبودن گرادیان همیشه به معنی افزایش وزن نیست؛ جهت تغییر هر پارامتر به علامت گرادیان همان پارامتر بستگی دارد.
۵.۵. مرحله چهارم: آیا زیان واقعاً کاهش یافته است؟
محاسبه گرادیان و اصلاح پارامترها بهتنهایی کافی نیست. باید یک انتشار روبهجلوی جدید انجام دهیم و زیان پس از بهروزرسانی را محاسبه کنیم.
با پارامترهای جدید:
خروجی جدید:
زیان جدید:
در مقایسه با زیان اولیه:
بنابراین:
درصد کاهش زیان:
پس در این مثال، تنها با یک گام بهروزرسانی، زیان حدود ۲۲٫۹ درصد کاهش یافته است.
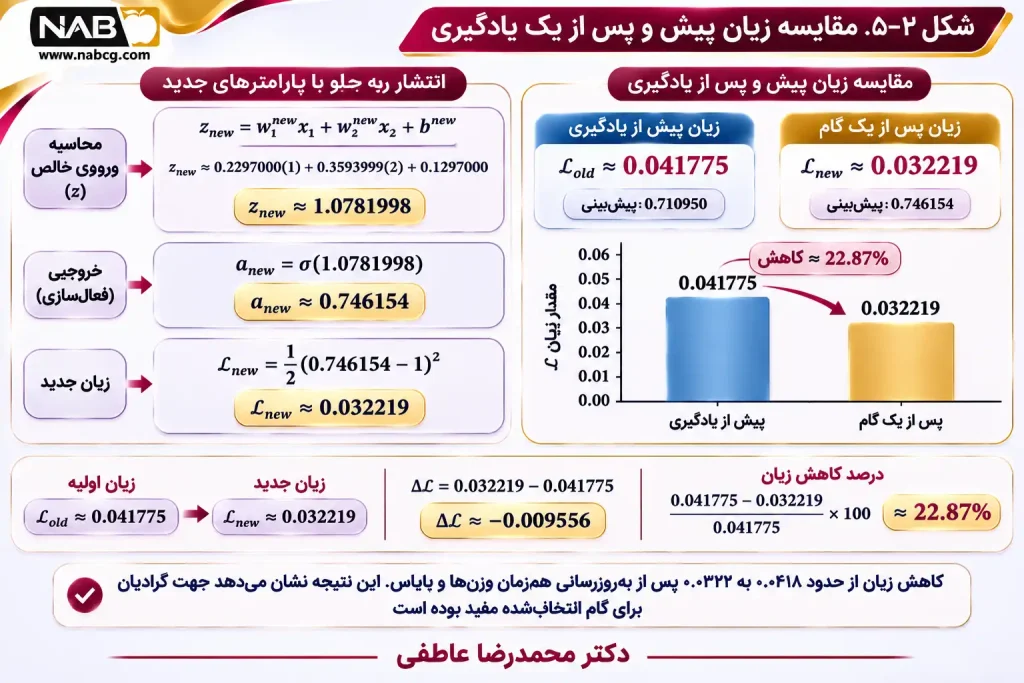
زیان پیش از یادگیری
0.041775
پیشبینی: 0.710950
زیان پس از یک گام
0.032219
پیشبینی: 0.746154
شکل ۵-۳. مقایسه زیان پیش و پس از یک گام یادگیری
این نتیجه نشان میدهد جهت گرادیان برای گام انتخابشده مفید بوده است.
البته کاهش زیان در یک گام به این معنی نیست که هر نرخ یادگیری یا هر بهروزرسانی لزوماً زیان را کاهش میدهد. اگر نرخ یادگیری بیشازحد بزرگ باشد، امکان افزایش زیان نیز وجود دارد.
۵.۶. چرا گرادیان وزن دوم بزرگتر است؟
در مثال ما:
و:
بنابراین:
این نتیجه از آنجا ناشی میشود که ورودی دوم دو برابر ورودی اول است.
اگر مقدار ورودی دوم بهجای ۲ برابر ۱۰ باشد، با ثابتماندن مقدار (delta) بهصورت فرضی، گرادیان وزن دوم نیز پنج برابر میشود.
این نکته یکی از دلایل اهمیت مقیاس ویژگیها در آموزش شبکههای عصبی است.
بااینحال، در یک شبکه واقعی تغییر مقدار ورودی معمولاً مقدار (z)، خروجی و در نتیجه (delta) را نیز تغییر میدهد. بنابراین نمیتوان بدون درنظرگرفتن این وابستگیها، نتیجه گرفت که افزایش پنجبرابری یک ورودی همیشه گرادیان نهایی را دقیقاً پنج برابر میکند.
۵.۷. مثال کاربردی دوم: نورون خطی برای پیشبینی فروش
برای نشاندادن اینکه Backpropagation فقط به Sigmoid محدود نیست، یک نورون خطی را بررسی میکنیم.
فرض کنید یک مدل آموزشی، فروش روزانه را از دو ویژگی پیشبینی میکند:
مقادیر:
خروجی اولیه:
زیان:
چون تابع فعالسازی همانی است:
داریم:
در نتیجه:
گرادیانها:
اگر نرخ یادگیری را ۰٫۱ انتخاب کنیم:
خروجی جدید:
زیان جدید:
پس:
زیان کاهش یافته است؛ اما پیشبینی از مقدار هدف عبور کرده و به ۶٫۶ رسیده است. این مثال نشان میدهد که حتی با کاهش زیان، اندازه گام یادگیری بر رفتار مدل تأثیر میگذارد.
۵.۸. پیادهسازی Backpropagation یک نورون بدون Autograd
اکنون مثال اصلی Sigmoid را با پایتون پیادهسازی میکنیم.
این کد فقط از کتابخانه استاندارد math استفاده میکند و هیچ ابزار مشتقگیری خودکاری در آن وجود ندارد.
import math
def sigmoid(z):
return 1.0 / (1.0 + math.exp(-z))
def forward(x1, x2, y, w1, w2, b):
z = w1 * x1 + w2 * x2 + b
a = sigmoid(z)
loss = 0.5 * (a - y) ** 2
return z, a, loss
# داده آموزشی
x1 = 1.0
x2 = 2.0
y = 1.0
# پارامترهای اولیه
w1 = 0.2
w2 = 0.3
b = 0.1
learning_rate = 0.5
# مرحله اول: Forward
z, a, loss_before = forward(
x1, x2, y, w1, w2, b
)
# مرحله دوم: Backward
dL_da = a - y
da_dz = a * (1.0 - a)
delta = dL_da * da_dz
dL_dw1 = delta * x1
dL_dw2 = delta * x2
dL_db = delta
# مرحله سوم: بهروزرسانی پارامترها
w1_new = w1 - learning_rate * dL_dw1
w2_new = w2 - learning_rate * dL_dw2
b_new = b - learning_rate * dL_db
# مرحله چهارم: محاسبه مجدد زیان
z_new, a_new, loss_after = forward(
x1, x2, y,
w1_new, w2_new, b_new
)
print("Initial prediction:", a)
print("Initial loss:", loss_before)
print("Gradient w1:", dL_dw1)
print("Gradient w2:", dL_dw2)
print("Gradient b:", dL_db)
print("Updated w1:", w1_new)
print("Updated w2:", w2_new)
print("Updated b:", b_new)
print("New prediction:", a_new)
print("New loss:", loss_after)
assert loss_after < loss_before
این برنامه چهار وظیفه مستقل را انجام میدهد: محاسبه خروجی، محاسبه گرادیانها، بهروزرسانی پارامترها و ارزیابی زیان جدید.
استفاده از assert در انتهای برنامه صرفاً بررسی میکند که در این مثال مشخص، زیان کاهش یافته است. این شرط برای همه دادهها و همه نرخهای یادگیری تضمینشده نیست.
۵.۸.۱. گسترش برنامه به چند تکرار یادگیری
برای مشاهده رفتار تدریجی یادگیری، میتوان فرایند را در یک حلقه تکرار کرد:
import math

def sigmoid(z):
    if z >= 0:
        return 1.0 / (1.0 + math.exp(-z))
    ez = math.exp(z)
    return ez / (1.0 + ez)

x1, x2, y = 1.0, 2.0, 1.0
w1, w2, b = 0.2, 0.3, 0.1
lr = 0.5

history = []

for epoch in range(101):
    # Forward
    z = w1 * x1 + w2 * x2 + b
    a = sigmoid(z)
    loss = 0.5 * (a - y) ** 2

    history.append((epoch, loss, a))

    if epoch == 100:
        break

    # Backward
    delta = (a - y) * a * (1.0 - a)

    grad_w1 = delta * x1
    grad_w2 = delta * x2
    grad_b = delta

    # Gradient descent
    w1 -= lr * grad_w1
    w2 -= lr * grad_w2
    b -= lr * grad_b

for epoch, loss, prediction in history:
    if epoch % 20 == 0:
        print(
            f"Epoch {epoch:3d} | "
            f"Loss={loss:.8f} | "
            f"Prediction={prediction:.6f}"
        )
در این برنامه، برای هر تکرار ابتدا خروجی و زیان محاسبه میشود، سپس گرادیانها به دست میآیند و پارامترها اصلاح میشوند.
تابع Sigmoid در نسخه دوم بهشکلی نوشته شده است که در ورودیهای مثبت و منفی بزرگ، از محاسبه نماییِ غیرضروری با خطر سرریز عددی جلوگیری کند.
این پیادهسازی از یک نمونه آموزشی استفاده میکند. بنابراین کاهش زیان روی همین نمونه، بهتنهایی نشاندهنده توانایی تعمیم مدل به دادههای جدید نیست.
۵.۹. سه خطای رایج هنگام پیادهسازی Backpropagation
خطای اول: اشتباهگرفتن خطای پیشبینی با سیگنال خطای محلی
در نورون Sigmoid با زیان مربعی:
اما:
بنابراین:
مگر در شرایط خاص.
اگر بهجای (delta)، مستقیماً از (e) برای گرادیان وزنها استفاده کنیم، مشتق تابع فعالسازی را نادیده گرفتهایم.
خطای دوم: استفاده از پارامترهای بهروزشده در محاسبه گرادیانهای همان گام
تمام گرادیانهای یک گام استاندارد گرادیان کاهشی باید بر اساس یک مجموعه مشترک از پارامترهای فعلی محاسبه شوند.
برای مثال، ابتدا باید هر سه مقدار زیر محاسبه شوند:
سپس بهروزرسانی انجام شود.
اگر وزن اول را تغییر دهیم و بعد با آن مقدار جدید، گرادیان وزن دوم را برای همان گام محاسبه کنیم، دیگر یک گام گرادیان کاهشی همزمان مطابق تعریف اولیه انجام ندادهایم.
خطای سوم: انتخاب نرخ یادگیری نامناسب
نرخ یادگیری بسیار کوچک ممکن است پیشرفت را کند کند.
نرخ یادگیری بسیار بزرگ ممکن است موجب نوسان یا افزایش زیان شود.
برای نمونه، در مثال نورون خطی بخش ۵.۷، نرخ یادگیری ۰٫۱ موجب کاهش زیان شد؛ اما برای همان داده و همان گرادیان اولیه، نرخ یادگیری ۱ مقدار پیشبینی را بهشدت از هدف دور میکند.
زیرا:
و:
در نتیجه:
درحالیکه زیان اولیه تنها ۱٫۱۲۵ بود.
پس جهت منفی گرادیان، یک جهت کاهش محلی است؛ اما تضمین نمیکند هر گام با هر اندازهای موجب کاهش زیان شود.
۵.۱۰. تمرینها و مسائل بخش پنجم
- تمرین ۱ ـ نورون خطی: نورونی با (x=3)، (w=2)، (b=1) و (y=10) در نظر بگیرید. زیان مربعی نصفشده، گرادیان وزن و بایاس و پارامترهای جدید را با نرخ یادگیری ۰٫۰۱ محاسبه کنید.
- تمرین ۲ ـ نورون Sigmoid: برای (x=2)، (w=0.5)، (b=0) و (y=0)، خروجی Sigmoid، زیان و گرادیان وزن را محاسبه کنید.
- تمرین ۳ ـ تحلیل علامت گرادیان: توضیح دهید چرا در مثال اصلی این بخش، هر سه پارامتر پس از یک گام یادگیری افزایش یافتند.
- تمرین ۴ ـ نرخ یادگیری: مثال نورون خطی بخش ۵.۷ را با نرخهای یادگیری ۰٫۰۱، ۰٫۰۵، ۰٫۱ و ۰٫۵ تکرار کنید و مقدار زیان جدید را مقایسه کنید.
- تمرین ۵ ـ برنامهنویسی: کد نورون Sigmoid را بهگونهای توسعه دهید که تعداد تکرارها، نرخ یادگیری و مقادیر اولیه وزنها از ورودی برنامه دریافت شوند.
- تمرین ۶ ـ تحلیل حساسیت: اگر در مثال اصلی x₂ از ۲ به ۴ تغییر کند، تمام محاسبات Forward و Backward را دوباره انجام دهید. بررسی کنید آیا گرادیان w₂ دقیقاً دو برابر میشود یا خیر.
- تمرین ۷ ـ پرسش تحلیلی: چرا کاهش زیان روی یک نمونه آموزشی، برای اثبات عملکرد مناسب مدل روی دادههای جدید کافی نیست؟
پاسخ تشریحی منتخب: تمرین ۱
داریم:
زیان:
گرادیان وزن:
گرادیان بایاس:
با نرخ یادگیری ۰٫۰۱:
پیشبینی جدید:
زیان جدید:
پس زیان از ۴٫۵ به ۳٫۶۴۵ کاهش یافته است.
منابع علمی بخش پنجم
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Hagan, M. T., Demuth, H. B., Beale, M. H., & De Jesús, O. (2014). Neural network design (2nd ed.). Martin Hagan.
Haykin, S. (2009). Neural networks and learning machines (3rd ed.). Pearson.
Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. https://doi.org/10.1038/323533a0
6. بازپسانتشار خطا در یک لایه کامل شبکه عصبی
در بخش پنجم، یاد گرفتیم که چگونه یک نورون مصنوعی با محاسبه گرادیان تابع زیان نسبت به وزنها و بایاس، پارامترهای خود را اصلاح میکند. اکنون یک گام مهمتر برمیداریم: چگونه میتوان گرادیان تمام نورونهای یک لایه را بهصورت همزمان محاسبه کرد؟
این مسئله نقطه اتصال محاسبات اسکالر به محاسبات برداری و ماتریسی است. در شبکههای عصبی واقعی، محاسبه جداگانه مشتق هر وزن نهتنها زمانبر است، بلکه پیادهسازی و نگهداری آن را نیز دشوار میکند.
هدف این بخش آن است که ابتدا Backpropagation یک لایه را با اعداد واقعی و محاسبات کامل بیاموزیم، سپس همان محاسبات را به زبان ماتریسها بیان کنیم و در پایان، یک پیادهسازی مستقل و قابلبازتولید با NumPy ارائه دهیم.
۶.۱. از یک نورون به یک لایه
در بخش پنجم، یک نورون با دو ورودی داشتیم:
اکنون فرض کنید یک لایه دارای سه نورون باشد و هر نورون همان دو ورودی را دریافت کند.
شکل ۶-۱. یک لایه با دو ورودی و سه نورون
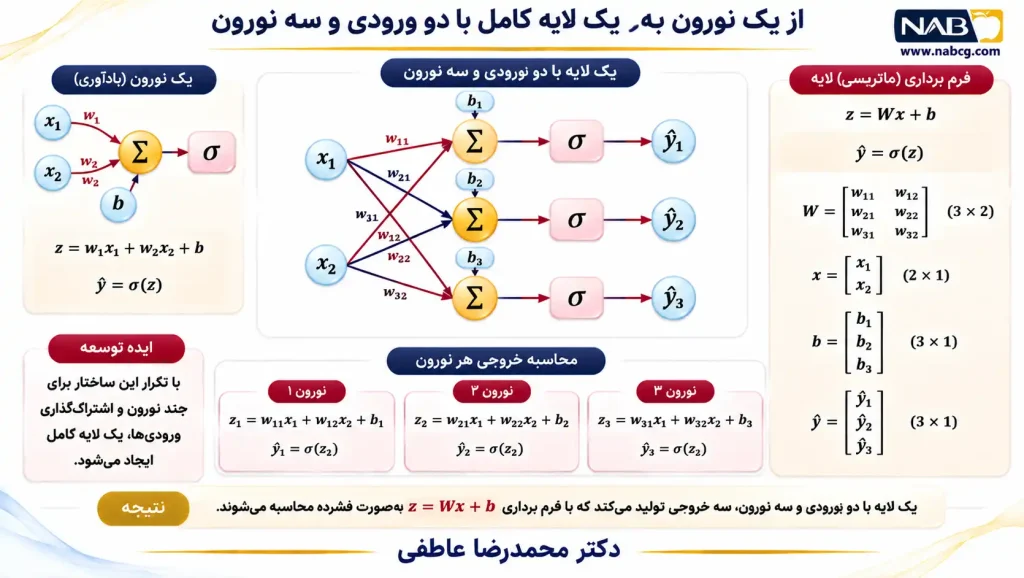
هر نورون دو وزن مستقل و یک بایاس دارد. بنابراین این لایه در مجموع ۶ وزن و ۳ بایاس، یعنی ۹ پارامتر قابلآموزش، خواهد داشت.
روابط سه نورون به شکل زیر هستند:
در این نمادگذاری، wⱼᵢ وزن اتصال ورودی i به نورون j است.
اگر تابع فعالسازی هر سه نورون یکسان باشد:
میتوان این روابط را بهشکل فشرده زیر نوشت:
که در آن φ بهصورت مؤلفهبهمؤلفه اعمال میشود.
۶.۲. مثال اصلی: پیشبینی سه شاخص عملکرد
فرض کنید یک شرکت میخواهد با استفاده از دو ویژگی عملیاتی، سه شاخص عملکرد نرمالشده را پیشبینی کند.
ورودیها:
وزنهای اولیه:
بایاسها:
مقادیر هدف:
برای هر نورون از Sigmoid استفاده میکنیم و تابع زیان کل را مجموع زیانهای مربعی نصفشده در نظر میگیریم:
در این مثال، مقادیر هدف صرفاً برای آموزش انتخاب شدهاند. اگر مسئله، طبقهبندی چندبرچسبی واقعی باشد، انتخاب تابع زیان و تفسیر خروجیها باید متناسب با صورتبندی آن مسئله انجام شود.
۶.۲.۱. محاسبه خروجی خطی نورون اول
۶.۲.۲. محاسبه خروجی خطی نورون دوم
۶.۲.۳. محاسبه خروجی خطی نورون سوم
بنابراین:
۶.۳. اعمال تابع فعالسازی
تابع Sigmoid:
- برای نورون اول:
- برای نورون دوم:
- برای نورون سوم:
پس:
۶.۳.۱. محاسبه زیان هر نورون
- برای نورون اول:
- برای نورون دوم:
- برای نورون سوم:
زیان کل:
شکل ۶-۲. انتشار روبهجلو در سه نورون با نمایش محاسبات
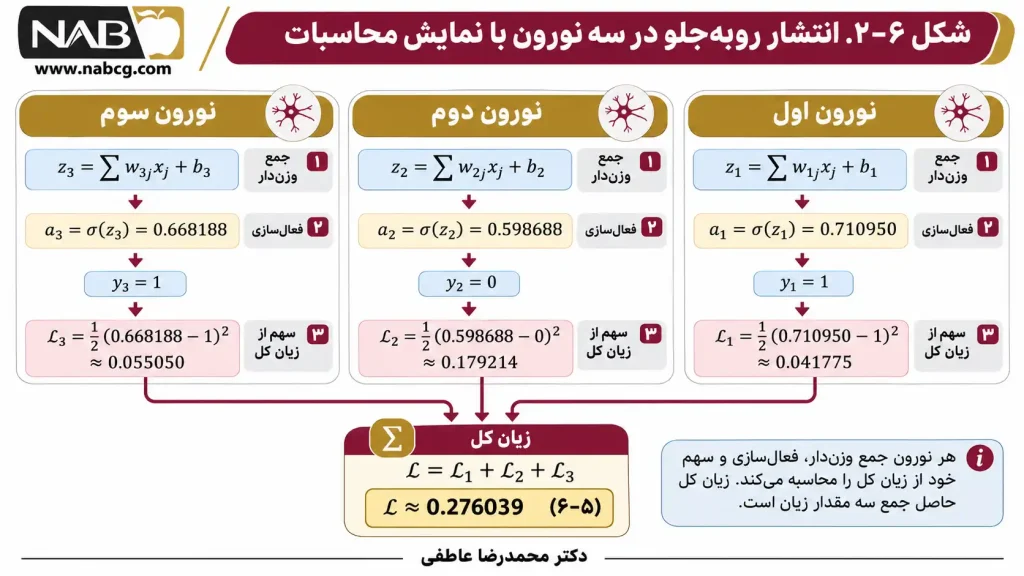
هر نورون جمع وزندار، فعالسازی و سهم خود از زیان کل را محاسبه میکند. زیان کل حاصل جمع سه مقدار زیان است.
۶.۴. بازپسانتشار خطا در سه نورون
اکنون میخواهیم گرادیان زیان نسبت به تمام وزنها و بایاسها را محاسبه کنیم.
برای هر نورون:
با استفاده از قاعده زنجیرهای:
چون:
در نتیجه:
۶.۴.۱. سیگنال خطای نورون اول
۶.۴.۲. سیگنال خطای نورون دوم
۶.۴.۳. سیگنال خطای نورون سوم
پس بردار سیگنالهای خطای محلی تقریباً برابر است با:
مقادیر در متن تا شش رقم اعشار گرد شدهاند؛ در محاسبات برنامهنویسی باید از مقادیر با دقت کامل استفاده شود.
۶.۴.۴. تفسیر علامت سیگنالهای خطا
- در نورون اول، مقدار پیشبینی کمتر از هدف است؛ بنابراین سیگنال خطا منفی شده است.
- در نورون دوم، مقدار هدف صفر است اما نورون خروجی مثبتی تولید کرده است؛ بنابراین سیگنال خطا مثبت است.
- در نورون سوم نیز پیشبینی کمتر از هدف است و سیگنال خطا منفی است.
این علامتها در تعیین جهت بهروزرسانی وزنها نقش دارند.
۶.۵. محاسبه گرادیان تمام وزنها
برای هر وزن wⱼᵢ:
از آنجا که:
گرادیانهای نورون اول:
گرادیانهای نورون دوم:
گرادیانهای نورون سوم:
بنابراین ماتریس گرادیان وزنها برابر است با:
گرادیان بایاسها نیز برابر است با:
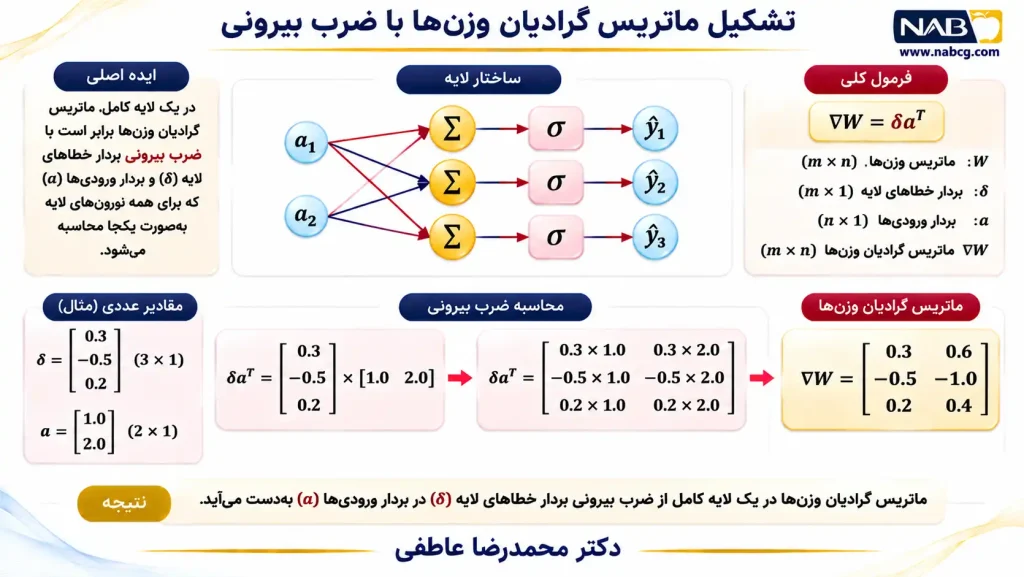
۶.۶. استخراج رابطه ماتریسی Backpropagation
اکنون میخواهیم نشان دهیم که ماتریس گرادیان وزنها را میتوان با یک ضرب ماتریسی محاسبه کرد.
بردار سیگنال خطا:
بردار ورودی:
ترانهاده ورودی:
حاصلضرب بیرونی:
این ماتریس دقیقاً شامل تمام مشتقهای وزنهاست.
بنابراین:
این رابطه یکی از مهمترین نتایج Backpropagation در یک لایه است.
بررسی ابعاد ماتریسها
بنابراین:
این دقیقاً با ابعاد ماتریس وزنها سازگار است.
شکل ۶-۳. ضرب بیرونی و تشکیل ماتریس گرادیان
۶.۷. گرادیان نسبت به ورودی لایه
تا اینجا گرادیان وزنها و بایاسها را محاسبه کردیم. اما اگر این لایه، لایه خروجی یک شبکه چندلایه نباشد، باید گرادیان زیان نسبت به ورودیهای آن را نیز به دست آوریم.
این گرادیان برای آموزش لایههای پیشین ضروری است.
رابطه:
برای مثال ما:
بنابراین:
مؤلفه اول:
مؤلفه دوم:
پس:
این گرادیان به ما میگوید اگر ورودیهای لایه، خروجی یک لایه قبلی باشند، زیان نسبت به آن خروجیها چه حساسیتی دارد.
در بخش هفتم، از همین رابطه برای انتقال گرادیان از لایه خروجی به لایه پنهان استفاده خواهیم کرد.
۶.۸. بهروزرسانی همزمان وزنها و بایاسها
برای انجام یک گام گرادیان کاهشی:
نرخ یادگیری را برابر ۰٫۱ انتخاب میکنیم:
در نتیجه، ماتریس وزنهای جدید تقریباً برابر است با:
و بایاسهای جدید:
برای ارزیابی نتیجه، دوباره انتشار روبهجلو را با پارامترهای جدید انجام میدهیم.
بهطور تقریبی:
زیان جدید تقریباً:
در مقایسه با زیان اولیه:
بنابراین زیان در این گام کاهش یافته است.
۶.۹. پیادهسازی کامل یک لایه بدون Autograd
در این بخش، محاسبات را با NumPy پیادهسازی میکنیم.
NumPy تنها برای انجام عملیات برداری و ماتریسی استفاده میشود. تمام مشتقها بهصورت دستی محاسبه شدهاند.
import numpy as np
def sigmoid(z):
positive = z >= 0
out = np.empty_like(z, dtype=float)
out[positive] = 1 / (1 + np.exp(-z[positive]))
ez = np.exp(z[~positive])
out[~positive] = ez / (1 + ez)
return out
# دادهها
x = np.array([[1.0], [2.0]])
y = np.array([[1.0], [0.0], [1.0]])
# پارامترهای اولیه
W = np.array([
[0.2, 0.3],
[0.4, -0.1],
[-0.2, 0.5]
])
b = np.array([
[0.1],
[0.2],
[-0.1]
])
learning_rate = 0.1
# ---------- Forward ----------
z = W @ x + b
a = sigmoid(z)
loss_before = 0.5 * np.sum((a - y) ** 2)
# ---------- Backward ----------
dL_da = a - y
da_dz = a * (1 - a)
delta = dL_da * da_dz
grad_W = delta @ x.T
grad_b = delta.copy()
# گرادیان نسبت به ورودی
grad_x = W.T @ delta
# ---------- Update ----------
W_new = W - learning_rate * grad_W
b_new = b - learning_rate * grad_b
# ---------- New Forward ----------
z_new = W_new @ x + b_new
a_new = sigmoid(z_new)
loss_after = 0.5 * np.sum((a_new - y) ** 2)
print("Initial z:n", z)
print("Initial a:n", a)
print("Initial loss:", loss_before)
print("Delta:n", delta)
print("Gradient W:n", grad_W)
print("Gradient b:n", grad_b)
print("Gradient x:n", grad_x)
print("Updated W:n", W_new)
print("Updated b:n", b_new)
print("New loss:", loss_after)
assert grad_W.shape == W.shape
assert grad_b.shape == b.shape
assert grad_x.shape == x.shape
assert loss_after < loss_before
۶.۹.۱. بررسی ابعاد در برنامه
| متغیر | ابعاد | توضیح |
| x | (2×1) | بردار ورودی |
| W | (3×2) | ماتریس وزنها |
| b | (3×1) | بایاسها |
| z | (3×1) | خروجی خطی نورونها |
| a | (3×1) | خروجی فعالسازی |
| delta | (3×1) | سیگنال خطای محلی |
| grad_W | (3×2) | گرادیان وزنها |
| grad_b | (3×1) | گرادیان بایاسها |
| grad_x | (2×1) | گرادیان نسبت به ورودی |
در پیادهسازی شبکههای عصبی، کنترل ابعاد یکی از مهمترین ابزارهای جلوگیری از خطاهای محاسباتی است.
۶.۱۰. تعمیم به یک دسته از نمونههای آموزشی (Mini-batch)
تا اینجا فقط یک نمونه آموزشی داشتیم. در عمل، معمولاً چند نمونه را همزمان پردازش میکنیم.
فرض کنید (B) نمونه آموزشی داریم و هر ستون ماتریس (X) یک نمونه باشد:
در این صورت:
که در آن 𝟏_B بردار ستونی شامل B عدد یک است.
اگر زیان کل، میانگین زیان نمونهها باشد و ماتریس (Delta) شامل مشتق زیان هر نمونه نسبت به پیشفعالسازیهای آن، پیش از اعمال ضریب میانگینگیری باشد، آنگاه:
عامل (1/B) به تعریف تابع زیان وابسته است. اگر مشتقهای داخل (Delta) از ابتدا بر اساس زیان میانگین محاسبه شده باشند، نباید دوباره بر (B) تقسیم کنیم.
این تفاوت در پیادهسازی بسیار مهم است؛ زیرا اعمال دوباره ضریب میانگین، اندازه گرادیان را اشتباه تغییر میدهد.
مثال کوتاه: دو نمونه آموزشی
فرض کنید یک نورون خطی داریم:
با:
دو نمونه:
پیشبینیها:
خطاها:
زیان میانگین مربعی نصفشده:
با (B=2):
گرادیان وزن:
گرادیان بایاس:
این مثال نشان میدهد گرادیان یک دسته آموزشی، از تجمیع سهم نمونهها به دست میآید.
۶.۱۱. خطاهای رایج در Backpropagation یک لایه
- خطای اول: جابهجایی ترتیب ضرب ماتریسی. رابطه صحیح برای یک نمونه، δ𝐱^T است، نه 𝐱δ^T. این دو ضرب در حالت کلی ابعاد و معنای متفاوتی دارند.
- خطای اول: جابهجایی ترتیب ضرب ماتریسی. رابطه صحیح برای یک نمونه، δ𝐱^T است، نه 𝐱δ^T. این دو ضرب در حالت کلی ابعاد و معنای متفاوتی دارند.
- خطای سوم: فراموشکردن گرادیان بایاس. هر نورون علاوه بر وزنها، بایاس قابلآموزش دارد. گرادیان بایاس در یک نمونه برابر سیگنال خطای محلی همان نورون است.
- خطای چهارم: استفاده از وزنهای جدید برای محاسبه گرادیان ورودی در همان گام. گرادیان ورودی باید با وزنهای مربوط به همان انتشار روبهجلویی محاسبه شود که گرادیانها از آن به دست آمدهاند.
- خطای پنجم: میانگینگیری ناهماهنگ از زیان و گرادیانها. اگر تابع زیان میانگین نمونهها باشد، ضریب میانگینگیری باید دقیقاً یک بار و بهشکلی سازگار در مشتقها لحاظ شود.
۶.۱۲. تمرینها و مسائل بخش ششم
- تمرین ۱ ـ محاسبه Forward یک لایه: لایهای با دو ورودی و دو نورون در نظر بگیرید:
مقادیر z₁، z₂ و خروجی Sigmoid هر نورون را محاسبه کنید.
- تمرین ۲ ـ محاسبه Backward: برای دادههای تمرین اول، بردار هدف را 𝐲 = [۱، ۰]^T در نظر بگیرید. زیان کل، سیگنالهای خطای محلی و گرادیان وزنها و بایاسها را محاسبه کنید.
- تمرین ۳ ـ گرادیان ورودی: برای همان لایه، مقدار W^T δ را محاسبه و ابعاد آن را بررسی کنید.
- تمرین ۴ ـ بهروزرسانی: پارامترهای تمرین دوم را با نرخ یادگیری ۰٫۱ اصلاح کرده و زیان جدید را محاسبه کنید.
- تمرین ۵ ـ پیادهسازی: کد NumPy این بخش را برای لایهای با ۵ ورودی و ۴ نورون تعمیم دهید. دادهها و وزنها را با مقادیر دلخواه کوچک مقداردهی کنید و ابعاد تمام گرادیانها را بررسی کنید.
- تمرین ۶ ـ Mini-batch: یک نورون خطی را با سه نمونه آموزشی و زیان میانگین مربعی نصفشده در نظر بگیرید. گرادیان وزن و بایاس را یک بار با جمع مشتقهای نمونهها و بار دیگر با ضرب ماتریسی محاسبه کنید.
- تمرین ۷ ـ تحلیل نظری: توضیح دهید چرا رابطه ∇_𝐱 ℒ = W^T δ برای Backpropagation در شبکههای چندلایه ضروری است.
پاسخ تشریحی منتخب: تمرین ۱
برای نورون اول:
برای نورون دوم:
خروجی Sigmoid نورون اول:
خروجی نورون دوم:
بنابراین:
منابع علمی بخش ششم
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Hagan, M. T., Demuth, H. B., Beale, M. H., & De Jesús, O. (2014). Neural network design (2nd ed.). Martin Hagan.
Haykin, S. (2009). Neural networks and learning machines (3rd ed.). Pearson.
Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. https://doi.org/10.1038/323533a0
7. بازپسانتشار خطا در شبکه عصبی چندلایه (Multilayer Backpropagation)
در بخش ششم، محاسبه گرادیانهای یک لایه کامل را آموختیم. اکنون به مهمترین مرحله فصل میرسیم: آموزش شبکهای که علاوه بر لایه خروجی، یک یا چند لایه پنهان دارد.
تفاوت اساسی این است که برای نورونهای لایه خروجی، مقدار هدف را در اختیار داریم؛ اما برای نورونهای لایه پنهان، مقدار هدف مستقلی تعریف نشده است. بنابراین نمیتوان خطای هر نورون پنهان را مستقیماً از اختلاف خروجی آن با یک مقدار هدف محاسبه کرد.
راهحل Backpropagation این است که گرادیان زیان را از لایه خروجی به لایههای پنهان منتقل کنیم. به این ترتیب، هر وزن، حتی در نخستین لایه شبکه، میتواند بر اساس تأثیری که بر زیان نهایی دارد اصلاح شود.
در این بخش، تمام محاسبات یک شبکه چندلایه را از ابتدا تا انتها انجام میدهیم و سپس فرمول عمومی آن را استخراج میکنیم.
۷.۱. معماری شبکه مورد مطالعه
برای جلوگیری از پیچیدگی غیرضروری، شبکهای با معماری زیر در نظر میگیریم:
شکل ۷-۱. معماری شبکه ۲–۲–۱
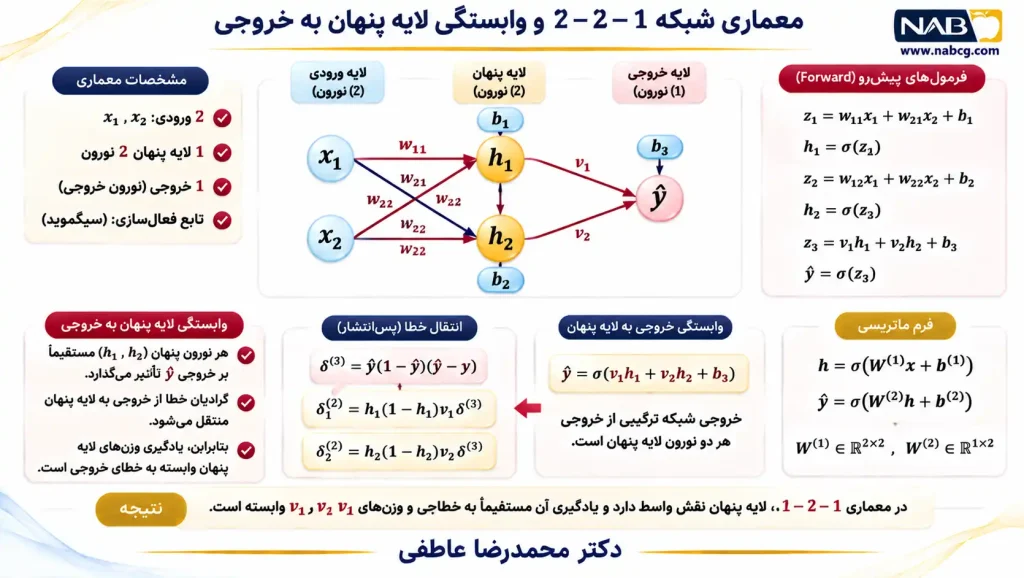
دو ورودی به دو نورون لایه پنهان متصل میشوند و خروجی این دو نورون به نورون نهایی منتقل میشود. تمام اتصالها دارای وزن مستقل هستند.
این شبکه دارای دو لایه قابلآموزش است:
- لایه اول: دو ورودی و دو نورون پنهان؛
- لایه دوم: دو ورودی از لایه پنهان و یک نورون خروجی.
در مجموع:
بنابراین شبکه دارای ۹ پارامتر قابلآموزش است: شش وزن و سه بایاس.
قرارداد نمادگذاری
برای جلوگیری از ابهام، از اندیس بالانویس برای شماره لایه استفاده میکنیم:
برای وزنها و بایاسهای لایه پنهان، و:
برای پارامترهای لایه خروجی.
همچنین:
یعنی خروجی لایه صفر همان ورودی شبکه است.
۷.۲. تعریف مسئله و مقادیر اولیه
فرض کنید شبکه قرار است یک امتیاز عملکرد نرمالشده را از دو ویژگی عددی پیشبینی کند.
داده آموزشی:
وزنهای لایه پنهان:
بایاسهای لایه پنهان:
وزنهای لایه خروجی:
بایاس خروجی:
تابع فعالسازی هر دو لایه Sigmoid است:
و تابع زیان:
این مقادیر ساختگیاند و صرفاً برای نمایش شفاف محاسبات انتخاب شدهاند.
۷.۳. مرحله اول: انتشار روبهجلو در لایه پنهان
رابطه لایه اول:
با جایگذاری:
محاسبه نورون پنهان اول
خروجی فعالسازی:
محاسبه نورون پنهان دوم
خروجی فعالسازی:
بنابراین:
این بردار، ورودی لایه خروجی خواهد بود.
۷.۴. مرحله دوم: انتشار روبهجلو در لایه خروجی
رابطه لایه دوم:
با جایگذاری:
محاسبات میانی:
پس:
اکنون خروجی نهایی:
زیان:
در این مرحله انتشار روبهجلو پایان یافته است.
۷.۵. مرحله سوم: بازپسانتشار خطا از لایه خروجی
اکنون میخواهیم گرادیان زیان نسبت به پارامترهای لایه دوم را محاسبه کنیم.
ابتدا سیگنال خطای خروجی:
طبق قاعده زنجیرهای:
از آنجا که:
و:
داریم:
با جایگذاری:
۷.۵.۱. گرادیان وزن اول لایه خروجی
۷.۵.۲. گرادیان وزن دوم لایه خروجی
۷.۵.۳. گرادیان بایاس خروجی
بنابراین:
تا اینجا محاسبات مشابه Backpropagation یک لایه بودهاند. تفاوت اصلی از مرحله بعد آغاز میشود.
۷.۶. مرحله چهارم: انتقال گرادیان به لایه پنهان
نورونهای پنهان مقدار هدف مستقلی ندارند. پس چگونه میتوان گرادیان وزنهای آنها را محاسبه کرد؟
پاسخ این است که خروجی هر نورون پنهان بر مقدار (z^{(2)}) اثر میگذارد و (z^{(2)}) نیز بر زیان تأثیر دارد.
بنابراین:
چون:
داریم:
پس:
برای نورون دوم:
این دو مقدار نشان میدهند زیان نسبت به خروجی هر نورون پنهان چه حساسیتی دارد.
اما برای محاسبه گرادیان وزنهای لایه پنهان، باید مشتق تابع فعالسازی را نیز لحاظ کنیم.
۷.۶.۱. سیگنال خطای نورون پنهان اول
مشتق Sigmoid:
پس:
۷.۶.۲. سیگنال خطای نورون پنهان دوم
مشتق Sigmoid نورون دوم:
پس:
در نتیجه:
رابطه کلیدی Backpropagation در لایه پنهان
تمام محاسبات بالا را میتوان در یک رابطه ماتریسی خلاصه کرد:
که در آن ⊙ ضرب مؤلفهبهمؤلفه است.
این رابطه نشان میدهد سیگنال خطای لایه پنهان از دو عامل تشکیل میشود:
1. گرادیانی که از لایه بعد به عقب منتقل میشود؛
2. مشتق تابع فعالسازی لایه فعلی.
نکته بسیار مهم: در این رابطه از وزنهای لایه دوم در زمان محاسبه Forward استفاده میکنیم، نه وزنهایی که بعداً بهروزرسانی خواهند شد.
۷.۷. مرحله پنجم: محاسبه گرادیان وزنها و بایاسهای لایه پنهان
اکنون سیگنال خطای هر دو نورون پنهان را داریم:
با استفاده از رابطه بخش ششم:
چون:
حاصلضرب بیرونی برابر است با:
بنابراین:
و گرادیان بایاسها:
محاسبه دستی تکتک وزنها
برای نورون پنهان اول:
برای نورون پنهان دوم:
اکنون گرادیان تمام ۹ پارامتر شبکه مشخص شده است.
شکل ۷-۳. جریان گرادیان از خروجی تا وزنهای لایه پنهان
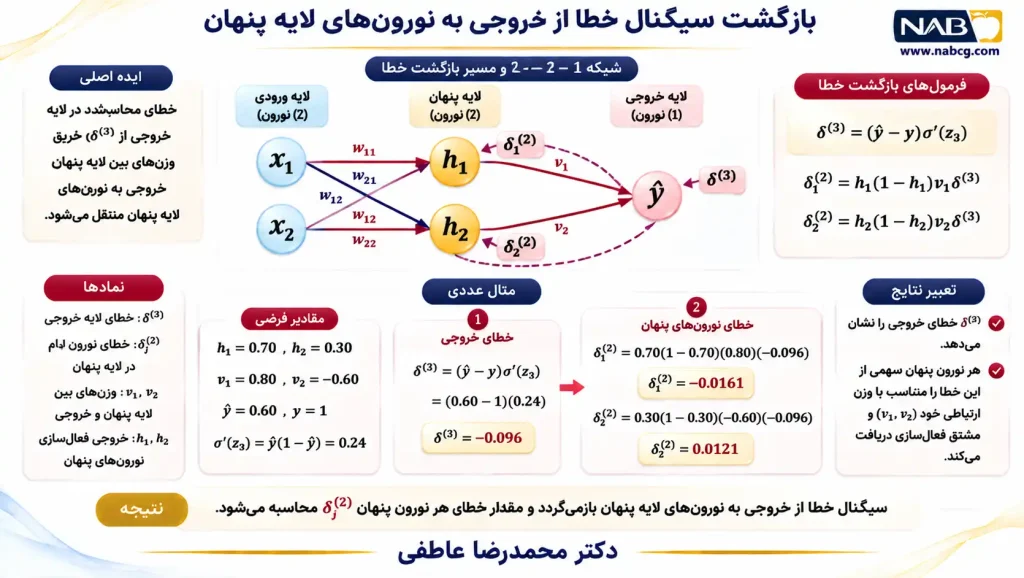
سیگنال خطای هر نورون پنهان از گرادیان دریافتی از لایه بعد و مشتق فعالسازی همان نورون ساخته میشود. سپس با ضرب آن در ورودیهای لایه، گرادیان وزنها محاسبه میشود.
۷.۸. مرحله ششم: بهروزرسانی همزمان تمام پارامترها
اکنون میتوانیم تمام پارامترهای شبکه را اصلاح کنیم.
نرخ یادگیری:
قانون گرادیان کاهشی برای هر لایه:
۷.۸.۱. بهروزرسانی لایه پنهان
وزنهای اولیه:
ماتریس گرادیان:
بنابراین:
نتیجه:
بایاسهای جدید:
۷.۸.۲. بهروزرسانی لایه خروجی
گرادیان وزنهای خروجی با استفاده از مقادیر دقیقتر برابر است با:
پس:
بنابراین:
و:
نکته اجرایی: ابتدا گرادیان همه لایهها با پارامترهای اولیه محاسبه میشود؛ سپس بهروزرسانی تمام پارامترها انجام میگیرد. تغییر وزنهای خروجی پیش از محاسبه سیگنال خطای لایه پنهان، نتیجه یک گام استاندارد Backpropagation را تغییر میدهد.
۷.۹. مرحله هفتم: محاسبه مجدد خروجی و زیان
پس از اصلاح پارامترها، باید یک انتشار روبهجلوی جدید انجام دهیم.
برای لایه پنهان:
برای نورون اول:
برای نورون دوم:
پس از اعمال Sigmoid:
اکنون لایه خروجی:
و خروجی نهایی:
زیان جدید:
مقایسه:
زیان پیش از بهروزرسانی
0.099551
پیشبینی: 0.553791
زیان پس از بهروزرسانی
0.097158
پیشبینی: 0.559186
کاهش زیان:
درصد کاهش:
شکل ۷-۴. زیان شبکه چندلایه قبل و بعد از یک گام یادگیری
زیان نمونه آموزشی با نرخ یادگیری ۰٫۱ کاهش یافته است.
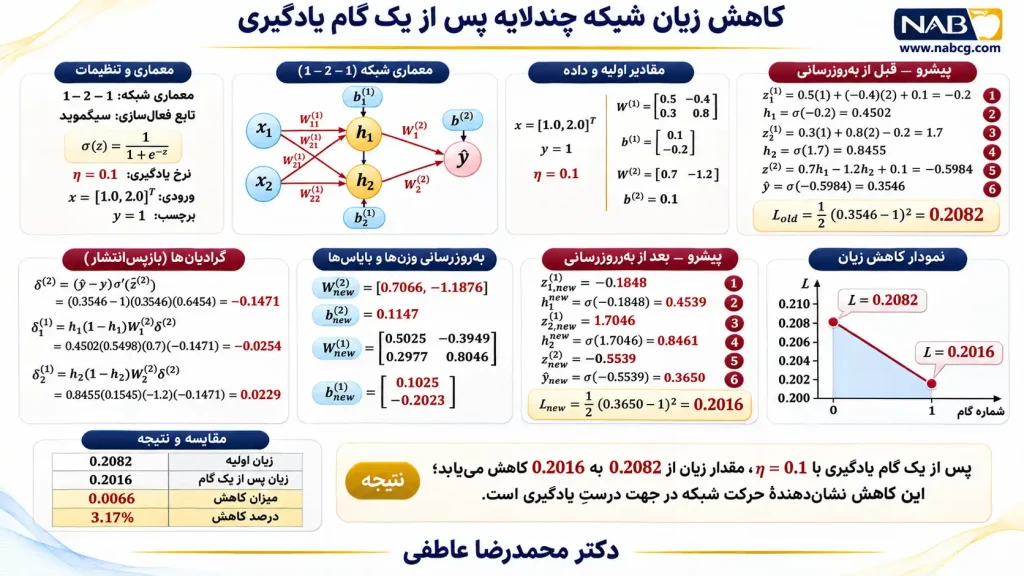
این کاهش نشان میدهد که در این مثال، اصلاح همزمان وزنهای لایه پنهان و خروجی در جهت کاهش زیان عمل کرده است. البته کاهش زیان یک نمونه، تضمینکننده عملکرد مناسب روی نمونههای دیدهنشده نیست.
۷.۱۰. استخراج فرمول عمومی Backpropagation برای شبکهای با (L) لایه
اکنون که محاسبات یک شبکه دولایه را انجام دادیم، میتوانیم الگوریتم را به شبکهای با هر تعداد لایه قابلآموزش تعمیم دهیم.
فرض کنید شبکه دارای (L) لایه باشد. برای هر لایه (l):
۷.۱۰.۱. سیگنال خطای لایه خروجی
در لایه خروجی:
این رابطه برای تابع فعالسازی مؤلفهای معتبر است. اگر فعالسازی خروجی مانند Softmax وابستگی بین مؤلفهها ایجاد کند، باید از ژاکوبین مناسب یا مشتق سادهشده ترکیب فعالسازی و زیان استفاده شود.
۷.۱۰.۲. سیگنال خطای لایههای پنهان
برای هر لایه پنهان:
که برای:
بهترتیب محاسبه میشود.
۷.۱۰.۳. گرادیان وزنها و بایاسها
برای هر لایه:
این چهار رابطه، هسته ریاضی Backpropagation در شبکههای تماممتصل با یک نمونه آموزشی را تشکیل میدهند.
بررسی ابعاد
اگر لایه (l) دارای (n_l) نورون و لایه قبلی دارای (n_{l-1}) نورون باشد:
| متغیر | ابعاد |
|---|---|
| W^(l) | nₗ × nₗ₋₁ |
| 𝐚^(l−1) | nₗ₋₁ × ۱ |
| 𝐳^(l) | nₗ × ۱ |
| δ^(l) | nₗ × ۱ |
| ∇_{W^(l)} ℒ | nₗ × nₗ₋₁ |
| ∇_{𝐛^(l)} ℒ | nₗ × ۱ |
اگر ابعاد محاسبهشده با این جدول سازگار نباشند، احتمالاً ترتیب ضرب ماتریسی یا نحوه تعریف بردارها اشتباه است.
۷.۱۱. الگوریتم عمومی در قالب شبهکد
الگوریتم ۷-۱. Backpropagation یک نمونه در شبکه تماممتصل
Input:
    x, y
    W[1...L], b[1...L]
    learning_rate

Forward:
    a[0] = x

    for l = 1 to L:
        z[l] = W[l] @ a[l-1] + b[l]
        a[l] = activation[l](z[l])

    loss = Loss(a[L], y)

Backward:
    delta[L] =
        grad_output_loss(a[L], y)
        * activation_derivative[L](z[L])

    for l = L-1 down to 1:
        delta[l] =
            (W[l+1].T @ delta[l+1])
            * activation_derivative[l](z[l])

    for l = 1 to L:
        grad_W[l] = delta[l] @ a[l-1].T
        grad_b[l] = delta[l]

Update:
    for l = 1 to L:
        W[l] = W[l] - learning_rate * grad_W[l]
        b[l] = b[l] - learning_rate * grad_b[l]

Output:
    updated W, updated b, loss
نماد * در سطرهای مشتق فعالسازی به معنی ضرب مؤلفهای است. بهروزرسانی فقط پس از محاسبه تمام گرادیانها انجام میشود.
۷.۱۲. پیادهسازی شبکه ۲–۲–۱ بدون Autograd
در این برنامه، تمام مشتقها بهصورت دستی نوشته شدهاند. NumPy فقط عملیات ماتریسی را انجام میدهد.
import numpy as np
def sigmoid(z):
out = np.empty_like(z, dtype=float)
positive = z >= 0
out[positive] = 1 / (1 + np.exp(-z[positive]))
exp_z = np.exp(z[~positive])
out[~positive] = exp_z / (1 + exp_z)
return out
def forward(x, y, W1, b1, W2, b2):
z1 = W1 @ x + b1
a1 = sigmoid(z1)
z2 = W2 @ a1 + b2
a2 = sigmoid(z2)
loss = 0.5 * np.sum((a2 - y) ** 2)
cache = {
"z1": z1,
"a1": a1,
"z2": z2,
"a2": a2,
}
return loss, cache
# داده آموزشی
x = np.array([[1.0], [2.0]])
y = np.array([[1.0]])
# لایه پنهان
W1 = np.array([
[0.2, 0.3],
[0.4, -0.1]
])
b1 = np.array([
[0.1],
[0.2]
])
# لایه خروجی
W2 = np.array([[0.5, -0.4]])
b2 = np.array([[0.1]])
learning_rate = 0.1
# 1. Forward
loss_before, cache = forward(
x, y, W1, b1, W2, b2
)
a1 = cache["a1"]
a2 = cache["a2"]
# 2. Backward: لایه خروجی
delta2 = (a2 - y) * a2 * (1 - a2)
grad_W2 = delta2 @ a1.T
grad_b2 = delta2.copy()
# 3. Backward: لایه پنهان
delta1 = (W2.T @ delta2) * a1 * (1 - a1)
grad_W1 = delta1 @ x.T
grad_b1 = delta1.copy()
# 4. Update: همزمان پس از محاسبه گرادیانها
W1_new = W1 - learning_rate * grad_W1
b1_new = b1 - learning_rate * grad_b1
W2_new = W2 - learning_rate * grad_W2
b2_new = b2 - learning_rate * grad_b2
# 5. Forward جدید
loss_after, new_cache = forward(
x, y,
W1_new, b1_new,
W2_new, b2_new
)
print("Initial loss:", loss_before)
print("Initial prediction:", a2.item())
print("nDelta output:n", delta2)
print("Delta hidden:n", delta1)
print("nGradient W1:n", grad_W1)
print("Gradient b1:n", grad_b1)
print("nGradient W2:n", grad_W2)
print("Gradient b2:n", grad_b2)
print("nUpdated W1:n", W1_new)
print("Updated W2:n", W2_new)
print("nNew prediction:",
new_cache["a2"].item())
print("New loss:", loss_after)
# بررسی ابعاد
assert grad_W1.shape == W1.shape
assert grad_b1.shape == b1.shape
assert grad_W2.shape == W2.shape
assert grad_b2.shape == b2.shape
# بررسی کاهش زیان برای این مثال مشخص
assert loss_after < loss_before
خروجی مورد انتظار
| کمیت | مقدار تقریبی |
| پیشبینی اولیه | ۰٫۵۵۳۷۹۱ |
| زیان اولیه | ۰٫۰۹۹۵۵۱ |
| سیگنال خطای خروجی | −۰٫۱۱۰۲۶۱ |
| سیگنال خطای نورون پنهان اول | −۰٫۰۱۱۳۲۹ |
| سیگنال خطای نورون پنهان دوم | ۰٫۰۱۰۵۹۷ |
| پیشبینی جدید | ۰٫۵۵۹۱۸۶ |
| زیان جدید | ۰٫۰۹۷۱۵۸ |
این برنامه یک گام کامل یادگیری را انجام میدهد. در بخش هشتم، ساختار برنامه را به یک پیادهسازی عمومیتر با تعداد لایههای قابلتنظیم، دستههای آموزشی و حلقه آموزش توسعه خواهیم داد.
۷.۱۳. چرا Backpropagation از محاسبه مستقل همه مشتقها کارآمدتر است؟
فرض کنید شبکهای دارای هزاران پارامتر باشد. اگر برای هر پارامتر، مشتق تابع زیان را از ابتدا و مستقل از پارامترهای دیگر محاسبه کنیم، بخش بزرگی از عملیات مشترک بارها تکرار خواهد شد.
Backpropagation از این تکرار جلوگیری میکند.
برای مثال، در شبکه آموزشی ما، مقدار:
فقط یک بار محاسبه شد؛ اما در محاسبه گرادیان وزنهای خروجی و هر دو نورون پنهان مورد استفاده قرار گرفت.
همچنین خروجیهای ذخیرهشده لایه پنهان در دو مرحله کاربرد داشتند: نخست در انتشار روبهجلو، و سپس در محاسبه گرادیان وزنهای خروجی.
این استفاده مجدد از نتایج میانی، یکی از دلایل اصلی کارایی روش مشتقگیری خودکار در حالت معکوس (Reverse-mode Automatic Differentiation) است.
برای شبکههای تماممتصل متعارف، هزینه محاسباتی یک گذر Backward معمولاً از همان مرتبه هزینه گذر Forward است، نه متناسب با تعداد پارامترها ضربدر هزینه یک Forward مستقل. مقدار دقیق این هزینه به معماری و عملیات شبکه بستگی دارد (Griewank & Walther, 2008).
۷.۱۴. مثال مفهومی: چرا یک نورون پنهان با خروجی ظاهراً مناسب هم ممکن است اصلاح شود؟
فرض کنید نورون پنهان اول خروجی زیر را تولید کرده است:
ممکن است تصور کنیم این مقدار به هدف نهایی یک نزدیک است و بنابراین نباید تغییر زیادی کند.
اما این برداشت نادرست است.
نورون پنهان مستقیماً برای پیشبینی هدف یک آموزش داده نشده است. وظیفه آن تولید یک نمایش میانی است که همراه با سایر نورونها، خروجی نهایی را بهبود دهد.
در مثال ما، وزن اتصال نورون پنهان اول به خروجی مثبت است:
بنابراین افزایش خروجی این نورون، با ثابتماندن سایر متغیرها، مقدار پیشفعالسازی خروجی را افزایش میدهد.
از طرف دیگر، چون خروجی نهایی کمتر از هدف است، گرادیان زیان نسبت به پیشفعالسازی خروجی منفی است.
ترکیب این دو عامل باعث شد:
اما برای نورون پنهان دوم، وزن اتصال به خروجی منفی است:
در نتیجه سیگنال خطای آن مثبت شد:
پس دو نورون پنهان ممکن است با وجود دریافت یک نمونه مشترک، در جهتهای متفاوتی اصلاح شوند.
نتیجه مفهومی: نورونهای پنهان بر اساس میزان مشارکت خود در زیان نهایی آموزش میبینند، نه بر اساس نزدیکی خروجی مستقل آنها به برچسب داده.
۷.۱۵. خطاهای رایج در Backpropagation شبکه چندلایه
| خطا | پیامد | راهحل |
|---|---|---|
| استفاده از W^(l+1) بهجای ترانهاده آن | ناسازگاری ابعاد یا گرادیان نادرست | کنترل ابعاد ماتریسی |
| فراموشکردن مشتق فعالسازی لایه پنهان | انتقال نادرست گرادیان | ضرب مؤلفهای در φ′(z) |
| بهروزرسانی زودهنگام وزنها | استفاده از پارامترهای ناسازگار در یک گام | محاسبه همه گرادیانها قبل از Update |
| اشتباهگرفتن δ^(l) با خطای پیشبینی | مشتق نادرست وزنهای پنهان | تعریف δ^(l) = ∂ℒ/∂𝐳^(l) |
| استفاده از خروجی لایه اشتباه در ضرب بیرونی | گرادیان با ابعاد یا مقدار نادرست | استفاده از 𝐚^(l−1) |
| گردکردن زودهنگام محاسبات | اختلاف عددی و تجمع خطا | نگهداری دقت کامل تا مرحله گزارش |
۷.۱۶. تمرینهای کاربردی و پژوهشی
- تمرین ۱. بازسازی دستی مثال اصلی:تمام مراحل Forward و Backward شبکه ۲–۲–۱ این بخش را بدون استفاده از کد محاسبه کنید. نتایج را با جدولهای بخشهای ۷.۷ تا ۷.۹ مقایسه کنید.
- تمرین ۲. تغییر تابع فعالسازی لایه پنهان:در همان شبکه، تابع فعالسازی لایه پنهان را از Sigmoid به Tanh تغییر دهید، اما تابع خروجی را Sigmoid نگه دارید.خروجی، زیان، سیگنالهای خطا و گرادیانها را مجدداً محاسبه کنید.
- تمرین ۳. بررسی نقش وزنهای خروجی:وزن دوم لایه خروجی را از (-0.4) به (+0.4) تغییر دهید.بررسی کنید سیگنال خطای نورون پنهان دوم چه تغییری میکند و آیا علامت آن عوض میشود یا خیر.
- تمرین ۴. توسعه شبکه به معماری ۲–۳–۱:شبکهای با دو ورودی، سه نورون پنهان و یک نورون خروجی تعریف کنید.تعداد وزنها، بایاسها و پارامترهای کل را محاسبه کرده و ابعاد همه ماتریسهای Forward و Backward را مشخص کنید.
- تمرین ۵. مقایسه نرخهای یادگیریبرنامه این بخش را با نرخهای یادگیری زیر اجرا کنید:
زیان پس از یک گام را برای هر مقدار محاسبه کنید. بررسی کنید آیا نرخ یادگیری بزرگتر همیشه کاهش زیان بیشتری ایجاد میکند.
- تمرین ۶. اثر غیرفعالشدن ReLU:لایه پنهان را به ReLU تغییر دهید. وزنها و بایاسها را طوری انتخاب کنید که پیشفعالسازی یکی از نورونهای پنهان منفی شود.بررسی کنید گرادیان وزنهای ورودی آن نورون چه میشود و علت را توضیح دهید.
- تمرین ۷. بررسی حساسیت به مقدار اولیه:پنج مجموعه وزن اولیه متفاوت برای شبکه ۲–۲–۱ انتخاب کنید.برای هر مجموعه، ۱۰۰ گام یادگیری انجام دهید و منحنی زیان را رسم کنید. تفاوت رفتار آموزش را تحلیل کنید.
- تمرین ۸. استخراج رابطه عمومی:برای یک شبکه سهلایه قابلآموزش، روابط زیر را بهصورت کامل استخراج کنید:
و گرادیان تمام ماتریسهای وزن و بردارهای بایاس را بنویسید.
پاسخ تشریحی منتخب: تمرین ۴
برای معماری ۲–۳–۱:
لایه اول دارای سه نورون است که هرکدام دو ورودی دریافت میکنند:
لایه خروجی یک نورون با سه ورودی دارد:
پس تعداد پارامترها:
ابعاد:
بنابراین:
این ابعاد با ماتریسهای وزن متناظر سازگارند.
۷.۱۷. جمعبندی بخش هفتم
در این بخش آموختیم که آموزش شبکه چندلایه، با وجود داشتن تعداد بیشتری نورون و پارامتر، همچنان بر همان اصولی استوار است که برای یک نورون و یک لایه بررسی کردیم.
تفاوت اصلی آن است که گرادیان زیان در لایههای پنهان، از لایههای بعدی دریافت میشود.
چهار رابطه اساسی Backpropagation در شبکه چندلایه
1. انتشار روبهجلو
2. سیگنال خطای لایه پنهان
3. گرادیان وزنها
4. گرادیان بایاسها
این روابط، پایه محاسباتی آموزش شبکههای عصبی پیشخور تماممتصل هستند. در معماریهای پیچیدهتر، مانند شبکههای کانولوشنی و ترنسفورمرها، ساختار عملیات تغییر میکند؛ اما اصل انتقال گرادیان با قاعده زنجیرهای همچنان برقرار است.
منابع علمی
Baydin, A. G., Pearlmutter, B. A., Radul, A. A., & Siskind, J. M. (2018). Automatic differentiation in machine learning: A survey. Journal of Machine Learning Research, 18(153), 1–43.
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Griewank, A., & Walther, A. (2008). Evaluating derivatives: Principles and techniques of algorithmic differentiation (2nd ed.). SIAM.
Hagan, M. T., Demuth, H. B., Beale, M. H., & De Jesús, O. (2014). Neural network design (2nd ed.). Martin Hagan.
Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. https://doi.org/10.1038/323533a0