۱. چرا شبکه عصبی باید گرادیان خطا را به عقب منتقل کند؟
شبکه عصبی در مرحله انتشار روبهجلو (Forward Propagation) مجموعهای از محاسبات را روی دادههای ورودی انجام میدهد و در نهایت خروجی تولید میکند. اما تولید خروجی، حتی اگر از نظر ریاضی کاملاً صحیح انجام شده باشد، به معنای یادگیری نیست. برای یادگیری، شبکه باید بتواند تشخیص دهد که پارامترهای آن چگونه در خطای پیشبینی نقش داشتهاند.
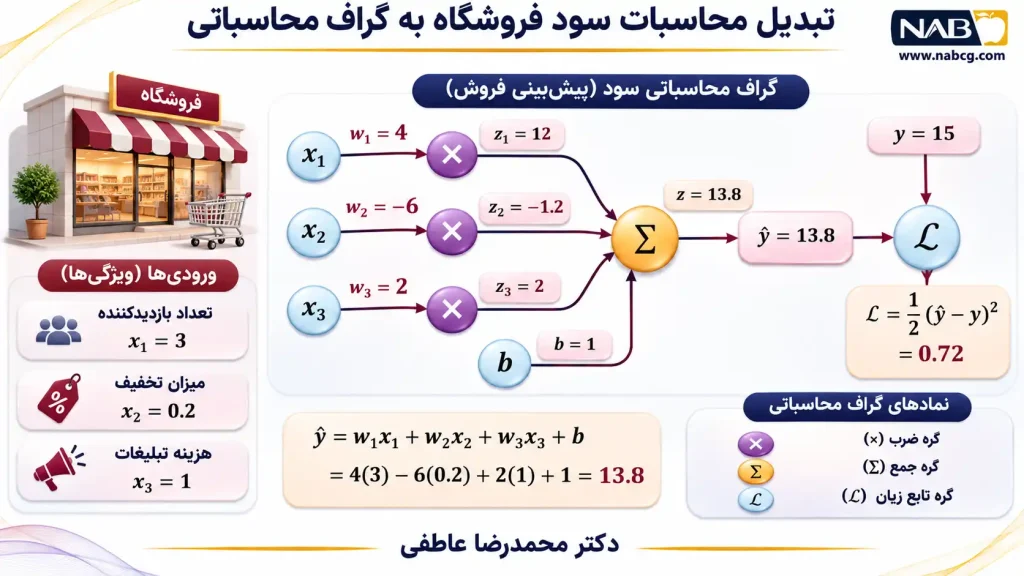
فرض کنید شبکهای برای پیشبینی فروش روزانه یک فروشگاه طراحی کردهایم. ورودیهای شبکه شامل تعداد بازدیدکنندگان، میزان تخفیف و هزینه تبلیغات است. شبکه با استفاده از وزنها و بایاسهای خود، فروش روز بعد را تخمین میزند.
اگر فروش واقعی با مقدار پیشبینیشده متفاوت باشد، میتوانیم خطای پیشبینی را محاسبه کنیم؛ اما هنوز به پرسش مهمتری پاسخ ندادهایم:
کدام وزنها باید تغییر کنند، در چه جهتی و با چه میزان حساسیتی نسبت به خطا؟
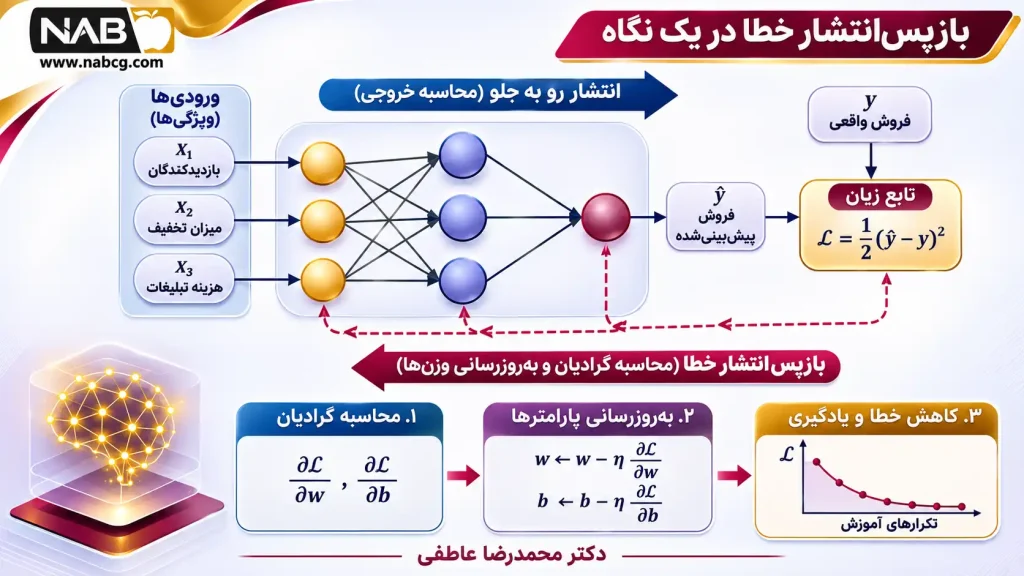
این همان مسئلهای است که محاسبه گرادیان و الگوریتم بازپسانتشار خطا (Backpropagation) برای حل آن به کار میروند.
۱.۱. تفاوت محاسبه خروجی و یادگیری از خطا
برای روشنشدن مسئله، یک مدل بسیار ساده را در نظر میگیریم:
که در آن:
• x: مقدار ورودی؛
• w: وزن ورودی؛
• b: بایاس؛
• ŷ: خروجی پیشبینیشده مدل.
فرض کنید دادههای آموزشی زیر را داریم:
در نتیجه:
اگر مقدار واقعی برابر (y=10) باشد، مدل بهاندازه ۳ واحد کمتر از مقدار واقعی پیشبینی کرده است.
برای اندازهگیری اختلاف پیشبینی و مقدار واقعی، تابع زیان زیر را انتخاب میکنیم:
ضریب ۱/۲ برای سادهشدن مشتقگیری انتخاب شده است و در این مثال، محل مقدار کمینه زیان را تغییر نمیدهد.
با جایگذاری اعداد:
اکنون میدانیم مقدار زیان برابر ۴٫۵ است. بااینحال، این عدد بهتنهایی مشخص نمیکند وزن و بایاس چگونه باید تغییر کنند.
برای مثال، افزایش وزن از ۲ به ۲٫۱ خروجی را به مقدار زیر میرساند:
زیان جدید برابر است با:
در نتیجه، افزایش وزن بهاندازه ۰٫۱ موجب کاهش زیان بهاندازه ۰٫۸۵۵ شده است.
اما اگر بایاس را بهجای وزن افزایش دهیم، چه اتفاقی میافتد؟ آیا اثر آن نیز همین مقدار خواهد بود؟
این پرسش، ما را از مفهوم «خطا» به مفهوم «حساسیت خطا» هدایت میکند.
۱.۲. گرادیان چه اطلاعاتی در اختیار شبکه قرار میدهد؟
گرادیان (Gradient) مجموعه مشتقهای جزئی تابع زیان نسبت به پارامترهای مدل است. برای مدلی با دو پارامتر (w) و (b)، گرادیان بهصورت زیر نوشته میشود:
هر مشتق جزئی نشان میدهد اگر یک پارامتر اندکی تغییر کند و سایر پارامترها ثابت بمانند، زیان با چه نرخ لحظهای تغییر خواهد کرد.
برای مدل خطی ما:
مشتق زیان نسبت به وزن برابر است با:
و مشتق نسبت به بایاس:
این روابط در بخشهای بعدی فصل از قاعده زنجیرهای استخراج خواهند شد. فعلاً از آنها برای تفسیر مفهوم گرادیان استفاده میکنیم.
با قرار دادن مقادیر مثال:
پس:
این نتیجه دو نکته مهم دارد. نخست، در وضعیت فعلی مدل، افزایش اندک هر دو پارامتر میتواند زیان را کاهش دهد، زیرا مشتق هر دو منفی است. دوم، اندازه حساسیت زیان نسبت به وزن، با واحد پارامتر مربوط، سه برابر حساسیت آن نسبت به بایاس است.
البته مقایسه مستقیم اندازه مشتقها برای پارامترهایی با مقیاس یا واحد متفاوت همیشه نشاندهنده اهمیت نسبی آنها نیست. این مقایسه در مثال حاضر صرفاً رفتار محلی تابع زیان را نشان میدهد.
۱.۳. نمایش محاسبات در گراف
در نمودار زیر، تمام محاسبات اصلی مدل نمایش داده شدهاند.
شکل ۱-۱. مسیر محاسبه خروجی و گرادیان
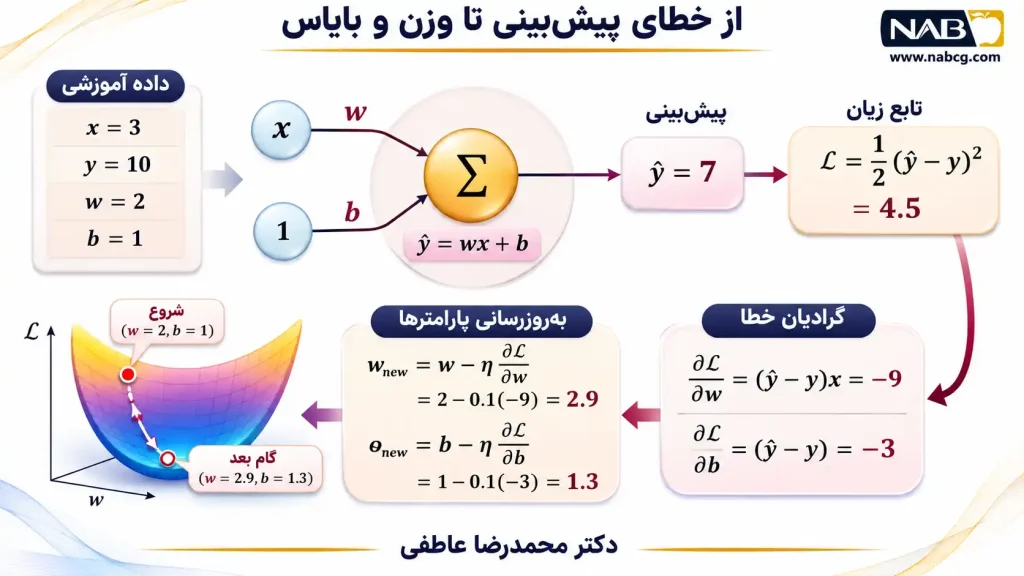
اعداد این شکل از یک مثال آموزشی ساختگی به دست آمدهاند. مسیر پیوسته، محاسبه خروجی و زیان را نشان میدهد؛ مسیر خطچین، محاسبه گرادیان را بهصورت مفهومی نمایش میدهد.
۱.۴. بررسی رفتار تابع زیان با تغییر وزن
برای اینکه مفهوم مشتق ملموستر شود، بایاس را ثابت نگه میداریم و وزن را تغییر میدهیم.
تابع زیان در این حالت عبارت است از:
شکل ۱-۲. تغییر زیان با تغییر وزن
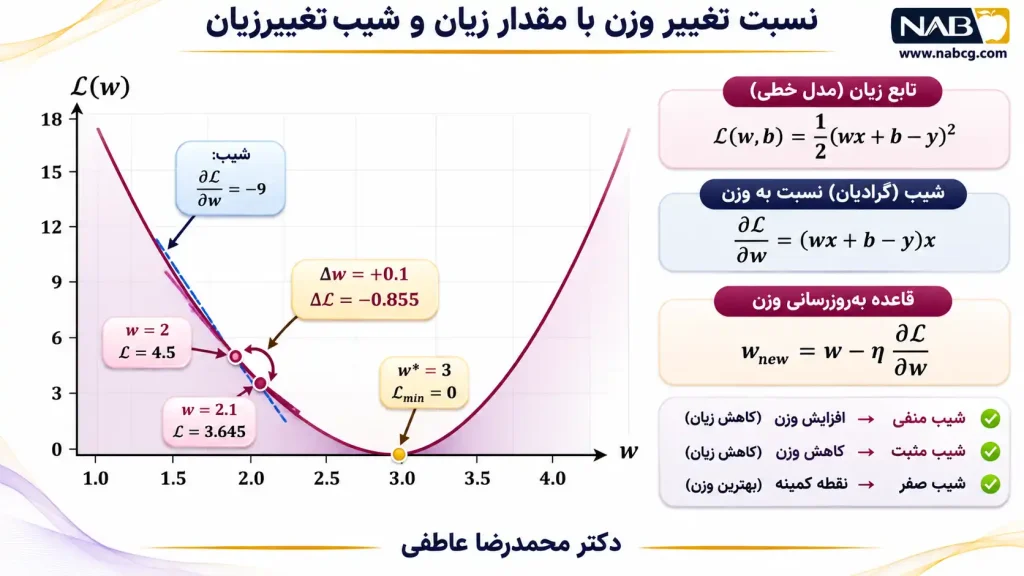
در این مثال بایاس برابر ۱ و مقدار واقعی خروجی برابر ۱۰ ثابت است.
نمودار نشان میدهد در (w=2)، با افزایش وزن، زیان ابتدا کاهش مییابد. این مشاهده با مشتق منفی در همان نقطه سازگار است. در (w=3)، زیان به صفر میرسد و مشتق آن نیز صفر میشود.
توجه کنیم که گرادیان در یک نقطه، شیب محلی تابع را مشخص میکند؛ نه اینکه مقدار تغییر زیان برای هر گام دلخواه دقیقاً برابر حاصلضرب گرادیان در آن گام باشد.
۱.۵. چرا روش تغییر آزمایشی تکتک وزنها کافی نیست؟
در مثال ساده بالا، فقط دو پارامتر داشتیم و میتوانستیم مقدار زیان را با تغییر آنها محاسبه کنیم. اما یک شبکه چندلایه ممکن است میلیونها پارامتر داشته باشد.
اگر بخواهیم مشتق هر پارامتر را با روش تفاضل مرکزی محاسبه کنیم، برای هر پارامتر به دو ارزیابی تابع زیان نیاز داریم:
در شبکهای با یک میلیون پارامتر، این روش به حدود دو میلیون ارزیابی تابع زیان برای محاسبه یک گرادیان کامل نیاز دارد.
در مقابل، Backpropagation با استفاده مجدد از محاسبات میانی و انتقال نظاممند گرادیانها در جهت معکوس، تمام گرادیانها را با هزینهای که معمولاً هممرتبه با هزینه محاسبه روبهجلو شبکه است به دست میآورد (Goodfellow et al., 2016).
این مزیت محاسباتی، یکی از دلایل اساسی کاربرد Backpropagation در یادگیری عمیق است.
۱.۶. یک مثال کاربردی دیگر: پیشبینی مصرف انرژی
فرض کنید یک مدل خطی ساده برای پیشبینی مصرف انرژی یک دستگاه داریم:
در این مثال ساختگی، (x1) و (x2) ویژگیهای عددی نرمالسازیشده مربوط به مدت فعالیت و بار دستگاه هستند. فرض کنید:
خروجی مدل:
زیان:
مشتق زیان نسبت به خروجی:
بنابراین:
| پارامتر | مقدار | گرادیان |
| وزن مدت فعالیت | ۰٫۵ | ۴- |
| وزن بار دستگاه | ۰٫۲ | ۵- |
| بایاس | ۱ | ۱- |
این مثال نشان میدهد گرادیان تنها به اختلاف خروجی و مقدار واقعی وابسته نیست؛ بلکه مقدار ورودی مرتبط با هر وزن نیز در آن نقش دارد.
ازاینرو، پیشپردازش و مقیاسبندی ویژگیها میتوانند بر مقیاس گرادیانها اثر بگذارند. تحلیل جامع این موضوع به فصل بهینهسازی و آمادهسازی دادهها تعلق دارد.
۱.۷. جمعبندی
تا اینجا سه نتیجه به دست آوردهایم.
نخست، محاسبه مقدار زیان برای یادگیری کافی نیست. شبکه به اطلاعاتی درباره حساسیت زیان نسبت به پارامترهای خود نیاز دارد.
دوم، مشتق هر پارامتر مشخص میکند که تغییر کوچک آن پارامتر، در شرایط ثابتبودن سایر پارامترها، چگونه بر زیان اثر میگذارد.
سوم، محاسبه مستقل مشتقها با اجرای مکرر کل شبکه در مقیاس بزرگ پرهزینه است. Backpropagation با استفاده از ساختار وابستگی محاسبات، این مسئله را بهصورت کارآمد حل میکند.
تمرینهای بخش اول
- تمرین ۱ ـ محاسباتی: برای مدل (ŷ = wx + b)، با مقادیر (x=4)، (w=1.5)، (b=2) و (y=10)، خروجی، زیان مربعی نصفشده و گرادیان وزن و بایاس را محاسبه کنید.
- تمرین ۲ ـ کاربردی: یک فروشگاه اینترنتی از دو ویژگی «تعداد بازدیدکنندگان» و «بودجه تبلیغات» برای پیشبینی فروش استفاده میکند. توضیح دهید چرا مقایسه مستقیم اندازه گرادیان دو وزن، بدون توجه به واحد و مقیاس ورودیها، ممکن است گمراهکننده باشد.
- تمرین ۳ ـ تحلیلی: در مدل (ŷ=2w+1)، مقدار واقعی (y=9) است. وزن متناظر با زیان صفر را به دست آورید و نشان دهید مشتق تابع زیان در آن نقطه صفر است.
- تمرین ۴ ـ مفهومی: تفاوت مقدار زیان، گرادیان زیان و تغییر پارامتر در یک گام بهینهسازی را توضیح دهید.
- تمرین ۵ ـ پژوهشی مقدماتی: چرا محاسبه گرادیان با تفاضل مرکزی، با وجود هزینه زیاد، همچنان برای بررسی صحت پیادهسازی Backpropagation مفید است؟
منابع
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Nielsen, M. A. (2015). Neural networks and deep learning. Determination Press.
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
۲. گراف محاسباتی؛ چگونه مسیر محاسبه به مسیر انتقال گرادیان تبدیل میشود؟
در بخش پیشین مشاهده کردیم که مقدار زیان بهتنهایی مشخص نمیکند هر پارامتر شبکه چه سهمی در تغییر خطا دارد. همچنین دیدیم که مشتقگیری مستقل از هر پارامتر، با اجرای مکرر کل شبکه، برای مدلهای بزرگ پرهزینه است.
اکنون مسئله دقیقتری پیش روی ما قرار دارد: چگونه میتوان یک محاسبه پیچیده را به عملیات سادهتر تقسیم کرد تا هم خروجی آن محاسبه شود و هم مشتقهای موردنیاز را بتوان بهشکلی منظم به دست آورد؟
پاسخ در مفهوم گراف محاسباتی (Computational Graph) نهفته است. گراف محاسباتی، نمایش ساختاری یک محاسبه ریاضی بهصورت مجموعهای از عملیات و وابستگیهای میان آنهاست. این نمایش، بنیان محاسباتی بازپسانتشار خطا و مشتقگیری خودکار در حالت معکوس را فراهم میکند (Goodfellow et al., 2016; Baydin et al., 2018).
۲.۱. چرا یک فرمول ریاضی را به گراف تبدیل میکنیم؟
فرض کنید یک شرکت برای محاسبه درآمد حاصل از فروش محصول، از رابطه زیر استفاده میکند:
در این رابطه، (p) قیمت هر واحد محصول، (q) تعداد واحدهای فروختهشده و (R) درآمد فروش است.
اگر قیمت هر واحد ۲۰۰ هزار تومان و تعداد فروش ۳۰ واحد باشد، درآمد برابر است با:
بنابراین درآمد ۶۰۰۰ هزار تومان، معادل ۶ میلیون تومان خواهد بود.
اکنون فرض کنید شرکت میخواهد سود خود را محاسبه کند و هزینه کل برابر ۱۰۰۰ هزار تومان باشد:
در نتیجه:
سود شرکت ۵ میلیون تومان است.
میتوان این دو رابطه را در یک فرمول ترکیب کرد:
این فرمول کوتاه است، اما دو عملیات مستقل در آن وجود دارد: ابتدا ضرب قیمت در تعداد فروش، سپس کمکردن هزینه از درآمد.
گراف محاسباتی همین ترتیب را آشکار میکند.
شکل ۲-۱. گراف محاسباتی سود فروشگاه
در شکل ۲-۱. مقادیر پولی داخل نمودار برحسب هزار تومان هستند. هر گره عملیاتی، مقدار ورودیهای خود را دریافت کرده و نتیجهای محاسبه میکند که در مراحل بعدی استفاده میشود.
تفاوت اصلی این نمودار با فرمول فشرده (P=pq-C) در آن است که مقادیر میانی، ترتیب عملیات و وابستگی هر خروجی به ورودیهای قبلی بهصورت آشکار نمایش داده شدهاند.
این ویژگی زمانی اهمیت بیشتری پیدا میکند که بهجای دو عملیات، صدها یا هزاران عملیات وابسته داشته باشیم.
۲.۲. اجزای گراف محاسباتی
یک گراف محاسباتی را میتوان با چهار جزء اصلی توضیح داد: متغیرهای ورودی، عملیات، مقادیر میانی و خروجی نهایی.
برای نمونه، تابع زیر را در نظر بگیرید:
بهجای محاسبه مستقیم، آن را به سه مرحله تقسیم میکنیم:
اگر (x=3) باشد:
| گام | عملیات | ورودی | خروجی |
| ۱ | ضرب در ۲ | (x=3) | (u=6) |
| ۲ | جمع با ۱ | (u=6) | (v=7) |
| ۳ | توان دوم | (v=7) | (f=49) |
در این مثال، (u) و (v) متغیرهای میانی هستند. این متغیرها صرفاً برای سادهترکردن نوشتن فرمول ایجاد نشدهاند؛ در زمان محاسبه گرادیان نیز اطلاعات ارزشمندی در اختیار ما قرار میدهند.
۲.۳. انتشار روبهجلو در گراف محاسباتی
فرایند محاسبه مقادیر از ورودی به خروجی، عبور روبهجلو (Forward Pass) نام دارد.
در مثال قبل، محاسبات به ترتیب زیر انجام میشوند:
شکل ۲-۲. انتشار روبهجلو با نمایش محاسبات
در این مرحله هنوز مشتقگیری انجام ندادهایم. تنها مقادیر تمام گرهها را محاسبه کردهایم.
بااینحال، همین مقادیر در عبور روبهعقب موردنیاز خواهند بود. برای مثال، مشتق تابع توان دوم (v^2) به مقدار (v) وابسته است؛ بنابراین دانستن اینکه (v=7) بوده، محاسبه مشتق را ساده میکند.
۲.۴. بازگشت گرادیان در همان گراف
اکنون فرض کنید بخواهیم بدانیم تغییر کوچک (x) چه اثری بر (f) دارد.
تابع اصلی عبارت است از:
با مشتقگیری مستقیم:
در (x=3):
اما گراف محاسباتی به ما امکان میدهد همین نتیجه را از طریق مشتقهای کوچکتر به دست آوریم.
ابتدا از آخرین عملیات شروع میکنیم:
مشتق محلی:
در مرحله قبل:
بنابراین:
و در اولین عملیات:
پس:
حاصلضرب این مشتقها برابر است با:
این محاسبه، نخستین نمونه ساده از منطق بازپسانتشار است: مشتقهای محلی از انتهای مسیر به ابتدای آن ترکیب میشوند.
شکل ۲-۳. مقایسه محاسبات Forward و Backward
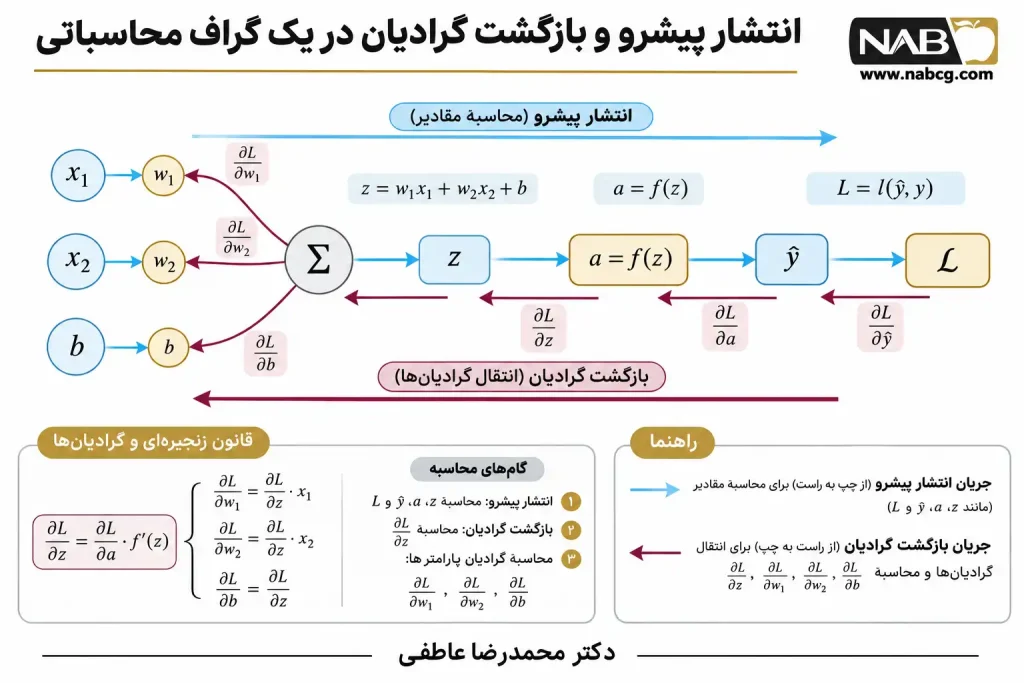
در شکل ۲-۳. در عبور روبهجلو مقادیر محاسبه میشوند و در عبور روبهعقب، حساسیت خروجی نسبت به متغیرهای میانی و ورودی به دست میآید. مقدار اولیه گرادیان خروجی نسبت به خودش برابر یک است.
این شکل تفاوت مهمی را آشکار میکند: جهت حرکت محاسبات Forward و Backward مخالف یکدیگر است، اما هر دو از همان ساختار وابستگی استفاده میکنند.
۲.۵. گراف محاسباتی دارای چند مسیر
تا اینجا تمام مثالها یک مسیر محاسباتی اصلی داشتند. اما در شبکههای عصبی، ممکن است یک متغیر در چند عملیات مختلف استفاده شود.
برای مثال، تابع زیر را در نظر بگیرید:
متغیر (x) از دو مسیر در مقدار نهایی (f) نقش دارد:
اگر (x=2) باشد:
برای محاسبه مشتق کل، باید اثر هر دو مسیر را در نظر بگیریم:
از آنجا که:
نتیجه میشود:
شکل ۲-۴. جمع گرادیانها در مسیرهای منشعب
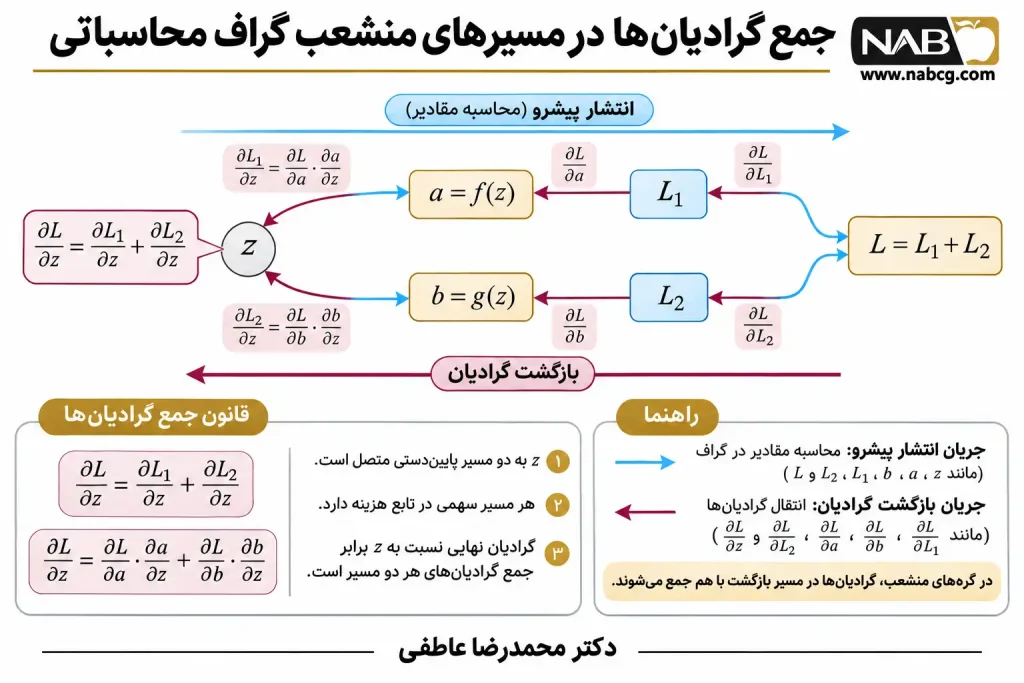
در شکل ۲-۴. متغیر (x) در دو مسیر مستقل ظاهر شده است. در بازپسانتشار، سهم گرادیانهای بازگشتی از هر دو مسیر باید جمع شود.
اصل مهم: اگر یک متغیر در چند مسیر محاسباتی بر خروجی اثر بگذارد، مشتق کل نسبت به آن متغیر، حاصل جمع مشارکتهای تمام مسیرهای وابسته است.
این اصل در شبکههای چندشاخه، اتصالهای میانبُر و ساختارهای پیچیدهتر اهمیت اساسی دارد. در بخش چهارم فصل، قاعده زنجیرهای را برای چنین گرافهایی بهصورت دقیقتر استخراج خواهیم کرد.
۲.۶. تبدیل یک نورون مصنوعی به گراف محاسباتی
اکنون گراف محاسباتی را به مسئله اصلی فصل، یعنی شبکه عصبی، متصل میکنیم.
یک نورون با دو ورودی را در نظر بگیرید:
فرض کنید تابع فعالسازی φ در این مثال، ReLU باشد:
مقادیر زیر را انتخاب میکنیم:
محاسبه نورون:
چون (z) مثبت است:
فرض کنید مقدار هدف برابر (y=2) باشد و زیان به شکل زیر تعریف شود:
در نتیجه:
گراف محاسباتی این نورون شامل عملیات ضرب، جمع، فعالسازی و محاسبه زیان است. در این ساختار، هر وزن مستقیماً بر یک حاصلضرب اثر میگذارد و اثر آن از طریق جمع وزندار، تابع فعالسازی و تابع زیان به خروجی نهایی منتقل میشود.
شکل ۲-۵. گراف محاسباتی نورون با مقادیر عددی
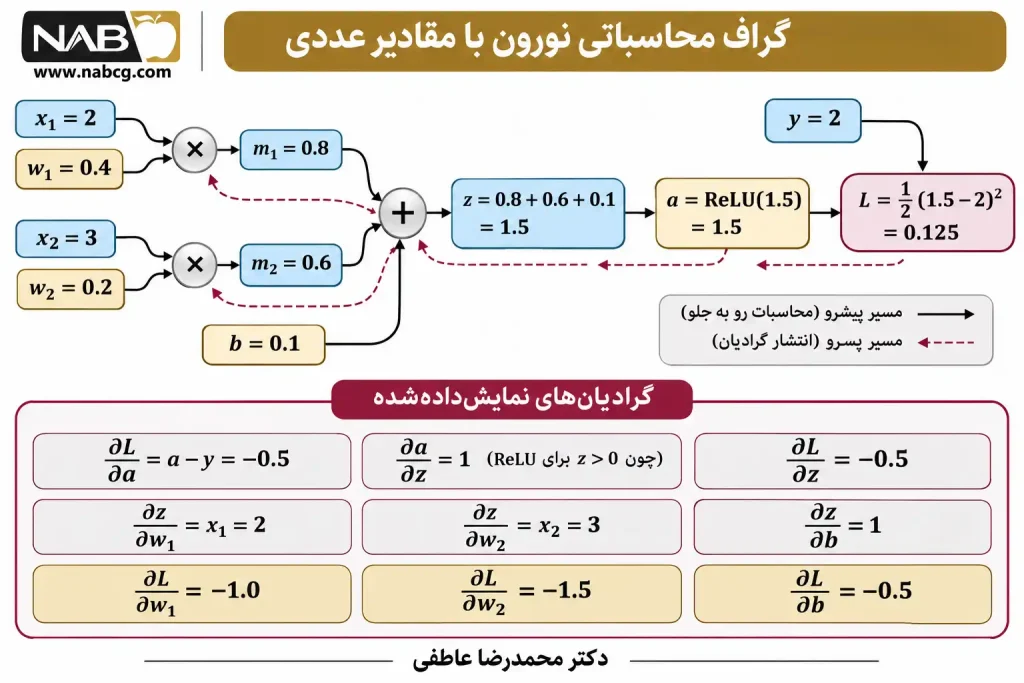
در شکل ۲-۵. در مسیر روبهجلو، مقدار خروجی و زیان محاسبه شده است. مقادیر گرادیان نیز در بخش پایینی نشان داده شدهاند و استخراج کامل آنها در بخش پنجم فصل انجام خواهد شد.
در این مثال، هر مرحله از محاسبات نورون به یک عملیات ساده تبدیل شده است. همین ساختار برای یک لایه یا شبکه چندلایه نیز قابل استفاده است؛ تفاوت در تعداد گرهها، ابعاد متغیرها و وابستگیهای میان آنهاست.
۲.۷. گراف محاسباتی شبکه چندلایه
برای شبکهای با دو لایه پارامتردار، محاسبات روبهجلو بهصورت زیر هستند:
در این روابط، W^(l) ماتریس وزنهای لایه l، b^(l) بردار بایاس و a^(l) خروجی فعالسازی همان لایه است.
برای نمایش وابستگیها، گراف را میتوان به شکل زیر خلاصه کرد:
شکل ۲-۶. مسیر محاسبات در شبکه دولایه
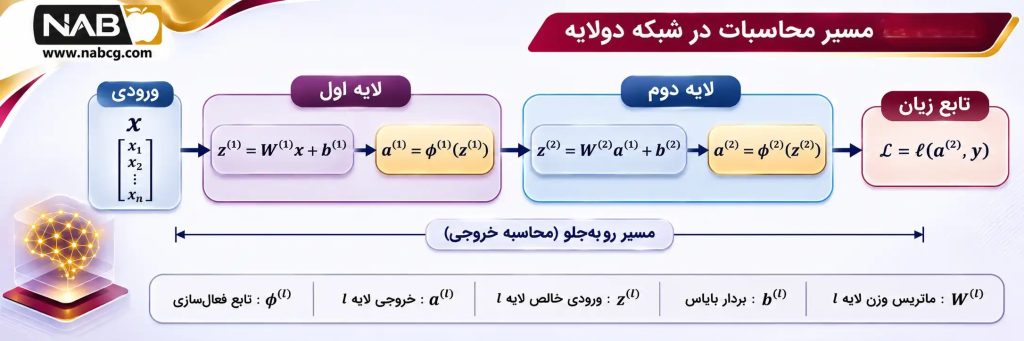
در شکل ۲-۶. نمای خلاصهشده شبکه است؛ گرههای فعالسازی خروجی و عملیات داخلی هر لایه برای خوانایی ادغام شدهاند. در بخش هفتم، گراف کامل با مقادیر عددی و ابعاد ماتریسی توسعه مییابد.
در این شبکه، خروجی لایه اول به ورودی لایه دوم تبدیل میشود. بنابراین وزنهای لایه اول بهطور غیرمستقیم بر زیان نهایی اثر میگذارند. محاسبه این اثر غیرمستقیم همان مسئلهای است که Backpropagation با استفاده از قاعده زنجیرهای حل میکند.
۲.۸. چرا مقادیر میانی را ذخیره میکنیم؟
در محاسبات روبهعقب، مشتق یک عملیات معمولاً به مقادیر محاسبهشده در مسیر روبهجلو وابسته است.
برای نمونه:
مشتق آن برابر است با:
بنابراین هنگام محاسبه گرادیان، دانستن مقدار (x) ضروری است.
یا برای تابع Sigmoid:
مشتق برابر است با:
در این حالت میتوان از مقدار فعالسازی (a) که در مرحله روبهجلو محاسبه شده است، برای به دست آوردن مشتق استفاده کرد.
در نتیجه، ذخیره مقادیر میانی میتواند از محاسبات تکراری جلوگیری کند؛ هرچند نگهداری این مقادیر به حافظه نیاز دارد. روشهای پیشرفتهتر، مانند بازمحاسبه انتخابی فعالسازیها، میان هزینه حافظه و محاسبات مصالحه برقرار میکنند.
در فصل حاضر، برای روشنماندن الگوریتم، ابتدا فرض میکنیم مقادیر لازم از Forward Pass ذخیره شدهاند.
۲.۹. مثال تکمیلی: محاسبه هزینه تولید با گراف چندمرحلهای
فرض کنید هزینه کل تولید یک محصول از رابطه زیر محاسبه میشود:
که (q) تعداد واحد تولید و (C) هزینه برحسب واحد پولی فرضی است.
برای (q=10):
حال میخواهیم بدانیم افزایش بسیار کوچک مقدار تولید، هزینه را با چه نرخی تغییر میدهد.
مشتق مسیر اول:
مشتق مسیر دوم:
بنابراین:
این مقدار، هزینه نهایی (Marginal Cost) در (q=10) را در مدل پیوسته نشان میدهد. نباید آن را بدون تقریب یا محاسبه جداگانه، با افزایش دقیق هزینه ناشی از تولید یک واحد کامل برابر دانست.
برای مثال:
و بنابراین:
اختلاف میان ۴۵ و ۴۷ نشان میدهد مشتق، نرخ تغییر لحظهای را بیان میکند، درحالیکه اختلاف دو مقدار تابع، تغییر واقعی در یک فاصله محدود را اندازه میگیرد.
این تمایز در تفسیر گرادیانهای شبکه عصبی نیز اهمیت دارد.
۲.۱۰. تمرینها و مسائل بخش دوم
- تمرین ۱ ـ ترسیم گراف: تابع (f(x)=3x^2+2) را به عملیات ساده تقسیم کنید. برای (x=2)، مقادیر تمام گرهها را محاسبه کرده و گراف آن را ترسیم کنید.
- تمرین ۲ ـ مشتق مسیر: برای تابع (f(x)=(x+2)^3)، گراف محاسباتی بسازید و مشتق آن را در (x=1) از طریق مشتقهای محلی به دست آورید.
- تمرین ۳ ـ مسیرهای منشعب: تابع (f(x)=x^3+2x^2) را در نظر بگیرید. با استفاده از دو مسیر مستقل، مشتق تابع را در (x=2) محاسبه کنید.
- تمرین ۴ ـ کاربرد مالی: سود یک شرکت از رابطه (P(q)=20q-2q^2-30) پیروی میکند. گراف محاسباتی تابع را رسم کرده و حساسیت سود نسبت به تعداد تولید را در (q=3) محاسبه کنید.
- تمرین ۵ ـ نورون مصنوعی: برای نورونی با x₁ = ۱، x₂ = ۲، w₁ = ۰٫۵، w₂ = −۰٫۲، b = ۰٫۱ و فعالسازی ReLU، تمام مقادیر روبهجلو را محاسبه کنید. سپس با فرض y = ۱، زیان مربعی نصفشده را به دست آورید.
- تمرین ۶ ـ تحلیل محاسباتی: توضیح دهید چرا ذخیرهکردن مقدار فعالسازیهای میانی میتواند محاسبه گرادیان را آسانتر کند و در عین حال مصرف حافظه را افزایش دهد.
پاسخ منتخب: تمرین ۲
برای تابع:
ابتدا تعریف میکنیم:
در (x=1):
مشتقهای محلی:
بنابراین:
منابع بخش دوم
Baydin, A. G., Pearlmutter, B. A., Radul, A. A., & Siskind, J. M. (2018). Automatic differentiation in machine learning: A survey. Journal of Machine Learning Research, 18(153), 1–43.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Griewank, A., & Walther, A. (2008). Evaluating derivatives: Principles and techniques of algorithmic differentiation (2nd ed.). SIAM.
۳. مشتق محلی؛ از تغییر یک متغیر تا محاسبه حساسیت
۳.۱. مشتق چه چیزی را اندازهگیری میکند؟
فرض کنید مدیر یک کارخانه میخواهد بداند افزایش مقدار تولید چه اثری بر هزینه کل دارد.
برای یک مدل آموزشی ساده، هزینه تولید را بهصورت زیر تعریف میکنیم:
در این رابطه، (q) مقدار تولید و (C) هزینه کل برحسب واحد پولی فرضی است.
اگر مقدار تولید ۵ واحد باشد:
اگر تولید به ۶ واحد افزایش یابد:
پس افزایش هزینه برای این تغییر برابر است با:
و نرخ تغییر متوسط هزینه در این فاصله:
اما آیا نرخ تغییر هزینه دقیقاً در نقطه (q=5) نیز برابر ۲۲ است؟
خیر. مقدار ۲۲، نرخ تغییر متوسط در فاصله ۵ تا ۶ است. برای محاسبه نرخ تغییر لحظهای، باید فاصله تغییر را به صفر نزدیک کنیم.
تعریف مشتق چنین است:
در این رابطه، (h) تغییر کوچک در مقدار تولید است.
اکنون تابع هزینه را جایگذاری میکنیم:
با بسط عبارت:
بنابراین:
برای h ≠ ۰، صورت و مخرج را بر h تقسیم میکنیم:
در نتیجه:
در نقطه (q=5):
این نتیجه نشان میدهد اگر مقدار تولید در نزدیکی ۵ واحد، بهاندازه بسیار کوچکی تغییر کند، هزینه با نرخ تقریبی ۲۰ واحد پولی بهازای هر واحد تولید تغییر خواهد کرد.
نکته آموزشی: مشتق، تغییر واقعی تابع برای یک گام بزرگ را مشخص نمیکند؛ بلکه حساسیت محلی تابع را اندازه میگیرد.
شکل ۳-۱. تابع هزینه و خط مماس در مقدار تولید ۵ واحد
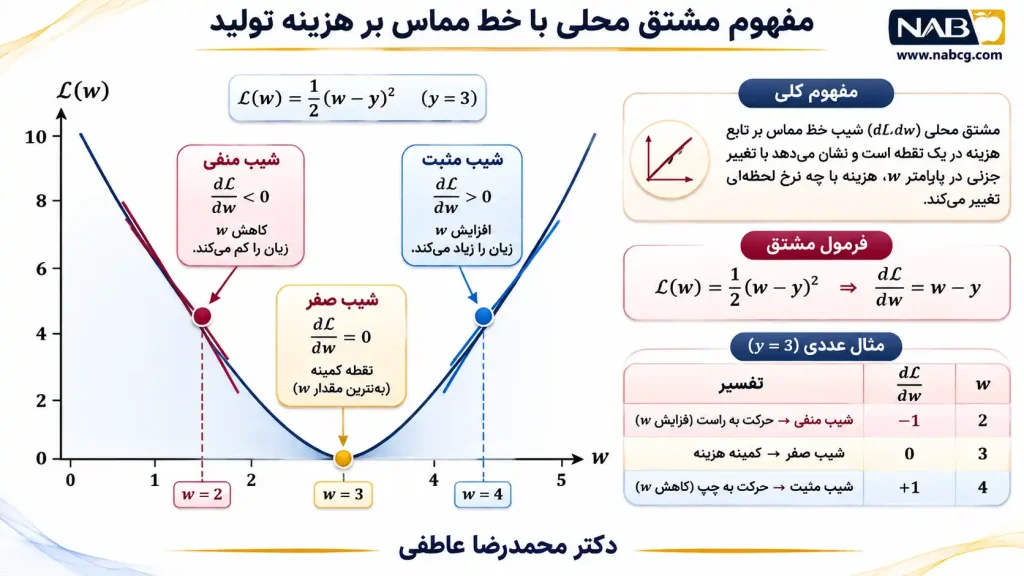
نمای شماتیک تابع (C(q)=2q^2+100) و مماس آن در (q=5). شیب مماس برابر ۲۰ است. محور عمودی هزینه را نشان میدهد.
برای مقایسه عددی دقیقتر، تغییرهای کوچکتر را بررسی میکنیم.
| تغییر تولید (h) | هزینه جدید (C(5+h)) | نرخ تغییر متوسط |
| ۱ | ۱۷۲ | ۲۲ |
| ۰٫۵ | ۱۶۰٫۵ | ۲۱ |
| ۰٫۱ | ۱۵۲٫۰۲ | ۲۰٫۲ |
| ۰٫۰۱ | ۱۵۰٫۲۰۰۲ | ۲۰٫۰۲ |
| ۰٫۰۰۱ | ۱۵۰٫۰۲۰۰۰۲ | ۲۰٫۰۰۲ |
مشاهده میکنیم که هرچه (h) کوچکتر میشود، نرخ تغییر متوسط به مقدار مشتق یعنی ۲۰ نزدیکتر میشود.
این همان منطقی است که در محاسبه گرادیان شبکه عصبی استفاده میشود: مشتق مشخص میکند تغییر کوچک یک پارامتر، چه اثری بر خروجی یا زیان خواهد گذاشت.
۳.۲. مشتق محلی چیست؟
فرض کنید یک گره محاسباتی، مقدار (u) را دریافت کرده و خروجی (v) را تولید میکند:
مشتق محلی این گره برابر است با:
این مشتق تنها رابطه میان ورودی و خروجی همان عملیات را توصیف میکند. برای محاسبه آن لازم نیست بدانیم متغیر (u) چگونه تولید شده یا خروجی (v) در کدام عملیات بعدی استفاده خواهد شد.
برای مثال، اگر:
مشتق محلی برابر است با:
این یعنی تغییر بسیار کوچک u بهاندازه Δu، تغییر خروجی را تقریباً بهاندازه ۳Δu ایجاد میکند:
اگر (u) از ۴ به ۴٫۰۱ تغییر کند، چون تابع خطی است:
پس:
که دقیقاً با رابطه زیر مطابقت دارد:
در توابع غیرخطی، این رابطه معمولاً تقریبی است و برای تغییرهای کوچک دقت بیشتری دارد.
۳.۳. مشتق محلی عملیات پایه
گرافهای محاسباتی شبکههای عصبی از عملیات سادهای مانند جمع، ضرب، تقسیم، توان، توابع فعالسازی و عملیات ماتریسی تشکیل میشوند.
برای فهم Backpropagation لازم است مشتق محلی این عملیات را بشناسیم.
۳.۳.۱. مشتق گره جمع
فرض کنید:
اگر (y) ثابت باشد، افزایش (x) بهاندازه ۰٫۱ موجب افزایش (z) به همان اندازه میشود.
بنابراین:
به همین ترتیب:
مثال عددی:
اگر (x) از ۴ به ۴٫۲ افزایش یابد:
پس:
تفسیر: گره جمع، حساسیت خروجی نسبت به هر ورودی را بدون تغییر مقیاس عبور میدهد.
۳.۳.۲. مشتق گره ضرب
فرض کنید:
مشتق نسبت به (x)، درحالیکه (y) ثابت است:
و مشتق نسبت به (y):
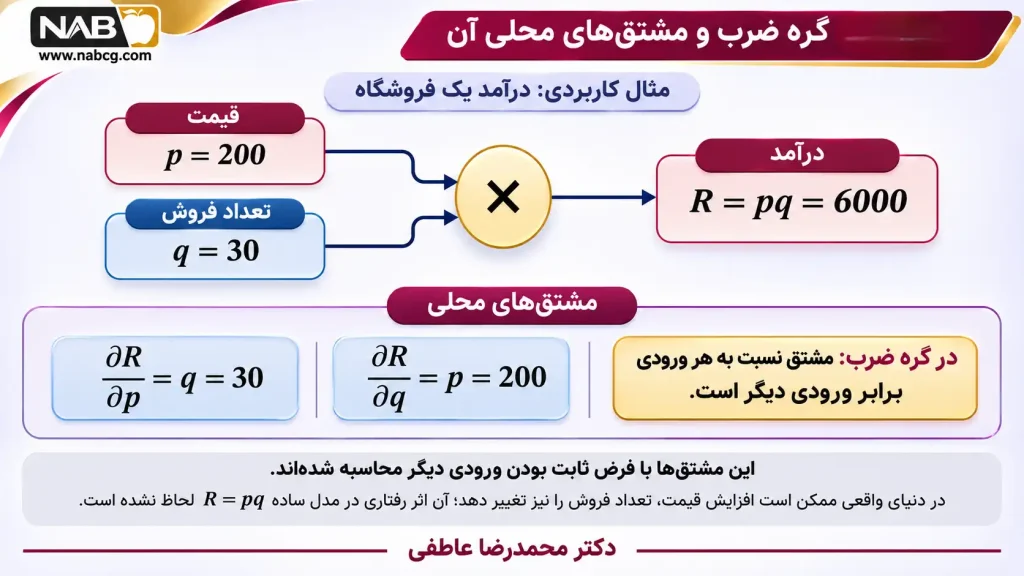
مثال کاربردی: درآمد یک فروشگاه
اگر:
آنگاه:
مشتق درآمد نسبت به قیمت:
و مشتق درآمد نسبت به تعداد فروش:
این مشتقها تحت فرض ثابتماندن ورودی دیگر محاسبه شدهاند. در دنیای واقعی ممکن است افزایش قیمت، تعداد فروش را نیز تغییر دهد؛ آن اثر رفتاری در مدل ساده (R=pq) لحاظ نشده است.
شکل ۳-۲. گره ضرب و مشتقهای محلی آن
۳.۳.۳. مشتق گره توان
اگر:
که (n) یک توان ثابت حقیقی است و تابع در نقطه موردنظر مشتقپذیر باشد، مشتق بهصورت زیر است:
برای مثال:
در (x=2):
این یعنی در نزدیکی (x=2)، افزایش کوچک ورودی بهاندازه ۰٫۰۱، خروجی را تقریباً ۰٫۱۲ افزایش میدهد.
مقدار دقیق:
مقدار تقریبی مبتنی بر مشتق:
اختلاف این دو مقدار، ناشی از غیرخطیبودن تابع است.
۳.۳.۴. مشتق گره تقسیم
اگر:
آنگاه:
فرض کنید هزینه متوسط تولید از تقسیم هزینه کل بر تعداد تولید به دست آید:
اگر:
آنگاه:
مشتق هزینه متوسط نسبت به هزینه کل، با ثابتبودن مقدار تولید:
و مشتق نسبت به تعداد تولید، با ثابتبودن هزینه کل:
توجه کنید که این تحلیل، هزینه کل را مستقل از تعداد تولید فرض میکند. اگر هزینه کل خود تابعی از (q) باشد، برای محاسبه مشتق کل باید وابستگی آن را نیز در نظر گرفت.
۳.۴. مشتق جزئی؛ وقتی یک گره چند ورودی دارد
تا اینجا برخی گرهها دارای یک ورودی و برخی دارای دو ورودی بودند. برای گرههایی با چند ورودی، از مفهوم مشتق جزئی (Partial Derivative) استفاده میکنیم.
فرض کنید:
مشتق نسبت به (x1)، درحالیکه (x2) ثابت است:
و مشتق نسبت به (x2):
این دو مشتق نشان میدهند خروجی نسبت به تغییرهای کوچک هر ورودی، با ثابتماندن ورودی دیگر، چه حساسیتی دارد.
مثال کاربردی: پیشبینی هزینه تبلیغات
فرض کنید یک مدل ساده، تعداد سفارشهای روزانه را از دو ورودی پیشبینی میکند:
که در آن:
• x₁: تعداد واحدهای تبلیغات آنلاین؛
• x₂: تعداد واحدهای تبلیغات محیطی؛
• ŷ: تعداد سفارش پیشبینیشده.
فرض کنید:
آنگاه:
مشتقهای جزئی:
بنابراین در این مدل، افزایش یک واحدی تبلیغات محیطی، با ثابتماندن تبلیغات آنلاین، اثر عددی بیشتری بر خروجی دارد.
اما این نتیجه بهتنهایی نشاندهنده اثربخشی اقتصادی بیشتر تبلیغات محیطی نیست؛ زیرا هزینه هر واحد تبلیغ و رابطه واقعی تبلیغات با سفارشها مشخص نشده است.
۳.۵. مشتق محلی در تابع زیان
در شبکه عصبی، آخرین گره محاسباتی معمولاً تابع زیان (Loss Function) است.
یکی از سادهترین توابع زیان برای آموزش مفاهیم مشتقگیری، زیان مربعی نصفشده است:
در این رابطه، ŷ پیشبینی مدل و y مقدار واقعی است.
با ثابتبودن (y)، مشتق زیان نسبت به خروجی مدل برابر است با:
برای مثال، اگر:
آنگاه:
اگر پیشبینی به ۱۲ افزایش یابد:
در حالت اول، مشتق منفی است و افزایش کوچک پیشبینی، زیان را کاهش میدهد. در حالت دوم، مشتق مثبت است و کاهش کوچک پیشبینی، زیان را کاهش میدهد.
شکل ۳-۳. زیان مربعی نصفشده برای مقدار واقعی ۱۰
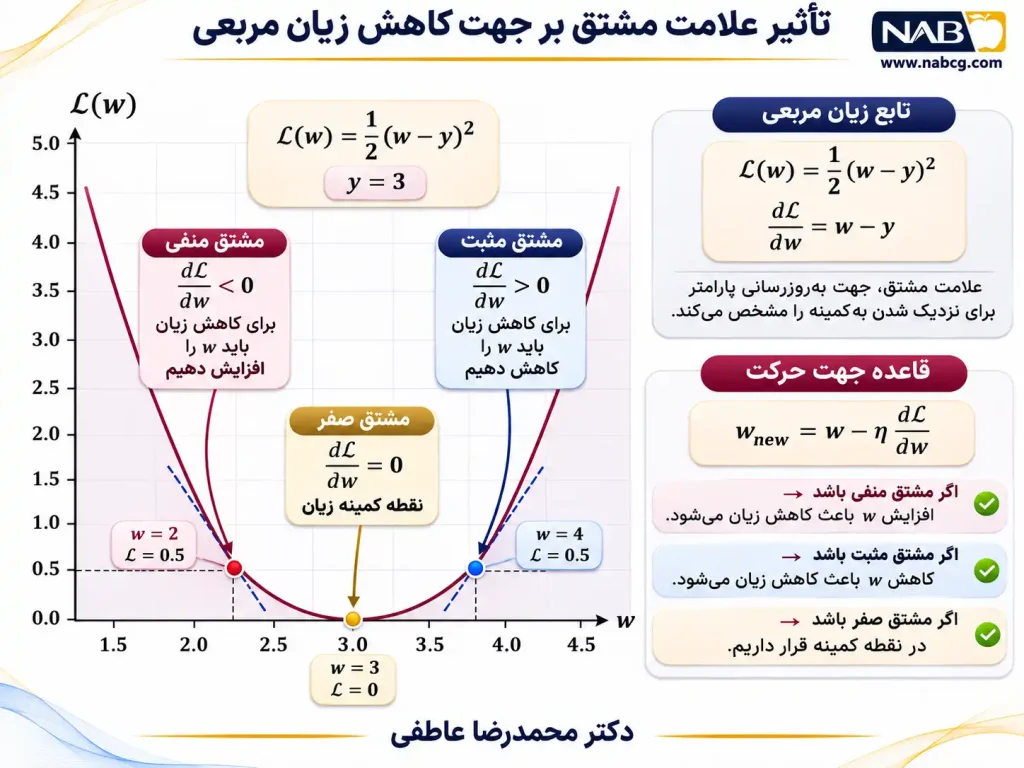
این نمودار نشان میدهد علامت مشتق چگونه جهت محلی کاهش زیان را مشخص میکند.
۳.۶. مشتق توابع فعالسازی
توابع فعالسازی (Activation Functions) از اجزای مهم شبکههای عصبی هستند. در این فصل، تمرکز ما بر مشتق آنها و نقش این مشتق در انتقال گرادیان است؛ تحلیل کامل ویژگیهای معماری و مقایسه توابع فعالسازی به فصل اختصاصی آنها تعلق دارد.
۳.۶.۱. تابع Sigmoid
تابع Sigmoid بهصورت زیر تعریف میشود:
مشتق آن:
برای نمونه، اگر (z=0) باشد:
پس:
اگر (z=2) باشد:
بنابراین:
| مقدار (z) | خروجی Sigmoid | مشتق Sigmoid |
| 4- | ۰٫۰۱۸۰ | ۰٫۰۱۷۷ |
| 2- | ۰٫۱۱۹۲ | ۰٫۱۰۵۰ |
| ۰ | ۰٫۵۰۰۰ | ۰٫۲۵۰۰ |
| ۲ | ۰٫۸۸۰۸ | ۰٫۱۰۵۰ |
| ۴ | ۰٫۹۸۲۰ | ۰٫۰۱۷۷ |
جدول نشان میدهد وقتی مقدار (z) از صفر بسیار دور میشود، مشتق Sigmoid به صفر نزدیک میشود. این رفتار میتواند در شبکههای عمیق به کوچکشدن گرادیانهای منتقلشده کمک کند.
۳.۶.۲. تابع ReLU
تابع ReLU بهصورت زیر تعریف میشود:
مشتق آن برای نقاط غیرصفر:
در نقطه (z=0)، مشتق کلاسیک وجود ندارد. در پیادهسازیهای رایج، یک مقدار قراردادی برای مشتق یا زیرگرادیان انتخاب میشود؛ اغلب صفر.
مثال:
اگر:
آنگاه:
اما اگر:
آنگاه:
در مسیر روبهعقب، مشتق محلی صفر موجب میشود گرادیان عبوری از آن مسیر نیز صفر شود. این مسئله یکی از دلایل اهمیت رفتار فعالسازی نورونها در آموزش شبکه است.
شکل ۳-۴. تابع ReLU
سپس شکل ۳-۵. مشتق ReLU
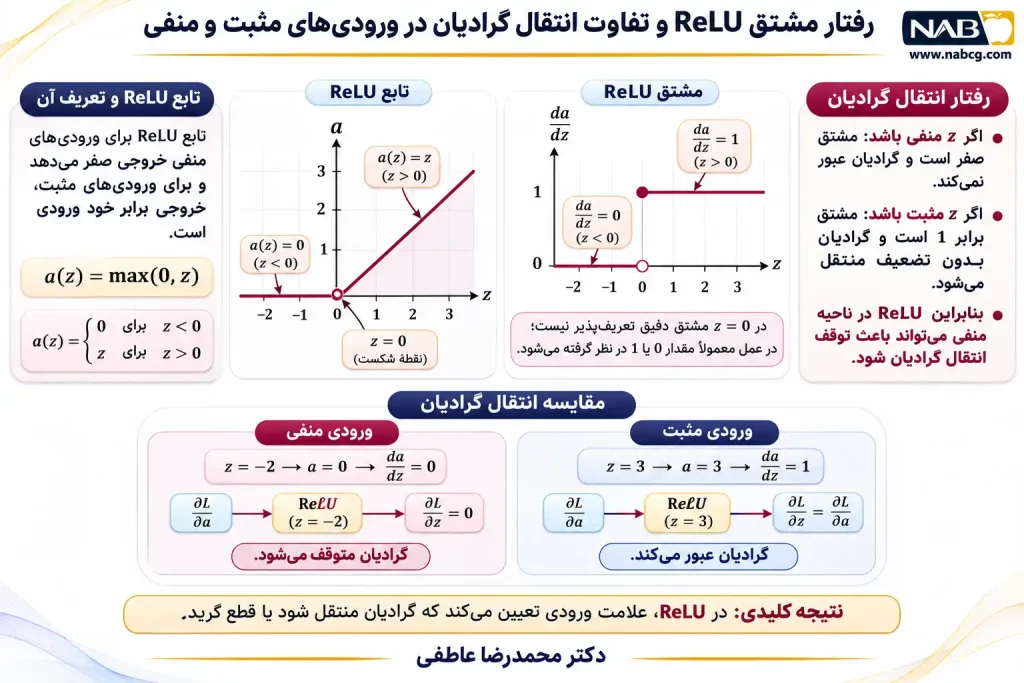
در نقطه صفر، تابع ReLU پیوسته است اما مشتق کلاسیک ندارد. دایرههای توخالی در نمودار مشتق نشان میدهند مقدار مشتق در آن نقطه بهصورت ریاضی تعریف نشده است.
۳.۶.۳. تابع Tanh
تابع تانژانت هیپربولیک (Hyperbolic Tangent) برابر است با:
مشتق آن:
برای (z=0):
برای (z=1):
پس:
در اینجا نیز مشتق تابع، ضریب حساسیت محلی گره فعالسازی است.
۳.۷. مثال یکپارچه: محاسبه مشتقهای محلی یک نورون
اکنون تمام مفاهیم این بخش را در یک مثال ترکیب میکنیم.
فرض کنید نورونی برای پیشبینی یک شاخص عددی عملکرد طراحی شده است:
دادههای آموزشی ساختگی:
ابتدا انتشار روبهجلو را انجام میدهیم:
خروجی Sigmoid:
زیان:
اکنون مشتقهای محلی را محاسبه میکنیم.
مشتق تابع زیان نسبت به خروجی نورون:
مشتق Sigmoid:
مشتقهای محلی جمع وزندار:
تا این مرحله، تنها مشتقهای محلی را محاسبه کردهایم. برای رسیدن به گرادیان زیان نسبت به هر وزن، باید این مشتقها را به روش قاعده زنجیرهای ترکیب کنیم.
بهعنوان پیشنمایش:
و برای وزن دوم:
برای بایاس نیز:
این مثال نشان میدهد که چگونه مشتقهای محلیِ ساده، در کنار یکدیگر گرادیان پارامترهای شبکه را تشکیل میدهند.
۳.۸. جدول مرجع مشتقهای محلی
| عملیات | رابطه | مشتق محلی |
| جمع | (z=x+y) | z/∂x = ۱ ∂ |
| تفریق | (z=x-y) | ( z/ ∂ y=-1 ∂) |
| ضرب | (z=xy) | ( z/ ∂ x=y ∂) |
| تقسیم | (z=x/y) | ( z/ ∂ x=1/y ∂) |
| توان | (z=x^n) | (dz/dx=nx^{n-1}) |
| نمایی | (z=e^x) | (dz/dx=e^x) |
| لگاریتم طبیعی | (z=ln x) | (dz/dx=1/x) |
| Sigmoid | (z=sigma(x)) | (dz/dx=z(1-z)) |
| Tanh | (z=tanh(x)) | (dz/dx=1-z^2) |
| ReLU | (z=max(0,x)) | صفر برای (x<0)، یک برای (x>0) |
این جدول، قواعد محاسباتی موردنیاز بخشهای بعدی فصل را فراهم میکند. شرایط دامنه، مانند (yne0) در تقسیم و (x>0) در لگاریتم حقیقی، باید هنگام استفاده رعایت شوند.
۳.۹. تمرینها و مسائل بخش سوم
- تمرین ۱ ـ مشتق محلی: تابع (f(x)=4x^2+3x) را در نظر بگیرید. مشتق آن را محاسبه کرده و مقدار مشتق را در (x=2) به دست آورید.
- تمرین ۲ ـ تحلیل حساسیت: درآمد یک شرکت برابر (R=pq) است. اگر قیمت ۱۵۰ و مقدار فروش ۴۰ باشد، مشتق درآمد نسبت به هر متغیر را محاسبه و تفسیر کنید.
- تمرین ۳ ـ مشتق تابع فعالسازی: برای (z=-1)، مقدار Sigmoid و مشتق آن را تا چهار رقم اعشار محاسبه کنید.
- تمرین ۴ ـ مقایسه ReLU و Sigmoid: اگر ورودی یک نورون برابر (z=-3) باشد، مشتق محلی ReLU و Sigmoid را محاسبه کنید. تفاوت این دو را از نظر عبور گرادیان توضیح دهید.
- تمرین ۵ ـ کاربرد صنعتی: تابع هزینه تولید برابر (C(q)=3q^2+10q+50) است. هزینه نهایی را در (q=5) محاسبه کنید و آن را با افزایش دقیق هزینه از ۵ به ۶ واحد مقایسه کنید.
- تمرین ۶ ـ گراف محاسباتی: تابع (f(x,y)=(xy+2)^2) را به عملیات ساده تقسیم کنید. برای (x=2) و (y=3)، مقدار خروجی و مشتقهای محلی تمام گرهها را محاسبه کنید.
- تمرین ۷ ـ پیادهسازی مقدماتی: بدون استفاده از کتابخانههای مشتقگیری خودکار، برنامهای در پایتون بنویسید که مقدار تابع (f(x)=x^3)، مشتق تحلیلی آن و مشتق عددی تفاضل مرکزی را در چند نقطه محاسبه و مقایسه کند.
پاسخ تشریحی منتخب: تمرین ۵
تابع هزینه:
مشتق:
در (q=5):
مقدار هزینه در ۵ واحد:
مقدار هزینه در ۶ واحد:
افزایش دقیق هزینه:
بنابراین هزینه نهایی در نقطه ۵ برابر ۴۰ است، درحالیکه افزایش واقعی هزینه برای یک واحد کامل تولید برابر ۴۳ است.
این اختلاف ناشی از انحنای تابع هزینه است.
منابع علمی بخش سوم
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Griewank, A., & Walther, A. (2008). Evaluating derivatives: Principles and techniques of algorithmic differentiation (2nd ed.). SIAM.
Baydin, A. G., Pearlmutter, B. A., Radul, A. A., & Siskind, J. M. (2018). Automatic differentiation in machine learning: A survey. Journal of Machine Learning Research, 18(153), 1–43.
4. قاعده زنجیرهای در شبکههای عصبی
در بخش سوم آموختیم که هر عملیات در گراف محاسباتی، مشتق محلی مشخصی دارد. برای مثال، مشتق یک گره ضرب نسبت به یکی از ورودیها برابر ورودی دیگر است و مشتق تابع Sigmoid را میتوان از خروجی همان تابع محاسبه کرد.
اما در یک شبکه عصبی، وزنها مستقیماً به تابع زیان متصل نیستند. تغییر یک وزن ابتدا بر جمع وزندار نورون اثر میگذارد؛ سپس خروجی تابع فعالسازی را تغییر میدهد و در نهایت مقدار زیان را تحت تأثیر قرار میدهد.
بنابراین باید بتوانیم اثر یک تغییر را از میان چند عملیات متوالی دنبال کنیم.
ابزار ریاضی انجام این کار، قاعده زنجیرهای (Chain Rule) است. این قاعده، مبنای محاسبه گرادیان در الگوریتم بازپسانتشار خطا محسوب میشود (Goodfellow et al., 2016; Baydin et al., 2018).
۴.۱. چرا مشتقهای محلی بهتنهایی کافی نیستند؟
فرض کنید یک شرکت برای برآورد هزینه حملونقل محصولات، از مدل ساده زیر استفاده میکند:
در این مدل آموزشی، (x) یک شاخص عددی فعالیت حملونقل، (u) مقدار میانی و (C) شاخص هزینه است.
برای (x=2):
اکنون میخواهیم بدانیم تغییر کوچک (x) چه اثری بر (C) دارد.
از بخش قبل میدانیم:
در (u=8):
اما هیچکدام از این مشتقها بهتنهایی پاسخ مسئله نیستند.
مشتق اول نشان میدهد (u) نسبت به (x) چقدر حساس است؛ مشتق دوم حساسیت (C) نسبت به (u) را نشان میدهد. برای یافتن حساسیت (C) نسبت به (x)، باید این دو اثر را ترکیب کنیم.
قاعده زنجیرهای بیان میکند:
در نتیجه:
این مقدار نشان میدهد در نزدیکی x = ۲، افزایش بسیار کوچک x بهاندازه Δx، هزینه را تقریباً بهاندازه ۴۸Δx تغییر میدهد.
نمایش محاسبات در نمودار
شکل ۴-۱. قاعده زنجیرهای در دو عملیات متوالی
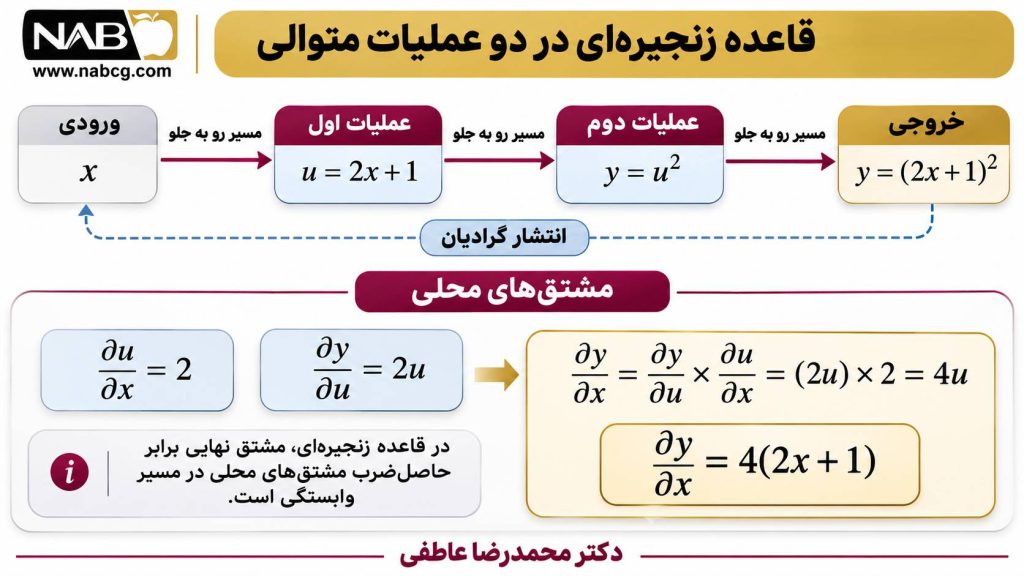
در عبور روبهجلو مقدار هر گره محاسبه میشود. در عبور روبهعقب، گرادیان دریافتی در مشتق محلی هر عملیات ضرب میشود.
۴.۲. استخراج قاعده زنجیرهای از تعریف مشتق
برای درک عمیقتر، فرض کنید:
در نتیجه:
اگر (x) اندکی تغییر کند، ابتدا (u) و سپس (y) تغییر خواهند کرد.
در نقاطی که توابع مربوط مشتقپذیرند، برای تغییرهای کوچک میتوان نوشت:
نماد o(Δx) نشاندهنده جملهای است که نسبت آن به Δx، با نزدیکشدن Δx به صفر، به صفر میل میکند.
با جایگذاری تغییر (u) در رابطه دوم، نتیجه میشود:
بنابراین:
یا به شکل رایج:
این رابطه فقط یک دستور محاسباتی نیست؛ بیان میکند که حساسیت یک خروجی نسبت به ورودی اولیه، از ترکیب حساسیتهای محلی مراحل میانی حاصل میشود.
مثال ۴-۱. بررسی قاعده زنجیرهای با دو روش
تابع زیر را در نظر بگیرید:
روش اول: مشتقگیری مستقیم
با بسط عبارت:
پس:
در (x=2):
روش دوم: قاعده زنجیرهای
ابتدا:
سپس:
مشتقهای محلی:
در (x=2)، مقدار (u=5) است. بنابراین:
هر دو روش به نتیجه یکسان میرسند. مزیت روش دوم زمانی آشکار میشود که بهجای دو عملیات، صدها عملیات متوالی داشته باشیم.
۴.۳. قاعده زنجیرهای در یک مسیر چندمرحلهای
فرض کنید یک مدل آموزشی برای محاسبه شاخص عملکرد فروش از سه مرحله تشکیل شده است:
برای (x=1)، انتشار روبهجلو چنین است:
اکنون مشتقهای محلی:
طبق قاعده زنجیرهای:
شکل ۴-۲. محاسبات کامل در گراف چهارمرحلهای
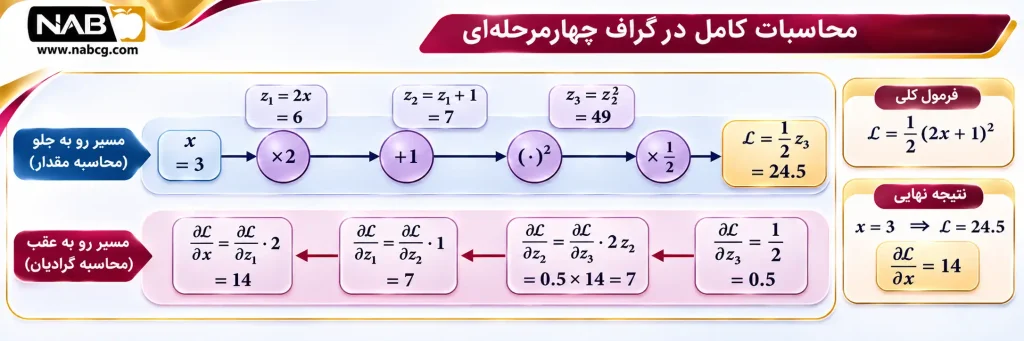
در شکل ۴-۲. مقدار هر گره در مسیر Forward و گرادیان متناظر در مسیر Backward نشان داده شده است. ترتیب خواندن مقادیر گرادیان از راست به چپ است.
۴.۴. قاعده زنجیرهای در گرافهای چندمسیره
در بسیاری از محاسبات، یک متغیر از چند مسیر مختلف بر خروجی اثر میگذارد.
در چنین شرایطی، فقط ضرب مشتقها کافی نیست؛ باید مشارکت گرادیانهای مسیرهای مختلف نیز جمع شود.
تابع زیر را در نظر بگیرید:
آن را به سه عملیات تقسیم میکنیم:
اگر (x=2) باشد:
از مسیر اول:
از مسیر دوم:
پس:
در حالت کلی، اگر f به متغیرهای میانی u₁، …، uₘ وابسته باشد و همه این متغیرها تابع x باشند:
این رابطه در گرافهای چندشاخه و شبکههای عصبی با اتصالات متعدد اهمیت ویژهای دارد.
مثال ۴-۲. یک ورودی با دو اثر متفاوت
فرض کنید تابع هزینه یک فرایند صنعتی بهصورت زیر تعریف شده است:
در این مدل ساختگی، (x) شاخص شدت فعالیت دستگاه است.
در (x=3):
مشتق از مسیر درجه دوم:
مشتق از مسیر خطی:
در نتیجه:
این عدد نشان میدهد حساسیت کل هزینه نسبت به شاخص فعالیت دستگاه، حاصل جمع دو اثر متفاوت است.
اگر فقط یکی از مسیرها را در نظر بگیریم، مشتق کل را اشتباه محاسبه خواهیم کرد.
۴.۵. قاعده زنجیرهای در یک نورون مصنوعی
اکنون به مسئله اصلی فصل بازمیگردیم.
یک نورون با دو ورودی را در نظر بگیرید:
هدف ما محاسبه گرادیان زیان نسبت به وزنها و بایاس است.
برای وزن اول:
از بخش سوم میدانیم:
پس:
به همین ترتیب:
و برای بایاس:
این روابط نشان میدهند گرادیان هر وزن از سه عامل تشکیل شده است: اختلاف پیشبینی و مقدار واقعی، مشتق تابع فعالسازی و مقدار ورودی مرتبط با آن وزن.
مثال ۴-۳. محاسبه کامل گرادیان یک نورون Sigmoid
از دادههای مثال بخش سوم استفاده میکنیم:
ابتدا:
مشتق زیان نسبت به خروجی:
مشتق Sigmoid:
اکنون:
برای وزن اول:
برای وزن دوم:
برای بایاس:
شکل ۴-۳. مسیر عددی گرادیان در نورون Sigmoid
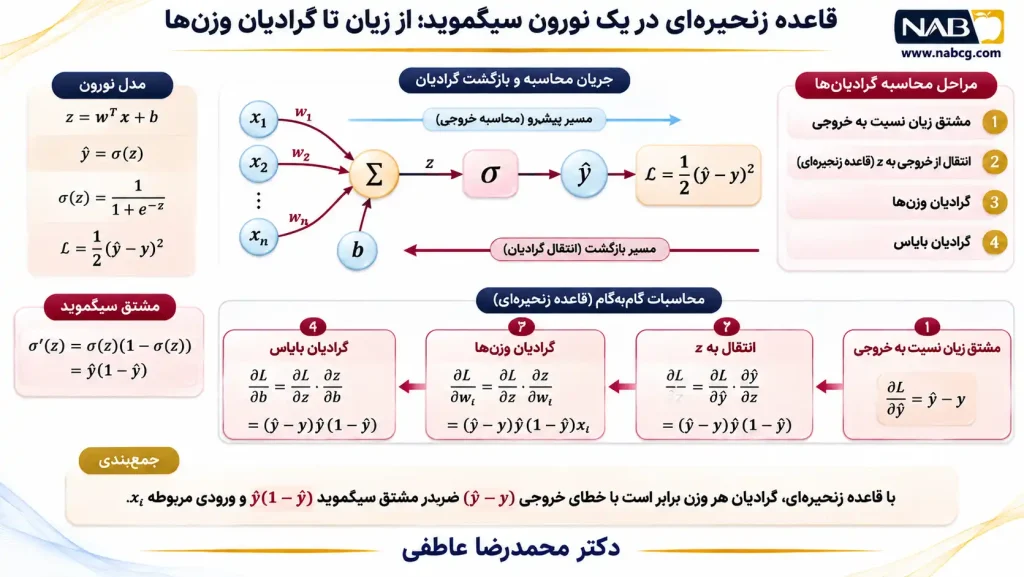
در شکل ۴-۳. در مسیر روبهجلو، خروجی و زیان محاسبه میشوند. در مسیر روبهعقب، مشتقهای محلی تابع زیان، Sigmoid و جمع وزندار با یکدیگر ترکیب میشوند.
۴.۶. معرفی متغیر خطای محلی نورون
در مثال قبل مشاهده کردیم که عبارت زیر در گرادیان تمام وزنها و بایاس تکرار میشود:
برای جلوگیری از تکرار محاسبات، این مقدار را با نماد δ نمایش میدهیم:
در نورون Sigmoid با زیان مربعی نصفشده:
در نتیجه:
در مثال عددی ما:
بنابراین:
این سادهسازی، پایه فرمولبندی Backpropagation در یک لایه و سپس شبکه چندلایه است.
توجه: (delta) در اینجا به معنی اختلاف ساده پیشبینی و هدف نیست؛ بلکه گرادیان زیان نسبت به ورودی پیشفعالسازی نورون، یعنی (z)، است. این تمایز در شبکههای چندلایه اهمیت زیادی دارد.
۴.۷. قاعده زنجیرهای در حالت برداری
تا اینجا با توابع اسکالر کار کردیم. اما یک لایه شبکه عصبی معمولاً چند نورون دارد و خروجی آن یک بردار است.
فرض کنید:
که در آن:
اگر تابع زیان ℒ به بردار 𝐳 وابسته باشد، گرادیان زیان نسبت به ورودی 𝐱 برابر است با:
این رابطه را میتوان از مشتق جزئی هر مؤلفه استخراج کرد.
چون:
داریم:
بنابراین:
که همان رابطه ماتریسی بالا است.
مثال ۴-۴. محاسبه گرادیان برداری با اعداد واقعی
فرض کنید:
آنگاه:
پس:
مؤلفه اول:
مؤلفه دوم:
بنابراین:
شکل ۴-۴. انتقال گرادیان در یک تبدیل خطی دوبعدی
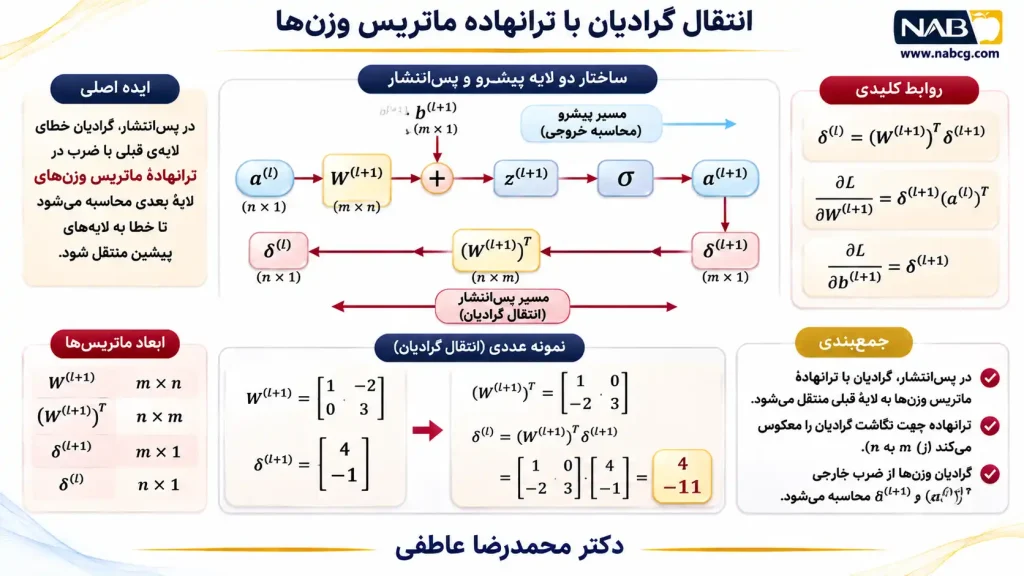
در شکل ۴-۴. ضرب ماتریس ترانهاده وزنها در گرادیان خروجی، گرادیان ورودی لایه را تولید میکند. در این مثال، همه ابعاد با یکدیگر سازگارند.
این رابطه یکی از مهمترین ابزارهای ریاضی Backpropagation در شبکههای چندلایه است.
۴.۸. تفاوت قاعده زنجیرهای و الگوریتم Backpropagation
گاهی قاعده زنجیرهای و Backpropagation بهجای یکدیگر استفاده میشوند، اما این دو دقیقاً یک مفهوم نیستند.
قاعده زنجیرهای یک قانون ریاضی برای مشتقگیری از ترکیب توابع است.
در مقابل، Backpropagation یک روش محاسباتی سازمانیافته برای استفاده از قاعده زنجیرهای روی گراف محاسباتی است. این روش با ذخیره یا بازمحاسبه مقادیر موردنیاز و استفاده مجدد از گرادیانهای میانی، از انجام محاسبات تکراری جلوگیری میکند.
به بیان دیگر:
این تمایز به ما کمک میکند بفهمیم چرا دانستن مشتق توابع بهتنهایی برای پیادهسازی کارآمد یک شبکه عصبی بزرگ کافی نیست.
۴.۹. تمرینها و مسائل بخش چهارم
- تمرین ۱ ـ قاعده زنجیرهای ساده: برای تابع f(x) = (3x + 2)²، مشتق را با دو روش بسط مستقیم و قاعده زنجیرهای به دست آورید و در x = ۱ مقایسه کنید.
- تمرین ۲ ـ گراف چندمرحلهای: تابع f(x) = ln(2x² + 1) را به عملیات ساده تقسیم کرده و مشتق آن را در x = ۲ محاسبه کنید.
- تمرین ۳ ـ مسیرهای منشعب: تابع f(x) = x³ + 4x² + 2x را به سه مسیر مستقل تقسیم کرده و مشتق آن را در x = ۲ محاسبه کنید.
- تمرین ۴ ـ نورون Sigmoid: نورونی با x₁ = ۲، x₂ = ۱، w₁ = ۰٫۱، w₂ = ۰٫۴، b = ۰ و y = ۱ در نظر بگیرید. مقدار خروجی، زیان مربعی نصفشده و گرادیان هر پارامتر را محاسبه کنید.
- تمرین ۵ ـ حالت برداری: اگر:
گرادیان ∇_𝐱 ℒ را محاسبه کنید.
- تمرین ۶ ـ تحلیل مفهومی: توضیح دهید چرا در یک گراف محاسباتی چندشاخه، ضرب مشتقهای یک مسیر بهتنهایی برای محاسبه مشتق کل کافی نیست.
- تمرین ۷ ـ پیادهسازی: برنامهای بنویسید که تابع (f(x)=(2x+1)^3) را به سه عملیات ساده تقسیم کرده، مقادیر Forward را ذخیره کند و در مرحله Backward مشتق تابع را بدون Autograd محاسبه کند.
پاسخ تشریحی منتخب: تمرین ۵
داریم:
پس:
بنابراین:
زیرا:
منابع علمی بخش چهارم
Baydin, A. G., Pearlmutter, B. A., Radul, A. A., & Siskind, J. M. (2018). Automatic differentiation in machine learning: A survey. Journal of Machine Learning Research, 18(153), 1–43.
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Griewank, A., & Walther, A. (2008). Evaluating derivatives: Principles and techniques of algorithmic differentiation (2nd ed.). SIAM.