8. پیادهسازی Backpropagation بدون Autograd؛ ساخت یک موتور یادگیری عصبی از پایه
در بخش هفتم، بازپسانتشار خطا را در یک شبکه چندلایه با محاسبات عددی کامل بررسی کردیم. اکنون میخواهیم همان روابط ریاضی را به یک برنامه عملیاتی تبدیل کنیم؛ برنامهای که بتواند شبکههایی با تعداد لایهها و نورونهای متفاوت بسازد، آموزش دهد و عملکرد آنها را ارزیابی کند.
هدف این بخش، استفاده از یک چارچوب آماده یادگیری عمیق نیست. برعکس، میخواهیم موتور محاسباتی آموزش شبکه عصبی را خودمان طراحی و پیادهسازی کنیم تا روشن شود کتابخانههایی مانند PyTorch و TensorFlow چه بخشهایی از فرایند را برای برنامهنویس خودکار میکنند.
در پایان این بخش، یک پیادهسازی با قابلیتهای زیر خواهیم داشت:
- تعریف معماری شبکه با تعداد دلخواه لایههای تماممتصل؛
- انتخاب تابع فعالسازی Sigmoid، Tanh یا ReLU برای لایههای پنهان؛
- انجام انتشار روبهجلو و ذخیره مقادیر میانی؛
- محاسبه دستی گرادیان تمام وزنها و بایاسها؛
- آموزش با Gradient Descent و Mini-batch؛
- ثبت زیان و دقت پیشبینی در طول آموزش؛
- اجرای یک مسئله غیرخطی مانند XOR؛
- بررسی ابعاد، پایداری عددی و صحت محاسبات.
در این بخش از NumPy برای عملیات عددی استفاده میکنیم، اما هیچ مشتقی با Autograd یا کتابخانههای یادگیری عمیق محاسبه نخواهد شد.
۸.۱. معماری نرمافزاری موتور یادگیری
قبل از نوشتن کد، باید اجزای برنامه را مشخص کنیم.
شکل ۸-۱. معماری موتور آموزشی شبکه عصبی
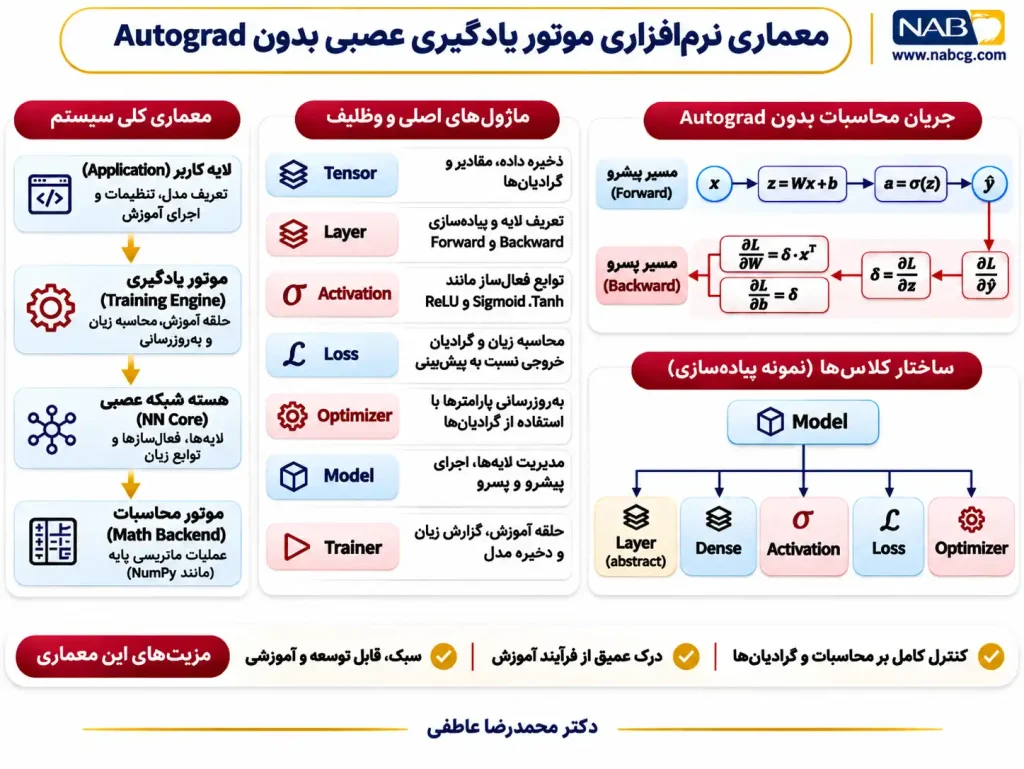
انتشار روبهجلو و بازپسانتشار خطا دو مرحله جداگانهاند. تمام گرادیانها پیش از بهروزرسانی وزنها محاسبه میشوند.
این معماری عمداً ساده نگه داشته شده است. موضوعاتی مانند Adam، زمانبندی نرخ یادگیری، Dropout و Batch Normalization در فصلهای تخصصی خود بررسی خواهند شد تا از همپوشانی محتوایی جلوگیری شود.
۸.۲. قرارداد نمایش دادهها و ابعاد ماتریسها
یکی از تصمیمهای مهم هنگام پیادهسازی، نحوه قرارگرفتن نمونههای آموزشی در ماتریس داده است.
در این بخش، قرارداد زیر را انتخاب میکنیم:
هر ستون ماتریس داده، یک نمونه آموزشی است.
اگر m نمونه داشته باشیم و هر نمونه دارای n₀ ویژگی باشد:
برای مثال، سه نمونه با دو ویژگی:
- ستون اول:
- ستون دوم:
- و ستون سوم:
بنابراین:
اگر لایه بعدی چهار نورون داشته باشد:
پس:
در NumPy، بردار بایاس با قابلیت Broadcasting به هر سه ستون اضافه میشود.
مثال ۸-۱. بررسی عددی ضرب ماتریسی
فرض کنید:
- محاسبه سطر اول:
- محاسبه سطر دوم:
پس:
این مثال نشان میدهد چگونه یک ضرب ماتریسی، محاسبات چند نورون و چند نمونه را بهصورت همزمان انجام میدهد.
۸.۳. انتخاب تابع زیان و تعریف دقیق گرادیانها
در این بخش، مسئله اصلی را طبقهبندی دودویی در نظر میگیریم.
لایه خروجی یک نورون Sigmoid دارد:
برای هر نمونه با برچسب y ∈ {۰، ۱}، زیان آنتروپی متقاطع دودویی (Binary Cross-Entropy) برابر است با:
برای (m) نمونه:
چرا Binary Cross-Entropy؟
در یک مسئله طبقهبندی دودویی، خروجی Sigmoid را میتوان بهعنوان احتمال پیشبینیشده کلاس یک تفسیر کرد.
زیان Binary Cross-Entropy پیشبینیهای اشتباه با اطمینان بالا را شدیدتر جریمه میکند و با مدلسازی برنولی خروجی سازگار است (Bishop, 2006; Goodfellow et al., 2016).
استخراج مشتق خروجی
برای یک نمونه:
مشتق نسبت به (a):
با مخرج مشترک:
از طرف دیگر:
طبق قاعده زنجیرهای:
پس:
این سادهسازی یکی از مزایای محاسباتی ترکیب Sigmoid و Binary Cross-Entropy است.
مثال ۸-۲. محاسبه عددی زیان و مشتق
فرض کنید:
زیان:
مشتق نسبت به پیشفعالسازی:
اگر:
آنگاه:
در حالت دوم، پیشبینی مدل با برچسب واقعی اختلاف بیشتری دارد و مقدار مطلق گرادیان نسبت به (z) نیز بزرگتر است.
۸.۴. فرمولهای Backpropagation برای Mini-batch
فرض کنید یک Mini-batch دارای (B) نمونه باشد.
در این بخش برای جلوگیری از دوبارهشماری عامل میانگین، قرارداد زیر را انتخاب میکنیم:
این ماتریس شامل مشتق زیان هر نمونه بهصورت جداگانه نسبت به پیشفعالسازی خروجی است؛ هنوز ضریب (1/B) اعمال نشده است.
برای لایههای پنهان:
- گرادیان وزنها:
- گرادیان بایاسها:
تفاوت D^(l) در این بخش با δ^(l) در بخش هفتم فقط به نحوه سازماندهی نمونهها و قرارداد میانگینگیری مربوط است. هر ستون D^(l) سیگنال خطای یک نمونه در همان لایه را نشان میدهد.
مثال ۸-۳. گرادیان Mini-batch با محاسبه کامل
فرض کنید دو ورودی و دو نمونه داریم:
و سیگنال خطای یک لایه دونورونی برای هر دو نمونه:
چون:
گرادیان وزنها:
محاسبه درایه اول:
- درایه دوم:
- درایه سوم:
- درایه چهارم:
بنابراین:
برای بایاس:
شکل ۸-۲. ساخت ماتریس گرادیان از دو نمونه آموزشی
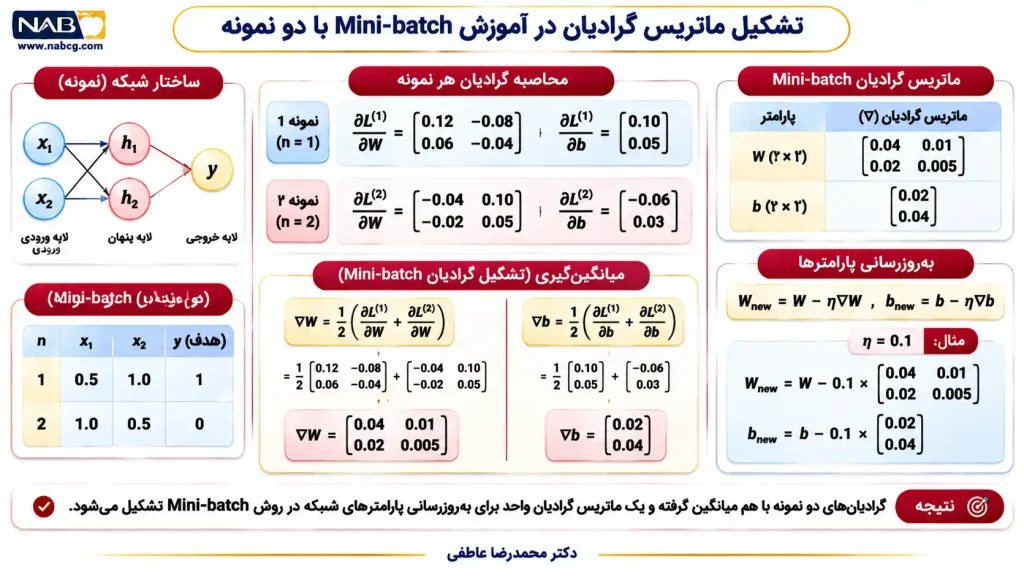
در ادامه، همین روابط را به توابع و کلاسهای پایتون تبدیل میکنیم.
۸.۵. طراحی کلاس شبکه عصبی
اکنون به پیادهسازی اصلی میرسیم.
برای طراحی برنامه، از یک کلاس به نام NeuralNetwork استفاده میکنیم. این کلاس مسئول نگهداری پارامترها و اجرای عملیات اصلی شبکه خواهد بود.
ورودی سازنده کلاس، فهرست تعداد نورونهای هر لایه است.
برای مثال:
- این عبارت شبکهای با ساختار زیر تعریف میکند:
- ۲ ورودی
- ۴ پنهان اول
- ۳ پنهان دوم
- ۱ خروجی
تعداد پارامترهای این شبکه:
در پیادهسازی زیر، تابع فعالسازی لایه خروجی Sigmoid است و لایههای پنهان میتوانند از Sigmoid، Tanh یا ReLU استفاده کنند.
۸.۵.۱. مقداردهی اولیه وزنها
اگر تمام وزنها صفر باشند، نورونهای یک لایه با معماری متقارن ممکن است گرادیانهای یکسانی دریافت کنند و در طول آموزش رفتار مشابهی داشته باشند. این مسئله توانایی شبکه در یادگیری نمایشهای متفاوت را محدود میکند.
به همین دلیل، وزنها را بهصورت تصادفی مقداردهی میکنیم.
برای ReLU از مقیاسبندی He و برای Sigmoid و Tanh از مقیاسبندی Glorot/Xavier استفاده میکنیم:
که در آن برای ReLU:
و برای Sigmoid و Tanh:
اینها روشهای رایج مقداردهی اولیه هستند، نه تضمینی برای همگرایی همه شبکهها.
۸.۶. پیادهسازی کامل موتور شبکه عصبی
کد زیر هسته اصلی موتور آموزشی است. آن را میتوان در یک فایل به نام neural_network.py قرار داد.
import numpy as np


class NeuralNetwork:
    def __init__(
        self,
        layer_sizes,
        hidden_activation="tanh",
        seed=42
    ):
        if len(layer_sizes) < 2:
            raise ValueError(
                "At least input and output layers are required."
            )

        if any(n <= 0 for n in layer_sizes):
            raise ValueError(
                "All layer sizes must be positive."
            )

        if layer_sizes[-1] != 1:
            raise ValueError(
                "This implementation requires one binary output."
            )

        if hidden_activation not in ("sigmoid", "tanh", "relu"):
            raise ValueError("Unsupported activation.")

        self.layer_sizes = layer_sizes
        self.hidden_activation = hidden_activation
        self.rng = np.random.default_rng(seed)

        self.weights = []
        self.biases = []

        for n_in, n_out in zip(
            layer_sizes[:-1],
            layer_sizes[1:]
        ):
            if hidden_activation == "relu":
                scale = np.sqrt(2.0 / n_in)
            else:
                scale = np.sqrt(
                    2.0 / (n_in + n_out)
                )

            W = self.rng.normal(
                0.0, scale, size=(n_out, n_in)
            )
            b = np.zeros((n_out, 1))

            self.weights.append(W)
            self.biases.append(b)

        self.cache = None

    @staticmethod
    def sigmoid(z):
        # Stable sigmoid
        result = np.empty_like(z, dtype=float)
        positive = z >= 0

        result[positive] = (
            1.0 / (1.0 + np.exp(-z[positive]))
        )

        exp_z = np.exp(z[~positive])
        result[~positive] = exp_z / (1.0 + exp_z)

        return result

    def activate_hidden(self, z):
        if self.hidden_activation == "sigmoid":
            return self.sigmoid(z)

        if self.hidden_activation == "tanh":
            return np.tanh(z)

        return np.maximum(0.0, z)

    def hidden_derivative(self, z, a):
        if self.hidden_activation == "sigmoid":
            return a * (1.0 - a)

        if self.hidden_activation == "tanh":
            return 1.0 - a ** 2

        # ReLU derivative at zero: convention = 0
        return (z > 0).astype(float)

    def forward(self, X, save_cache=True):
        A = np.asarray(X, dtype=float)

        if A.ndim != 2:
            raise ValueError("X must be a 2D matrix.")

        if A.shape[0] != self.layer_sizes[0]:
            raise ValueError("Wrong input dimension.")

        activations = [A]
        preactivations = []

        for index, (W, b) in enumerate(
            zip(self.weights, self.biases)
        ):
            Z = W @ A + b

            if index == len(self.weights) - 1:
                A = self.sigmoid(Z)
            else:
                A = self.activate_hidden(Z)

            preactivations.append(Z)
            activations.append(A)

        if save_cache:
            self.cache = {
                "A": activations,
                "Z": preactivations
            }

        return A

    @staticmethod
    def binary_cross_entropy(A, Y):
        # A and Y have shape (1, batch_size)
        eps = 1e-12
        A_safe = np.clip(A, eps, 1.0 - eps)

        return float(-np.mean(
            Y * np.log(A_safe)
            + (1.0 - Y) * np.log1p(-A_safe)
        ))

    def backward(self, Y):
        if self.cache is None:
            raise RuntimeError("Run forward first.")

        A_list = self.cache["A"]
        Z_list = self.cache["Z"]

        Y = np.asarray(Y, dtype=float)
        output = A_list[-1]

        if Y.shape != output.shape:
            raise ValueError("Wrong target dimension.")

        if not np.all((Y == 0) | (Y == 1)):
            raise ValueError("Targets must be binary.")

        batch_size = Y.shape[1]
        num_layers = len(self.weights)

        grad_W = [None] * num_layers
        grad_b = [None] * num_layers

        # BCE + sigmoid: unaveraged output delta
        D = output - Y

        for l in reversed(range(num_layers)):
            A_previous = A_list[l]

            grad_W[l] = (
                D @ A_previous.T
            ) / batch_size

            grad_b[l] = np.sum(
                D, axis=1, keepdims=True
            ) / batch_size

            if l > 0:
                D = self.weights[l].T @ D

                Z_previous = Z_list[l - 1]
                A_hidden = A_list[l]

                D *= self.hidden_derivative(
                    Z_previous, A_hidden
                )

        return grad_W, grad_b

    def update(self, grad_W, grad_b, learning_rate):
        if learning_rate <= 0:
            raise ValueError(
                "Learning rate must be positive."
            )

        for l in range(len(self.weights)):
            self.weights[l] -= (
                learning_rate * grad_W[l]
            )
            self.biases[l] -= (
                learning_rate * grad_b[l]
            )

    def predict_proba(self, X):
        return self.forward(X, save_cache=False)

    def predict(self, X, threshold=0.5):
        probabilities = self.predict_proba(X)
        return (probabilities >= threshold).astype(int)

    def fit(
        self,
        X,
        Y,
        epochs=2000,
        learning_rate=0.1,
        batch_size=None,
        shuffle=True,
        verbose_every=200
    ):
        X = np.asarray(X, dtype=float)
        Y = np.asarray(Y, dtype=float)

        if X.ndim != 2 or Y.ndim != 2:
            raise ValueError("X and Y must be 2D.")

        m = X.shape[1]

        if m == 0:
            raise ValueError("Dataset cannot be empty.")

        if X.shape[0] != self.layer_sizes[0]:
            raise ValueError("Wrong input dimension.")

        if Y.shape != (1, m):
            raise ValueError("Y must have shape (1, m).")

        if not np.all((Y == 0) | (Y == 1)):
            raise ValueError("Targets must be 0 or 1.")

        if epochs < 1:
            raise ValueError("epochs must be positive.")

        if learning_rate <= 0:
            raise ValueError(
                "learning_rate must be positive."
            )

        if batch_size is None:
            batch_size = m

        if batch_size < 1:
            raise ValueError("batch_size must be positive.")

        history = {
            "epoch": [],
            "loss": [],
            "accuracy": []
        }

        for epoch in range(epochs + 1):
            # Evaluate current parameters
            A_full = self.forward(
                X, save_cache=False
            )

            loss = self.binary_cross_entropy(
                A_full, Y
            )

            predictions = (
                A_full >= 0.5
            ).astype(int)

            accuracy = float(
                np.mean(predictions == Y)
            )

            history["epoch"].append(epoch)
            history["loss"].append(loss)
            history["accuracy"].append(accuracy)

            if verbose_every and epoch % verbose_every == 0:
                print(
                    f"Epoch {epoch:4d} | "
                    f"Loss={loss:.6f} | "
                    f"Accuracy={accuracy:.3f}"
                )

            if epoch == epochs:
                break

            indices = (
                self.rng.permutation(m)
                if shuffle else np.arange(m)
            )

            for start in range(0, m, batch_size):
                selected = indices[
                    start:start + batch_size
                ]

                X_batch = X[:, selected]
                Y_batch = Y[:, selected]

                self.forward(
                    X_batch, save_cache=True
                )

                grad_W, grad_b = self.backward(
                    Y_batch
                )

                self.update(
                    grad_W,
                    grad_b,
                    learning_rate
                )

        return history
تحلیل ساختار برنامه
کلاس بالا دارای چند مسئولیت مشخص است.
| تابع | وظیفه | خروجی اصلی |
| __init__ | ساخت معماری و مقداردهی اولیه | وزنها و بایاسها |
| forward | محاسبه خروجی لایهها | پیشبینی و مقادیر ذخیرهشده |
| backward | محاسبه دستی مشتقها | گرادیان وزنها و بایاسها |
| update | اجرای Gradient Descent | پارامترهای اصلاحشده |
| predict_proba | محاسبه احتمال کلاس یک | مقادیر بین صفر و یک |
| predict | تبدیل احتمال به برچسب | صفر یا یک |
| fit | اجرای چرخه آموزش | تاریخچه زیان و دقت |
در تابع backward، عبارت:
گرادیان را از لایه بعد به خروجی لایه قبلی منتقل میکند.
سپس:
D *= self.hidden_derivative(
    Z_previous, A_hidden
)
مشتق تابع فعالسازی را اعمال میکند.
در نهایت:
گرادیان تمام وزنهای لایه را بهصورت همزمان به دست میآورد.
نکته عددی: تابع زیان در این پیادهسازی برای محاسبه لگاریتم، احتمالها را به بازهای امن محدود میکند؛ اما مشتق output – Y مربوط به Binary Cross-Entropy ریاضیِ بدون محدودسازی است. برای پیشبینیهای معمول این تفاوت عملاً مطرح نیست، ولی در خروجیهای بسیار اشباعشده بهتر است زیان مستقیماً از Logit و با فرمول پایدار logaddexp محاسبه شود. این اصلاح را در بخش بررسی صحت عددی نیز میتوان آزمود.
۸.۷. آزمون اول: آموزش شبکه روی مسئله XOR
مسئله XOR یکی از مثالهای کلاسیک برای نشاندادن ضرورت مدلهای غیرخطی است.
در این مسئله، خروجی یک است اگر دو ورودی با یکدیگر متفاوت باشند و در غیر این صورت صفر است.
| x₁ | x₂ | (y) |
| ۰ | ۰ | ۰ |
| ۰ | ۱ | ۱ |
| ۱ | ۰ | ۱ |
| ۱ | ۱ | ۰ |
شکل ۸-۳. نمایش هندسی دادههای XOR
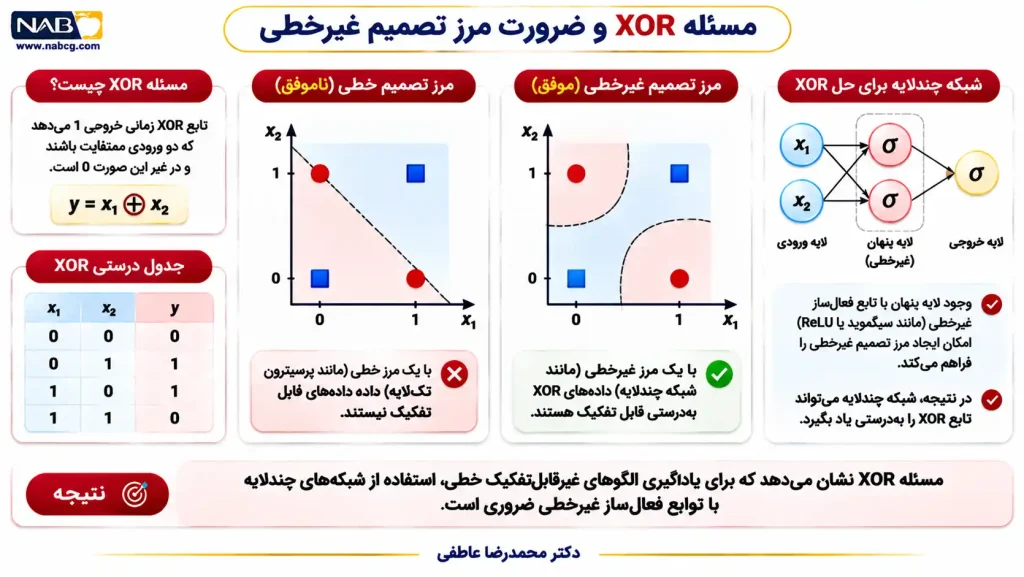
نقاط هر کلاس در دو گوشه مقابل قرار گرفتهاند؛ بنابراین یک مرز تصمیم خطی نمیتواند چهار نقطه را بهدرستی جدا کند.
اجرای برنامه
کد زیر را پس از تعریف کلاس NeuralNetwork اجرا کنید:
import numpy as np
import matplotlib.pyplot as plt

# هر ستون یک نمونه است
X = np.array([
    [0.0, 0.0, 1.0, 1.0],
    [0.0, 1.0, 0.0, 1.0]
])

Y = np.array([
    [0.0, 1.0, 1.0, 0.0]
])

model = NeuralNetwork(
    layer_sizes=[2, 8, 1],
    hidden_activation="tanh",
    seed=42
)

history = model.fit(
    X, Y,
    epochs=10000,
    learning_rate=0.5,
    batch_size=4,
    shuffle=False,
    verbose_every=1000
)

probabilities = model.predict_proba(X)
predictions = model.predict(X)

print("nXOR predictions:")
for i in range(X.shape[1]):
    print(
        f"Input={X[:, i]} | "
        f"Target={int(Y[0, i])} | "
        f"Probability={probabilities[0, i]:.6f} | "
        f"Predicted={predictions[0, i]}"
    )

plt.figure(figsize=(8, 4.5))
plt.plot(
    history["epoch"],
    history["loss"],
    linewidth=2
)
plt.xlabel("Epoch")
plt.ylabel("Binary Cross-Entropy")
plt.title("XOR Training Loss")
plt.grid(True, alpha=0.3)
plt.tight_layout()
plt.show()
در این برنامه، شبکه دارای هشت نورون پنهان است. این انتخاب برای افزایش انعطاف مدل در مثال آموزشی انجام شده و به معنی نیاز XOR به هشت نورون پنهان نیست.
در صورت آموزش موفق، انتظار داریم احتمال پیشبینیشده برای دو نمونه با برچسب یک به یک نزدیک شود و برای دو نمونه دیگر به صفر نزدیک شود.
بااینحال، مقادیر دقیق خروجی باید از اجرای واقعی برنامه به دست آیند؛ نباید آنها را بدون اجرای کد بهعنوان نتیجه تجربی گزارش کرد.
۸.۸. تحلیل منحنی یادگیری
یکی از مزایای ذخیره تاریخچه آموزش، امکان مشاهده رفتار مدل در طول زمان است.
در کد قبلی، سه متغیر برای هر دوره ثبت میشوند:
Epoch به معنی یک بار عبور از کل مجموعه داده آموزشی است. اگر دادهها به Mini-batch تقسیم شوند، هر Epoch شامل چند مرحله بهروزرسانی خواهد بود.
برای مثال، اگر ۱۰۰۰ نمونه داشته باشیم و اندازه Mini-batch برابر ۱۰۰ باشد:
بنابراین ۵۰ دوره آموزش شامل ۵۰۰ بهروزرسانی پارامترهاست.
سه رفتار متداول زیان در آموزش
شکل ۸-۴. الگوهای شماتیک رفتار زیان
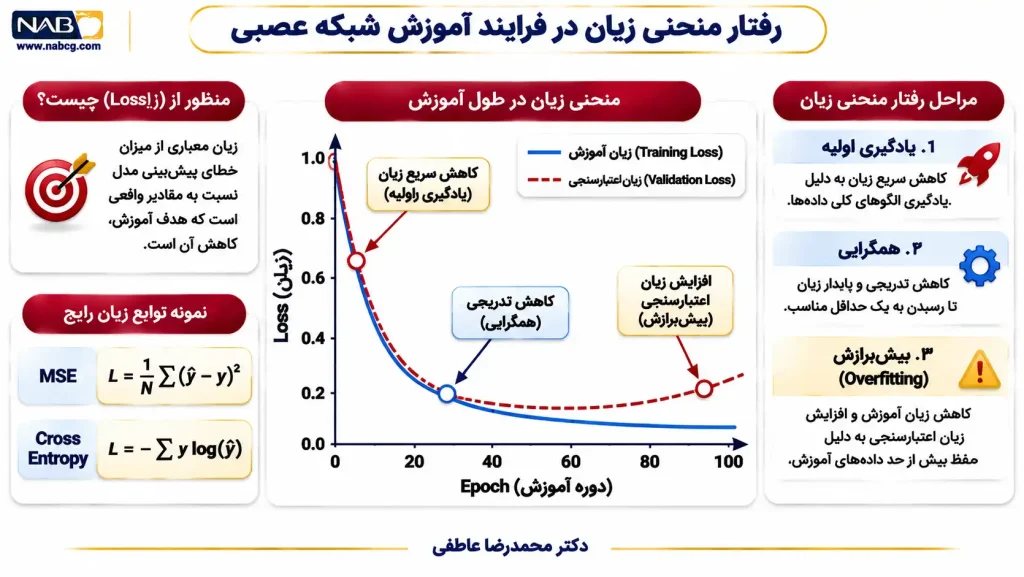
این نمودار داده تجربی نیست؛ صرفاً سه الگوی ممکن را نشان میدهد. برای تحلیل واقعی باید نمودار حاصل از اجرای برنامه بررسی شود.
کاهش تدریجی زیان معمولاً نشانه پیشرفت بهینهسازی روی داده آموزشی است. ثابتماندن زیان ممکن است به نرخ یادگیری، ظرفیت مدل، مقداردهی اولیه، اشباع فعالسازی یا سایر عوامل مربوط باشد.
نوسان شدید زیان نیز میتواند با نرخ یادگیری بزرگ یا نویز گرادیان مرتبط باشد. بااینحال، فقط از شکل منحنی نمیتوان علت قطعی مشکل را تعیین کرد.
۸.۹. آزمایش کاربردی دوم: پیشبینی یک وضعیت عملیاتی
اکنون یک مسئله ساختگی نزدیکتر به کاربردهای مدیریتی تعریف میکنیم.
فرض کنید یک واحد تولیدی میخواهد با استفاده از دو ویژگی نرمالشده، احتمال قرارگرفتن فرایند در وضعیت نیازمند بررسی را برآورد کند.
ویژگیها:
برچسب:
برای نمایش آموزشی، دادههای زیر را در نظر میگیریم:
| نمونه | فشار کاری | نوسان فرایند | برچسب |
| ۱ | ۰٫۱ | ۰٫۲ | ۰ |
| ۲ | ۰٫۲ | ۰٫۴ | ۰ |
| ۳ | ۰٫۴ | ۰٫۳ | ۰ |
| ۴ | ۰٫۶ | ۰٫۷ | ۱ |
| ۵ | ۰٫۸ | ۰٫۶ | ۱ |
| ۶ | ۰٫۹ | ۰٫۹ | ۱ |
این مجموعه بسیار کوچک و ساختگی است و برای استقرار عملیاتی یا نتیجهگیری درباره قابلیت پیشبینی خرابی تجهیزات مناسب نیست.
پیادهسازی
import numpy as np

X = np.array([
    [0.1, 0.2, 0.4, 0.6, 0.8, 0.9],
    [0.2, 0.4, 0.3, 0.7, 0.6, 0.9]
])

Y = np.array([
    [0, 0, 0, 1, 1, 1]
], dtype=float)

model = NeuralNetwork(
    layer_sizes=[2, 4, 1],
    hidden_activation="tanh",
    seed=12
)

history = model.fit(
    X, Y,
    epochs=3000,
    learning_rate=0.2,
    batch_size=3,
    shuffle=True,
    verbose_every=500
)

probabilities = model.predict_proba(X)

print("nPredictions:")
for i in range(X.shape[1]):
    print(
        f"Sample {i+1}: "
        f"target={int(Y[0, i])}, "
        f"probability={probabilities[0, i]:.4f}"
    )
تفسیر مدیریتی
خروجی این مدل عددی بین صفر و یک است که در چارچوب مدل، احتمال پیشبینیشده کلاس یک محسوب میشود.
برای مثال، اگر مدل برای یک مشاهده مقدار ۰٫۸ تولید کند، میتوان گفت مدل آن مشاهده را با امتیاز احتمال ۰٫۸ به کلاس «نیازمند بررسی» نسبت داده است.
اما این عدد لزوماً به معنی احتمال واقعی و کالیبرهشده وقوع خرابی نیست. برای چنین تفسیری باید کیفیت دادهها، تعمیمپذیری، کالیبراسیون احتمالات و اعتبارسنجی مستقل بررسی شوند.
در کاربرد واقعی، آستانه تصمیم نیز باید با توجه به هزینه هشدار اشتباه و هزینه ازدستدادن موارد خطرناک تعیین شود؛ آستانه ۰٫۵ الزاماً بهترین انتخاب عملیاتی نیست.
۸.۱۰. کنترل کیفیت پیادهسازی
پیش از استفاده از موتور آموزشی در پروژههای بزرگتر، باید چند آزمون پایه انجام دهیم.
آزمون اول: بررسی ابعاد
برای معماری:
ابعاد وزنها باید چنین باشند:
میتوانیم این شرط را در برنامه بررسی کنیم:
model = NeuralNetwork(
    [3, 5, 4, 1],
    seed=42
)

expected_shapes = [
    (5, 3),
    (4, 5),
    (1, 4)
]

for W, expected in zip(
    model.weights,
    expected_shapes
):
    assert W.shape == expected

print("All weight dimensions are correct.")
آزمون دوم: بررسی محدودۀ خروجی
چون لایه خروجی Sigmoid دارد، خروجی مدل باید بین صفر و یک باشد:
[ 0leqhat yleq1 ]

X_test = np.array([
    [0.2, 0.7],
    [0.3, 0.8],
    [0.5, 0.1]
])

output = model.predict_proba(X_test)

assert output.shape == (1, 2)
assert np.all(output >= 0.0)
assert np.all(output <= 1.0)

print("Output range is valid.")
آزمون سوم: بررسی متناهیبودن زیان و گرادیانها
در محاسبات عددی، مقادیر NaN و Inf نشانه مشکلاتی مانند سرریز، تقسیم نامعتبر یا ناپایداری محاسباتی هستند.
Y_test = np.array([[0.0, 1.0]])

A = model.forward(X_test)
loss = model.binary_cross_entropy(
    A, Y_test
)

grad_W, grad_b = model.backward(
    Y_test
)

assert np.isfinite(loss)

for grad in grad_W + grad_b:
    assert np.all(np.isfinite(grad))

print("Loss and gradients are finite.")
این آزمونها برای تشخیص برخی خطاهای برنامهنویسی مفیدند؛ اما صحت مشتقها را اثبات نمیکنند. ممکن است تمام ابعاد درست باشند و همه اعداد متناهی باشند، ولی یک مشتق اشتباه محاسبه شده باشد.
برای همین، در بخش نهم از Gradient Checking استفاده خواهیم کرد.
۸.۱۱. محدودیتهای موتور آموزشی
موتور ساختهشده برای یادگیری و بررسی محاسبات طراحی شده است، نه جایگزینی برای چارچوبهای صنعتی.
| قابلیت | وضعیت در این پیادهسازی |
| شبکه تماممتصل چندلایه | پشتیبانی میشود |
| Sigmoid، Tanh و ReLU در لایه پنهان | پشتیبانی میشود |
| طبقهبندی دودویی با BCE | پشتیبانی میشود |
| Mini-batch Gradient Descent | پشتیبانی میشود |
| مقداردهی اولیه تصادفی | پشتیبانی میشود |
| ثبت زیان و دقت آموزش | پشتیبانی میشود |
| Autograd | عمداً استفاده نشده |
| خروجی چندکلاسه Softmax | پیادهسازی نشده |
| Adam و سایر بهینهسازهای پیشرفته | پیادهسازی نشده |
| Dropout و Batch Normalization | پیادهسازی نشده |
| GPU و آموزش توزیعشده | پیادهسازی نشده |
| ذخیره و بازیابی وضعیت مدل | پیادهسازی نشده |
این محدودسازی عمدی است. هدف آن است که دانشجو پیش از استفاده از ابزارهای پیشرفته، سازوکار پایه یادگیری را دقیقاً درک کند.
۸.۱۲. تمرینهای عملیاتی و پژوهشی
تمرین ۱. توسعه تابع فعالسازی
تابع Leaky ReLU را به کلاس اضافه کنید:
مشتق آن را پیادهسازی کنید و خروجی شبکه را با ReLU مقایسه کنید.
تمرین ۲. آزمایش معماری
مسئله XOR را با معماریهای زیر آموزش دهید:
برای هر معماری، تعداد پارامترها، زیان نهایی و دقت آموزش را گزارش کنید. آزمایش را با چند مقدار Seed تکرار کنید تا اثر مقداردهی اولیه نیز مشخص شود.
تمرین ۳. بررسی اندازه Mini-batch
یک مجموعه داده مصنوعی با حداقل ۲۰۰ نمونه ایجاد کنید و مدل را با اندازههای Mini-batch برابر ۱، ۱۶، ۳۲ و کل مجموعه آموزش دهید.
تعداد بهروزرسانیها در هر Epoch، زمان اجرا و رفتار منحنی زیان را مقایسه کنید.
تمرین ۴. تحلیل نرخ یادگیری
نرخهای یادگیری زیر را بررسی کنید:
برای مقایسه منصفانه، معماری، دادهها، Seed و تعداد Epoch را ثابت نگه دارید.
تمرین ۵. آزمایش تابع فعالسازی
برای یک مجموعه داده ثابت، سه مدل با Sigmoid، Tanh و ReLU در لایههای پنهان آموزش دهید.
رفتار گرادیانها و زیان را بررسی کنید و درباره تفاوتها نتیجهگیری کنید.
تمرین ۶. توسعه ارزیابی
تابعی به برنامه اضافه کنید که علاوه بر Accuracy، معیارهای زیر را محاسبه کند:
سپس این معیارها را روی داده آزمون مستقل گزارش کنید.
تمرین ۷. تحلیل پایداری عددی
برای ورودیهای زیر مقدار Sigmoid را محاسبه کنید:
نسخه ساده Sigmoid و نسخه پایدار استفادهشده در برنامه را مقایسه کنید.
تمرین ۸. توسعه موتور برای رگرسیون
کلاس را بهگونهای توسعه دهید که برای مسئله رگرسیون، لایه خروجی خطی و تابع زیان MSE داشته باشد.
مشتق خروجی را بهصورت دستی استخراج کرده و برنامه را روی یک مجموعه داده خطی آزمایش کنید.
تمرین ۹. ثبت اندازه گرادیان
در هر Epoch، نرم فروبنیوس گرادیان وزنهای هر لایه را محاسبه کنید:
نمودار تغییر این مقدار را رسم کنید و بررسی کنید آیا گرادیان لایههای اولیه در طول آموزش بسیار کوچک یا بسیار بزرگ میشود.
پاسخ تشریحی منتخب: تمرین ۷
تابع Sigmoid:
اگر (z=-1000) باشد، محاسبه مستقیم (e^{1000}) در محاسبات معمول شناور میتواند باعث سرریز شود.
اما میتوان Sigmoid را برای (z<0) به شکل معادل زیر نوشت:
در این حالت برای (z=-1000)، مقدار (e^{-1000}) در دقت شناور معمول عملاً صفر میشود و خروجی بدون سرریز محاسبه خواهد شد.
برای z ≥ ۰، از رابطه اولیه استفاده میکنیم؛ زیرا e^(−z) از یک بزرگتر نمیشود.
بنابراین پیادهسازی پایدار:
این دو رابطه از نظر ریاضی معادلاند، اما از نظر پایداری عددی در محاسبات کامپیوتری رفتار مناسبتری دارند.
۸.۱۳. جمعبندی بخش هشتم
در این بخش، روابط ریاضی Backpropagation را به یک موتور آموزشی قابلاستفاده تبدیل کردیم.
مهمترین نتیجه این است که آموزش یک شبکه عصبی چندلایه را میتوان با تعداد محدودی عملیات ماتریسی و مشتقهای محلی پیادهسازی کرد.
چهار مرحله اصلی عبارتاند از:
در این پیادهسازی، شبکه قادر است معماریهای متفاوتی را اجرا کند و گرادیانها را بدون استفاده از مشتقگیری خودکار به دست آورد.
بااینحال، یک پرسش اساسی هنوز باقی مانده است:
چگونه مطمئن شویم گرادیانهایی که خودمان نوشتهایم واقعاً درست هستند؟
درستی شکل ماتریسها، کاهش زیان و حتی موفقیت در یادگیری XOR، هیچکدام بهتنهایی اثبات نمیکنند که تمام مشتقها درست پیادهسازی شدهاند.
پاسخ این پرسش، موضوع بخش نهم است.
منابع علمی بخش هشتم
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
Glorot, X., & Bengio, Y. (2010). Understanding the difficulty of training deep feedforward neural networks. Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics, 9, 249–256.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
He, K., Zhang, X., Ren, S., & Sun, J. (2015). Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. Proceedings of the IEEE International Conference on Computer Vision, 1026–1034. https://doi.org/10.1109/ICCV.2015.123
Nielsen, M. A. (2015). Neural networks and deep learning. Determination Press.
Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323, 533–536. https://doi.org/10.1038/323533a0
9. بررسی عددی گرادیانها (Numerical Gradient Checking)
در بخش هشتم، یک موتور آموزشی شبکه عصبی را بدون استفاده از Autograd پیادهسازی کردیم. این موتور میتواند انتشار روبهجلو، محاسبه زیان، بازپسانتشار خطا و بهروزرسانی پارامترها را انجام دهد.
اما یک مسئله مهم باقی مانده است:
از کجا مطمئن شویم گرادیانهایی که بهصورت دستی محاسبه کردهایم، صحیح هستند؟
ممکن است شبکه در طول آموزش زیان کمتری تولید کند، اما یکی از مشتقها اشتباه پیادهسازی شده باشد. همچنین ممکن است ابعاد تمام ماتریسها درست باشند، ولی یک ترانهاده، ضریب میانگینگیری یا مشتق فعالسازی بهدرستی اعمال نشده باشد.
در این بخش، روشی مستقل برای کنترل صحت Backpropagation معرفی میکنیم: بررسی عددی گرادیانها.
این روش با ایجاد تغییرات بسیار کوچک در پارامترهای شبکه، حساسیت تابع زیان را مستقیماً اندازهگیری میکند و آن را با گرادیان تحلیلی مقایسه میکند.
هدف نهایی آن است که بتوانیم برای تمام وزنها و بایاسهای یک شبکه چندلایه، آزمونی قابلبازتولید طراحی کنیم.
۹.۱. تفاوت گرادیان تحلیلی و گرادیان عددی
فرض کنید تابعی بهصورت زیر تعریف شده باشد:
مشتق تحلیلی:
در نقطه (x=3):
این نتیجه را از قواعد مشتقگیری به دست آوردهایم.
اما فرض کنید نمیخواهیم یا نمیتوانیم مشتق تابع را بهصورت نمادین محاسبه کنیم. آیا میتوان با اندازهگیری تغییر خروجی تابع، مقدار مشتق را تخمین زد؟
بله.
تعریف مشتق:
اگر (h) کوچک اما غیرصفر باشد، میتوان نوشت:
این روش را تفاضل محدود پیشرو (Forward Finite Difference) مینامیم.
مثال ۹-۱. محاسبه مشتق بدون قواعد مشتقگیری
برای:
داریم:
پس:
درحالیکه مشتق دقیق برابر ۶ بود.
خطای مطلق:
اگر مقدار (h) را کوچکتر کنیم، معمولاً تقریب بهتر میشود؛ البته فقط تا جایی که خطاهای گردکردن محاسبات شناور غالب نشوند.
۹.۲. چرا تفاضل مرکزی دقیقتر است؟
روش تفاضل پیشرو فقط تغییر تابع در سمت راست نقطه را بررسی میکند.
اما میتوان تابع را در دو طرف نقطه ارزیابی کرد:
در این صورت:
این روش تفاضل محدود مرکزی (Central Finite Difference) نام دارد.
برای توابع بهاندازه کافی هموار، خطای برش تفاضل پیشرو از مرتبه (O(h)) و خطای برش تفاضل مرکزی از مرتبه (O(h^2)) است.
مثال ۹-۲. مشتق مرکزی تابع درجه دوم
برای همان تابع:
در نقطه (x=3) و با (h=0.1):
پس:
در این مثال، تفاضل مرکزی مشتق را دقیقاً به دست داده است؛ زیرا جملههای خطای مرتبه دوم تابع درجه دوم در تفاضل متقارن حذف میشوند.
شکل ۹-۱. تفاوت تفاضل پیشرو و مرکزی
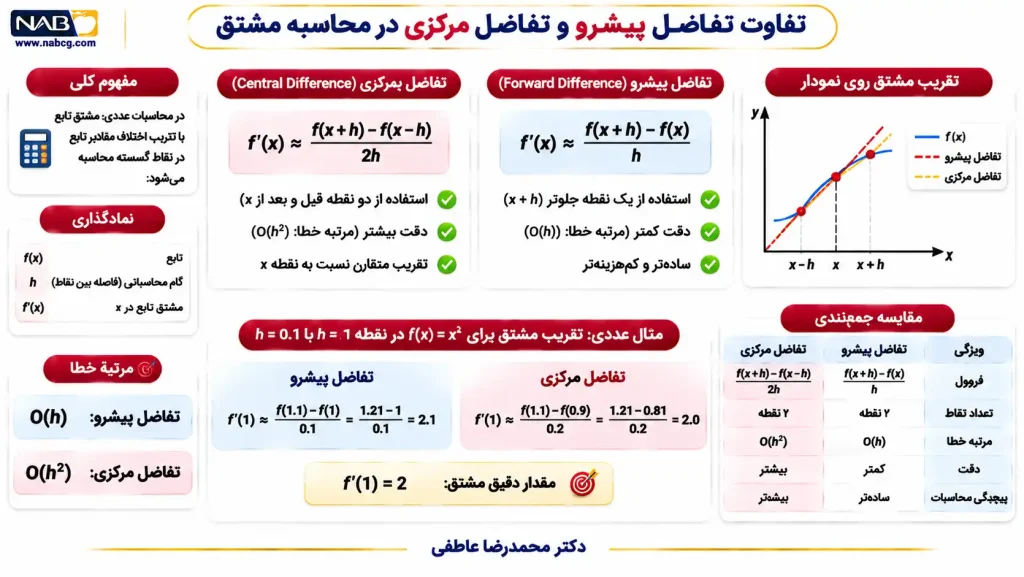
شکل شماتیک است و مقیاس عددی ندارد. تفاضل مرکزی شیب خط گذرنده از دو نقطه متقارن نسبت به (x) را محاسبه میکند.
۹.۳. استنتاج دقت تفاضل مرکزی با بسط تیلور
برای درک دلیل برتری تفاضل مرکزی، تابع هموار (f) را در اطراف (x) بسط میدهیم.
- برای نقطه (x+h):
- برای نقطه (x-h):
اکنون رابطه دوم را از رابطه اول کم میکنیم:
در نتیجه:
پس خطای اصلی روش مرکزی با (h^2) متناسب است.
این نتیجه با فرض همواری کافی تابع و در حساب دقیق برقرار است. در محاسبات کامپیوتری، خطای گردکردن نیز باید در نظر گرفته شود.
۹.۴. مثال عددی پیشرفته: مشتق تابع غیرخطی
تابع زیر را در نظر بگیرید:
مشتق تحلیلی:
در نقطه:
داریم:
اکنون با تفاضل مرکزی و (h=0.01):
مقادیر:
با محاسبه عددی:
در نتیجه:
که به مقدار تحلیلی نزدیک است.
برای محاسبه دقیقتر و جلوگیری از اثر گردکردن زودهنگام، از کد زیر استفاده میکنیم:
import numpy as np

def f(x):
    return np.sin(x) + x**3

def analytical_derivative(x):
    return np.cos(x) + 3*x**2

def central_difference(f, x, h):
    return (f(x+h) - f(x-h)) / (2*h)

x = 1.0
exact = analytical_derivative(x)

for h in [1e-1, 1e-2, 1e-3, 1e-4, 1e-5]:
    numerical = central_difference(f, x, h)
    error = abs(numerical - exact)

    print(
        f"h={h:.0e} | "
        f"numerical={numerical:.10f} | "
        f"error={error:.3e}"
    )
این آزمایش نشان میدهد که انتخاب (h) یکی از عوامل مهم در دقت Gradient Checking است.
۹.۵. تعمیم مشتق عددی به چند پارامتر
در شبکه عصبی، تابع زیان به یک پارامتر محدود نیست.
فرض کنید:
که در آن (P) تعداد کل پارامترهای شبکه است.
گرادیان تحلیلی:
برای بررسی عددی هر مؤلفه، تنها همان پارامتر را تغییر میدهیم و سایر پارامترها را ثابت نگه میداریم:
که 𝐞ᵢ برداری است که تنها مؤلفه i-ام آن یک است.
مثال ۹-۳. تابعی با دو پارامتر
فرض کنید:
در نقطه:
ابتدا:
پس:
مشتق تحلیلی نسبت به وزن:
مشتق تحلیلی نسبت به بایاس:
اکنون با (h=0.01) گرادیان وزن را بررسی میکنیم:
بنابراین:
برای بایاس:
پس:
در این مثال، گرادیانهای تحلیلی و عددی دقیقاً یکسان هستند.
۹.۶. چگونه اختلاف دو گرادیان را اندازهگیری کنیم؟
پس از محاسبه گرادیان عددی و تحلیلی، باید معیاری برای مقایسه آنها تعریف کنیم.
خطای مطلق
برای مؤلفه (i):
این معیار ساده است، اما وقتی اندازه گرادیانها بسیار متفاوت باشد، مقایسه را دشوار میکند.
خطای نسبی متقارن
برای کل بردار گرادیان:
که در آن ε عددی کوچک برای جلوگیری از تقسیم بر صفر است.
اگر:
آنگاه:
آستانه پذیرش
برای محاسبات float64، توابع هموار و پیادهسازی صحیح، خطای نسبی در حدود (10^{-7}) یا کوچکتر اغلب نتیجه مطلوبی است؛ اما این مقدار یک معیار جهانشمول نیست.
آستانه مناسب به اندازه گام (h)، مقیاس پارامترها، اندازه گرادیانها، نوع تابع زیان و پایداری عددی بستگی دارد.
در نزدیکی نقاط غیرقابلمشتق ReLU، یا وقتی گرادیانها بسیار کوچکاند، باید نتیجه را با احتیاط تفسیر کرد.
۹.۷. پیادهسازی بررسی عددی گرادیان برای یک نورون
پیش از آزمون شبکه چندلایه، بهتر است ابتدا Gradient Checking را روی یک نورون اجرا کنیم.
فرض کنید:
و تابع زیان، Binary Cross-Entropy باشد.
برای یک نمونه:
از بخش هشتم میدانیم:
پس:
مثال ۹-۴. محاسبه عددی و تحلیلی
مقادیر زیر را در نظر بگیرید:
انتشار روبهجلو:
سیگنال خطا:
گرادیان تحلیلی وزن:
گرادیان بایاس:
اکنون این دو مقدار را با تفاضل مرکزی بررسی میکنیم.
برای افزایش پایداری عددی، زیان Binary Cross-Entropy را مستقیماً از مقدار (z) محاسبه میکنیم:
این رابطه از نظر ریاضی با BCE مبتنی بر Sigmoid معادل است.
برای محاسبه پایدار آن، از تابع logaddexp استفاده میکنیم.
import numpy as np

def sigmoid(z):
    return np.exp(-np.logaddexp(0.0, -z))

def loss_function(w, b, x, y):
    z = w * x + b
    return np.logaddexp(0.0, z) - y * z

def analytical_gradients(w, b, x, y):
    z = w * x + b
    a = sigmoid(z)

    delta = a - y

    grad_w = delta * x
    grad_b = delta

    return grad_w, grad_b

def numerical_gradients(w, b, x, y, h=1e-5):
    grad_w = (
        loss_function(w + h, b, x, y)
        - loss_function(w - h, b, x, y)
    ) / (2 * h)

    grad_b = (
        loss_function(w, b + h, x, y)
        - loss_function(w, b - h, x, y)
    ) / (2 * h)

    return grad_w, grad_b

x = 2.0
y = 1.0
w = 0.5
b = 0.0

gw_a, gb_a = analytical_gradients(w, b, x, y)
gw_n, gb_n = numerical_gradients(w, b, x, y)

print("Analytical weight gradient:", gw_a)
print("Numerical weight gradient: ", gw_n)

print("Analytical bias gradient:", gb_a)
print("Numerical bias gradient: ", gb_n)

print("Weight absolute error:", abs(gw_a - gw_n))
print("Bias absolute error:", abs(gb_a - gb_n))

assert np.isclose(gw_a, gw_n, rtol=1e-7, atol=1e-9)
assert np.isclose(gb_a, gb_n, rtol=1e-7, atol=1e-9)
نتیجه مورد انتظار
| پارامتر | گرادیان تحلیلی | گرادیان عددی مورد انتظار |
| وزن (w) | −۰٫۵۳۷۸۸۲۸۴ | نزدیک به −۰٫۵۳۷۸۸۲۸۴ |
| بایاس (b) | −۰٫۲۶۸۹۴۱۴۲ | نزدیک به −۰٫۲۶۸۹۴۱۴۲ |
اگر کد صحیح اجرا شود، اختلاف گرادیانها بسیار کوچک خواهد بود.
اما توجه کنید که این آزمون فقط مشتقهای همین نورون و همین تابع زیان را بررسی میکند. برای شبکه چندلایه باید تمام پارامترها را آزمود.
۹.۸. بررسی عددی گرادیان تمام پارامترهای یک شبکه
اکنون به مهمترین قسمت این بخش میرسیم.
میخواهیم موتور NeuralNetwork ساختهشده در بخش هشتم را اعتبارسنجی کنیم.
شبکه ممکن است چند ماتریس وزن و چند بردار بایاس داشته باشد. برای مثال، شبکه ۲–۳–۱ دارای ۱۳ پارامتر است:
برای هر پارامتر باید دو بار تابع زیان را ارزیابی کنیم:
پس برای بررسی تمام (P) پارامترها، تفاضل مرکزی به حدود (2P) ارزیابی Forward نیاز دارد.
برای شبکه کوچک این هزینه قابلقبول است؛ اما برای شبکهای با میلیونها پارامتر، بررسی عددی همه مؤلفهها بسیار پرهزینه خواهد بود.
۹.۸.۱. طراحی آزمون
آزمون باید این مراحل را اجرا کند:
شکل ۹-۲. فرایند اعتبارسنجی گرادیان
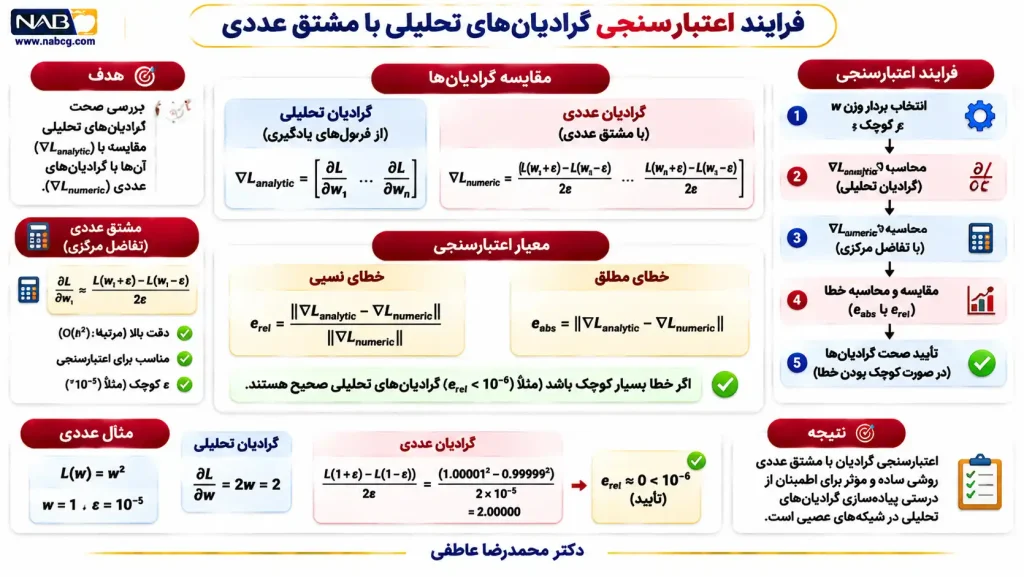
نکته ضروری این است که هنگام تغییر موقت یک پارامتر، تمام پارامترهای دیگر ثابت بمانند. همچنین باید پس از محاسبه هر مشتق عددی، مقدار اولیه پارامتر بازگردانده شود.
۹.۹. ساخت تابع عمومی Gradient Checking
کد زیر با کلاس NeuralNetwork بخش هشتم سازگار است.
در این آزمون، زیان را از Logit خروجی محاسبه میکنیم تا اختلاف ناشی از محدودسازی عددی احتمالها در تابع زیان قبلی، نتیجه Gradient Checking را مخدوش نکند.
برای شبکه دارای خروجی Sigmoid:
این تابع دقیقاً با مشتق خروجی زیر سازگار است:
import numpy as np


def stable_loss_from_logits(model, X, Y):
    """
    Stable binary cross-entropy from output logits.
    Requires the NeuralNetwork class from Section 8.
    """
    model.forward(X, save_cache=True)

    logits = model.cache["Z"][-1]

    return float(np.mean(
        np.logaddexp(0.0, logits) - Y * logits
    ))


def gradient_check(model, X, Y, h=1e-5):
    """
    Compare analytical and central-difference
    gradients for every weight and bias.
    """

    # Analytical gradients
    model.forward(X, save_cache=True)
    grad_W, grad_b = model.backward(Y)

    analytic = []
    numeric = []
    names = []

    # Check every weight
    for layer_index, W in enumerate(model.weights):
        for index in np.ndindex(W.shape):
            original = W[index]

            try:
                W[index] = original + h
                loss_plus = stable_loss_from_logits(
                    model, X, Y
                )

                W[index] = original - h
                loss_minus = stable_loss_from_logits(
                    model, X, Y
                )
            finally:
                W[index] = original

            numerical_gradient = (
                loss_plus - loss_minus
            ) / (2.0 * h)

            analytic.append(
                grad_W[layer_index][index]
            )
            numeric.append(numerical_gradient)

            names.append(
                f"W{layer_index + 1}{index}"
            )

    # Check every bias
    for layer_index, b in enumerate(model.biases):
        for index in np.ndindex(b.shape):
            original = b[index]

            try:
                b[index] = original + h
                loss_plus = stable_loss_from_logits(
                    model, X, Y
                )

                b[index] = original - h
                loss_minus = stable_loss_from_logits(
                    model, X, Y
                )
            finally:
                b[index] = original

            numerical_gradient = (
                loss_plus - loss_minus
            ) / (2.0 * h)

            analytic.append(
                grad_b[layer_index][index]
            )
            numeric.append(numerical_gradient)

            names.append(
                f"b{layer_index + 1}{index}"
            )

    analytic = np.array(analytic)
    numeric = np.array(numeric)

    absolute_errors = np.abs(analytic - numeric)

    relative_error = (
        np.linalg.norm(analytic - numeric)
        /
        (
            np.linalg.norm(analytic)
            + np.linalg.norm(numeric)
            + 1e-12
        )
    )

    print("Number of parameters:", len(names))
    print("Relative error:", relative_error)
    print("Maximum absolute error:",
          np.max(absolute_errors))

    print("nParameter comparison:")

    for name, ga, gn, error in zip(
        names,
        analytic,
        numeric,
        absolute_errors
    ):
        print(
            f"{name:12s} "
            f"analytic={ga:+.9f} "
            f"numeric={gn:+.9f} "
            f"error={error:.3e}"
        )

    return {
        "relative_error": relative_error,
        "max_absolute_error": float(
            np.max(absolute_errors)
        ),
        "analytical": analytic,
        "numerical": numeric,
        "parameter_names": names
    }
۹.۹.۱. اجرای آزمون روی شبکه ۲–۳–۱
import numpy as np

X = np.array([
    [0.2, 0.7, 0.4],
    [0.5, 0.1, 0.9]
])

Y = np.array([
    [1.0, 0.0, 1.0]
])

model = NeuralNetwork(
    layer_sizes=[2, 3, 1],
    hidden_activation="tanh",
    seed=42
)

results = gradient_check(
    model,
    X,
    Y,
    h=1e-5
)

assert results["relative_error"] < 1e-7
این آزمون برای تمام ۱۳ پارامتر شبکه، گرادیان تحلیلی و عددی را محاسبه و مقایسه میکند.
در یک پیادهسازی صحیح و در این شرایط عددی، انتظار داریم خطای نسبی بسیار کوچک باشد. مقدار دقیق آن باید از اجرای کد گزارش شود.
۹.۹.۲. چرا آزمون باید پیش از آموزش انجام شود؟
Gradient Checking معمولاً یک ابزار اشکالزدایی است، نه بخشی از حلقه عادی آموزش.
اگر گرادیانها نادرست باشند، اجرای هزاران Epoch فقط باعث میشود زمان بیشتری صرف آموزش مدلی با محاسبات اشتباه شود.
بنابراین ترتیب مناسب توسعه چنین است:
1. ساخت Forward؛
2. ساخت Backward؛
3. اجرای Gradient Checking؛
4. اصلاح خطاهای مشتقگیری؛
5. شروع آموزش اصلی.
پس از اطمینان از صحت پیادهسازی، Gradient Checking را از حلقه آموزش خارج میکنیم.
۹.۱۰. آزمایش حساسیت: اندازه گام (h) چه اثری بر دقت دارد؟
یکی از اشتباهات رایج این است که تصور کنیم هرچه (h) کوچکتر باشد، گرادیان عددی دقیقتر خواهد بود.
در حساب دقیق، کوچکشدن (h) خطای برش تفاضل مرکزی را کاهش میدهد. اما در محاسبات شناور، وقتی (h) بسیار کوچک شود، دو مقدار:
[ f(x+h),qquad f(x-h) ]
به یکدیگر بسیار نزدیک خواهند شد.
تفریق این دو عدد میتواند باعث حذف ارقام معنادار (Catastrophic Cancellation) شود.
بنابراین دو منبع خطا داریم:
برای تفاضل مرکزی در شرایط معمول:
و خطای گردکردن میتواند تقریباً متناسب با:
باشد؛ که (u) دقت ماشین است و ضرایب این تقریب به مقیاس تابع و محاسبات بستگی دارند.
از اینرو، انتخاب (h) باید میان این دو منبع خطا تعادل ایجاد کند.
آزمایش ۹-۱. مقایسه اندازههای مختلف گام
import numpy as np
import matplotlib.pyplot as plt

def f(x):
    return np.sin(x) + x**3

def df(x):
    return np.cos(x) + 3*x**2

x = 1.0
exact = df(x)

h_values = np.logspace(-1, -14, 100)
errors = []

for h in h_values:
    numerical = (f(x+h) - f(x-h)) / (2*h)
    errors.append(abs(numerical - exact))

plt.figure(figsize=(8, 4.5))
plt.loglog(h_values, errors)
plt.xlabel("Step size h")
plt.ylabel("Absolute derivative error")
plt.title("Central Difference: Truncation vs Roundoff")
plt.grid(True, which="both", alpha=0.3)
plt.tight_layout()
plt.show()

best_index = int(np.argmin(errors))

print("Best tested h:", h_values[best_index])
print("Minimum observed error:", errors[best_index])
برای این آزمایش، معمولاً نموداری با یک ناحیه خطای کمینه مشاهده میشود: در یک سمت، گام بزرگ موجب خطای برش میشود و در سمت دیگر، گام بسیار کوچک خطای گردکردن را افزایش میدهد.
مقدار بهینه به تابع، نقطه ارزیابی و دقت عددی بستگی دارد. برای Gradient Checking شبکههای عصبی با float64، مقدار (h=10^{-5}) اغلب نقطه شروع عملی مناسبی است، اما باید در صورت نیاز با چند مقدار دیگر نیز آزمون شود.
۹.۱۱. محدودیت مهم: نقاط غیرقابلمشتق ReLU
تابع ReLU بهصورت زیر تعریف میشود:
مشتق آن:
در نقطه (z=0)، مشتق کلاسیک وجود ندارد.
در بسیاری از پیادهسازیها، برای Backpropagation در صفر از قرارداد زیر استفاده میشود:
اما اگر تفاضل مرکزی را در صفر محاسبه کنیم:
پس ممکن است داشته باشیم:
آیا این اختلاف به معنی اشتباهبودن Backpropagation است؟
خیر. مشکل آن است که تابع در این نقطه مشتقپذیر نیست و دو روش در واقع دو قرارداد متفاوت را ارزیابی میکنند.
آزمایش ۹-۲. رفتار ReLU در صفر
def relu(x):
    return max(0.0, x)

def relu_derivative(x):
    return 1.0 if x > 0 else 0.0

h = 1e-5
x = 0.0

analytic = relu_derivative(x)

numerical = (
    relu(x+h) - relu(x-h)
) / (2*h)

print("Analytical convention:", analytic)
print("Central difference:", numerical)
برای اعتبارسنجی شبکههای دارای ReLU، بهتر است پارامترها و دادههای آزمون را طوری انتخاب کنیم که پیشفعالسازی نورونها در نزدیکی صفر قرار نگیرند.
همچنین میتوان Gradient Checking را برای نقاطی که فاصله کافی از نواحی غیرقابلمشتق دارند انجام داد.
۹.۱۲. چگونه یک خطای عمدی در Backpropagation را کشف کنیم؟
یکی از بهترین راههای یادگیری ابزارهای اعتبارسنجی، ایجاد یک خطای کنترلشده و بررسی واکنش آزمون است.
در شبکه چندلایه، رابطه صحیح سیگنال خطای لایه پنهان برای Tanh برابر است با:
فرض کنید برنامهنویس بهاشتباه مشتق Tanh را چنین محاسبه کند:
بهجای:
در این صورت گرادیان وزنهای لایه پنهان معمولاً نادرست خواهد شد.
آزمایش ۹-۳. شناسایی مشتق اشتباه
کد زیر یک نسخه آزمایشی از Backward را با خطای عمدی پیادهسازی میکند. این کد باید پس از تعریف کلاس NeuralNetwork و تابع gradient_check اجرا شود.
mport numpy as np

class BuggyNeuralNetwork(NeuralNetwork):

    def hidden_derivative(self, z, a):
        if self.hidden_activation == "tanh":
            # INTENTIONAL BUG:
            # correct derivative is 1 - a**2
            return 1.0 - a

        return super().hidden_derivative(z, a)


X = np.array([
    [0.2, 0.7, 0.4],
    [0.5, 0.1, 0.9]
])

Y = np.array([
    [1.0, 0.0, 1.0]
])

buggy_model = BuggyNeuralNetwork(
    layer_sizes=[2, 3, 1],
    hidden_activation="tanh",
    seed=42
)

result = gradient_check(
    buggy_model, X, Y, h=1e-5
)

print("Relative error:", result["relative_error"])

if result["relative_error"] >= 1e-7:
    print("Gradient check failed: inspect backward.")
در این آزمایش، انتظار داریم گرادیانهای مربوط به لایه پنهان با گرادیانهای عددی اختلاف معناداری داشته باشند.
اما گرادیانهای لایه خروجی ممکن است همچنان صحیح باشند؛ زیرا محاسبه آنها به مشتق اشتباه Tanh در لایه پنهان وابسته نیست.
این ویژگی Gradient Checking در اشکالزدایی بسیار ارزشمند است: با بررسی اینکه کدام پارامترها خطای بیشتری دارند، میتوان محل احتمالی اشتباه را شناسایی کرد.
۹.۱۳. بررسی عددی گرادیان در شبکههای بزرگ
روش تفاضل مرکزی برای تمام پارامترها از نظر محاسباتی گران است.
اگر شبکه دارای (P) پارامتر باشد، بررسی تمام گرادیانها به حدود (2P) ارزیابی تابع زیان نیاز دارد.
برای مثال:
| تعداد پارامترها | ارزیابی Forward موردنیاز |
| ۱۰ | ۲۰ |
| ۱۰۰ | ۲۰۰ |
| ۱٬۰۰۰ | ۲٬۰۰۰ |
| ۱۰۰٬۰۰۰ | ۲۰۰٬۰۰۰ |
| ۱٬۰۰۰٬۰۰۰ | ۲٬۰۰۰٬۰۰۰ |
بنابراین برای شبکههای بزرگ، میتوان از روشهای مکمل استفاده کرد.
روش اول: بررسی تصادفی تعدادی از پارامترها
بهجای بررسی تمام پارامترها، مجموعهای از آنها را بهصورت تصادفی انتخاب میکنیم.
این روش هزینه محاسباتی را کاهش میدهد، اما تضمین نمیکند که خطای موجود در پارامترهای بررسینشده کشف شود.
بهتر است نمونهگیری از تمام لایهها و انواع پارامترها، یعنی وزنها و بایاسها، انجام شود.
روش دوم: بررسی مشتق جهتی
فرض کنید بردار پارامترهای شبکه (boldsymboltheta) و گرادیان تحلیلی آن (mathbf g) باشد.
برای یک جهت دلخواه (mathbf v):
سمت چپ را میتوان با تفاضل مرکزی تخمین زد:
و با:
مقایسه کرد.
این روش برای هر جهت فقط دو ارزیابی تابع زیان نیاز دارد.
مثال ۹-۵. مشتق جهتی با محاسبات کامل
تابع:
در نقطه:
گرادیان:
جهت:
مشتق جهتی تحلیلی:
اکنون تغییرات پارامترها:
تابع در این مسیر:
با بسط:
پس:
تفاضل مرکزی:
در این مثال، مشتق جهتی عددی و تحلیلی یکسان هستند.
محدودیت مهم: بررسی مشتق جهتی، صحت تکتک مؤلفههای گرادیان را تضمین نمیکند. ممکن است بعضی خطاها در یک جهت خاص یکدیگر را خنثی کنند. به همین دلیل، استفاده از چند جهت تصادفی مستقل و ترکیب آن با بررسی مؤلفهای توصیه میشود.
۹.۱۴. چکلیست اعتبارسنجی Backpropagation
چکلیست پیش از تأیید موتور آموزشی
0 از 10
- ابعاد تمام ماتریسهای وزن و گرادیان متناظر یکسان است.
- تابع زیان عددی و مشتق تحلیلی دقیقاً به یک تعریف زیان مربوطاند.
- ضریب میانگینگیری Mini-batch دقیقاً یک بار اعمال شده است.
- در Gradient Checking فقط یک پارامتر در هر مرحله تغییر میکند.
- پارامتر تغییرکرده پس از هر آزمون به مقدار اولیه بازمیگردد.
- هنگام آزمون، عملیات تصادفی و وابسته به وضعیت غیرفعال یا ثابت هستند.
- مقادیر آزمون از نقاط غیرقابلمشتق فاصله دارند.
- آزمون با float64 و چند اندازه گام مناسب انجام شده است.
- خطای مطلق و نسبی هر دو بررسی شدهاند.
- گرادیانهای تمام لایهها، از جمله بایاسها، پوشش داده شدهاند.
- بازنشانی چکلیست
این چکلیست برای بررسی یک پیادهسازی پژوهشی یا آموزشی مفید است. بااینحال، موفقیت در Gradient Checking بهتنهایی تضمین نمیکند که معماری، دادهها، تابع زیان یا روش آموزش برای مسئله واقعی مناسب انتخاب شدهاند.
۹.۱۵. تمرینهای پایانی بخش نهم
- تمرین ۱ ـ مقایسه روشها: مشتق تابع (f(x)=e^x+x^2) را در (x=1) با تفاضل پیشرو و مرکزی برای (h=0.1)، (0.01) و (0.001) محاسبه کنید. خطای هر روش را با مشتق تحلیلی مقایسه کنید.
- تمرین ۲ ـ گرادیان چندمتغیره: تابع زیر را در نظر بگیرید:
در نقطه (w₁، w₂، b) = (۱، ۱، ۰)، تمام مشتقهای تحلیلی و عددی را محاسبه کنید.
- تمرین ۳ ـ کشف خطا: در کد Backpropagation بخش هشتم، عمداً ترانهاده ماتریس وزن در انتقال گرادیان را حذف کنید. مشخص کنید برنامه با چه نوع خطایی مواجه میشود و چرا.
- تمرین ۴ ـ آزمون فعالسازیها: برای شبکه ۲–۳–۱، Gradient Checking را با Sigmoid، Tanh و ReLU اجرا کنید. تفاوت نتایج را تحلیل کنید.
- تمرین ۵ ـ اندازه گام: آزمون گرادیان شبکه را با مقادیر زیر اجرا کنید:
نمودار خطای نسبی برحسب (h) را در مقیاس لگاریتمی رسم کنید.
- تمرین ۶ ـ آزمون Mini-batch: اندازه دسته آموزشی را از ۳ به ۱ و سپس به ۵ تغییر دهید. مطمئن شوید که تعریف زیان و گرادیانها همچنان سازگار است.
- تمرین ۷ ـ خطای عمدی میانگینگیری: در کد backward، تقسیم گرادیان وزنها بر اندازه Mini-batch را حذف کنید. آزمون را اجرا کرده و اختلاف گرادیان تحلیلی و عددی را توضیح دهید.
- تمرین ۸ ـ مشتق جهتی: تابع Gradient Checking را بهگونهای توسعه دهید که علاوه بر بررسی تمام پارامترها، ۱۰ جهت تصادفی مستقل را نیز آزمون کند.
پاسخ تشریحی منتخب: تمرین ۲
تابع:
ابتدا عبارت میانی را تعریف میکنیم:
در نقطه دادهشده:
پس:
- گرادیان نسبت به w₁:
- گرادیان نسبت به w₂:
- گرادیان نسبت به بایاس:
پس:
برای بررسی عددی وزن دوم با (h=0.01):
بنابراین:
با روش مشابه میتوان مشتق عددی وزن اول و بایاس را نیز برابر (-2) به دست آورد.
۹.۱۶. جمعبندی بخش نهم و پایان فصل
در این بخش، آموختیم که Gradient Checking ابزاری برای اعتبارسنجی محاسبات Backpropagation است، نه جایگزینی برای آن.
Backpropagation گرادیان تمام پارامترها را با استفاده از قاعده زنجیرهای و استفاده مجدد از محاسبات میانی به دست میآورد.
در مقابل، تفاضل محدود با ایجاد تغییر کوچک در پارامترها و مشاهده تغییر زیان، تخمینی مستقل از مشتق فراهم میکند.
مقایسه این دو نتیجه به شناسایی خطاهایی مانند مشتق نادرست فعالسازی، فراموشکردن میانگینگیری، خطای اندیسگذاری و انتقال اشتباه گرادیان کمک میکند.
| ویژگی | Backpropagation | تفاضل محدود مرکزی |
| نوع مشتق | تحلیلی با محاسبات عددی | تقریب عددی |
| مبنای محاسبه | قاعده زنجیرهای | تغییر تابع زیان |
| هزینه برای کل گرادیان | کارآمد | پرهزینه |
| نیاز به مشتق عملیات داخلی | دارد | ندارد |
| کاربرد اصلی | آموزش مدل | آزمون صحت گرادیان |
| حساسیت به اندازه (h) | ندارد | دارد |
| رفتار در نقاط غیرقابلمشتق | وابسته به قرارداد مشتق | ممکن است با قرارداد متفاوت باشد |
منابع علمی
Baydin, A. G., Pearlmutter, B. A., Radul, A. A., & Siskind, J. M. (2018). Automatic differentiation in machine learning: A survey. Journal of Machine Learning Research, 18(153), 1–43.
Burden, R. L., & Faires, J. D. (2011). Numerical analysis (9th ed.). Brooks/Cole.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press.
Griewank, A., & Walther, A. (2008). Evaluating derivatives: Principles and techniques of algorithmic differentiation (2nd ed.). SIAM.
Higham, N. J. (2002). Accuracy and stability of numerical algorithms (2nd ed.). SIAM. Nocedal, J., & Wright, S. J. (2006). Numerical optimization (2nd ed.). Springer.