1.7.تجزیه ماتریسهاMatrix Decompositions
1.7.1.چرا به تجزیه ماتریس نیاز داریم؟
ماتریسها یکی از اصلیترین ساختارهای محاسباتی در یادگیری عمیق هستند.
در یک شبکه عصبی، ماتریسها برای نمایش موارد زیر استفاده میشوند:
- وزنهای شبکه
- تبدیل ویژگیها
- نمایش دادهها
- ارتباط بین لایهها
یک شبکه عمیق ممکن است شامل میلیونها یا میلیاردها پارامتر باشد که به شکل ماتریس ذخیره میشوند.
برای مثال:
اما کار مستقیم با این ماتریسها همیشه ساده نیست.
بنابراین یک ایده مهم مطرح میشود:
آیا میتوان یک ماتریس پیچیده را به چند ماتریس سادهتر تبدیل کرد؟
پاسخ مثبت است.
این فرآیند را:
یا تجزیه ماتریس مینامیم.
1.7.2.مفهوم کلی تجزیه ماتریس
هدف تجزیه ماتریس تبدیل:
به چند ماتریس سادهتر است:
یا:
که در آن:
- A: ماتریس اصلی
- B,C,D: اجزای سادهتر
هستند.
مزایای تجزیه ماتریس:
- کاهش هزینه محاسباتی
- حل سریعتر سیستمهای خطی
- کاهش حافظه موردنیاز
- تحلیل ساختار داده
- استخراج ویژگیهای مهم
1.7.3.تجزیه LU
LU Decomposition
یکی از قدیمیترین و مهمترین روشهای تجزیه ماتریس است.
در این روش یک ماتریس به حاصلضرب دو ماتریس تبدیل میشود:
که:
- L: ماتریس مثلثی پایین (Lower Triangular Matrix)
- U: ماتریس مثلثی بالا (Upper Triangular Matrix)
است.
ماتریس مثلثی پایین
شکل کلی:
تمام عناصر بالای قطر اصلی صفر هستند.
ماتریس مثلثی بالا
تمام عناصر پایین قطر اصلی صفر هستند.
1.7.4.مثال تجزیه LU
فرض کنید:
میتوان آن را به شکل:
نوشت.
مثلاً:
و:
داریم:
بنابراین:
که همان ماتریس اولیه است.
1.7.5.کاربرد LU در یادگیری ماشین
اگر بخواهیم دستگاه:
را حل کنیم، با LU میتوانیم آن را به دو مرحله تقسیم کنیم:
ابتدا:
سپس:
این کار از نظر محاسباتی بسیار سریعتر از محاسبه مستقیم معکوس ماتریس است.
1.7.6.تجزیه QR
QR Decomposition
در تجزیه QR:
که:
- Q: ماتریس متعامد (Orthogonal Matrix)
- R: ماتریس مثلثی بالا
است.
ویژگی ماتریس Q
یک ماتریس متعامد دارای ویژگی زیر است:
یعنی:
1.7.7.مفهوم هندسی QR
ماتریس:
یک تغییر جهت بدون تغییر اندازه ایجاد میکند.
یعنی:
بنابراین طول بردار حفظ میشود.
ماتریس:
میزان کشیدگی و ترکیب خطی را مشخص میکند.
1.7.8.کاربرد QR در یادگیری عمیق
QR در موارد زیر استفاده میشود:
1. حل مسائل کمترین مربعات
در بسیاری از مسائل یادگیری ماشین هدف یافتن:
است.
QR یک روش پایدار برای حل این مسئله است.
2. تحلیل وزنهای شبکه
ماتریسهای وزن را میتوان با QR بررسی کرد تا:
- وابستگی ویژگیها
- ساختار فضای وزن
- پایداری
تحلیل شود.
1.7.9.تجزیه چولسکیCholesky Decomposition
این تجزیه برای ماتریسهای خاص استفاده میشود.
اگر ماتریس:
متقارن و مثبت معین باشد:
میتوان نوشت:
که:
- L: ماتریس مثلثی پایین
است.
مثال کاربردی
ماتریس کوواریانس در آمار:
معمولاً:
است.
بنابراین میتوان نوشت:
1.7.10.ارتباط تجزیه ماتریس با شبکههای عصبی
در شبکه عصبی:
ماتریس وزن:
معمولاً بسیار بزرگ است.
مثلاً:
یعنی:
100,000,000
پارامتر.
اما ممکن است این ماتریس دارای ساختار پنهان باشد.
مثلاً:
که:
و
باشد.
تعداد پارامتر جدید:
10000(100)+100(10000)
برابر:
2,000,000
است.
در حالی که حالت اولیه:
100,000,000
پارامتر داشت.
این ایده پایه روشهای:
- Low Rank Approximation
- Model Compression
- LoRA
است.
1.7.11.ارتباط با مدلهای زبانی بزرگ
در مدلهای بزرگ مانند Transformer، ماتریسهای زیر بسیار بزرگ هستند:
که در Attention استفاده میشوند.
مثلاً:
تجزیه ماتریس کمک میکند:
- حجم مدل کاهش یابد.
- آموزش سریعتر شود.
- حافظه کمتر مصرف شود.
1.7.12.مقایسه روشهای تجزیه ماتریس
| روش | تجزیه | کاربرد اصلی |
| LU | A=LU | حل دستگاه خطی |
| QR | A=QR | کمترین مربعات و پایداری |
| Cholesky | A=LL^T | ماتریس کوواریانس |
| SVD | A = ΣU^T | کاهش بعد و فشردهسازی |
جمعبندی بخش 1.7
در این بخش یاد گرفتیم:
- ماتریسهای بزرگ را میتوان به اجزای سادهتر تقسیم کرد.
- LU برای حل دستگاههای خطی استفاده میشود.
- QR ساختار هندسی ماتریس را تحلیل میکند.
- Cholesky برای ماتریسهای کوواریانس مهم است.
- تجزیه ماتریس پایه بسیاری از روشهای کاهش محاسبات در Deep Learning است.
1.8.تجزیه مقادیر منفردSingular Value Decomposition (SVD)
1.8.1.مقدمهای بر SVD
تجزیه مقادیر منفرد یا Singular Value Decomposition یکی از مهمترین ابزارهای جبر خطی در علوم داده، یادگیری ماشین و یادگیری عمیق است.
ایده اصلی SVD این است:
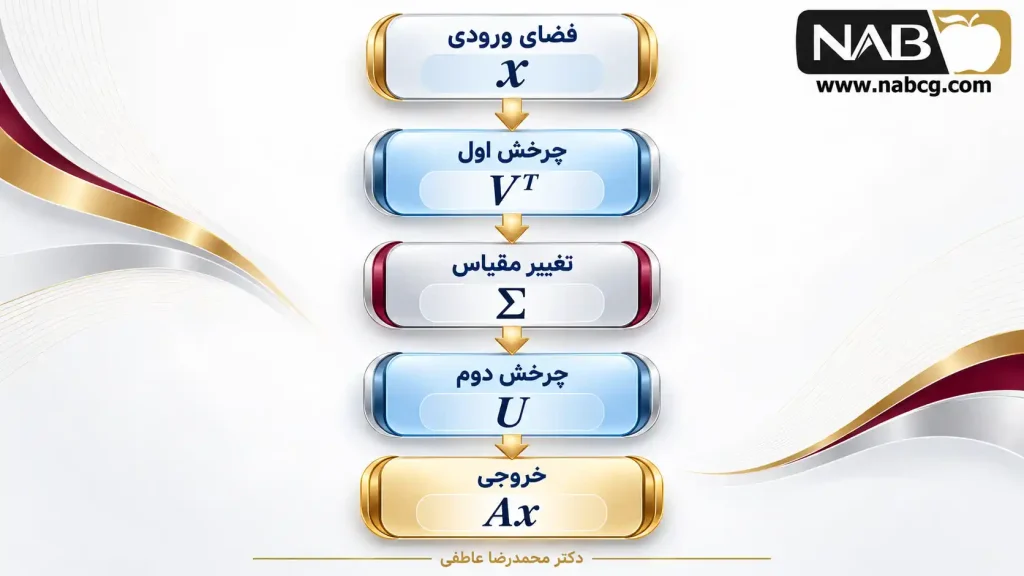
هر ماتریس را میتوان به سه تبدیل سادهتر تجزیه کرد: یک چرخش در فضای ورودی، یک تغییر مقیاس، و یک چرخش در فضای خروجی.
به صورت ریاضی:
که در آن:
- A: ماتریس اصلی
- U: ماتریس بردارهای منفرد چپ (Left Singular Vectors)
- Sigma: ماتریس مقادیر منفرد (Singular Values)
- V^T: ترانهاده ماتریس بردارهای منفرد راست (Right Singular Vectors)
است.
1.8.2.شهود هندسی SVD
یک تبدیل ماتریسی عمومی میتواند چند اتفاق را همزمان انجام دهد:
- چرخاندن فضا
- کشیدن یا فشرده کردن فضا
- چرخاندن دوباره فضا
SVD این فرآیند را جدا میکند.
یعنی:
به صورت مفهومی:
1.8.3.ساختار ماتریسهای SVD
فرض کنید:
باشد.
تجزیه SVD:
دارای ابعاد زیر است:
ماتریس:
Sigma
دارای ساختار قطری است:
که مقادیر:
مقادیر منفرد هستند.
1.8.4.مقادیر منفرد (Singular Values)
مقادیر منفرد مشخص میکنند هر جهت چقدر اهمیت دارد.
فرض کنید:
باشد.
یعنی:
- جهت اول بیشترین اطلاعات را حمل میکند.
- جهت دوم اهمیت کمتر دارد.
- جهت سوم ممکن است فقط نویز باشد.
به همین دلیل SVD ابزاری قدرتمند برای:
- کاهش ابعاد
- حذف نویز
- فشردهسازی داده
است.
1.8.5.ارتباط SVD با رتبه ماتریس
تعداد مقادیر منفرد غیرصفر، رتبه ماتریس را مشخص میکند.
یعنی:
اگر:
و:
باشد.
مثلاً:
دارای دو مقدار منفرد غیرصفر است.
پس:
1.8.6.تقریب کمرتبه (Low Rank Approximation)
یکی از مهمترین کاربردهای SVD این است که میتوان یک ماتریس بزرگ را با یک ماتریس کوچکتر تقریب زد.
فرض کنید:
باشد.
اگر فقط بزرگترین:
مقدار منفرد را نگه داریم:
یک تقریب کمرتبه از ماتریس خواهیم داشت.
هدف:حفظ بیشترین اطلاعات با کمترین پارامتر.
مثال مفهومی
فرض کنید یک ماتریس تصویر داریم:
تعداد پارامترها:
1,000,000
است.
اما بعد از SVD:
ممکن است فقط ۵۰ مؤلفه اصلی لازم باشد.
1.8.7.ارتباط SVD با فشردهسازی تصاویر
تصویر دیجیتال یک ماتریس است:
A
که هر عنصر شدت روشنایی یک پیکسل است.
با SVD:
میتوان مؤلفههای کماهمیت را حذف کرد.
مثلاً:
قبل:
مقدار
بعد:
مقدار
حافظه بسیار کمتر میشود.
1.8.8. SVD و کاهش پارامترهای شبکه عصبی
در شبکههای عمیق، وزن یک لایه معمولاً یک ماتریس است:
برای مثال:
تعداد پارامترها:
یعنی:
پارامتر.
با SVD:
میتوان آن را به چند ماتریس کوچک تبدیل کرد.
به جای:
mn
پارامتر،
داریم:
r(m+n)
پارامتر.
که:
r<<min(m,n)
است.
1.8.9.کاربرد SVD در شبکههای Transformer
در معماری Transformer، ماتریسهای بزرگی وجود دارند:
برای مثال:
این ماتریسها بخش بزرگی از پارامترهای مدل را تشکیل میدهند.
روشهای مبتنی بر SVD میتوانند:
- وزنها را کمرتبه کنند.
- حجم مدل را کاهش دهند.
- سرعت inference را افزایش دهند.
1.8.11. SVD و LoRA
یکی از کاربردهای مدرن SVD در مدلهای زبانی بزرگ، ایده آموزش کمپارامتر است.
در LoRA به جای تغییر مستقیم:
W
یک تغییر کمرتبه اضافه میشود:
که:
است.
در نتیجه:
و:
با:
مزیت:
- پارامترهای کمتر
- آموزش سریعتر
- حافظه کمتر
1.8.11.ارتباط SVD با سیستمهای توصیهگر
یکی از کاربردهای کلاسیک SVD در Recommendation Systems است.
فرض کنید ماتریس تعامل کاربر-کالا داریم:
که:
امتیاز کاربر i به محصول j است.
این ماتریس معمولاً بسیار بزرگ و پراکنده است.
SVD آن را به شکل زیر تجزیه میکند:
که:
- Uk: نمایش کاربران
- Vk: نمایش کالاها
است.
مثلاً یک عامل پنهان میتواند نشاندهنده:
- سبک ورزشی
- قیمت بالا
- علاقه به تکنولوژی
باشد.
1.8.12.تفاوت Eigenvalue و SVD
این دو مفهوم بسیار مرتبط هستند اما یکسان نیستند.
| ویژگی | Eigenvalue | SVD |
| ورودی | ماتریس مربعی | هر ماتریسی |
| فرمول | Av = λv | A = U Σ V^T |
| کاربرد اصلی | تحلیل تبدیل | تجزیه عمومی |
| PCA | مستقیم | غیرمستقیم |
| شبکه عصبی | تحلیل پایداری | فشردهسازی وزن |
جمعبندی بخش 1.8
در این بخش یاد گرفتیم:
- SVD یکی از مهمترین تجزیههای ماتریسی است.
- هر ماتریس را میتوان به سه بخش:
تقسیم کرد.
- مقادیر منفرد اهمیت اطلاعاتی هر جهت را نشان میدهند.
- حذف مقادیر کوچک باعث کاهش بعد و فشردهسازی میشود.
- SVD در موارد زیر کاربرد دارد:
- PCA
- Compression
- Recommendation System
- Transformer
- LoRA
- Model Optimization
1.9.کاهش بُعد و تحلیل مؤلفههای اصلی(Dimensionality Reduction and Principal Component Analysis (PCA)
1.9.1.مقدمهای بر کاهش بُعد
در بسیاری از مسائل یادگیری ماشین، دادهها دارای تعداد بسیار زیادی ویژگی هستند.
برای مثال:
| نوع داده | تعداد ابعاد احتمالی |
| تصویر HD | میلیونها پیکسل |
| متن در فضای embedding | هزاران بعد |
| ژنوم انسانی | دهها هزار ویژگی |
| رفتار کاربر | صدها یا هزاران ویژگی |
اگرچه افزایش تعداد ویژگیها میتواند اطلاعات بیشتری فراهم کند، اما همیشه باعث بهبود مدل نمیشود.
این مسئله به یکی از چالشهای اساسی یادگیری ماشین منجر میشود:
1.9.2.نفرین ابعاد (Curse of Dimensionality)
با افزایش تعداد ابعاد، فضای داده بسیار بزرگ میشود.
فرض کنید دادهها در یک فضای یکبعدی قرار دارند:
برای پوشش فضای داده، تعداد کمی نمونه کافی است.
اما اگر:
باشد، فضای ممکن به شدت افزایش مییابد.
نتیجه:
- فاصله بین نقاط افزایش مییابد.
- دادهها پراکندهتر میشوند.
- نیاز به نمونههای بسیار بیشتری داریم.
- یادگیری الگوها سختتر میشود.
مثال شهودی
فرض کنید میخواهیم فضای یک مکعب را با نقاط پر کنیم.
در یک بعد:
10
نقطه کافی است.
در دو بعد:
نقطه لازم است.
در سه بعد:
نقطه لازم است.
در صد بعد:
نقطه نیاز است.
بنابراین یکی از اهداف مهم یادگیری ماشین:
یافتن نمایش کمبعدتر که همچنان اطلاعات مهم را حفظ کند.
1.9.3. مفهوم کاهش بُعد(Dimensionality Reduction)
کاهش بعد یعنی تبدیل داده از فضای بزرگتر به فضای کوچکتر:
که:
است.
مثلاً:
داده اولیه:
پس از کاهش بعد:
اما هدف این نیست که فقط تعداد ابعاد کم شود.
هدف اصلی:
حفظ بیشترین اطلاعات ممکن.
1.9.4.انواع روشهای کاهش بعد
روشهای کاهش بعد به دو دسته کلی تقسیم میشوند:
1. روشهای خطی
مانند:
- PCA
- SVD
- Linear Discriminant Analysis
2. روشهای غیرخطی
مانند:
- t-SNE
- UMAP
- Autoencoder
در این فصل تمرکز اصلی بر PCA است، زیرا پایه بسیاری از روشهای مدرن یادگیری عمیق است.
1.9.5.تحلیل مؤلفههای اصلیPrincipal Component Analysis (PCA)
PCA یکی از مهمترین روشهای کاهش بعد است.
ایده اصلی PCA:
یافتن جهتهایی در فضای داده که بیشترین تغییرات و بیشترین اطلاعات را نگه میدارند.
فرض کنید دادهها:
باشند.
هدف یافتن یک فضای جدید است:
که:
- ابعاد کمتر دارد.
- اطلاعات مهم را حفظ میکند.
1.9.6.مرحله اول PCA: مرکز کردن دادهها
ابتدا میانگین هر ویژگی محاسبه میشود:
سپس دادهها مرکز میشوند:
هدف:
قرار دادن مرکز دادهها روی نقطه صفر.
1.9.7.مرحله دوم PCA: محاسبه ماتریس کوواریانس
ماتریس کوواریانس نشان میدهد ویژگیها چگونه با یکدیگر تغییر میکنند.
فرمول:
که:
C
یک ماتریس:
است.
مثلاً اگر سه ویژگی داشته باشیم:
1.9.8. مرحله سوم PCA: محاسبه بردارهای ویژه
در PCA، بردارهای ویژه ماتریس کوواریانس محاسبه میشوند:
که:
- v: جهتهای اصلی داده
- λ: میزان اهمیت هر جهت
است.
مقدار ویژه بزرگتر:
یعنی:
اطلاعات بیشتری در آن جهت وجود دارد.
1.9.9.مرحله چهارم PCA: انتخاب مؤلفههای اصلی
فرض کنید Eigenvalueها:
باشند.
کل اطلاعات:
نسبت واریانس:
بنابراین:
مؤلفه اول:
اطلاعات را نگه میدارد.
دو مؤلفه اول:
95\%
اطلاعات را حفظ میکنند.
پس میتوان چهار بعد را به دو بعد کاهش داد.
1.9.10.ارتباط PCA و SVD
PCA را میتوان با SVD نیز محاسبه کرد.
اگر:
باشد، مؤلفههای اصلی از ستونهای:
V
به دست میآیند.
ارتباط مهم:
و بردارهای ویژه کوواریانس همان بردارهای منفرد SVD هستند.
بنابراین:
یک زنجیره بنیادی در جبر خطی یادگیری ماشین است.
1.9.11. کاربرد PCA در یادگیری عمیق
اگرچه شبکههای عمیق معمولاً خودشان ویژگی استخراج میکنند، PCA هنوز کاربردهای مهمی دارد.
1. تجسم فضای ویژگی
شبکههای عمیق ممکن است بردارهایی با صدها بعد تولید کنند:
برای نمایش دو بعدی:
میتوان از PCA استفاده کرد.
2. حذف نویز
برخی مؤلفهها دارای مقدار ویژه کوچک هستند.
این مؤلفهها معمولاً اطلاعات کم یا نویز هستند.
با حذف آنها:
به دست میآید.
3. پیشپردازش داده
در برخی پروژهها قبل از آموزش مدل:
انجام میشود.
مزایا:
- کاهش زمان آموزش
- کاهش حافظه
- حذف ویژگیهای زائد
1.9.12. ارتباط PCA با Autoencoder
Autoencoder یک شبکه عصبی برای کاهش بعد است.
ساختار:
در PCA:
تبدیل:
خطی است.
اما Autoencoder میتواند:
Z=f(X)
را به صورت غیرخطی یاد بگیرد.
بنابراین:
PCA:
Autoencoder:
1.9.13. PCA در سیستمهای توصیهگر
در سیستمهای توصیهگر، ماتریس تعامل کاربر-کالا:
R
معمولاً بسیار بزرگ است.
مثلاً:
PCA یا روشهای مرتبط میتوانند عوامل پنهان را استخراج کنند:
که در آن:
- ویژگیهای پنهان کاربران
- ویژگیهای پنهان کالاها
نمایش داده میشوند.
جمعبندی بخش 1.9
| مفهوم | نقش |
| Curse of Dimensionality | مشکل فضای بسیار بزرگ |
| Dimensionality Reduction | کاهش ابعاد با حفظ اطلاعات |
| PCA | یافتن جهتهای مهم داده |
| Eigenvector | جهت مؤلفه اصلی |
| Eigenvalue | اهمیت مؤلفه |
| SVD | روش محاسباتی PCA |
| Autoencoder | کاهش بعد غیرخطی |
نکته کلیدی
کاهش بعد به معنی حذف ساده اطلاعات نیست؛ بلکه یافتن یک نمایش جدید است که اطلاعات مهم داده را در فضای کوچکتر نگه میدارد.
این ایده یکی از پایههای اصلی یادگیری عمیق است، زیرا شبکههای عصبی نیز در هر لایه در حال یادگیری نمایشهای جدید و فشردهتر از داده هستند.
1.10.کاربرد جبر خطی در شبکههای عصبی عمیق(Linear Algebra Applications in Deep Neural Networks)
1.10.1.مقدمه: شبکه عصبی به عنوان یک سیستم جبر خطی
تا این مرحله، مفاهیم اصلی جبر خطی را بررسی کردیم:
- بردارها
- ماتریسها
- فضاهای برداری
- استقلال خطی
- رتبه
- نرمها
- مقادیر ویژه
- تجزیه ماتریس
- SVD
- PCA
اکنون باید ببینیم این مفاهیم چگونه در قلب شبکههای عصبی استفاده میشوند.
یک دیدگاه بنیادی در یادگیری عمیق وجود دارد:
هر لایه شبکه عصبی یک تبدیل ریاضی است که داده را از یک فضای برداری به فضای برداری جدید منتقل میکند.
به صورت کلی:
که در آن:
- x: بردار ورودی
- W: ماتریس وزنها
- b: بردار بایاس
- f: تابع فعالسازی
- h: نمایش جدید داده
است.
1.10.2.نورون مصنوعی به عنوان یک عملگر برداری
سادهترین واحد شبکه عصبی، نورون مصنوعی است.
یک نورون چند ورودی دریافت میکند:
و برای هر ورودی یک وزن دارد:
محاسبه نورون:
است.
باز کردن رابطه:
یعنی نورون در واقع یک ضرب داخلی انجام میدهد.
تفسیر هندسی
ضرب داخلی:
اندازهای از میزان همجهتی بین:
- ورودی
- وزنها
است.
اگر:
بزرگ باشد، ورودی با الگوی یادگرفتهشده نورون شباهت دارد.
1.10.3.یک لایه شبکه عصبی به عنوان تبدیل ماتریسی
یک نورون فقط یک خروجی تولید میکند.
اما یک لایه شبکه عصبی معمولاً صدها یا هزاران نورون دارد.
فرض کنید:
ورودی:
و لایه دارای:
m
نورون باشد.
وزنها:
خواهند بود.
خروجی قبل از فعالسازی:
است.
مثال:
فرض کنید:
(تصویر MNIST)
و لایه اول:
128
نورون دارد.
پس:
خواهد بود.
خروجی:
است.
یعنی شبکه تصویر ۷۸۴ بعدی را به یک فضای ویژگی ۱۲۸ بعدی منتقل کرده است.
1.10.4.شبکه عصبی به عنوان زنجیرهای از تبدیلهای خطی و غیرخطی
یک شبکه چندلایه:
x
را از چندین فضای مختلف عبور میدهد.
مثلاً:
اگر توابع فعالسازی حذف شوند:
خواهیم داشت.
یعنی کل شبکه فقط یک تبدیل خطی خواهد بود.
بنابراین نقش تابع فعالسازی بسیار مهم است.
زیرا:
اما:
قدرت نمایش بسیار بیشتری ایجاد میکند.
1.10.5. جبر خطی در شبکههای کانولوشنی (CNN)
شبکههای CNN برای پردازش تصویر طراحی شدهاند.
تصویر یک تانسور است:
که:
- H: ارتفاع
- W: عرض
- C: تعداد کانالها
است.
مثلاً یک تصویر RGB
دارد.
عملیات کانولوشن از دید جبر خطی
فیلتر CNN:
K
نیز یک ماتریس کوچک است.
مثلاً:
عملیات کانولوشن در واقع مجموعهای از ضربهای داخلی است:
یعنی CNN دائماً در حال انجام:
است.
1.10.6. تبدیل کانولوشن به ضرب ماتریسی
یکی از مفاهیم مهم در پیادهسازی CNN، تبدیل کانولوشن به ضرب ماتریسی است.
با روش:
im2col
میتوان تصویر را به ماتریس تبدیل کرد.
سپس:
Y=XW
محاسبه میشود.
این موضوع نشان میدهد که حتی CNN نیز در نهایت به جبر خطی وابسته است.
1.10.7.جبر خطی در شبکههای Transformer
مدلهای Transformer یکی از مهمترین معماریهای هوش مصنوعی مدرن هستند.
قلب Transformer مکانیزم:
Attention
است.
Attention به زبان جبر خطی
سه ماتریس اصلی داریم:
Query
Key
Value
سپس:
تمام اجزای این رابطه:
- ضرب ماتریسی
- ترانهاده
- مقیاسبندی
- جمع برداری
هستند.
1.10.8.تفسیر هندسی Attention
ماتریس:
شباهت بین بردارهای مختلف را محاسبه میکند.
اگر:
بزرگ باشد:
یعنی Query و Key مشابه هستند.
بنابراین Attention در اصل:
محاسبه شباهت بین بردارها در یک فضای ویژگی است.
1.10.9. جبر خطی در Embeddingها
یکی از مهمترین کاربردهای جبر خطی در هوش مصنوعی، تبدیل مفاهیم به بردار است.
مثلاً:
کلمه:
“king”
به یک بردار تبدیل میشود:
مدل تلاش میکند روابط معنایی را در فضای برداری یاد بگیرد.
مثلاً:
این رابطه یک عملیات برداری است.
1.10.10. جبر خطی در سیستمهای توصیهگر
در سیستمهای توصیهگر، کاربران و کالاها به بردار تبدیل میشوند.
کاربر:
کالا:
امتیاز پیشبینیشده:
است.
اگر شباهت کاربر و کالا زیاد باشد:
بزرگتر خواهد بود.
این همان ایدهای است که در:
- Netflix
- Amazon
- سیستمهای پیشنهاد محتوا
استفاده میشود.
1.10.11. جبر خطی در شبکههای گرافی (GNN)
در Graph Neural Network دادهها به شکل گراف نمایش داده میشوند:
G=(V,E)
که:
- V: گرهها
- E: یالها
هستند.
ماتریس مجاورت:
A
روابط بین گرهها را نشان میدهد.
عملیات اصلی GNN:
است.
که در آن:
- A: ساختار گراف
- H: ویژگی گرهها
- : وزن شبکه
است.
یعنی حتی یادگیری روی گراف نیز با جبر خطی انجام میشود.
1.10.12. جبر خطی و فرآیند یادگیری
در آموزش شبکه عصبی، هدف پیدا کردن وزنها است.
تابع هزینه:
J(W)
داریم.
وزنها بهروزرسانی میشوند:
که:
- η: نرخ یادگیری
- ΔWJ(W): گرادیان نسبت به وزنها
است.
گرادیان نیز یک ساختار برداری/ماتریسی است.
بنابراین:
- Forward Pass
- Backpropagation
- Optimization
همگی بر پایه جبر خطی هستند.
جمعبندی نهایی
در این فصل مشاهده کردیم که جبر خطی فقط یک ابزار ریاضی مقدماتی نیست؛ بلکه زبان اصلی یادگیری عمیق است.
| مفهوم جبر خطی | کاربرد در Deep Learning |
| بردار | نمایش داده و ویژگی |
| ماتریس | وزن شبکه و تبدیل ویژگی |
| ضرب داخلی | فعالیت نورون |
| تبدیل خطی | عملکرد لایهها |
| Norm | کنترل وزن و فاصله |
| Eigenvalue | تحلیل ساختار داده |
| SVD | فشردهسازی مدل |
| PCA | کاهش بعد |
| تانسور | نمایش دادههای پیچیده |
| Matrix Multiplication | هسته محاسبات شبکه |
پیام اصلی فصل
شبکههای عصبی در ظاهر مدلهایی الهامگرفته از مغز هستند، اما در سطح محاسباتی، ماشینهایی برای انجام تبدیلهای جبر خطی پیچیده هستند که با دادهها یاد میگیرند چگونه بهترین فضای نمایش را ایجاد کنند.