1.1.چرا جبر خطی زبان ریاضی شبکههای عصبی است؟
مقدمه
یادگیری عمیق در ظاهر درباره ساختارهایی مانند:
- نورون مصنوعی
- شبکه چندلایه
- کانولوشن
- Transformer
- شبکههای گرافی
است، اما در سطح محاسباتی، تقریباً تمام این معماریها بر یک زبان مشترک بنا شدهاند:
جبر خطی (Linear Algebra)
شبکه عصبی بدون جبر خطی قابل تصور نیست؛ زیرا تمام مراحل اصلی یادگیری عمیق شامل تبدیل دادهها در فضاهای برداری است.
یک شبکه عصبی ورودی را دریافت میکند، آن را به یک نمایش عددی تبدیل میکند، این نمایش را در لایههای مختلف تغییر میدهد و در نهایت یک خروجی تولید میکند.
تمام این فرآیند به صورت زنجیرهای از عملیات زیر بیان میشود:
که در آن:
- x بردار ورودی
- W ماتریس وزنها
- b بردار بایاس
- f تابع فعالسازی
است.
بنابراین یک شبکه عصبی در سادهترین نگاه، مجموعهای از تبدیلهای ماتریسی به همراه توابع غیرخطی است.
1.1.1. دادهها چگونه به زبان جبر خطی تبدیل میشوند؟
کامپیوتر نمیتواند مفاهیمی مانند:
- تصویر
- متن
- صدا
- رفتار کاربر
- معنی یک جمله
را مستقیماً درک کند.
تمام اطلاعات باید به مجموعهای از اعداد تبدیل شوند.
این نمایش عددی معمولاً یک بردار (Vector) است.
مثال: نمایش یک تصویر
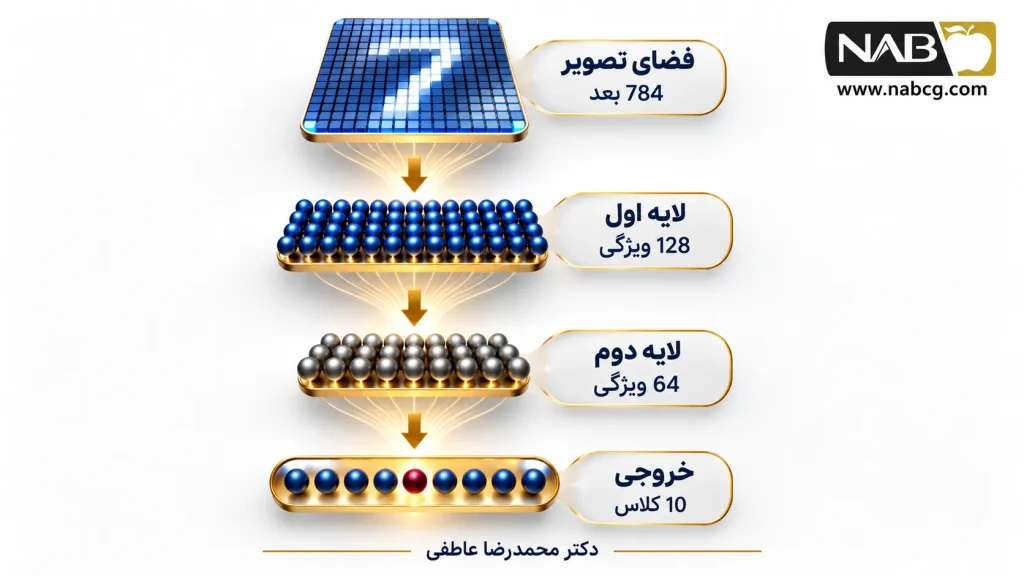
فرض کنید یک تصویر سیاهوسفید با ابعاد:
پیکسل داریم.
این تصویر شامل:
عدد است.
میتوانیم آن را به شکل یک بردار بنویسیم:
بنابراین:
یعنی تصویر در یک فضای ۷۸۴ بعدی قرار گرفته است.
مفهوم فضای ویژگی (Feature Space)
در یادگیری ماشین، دادهها معمولاً در یک فضای ریاضی قرار میگیرند.
برای مثال:
| داده | فضای نمایش |
| تصویر | فضای پیکسل |
| متن | فضای embedding |
| صدا | فضای ویژگی صوتی |
| کاربر | فضای رفتار |
| کالا | فضای ویژگی محصول |
شبکه عصبی تلاش میکند این فضاها را به نمایشهایی تبدیل کند که اطلاعات مهم را بهتر آشکار کنند.
1.1.2.شبکه عصبی به عنوان یک تبدیل خطی
یک نورون مصنوعی ساده را در نظر بگیرید.
ورودی:
وزنها:
نورون ابتدا حاصل جمع وزندار را محاسبه میکند:
این رابطه همان ضرب داخلی دو بردار است:
این اولین ارتباط مستقیم بین شبکه عصبی و جبر خطی است.
1.1.3.چرا ماتریسها در شبکه عصبی ضروری هستند؟
فرض کنید یک شبکه دارای:
- 1000 نمونه ورودی
- 784 ویژگی
باشد.
به جای محاسبه تکتک نورونها، دادهها به صورت ماتریسی ذخیره میشوند.
ماتریس داده:
ابعاد:
که:
- m تعداد نمونهها
- n تعداد ویژگیها
وزنهای یک لایه:
خروجی:
این عملیات پایه تقریباً تمام شبکههای عصبی است.
1.2. فضای برداری؛ محیط زندگی دادههای هوشمند
1.2.1. تعریف بردار
یک بردار مجموعهای مرتب از اعداد است:
این بردار یک نقطه در فضای سهبعدی را نشان میدهد.
عملیات اصلی روی بردارها
- جمع بردارها
- ضرب اسکالر
- ضرب داخلی
مثلاً:
پس:
تفسیر در یادگیری عمیق
ضرب داخلی میزان شباهت دو بردار را اندازه میگیرد.
برای همین در:
- سیستم توصیهگر
- موتور جستجو
- مدلهای زبانی
- embedding
استفاده میشود.
1.2.2.ماتریسها؛ ابزار اصلی تبدیل ویژگیها
ماتریس مجموعهای از اعداد در قالب سطر و ستون است:
اما در یادگیری عمیق، ماتریس فقط یک جدول عددی نیست.
یک ماتریس نشاندهنده:
- تبدیل
- وزن
- ارتباط
- نگاشت بین فضاها
است.
مثال شبکه عصبی
فرض کنید:
ورودی:
داریم.
یک لایه:
ابعاد:
خروجی:
یک بردار دو بعدی خواهد بود.
یعنی شبکه:
فضای ۳ بعدی را به فضای ۲ بعدی منتقل کرده است.
نکته مهم
هر لایه شبکه عصبی را میتوان به صورت یک نگاشت بین فضاهای مختلف دید:
مثلاً:
تمرین مفهومی فصل
- سؤال 1
چرا میتوان گفت شبکه عصبی یک مدل جبر خطی + غیرخطی است؟
- سؤال 2
اگر یک تصویر 32×32 RGB داشته باشیم، چند ویژگی اولیه دارد؟
- سؤال 3
در رابطه:
1.3 دستگاههای خطی (Linear Systems)
1.3.1 مسئله بنیادی دستگاههای خطی
یکی از مهمترین مسائل در ریاضیات و علوم مهندسی، یافتن مقادیر مجهول در مجموعهای از روابط است.
فرض کنید سه متغیر مجهول داریم:
x1 , x2 , x3
و سه رابطه خطی:
هدف، یافتن مقادیری است که هر سه معادله را همزمان ارضا کنند.
این مجموعه از معادلات یک دستگاه خطی نامیده میشود.
1.3.2.نمایش ماتریسی دستگاه خطی
در جبر خطی، به جای نوشتن تکتک معادلات، تمام سیستم را در قالب یک رابطه فشرده نمایش میدهیم:
که در آن:
ماتریس ضرایب:
بردار مجهولات:
بردار خروجی:
بنابراین:
1.3.3.دیدگاه هندسی دستگاه خطی
یک دستگاه خطی را میتوان از دید هندسی نیز بررسی کرد.
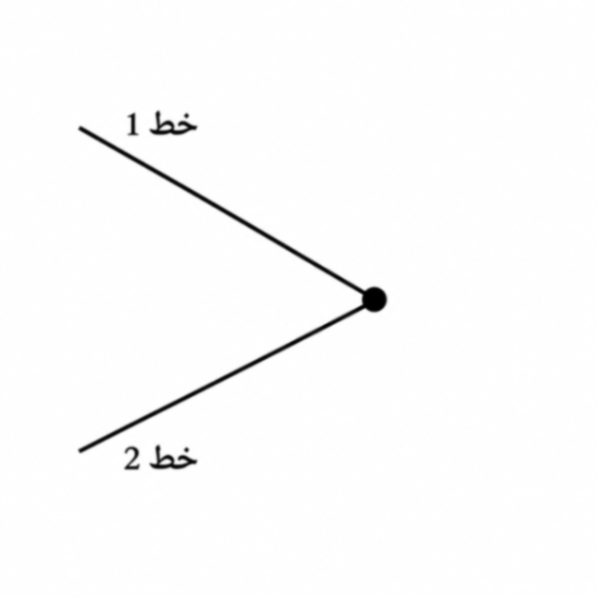
در فضای دو بعدی:
یک خط را تشکیل میدهد.
در فضای سه بعدی:
یک صفحه ایجاد میکند.
بنابراین حل دستگاه خطی یعنی یافتن نقطهای که تمام محدودیتها را همزمان برآورده کند.
حالتهای ممکن جواب
یک دستگاه خطی سه حالت دارد:
1- جواب یکتا (Unique Solution)
تمام معادلات در یک نقطه همدیگر را قطع میکنند.
2- بینهایت جواب
معادلات یک اطلاعات مشابه ارائه میکنند.
مثلاً:
و:
هر دو یک خط را نمایش میدهند.
3- بدون جواب
معادلات با هم سازگار نیستند.
مثلاً:
و:
1.3.4. حل دستگاههای خطی و ارتباط آن با یادگیری عمیق
در یادگیری عمیق، معمولاً هدف حل مستقیم:
نیست.
اما مفهوم تبدیل خطی بسیار مهم است.
هر لایه شبکه عصبی:
در واقع یک تبدیل خطی انجام میدهد.
ماتریس:
مشابه ماتریس ضرایب در دستگاه خطی است.
اما تفاوت مهم وجود دارد:
در دستگاههای خطی کلاسیک:
مشخص و ثابت است.
در شبکه عصبی:
پارامتری است که طی فرآیند آموزش یاد گرفته میشود.
1.3.5.یادگیری وزنها به عنوان یافتن بهترین تبدیل
فرض کنید داده آموزشی داریم:
و خروجیهای واقعی:
شبکه تلاش میکند ماتریسی پیدا کند که:
را ایجاد کند.
یعنی وزنها باید به گونهای تنظیم شوند که بهترین تبدیل بین ورودی و خروجی ساخته شود.
مثال ساده
فرض کنید:
ورودی:
وزن:
خروجی:
خواهد بود:
محاسبه:
عنصر اول:
عنصر دوم:
پس:
شبکه این تبدیل را هزاران یا میلیونها بار انجام میدهد تا وزن مناسب پیدا شود.
1.3.6. معکوس ماتریس و حل دستگاه
اگر ماتریس:
معکوس داشته باشد:
میتوان نوشت:
دو طرف را در:
ضرب میکنیم
و چون:
داریم:
اما در یادگیری عمیق معمولاً این روش استفاده نمیشود.
چرا؟
زیرا شبکههای عمیق دارای:
- میلیونها پارامتر
- ماتریسهای بسیار بزرگ
- دادههای عظیم
هستند.
محاسبه معکوس ماتریس بسیار پرهزینه است.
به همین دلیل از روشهای:
- Gradient Descent
- Adam
- SGD
استفاده میشود.
1.3.7. ارتباط دستگاههای خطی باBackpropagation
در آموزش شبکه عصبی:
ابتدا:
محاسبه میشود.
سپس خطا:
محاسبه میشود.
بعد گرادیان وزنها:
به دست میآید.
یعنی حتی مرحله آموزش نیز بر پایه محاسبات ماتریسی است.
جمعبندی بخش 1.3
در این بخش یاد گرفتیم:
- دستگاه خطی مجموعهای از روابط همزمان است.
- نمایش فشرده آن:
است.
- شبکه عصبی نیز از تبدیلهای خطی استفاده میکند:
- تفاوت اصلی این است که در شبکه عصبی، ماتریس وزنها یاد گرفته میشود.
- آموزش شبکه در واقع یافتن بهترین ماتریس تبدیل برای دادهها است.
1.4.استقلال خطی، رتبه و پایهLinear Independence, Rank and Basis
مقدمه
یکی از مهمترین پرسشها در یادگیری ماشین این است:
آیا ویژگیهایی که داریم واقعاً اطلاعات جدیدی اضافه میکنند یا فقط تکرار اطلاعات قبلی هستند؟
این پرسش مستقیماً با مفهوم استقلال خطی ارتباط دارد.
1.4.1.مفهوم استقلال خطی (Linear Independence)
یکی از بنیادیترین مفاهیم جبر خطی، مفهوم استقلال خطی است.
ایده اصلی:
مجموعهای از بردارها مستقل خطی هستند اگر هیچکدام از آنها را نتوان با ترکیب خطی سایر بردارها ساخت.
به بیان سادهتر:
اگر هر بردار اطلاعات جدیدی به مجموعه اضافه کند، آن بردار مستقل است.
فرض کنید چند بردار داریم:
این بردارها مستقل خطی هستند اگر تنها جواب معادله:
برابر باشد با:
یعنی هیچ ترکیب غیرصفر از بردارها نمیتواند بردار صفر ایجاد کند.
مثال هندسی
دو بردار زیر را در نظر بگیرید:
و:
این دو بردار مستقل هستند.
زیرا هیچ ضریبی از یکی نمیتواند دیگری را ایجاد کند.
آنها دو جهت مستقل در فضای دوبعدی ایجاد میکنند.
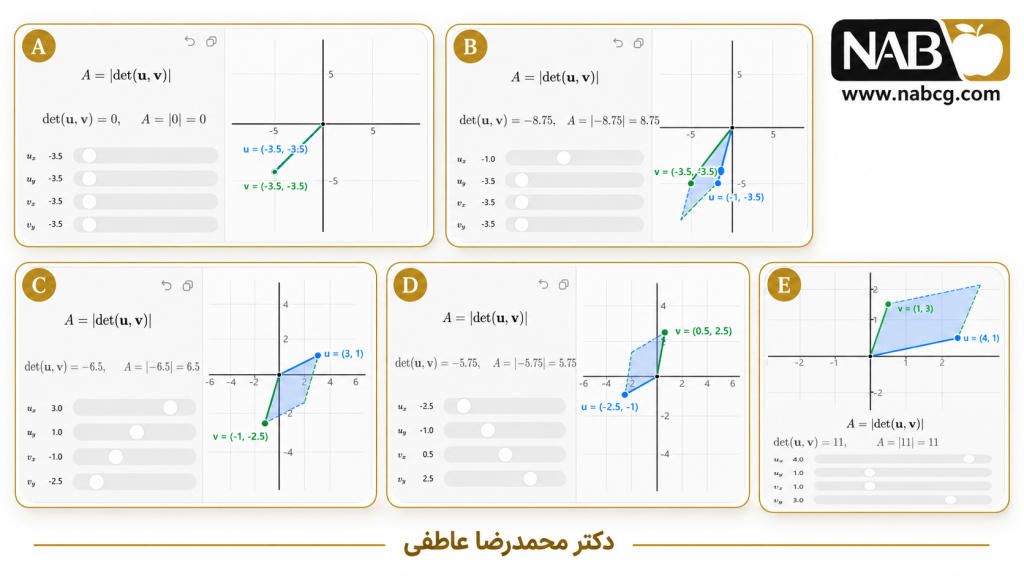
اما بردارهای زیر را ببینید:
مشاهده میکنیم:
بنابراین بردار دوم اطلاعات جدیدی اضافه نمیکند.
این دو بردار وابسته خطی هستند.
1.4.2.استقلال خطی در دادههای یادگیری ماشین
در یادگیری ماشین، ویژگیهای داده معمولاً به صورت بردار نمایش داده میشوند.
مثلاً برای پیشبینی قیمت خانه:
هر ویژگی یک بعد از فضای داده است.
اما ممکن است بعضی ویژگیها اطلاعات تکراری داشته باشند.
مثال
فرض کنید دو ویژگی داریم:
- ویژگی اول:
- ویژگی دوم:
حالا ویژگی دوم اطلاعات جدیدی ارائه نمیدهد.
از نظر ریاضی:
بنابراین:
وابسته خطی هستند.
چرا این موضوع مهم است؟
وجود ویژگیهای وابسته باعث مشکلاتی میشود:
1- افزایش تعداد پارامترها
مدل مجبور است وزنهایی را برای اطلاعات تکراری یاد بگیرد.
2-کاهش تفسیرپذیری
مشخص نیست کدام ویژگی واقعاً مهم است.
3- مشکل در بهینهسازی
وجود همبستگی شدید بین ویژگیها میتواند سطح خطا را پیچیدهتر کند.
در شبکههای عصبی عمیق، این مسئله با روشهایی مانند:
- Regularization
- Batch Normalization
- Representation Learning
تا حدی کنترل میشود.
1.4.3.مفهوم پایه (Basis)
بعد از مفهوم استقلال خطی، باید مفهوم پایه را درک کنیم.
پایه یعنی:
کوچکترین مجموعه بردارهای مستقل که بتوانند تمام فضای موردنظر را بسازند.
مثلاً در فضای دوبعدی:
دو بردار مستقل نیاز داریم:
و:
هر نقطه در این فضا را میتوان با ترکیب این دو ساخت:
مثلاً:
برابر است با:
1.4.4. پایه در یادگیری عمیق؛ مفهوم نمایش ویژگی
یکی از مهمترین ایدههای Deep Learning این است:
شبکه عصبی تلاش میکند یک پایه مناسب برای نمایش داده پیدا کند.
مثال:
یک تصویر خام ممکن است دارای:
بعد باشد.
اما همه این ابعاد برای تشخیص یک گربه لازم نیستند.
شبکه عصبی یاد میگیرد ویژگیهای مهم را استخراج کند:
که:
یک نمایش جدید است.
مثلاً:
فضای اولیه:
فضای ویژگی:
اما این ۱۲۸ ویژگی جدید ممکن است اطلاعات مهمتری از ۷۸۴ مقدار اولیه داشته باشند.
1.4.5.رتبه ماتریس (Matrix Rank)
رتبه یکی از مهمترین مفاهیم جبر خطی است.
تعریف:
رتبه یک ماتریس تعداد ابعاد مستقل اطلاعات موجود در آن ماتریس است.
اگر ماتریس:
داشته باشیم:
یعنی این ماتریس دارای:
جهت مستقل است.
مثال
ماتریس:
سطر دوم:
.سطر اول است.
پس فقط یک اطلاعات مستقل داریم:
اما:
دارای دو جهت مستقل است:
1.4.6.رتبه و ظرفیت اطلاعاتی شبکه عصبی
در شبکههای عصبی، رتبه ماتریس وزنها اهمیت زیادی دارد.
یک ماتریس وزن:
ممکن است:
باشد.
از نظر تعداد پارامتر:
یک میلیون مقدار دارد.
اما اگر:
باشد، یعنی اطلاعات واقعی کمتر از تعداد پارامترها است.
این ایده پایه روشهای زیر است:
- Low Rank Approximation
- Matrix Factorization
- LoRA در مدلهای زبانی بزرگ
1.4.7.ارتباط Rank با شبکههای عمیق بزرگ
مدلهای مدرن مانند:
- Transformer
- Large Language Models
دارای میلیاردها پارامتر هستند.
اما تحقیقات نشان دادهاند که بسیاری از ماتریسهای وزن دارای ساختار کمرتبه هستند.
یعنی:
به جای ذخیره مستقیم W.
مزایا:
- کاهش حافظه
- سرعت بالاتر
- آموزش کمهزینهتر
جمعبندی بخش 1.4
در این بخش یاد گرفتیم:
| مفهوم | معنی |
| استقلال خطی | هر بردار اطلاعات جدید اضافه میکند |
| وابستگی خطی | اطلاعات تکراری وجود دارد |
| پایه | مجموعهای برای ساخت کل فضا |
| رتبه | تعداد ابعاد مستقل اطلاعات |
| Rank پایین | نمایش فشرده داده |
ارتباط با یادگیری عمیق
شبکه عصبی:
- داده را به فضای جدید منتقل میکند.
- ویژگیهای مستقلتر استخراج میکند.
- نمایش کمبعد و غنی ایجاد میکند.
- از ساختارهای کمرتبه برای کاهش پیچیدگی استفاده میکند.
1.5.نرمها و فاصلههاNorms and Distances
1.5.1.چرا مفهوم اندازه در یادگیری عمیق مهم است؟
در فضای معمولی، اندازه یک شیء را بهسادگی میتوان اندازه گرفت.
مثلاً:
- طول یک خط
- فاصله دو نقطه
- اندازه یک جسم
اما در یادگیری ماشین، دادهها معمولاً در فضاهای بسیار بزرگ قرار دارند.
مثلاً:
- یک تصویر با میلیونها پیکسل
- یک جمله با هزاران ویژگی embedding
- یک کاربر با صدها ویژگی رفتاری
- یک مولکول با فضای ویژگی چندبعدی
بنابراین باید بتوانیم مفهوم:
- اندازه
- فاصله
- شباهت
را در فضای ریاضی تعریف کنیم.
این مفهوم با Norm و Distance بیان میشود.
1.5.2.مفهوم نرم (Norm)
نرم یک تابع ریاضی است که اندازه یک بردار را مشخص میکند.
برای یک بردار:
نرم آن را به یک عدد تبدیل میکند:
که نشاندهنده بزرگی بردار است.
یک نرم باید سه ویژگی اصلی داشته باشد:
ویژگی اول: مثبت بودن
اندازه هیچ برداری منفی نیست.
ویژگی دوم: صفر بودن فقط برای بردار صفر
تنها زمانی رخ میدهد که:
باشد.
ویژگی سوم: خاصیت همگنی
اگر بردار را در یک عدد ضرب کنیم:
اندازه نیز به همان نسبت تغییر میکند.
1.5.3.نرم L2 یا فاصله اقلیدسی
معروفترین نرم در یادگیری ماشین، نرم اقلیدسی یا L2 است.
فرمول:
این همان فاصلهای است که در هندسه معمولی استفاده میکنیم.
مثال
بردار:
داریم:
این همان قضیه فیثاغورس است.
کاربرد L2 در شبکه عصبی
1. اندازه وزنها
فرض کنید وزنهای شبکه:
باشند.
میتوانیم اندازه کل وزنها را با نرم L2 بسنجیم.
2. جلوگیری از بیشبرازش (Regularization)
در بسیاری از مدلها تابع هزینه به شکل زیر تغییر میکند:
که به آن:
گفته میشود.
ایده:
اگر وزنها خیلی بزرگ شوند، مدل بیش از حد به داده آموزشی وابسته میشود.
بنابراین جریمهای برای وزنهای بزرگ اضافه میکنیم.
1.5.4.نرم L1
نرم L1 به صورت زیر تعریف میشود:
مثال
پس:
تفاوت L1 و L2
| ویژگی | L1 | L2 |
| فرمول | جمع قدرمطلق | ریشه مجموع مربعها |
| اثر روی وزنها | صفر کردن برخی وزنها | کوچک کردن همه وزنها |
| ایجاد sparsity | زیاد | کم |
| کاربرد | انتخاب ویژگی | Regularization |
1.5.5.مفهوم فاصله (Distance)
نرم اندازه یک بردار را بیان میکند.
اما فاصله، رابطه بین دو نقطه را مشخص میکند.
برای دو بردار:
و:
فاصله اقلیدسی:
است.
مثال
دو نقطه:
اختلاف:
فاصله:
1.5.6.فاصله در فضای ویژگی شبکه عصبی
یکی از مهمترین کاربردهای نرمها در یادگیری عمیق، مقایسه نمایشهای داخلی شبکه است.
فرض کنید شبکه یک تصویر را به یک بردار ویژگی تبدیل کند:
تصویر A:
تصویر B:
اگر:
کوچک باشد، یعنی شبکه آنها را مشابه دیده است.
این مفهوم پایه بسیاری از مدلها است:
- Face Recognition
- Recommendation Systems
- Search Engines
- Contrastive Learning
1.5.7.شباهت کسینوسی (Cosine Similarity)
در بسیاری از کاربردهای هوش مصنوعی، فقط فاصله مهم نیست؛ جهت بردارها اهمیت دارد.
شباهت کسینوسی:
این مقدار بین:
تا:
قرار دارد.
تفسیر هندسی
اگر زاویه بین دو بردار:
صفر باشد:
بردارها همجهت هستند:
90 درجه باشد:
ارتباطی ندارند:
مخالف جهت باشند:
1.5.8.کاربرد شباهت کسینوسی در مدلهای زبانی
مدلهای زبانی بزرگ مانند Transformer کلمات و جملات را به بردار تبدیل میکنند.
مثلاً:
king
و:
queen
در فضای embedding قرار میگیرند.
اگر دو مفهوم نزدیک باشند:
فاصله زاویهای آنها کم است.
به همین دلیل میتوان پرسید:
کدام جمله به جمله موردنظر نزدیکتر است؟
با محاسبه:
CosineSimilarity
1.5.9.نرم فروبنیوس (Frobenius Norm)
برای ماتریسها، مشابه نرم L2، نرم فروبنیوس استفاده میشود.
اگر:
باشد:
کاربردها:
- اندازه ماتریس وزن شبکه
- مقایسه دو مدل
- تحلیل تغییرات وزنها
- Regularization
1.5.10.ارتباط نرمها با آموزش شبکه عصبی
در فرآیند آموزش، هدف شبکه کاهش خطا است.
تابع هدف:
معمولاً شامل دو بخش است:
بخش اول:
خطای پیشبینی:
بخش دوم:
کنترل پیچیدگی مدل:
بنابراین:
این رابطه نشان میدهد که جبر خطی مستقیماً در یادگیری مدل دخالت دارد.
جمعبندی بخش 1.5
| مفهوم | کاربرد در Deep Learning |
| Norm | اندازه بردار و وزن |
| L1 | انتخاب ویژگی و sparsity |
| L2 | Regularization |
| Distance | مقایسه نمونهها |
| Cosine Similarity | مقایسه embeddingها |
| Frobenius Norm | تحلیل ماتریس وزن |
1.6.مقادیر ویژه و بردارهای ویژهEigenvalues and Eigenvectors
1.6.1.چرا مقادیر ویژه مهم هستند؟
در بسیاری از مسائل یادگیری ماشین، ما با تبدیلهای خطی سروکار داریم.
یک ماتریس:
میتواند یک بردار ورودی را تغییر دهد:
این تغییر ممکن است شامل:
- تغییر جهت
- تغییر اندازه
- چرخش
- کشیدگی
- فشردگی
باشد.
اما سؤال مهم این است:
آیا جهاتی وجود دارند که بعد از اعمال این تبدیل، جهت خود را حفظ کنند؟
پاسخ مثبت است.
این جهتها همان بردارهای ویژه هستند.
1.6.2.تعریف بردار ویژه (Eigenvector)
فرض کنید ماتریس:
را روی بردار:
اعمال کنیم:
اگر نتیجه فقط باعث تغییر اندازه بردار شود و جهت آن تغییر نکند، یعنی:
در این رابطه:
- v : بردار ویژه (Eigenvector)
- λ: مقدار ویژه (Eigenvalue)
نامیده میشود.
به زبان ساده:بردار ویژه، جهتی در فضای داده است که یک تبدیل خطی آن را نمیچرخاند؛ فقط آن را بزرگتر یا کوچکتر میکند.
1.6.3.شهود هندسی Eigenvector
فرض کنید یک ماتریس مانند یک دستگاه تغییر شکل عمل کند.
یک شبکه مختصات را تصور کنید:
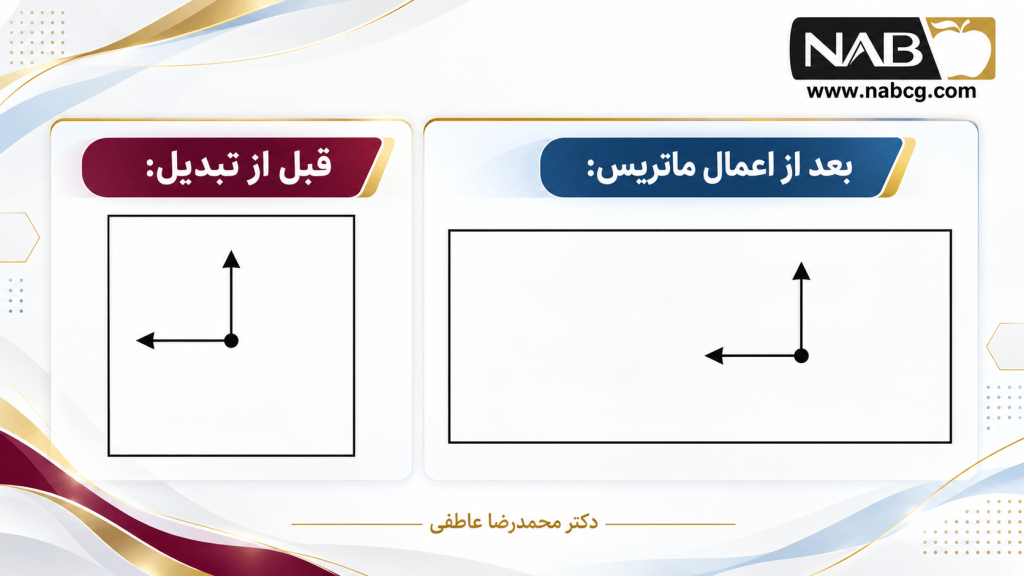
بسیاری از جهتها تغییر جهت میدهند.
اما برخی جهتها فقط کشیده یا فشرده میشوند.
این جهتها Eigenvector هستند.
1.6.4.محاسبه مقادیر ویژه
برای یافتن Eigenvalue باید رابطه زیر را حل کنیم:
میتوانیم بنویسیم:
عاملگیری:
برای اینکه جواب غیرصفر داشته باشیم، باید:
باشد.
این معادله را:
معادله مشخصه (Characteristic Equation)
مینامیم.
مثال ساده
ماتریس:
را در نظر بگیرید.
بردار:
را اعمال کنیم:
نتیجه:
یعنی:
پس:
برای بردار:
داریم:
پس:
1.6.5.ارتباط Eigenvalue با اهمیت اطلاعات
یکی از مهمترین کاربردهای مقادیر ویژه در یادگیری ماشین، تشخیص میزان اهمیت جهتهای مختلف داده است.
فرض کنید دادهها در فضای چندبعدی قرار دارند.
هر جهت:
یک الگوی تغییر را نشان میدهد.
مقدار ویژه:
نشان میدهد این جهت چقدر اهمیت دارد.
مثلاً:
فرض کنید:
یعنی:
- جهت اول بیشترین اطلاعات را دارد.
- جهت دوم اطلاعات کمتری دارد.
- جهت سوم تقریباً کماهمیت است.
این ایده پایه روش:
PCA
است.
1.6.6.ارتباط با تحلیل مؤلفه اصلی (PCA)
PCA تلاش میکند داده را به جهاتی منتقل کند که بیشترین تغییرات اطلاعاتی را دارند.
این جهتها همان بردارهای ویژه ماتریس کوواریانس هستند.
مراحل PCA:
- مرکز کردن دادهها
- محاسبه کوواریانس:
- محاسبه:
- انتخاب بزرگترین Eigenvalueها
نتیجه:
داده در فضای جدیدی قرار میگیرد که مؤلفههای مهمتر در آن حفظ شدهاند.
1.6.7.کاربرد Eigenvalue در شبکههای عصبی
اگرچه شبکههای عمیق معمولاً مستقیماً Eigenvalue را محاسبه نمیکنند، اما این مفهوم در تحلیل رفتار شبکه بسیار مهم است.
1. تحلیل فضای ویژگی
لایههای شبکه عصبی:
نمایش جدیدی از داده ایجاد میکنند.
با تحلیل Eigenvalue میتوان فهمید:
- کدام ویژگیها مهمتر هستند.
- آیا فضای ویژگی بیش از حد فشرده شده است.
- آیا اطلاعات از بین رفته است.
2. تحلیل ماتریس وزنها
وزنهای یک شبکه:
یک تبدیل خطی ایجاد میکنند.
بررسی ساختار طیفی آن:
Eigenvalue(W)
اطلاعاتی درباره:
- پایداری آموزش
- رفتار گرادیان
- پیچیدگی مدل
ارائه میدهد.
1.6.8.ارتباط با مشکل انفجار و ناپدید شدن گرادیان
در شبکههای عمیق، گرادیانها از ضرب چندین ماتریس عبور میکنند:
رفتار این ضرب به مقادیر ویژه ماتریسها وابسته است.
اگر مقدار ویژه بسیار بزرگ باشد:
ممکن است گرادیان افزایش یابد.
نتیجه:
اگر:
باشد:
رخ میدهد.
1.6.9.شعاع طیفی (Spectral Radius)
یکی از مفاهیم مهم در تحلیل شبکهها:
است.
یعنی بزرگترین مقدار مطلق Eigenvalue.
در شبکههای عصبی، کنترل این مقدار میتواند باعث:
- پایداری بیشتر آموزش
- کنترل رشد وزنها
- بهبود همگرایی
شود.
1.6.10. ارتباط با شبکههای بازگشتی (RNN)
در RNN:
حالت پنهان چندین بار با ماتریس:
W
ضرب میشود.
پس:
در طول زمان ایجاد میشود.
رفتار:
به Eigenvalueهای W وابسته است.
اگر:
اطلاعات گذشته سریع کاهش مییابد.
اگر:
ممکن است رشد ناپایدار رخ دهد.
1.6.11. Eigenvalue و یادگیری نمایش (Representation Learning)
یکی از اهداف Deep Learning یافتن فضای نمایش مناسب است.
شبکه تلاش میکند:
ورودی:
را به:
تبدیل کند:
این فضای جدید دارای ساختار هندسی جدید است.
تحلیل Eigenvalue کمک میکند بفهمیم:
- چه ابعادی اطلاعات بیشتری دارند؟
- آیا فضای ویژگی فشرده شده؟
- آیا ویژگیهای مهم حفظ شدهاند؟
جمعبندی بخش 1.6
| مفهوم | معنی | کاربرد |
| Eigenvector | جهتی که تغییر جهت نمیدهد | تحلیل فضا |
| Eigenvalue | میزان تغییر در آن جهت | اهمیت اطلاعات |
| Characteristic Equation | روش یافتن Eigenvalue | محاسبات ماتریسی |
| PCA | انتخاب جهتهای مهم | کاهش بعد |
| Spectral Radius | بزرگترین Eigenvalue | پایداری شبکه |
نکته کلیدی
در یادگیری عمیق، دادهها فقط مجموعهای از اعداد نیستند؛ بلکه در فضاهای چندبعدی قرار دارند.
مقادیر ویژه به ما کمک میکنند بفهمیم کدام جهتهای این فضا بیشترین اطلاعات، بیشترین تغییر و بیشترین اثر را دارند.