۴۴. پروژه جامع پایانی:انتخاب و ارزیابی بهینهساز برای یک مسئله واقعی
Capstone Project:From Optimizer Selection to Reproducible Evaluation
۴۴.۱. هدف پروژه
در بخشهای قبلی، الگوریتمهای مختلفی را مطالعه کردیم؛ از Gradient Descent و Momentum تا AdamW و روشهای شبهنیوتنی و ماتریسی.
اکنون باید این دانش را به یک مهارت عملی تبدیل کنیم:انتخاب یک بهینهساز مناسب بر اساس شواهد محاسباتی، نه صرفاً شهرت الگوریتم.
فرض کنید تیم تحقیق و توسعه یک کارخانه میخواهد مدلی برای پیشبینی احتمال خرابی یک دستگاه صنعتی طراحی کند. دادههای حسگر شامل دما، فشار، لرزش و جریان موتور هستند. خروجی مدل احتمال خرابی دستگاه در بازهای مشخص خواهد بود.
سؤال اصلی پروژه:
کدام یک از چهار روش SGD، Momentum، RMSProp و AdamW، با بودجه آموزشی مشخص، عملکرد مناسبی در تشخیص خرابی تجهیزات فراهم میکند؟
به این سؤال باید از چهار دیدگاه پاسخ دهیم:کیفیت پیشبینی، پایداری آموزش، هزینه محاسباتی و تعمیمپذیری.
۴۴.۲. مرحله اول:تعریف داده و معماری
برای تمرین دانشگاهی، از مجموعهداده مصنوعی با چهار ورودی استفاده میکنیم. داده باید شامل روابط غیرخطی، نویز و ترکیبی از نمونههای سالم و معیوب باشد.
پیشنهاد میشود مجموعه شامل ۶۰۰۰ نمونه باشد:
| مجموعه | تعداد | کاربرد |
| آموزش | ۴۲۰۰ | یادگیری وزنهای شبکه |
| اعتبارسنجی | ۹۰۰ | تنظیم بهینهساز و ابرپارامترها |
| آزمون | ۹۰۰ | ارزیابی نهایی مدل انتخابشده |
تقسیم داده در صورت شبیهسازی مستقل میتواند تصادفی و طبقهبندیشده باشد. اما اگر داده واقعی مربوط به زمان، تجهیز یا کارخانههای مختلف باشد، باید خطر نشت اطلاعات (Data Leakage) را بررسی کنیم. برای مثال، در پیشبینی خرابی دستگاهها، قرار گرفتن بخشهایی از داده یک دستگاه در آموزش و آزمون ممکن است ارزیابی را خوشبینانه کند.
معماری پیشنهادی:
در لایههای پنهان از ReLU و در خروجی از یک مقدار خام موسوم به Logit استفاده میشود. احتمال خرابی پس از اعمال Sigmoid بر این خروجی محاسبه خواهد شد.
تابع زیان مناسب این مسئله، Binary Cross-Entropy with Logits است که جزئیات آن متعلق به فصل توابع زیان است و در اینجا تنها برای تعریف آزمایش به کار میرود.
۴۴.۳. مرحله دوم:طراحی مقایسه منصفانه
مقایسه باید دو هدف متفاوت را از یکدیگر جدا کند.
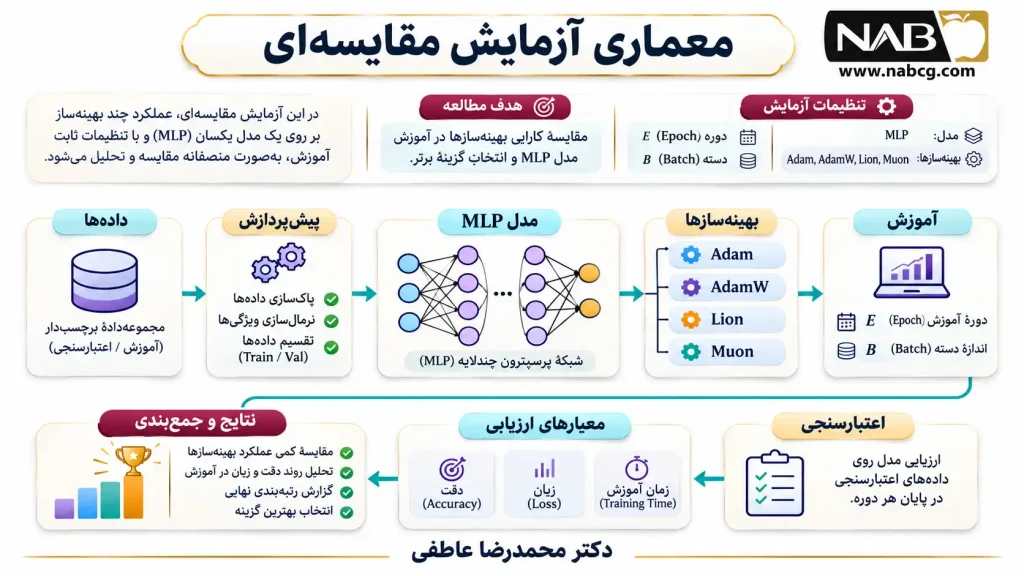
- آزمایش اول — بودجه ثابت:هر بهینهساز تعداد یکسانی بهروزرسانی و پردازش داده دریافت میکند. این آزمایش نشان میدهد روشها تحت بودجه از پیش تعیینشده چه عملکردی دارند.
- آزمایش دوم — رسیدن به آستانه کیفیت:برای هر بهینهساز محاسبه میکنیم چقدر زمان و چند ارزیابی گرادیان لازم است تا مدل به یک معیار از پیش تعریفشده برسد.
این دو آزمایش میتوانند رتبهبندی متفاوتی تولید کنند. بهینهسازی که در آغاز سریعتر پیش میرود، لزوماً در پایان بهترین عملکرد را ندارد.
شکل . معماری آزمایش مقایسهای
۴۴.۴. مرحله سوم:انتخاب ابرپارامترها
برای هر بهینهساز، یک فضای جستوجوی اولیه تعریف میکنیم.
| روش | نرخهای یادگیری پیشنهادی برای آزمایش | تنظیم مکمل |
| SGD | ۰٫۰۰۱، ۰٫۰۱، ۰٫۰۵، ۰٫۱ | بدون مومنتوم |
| Momentum | ۰٫۰۰۱، ۰٫۰۱، ۰٫۰۵، ۰٫۱ | (β=0.9) |
| RMSProp | ۰٫۰۰۰۱، ۰٫۰۰۱، ۰٫۰۰۳، ۰٫۰۱ | (ρ=0.9) |
| AdamW | ۰٫۰۰۰۱، ۰٫۰۰۰۳، ۰٫۰۰۱، ۰٫۰۰۳ | Weight Decay قابل تنظیم |
این مقادیر صرفاً نقطه شروع آزمایش هستند. در صورت مشاهده واگرایی یا پیشرفت کند، محدوده جستوجو باید بر اساس پروتکل از پیش تعیینشده اصلاح شود.
برای جلوگیری از مقایسه نامنصفانه، باید تعداد آزمایشهای تنظیمی و منابع محاسباتی مصرفشده برای هر روش گزارش شود.
۴۵. چگونه نتایج آزمایش را علمی تفسیر کنیم؟
۴۵.۱. تفاوت زیان، دقت و کیفیت تصمیمگیری
در یک مسئله تشخیص خرابی، کم شدن تابع زیان آموزشی کافی نیست.
فرض کنید فقط پنج درصد دادهها مربوط به دستگاههای معیوب باشند. اگر مدلی برای تمام نمونهها پاسخ «سالم» بدهد، دقت ظاهری آن ۹۵ درصد خواهد بود؛ بااینحال، هیچ خرابی را تشخیص نداده است.
بنابراین باید در کنار تابع زیان، معیارهایی مانند Precision، Recall و PR-AUC را بررسی کنیم. جزئیات ریاضی این معیارها به فصل ارزیابی مدل مربوط است؛ در اینجا تمرکز ما بر نقش آنها در انتخاب بهینهساز است.
بهویژه در مسئله خرابی تجهیزات، هزینه از دست دادن یک خرابی ممکن است با هزینه هشدار اشتباه برابر نباشد.
ازاینرو، انتخاب بهینهساز باید بر اساس معیارهای منطبق با هدف عملیاتی سازمان انجام شود.
۴۵.۲. مثال عددی:بهترین بهینهساز کدام است؟
فرض کنیم پس از تنظیم ابرپارامترها، نتایج فرضی زیر در مجموعه اعتبارسنجی به دست آمدهاند:
| روش | PR-AUC | Recall | زمان آموزش |
| SGD | ۰٫۸۲ | ۰٫۷۹ | ۴۵ ثانیه |
| Momentum | ۰٫۸۷ | ۰٫۸۵ | ۴۸ ثانیه |
| RMSProp | ۰٫۸۶ | ۰٫۸۳ | ۵۲ ثانیه |
| AdamW | ۰٫۸۸ | ۰٫۸۴ | ۵۵ ثانیه |
تمام مقادیر این جدول آموزشی و فرضی هستند؛ نتیجه اجرای آزمایش واقعی محسوب نمیشوند.
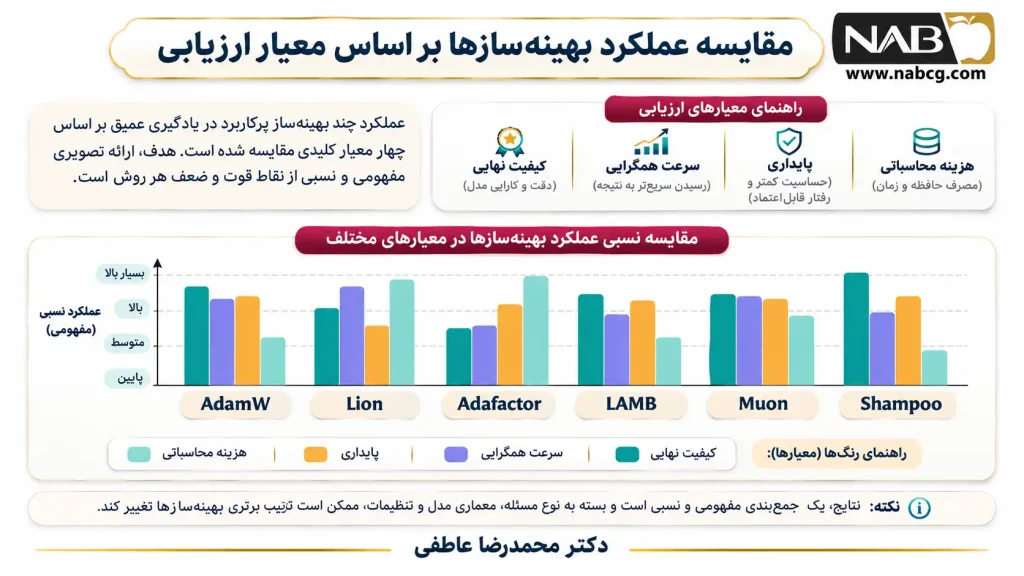
در این مثال، AdamW بالاترین PR-AUC را دارد، اما Momentum بیشترین Recall را ثبت کرده و زمان آموزش کمتری نیز نیاز داشته است.
اگر هزینه از دست دادن خرابی بسیار زیاد باشد، Recall میتواند اولویت بیشتری داشته باشد. در مقابل، اگر تعداد هشدارهای اشتباه هزینه عملیاتی بالایی ایجاد کند، باید Precision و آستانه تصمیمگیری نیز بررسی شوند.
نکته مهم این است که آستانه تصمیمگیری باید با داده اعتبارسنجی انتخاب شود و عملکرد نهایی فقط روی مجموعه آزمون دستنخورده گزارش گردد.
۴۵.۳. نقش چند بذر تصادفی
برای افزایش اعتبار نتایج، هر روش باید چند بار با مقداردهی اولیه و ترتیب دادههای متفاوت اجرا شود.
مثلاً میتوان از پنج بذر تصادفی استفاده کرد:
این اعداد صرفاً شناسه اجرا هستند و ویژگی خاصی ندارند.
در هر بذر، وزنهای اولیه بین بهینهسازها یکسان نگه داشته میشوند، اما در بذر بعدی تغییر میکنند.
سپس میانگین و انحراف معیار معیارها گزارش میشود.
نمودار مفهومی پایداری
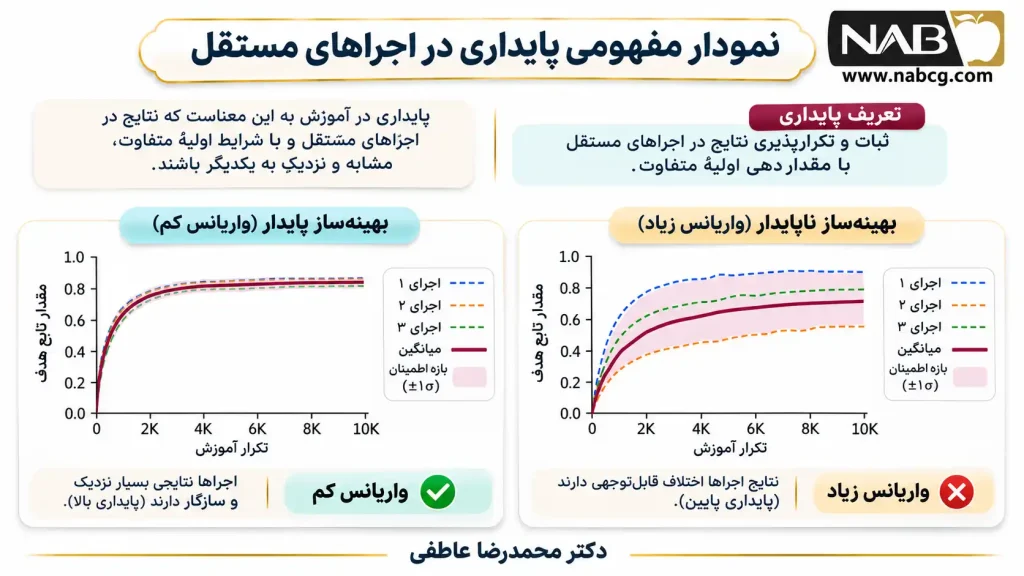
اگر دو بهینهساز میانگین عملکرد مشابهی داشته باشند، اما یکی نتایج پایدارتر و زمان محاسباتی کمتری ارائه کند، آن روش ممکن است از منظر عملیاتی انتخاب بهتری باشد.
۴۶. بازتولیدپذیری؛ شرط تبدیل آزمایش آموزشی به پژوهش معتبر
Reproducibility, Experimental Protocol and Scientific Reporting
۴۶.۱. چرا ثبت بذر تصادفی بهتنهایی کافی نیست؟
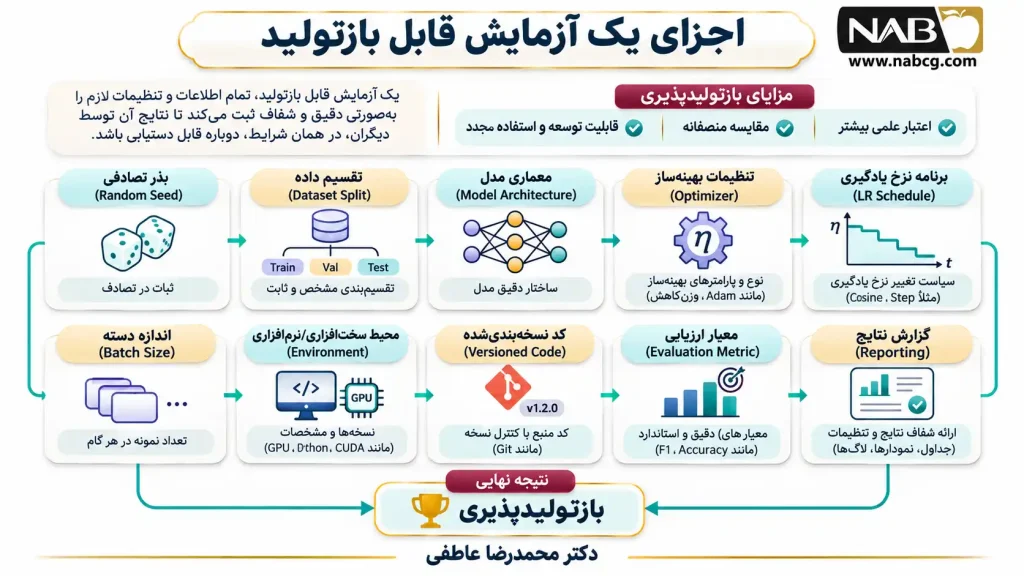
در پروژههای یادگیری عمیق، گاهی پژوهشگر تنها بذر تصادفی (Random Seed) را ثبت میکند و انتظار دارد آزمایش در هر زمان و روی هر رایانه، دقیقاً همان نتیجه را تولید کند.
اما رفتار محاسباتی شبکه میتواند به عوامل دیگری نیز وابسته باشد؛ از جمله نسخه کتابخانهها، نوع سختافزار، روش اجرای عملیات موازی و نوع محاسبات ممیز شناور.
حتی مستندات PyTorch تصریح میکنند که بازتولیدپذیری کامل میان نسخهها یا پلتفرمهای مختلف تضمین نمیشود و اجرای CPU و GPU نیز ممکن است با بذر یکسان، نتایج متفاوتی ایجاد کند.
بنابراین باید بین دو مفهوم تفاوت بگذاریم:
تکرارپذیری محاسباتی (Computational Repeatability):تلاش برای دریافت همان نتیجه با اجرای مجدد آزمایش در شرایط یکسان.
بازتولیدپذیری پژوهشی (Research Reproducibility):فراهم کردن اطلاعات کافی تا پژوهشگران دیگر بتوانند روش آزمایش، نتایج اصلی و اعتبار ادعاها را بررسی یا بازسازی کنند.
شکل . اجزای یک آزمایش قابل بازتولید
۴۶.۲. پیادهسازی تنظیمات بازتولیدپذیری در PyTorch
در کد زیر، منابع متداول تصادفی بودن کنترل میشوند.
import os
import random
import numpy as np
import torch

SEED = 42

random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)

if torch.cuda.is_available():
    torch.cuda.manual_seed_all(SEED)

torch.backends.cudnn.benchmark = False
torch.backends.cudnn.deterministic = True

torch.use_deterministic_algorithms(True)

print("PyTorch:", torch.__version__)
print("CUDA available:", torch.cuda.is_available())
این تنظیمات ممکن است در صورت استفاده از عملیات غیرقطعی فاقد جایگزین قطعی، موجب خطای اجرایی شوند. همچنین برای بعضی عملیات CUDA تنظیمات محیطی اضافی لازم است که باید پیش از آغاز فرایند تنظیم شوند.
از سوی دیگر، اجرای قطعی میتواند کندتر از حالت عادی باشد؛ بنابراین برای بنچمارک سرعت، تأثیر این تنظیمات باید بهطور شفاف گزارش شود.
۴۶.۳. پروتکل پنجمرحلهای مقایسه بهینهسازها
برای مطالعه دقیقتر چهار بهینهساز پروژه، از پروتکل زیر استفاده میکنیم.
- تثبیت مسئله و مجموعه داده
داده، تقسیمبندی، معماری شبکه و معیار اصلی ارزیابی را پیش از شروع آزمایش مشخص میکنیم.
- تنظیم منصفانه ابرپارامترها
برای هر بهینهساز، بودجه مشخصی از آزمایشهای تنظیمی اختصاص میدهیم. معیار انتخاب بهترین تنظیم، داده اعتبارسنجی است.
- اجرای مستقل با چند بذر تصادفی
برای هر روش منتخب، آزمایش را با چند مقداردهی اولیه و ترتیب داده متفاوت تکرار میکنیم.
- اندازهگیری عملکرد و منابع
کیفیت پیشبینی، تعداد ارزیابی گرادیان، زمان اجرا و حافظه مصرفی را ثبت میکنیم.
- ارزیابی نهایی و گزارش محدودیتها
پس از انتخاب تنظیمات، مجموعه آزمون مستقل ارزیابی میشود. میانگین، پراکندگی و محدودیتهای نتیجه گزارش میشوند.
این رویکرد با اصول شفافیت و بازتولیدپذیری مطرحشده در چکلیست پژوهشی NeurIPS نیز سازگار است؛ از جمله ضرورت تشریح جزئیات آزمایش، الگوریتم و شرایط بازسازی نتایج.
۴۷. تفسیر پیشرفته:رابطه بهینهسازی و تعمیمپذیری
۴۷.۱. آیا بهترین بهینهساز همان است که کمترین زیان آموزشی را ایجاد میکند؟
این سؤال از نظر علمی بسیار مهم است.
در شبکههای عصبی، کاهش تابع زیان آموزش هدف مستقیم بسیاری از الگوریتمهای بهینهسازی است. بااینحال، هدف نهایی استفاده عملی از مدل معمولاً عملکرد مناسب روی دادههای جدید است.
دو مدل ممکن است زیان آموزشی تقریباً یکسانی داشته باشند، اما روی مجموعه آزمون نتایج متفاوتی تولید کنند.
این اختلاف میتواند به عواملی مانند ساختار تابع زیان، مسیر آموزش، منظمسازی، ویژگیهای داده و انتخاب نقطه توقف مربوط باشد.
بنابراین باید میان دو مفهوم تفاوت قائل شویم:
اولی به توانایی کاهش تابع هدف آموزشی مربوط است و دومی به عملکرد مدل روی دادههای خارج از مجموعه آموزش.
۴۷.۲. مثال مدیریتی:تصمیمگیری بر اساس کیفیت و هزینه
فرض کنید تیم تحقیق و توسعه یک سامانه هوش مصنوعی سازمانی، سه گزینه برای آموزش مدل دارد.
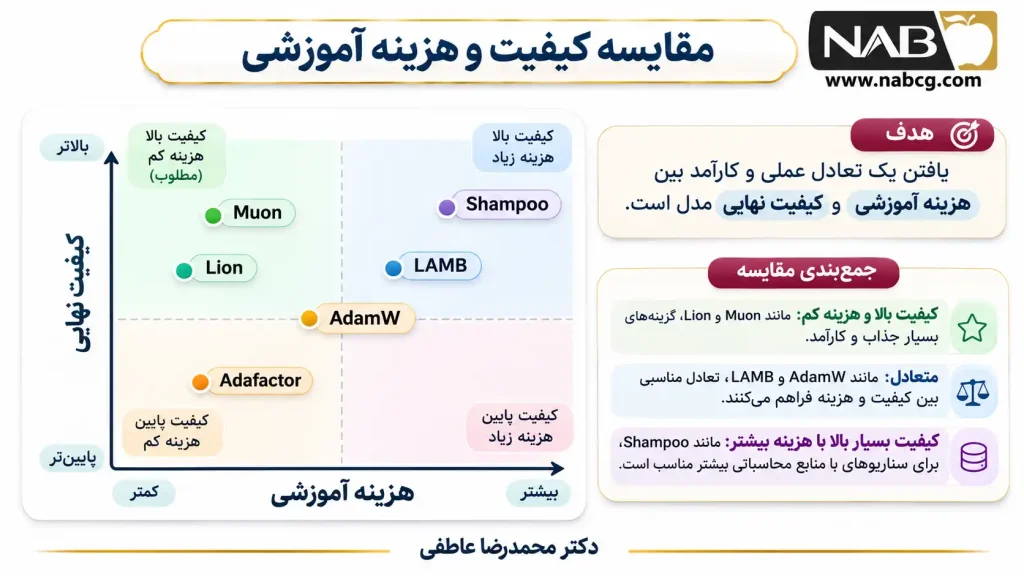
گزینه اول طی ۲۰ دقیقه به کیفیت ۰٫۸۹ میرسد. گزینه دوم طی ۳۵ دقیقه به ۰٫۹۲ و گزینه سوم طی ۶۰ دقیقه به ۰٫۹۲۵ میرسد.
از منظر فنی، گزینه سوم بالاترین کیفیت را دارد. اما از منظر مدیریتی، هزینه ۲۵ دقیقه آموزش بیشتر برای تنها ۰٫۰۰۵ بهبود ممکن است همیشه توجیهپذیر نباشد.
در این شرایط، تصمیم درست به ارزش اقتصادی بهبود کیفیت، هزینه محاسبات، الزامات زمانی و پایداری مدل وابسته است.
نکته سطح دکتری:تحلیل چندهدفه
میتوان مسئله انتخاب را بهصورت چندهدفه تعریف کرد:
در این رابطه:
| نماد | تعریف |
|---|---|
| 𝒜 | انتخاب الگوریتم بهینهسازی |
| h | مجموعه ابرپارامترهای الگوریتم و آموزش |
| E | خطای اعتبارسنجی یا معیار خطای منتخب |
| T | زمان یا هزینه محاسباتی آموزش |
| M | مصرف حافظه |
| min | جستوجوی راهحلهایی با مقادیر مطلوب هر سه هدف |
در این صورت ممکن است یک الگوریتم از نظر کیفیت بهترین باشد، اما الگوریتم دیگری از نظر هزینه و پایداری مناسبتر باشد.
این چارچوب با مفهوم جبهه پارتو (Pareto Frontier) مرتبط است؛ یعنی مجموعه انتخابهایی که بهبود یک هدف در آنها بدون بدتر شدن دستکم یک هدف دیگر ممکن نیست.
۴۸. ارزیابی پایانی فصل؛ از دانش مفهومی تا توانایی پژوهش
اکنون که خواننده از مشتق و گرادیان تا بهینهسازهای تطبیقی و ماتریسی پیش رفته است، باید بتواند علاوه بر اجرای الگوریتمها، منطق انتخاب و محدودیتهای آنها را تحلیل کند.
۴۸.۱. سطوح مورد انتظار یادگیری
| سطح تحصیلی | توانایی مورد انتظار |
| کارشناسی | فهم گرادیان و اجرای دستی SGD، Momentum و Adam |
| کارشناسی پیشرفته | پیادهسازی بهینهسازهای مرتبه اول و تحلیل نرخ یادگیری |
| کارشناسی ارشد | مقایسه تجربی روشها، تحلیل پایداری و تنظیم ابرپارامترها |
| دکتری | بررسی فرضهای همگرایی، طراحی آزمایش معتبر و تحلیل روشهای جدید |
| پژوهشگر صنعتی | انتخاب روش بر اساس کیفیت، هزینه، حافظه و قیود عملیاتی |
۴۸.۲. آزمون جامع نهایی
مسئله اول — تحلیل گرادیان
تابع زیر را در نظر بگیرید:
گرادیان و هسین را محاسبه کنید. سپس یک گام Gradient Descent و یک گام Newton را از نقطه ((0,0)) اجرا کنید و اختلاف نتایج را توضیح دهید.
مسئله دوم — انتخاب بهینهساز
شبکهای با ۵۰ میلیون پارامتر قرار است روی GPU با حافظه محدود آموزش داده شود. AdamW، SGD with Momentum و Adafactor را از نظر وضعیت حافظه، تنظیمات و ویژگیهای بهینهسازی مقایسه کنید.
مسئله سوم — تشخیص مشکل آموزش
در یک آزمایش، زیان آموزشی پس از ۵۰۰ گام کاهش نمییابد و نرم گرادیان بهشدت نوسان دارد. یک برنامه عیبیابی طراحی کنید که مشکل را میان داده، پیادهسازی، نرخ یادگیری، اندازه Batch و پایداری عددی تفکیک کند.
مسئله چهارم — روش پژوهشی
دو بهینهساز روی یک Transformer کوچک به نتایج اعتبارسنجی نزدیک رسیدهاند. طراحی آزمایشی پیشنهاد دهید که بتوان با آن درباره تفاوت عملکردشان با اطمینان بیشتری نتیجهگیری کرد.
مسئله پنجم — توسعه الگوریتم
یک روش بهینهسازی پیشنهاد کنید که از مومنتوم جهتدار و تقریب قطری خمیدگی استفاده کند. روابط آن را بنویسید، حافظه اضافی را تحلیل کنید و توضیح دهید چگونه میتوان احتمال واگرایی را بررسی کرد.
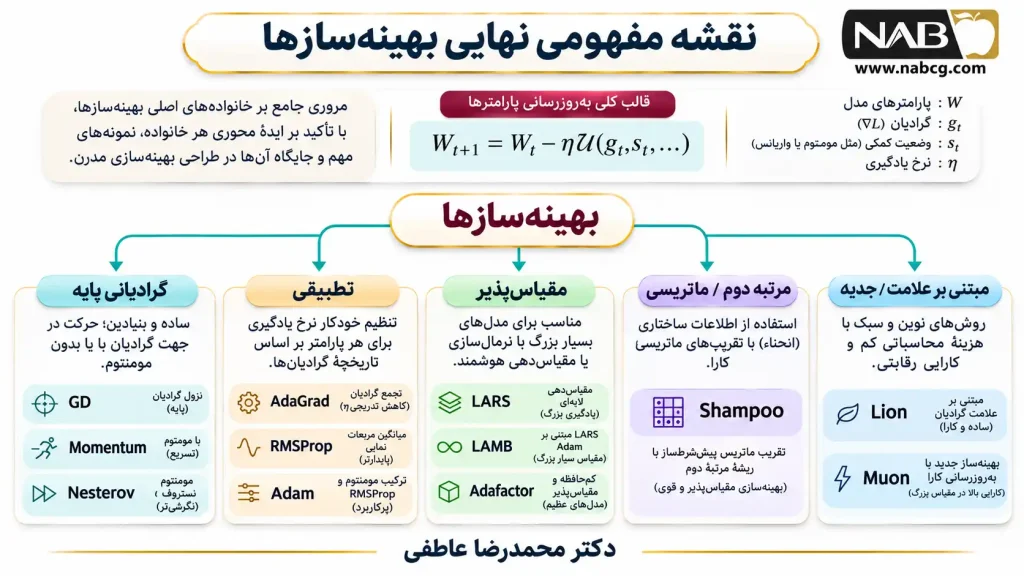
۴۹. نقشه مفهومی نهایی بهینهسازها
۵۰. نتیجهگیری علمی فصل
بهینهسازی شبکه عصبی را میتوان فرایند تصمیمگیری مکرر درباره تغییر پارامترهای مدل دانست.
در روشهای گرادیانی ساده، تصمیم عمدتاً بر اساس شیب فعلی گرفته میشود. روشهای دارای مومنتوم، تاریخچه جهت حرکت نیز وارد محاسبات میشود. در روشهای تطبیقی، اندازه گرادیانهای گذشته بر مقیاس گام تأثیر میگذارد. روشهای شبهنیوتنی اطلاعات مربوط به خمیدگی را تقریب میزنند و روشهای جدیدتر تلاش میکنند بخشی از محدودیتهای حافظه و مقیاسپذیری را برطرف سازند.
از این مباحث، پنج نتیجه اصلی حاصل میشود:
- هیچ بهینهسازی در همه مسائل بهترین نیست. ساختار مسئله و منابع محاسباتی بر انتخاب مؤثرند.
- نرخ یادگیری و سایر ابرپارامترها جزئی از عملکرد الگوریتم هستند. مقایسه بدون تنظیم منصفانه میتواند گمراهکننده باشد.
- کاهش زیان آموزشی با تعمیمپذیری یکسان نیست. معیار نهایی باید با هدف واقعی مسئله سازگار باشد.
- هزینه محاسبات و حافظه اهمیت دارند. روشی که در تعداد تکرار کمتر همگرا میشود، ممکن است زمان واقعی بیشتری مصرف کند.
- پژوهش معتبر به آزمایش بازتولیدپذیر نیاز دارد. ادعای برتری باید بر شواهد کافی و گزارش شفاف استوار باشد.
۵۱. ممیزی علمی و محاسباتی بهینهسازها
Scientific and Numerical Verification of Optimization Algorithms
۵۱.۱. چرا ممیزی محاسبات ضروری است؟
در تألیف یک کتاب دانشگاهی، صحیح بودن تعریف الگوریتم بهتنهایی کافی نیست. مثالهای عددی، نمودارها، کدهای برنامهنویسی و تفسیر نتایج نیز باید با همان تعریف سازگار باشند.
این موضوع در فصل بهینهسازها اهمیت بیشتری دارد؛ زیرا تغییر کوچکی در ترتیب محاسبات، محل قرارگیری (ε)، اصلاح بایاس یا نحوه اعمال Weight Decay ممکن است نتیجه الگوریتم را تغییر دهد.
برای مثال، تفاوت میان این دو عبارت را در نظر بگیرید:
این دو فرمول در حالت کلی برابر نیستند. برای (v=0) و (ε=0.01)، مخرج اول برابر (0.01) و مخرج دوم برابر (0.1) است؛ یعنی نتیجه تقسیم میتواند ده برابر تفاوت داشته باشد.
بنابراین از این بخش به بعد، علاوه بر توضیح نظری، یک استاندارد کنترل عددی برای تمام الگوریتمهای کتاب تعریف میکنیم.
۵۱.۲. نتایج بازبینی محاسبات فصل
محاسبات چندمرحلهای مثالهای اصلی را با اجرای مستقل روابط ریاضی بررسی کردم.
| روش | مورد بررسی | نتیجه |
| AdaGrad | چهار گام روی تابع درجه دوم | محاسبات سازگار |
| AdaDelta | چهار گام با میانگین متحرک دوگانه | محاسبات سازگار |
| RMSProp | چهار گام با (rho=0.9) | محاسبات سازگار |
| Adam | پنج گام با اصلاح بایاس | محاسبات سازگار |
| AdamW | پنج گام با کاهش وزن تفکیکشده | محاسبات سازگار |
| AMSGrad | پنج گام مطابق قرارداد آموزشی تعریفشده | محاسبات سازگار |
| Nadam | پنج گام مطابق فرمول منتخب فصل | محاسبات سازگار |
| BFGS | ماتریس جدید و جهت حرکت | تأیید شد |
| L-BFGS | تقریب کمحافظه با یک جفت بردار | تأیید شد |
برای نمونه، در مثال BFGS، ماتریس حاصل برابر است با:
و جهت محاسبهشده:
همچنین در مثال L-BFGS، با مقیاس اولیه (0.3I)، جهت حرکت بهدرستی برابر است با:
این سازگاری عددی به معنای تأیید تمام جزئیات علمی فصل نیست. بهویژه تفاوت قراردادها در AMSGrad و Nadam و تفاوت مثالهای آموزشی سادهشده با پیادهسازی کامل LARS، LAMB، Shampoo و Muon باید در نسخه نهایی روشن بماند.
۵۱.۳. بازتولید آزمایش عملی MLP
آزمایش مقایسهای قبلی را نیز مجدداً با کد موجود اجرا کردم. دادهها مصنوعی بودند و شبکه دارای ۳۶۹ پارامتر، ۵۰ Epoch و چهار بهینهساز بود.
خروجی بازتولیدشده:
| بهینهساز | بهترین MSE اعتبارسنجی | Epoch بهترین نتیجه |
| SGD | ۰٫۰۲۰۷۳ | ۵۰ |
| Momentum | ۰٫۰۱۴۷۳ | ۴۱ |
| RMSProp | ۰٫۰۱۵۶۶ | ۵۰ |
| AdamW | ۰٫۰۲۰۵۹ | ۴۸ |
این نتایج با گزارش عددی قبلی انطباق دارند.
بااینحال، نتیجه صرفاً یک آزمایش کنترلشده با یک بذر و نرخهای یادگیری منتخب است. برای انتشار یک ادعای پژوهشی درباره برتری Momentum، باید آزمایشهای چندبذری و تنظیم منصفانه ابرپارامترها انجام شوند.
۵۲. استانداردسازی محاسبات و پیادهسازی الگوریتمها
۵۲.۱. چرا باید قرارداد محاسباتی هر الگوریتم مشخص باشد؟
یکی از مشکلات رایج در کتابهای آموزش یادگیری عمیق، استفاده از یک نام الگوریتم برای چند پیادهسازی نسبتاً متفاوت است.
برای مثال، در فرمولهای آموزشی این فصل از AMSGrad، بیشینهگیری پس از اصلاح بایاس ممان دوم انجام شده است. اما در صورتبندی اصلی و پیادهسازیهای متداول، ممکن است بیشینهگیری روی ممان دوم خام انجام شود.
این تفاوت باید در عنوان مثال، فرمول و کد ثبت شود؛ در غیر این صورت دانشجو ممکن است با اجرای تابع آماده یک کتابخانه، اعداد متفاوتی به دست آورد و تصور کند محاسبات اشتباهاند.
جدول ۵۲-۱. مواردی که باید در نسخه نهایی صریح شوند
| الگوریتم | نکته محاسباتی مهم |
| Momentum | تعریف حافظه به شکل گرادیان انباشته یا سرعت حرکت |
| Nesterov | محل محاسبه گرادیان و ترتیب بهروزرسانی |
| RMSProp | محل قرارگیری (epsilon) و ضریب حافظه |
| AdaDelta | محل قرارگیری (epsilon) داخل رادیکال |
| Adam | اصلاح بایاس و ترتیب تغییر پارامترها |
| AdamW | تفکیک Weight Decay از ممانها |
| AMSGrad | محل بیشینهگیری و قرارداد اصلاح بایاس |
| Nadam | نوع اعمال مومنتوم نستروف |
| L-BFGS | مقیاس اولیه، تاریخچه و جستوجوی خطی |
| Shampoo | منظمسازی ماتریسها و محاسبه توان ماتریسی |
| Muon | الگوریتم متعامدسازی و مقیاس خروجی |
در نسخه نهایی کتاب باید هر جا از یک الگوریتم سادهشده استفاده شده است، عبارت «نسخه آموزشی سادهشده» در عنوان یا زیرنویس شکل و مثال ذکر شود.
۵۲.۲. آزمون خودکار مثالهای عددی
برای اینکه کنترل اعداد فقط به بررسی دستی وابسته نباشد، یک فایل Python مستقل ایجاد و اجرا کردم. این فایل نتایج الگوریتمهای تطبیقی و محاسبات BFGS و L-BFGS را با روابط فصل کنترل میکند.
دریافت کد ممیزی عددی بهینهسازها
آزمونهای خودکار با موفقیت اجرا شدند.
جدول ۵۲-۲. نتایج مرجع برای گام پنجم
برای تمام روشهای این جدول، تابع زیان زیر استفاده شده است:
| الگوریتم | وزن پس از گام پنجم |
| Adam | ۰٫۹۹۱۲۸۳۷ |
| AdamW | ۰٫۹۵۲۴۷۱۲ |
| AMSGrad با قرارداد منتخب فصل | ۰٫۹۲۹۲۹۶۳ |
| Nadam با ضرایب ثابت | ۱٫۳۳۴۳۳۲۵ |
این نتایج را میتوان بهعنوان داده مرجع برای بررسی پیادهسازی دانشجویان استفاده کرد؛ البته فقط در صورتی که پارامترهای اولیه و قراردادهای محاسباتی دقیقاً همان مقادیر فصل باشند.
۵3. انباشت گرادیان؛ چگونه با حافظه محدود از Batch بزرگ استفاده کنیم؟
Gradient Accumulation and Effective Batch Size
این موضوع یک حلقه مهم میان بخش Mini-Batch و بخش بهینهسازهای مقیاسپذیر است و بهتر است در نسخه نهایی، پس از آموزش Mini-Batch قرار گیرد.
۵3.۱. مسئله اصلی
فرض کنید یک شبکه Transformer را آموزش میدهیم و میخواهیم برای هر بهروزرسانی از ۱۲۸ نمونه استفاده کنیم.
اما حافظه GPU فقط اجازه میدهد در هر مرحله ۱۶ نمونه را همزمان پردازش کنیم.
آیا مجبوریم اندازه Batch را به ۱۶ کاهش دهیم؟
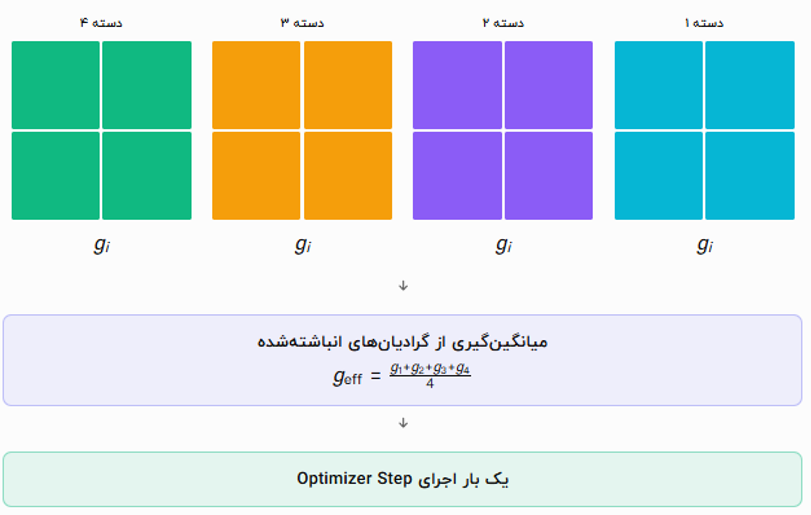
خیر. میتوانیم گرادیان چند دسته کوچک را محاسبه و جمع کنیم و پس از پردازش همه آنها، فقط یک بار پارامترهای مدل را تغییر دهیم.
به این روش انباشت گرادیان (Gradient Accumulation) میگوییم.
در مثال ما:
در این روابط:
| نماد | تعریف |
|---|---|
| B_micro | تعداد نمونههای هر دسته کوچک که در یک بار پردازش وارد مدل میشوند |
| K | تعداد دستههای کوچک پیش از هر بهروزرسانی وزنها |
| B_effective | تعداد کل نمونههای مؤثر در تشکیل گرادیان یک گام |
| θ | بردار پارامترهای مدل |
بنابراین میتوان بدون نگهداری فعالسازیهای هر ۱۲۸ نمونه بهصورت همزمان، گرادیان مربوط به آنها را در چند مرحله محاسبه کرد.
۵3.۲. فرمول ریاضی انباشت گرادیان
اگر تابع زیان برای هر نمونه برابر Lᵢ(θ) باشد، گرادیان یک دسته مؤثر با B نمونه برابر است با:
حال اگر نمونهها به K دسته کوچک تقسیم شده باشند و هر دسته شامل bₖ نمونه باشد:
گرادیان مؤثر:
که:
در این روابط، gₖ میانگین گرادیان دسته کوچک شماره k، bₖ تعداد نمونههای همان دسته و ℬₖ مجموعه اندیسهای آن است.
نکته مهم:اگر اندازه Micro-Batchها متفاوت باشد، میانگین ساده گرادیان دستهها معمولاً نتیجه درست نمیدهد. هر گرادیان باید متناسب با تعداد نمونههای دسته خودش وزن بگیرد.
۵3.۳. مثال عددی کامل انباشت گرادیان
یک نورون خطی داریم:
تابع زیان هر نمونه:
دادهها:
| نمونه | (x_i) | (y_i) |
| ۱ | ۱ | ۲ |
| ۲ | ۲ | ۴ |
| ۳ | ۳ | ۶ |
وزن اولیه:
گرادیان نمونه:
در وزن صفر:
فرض کنید Micro-Batch اول دو نمونه و Micro-Batch دوم یک نمونه داشته باشد.
میانگین گرادیان دسته اول:
گرادیان دسته دوم:
اگر به اشتباه میانگین ساده این دو مقدار را بگیریم:
اما گرادیان صحیح باید با تعداد نمونهها وزندهی شود:
این مقدار دقیقاً با گرادیان Batch کامل که در ابتدای فصل محاسبه کردیم برابر است.
اگر نرخ یادگیری برابر ۰٫۱ باشد:
بنابراین در این مثال، پردازش یک دسته سهنمونهای و پردازش دو Micro-Batch بدون تغییر وزن بین آنها، گرادیان ریاضی یکسانی تولید میکند.
آیا نتیجه همیشه کاملاً یکسان خواهد بود؟
خیر. یکسانی ریاضی تحت شرایط مشخص برقرار است:تابع زیان باید بهدرستی میانگینگیری شود، وزنها طی انباشت ثابت بمانند و محاسبه گرادیان هر نمونه به ترکیب همان نمونه با نمونههای دیگر وابستگی نامناسب نداشته باشد.
برای مثال، Batch Normalization، عملیات تصادفی و اختلافهای ممیز شناور ممکن است باعث شوند اجرای Batch کامل و انباشت Micro-Batchها دقیقاً خروجی یکسانی نداشته باشند.
در آموزش توزیعشده نیز تعداد پردازندهها و شیوه میانگینگیری گرادیانها اهمیت دارد.
۵4. پیادهسازی انباشت گرادیان در PyTorch
۵4.۱. پیادهسازی صحیح با دستههای هماندازه
در کد زیر از چهار Micro-Batch برای تشکیل یک دسته مؤثر استفاده میکنیم.
import torch
from torch import nn

model = nn.Sequential(
    nn.Linear(4, 16),
    nn.ReLU(),
    nn.Linear(16, 1)
)

optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=0.001,
    weight_decay=0.01
)

criterion = nn.MSELoss()

accumulation_steps = 4
optimizer.zero_grad()

for step, (x, y) in enumerate(train_loader):
    prediction = model(x)
    loss = criterion(prediction, y)

    # Correct for equal-sized micro-batches
    (loss / accumulation_steps).backward()

    if (step + 1) % accumulation_steps == 0:
        torch.nn.utils.clip_grad_norm_(
            model.parameters(), max_norm=1.0
        )

        optimizer.step()
        optimizer.zero_grad()
در این مثال، train_loader باید از قبل تعریف شده باشد و برای انباشت دقیق، همه Micro-Batchهای هر گروه چهارتایی باید هماندازه باشند.
یک اشکال عملی نیز وجود دارد:اگر تعداد کل Micro-Batchها مضربی از چهار نباشد، گروه آخر در این قطعه کد بهروزرسانی نمیشود. همچنین اگر دادهها دارای دسته ناقص باشند، تقسیم ثابت زیان بر چهار ممکن است وزندهی را نادرست کند.
برای نسخه نهایی کتاب، بهتر است از پیادهسازیای استفاده شود که تعداد واقعی نمونهها را در هر گروه انباشت محاسبه کند.
۵4.۲. پیادهسازی مقاوم در برابر دسته ناقص
در نسخه زیر، فرض شده تابع زیان میانگین روی نمونههای هر Micro-Batch را برمیگرداند. برای هر گروه انباشت، مجموع زیان نمونهها محاسبه میشود و در پایان بر تعداد واقعی نمونههای گروه تقسیم میگردد.
import torch

def train_one_epoch(model, loader, optimizer,
                    criterion, accumulation_steps=4):

    model.train()
    optimizer.zero_grad(set_to_none=True)

    accumulated_samples = 0
    accumulated_batches = 0

    def finish_accumulation():
        nonlocal accumulated_samples, accumulated_batches

        for parameter in model.parameters():
            if parameter.grad is not None:
                parameter.grad.div_(accumulated_samples)

        torch.nn.utils.clip_grad_norm_(
            model.parameters(), max_norm=1.0
        )

        optimizer.step()
        optimizer.zero_grad(set_to_none=True)

        accumulated_samples = 0
        accumulated_batches = 0

    for batch_index, (x, y) in enumerate(loader):
        output = model(x)

        # Assume loss reduction='mean' across samples.
        loss = criterion(output, y)

        batch_size = x.shape[0]

        # Accumulate the sum, not an unweighted
        # average of micro-batch means.
        (loss * batch_size).backward()

        accumulated_samples += batch_size
        accumulated_batches += 1

        if accumulated_batches == accumulation_steps:
            finish_accumulation()

    if accumulated_batches > 0:
        finish_accumulation()
این کد برای زیانهایی مناسب است که میانگین هر نمونه را برمیگردانند و هر نمونه سهم مساوی در هدف دارد. برای زیانهای دارای ماسک، توکنهای با طول متفاوت یا وزندهی نمونهها، باید مخرج نرمالسازی متناسب با تعداد عناصر معتبر یا مجموع وزنها تعیین شود.
همچنین در مدلهای دارای Batch Normalization، تساوی دقیق با Batch کامل تضمین نمیشود.
۵4.۳. چرا ترتیب Gradient Clipping مهم است؟
یکی از اشتباههای رایج این است که پس از پردازش هر Micro-Batch، گرادیان همان بخش برش داده شود و سپس گرادیانها جمع شوند.
این کار در حالت کلی با انباشت گرادیانها و انجام Clipping در پایان معادل نیست.
برای مثال، دو گرادیان تکبعدی را در نظر بگیرید:
میانگین صحیح:
اگر آستانه Clipping برابر ۵ باشد، گرادیان مؤثر برابر ۱ است و نیازی به برش ندارد.
اما اگر هر گرادیان را ابتدا جداگانه برش دهیم:
میانگین جدید:
نتیجه کاملاً متفاوت شده است.
بنابراین برای اجرای متعارف انباشت گرادیان، ترتیب مناسب چنین است:
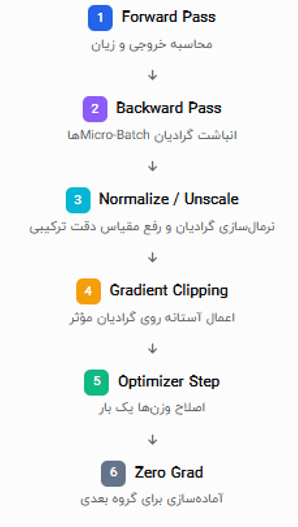
در آموزش با Mixed Precision، مرحله Unscale باید مطابق سازوکار کتابخانه و پیش از Gradient Clipping انجام شود. همچنین Learning Rate Scheduler معمولاً باید با شمارنده بهروزرسانیهای واقعی تنظیم شود، نه صرفاً تعداد Micro-Batchها؛ مگر اینکه برنامه زمانبندی عمداً تعریف دیگری داشته باشد.
۵5. جمعبندی اصلاحی و استاندارد ارزیابی نهایی
۵5.۱. معیار پذیرش مثالهای عددی
برای هر بهینهساز در نسخه نهایی کتاب، چهار کنترل باید انجام شود:
| کنترل | معیار پذیرش |
| فرمول | مطابقت با قرارداد صریح الگوریتم |
| محاسبات دستی | تطابق با اجرای عددی تا دقت گرد کردن تعیینشده |
| نمودار | استخراج از همان مقادیر محاسبهشده |
| کد | اجرای موفق و تولید خروجی قابل بازسازی |
برای مقایسه اعداد ممیز شناور، بهجای برابری دقیق باید از تلرانس مشخص استفاده شود؛ مانند:
البته تلرانس باید بر اساس مقیاس اعداد، دقت محاسبات و نوع الگوریتم انتخاب شود. برای مقادیر بسیار بزرگ یا نزدیک صفر، ترکیب تلرانس مطلق و نسبی مناسبتر است.
۵5.۲. فایل کنترل عددی مثال جدید
خروجی محاسبات:
| کمیت | مقدار |
| گرادیان Batch کامل | −۹٫۳۳۳۳۳۳ |
| گرادیان انباشته صحیح | −۹٫۳۳۳۳۳۳ |
| میانگین نادرست دستهها | −۱۱٫۵۰۰۰۰۰ |
| وزن جدید با نرخ ۰٫۱ | ۰٫۹۳۳۳۳۳ |