۱.از پیشبینی شبکه تا اندازهگیری خطا
شبکه عصبی چگونه متوجه میشود که در پیشبینی خود اشتباه کرده است؟ مهمتر از آن، چگونه میتوان میزان این اشتباه را به عددی تبدیل کرد که برای اصلاح رفتار شبکه قابل استفاده باشد؟
فرض کنید یک شرکت فروش اینترنتی برای پیشبینی تعداد سفارشهای روزانه از یک شبکه عصبی استفاده میکند.ورودی شبکه شامل فروش روزهای گذشته، قیمت محصولات، میزان تبلیغات و مناسبتهای تقویمی است.شبکه پس از پردازش اطلاعات پیشبینی میکند که فردا ۹۰ سفارش ثبت خواهد شد.
اما تعداد سفارشهای واقعی ۱۰۰ مورد است.بنابراین پیشبینی شبکه با واقعیت اختلاف دارد.
اگر تنها بدانیم شبکه اشتباه کرده است، هنوز اطلاعات کافی برای آموزش آن نداریم.باید مشخص شود خطا چه اندازهای دارد و چگونه باید جریمه شود.
اینجاست که مفهوم تابع زیان (Loss Function) وارد فرایند یادگیری میشود.
تابع زیان، خروجی پیشبینیشده شبکه و مقدار واقعی را دریافت میکند و اختلاف آنها را بر اساس یک قاعده مشخص به مقدار عددی تبدیل میکند.این مقدار، مبنای محاسبه گرادیان و اصلاح پارامترهای شبکه در فرایند آموزش خواهد بود.
شکل ۱.مسیر محاسبه زیان در آموزش شبکه عصبی
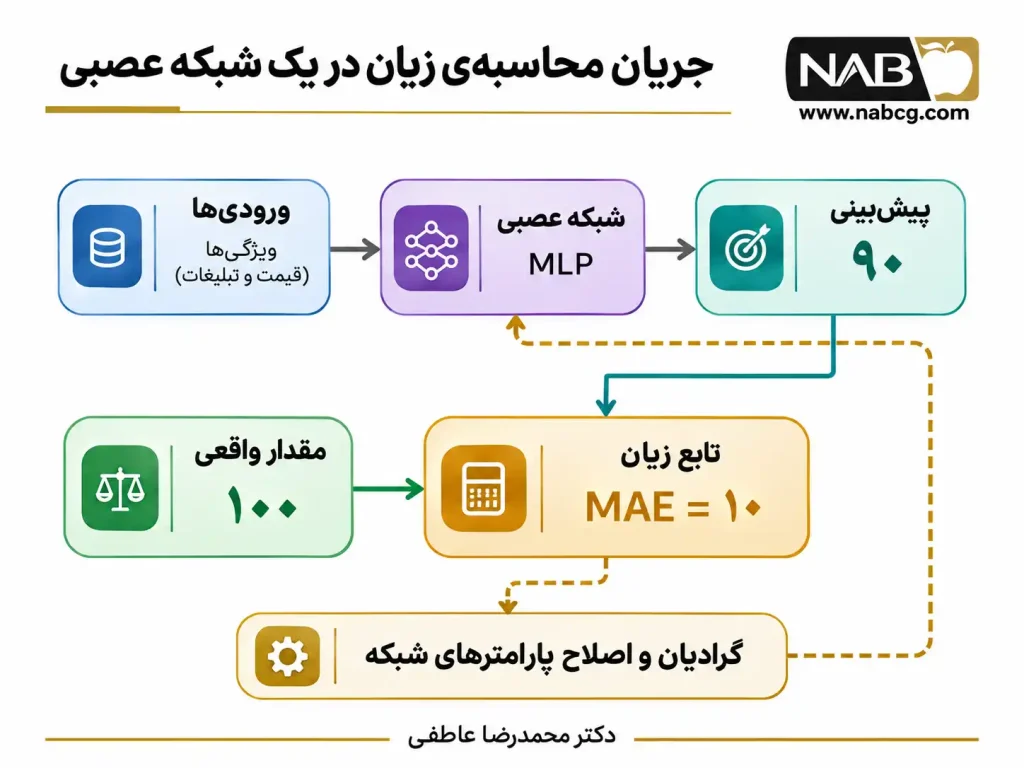
شکل ۱ ـ خروجی شبکه با مقدار واقعی مقایسه میشود.تابع زیان اندازه خطا را مشخص میکند و گرادیان آن در فرایند یادگیری به اصلاح پارامترهای شبکه کمک میکند.
انتخاب تابع زیان تنها یک تصمیم ریاضی نیست؛ بلکه تعیین میکند شبکه در هنگام یادگیری کدام خطاها را مهمتر بداند.
برای مثال، در پیشبینی فروش ممکن است بخواهیم خطاهای بزرگ شدیدتر جریمه شوند؛ اما در یک مسئله دیگر، مانند پیشبینی زمان سفر، هدف کاهش میانگین اختلاف زمانی باشد.این دو هدف لزوماً به تابع زیان یکسانی نیاز ندارند.
۱.۱.تفاوت خطا، تابع زیان و معیار ارزیابی
پیش از بررسی توابع زیان، لازم است سه مفهوم از یکدیگر تفکیک شوند.
| مفهوم | توضیح | نمونه |
| خطا (Error) | اختلاف پیشبینی با واقعیت | ۱۰ سفارش |
| تابع زیان (Loss Function) | قاعده ریاضی جریمه خطا | مربع خطا = ۱۰۰ |
| معیار ارزیابی (Evaluation Metric) | شاخص قضاوت درباره عملکرد مدل | MAE روی مجموعه آزمون |
ممکن است از MSE برای آموزش مدل استفاده کنیم، ولی کیفیت نهایی آن را با MAE و RMSE گزارش دهیم.بنابراین تابع زیان آموزش و معیار پذیرش لزوماً یکی نیستند.
۱.۲.ساختار عمومی تابع زیان
فرض کنید مجموعه داده دارای N نمونه باشد. هر نمونه شامل یک ورودی xᵢ و مقدار واقعی yᵢ است. شبکه عصبی با پارامترهای θ خروجی زیر را تولید میکند:
برای یک نمونه، تابع زیان بهصورت کلی نوشته میشود:
اگر زیان تمام نمونهها میانگین گرفته شود:
در این رابطه:
| نماد | مفهوم |
|---|---|
| xᵢ | ورودی نمونه i |
| yᵢ | مقدار واقعی |
| ŷᵢ | مقدار پیشبینیشده |
| θ | وزنها و بایاسهای شبکه |
| ℓᵢ | زیان یک نمونه |
| L(θ) | میانگین زیان مجموعه نمونهها |
| N | تعداد نمونهها |
هدف رایج در یادگیری نظارتشده، یافتن پارامترهایی است که زیان آموزش را کاهش دهند، درحالیکه عملکرد مدل روی دادههای مشاهدهنشده نیز مناسب باقی بماند.
نکته مهم این است که کوچکشدن زیان آموزش الزاماً به معنای بهترشدن تعمیمپذیری مدل نیست.به همین دلیل باید زیان آموزش، اعتبارسنجی و معیارهای آزمون بهصورت جداگانه بررسی شوند.
۲.توابع زیان رگرسیون
در مسائل رگرسیون، خروجی شبکه عصبی معمولاً عددی پیوسته است؛ مانند قیمت خانه، دمای هوا، میزان مصرف برق، مدت سفر یا حجم فروش.
تفاوت توابع زیان رگرسیون در این است که خطا را چگونه اندازهگیری و جریمه میکنند.
۲.۱.میانگین مربعات خطا (Mean Squared Error — MSE)
میانگین مربعات خطا یکی از پرکاربردترین توابع زیان رگرسیون است.ایده آن ساده است:اختلاف میان مقدار واقعی و پیشبینیشده را محاسبه میکنیم، آن را به توان دو میرسانیم و سپس از تمام مقادیر میانگین میگیریم.
در این فرمول yᵢ مقدار واقعی، ŷᵢ مقدار پیشبینیشده و N تعداد نمونههاست.
مثال عددی:پیشبینی فروش سه روز
| روز | مقدار واقعی | پیشبینی | خطا | مربع خطا |
| اول | ۱۰۰ | ۹۰ | ۱۰ | ۱۰۰ |
| دوم | ۱۲۰ | ۱۱۵ | ۵ | ۲۵ |
| سوم | ۱۵۰ | ۱۳۰ | ۲۰ | ۴۰۰ |
با جایگذاری اعداد:
بنابراین مقدار MSE برابر ۱۷۵ واحد مربعشده است.
شکل ۲ ـ نحوه جریمه خطا توسط تابع MSE
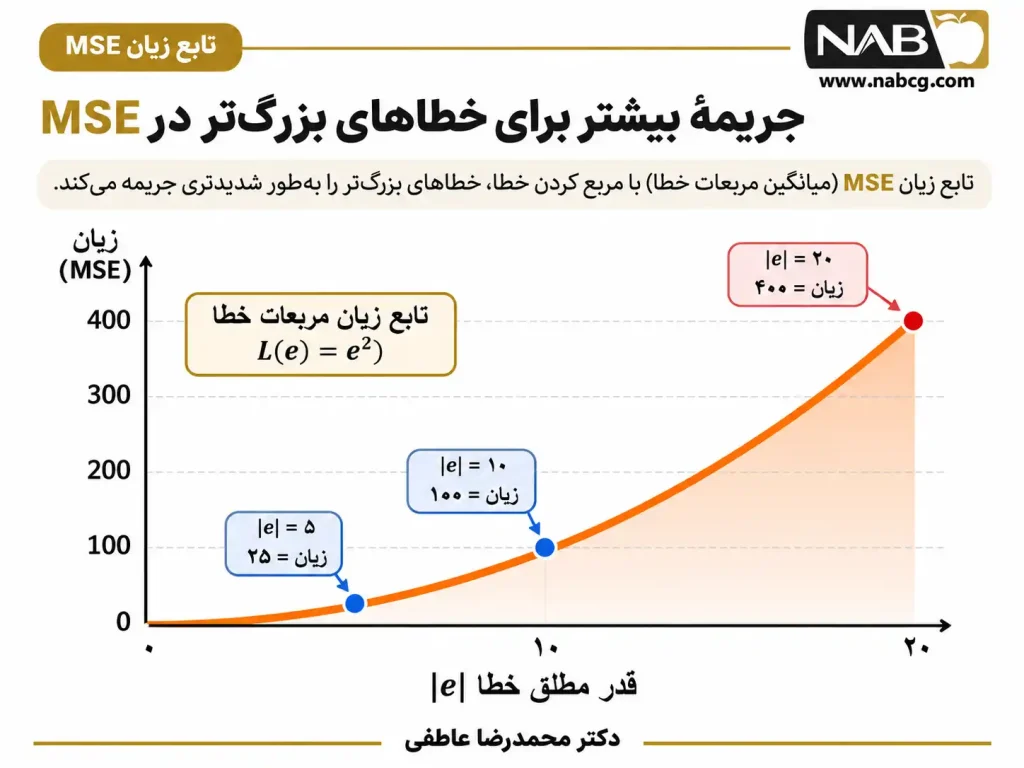
شکل ۲ ـ سهم یک نمونه با خطای ۲۰ در زیان مربعی، چهار برابر سهم نمونهای با خطای ۱۰ است.این خاصیت باعث حساسیت بیشتر MSE به خطاهای بزرگ میشود.
در چه مواردی از MSE استفاده کنیم؟
MSE در شرایطی مناسب است که خطاهای بزرگ باید نسبت به خطاهای کوچک جریمه بیشتری دریافت کنند.همچنین اگر خطاها تقریباً از یک توزیع نرمال با واریانس ثابت پیروی کنند، کمینهسازی MSE با برآورد بیشینه درستنمایی در آن مدل احتمالاتی سازگار است (Bishop, 2006).
برای مثال، در پیشبینی مصرف برق یک کارخانه، خطای بزرگ ممکن است برنامهریزی ظرفیت را مختل کند.در این شرایط، حساسیت بالای MSE میتواند مطلوب باشد.
محدودیتهای MSE
MSE نسبت به دادههای پرت حساس است و ممکن است تعداد کمی نمونه با خطای بسیار بزرگ، سهم غالبی در مقدار زیان پیدا کنند.همچنین مقدار آن به مقیاس داده وابسته است و واحد آن برابر مربع واحد متغیر هدف است.
در نتیجه، MSE دو مدل را فقط زمانی باید بهطور مستقیم مقایسه کرد که خروجیها روی مقیاس یکسان و با قرارداد محاسباتی مشابه ارزیابی شده باشند.
تفسیر و معیار پذیرش
اگر MSE برابر ۱۷۵ باشد، نمیتوان بدون دانستن مقیاس متغیر هدف و مدل مرجع آن را خوب یا بد دانست.
فرض کنید MSE یک مدل ساده مرجع روی دادههای آزمون برابر ۲۵۰ و MSE شبکه جدید برابر ۱۷۵ باشد.
در این صورت:
شبکه جدید نسبت به مدل مرجع، ۳۰ درصد کاهش MSE داشته است.
با این حال، پذیرش عملی مدل باید بر اساس محدودیتهای کسبوکار و دادههای آزمون تعیین شود.برای مثال، اگر سقف مجاز RMSE برابر ۱۵ واحد فروش باشد:
مدل این شرط فرضی را رعایت میکند؛ ولی همچنان ممکن است بررسی بیشینه خطا یا عملکرد در روزهای پرترافیک ضروری باشد.
۲.۲.میانگین قدرمطلق خطا (Mean Absolute Error — MAE)
تابع MSE خطاهای بزرگ را با شدت بیشتری جریمه میکند.اما آیا همیشه یک خطای ۲۰ واحدی باید چهار برابر خطای ۱۰ واحدی اهمیت داشته باشد؟
خیر.در بسیاری از مسائل، هزینه خطا تقریباً متناسب با اندازه آن افزایش مییابد.در چنین شرایطی، میانگین قدرمطلق خطا یا MAE انتخاب مناسبی است.
در MAE، ابتدا قدرمطلق اختلاف میان مقدار واقعی و پیشبینیشده محاسبه میشود و سپس میانگین این اختلافها به دست میآید.
قدر مطلق باعث میشود که خطاهای مثبت و منفی یکدیگر را خنثی نکنند.
مثال عددی:پیشبینی فروش
همان اطلاعات مثال قبل را در نظر میگیریم تا بتوانیم رفتار دو تابع را مستقیماً بررسی کنیم.
این نتیجه نشان میدهد میانگین اندازه خطای پیشبینی برابر ۱۱٫۶۷ واحد فروش است.
در این مثال، MSE برابر ۱۷۵ و MAE برابر ۱۱٫۶۷ است.با این حال، مقایسه مستقیم بزرگی این دو عدد صحیح نیست؛ زیرا واحد MSE مربع واحد فروش، ولی واحد MAE همان واحد فروش است.
شکل ۳ ـ مقایسه رفتار MAE و MSE نسبت به اندازه خطا
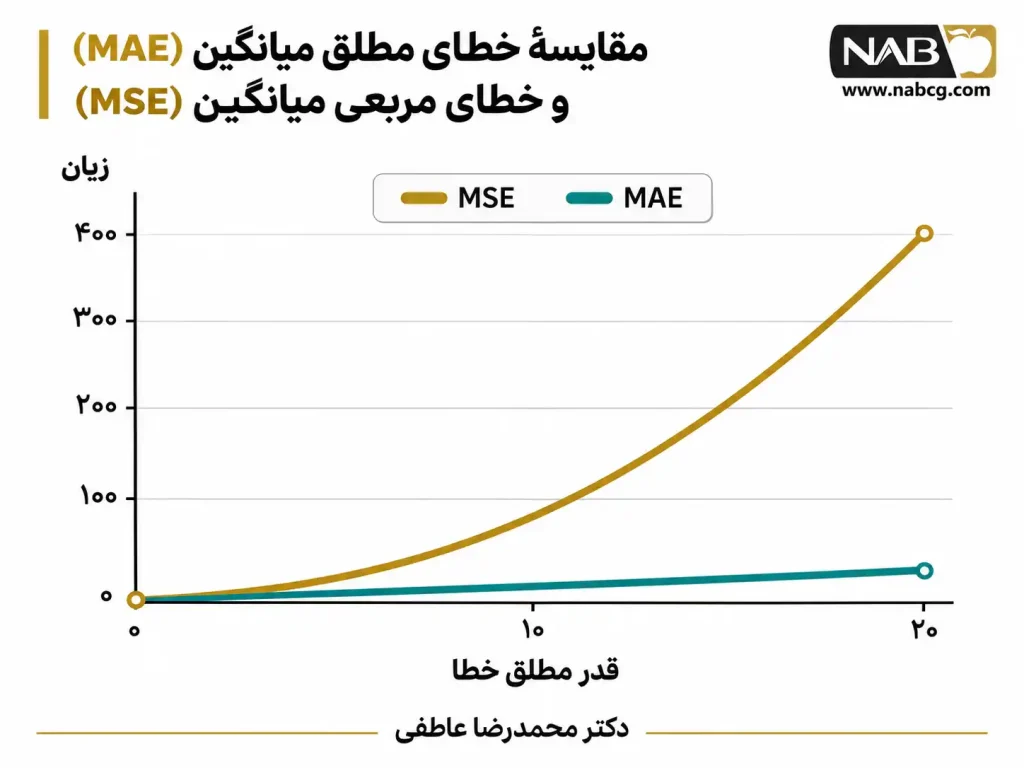
شکل ۳ ـ MSE بهصورت درجهدوم رشد میکند، اما MAE رشد خطی دارد.منحنیها برای خطای یک نمونه رسم شدهاند؛ مقیاس عمودی مشترک صرفاً رفتار ریاضی دو تابع را نمایش میدهد.
در چه مواردی از MAE استفاده کنیم؟
فرض کنید یک شرکت حملونقل میخواهد مدت رسیدن سفارشها را پیشبینی کند.در این کاربرد، خطای ۱۰ دقیقهای ممکن است تقریباً دو برابر خطای ۵ دقیقهای نامطلوب باشد.
MAE در چنین حالتی انتخابی طبیعی است؛ زیرا هر دقیقه خطای اضافی، سهم یکسانی در مقدار زیان دارد.
همچنین MAE در شرایطی که مجموعه داده دارای تعدادی مقدار پرت باشد، معمولاً نسبت به MSE مقاومتر است.
از دیدگاه آماری، کمینهسازی امید ریاضی خطای قدرمطلق با برآورد میانه شرطی مرتبط است؛ درحالیکه کمینهسازی خطای مربعی با میانگین شرطی ارتباط دارد (Hastie et al., 2009).
محدودیتهای MAE
مهمترین محدودیت آن این است که میان خطای نسبتاً بزرگ و خطای بسیار بزرگ، تفاوت جریمه متناسب با اندازه خطا باقی میماند.بنابراین اگر پیامد خطاهای بزرگ بهشدت افزایش پیدا کند، MAE ممکن است هدف مناسبی برای یادگیری نباشد.
علاوه بر این، تابع قدرمطلق در خطای صفر مشتق کلاسیک ندارد؛ هرچند استفاده از زیرگرادیان، بهینهسازی آن را ممکن میکند.
تفسیر نتایج و معیار پذیرش
فرض کنید در یک سامانه پیشبینی زمان رسیدن سفارشها، MAE برابر ۴ دقیقه و MAE مدل مرجع برابر ۶ دقیقه باشد.
مدل جدید میانگین خطای مطلق کمتری دارد.
اما آیا برای استفاده عملی پذیرفتنی است؟
فرض کنیم شرکت دو شرط تعیین کرده است:MAE حداکثر ۵ دقیقه و صدک ۹۵ خطای مطلق حداکثر ۱۲ دقیقه باشد.
| معیار | نتیجه مدل | حد مجاز فرضی | ارزیابی |
| MAE | ۴ دقیقه | ۵ دقیقه | پذیرفته |
| صدک ۹۵ خطای مطلق | ۱۵ دقیقه | ۱۲ دقیقه | رد |
پس مدل باوجود MAE مناسب، هنوز همه الزامات عملیاتی را برآورده نمیکند.
این مثال یک اصل مهم را روشن میکند:مقدار مطلوب تابع زیان، شرط کافی برای پذیرش مدل نیست.
۲.۳.تابع Huber؛ ایجاد تعادل میان حساسیت و مقاومت
MSE نسبت به خطاهای بزرگ حساس است؛ MAE تأثیر آنها را بهصورت خطی افزایش میدهد.در برخی مسائل، ترکیبی از این دو رفتار مطلوبتر است.
تابع Huber که توسط Huber (1964) معرفی شد، برای خطاهای کوچک رفتار مربعی و برای خطاهای بزرگ رفتار خطی دارد.
در این رابطه، e = y − ŷ خطای پیشبینی و δ > ۰ آستانه تغییر رفتار تابع است.
مثال عددی:پیشبینی قیمت
فرض کنید سه خطای پیشبینی برابر با ۱، ۲ و ۸ واحد باشد و δ = ۲ انتخاب شود.
برای خطای ۱:
برای خطای ۲:
برای خطای ۸:
در نتیجه:
برای مقایسه، MSE همین سه نمونه برابر ۲۳ و MAE برابر ۳٫۶۷ است.این مقادیر بر اساس قواعد ریاضی متفاوتی محاسبه شدهاند و نباید فقط با بزرگی عددی آنها درباره کیفیت مدل قضاوت کرد.
نمودار تعاملی تابع Huber
با جابهجا کردن آستانه (δ)، تفاوت رفتار مربعی و خطی را مشاهده کنید.
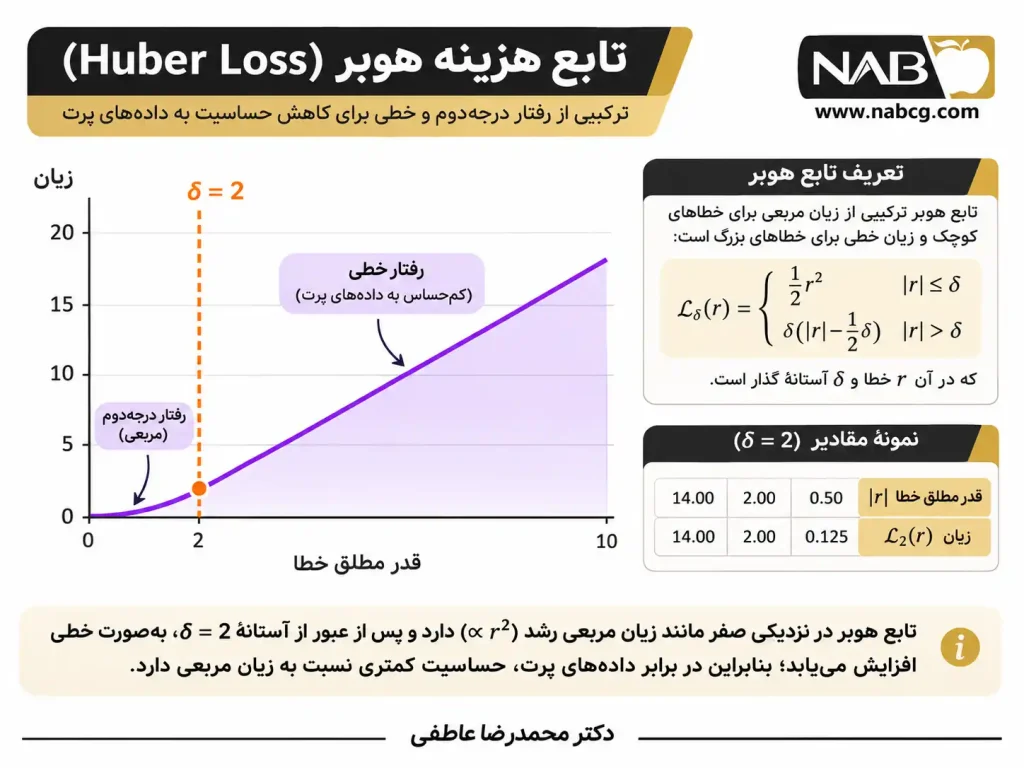
شکل ۴ ـ سمت چپ آستانه رفتار مربعی دارد و پس از عبور از آستانه، زیان بهصورت خطی افزایش مییابد.تغییر (δ) مقدار زیان و حساسیت تابع را تغییر میدهد.
موارد استفاده و محدودیتها
Huber برای رگرسیونی مناسب است که در آن بیشتر دادهها خطاهای معمول دارند، اما تعدادی مشاهده پرت نیز وجود دارد؛ مانند پیشبینی قیمت محصولات با تغییرات غیرمنتظره بازار یا دادههای حسگر دارای اختلال.
مهمترین محدودیت، انتخاب آستانه (δ) است.این مقدار باید متناسب با مقیاس خطا و ویژگی دادههای مسئله تعیین شود.انتخاب نامناسب آن میتواند مزیت موردنظر را کاهش دهد.
تفسیر و معیار پذیرش
مقدار Huber Loss هرچه کمتر باشد، از دید همان تابع مطلوبتر است؛ اما مقدار ۵٫۵ بهتنهایی مبنای پذیرش نیست.
برای ارزیابی میتوان زیان Huber مدل را روی داده آزمون با مدل مرجع و با همان (δ) مقایسه کرد.در کنار آن، MAE، RMSE و خطاهای شدید نیز باید بررسی شوند.
برای مثال، اگر مدل جدید هم Huber Loss کمتری داشته باشد و هم صدک ۹۵ خطای مطلق آن زیر سقف عملیاتی تعیینشده قرار گیرد، شواهد قویتری برای پذیرش فراهم میشود.
۲.۴.تابع زیان Smooth L1؛ کنترل خطاهای بزرگ با یک تابع هموار
تابع زیان Smooth L1 برای ترکیب رفتار مربعی در نزدیکی خطای صفر و رفتار خطی در خطاهای بزرگ استفاده میشود.این ویژگی باعث میشود در برخی مسائل رگرسیون، بهویژه مکانیابی اشیا در تصاویر، انتخاب مناسبی باشد.
این تابع شباهت زیادی به Huber دارد؛ اما نحوه مقیاسبندی آن متفاوت است.
۲.۴.۱.فرمول ریاضی و تعریف پارامترها
در قرارداد رایج PyTorch، تابع Smooth L1 با پارامتر مثبت (β) بهصورت زیر تعریف میشود:
که در آن:
| نماد | مفهوم |
|---|---|
| e | اختلاف مقدار واقعی و پیشبینیشده |
| β | آستانه تغییر رفتار مربعی به خطی |
| L_β(e) | زیان یک نمونه؛ β بهصورت اندیس زیر L است |
| |e| | اندازه خطا بدون توجه به علامت آن |
برای (β>0)، رابطه این تابع با Huber چنین است:
بنابراین، دو تابع در این قرارداد از نظر محل تغییر رفتار مشابهاند، ولی اندازه زیان و گرادیان آنها یکسان نیست.
۲.۴.۲.مثال عددی:پیشبینی مختصات یک شیء
فرض کنید شبکهای باید موقعیت یک قطعه را در تصویر تشخیص دهد.اختلاف مختصات پیشبینیشده با مختصات واقعی برای سه نمونه برابر است با:
آستانه را برابر (β=1) قرار میدهیم.
برای نمونه اول:
برای نمونه دوم:
برای نمونه سوم:
در نتیجه میانگین زیان برابر است با:
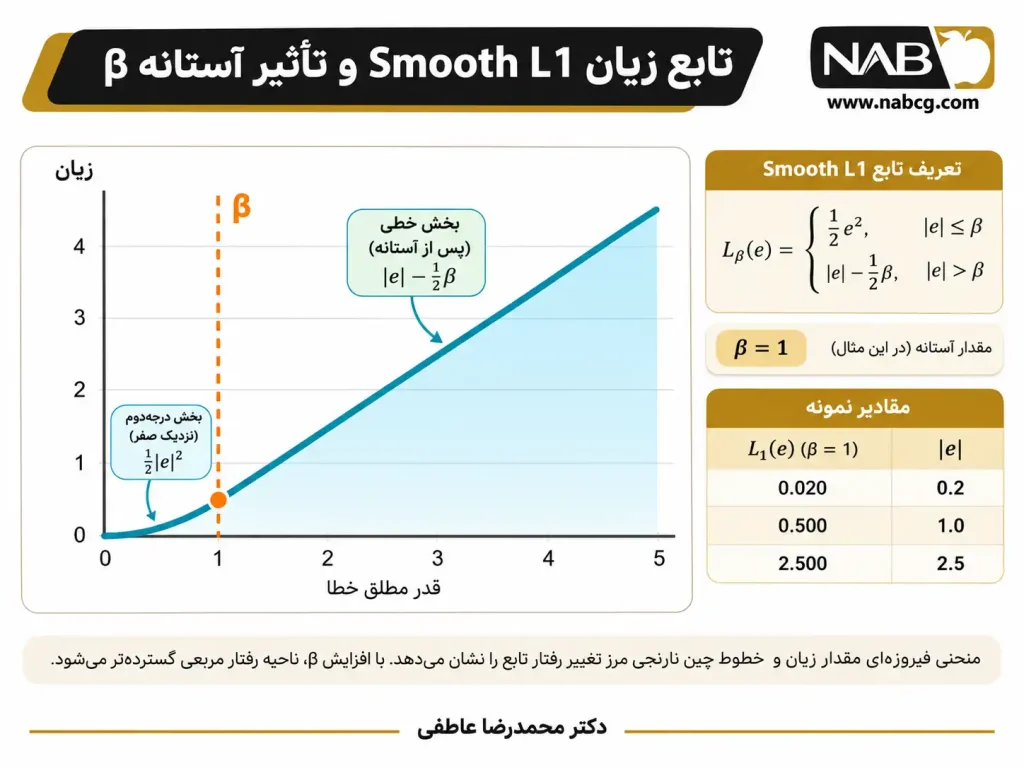
این مثال نشان میدهد که برای خطاهای بزرگتر از آستانه، زیان با نرخ ثابت افزایش مییابد؛ برخلاف MSE که نرخ رشد آن پیوسته بزرگتر میشود.
۲.۴.۳.نمودار تابع Smooth L1
۲.۴.۴.موارد استفاده و محدودیتها
Smooth L1 بهویژه در رگرسیون مختصات جعبههای محدودکننده اشیا (Bounding Box Regression) کاربرد دارد.همچنین در مسائل تخمین موقعیت و رگرسیون دارای مشاهدات پرت میتواند مفید باشد.
محدودیت اصلی آن وابستگی به انتخاب (β) است.اگر پارامتر آستانه متناسب با مقیاس مختصات یا خطای مورد انتظار تنظیم نشود، رفتار تابع ممکن است با هدف مسئله مطابقت نداشته باشد.
همچنین Smooth L1 جایگزین مناسبی برای همه توابع مکانیابی اشیا نیست؛ زیرا هنگام آموزش یک جعبه محدودکننده، خطای مستقل مختصات الزاماً کیفیت همپوشانی هندسی آن جعبه را بهخوبی توصیف نمیکند.
۲.۴.۵.تفسیر نتایج و معیار پذیرش
مقدار صفر به معنای انطباق کامل پیشبینی با مقدار هدف است.مقدار بزرگتر نشاندهنده اختلاف بیشتر بر اساس این تابع است.
اما زیان Smooth L1 بهتنهایی معیاری برای پذیرفتن مکانیابی شیء نیست.در تشخیص اشیا باید از معیارهایی مانند IoU، دقت تشخیص و عملکرد روی مجموعه آزمون نیز استفاده کرد.
برای نمونه، اگر شرط پروژه IoU حداقل ۰٫۷۵ باشد، مدل فقط زمانی این شرط را برآورده میکند که جعبه پیشبینیشده همپوشانی لازم را داشته باشد؛ حتی اگر Smooth L1 آن کوچک باشد.
۲.۵.ریشه میانگین مربعات خطا (Root Mean Squared Error — RMSE)
یکی از محدودیتهای MSE این است که واحد آن برابر مربع واحد متغیر هدف است.اگر شبکه دما را بر حسب درجه سانتیگراد پیشبینی کند، MSE بر حسب درجه سانتیگراد مربعشده گزارش میشود.
برای بازگرداندن مقدار خطا به مقیاس متغیر اصلی، از RMSE استفاده میکنیم.
۲.۵.۱.فرمول ریاضی
به عبارت ساده:
بنابراین RMSE یک تابع کاملاً مستقل از MSE نیست، بلکه تبدیل یکنوای آن است.
۲.۵.۲.مثال عددی:پیشبینی دمای گلخانه
یک شبکه عصبی، دمای چهار ساعت آینده گلخانه را پیشبینی کرده است.
| ساعت | دمای واقعی | پیشبینی | خطا | مربع خطا |
| ۱ | ۲۰ | ۱۹ | ۱ | ۱ |
| ۲ | ۲۲ | ۲۴ | ۲− | ۴ |
| ۳ | ۲۱ | ۲۰ | ۱ | ۱ |
| ۴ | ۲۵ | ۲۲ | ۳ | ۹ |
تمام دماها بر حسب درجه سانتیگراد هستند.
ابتدا MSE محاسبه میشود:
سپس:
پس RMSE مدل حدود ۱٫۹۴ درجه سانتیگراد است.
۲.۵.۳.نمودار مقایسه دمای واقعی و پیشبینیشده
شکل ۶ ـ اختلاف دمای واقعی و پیشبینی شبکه
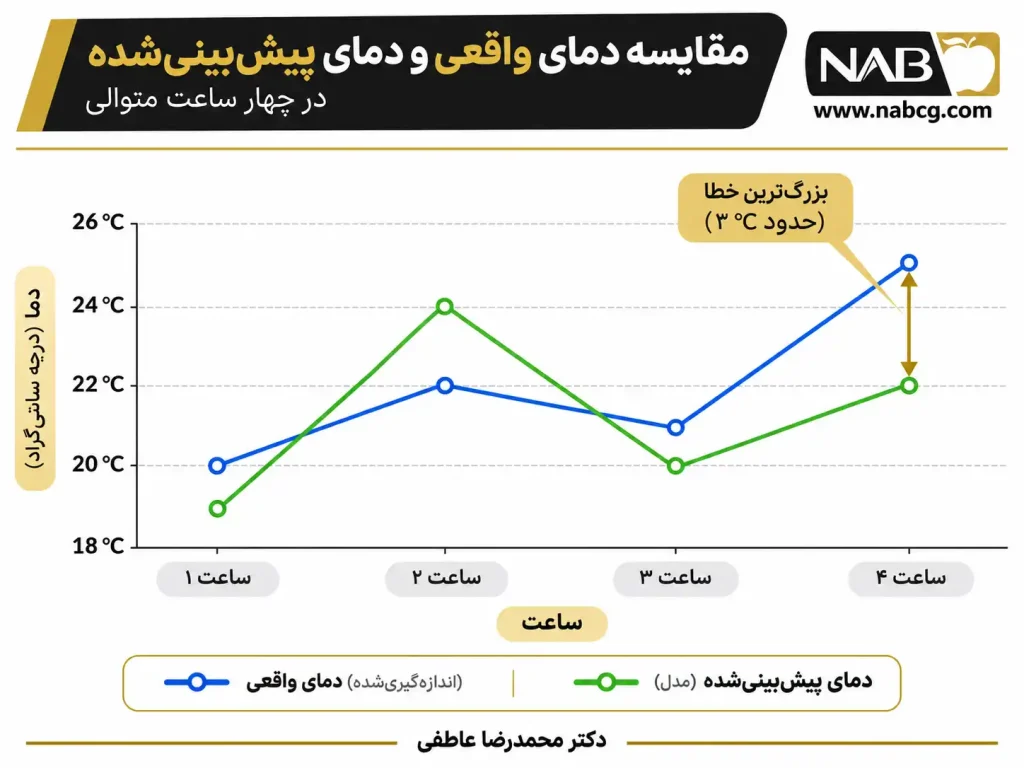
نمودار تغییرات دمای واقعی و پیشبینیشده؛ بیشترین خطای مطلق مربوط به ساعت چهارم و برابر ۳ درجه سانتیگراد است.
نمودار نشان میدهد که شبکه در ساعت دوم دما را بیشبرآورد و در سه ساعت دیگر کمبرآورد کرده است.RMSE اندازه خطاها را منعکس میکند، اما جهت بیشبرآورد یا کمبرآورد را بهتنهایی مشخص نمیکند.
۲.۵.۴.موارد استفاده و محدودیتها
RMSE در پیشبینی دما، مصرف انرژی، قیمت، بار شبکه برق و سایر مسائل رگرسیون کاربرد دارد.مهمترین مزیت آن امکان گزارش اندازه خطا در واحد اصلی متغیر هدف است.
این تابع مانند MSE به خطاهای بزرگ حساس است.همچنین مقدار RMSE نشاندهنده بیشینه خطا نیست؛ برای مثال، RMSE برابر ۱٫۹۴ درجه مانع از وجود پیشبینیهایی با خطای بیش از ۳ درجه نمیشود.
۲.۵.۵.تفسیر نتایج و معیار پذیرش
فرض کنیم در این گلخانه، بر اساس الزامات کنترل دما، RMSE حداکثر ۲ درجه سانتیگراد تعریف شده است.
نتیجه مدل برابر ۱٫۹۴ درجه است؛ بنابراین شرط RMSE را برآورده میکند.
اما اگر یکی از محصولات نسبت به تغییرات ناگهانی دما حساس باشد، ممکن است لازم باشد شرط دیگری مانند بیشینه خطای مطلق کمتر از ۲٫۵ درجه نیز برقرار باشد.
در دادههای این مثال، بیشینه خطای مطلق برابر ۳ درجه است؛ بنابراین مدل شرط دوم را رعایت نمیکند.
در چنین شرایطی، پذیرش یا رد مدل باید بر اساس مجموعه الزامات فنی صورت گیرد، نه تنها یک شاخص.
۲.۶.تابع زیان Log-Cosh؛ تقریب هموار خطای مطلق
در MAE، خطا بهصورت خطی جریمه میشود، اما تابع قدرمطلق در صفر مشتقپذیر نیست.از سوی دیگر، MSE تابعی هموار است ولی به خطاهای بسیار بزرگ حساسیت زیادی دارد.
یکی از راهحلهای ممکن، استفاده از تابع زیان لگاریتم کسینوس هذلولوی (Log-Cosh Loss) است.این تابع برای خطاهای کوچک رفتاری تقریباً مربعی و برای خطاهای بزرگ رفتاری تقریباً خطی دارد.
۲.۶.۱.فرمول و تعریف پارامترها
در این رابطه:
• yᵢ: مقدار واقعی نمونه
• ŷᵢ: مقدار پیشبینیشده
• N: تعداد نمونهها
• cosh: تابع کسینوس هذلولوی
• log: لگاریتم طبیعی
تابع کسینوس هذلولوی برابر است با:
در این فرمول، e در توان نمایی، نماد خطای پیشبینی است. برای جلوگیری از اشتباه با عدد اویلر، میتوان تابع را بر حسب r = y − ŷ نوشت:
نزدیک صفر، تقریب زیر برقرار است:
و برای خطاهای بزرگ:
این دو رابطه علت رفتار ترکیبی Log-Cosh را توضیح میدهند.
۲.۶.۲.مثال عددی:پیشبینی زمان انجام یک فعالیت
فرض کنید شبکه عصبی مدت انجام سه فعالیت صنعتی را پیشبینی کرده و خطاهای آن بهترتیب برابر ۰، ۱ و ۲ دقیقه باشد.
برای خطای صفر:
برای خطای ۱:
برای خطای ۲:
بنابراین:
اگر در همین مثال از MSE استفاده کنیم:
این اختلاف عددی به معنای بهتر بودن Log-Cosh نیست؛ زیرا هر تابع خطاها را با مقیاس و قاعده متفاوتی اندازه میگیرد.
۲.۶.۳.نمودار مقایسه Log-Cosh، MAE و MSE
شکل ۷ ـ رفتار سه تابع در خطاهای کوچک و بزرگ
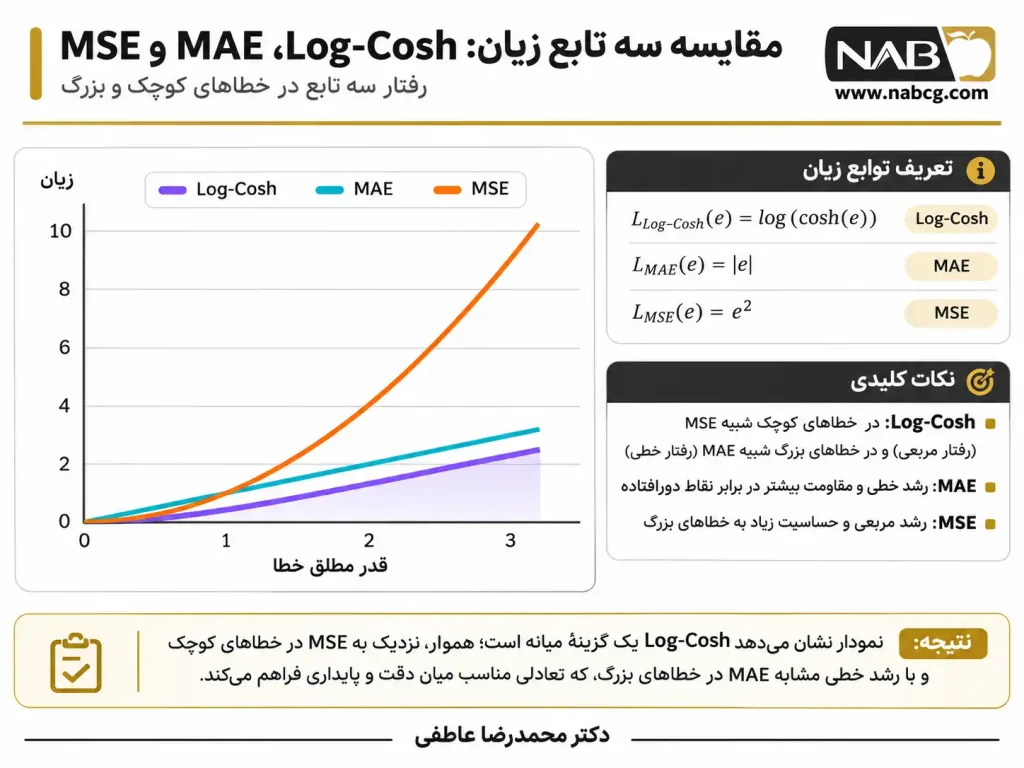
شکل ۷ ـ نمودار زیان یک نمونه.منحنی بنفش Log-Cosh هموار است؛ منحنی نارنجی MSE رشد درجهدوم و منحنی فیروزهای MAE رشد خطی دارد.توابع با مقیاس ریاضی خودشان نمایش داده شدهاند.
۲.۶.۴.موارد استفاده و محدودیتها
Log-Cosh زمانی قابل بررسی است که مسئله از نوع رگرسیون باشد و بخواهیم تابع هدف در تمام نقاط هموار بماند، اما حساسیت آن به خطاهای بزرگ از MSE کمتر باشد.
برای مثال، در پیشبینی خروجی حسگرهای صنعتی، احتمال دارد تعدادی اندازهگیری غیرعادی وجود داشته باشد.Log-Cosh میتواند اثر این موارد را در مقایسه با MSE کاهش دهد.
با این حال، چند محدودیت باید در نظر گرفته شود.نخست اینکه انتخاب Log-Cosh تضمین نمیکند مدل از نظر دقت یا تعمیم بهتر از Huber باشد.دوم اینکه اگر واحد خطا بسیار بزرگ یا کوچک باشد، مقیاسبندی آن بر رفتار مؤثر تابع اثر میگذارد.سوم اینکه محاسبه مستقیم (cosh(r)) برای خطاهای بسیار بزرگ میتواند سرریز عددی ایجاد کند.
برای پیادهسازی پایدارتر میتوان از رابطه زیر استفاده کرد:
۲.۶.۵.تفسیر نتایج و معیار پذیرش
Log-Cosh غیرمنفی است و کمترین مقدار آن صفر است.صفر زمانی به دست میآید که تمامی پیشبینیها با اهداف متناظر برابر باشند.
مقدار ۰٫۵۸۶۳ در مثال ما فقط اندازه زیان طبق همین تابع را مشخص میکند.برای پذیرش مدل باید نتیجه را با مقدار زیان مدل مرجع، MAE یا RMSE و الزامات عملیاتی مقایسه کرد.
فرض کنید شرط یک سامانه صنعتی MAE کمتر از ۱٫۵ دقیقه باشد.اگر مدل آموزشدیده با Log-Cosh روی دادههای آزمون MAE برابر ۱٫۲ دقیقه تولید کند، آن شرط را رعایت میکند؛ حتی اگر تابع آموزش آن MAE نبوده باشد.
۲.۷.میانگین مربعات خطای لگاریتمی (MSLE)
در برخی مسائل، تفاوت نسبی میان مقادیر از اختلاف مطلق مهمتر است.
برای مثال، خطای ۱۰ واحدی در پیشبینی فروش محصولی که روزانه ۲۰ واحد فروش دارد، بسیار مهمتر از همان خطای ۱۰ واحدی برای محصولی با فروش روزانه ۱۰ هزار واحد است.
تابع Mean Squared Logarithmic Error یا MSLE میتواند در چنین موقعیتهایی مفید باشد.
۲.۷.۱.فرمول و پارامترها
فرض میکنیم:
جمله (1+) باعث میشود مقدار صفر نیز بدون مشکل وارد لگاریتم شود.
تفاوت لگاریتمها را میتوان به شکل نسبت نوشت:
پس MSLE بهجای اختلاف مستقیم مقادیر، اختلاف در مقیاس لگاریتمی را جریمه میکند.
۲.۷.۲.مثال عددی:پیشبینی فروش دو محصول
دو محصول با حجم فروش کاملاً متفاوت را در نظر بگیرید.
| محصول | فروش واقعی | پیشبینی | خطای مطلق |
| A | ۱۰ | ۲۰ | ۱۰ |
| B | ۱۰۰۰ | ۱۰۱۰ | ۱۰ |
در هر دو محصول، خطای مطلق برابر ۱۰ است.بنابراین MAE این دو نمونه برابر ۱۰ خواهد بود.
اما در MSLE:
برای محصول A:
برای محصول B:
در نتیجه:
مشاهده میکنیم با وجود یکسان بودن خطای مطلق، سهم محصول A در MSLE بسیار بیشتر است؛ زیرا اختلاف آن در مقایسه با مقیاس فروش محصول بزرگتر است.
۲.۷.۳.نمودار مقایسه سهم خطاها
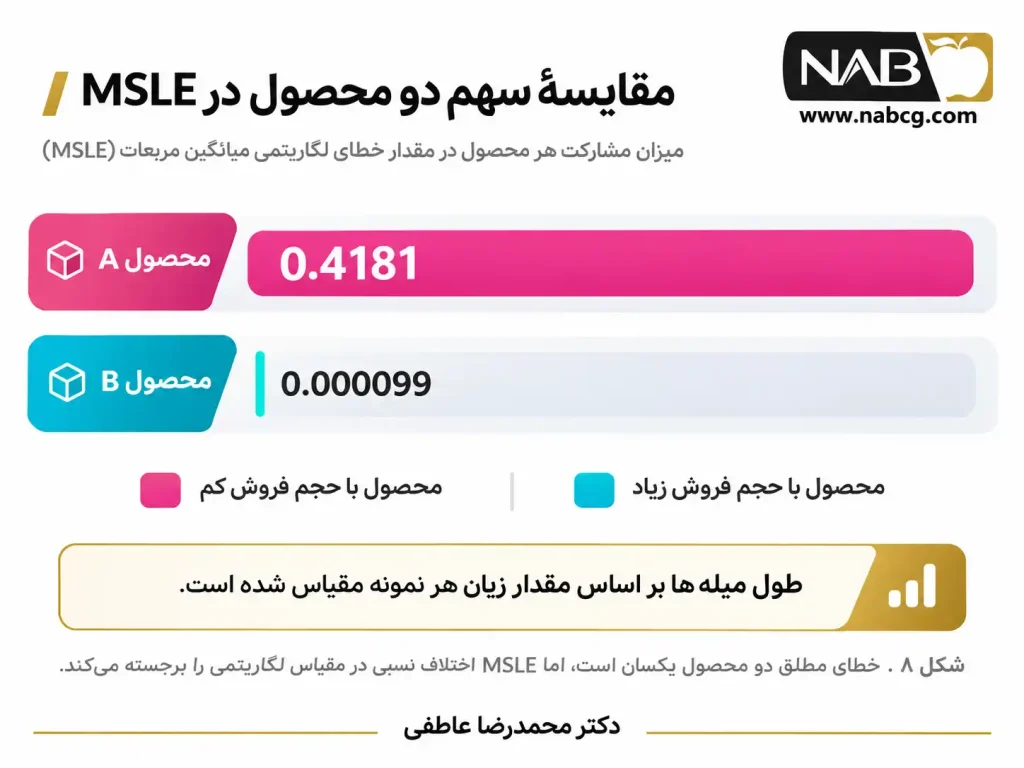
شکل ۸ ـ خطای مطلق دو محصول یکسان است، اما MSLE اختلاف نسبی در مقیاس لگاریتمی را برجسته میکند.
۲.۷.۴.موارد استفاده و محدودیتها
MSLE برای پیشبینی متغیرهای غیرمنفی با دامنه مقادیر گسترده، مانند میزان فروش، تعداد بازدید یا تقاضا، قابل بررسی است؛ بهویژه زمانی که اختلافهای نسبی یا چندبرابری از اختلافهای مطلق مهمتر باشند.
اما MSLE محدودیتهایی دارد.در تعریف فوق مقادیر کمتر از صفر مجاز نیستند.همچنین این تابع عموماً به پیشبینی کمتر و بیشتر از واقعیت با خطای مطلق یکسان، زیان یکسانی نمیدهد؛ بنابراین نباید آن را کاملاً متقارن فرض کرد.
افزون بر این، افزودن عدد ۱ به دادهها بر نحوه رفتار تابع نزدیک صفر اثر میگذارد.در نتیجه MSLE دقیقاً معادل مربع درصد خطا نیست.
۲.۷.۵.تفسیر و معیار پذیرش
MSLE غیرمنفی است و مقدار صفر نشاندهنده پیشبینی کاملاً درست است.
مقدار MSLE را میتوان با مدل مرجع در همان مجموعه آزمون مقایسه کرد.برای پذیرش عملی، اگر تصمیم تجاری به خطای نسبی وابسته است، بهتر است علاوه بر MSLE، معیارهای متناسب با هزینه کسبوکار نیز بررسی شوند.
برای مثال، یک فروشگاه ممکن است شرط کند که برای محصولات پرتقاضا، درصد معینی از پیشبینیها در فاصله قابلقبول از مقدار واقعی قرار گیرند.MSLE بهتنهایی تحقق چنین شرطی را تضمین نمیکند.
۲.۸.میانگین قدرمطلق درصد خطا (Mean Absolute Percentage Error — MAPE)
مدیران و تصمیمگیرندگان در بسیاری از پروژهها ترجیح میدهند میزان خطا را بهصورت درصد مشاهده کنند.
برای مثال، گفتن اینکه «مدل در پیشبینی فروش بهطور میانگین ۸ درصد خطا داشته است» ممکن است از گزارش یک عدد خام قابلفهمتر باشد.
تابع MAPE برای اندازهگیری میانگین خطای مطلق نسبت به مقدار واقعی استفاده میشود.
۲.۸.۱.فرمول ریاضی
در این رابطه (y_i) نباید صفر باشد.عامل ۱۰۰ برای گزارش خروجی بهصورت درصد است.
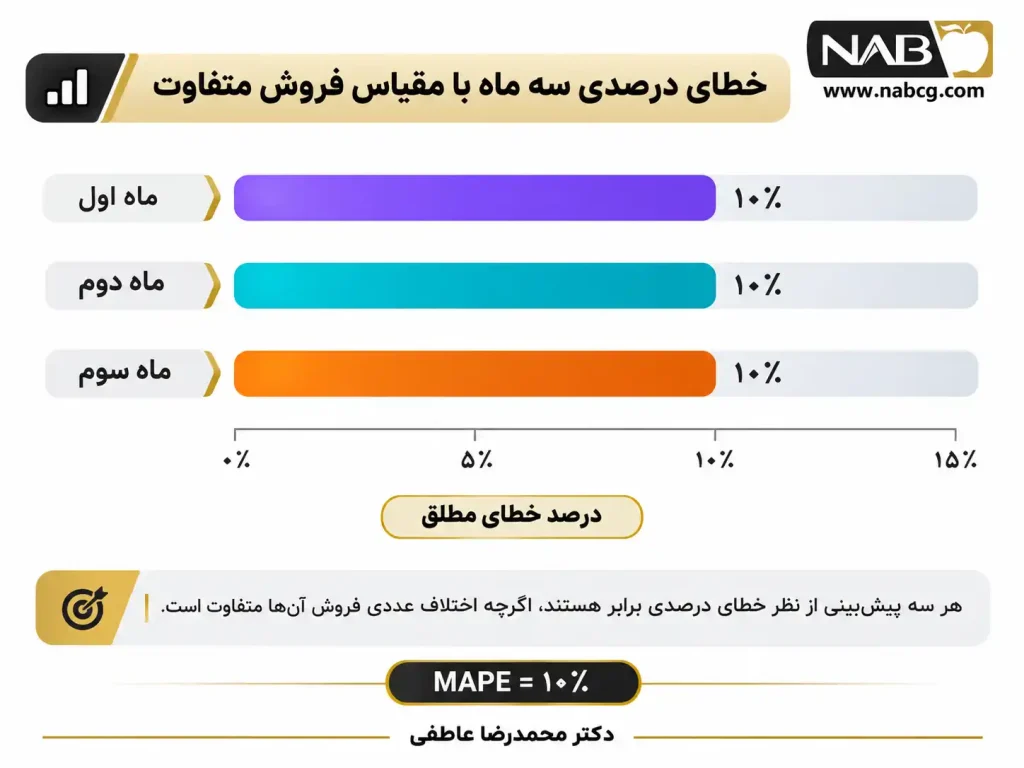
۲.۸.۲.مثال عددی:پیشبینی فروش ماهانه
| ماه | فروش واقعی | فروش پیشبینیشده | درصد خطای مطلق |
| اول | ۱۰۰ | ۹۰ | ۱۰٪ |
| دوم | ۲۰۰ | ۲۲۰ | ۱۰٪ |
| سوم | ۴۰۰ | ۳۶۰ | ۱۰٪ |
برای نمونه اول:
برای نمونه دوم:
برای نمونه سوم:
در نتیجه:
۲.۸.۳.نمودار خطای درصدی
۲.۸.۴.موارد استفاده و محدودیتها
MAPE برای گزارش خطای نسبی در پیشبینی فروش، تقاضا و سایر مقادیر با مقدار واقعی مثبت و دور از صفر مناسب است.
اما این تابع دو محدودیت مهم دارد.نخست اینکه اگر مقدار واقعی صفر باشد، فرمول تعریفنشده است.دوم اینکه وقتی مقدار واقعی بسیار به صفر نزدیک شود، خطای درصدی میتواند بسیار بزرگ شود و نتیجه را تحتتأثیر قرار دهد.
همچنین MAPE در مقایسه پیشبینی کمتر و بیشتر از واقعیت کاملاً متقارن نیست و ممکن است در برخی مسائل تمایل به کمبرآورد ایجاد کند.
۲.۸.۵.تفسیر نتایج و معیار پذیرش
MAPE برابر ۱۰ درصد به معنی آن است که میانگین قدرمطلق خطای نسبی نمونهها برابر ۱۰ درصد بوده است.
این عدد به معنای قرار داشتن همه پیشبینیها در فاصله ۱۰ درصد از واقعیت نیست.
اگر سازمان برای یک کاربرد مشخص، MAPE حداکثر ۸ درصد تعیین کرده باشد، مدل مثال ما شرط پذیرش را رعایت نمیکند.این آستانه باید بر اساس نیاز واقعی کاربرد تعیین شود و نباید بهعنوان یک استاندارد جهانی معرفی شود.
۲.۹.میانگین متقارن درصد خطای مطلق (Symmetric MAPE — sMAPE)
برای کاهش برخی مشکلات MAPE، معیار دیگری با عنوان sMAPE معرفی شده است.
یکی از تعریفهای متداول آن عبارت است از:
این تعریف باید همراه با قرارداد برخورد با مخرج صفر ارائه شود؛ زیرا وقتی مقدار واقعی و پیشبینی هر دو صفر باشند، عبارت تعریفنشده است.
۲.۹.۱.مثال عددی:مقایسه پیشبینی کمتر و بیشتر از واقعیت
فرض کنید مقدار واقعی فروش ۱۰۰ واحد است.
مدل اول مقدار ۸۰ و مدل دوم مقدار ۱۲۰ را پیشبینی میکند.
برای مدل اول:
برای مدل دوم:
با وجود یکسان بودن خطای مطلق، مقدار sMAPE این دو مدل متفاوت است.
شکل ۱۰ ـ مقایسه خطای کمترپیشبینی و بیشترپیشبینی در sMAPE
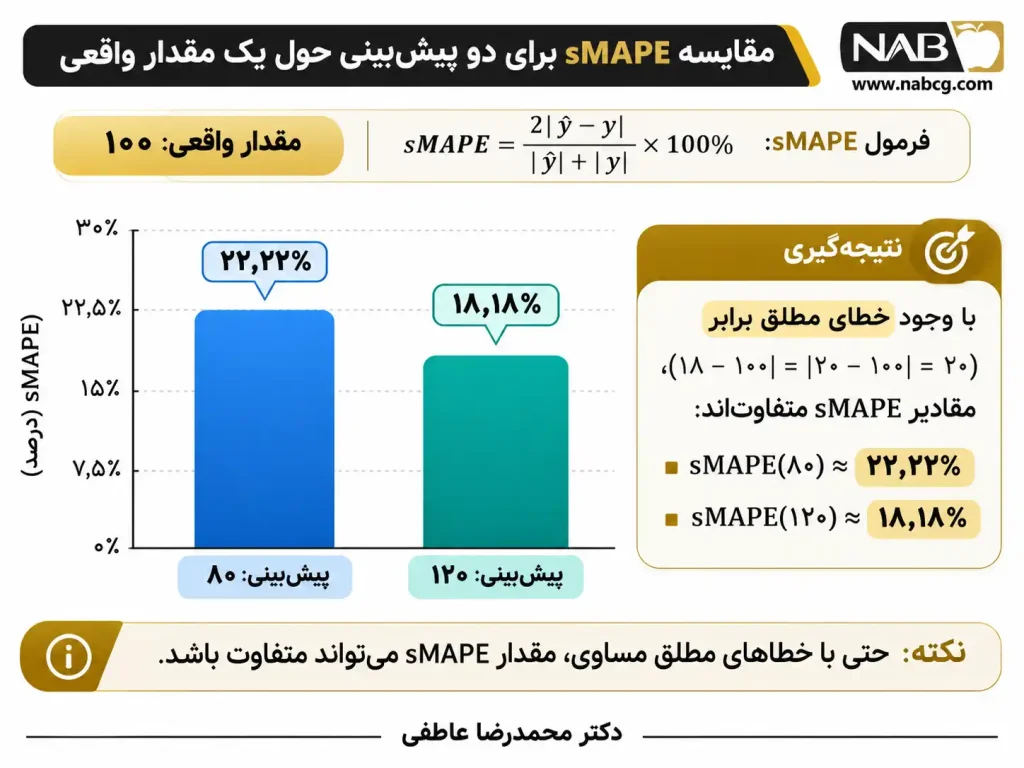
شکل ۱۰ ـ sMAPE با وجود نام «متقارن»، برای دو خطای مطلق برابر در دو سوی مقدار واقعی لزوماً خروجی برابر تولید نمیکند.
۲.۹.۲.موارد استفاده و محدودیتها
sMAPE در پیشبینی سریهای زمانی و مقایسه مدلهای پیشبینی کاربرد دارد؛ بهویژه زمانی که گزارش یک معیار نرمالشده مطلوب باشد.
با این حال، نام «متقارن» نباید باعث این تصور شود که تابع از هر نظر بدون سوگیری است.رفتار آن نزدیک صفر میتواند مشکلساز شود و تعریفهای متفاوتی نیز برای آن در منابع و نرمافزارها وجود دارد.
۲.۹.۳.تفسیر نتایج و معیار پذیرش
برای مقادیر واقعی و پیشبینی غیرمنفی، sMAPE با تعریف بالا معمولاً در بازه صفر تا ۲۰۰ درصد قرار دارد، به شرط آنکه وضعیت صفر بودن همزمان دو مقدار با یک قرارداد مشخص مدیریت شود.
مقدار کمتر مطلوبتر است، اما هیچ حد پذیرش عمومی برای آن وجود ندارد.
برای پذیرش مدل باید تعریف دقیق sMAPE، نوع داده، عملکرد مدل مرجع و معیارهای عملیاتی مشخص باشند.
۲.۱۰.مقایسه و انتخاب پنج خانواده پرکاربرد خطای رگرسیون
تا این مرحله، توابع MSE، MAE، Huber، Smooth L1، RMSE، Log-Cosh، MSLE، MAPE و sMAPE معرفی شدهاند.
جدول زیر تفاوت عملی آنها را نشان میدهد.
| تابع | ویژگی اصلی | محدودیت برجسته |
| MSE | جریمه شدید خطاهای بزرگ | حساسیت به دادههای پرت |
| MAE | خطای خطی و قابلتفسیر | حساسیت کمتر به خطاهای شدید |
| Huber | رفتار مربعی و خطی | نیاز به تنظیم آستانه |
| Smooth L1 | رفتار ترکیبی با مقیاسبندی خاص | وابستگی به β |
| RMSE | خطا در واحد متغیر هدف | حساسیت به خطاهای بزرگ |
| Log-Cosh | زیان هموار با رشد تقریباً خطی | وابستگی رفتار مؤثر به مقیاس خطا |
| MSLE | توجه به اختلاف لگاریتمی | محدودیت دامنه و رفتار نزدیک صفر |
| MAPE | گزارش خطا به درصد | مشکل مقادیر واقعی صفر یا نزدیک صفر |
| sMAPE | مقیاسبندی با واقعی و پیشبینی | ابهام تعاریف و رفتار نزدیک صفر |
نکته ضروری آن است که این توابع لزوماً جایگزین یکدیگر نیستند.ممکن است شبکه با Huber آموزش داده شود، ولی MAE و RMSE معیار اصلی ارزیابی آن باشند.
همچنین کاهش مقدار زیان روی مجموعه آموزش تنها یکی از نشانههای پیشرفت یادگیری است و نباید با پذیرش نهایی مدل اشتباه گرفته شود.
۲.۱۱.تابع زیان چندکی (Quantile Loss / Pinball Loss)
۲.۱۱.۱.چرا همیشه پیشبینی میانگین کافی نیست؟
فرض کنید شبکهای برای پیشبینی مدت تحویل سفارش طراحی شده است.میانگین زمان تحویل ممکن است ۳۰ دقیقه باشد، اما مدیر عملیات میخواهد بداند چه زمانی میتواند انتظار داشته باشد ۹۰ درصد سفارشها تحویل داده شده باشند.
این دو پرسش متفاوتاند:
- زمان تحویل معمولاً چقدر است؟
- زمانی که حدود ۹۰ درصد سفارشها تا آن موقع تحویل شدهاند، چقدر است؟
برای پاسخ به پرسش دوم، از مفهوم چندک (Quantile) استفاده میکنیم.
چندک ۰٫۹ توزیع زمان تحویل، مقداری است که بهطور نظری دستکم ۹۰ درصد احتمال توزیع در آن مقدار یا کمتر قرار میگیرد.
تابع Quantile Loss شبکه را بهجای تخمین میانگین، به سمت تخمین چندک مشخصی از توزیع شرطی خروجی هدایت میکند.
۲.۱۱.۲.فرمول و تعریف پارامترها
در این رابطه:
| نماد | مفهوم |
|---|---|
| y | مقدار واقعی |
| q̂ | چندک پیشبینیشده توسط شبکه |
| τ | سطح چندک، عددی بین صفر و یک |
| y − q̂ | خطای پیشبینی نسبت به چندک هدف |
| L_τ | زیان چندکی یک نمونه |
وقتی τ=0.5 باشد، تابع به نصف خطای قدرمطلق تبدیل میشود.بنابراین کمینهکننده آن با میانه شرطی ارتباط دارد.
وقتی τ = ۰٫۹ باشد، کمبرآوردکردن مقدار واقعی با ضریب ۰٫۹ و بیشبرآوردکردن آن با ضریب ۰٫۱ جریمه میشود.
۲.۱۱.۳.مثال عددی:برآورد زمان تحویل سفارش
فرض کنید زمان واقعی تحویل ۴۰ دقیقه است و شبکه چندک ۹۰ درصد را برابر ۳۵ دقیقه پیشبینی کرده است.
چون مقدار واقعی بیشتر از پیشبینی است:
اکنون فرض کنید شبکه برای همین سفارش مقدار ۴۵ دقیقه را پیشبینی کند.
یعنی برای سطح چندک ۰٫۹، کمبرآوردکردن و بیشبرآوردکردن به یک اندازه جریمه نمیشوند.
این نامتقارنبودن کاملاً عمدی است؛ زیرا شبکه باید چندک بالایی را یاد بگیرد، نه صرفاً نزدیکترین مقدار به واقعیت را.
۲.۱۱.۴.نمودار تعاملی زیان چندکی
در نمودار زیر سطح چندک را تغییر دهید و مشاهده کنید چگونه شدت جریمه در دو طرف خطای صفر تغییر میکند.
شکل ۱۱ ـ رفتار نامتقارن Quantile Loss
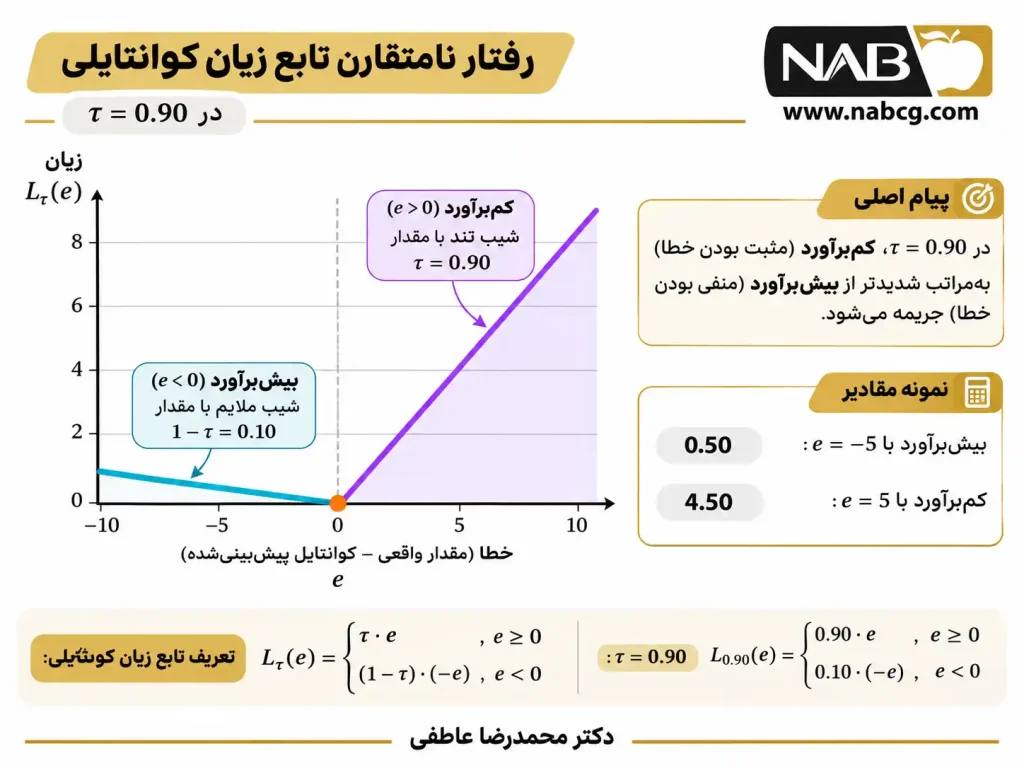
شکل ۱۱ ـ برای چندکهای بالاتر از ۰٫۵، کمبرآوردکردن با شدت بیشتری جریمه میشود.رنگ بنفش خطاهای مثبت و فیروزهای خطاهای منفی را نمایش میدهد.
۲.۱۱.۵.کاربردها و محدودیتها
این تابع برای پیشبینی بازه زمانی تحویل، تقاضای بالای احتمالی، ظرفیت موردنیاز انبار و پیشبینی چندکهای قیمت کاربرد دارد.
با آموزش شبکه برای چند سطح مانند ۰٫۱، ۰٫۵ و ۰٫۹ میتوان توصیف غنیتری از توزیع خروجی به دست آورد.البته چندکهای مختلف باید از نظر ترتیب نیز بررسی شوند؛ زیرا ممکن است مدل بهاشتباه چندک ۰٫۹ را کمتر از چندک ۰٫۵ پیشبینی کند.به این مشکل Quantile Crossing گفته میشود.
همچنین Quantile Loss در نقطه خطای صفر مشتق کلاسیک ندارد و مقدار آن به مقیاس متغیر هدف وابسته است.
۲.۱۱.۶.تفسیر نتایج و معیار پذیرش
کمتر بودن میانگین Quantile Loss روی داده آزمون مطلوبتر است، ولی برای پذیرش باید پوشش تجربی چندک نیز بررسی شود.
برای مثال، اگر شبکه چندک ۰٫۹ زمان تحویل را پیشبینی میکند، انتظار داریم در شرایط کالیبراسیون مناسب، تقریباً ۹۰ درصد زمانهای واقعی کمتر یا مساوی مقدار پیشبینیشده باشند.
اگر در ۱۰۰۰ سفارش مستقل آزمون، تنها ۷۴۰ زمان تحویل کمتر یا مساوی چندک ۰٫۹ پیشبینیشده باشند، پوشش مشاهدهشده برابر ۷۴ درصد است.این اختلاف قابلتوجه نشان میدهد مدل برای هدف ادعاشده نیاز به بررسی دارد.
معیار پذیرش پیشنهادی:مقایسه Quantile Loss با مدل مرجع و بررسی پوشش تجربی روی داده آزمون، با تلورانس ازپیشتعریفشده و توجه به عدمقطعیت آماری.
۲.۱۲.تابع زیان Expectile؛ جریمه نامتقارن با خطای مربعی
تابع Quantile Loss از خطای مطلق نامتقارن استفاده میکند.اما گاهی میخواهیم همان ویژگی نامتقارن را حفظ کنیم و در عین حال خطاهای بزرگ را بهصورت مربعی جریمه کنیم.
در این شرایط میتوان از Expectile Loss استفاده کرد.
این تابع در مسائل رگرسیون نامتقارن و تحلیل ریسک کاربرد دارد و ارتباط نزدیکی با روش کمترین مربعات نامتقارن (Asymmetric Least Squares) دارد.
۲.۱۲.۱.فرمول و تعریف پارامترها
در این رابطه:
| نماد | مفهوم |
|---|---|
| y | مقدار واقعی |
| ê | مقدار Expectile پیشبینیشده |
| τ | پارامتر عدمتقارن بین صفر و یک |
| y − ê | خطای پیشبینی |
| L_τ | زیان یک نمونه |
در (tau=0.5)، این تابع معادل نصف خطای مربعی است و کمینهکننده آن همان میانگین شرطی خواهد بود.
برخلاف Quantile Loss، زیان Expectile بر اساس مربع خطا ساخته میشود و در نتیجه خطاهای بزرگتر را شدیدتر جریمه میکند.
۲.۱۲.۲.مثال عددی:پیشبینی نیاز به موجودی انبار
فرض کنید یک شبکه عصبی میزان تقاضای مورد انتظار انبار را پیشبینی میکند.کمبرآوردکردن تقاضا ممکن است به کمبود کالا منجر شود.
دو خطای فرضی داریم:
- نمونه اول:تقاضای واقعی ۱۲ واحد و پیشبینی ۱۰ واحد
- نمونه دوم:تقاضای واقعی ۹ واحد و پیشبینی ۱۰ واحد
پارامتر را (τ=0.8) انتخاب میکنیم.
برای نمونه اول، خطای مثبت برابر ۲ است:
برای نمونه دوم، خطای منفی برابر ۱ است:
بنابراین:
این مثال نشان میدهد که تابع برای خطاهای مثبت ضریب جریمه بیشتری در نظر میگیرد و در هر طرف نیز نسبت به مربع اندازه خطا حساس است.
۲.۱۲.۳.نمودار تعاملی Expectile
شکل ۱۲ ـ رفتار نامتقارن Expectile Loss
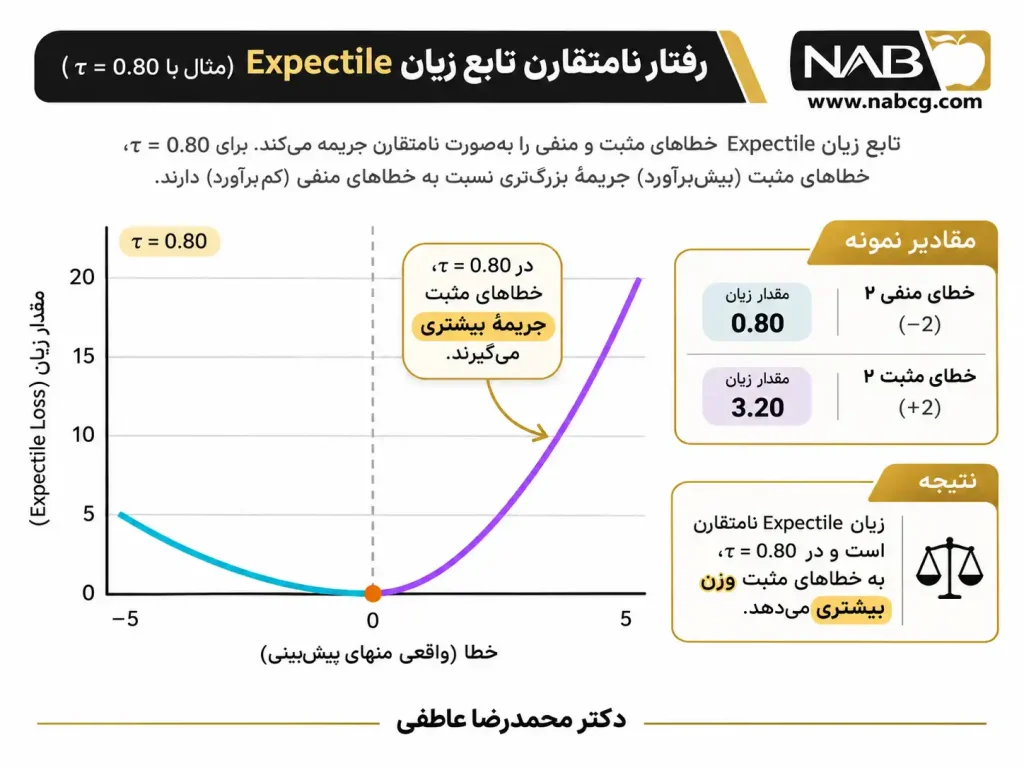
شکل ۱۲ ـ منحنیهای بنفش و فیروزهای جریمه خطاهای مثبت و منفی را نشان میدهند.با افزایش سطح Expectile، جریمه خطاهای مثبت بیشتر میشود.
۲.۱۲.۴.موارد استفاده و محدودیتها
Expectile Loss برای تخمین آمارههای شرطی نامتقارن، تحلیل ریسک و برخی مسائل پیشبینی تقاضا مناسب است.
محدودیت اصلی آن حساسیت مربعی به خطاهای بزرگ است.همچنین پارامتر (tau) برخلاف Quantile Loss مستقیماً بیانگر درصد دادههایی نیست که باید زیر مقدار پیشبینیشده قرار گیرند.
به بیان دیگر، Expectile با سطح ۰٫۹ لزوماً پوشش ۹۰ درصدی ایجاد نمیکند.
۲.۱۲.۵.تفسیر و معیار پذیرش
مقدار زیان غیرمنفی است و مقدار صفر با پیشبینی کاملاً منطبق به دست میآید.
برای پذیرش مدل باید Expectile Loss روی داده آزمون با مدل مرجع مقایسه شود و هزینه واقعی کمبرآورد و بیشبرآورد نیز سنجیده شود.
اگر هدف اصلی ایجاد پوشش ۹۰ درصدی باشد، استفاده از معیارهای کالیبراسیون چندکی یا بازهای مناسبتر از اتکا به مقدار Expectile Loss بهتنهایی است.
۲.۱۳.زیان درستنمایی منفی گاوسی (Gaussian Negative Log-Likelihood)
تا اینجا شبکه فقط یک مقدار عددی، یک چندک یا یک Expectile پیشبینی میکرد.اکنون میخواهیم شبکه علاوه بر مقدار مرکزی، میزان عدمقطعیت پیشبینی را نیز تخمین بزند.
فرض کنید دو سامانه پیشبینی دما هر دو دمای ۲۵ درجه را پیشبینی میکنند.سامانه اول به پیشبینی خود بسیار مطمئن است و سامانه دوم عدمقطعیت بیشتری گزارش میکند.
اگر دمای واقعی ۳۰ درجه باشد، کیفیت دو پیشبینی احتمالاتی یکسان نیست؛ زیرا هر مدل درباره میزان پراکندگی نتایج نیز ادعایی داشته است.
Gaussian NLL برای ارزیابی چنین پیشبینیهایی به کار میرود.
۲.۱۳.۱.فرمول ریاضی
فرض میکنیم متغیر هدف، به شرط ورودی، از توزیع نرمال پیروی میکند:
زیان یک نمونه برابر است با:
در این رابطه:
| نماد | مفهوم |
|---|---|
| y | مقدار واقعی |
| μ | میانگین پیشبینیشده شبکه |
| σ | انحراف معیار مثبت پیشبینیشده |
| σ² | واریانس پیشبینیشده |
| π | ثابت ریاضی پی |
| log | لگاریتم طبیعی |
جمله اول با میزان پراکندگی توزیع مرتبط است.جمله دوم اختلاف مقدار واقعی از میانگین پیشبینیشده را نسبت به واریانس اندازهگیری میکند.
در این تابع، شبکه نمیتواند با بزرگکردن بیحد واریانس، بدون جریمه زیان را کاهش دهد؛ زیرا جمله لگاریتمی افزایش مییابد.
۲.۱۳.۲.مثال عددی:پیشبینی دما همراه با عدمقطعیت
فرض کنید:
در نتیجه:
با جایگذاری:
این مقدار، درستنمایی منفی در مقیاس چگالی احتمال است، نه خطای پیشبینی در واحد درجه سانتیگراد.
۲.۱۳.۳.نمودار اثر عدمقطعیت بر پیشبینی
شکل ۱۳ ـ توزیعهای نرمال با میانگین یکسان و عدمقطعیت متفاوت
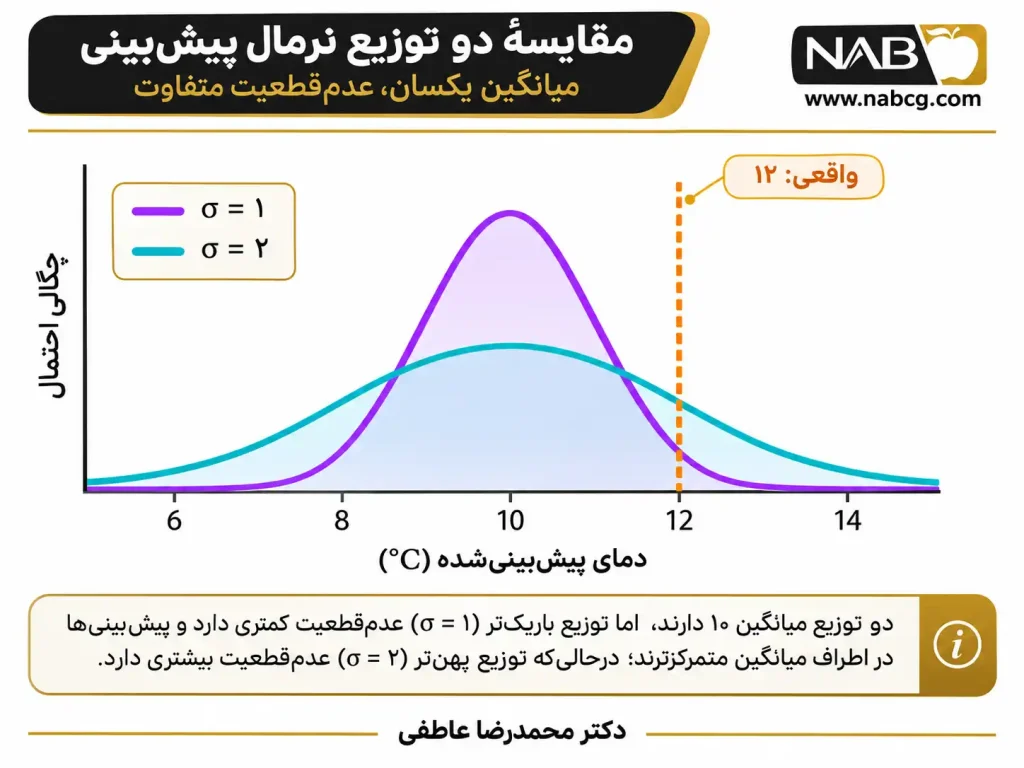
شکل ۱۳ ـ دو توزیع میانگین ۱۰ دارند، اما توزیع فیروزهای گستردهتر است.مقدار واقعی ۱۲ در هر دو توزیع قرار دارد، ولی چگالی اختصاصیافته به آن متفاوت است.
۲.۱۳.۴.موارد استفاده و محدودیتها
Gaussian NLL در رگرسیون احتمالاتی، مدلسازی عدمقطعیت وابسته به ورودی و برخی مسائل پیشبینی علمی کاربرد دارد.
محدودیت اصلی، فرض نرمال بودن توزیع شرطی است.اگر دادهها بسیار چوله، دارای دنبالههای سنگین یا چندقلهای باشند، استفاده از یک توزیع نرمال ممکن است توصیف مناسبی ارائه ندهد.
همچنین برای جلوگیری از واریانس صفر یا بسیار کوچک، معمولاً از پارامترسازی مثبت و محدودسازی عددی واریانس استفاده میشود.
۲.۱۳.۵.تفسیر نتایج و معیار پذیرش
برخلاف MSE، مقدار Gaussian NLL میتواند منفی نیز باشد؛ زیرا چگالی احتمال پیوسته ممکن است بیشتر از یک شود.
بنابراین، صفر حداقل عمومی این تابع نیست.
برای ارزیابی مدل، Gaussian NLL روی داده آزمون، کالیبراسیون بازههای پیشبینی و مقایسه با مدل احتمالاتی مرجع اهمیت دارند.
برای نمونه، اگر مدل بازههای اسمی ۹۰ درصدی تولید میکند، باید بررسی شود که پوشش تجربی آن بازهها واقعاً نزدیک ۹۰ درصد باشد؛ البته پوشش مناسب بهتنهایی کافی نیست و پهنای بازهها نیز باید سنجیده شود.
۲.۱۴.زیان درستنمایی منفی پواسون (Poisson Negative Log-Likelihood)
گاهی خروجی شبکه یک کمیت پیوسته مانند دما یا قیمت نیست، بلکه تعداد وقوع یک رویداد است.
برای مثال، ممکن است بخواهیم تعداد مراجعهکنندگان به یک مرکز خدمات، تعداد تماسهای ورودی در یک ساعت یا تعداد خرابیهای یک دستگاه در طول یک هفته را پیشبینی کنیم.
چنین خروجیهایی معمولاً اعداد صحیح نامنفی هستند و در شرایط مناسب میتوان آنها را با توزیع پواسون مدلسازی کرد.
۲.۱۴.۱.فرمول و تعریف پارامترها
فرض میکنیم:
تابع جرم احتمال پواسون:
با گرفتن منفی لگاریتم:
| نماد | مفهوم |
|---|---|
| y | تعداد واقعی رخدادها، عدد صحیح نامنفی |
| λ | میانگین و نرخ موردانتظار رخدادها، بزرگتر از صفر |
| y! | فاکتوریل مقدار واقعی |
| log | لگاریتم طبیعی |
| L_Poisson | منفی لگاریتم احتمال مشاهده تعداد y |
در پیادهسازیهای رایج، گاهی جمله (log(y!)) حذف میشود؛ زیرا نسبت به پارامترهای شبکه ثابت است.این حذف، نقطه بهینه را تغییر نمیدهد، اما مقدار عددی زیان و امکان تفسیر آن بهعنوان NLL کامل را تغییر میدهد.
۲.۱۴.۲.مثال عددی:تعداد تماسهای یک مرکز خدمات
فرض کنید تعداد واقعی تماسها در یک بازه زمانی برابر ۳ باشد و شبکه میانگین موردانتظار را ۲ پیشبینی کند:
در نتیجه:
با استفاده از (log 2approx0.6931) و (log6approx1.7918):
این مقدار نشان میدهد شبکه چه میزان زیان احتمالاتی برای مشاهده سه تماس، با فرض نرخ پواسون ۲، متحمل شده است.
۲.۱۴.۳.نمودار توزیع تعداد رخدادها
شکل ۱۴ ـ احتمال تعداد تماسها با فرض λ = ۲
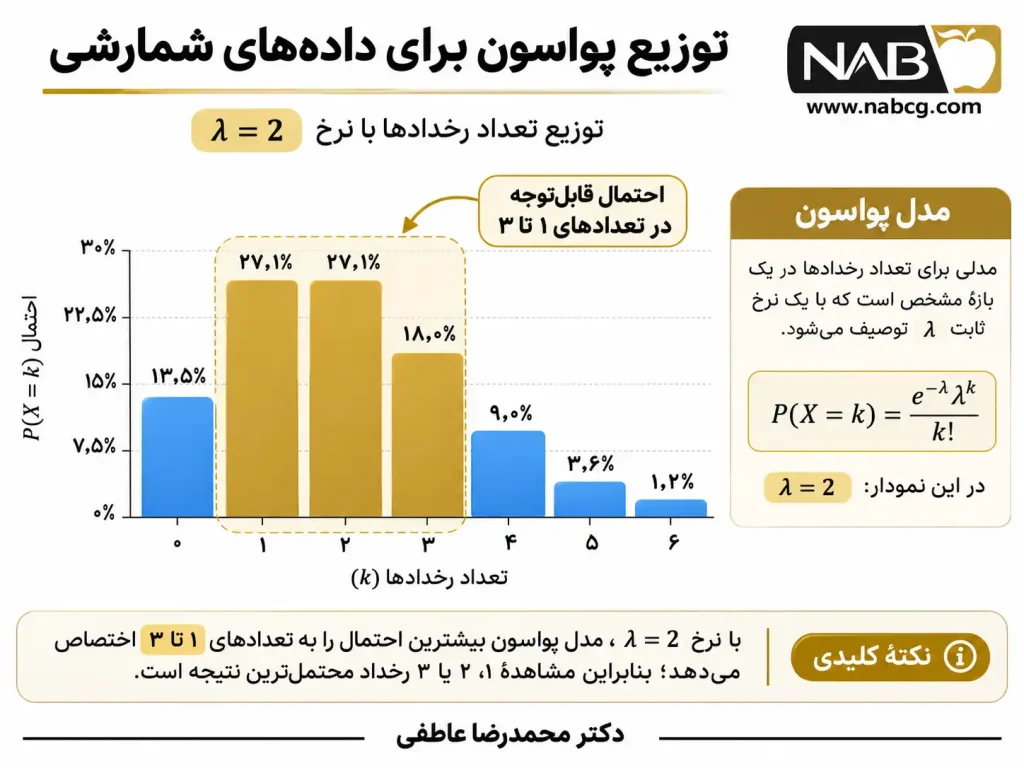
شکل ۱۴ ـ توزیع پواسون برای میانگین ۲ رخداد در یک بازه ثابت.مقدار واقعی مثال، ۳ تماس است که طبق مدل حدود ۱۸٫۰۴ درصد احتمال دارد.
۲.۱۴.۴.موارد استفاده و محدودیتها
Poisson NLL برای پیشبینی تعداد رخدادها در بازههای مشخص زمانی یا مکانی مناسب است؛ بهویژه وقتی فرض برابری میانگین و واریانس شرطی تقریب معقولی باشد.
محدودیت مهم توزیع پواسون آن است که:
اگر واریانس دادهها بهطور معناداری از میانگین بزرگتر باشد، پدیده Overdispersion رخ میدهد و مدل پواسون ممکن است عدمقطعیت را کمتر از واقعیت تخمین بزند.
در دادههای دارای صفرهای بیشازحد نیز ممکن است مدلهای دیگری مانند پواسون صفرمتورم یا دوجملهای منفی مناسبتر باشند.
۲.۱۴.۵.تفسیر و معیار پذیرش
Poisson NLL کامل، غیرمنفی است؛ اما نسخهای که جمله ثابت (log(y!)) از آن حذف شده، میتواند منفی شود.بنابراین هنگام مقایسه نتایج باید مشخص باشد کدام قرارداد استفاده شده است.
برای پذیرش مدل، کاهش NLL روی مجموعه آزمون نسبت به مدل مرجع، کالیبراسیون تعداد رخدادها و بررسی رفتار باقیماندهها اهمیت دارند.
همچنین اگر تصمیم عملیاتی به پیشبینی تعداد تماسهای بسیار زیاد وابسته باشد، لازم است کیفیت پیشبینی در بخش انتهایی توزیع نیز بررسی شود.
۲.۱۵.زیان درستنمایی منفی لگنرمال (Log-Normal NLL)
در برخی مسائل، متغیر هدف تنها میتواند مثبت باشد و توزیع آن به سمت مقادیر بزرگ چولگی دارد.
برای مثال، مدت انجام یک فعالیت، زمان تعمیر دستگاه، هزینه برخی خدمات یا اندازه برخی تراکنشها ممکن است چنین رفتاری داشته باشند.
در این شرایط، یکی از گزینههای مدلسازی، توزیع لگنرمال (Log-Normal Distribution) است.
۲.۱۵.۱.فرمول و تعریف پارامترها
اگر لگاریتم متغیر هدف توزیع نرمال داشته باشد:
آنگاه (Y) از توزیع لگنرمال پیروی میکند.
زیان درستنمایی منفی یک نمونه:
در این رابطه:
| نماد | مفهوم |
|---|---|
| مقدار واقعی مثبت متغیر هدف | |
| μ | میانگین لگاریتم متغیر هدف |
| انحراف معیار لگاریتم متغیر هدف | |
| لگاریتم طبیعی مقدار واقعی | |
| درستنمایی منفی (Negative Log-Likelihood) مشاهده |
نکته مهم این است که (μ) میانگین خود متغیر هدف نیست.میانگین توزیع لگنرمال برابر است با:
و میانه آن:
۲.۱۵.۲.مثال عددی:مدت تعمیر یک دستگاه
فرض کنید مدت واقعی تعمیر دستگاه:
و شبکه پارامترهای زیر را پیشبینی کرده است:
بنابراین:
با جایگذاری در فرمول:
این نتیجه زیان احتمالاتی مشاهده مدت تعمیر است و نباید آن را با ۱٫۳۰۵۸ ساعت خطای پیشبینی اشتباه گرفت.
۲.۱۵.۳.نمودار توزیع لگنرمال
شکل ۱۵ ـ توزیع چوله مدت تعمیر دستگاه
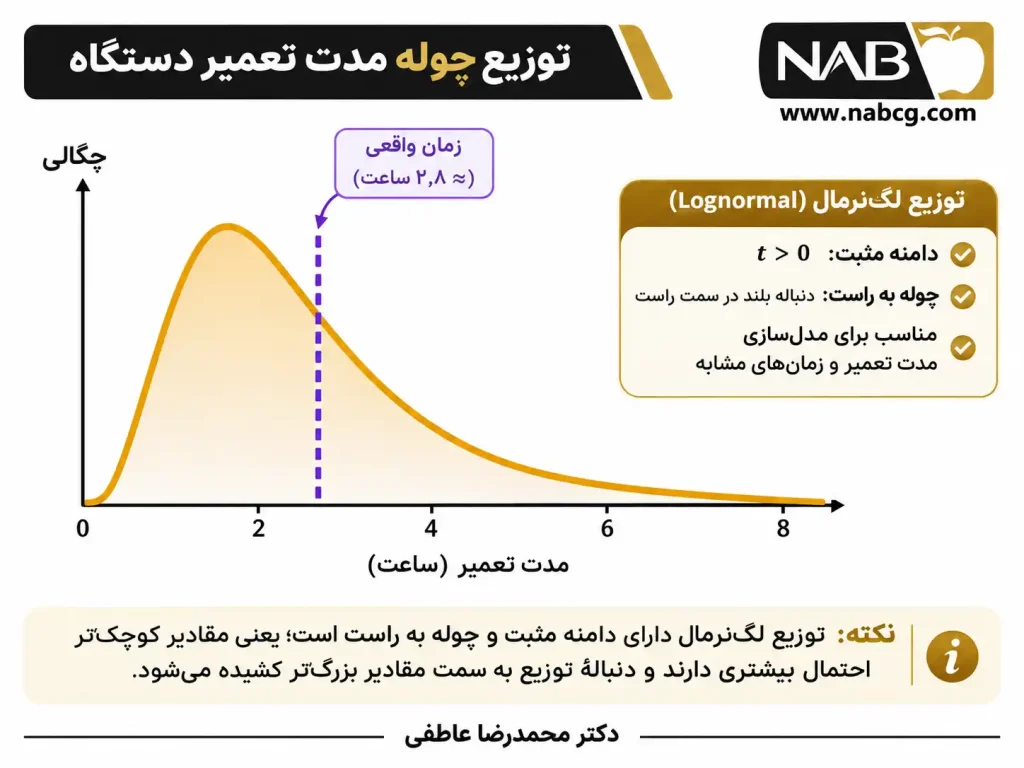
شکل ۱۵ ـ توزیع لگنرمال دارای دامنه مثبت و دنباله راست است.شکل صرفاً توزیع فرضشده با پارامترهای مثال را نمایش میدهد.
۲.۱۵.۴.موارد استفاده و محدودیتها
Log-Normal NLL برای پیشبینی متغیرهای مثبت و چوله مناسب است، بهویژه زمانی که لگاریتم آنها تقریباً توزیع نرمال داشته باشد.
محدودیت اصلی این است که مقدار صفر یا منفی در توزیع لگنرمال استاندارد مجاز نیست.همچنین اگر دادهها چندقلهای باشند یا دنبالههای آنها با توزیع لگنرمال تطابق نداشته باشد، این مدل ممکن است کیفیت کافی نداشته باشد.
۲.۱۵.۵.تفسیر و معیار پذیرش
Log-Normal NLL میتواند منفی باشد و مقدار صفر حداقل عمومی آن نیست.مقایسه باید روی دادههای یکسان، با واحد یکسان و تعریف ثابت چگالی انجام شود.
در مثال تعمیرات صنعتی، پذیرش مدل میتواند به دقت پیشبینی میانه مدت تعمیر، پوشش بازههای احتمالاتی و کیفیت پیشبینی تعمیرات طولانی وابسته باشد.
اگر هدف سازمان این است که ۹۵ درصد تعمیرات پیش از زمان اعلامشده کامل شوند، باید پوشش تجربی چندک ۹۵ درصدی توزیع پیشبینیشده بررسی شود.