۲.۱۶.زیان تویدی (Tweedie Deviance Loss)
آخرین تابع این بخش برای دادههایی طراحی شده است که ممکن است تعداد زیادی مقدار صفر داشته باشند، اما مقادیر مثبت آنها پیوسته و گاهی بسیار بزرگ باشند.
برای مثال، در یک شرکت بیمه، بسیاری از مشتریان طی سال هیچ خسارتی ثبت نمیکنند و مبلغ خسارت آنها صفر است.در مقابل، برخی مشتریان خسارتهایی با مقادیر مثبت و متفاوت دارند.
پیشبینی چنین خروجیهایی با MSE همیشه بهترین انتخاب نیست؛ زیرا ساختار احتمالاتی دادهها ممکن است پیچیدهتر باشد.
خانواده توزیعهای Tweedie میتواند برای برخی از این مسائل استفاده شود.
۲.۱۶.۱.مفهوم و فرمول ریاضی
در مدل Tweedie، واریانس متغیر هدف معمولاً از رابطه زیر تبعیت میکند:
که در آن:
| نماد | مفهوم |
|---|---|
| Y | متغیر تصادفی هدف |
| μ | میانگین موردانتظار، معمولاً مثبت |
| p | پارامتر توان واریانس |
| φ | پارامتر پراکندگی مثبت |
| Var(Y) | واریانس متغیر هدف |
برای (pne1,2)، یکی از تعریفهای متداول انحراف تویدی برای یک نمونه چنین است:
در این رابطه، y مقدار واقعی نامنفی و μ میانگین مثبت پیشبینیشده است. برای حالت مرکب پواسون–گاما، معمولاً ۱ < p < ۲ انتخاب میشود.
این کمیت، Deviance است و با NLL کامل یکسان نیست.با فرض پراکندگی ثابت، کمینهسازی آن میتواند هدف آموزشی مناسبی باشد.
۲.۱۶.۲.مثال عددی:پیشبینی مبلغ خسارت بیمه
فرض کنید مبلغ خسارت واقعی یک مشتری برابر ۱ واحد مالی و میانگین خسارت پیشبینیشده توسط شبکه برابر ۴ واحد باشد.
در این حالت:
فرمول به شکل زیر تبدیل میشود:
محاسبات سه جمله:
بنابراین:
اکنون فرض کنید خسارت واقعی همان ۱ واحد باقی بماند، اما شبکه میانگین را ۱ پیشبینی کند:
پس در مثال دوم، میانگین پیشبینیشده دقیقاً با مقدار مشاهدهشده برابر است و انحراف برای آن نمونه صفر میشود.
۲.۱۶.۳.نمودار رفتار Tweedie Deviance
شکل ۱۶ ـ تغییر انحراف تویدی بر حسب میانگین پیشبینیشده
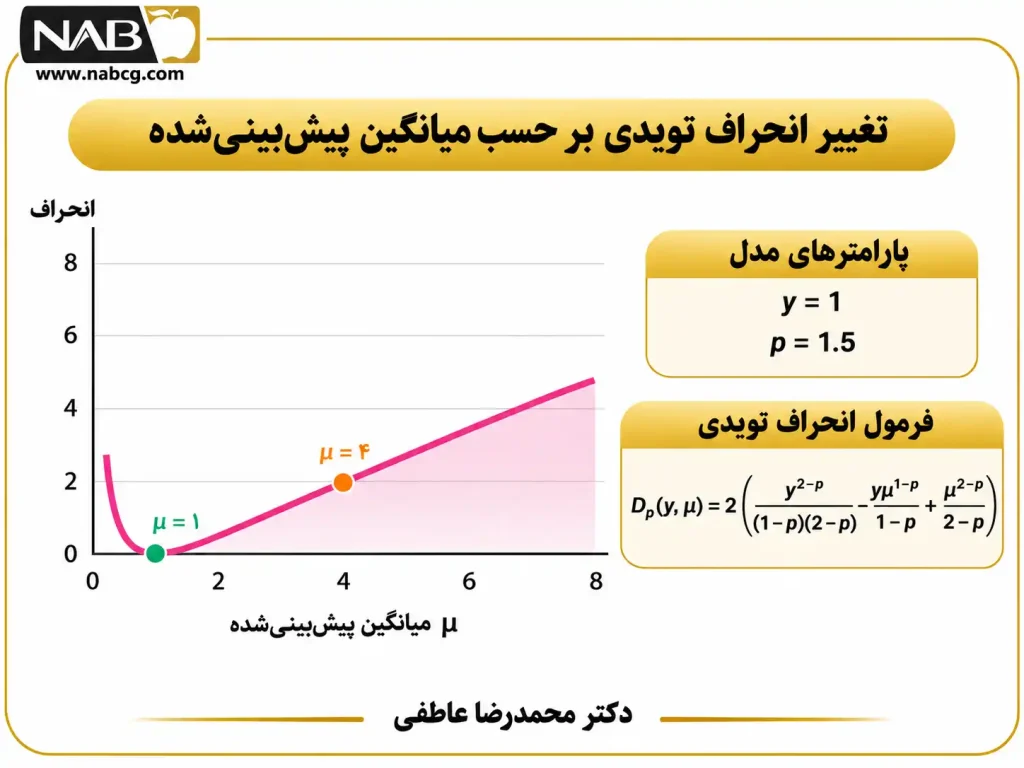
شکل ۱۶ ـ مقدار واقعی ثابت و برابر ۱ و پارامتر توان برابر ۱٫۵ است.کمترین زیان در μ برابر ۱ به دست میآید.منحنی در دو سوی این مقدار لزوماً متقارن نیست.
۲.۱۶.۴.کاربردها و محدودیتها
Tweedie Deviance در بیمه، پیشبینی هزینه خسارت، برخی دادههای مالی نامنفی و دادههایی با صفرهای فراوان و مقادیر مثبت پیوسته کاربرد دارد.
با این حال، وجود صفرهای فراوان بهتنهایی اثبات نمیکند که توزیع Tweedie بهترین مدل است.
پارامتر (p) باید متناسب با ساختار داده انتخاب شود.برای نمونه، مقادیر مختلف این پارامتر به خانوادههای متفاوتی ارتباط دارند:
| پارامتر (p) | مدل مرتبط |
| ۰ | نرمال؛ انحراف معادل خطای مربعی |
| ۱ | پواسون |
| بین ۱ و ۲ | پواسون–گامای مرکب |
| ۲ | گاما |
| ۳ | نرمال معکوس |
برای (p=1) و (p=2)، باید از صورتهای حدی مخصوص همان خانواده استفاده شود.
۲.۱۶.۵.تفسیر و معیار پذیرش
Tweedie Deviance غیرمنفی است و مقدار صفر نشان میدهد میانگین پیشبینیشده با مقدار واقعی آن نمونه منطبق است.
اما پایینبودن انحراف، بهتنهایی تضمین نمیکند توزیع پیشبینیشده یا احتمال رخداد صفر بهدرستی مدلسازی شده باشد.
در یک پروژه بیمه، معیار پذیرش میتواند شامل کاهش انحراف نسبت به مدل مرجع، کالیبراسیون مجموع خسارتهای پیشبینیشده، دقت پیشبینی خسارتهای بزرگ و عملکرد پایدار روی داده آزمون باشد.
۲.۱۷.جمعبندی تحلیلی توابع زیان رگرسیون
در این بخش، ۱۵ تابع زیان رگرسیون را از سادهترین شکل اندازهگیری اختلاف عددی تا روشهای پیشبینی احتمالاتی بررسی کردیم.
انتخاب مناسب تابع زیان باید از ماهیت مسئله آغاز شود، نه از محبوبیت یک روش یا کوچکتر بودن عدد زیان آن.
راهنمای انتخاب تابع زیان بر اساس مسئله
| مسئله | گزینه قابل بررسی | معیار تکمیلی پذیرش |
| پیشبینی عمومی مقدار پیوسته | MSE یا Huber | RMSE و عملکرد مدل مرجع |
| کاهش متوسط خطای مطلق | MAE | MAE و صدک خطا |
| وجود دادههای پرت | Huber یا Smooth L1 | خطای دادههای عادی و پرت |
| گزارش خطا در واحد اصلی | RMSE | آستانه خطای کاربردی |
| نیاز به تابع هموار با رشد تقریباً خطی | Log-Cosh | MAE و RMSE |
| خروجی مثبت با مقیاس گسترده | MSLE | خطای نسبی و عملکرد نزدیک صفر |
| گزارش خطا به درصد | MAPE یا sMAPE | اعتبار دامنه داده و معیار مرجع |
| پیشبینی چندک | Quantile Loss | پوشش تجربی چندک |
| رگرسیون نامتقارن با جریمه مربعی | Expectile Loss | زیان نامتقارن و هزینه تصمیم |
| پیشبینی همراه با واریانس | Gaussian NLL | کالیبراسیون و پوشش بازهها |
| شمارش رخدادها | Poisson NLL | کالیبراسیون تعداد و پراکندگی |
| متغیر مثبت و چوله | Log-Normal NLL | NLL و پوشش بازههای احتمالاتی |
| داده نامنفی با صفرهای فراوان | Tweedie Deviance | انحراف و کالیبراسیون خسارت |
مطالعه تلفیقی:انتخاب تابع زیان برای سامانه پیشبینی سفارش
فرض کنید سه خروجی متفاوت از یک سامانه فروش اینترنتی میخواهیم:
هدف اول:پیشبینی تعداد سفارشها
اگر تعداد سفارشها شمارشی باشد و فرض پواسون مناسب باشد، Poisson NLL گزینهای قابل بررسی است.
هدف دوم:اعلام زمان تحویل محافظهکارانه
میتوان Quantile Loss را در سطحی مانند ۰٫۹ آموزش داد و پوشش تجربی آن را بررسی کرد.
هدف سوم:پیشبینی مبلغ سفارش
با توجه به توزیع مبالغ، میتوان MSE، Huber یا یک مدل احتمالاتی مناسب برای مقادیر مثبت را ارزیابی کرد.
این سه مسئله ممکن است از دادههای ورودی مشابه استفاده کنند، اما هدف آماری یکسانی ندارند؛ بنابراین استفاده از یک تابع زیان برای هر سه، الزاماً تصمیم مناسبی نیست.
۲.۱۸.تمرینهای پایان بخش رگرسیون
- محاسباتی:برای دادههای واقعی (10,20,30) و پیشبینیهای (12,18,25)، مقادیر MSE، MAE و RMSE را محاسبه کنید و تفاوت تفسیر آنها را توضیح دهید.
- تحلیلی:چرا کاهش MSE روی داده آموزش الزاماً به معنی کاهش خطا روی داده آزمون نیست؟
- کاربردی:یک شرکت خدمات اینترنتی میخواهد زمان رفع خرابی را تخمین بزند.برخی خرابیها بسیار طولانی هستند.کدام تابع زیان را برای شروع آزمایش انتخاب میکنید و چه معیارهایی را برای پذیرش نهایی به کار میبرید؟
- پیشرفته:توضیح دهید چرا Gaussian NLL میتواند مقدار منفی داشته باشد، درحالیکه MSE همواره غیرمنفی است.
- برنامهنویسی:با استفاده از Python، رفتار MSE، MAE، Huber و Quantile Loss را روی مجموعهای از خطاهای یکسان رسم کنید و اثر افزایش تعداد دادههای پرت را بررسی کنید.
۳.از پیشبینی مقدار عددی تا تصمیمگیری درباره کلاسها
در بخش قبل، شبکه عصبی مقدار یک متغیر پیوسته مانند قیمت، دما یا فروش را پیشبینی میکرد.در چنین مسائلی، اختلاف عددی میان پیشبینی و مقدار واقعی مبنای طبیعی اندازهگیری خطا بود.
اما بسیاری از کاربردهای هوش مصنوعی ماهیت متفاوتی دارند.برای مثال، یک بانک میخواهد مشخص کند آیا تراکنش مالی مشکوک است، یک سامانه پزشکی میخواهد تصویری را در یکی از چند گروه تشخیصی قرار دهد و یک فروشگاه اینترنتی میخواهد نظرات مشتریان را مثبت، منفی یا خنثی طبقهبندی کند.
در این مسائل، هدف صرفاً نزدیککردن دو عدد به یکدیگر نیست؛ بلکه شبکه باید بتواند میان کلاسهای مختلف تمایز ایجاد کند و در بسیاری از موارد، امتیاز یا احتمال مناسبی به هر کلاس اختصاص دهد.
اینجا مفهوم زیان طبقهبندی (Classification Loss) اهمیت پیدا میکند.
۳.۱.خروجی شبکه در طبقهبندی چگونه تفسیر میشود؟
در طبقهبندی دودویی (Binary Classification)، تنها دو کلاس وجود دارد؛ مانند تراکنش عادی و مشکوک.
فرض کنید شبکه عصبی پس از پردازش اطلاعات یک تراکنش، احتمال تعلق آن به کلاس مشکوک را برابر ۰٫۸ پیشبینی میکند.
در این رابطه:
- (X=x):ویژگیهای تراکنش مورد بررسی
- (Y=1):برچسب کلاس مشکوک
- (p):احتمال پیشبینیشده برای کلاس مشکوک، در مدل احتمالاتی
اگر تراکنش واقعاً مشکوک باشد، پیشبینی شبکه به برچسب واقعی نزدیک است.اما اگر تراکنش عادی باشد، شبکه با اطمینان نسبتاً زیادی به کلاس اشتباه امتیاز داده است.
تابع زیان باید بتواند این دو وضعیت را از یکدیگر تفکیک کند.
شکل ۱۷ ـ مسیر محاسبه زیان در طبقهبندی دودویی
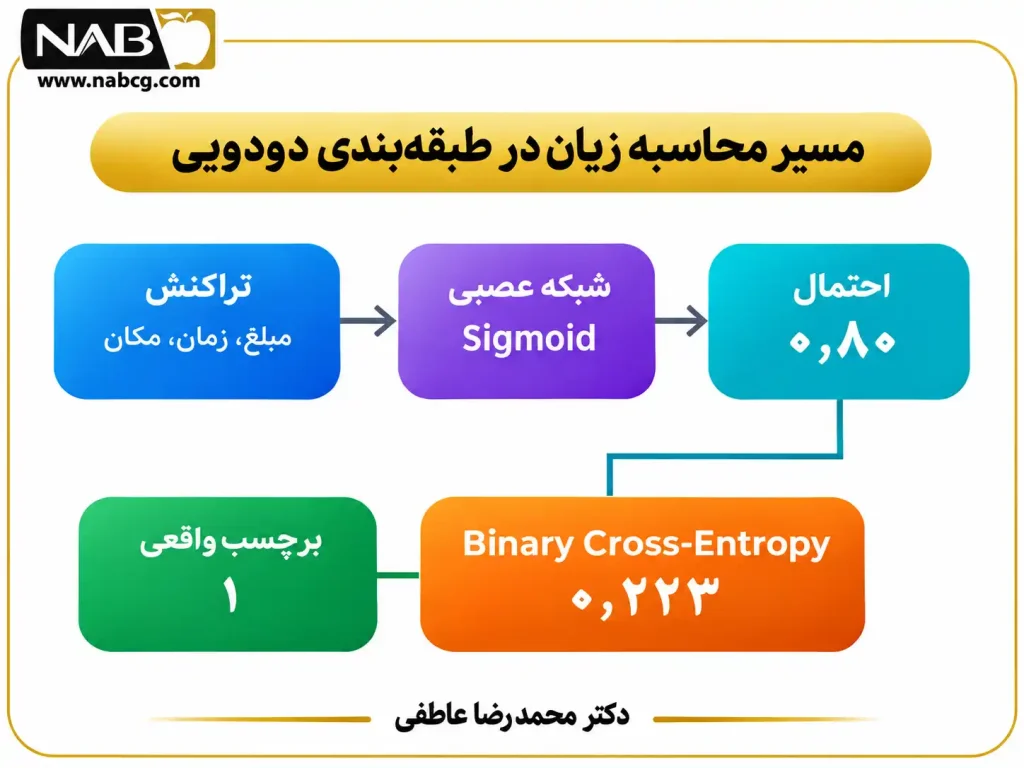
شکل ۱۷ ـ شبکه احتمال کلاس مثبت را تولید میکند و تابع زیان با توجه به برچسب واقعی، میزان نامناسببودن پیشبینی را محاسبه میکند.
در ادامه خواهیم دید که چرا نمیتوان تنها با بررسی درست یا غلط بودن کلاس نهایی، شبکه را بهخوبی آموزش داد.
برای مثال، دو پیشبینی با احتمالهای ۰٫۵۱ و ۰٫۹۹ ممکن است با آستانه ۰٫۵ هر دو به کلاس مثبت تبدیل شوند؛ اما میزان اطمینانی که شبکه به کلاس واقعی اختصاص داده است متفاوت است.
تابع آنتروپی متقاطع این اختلاف را در زیان منعکس میکند.
۳.۲.زیان آنتروپی متقاطع دودویی (Binary Cross-Entropy — BCE)
BCE یکی از بنیادیترین توابع زیان برای آموزش شبکههای طبقهبندی دودویی است.
این تابع بر اساس درستنمایی توزیع برنولی (Bernoulli Distribution) ساخته میشود و پیشبینیهایی را که احتمال کمی به نتیجه واقعی اختصاص میدهند، با زیان بیشتری مواجه میکند.
۳.۲.۱.فرمول ریاضی و تعریف پارامترها
برای یک نمونه:
برای (N) نمونه:
| نماد | مفهوم | دامنه |
|---|---|---|
| yᵢ | برچسب واقعی | صفر یا یک |
| pᵢ | احتمال پیشبینیشده کلاس مثبت | بین صفر و یک |
| N | تعداد نمونهها | عدد صحیح مثبت |
| log | لگاریتم طبیعی | برای ورودی مثبت |
| L_BCE | میانگین زیان دودویی | غیرمنفی |
اگر برچسب واقعی برابر یک باشد، رابطه ساده میشود:
اگر برچسب واقعی صفر باشد:
بنابراین هرچه احتمال اختصاصیافته به کلاس واقعی بیشتر باشد، مقدار زیان کمتر خواهد بود.
۳.۲.۲.مثال عددی:تشخیص تراکنش مشکوک
فرض کنید چهار تراکنش بررسی شدهاند و برچسب یک به معنی تراکنش مشکوک است.
| تراکنش | برچسب واقعی (y) | احتمال مشکوک (p) | زیان |
| A | ۱ | ۰٫۹۰ | ۰٫۱۰۵۴ |
| B | ۰ | ۰٫۲۰ | ۰٫۲۲۳۱ |
| C | ۱ | ۰٫۶۰ | ۰٫۵۱۰۸ |
| D | ۰ | ۰٫۸۰ | ۱٫۶۰۹۴ |
- برای تراکنش A:
- برای تراکنش B:
- برای تراکنش C:
- برای تراکنش D:
میانگین زیان:
تراکنش D بیشترین سهم را در زیان دارد؛ زیرا درحالیکه تراکنش عادی است، شبکه با احتمال ۰٫۸ آن را مشکوک پیشبینی کرده است.
۳.۲.۳.نمودار تعاملی BCE
شکل ۱۸ ـ اثر احتمال پیشبینیشده بر BCE
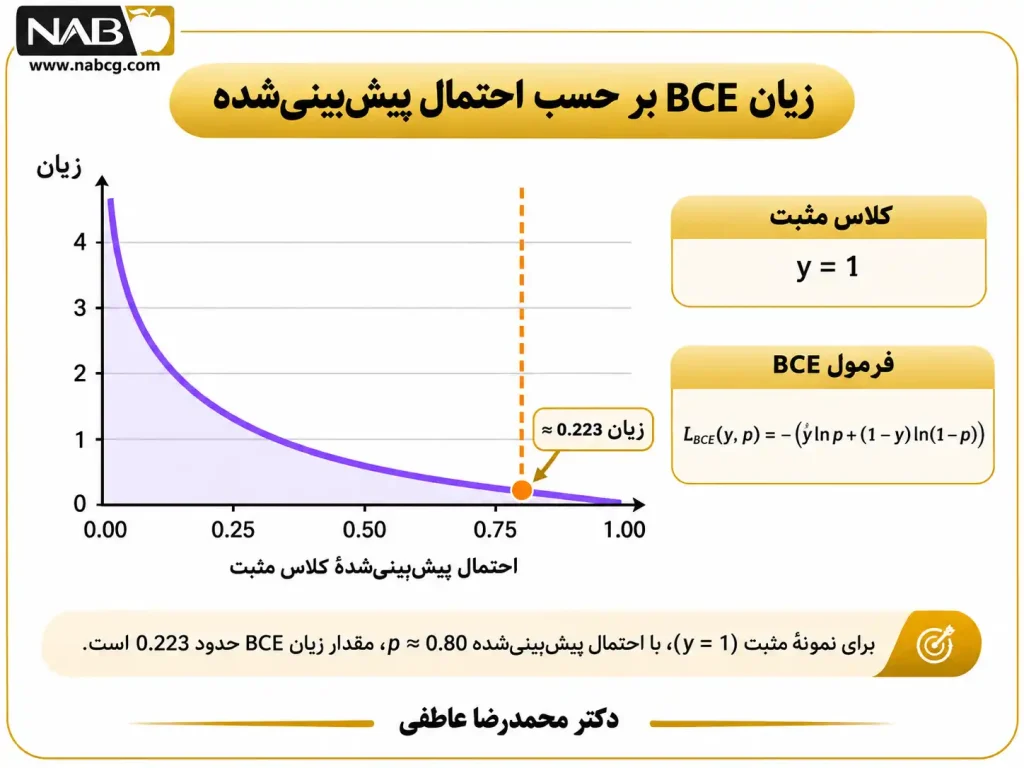
با انتخاب کلاس واقعی ۱ یا ۰، جهت منحنی تغییر میکند.خط نارنجی محل پیشبینی فعلی را نشان میدهد.
۳.۲.۴.چه زمانی باید از BCE استفاده کنیم؟
BCE زمانی مناسب است که خروجی مدل احتمال رخداد یک رویداد دودویی باشد؛ مانند تشخیص تقلب، احتمال لغو اشتراک مشتری، تشخیص یک ویژگی در تصویر یا طبقهبندی دودویی متن.
همچنین در مسائل چندبرچسبی (Multi-Label Classification) که هر نمونه میتواند همزمان عضو چند کلاس مستقل از نظر ساختار خروجی باشد، معمولاً برای هر کلاس یک BCE جداگانه محاسبه میشود.
۳.۲.۵.محدودیتهای BCE
این تابع در دادههای بسیار نامتوازن ممکن است بهتنهایی با هدف عملیاتی سازگار نباشد.برای مثال، اگر ۹۹ درصد تراکنشها عادی باشند، مدل ممکن است زیان متوسط نسبتاً کمی داشته باشد، ولی تعداد زیادی از تراکنشهای نادر مشکوک را تشخیص ندهد.
همچنین محاسبه مستقیم لگاریتم احتمال صفر مشکل عددی ایجاد میکند؛ به همین دلیل در پیادهسازی از روشهای پایدار عددی استفاده میشود.
کاهش BCE نیز تضمین نمیکند تصمیمهای دودویی با آستانه مشخص، از نظر هزینه خطاهای مثبت و منفی کاذب بهینه باشند.
۳.۲.۶.تفسیر و معیار پذیرش
BCE غیرمنفی است و برای برچسبهای قطعی، حداقل نظری آن صفر است.هرچه مدل احتمال بیشتری به کلاس واقعی اختصاص دهد، زیان کمتر خواهد بود.
اما مقدار BCE برابر ۰٫۶۱۲۲ در مثال ما، بهتنهایی برای قضاوت درباره کیفیت یک سامانه تشخیص تقلب کافی نیست.
در این کاربرد باید علاوه بر BCE، شاخصهایی مانند Recall کلاس مشکوک، Precision، PR-AUC و هزینه تصمیمها نیز بررسی شوند.
برای مثال، اگر سازمان از پیش شرط کرده باشد که حداقل ۹۵ درصد تراکنشهای مشکوک شناسایی شوند، مدلی با Recall برابر ۸۰ درصد شرط پذیرش را برآورده نمیکند؛ حتی اگر BCE آن نسبت به مدل مرجع کاهش یافته باشد.
۳.۳.آنتروپی متقاطع چندکلاسه (Categorical Cross-Entropy — CCE)
در طبقهبندی دودویی، شبکه تنها میان دو کلاس تصمیم میگرفت.اما فرض کنید یک سامانه باید تصاویر محصولات فروشگاه را در سه گروه «پوشاک»، «لوازم الکترونیکی» و «مواد غذایی» طبقهبندی کند.
در این حالت، شبکه باید برای هر تصویر سه احتمال تولید کند.اگر کلاسها متقابلاً انحصاری باشند، مجموع این احتمالها باید برابر یک باشد.
برای تولید چنین خروجیای معمولاً از تابع Softmax استفاده میشود.سپس تابع Categorical Cross-Entropy میزان تناسب توزیع احتمالی پیشبینیشده با برچسب واقعی را اندازهگیری میکند.
۳.۳.۱.فرمول ریاضی و پارامترها
برای یک نمونه با (K) کلاس:
و برای (N) نمونه:
که در آن:
| نماد | مفهوم |
|---|---|
| K | تعداد کلاسها |
| N | تعداد نمونهها |
| yᵢₖ | مقدار هدف نمونه i برای کلاس k |
| pᵢₖ | احتمال پیشبینیشده همان کلاس |
| log | لگاریتم طبیعی |
در برچسبگذاری One-Hot، برای کلاس واقعی مقدار یک و برای سایر کلاسها مقدار صفر قرار میگیرد.بنابراین فرمول عملاً به منفی لگاریتم احتمال کلاس واقعی تبدیل میشود.
۳.۳.۲.مثال عددی:شناسایی دسته محصول
فرض کنید تصویر یک گوشی تلفن همراه وارد شبکه شده و خروجی زیر تولید شده است:
| کلاس | احتمال پیشبینی | برچسب واقعی |
| پوشاک | ۰٫۱۰ | ۰ |
| الکترونیکی | ۰٫۷۰ | ۱ |
| مواد غذایی | ۰٫۲۰ | ۰ |
زیان این نمونه برابر است با:
اکنون تصور کنید شبکه بهاشتباه تنها احتمال ۰٫۰۵ به کلاس الکترونیکی اختصاص داده باشد.
زیان بهشدت افزایش پیدا میکند؛ زیرا مدل به کلاس واقعی احتمال بسیار کمی اختصاص داده است.
۳.۳.۳.نمودار احتمال کلاسها
شکل ۱۹ ـ توزیع احتمال سه کلاس در طبقهبندی محصول
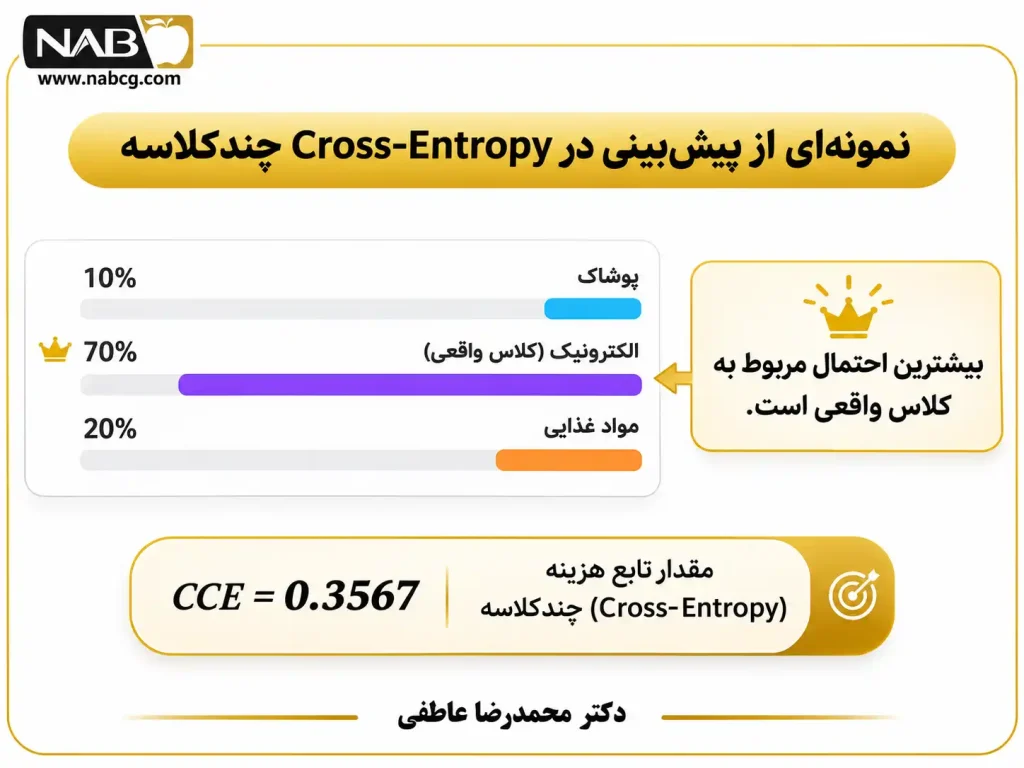
کلاس الکترونیکی بیشترین احتمال را دریافت کرده است.برای این نمونه، زیان CCE برابر ۰٫۳۵۶۷ است.
۳.۳.۴.موارد استفاده و محدودیتها
CCE برای طبقهبندی چندکلاسه با کلاسهای متقابلاً انحصاری مناسب است؛ مانند تشخیص نوع محصول، شناسایی گونه گیاه، تشخیص رقم دستنویس و طبقهبندی موضوعی متن.
اگر هر نمونه بتواند همزمان متعلق به چند کلاس باشد، استفاده از Softmax همراه با CCE معمولاً انتخاب مناسبی نیست؛ در چنین شرایطی معمولاً از چند خروجی Sigmoid و BCE استفاده میشود.
از دیگر محدودیتهای CCE میتوان به حساسیت آن به برچسبهای اشتباه، مشکلات عدمتوازن کلاسها و احتمال بیشاطمینانی مدل اشاره کرد.
۳.۳.۵.تفسیر نتایج و معیار پذیرش
برای برچسبهای One-Hot، زیان CCE غیرمنفی است و مقدار صفر حداقل نظری آن محسوب میشود.
اگر یک مدل بدون اطلاعات مفید، برای تمام (K) کلاس احتمال برابر اختصاص دهد، زیان هر نمونه برابر خواهد بود با:
برای سه کلاس:
این مقدار یک مرجع آموزشی برای پیشبینی یکنواخت است، نه آستانه جهانی پذیرش.
در مثال ما، زیان ۰٫۳۵۶۷ از زیان پیشبینی یکنواخت کمتر است.اما برای پذیرش مدل باید معیارهایی مانند Accuracy، Macro-F1، Recall کلاسهای مهم و کیفیت احتمالات روی داده آزمون بررسی شوند.
۳.۴.آنتروپی متقاطع چندکلاسه با برچسب عددی (Sparse Categorical Cross-Entropy)
در CCE معمولی، برچسبهای واقعی اغلب بهصورت بردار One-Hot نمایش داده میشوند؛ اما در بسیاری از مجموعهدادهها برچسب هر نمونه فقط یک عدد صحیح است.
برای مثال، بهجای بردار (0,1,0)، میتوان تنها عدد ۱ را برای کلاس دوم ذخیره کرد.
این شیوه در بسیاری از چارچوبها با عنوان Sparse Categorical Cross-Entropy شناخته میشود.
۳.۴.۱.فرمول ریاضی
اگر (c_i) اندیس کلاس واقعی نمونه (i) باشد:
در این رابطه:
| نماد | مفهوم |
|---|---|
| N | تعداد نمونهها |
| cᵢ | اندیس صحیح کلاس واقعی |
| p_{i,cᵢ} | احتمال پیشبینیشده برای کلاس واقعی |
| L | میانگین زیان روی نمونهها |
این تابع با CCE دارای برچسب One-Hot، از نظر ریاضی معادل است؛ تفاوت اصلی در نحوه نمایش هدف است.
۳.۴.۲.مثال عددی:تشخیص ارقام دستنویس
شبکهای را در نظر بگیرید که تصویر یک رقم را به یکی از ۱۰ کلاس طبقهبندی میکند.
برچسب واقعی رقم ۳ است:
و شبکه احتمال این کلاس را برابر ۰٫۸ پیشبینی کرده است.
اگر همین برچسب را بهصورت One-Hot دهعضوی نمایش دهیم و CCE محاسبه کنیم، نتیجه باز هم ۰٫۲۲۳۱ خواهد بود.
۳.۴.۳.شکل مفهومی نمایش برچسبها
شکل ۲۰ ـ دو شیوه نمایش یک برچسب واقعی
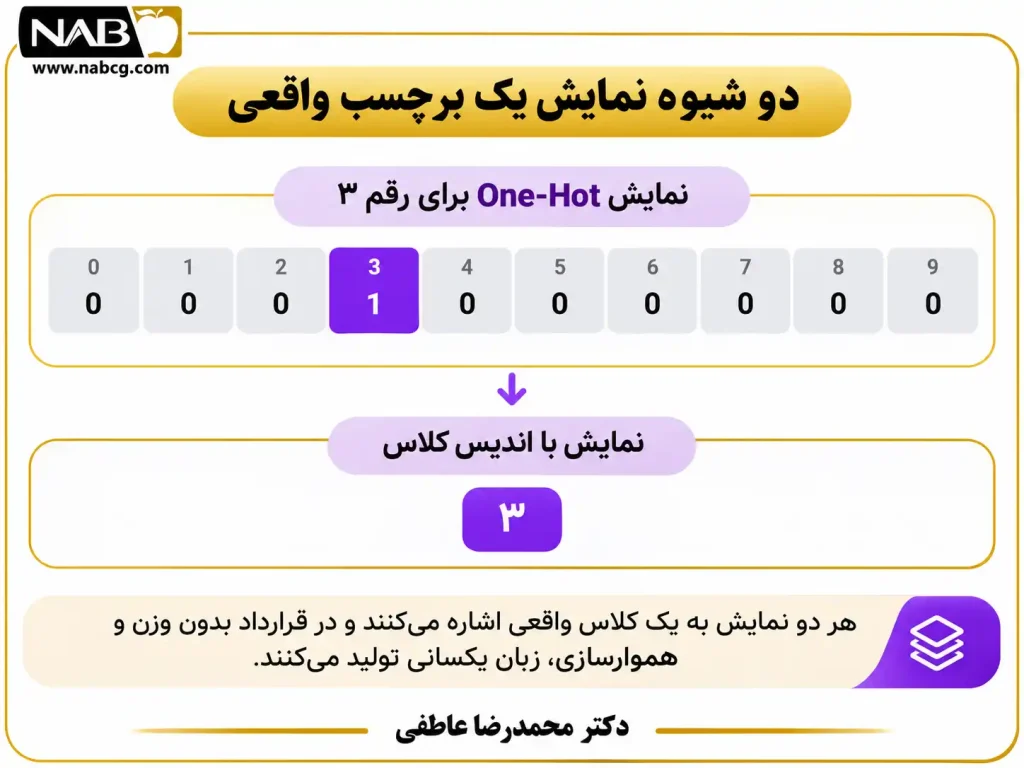
هر دو نمایش به یک کلاس واقعی اشاره میکنند و در قرارداد بدون وزن و هموارسازی، زیان یکسانی تولید میکنند.
۳.۴.۴.موارد استفاده و محدودیتها
این روش زمانی مفید است که تعداد کلاسها زیاد باشد و هر نمونه دقیقاً یک برچسب صحیح داشته باشد.در چنین شرایطی، ذخیره یک اندیس برای هر نمونه بهجای بردار One-Hot میتواند به کاهش حافظه موردنیاز برچسبها کمک کند.
محدودیت اصلی این است که نمایش ساده اندیس کلاس نمیتواند مستقیماً یک توزیع هدف نرم را نشان دهد؛ برای نمونه، اگر هدف آموزشی برای سه کلاس (0.1,0.7,0.2) باشد، یک اندیس صحیح بهتنهایی این اطلاعات را نگه نمیدارد.
۳.۴.۵.تفسیر و معیار پذیرش
مقدار زیان و تفسیر آن با CCE معادل است.بنابراین معیار پذیرش جداگانهای فقط به دلیل Sparse بودن برچسب وجود ندارد.
برای مثال، اگر CCE و Sparse CCE روی پیشبینیها و برچسبهای یکسان، بدون وزندهی اضافی و با روش تجمیع یکسان اجرا شوند، باید نتایج آنها با تلورانس خطای عددی برابر باشند.این یک آزمون مناسب برای صحت پیادهسازی است.
۳.۵.زیان لگاریتم درستنمایی منفی (Negative Log-Likelihood — NLL)
اکنون به بنیان احتمالاتی توابع آنتروپی متقاطع میرسیم.
فرض کنید شبکه عصبی یک توزیع احتمال برای کلاسهای ممکن تولید میکند.هرچه احتمال اختصاصیافته به کلاس واقعی بیشتر باشد، آن مشاهده از نظر مدل محتملتر است.
تابع Negative Log-Likelihood این احتمال را با گرفتن منفی لگاریتم به مقداری تبدیل میکند که باید کمینه شود.
۳.۵.۱.فرمول ریاضی
برای یک نمونه:
اگر احتمال کلاس واقعی را با (p_c) نشان دهیم:
و برای (N) نمونه:
تمام نمادها به این صورت تعریف میشوند: ورودی مورد بررسی، وقوع کلاس واقعی ، احتمال اختصاصیافته به کلاس واقعی نمونه i، و تعداد نمونههاست.
۳.۵.۲.مثال عددی:تشخیص نوع پیام مشتری
فرض کنید پیام یک مشتری متعلق به کلاس «شکایت» است.شبکه به سه کلاس احتمالهای زیر را اختصاص داده است:
| کلاس | احتمال |
| درخواست اطلاعات | ۰٫۲۰ |
| شکایت | ۰٫۶۰ |
| پیشنهاد | ۰٫۲۰ |
زیان:
اگر شبکه احتمال شکایت را به ۰٫۹۰ افزایش دهد:
زیان کاهش مییابد؛ زیرا شبکه اکنون احتمال بیشتری به کلاس واقعی اختصاص داده است.
۳.۵.۳.نمودار اثر احتمال کلاس واقعی بر NLL
شکل ۲۱ ـ افزایش زیان هنگامی که احتمال کلاس واقعی کاهش مییابد
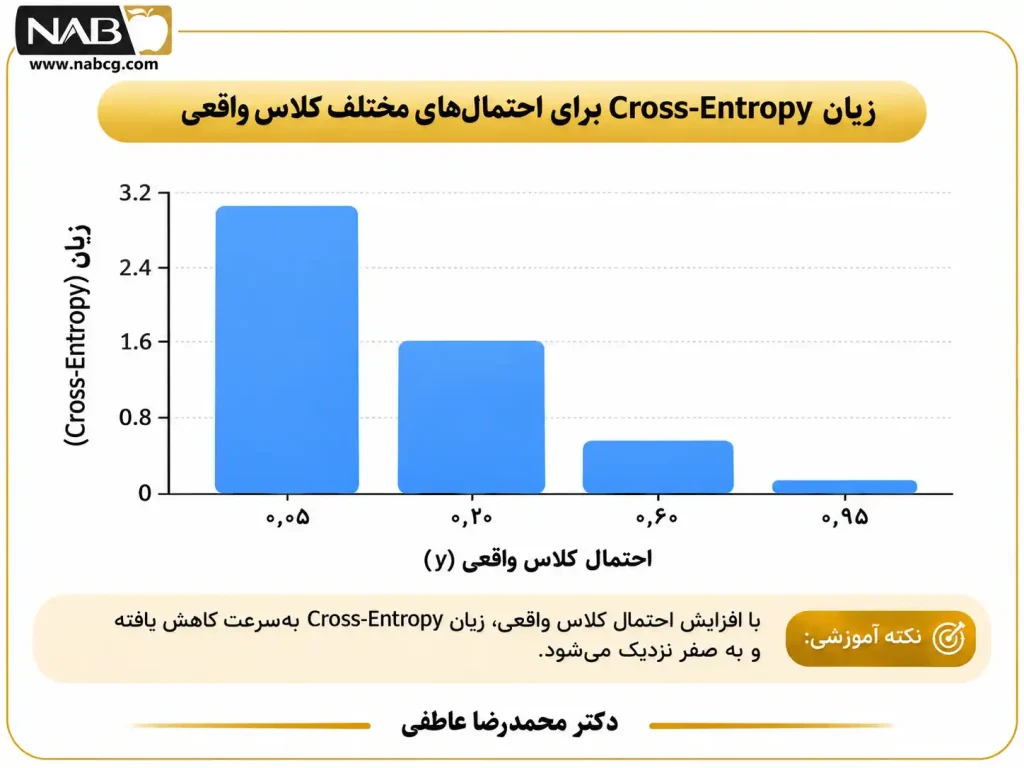
احتمال کلاس واقعی روی محور افقی و زیان روی محور عمودی نمایش داده شده است.هرچه احتمال کلاس واقعی به یک نزدیکتر شود، NLL به صفر نزدیک میشود.
۳.۵.۴.چه زمانی از NLL استفاده کنیم؟
NLL زمانی مناسب است که مدل یک توزیع احتمالاتی تعریف کند و بخواهیم احتمال مشاهدات واقعی را بیشینه کنیم.
در طبقهبندی، NLL با Log-Softmax و برچسبهای کلاس استفاده میشود.در مدلهای احتمالاتی دیگر نیز صورتهای تخصصی NLL وجود دارند؛ همانطور که Gaussian NLL و Poisson NLL را در رگرسیون بررسی کردیم.
در مستندات PyTorch، تابع NLLLoss ورودی را بهصورت لگاریتم احتمال کلاسها دریافت میکند و استفاده از LogSoftmax پیش از آن روش معمولی است.
۳.۵.۵.محدودیتها
اگر احتمال کلاس واقعی به صفر نزدیک شود، NLL بسیار بزرگ میشود.همچنین پیشبینیهای دارای برچسب اشتباه، بهویژه وقتی مدل نسبت به کلاس غلط بسیار مطمئن باشد، میتوانند زیان بزرگی تولید کنند.
در طبقهبندی گسسته، زیان غیرمنفی است.اما این ویژگی نباید بدون بررسی به تمام NLLهای مبتنی بر چگالیهای پیوسته تعمیم داده شود.
۳.۵.۶.تفسیر نتایج و معیار پذیرش
برای طبقهبندی با برچسبهای قطعی، مقدار کمتر NLL مطلوبتر است و حداقل نظری آن صفر است.
در مثال ما، NLL برابر ۰٫۵۱۰۸ به معنی خطای ۵۱ درصد نیست؛ بلکه منفی لگاریتم احتمال کلاس واقعی است.
معیار پذیرش باید شامل مقایسه NLL با مدل مرجع روی داده آزمون و ارزیابی معیارهای طبقهبندی باشد.در کاربردهایی که کیفیت احتمال اهمیت دارد، کالیبراسیون نیز باید بررسی شود.
۳.۵.۷.رابطه NLL با CCE
نکته مهم این است که برای یک مسئله طبقهبندی چندکلاسه با برچسب One-Hot، CCE و NLL محاسبه یکسانی انجام میدهند:
بنابراین تفاوت اساسی در اینجا بیشتر به نمایش ورودی و نحوه پیادهسازی مربوط است، نه یک قاعده جریمه جدید.
۳.۶.زیان BCEWithLogits؛ محاسبه پایدار طبقهبندی دودویی
در بخش BCE فرض کردیم شبکه مستقیماً مقدار احتمال (p) را تولید میکند.اما در یک شبکه عصبی، خروجی آخرین لایه خطی اغلب عددی موسوم به لاجیت (Logit) است.
لاجیت میتواند هر عدد حقیقی باشد.برای تبدیل آن به احتمال، از تابع Sigmoid استفاده میکنیم:
که در آن (z) لاجیت خروجی شبکه است.
در روش معمولی میتوان ابتدا Sigmoid و سپس BCE را محاسبه کرد.اما برای آموزش شبکه، محاسبه ترکیبی و پایدارتر انتخاب مناسبی است.
۳.۶.۱.فرمول ریاضی
برای یک نمونه با برچسب (yin{0,1}):
این رابطه از نظر ریاضی با BCE روی احتمال σ(z) معادل است.
برای پایداری عددی بهتر، صورت زیر استفاده میشود:
در این فرمول:
| نماد | مفهوم |
| (z) | لاجیت خروجی شبکه |
| (y) | برچسب واقعی صفر یا یک |
| (σ(z)) | احتمال بهدستآمده از Sigmoid |
| (max(z,0)) | بزرگترین مقدار میان (z) و صفر |
| (e) | ثابت اویلر در تابع نمایی |
۳.۶.۲.مثال عددی:تشخیص تقلب
فرض کنید خروجی خام شبکه:
و برچسب واقعی:
ابتدا احتمال را برای تفسیر محاسبه میکنیم:
در نتیجه BCE معمولی:
اکنون روش BCEWithLogits:
دو روش از نظر ریاضی به یک مقدار میرسند.
۳.۶.۳.شکل مسیر محاسبه دو روش
شکل ۲۲ ـ BCE معمولی در برابر BCEWithLogits
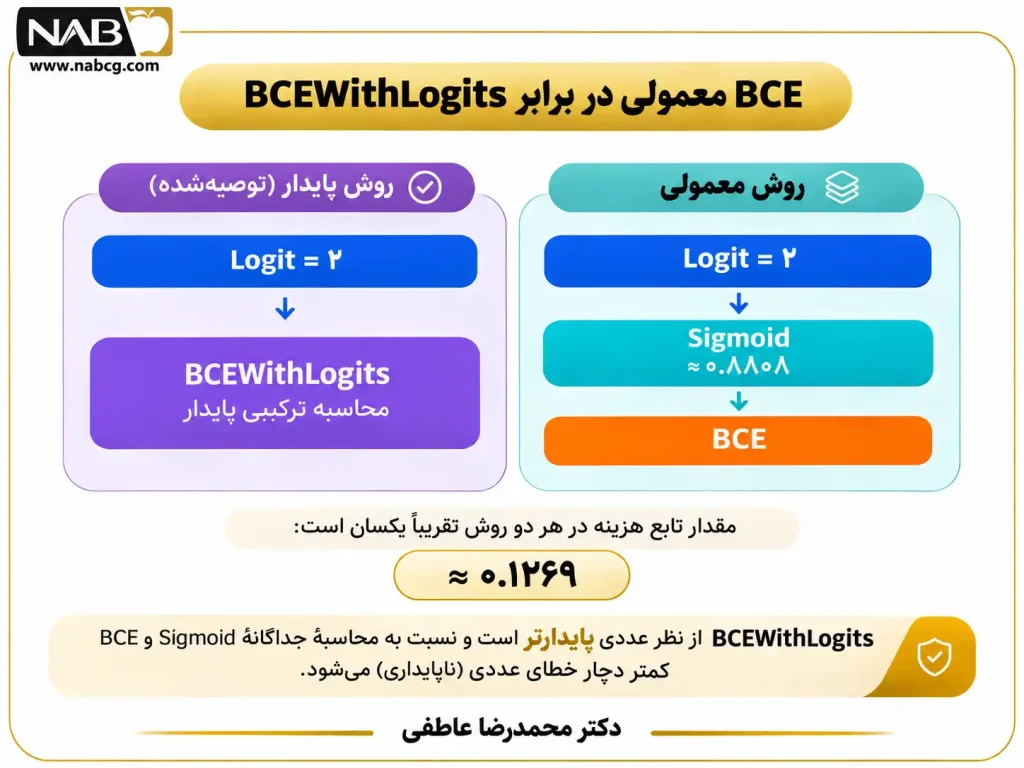
روش سمت راست از نظر ریاضی همان BCE است، اما در محاسبات عددی از صورت پایدارتر استفاده میکند.
۳.۶.۴.موارد استفاده و محدودیتها
BCEWithLogits برای طبقهبندی دودویی و چندبرچسبی در شبکههایی که خروجی خام آنها لاجیت است، بسیار مناسب است.
این روش در PyTorch با ترکیب Sigmoid و BCE و استفاده از تکنیک Log-Sum-Exp، پایداری عددی بیشتری نسبت به محاسبه جداگانه این دو عملیات فراهم میکند.
محدودیت مهم آن این است که ورودی باید لاجیت خام باشد.اگر خروجی قبلاً از Sigmoid عبور کرده باشد، اعمال BCEWithLogits روی آن محاسبه اشتباهی ایجاد میکند.
این روش نیز بهخودیخود مشکل دادههای نامتوازن یا کالیبراسیون نامناسب احتمالها را برطرف نمیکند.
۳.۶.۵.تفسیر و معیار پذیرش
BCEWithLogits و BCE معمولی، در شرایط معادل، هدف ریاضی یکسانی را کمینه میکنند.بنابراین دامنه و معیارهای پذیرش آنها یکسان است.
تفاوت اصلی در قابلیت اطمینان محاسبات عددی، بهویژه هنگام وجود لاجیتهای بسیار بزرگ مثبت یا منفی، است.
در یک پروژه تشخیص تقلب، باید مقدار زیان روی داده آزمون، Recall، Precision، PR-AUC، هزینه خطاهای تصمیمگیری و پایداری مدل بررسی شود.
۳.۷.جمعبندی و مقایسه توابع پایه طبقهبندی
چهار روش CCE، Sparse CCE، NLL و BCEWithLogits در نگاه اول ممکن است الگوریتمهای کاملاً متفاوتی به نظر برسند.اما بررسی ریاضی نشان میدهد برخی از آنها صورتهای متفاوت نمایش و پیادهسازی یک هدف احتمالاتی مشترک هستند.
| تابع | نوع مسئله | ورودی مورد انتظار | نکته اصلی |
| BCE | دودویی و چندبرچسبی | احتمال | منفی لگاریتم احتمال نتیجه واقعی |
| CCE | چندکلاسه انحصاری | توزیع احتمال در تعریف ریاضی | برچسب One-Hot یا توزیع هدف |
| Sparse CCE | چندکلاسه انحصاری | احتمال و اندیس کلاس | نمایش فشرده برچسب |
| NLL | طبقهبندی احتمالاتی | لگاریتم احتمال | محاسبه زیان کلاس واقعی |
| BCEWithLogits | دودویی و چندبرچسبی | لاجیت خام | محاسبه عددی پایدارتر BCE |
نکته پیادهسازی:در PyTorch، CrossEntropyLoss مستقیماً لاجیتهای خام را میپذیرد و عملیات Log-Softmax و NLL را در یک تابع انجام میدهد.بنابراین نباید به تصور اینکه CCE حتماً احتمال میخواهد، پیش از این تابع Softmax جداگانه اعمال کرد.
تمرین تحلیلی
فرض کنید یک شبکه سه کلاس دارد و برای کلاس واقعی احتمال ۰٫۸ تولید کرده است.زیان CCE را محاسبه کنید.سپس نشان دهید اگر همان داده با برچسب عددی و Sparse CCE یا با لگاریتم احتمال و NLL محاسبه شود، مقدار یکسانی حاصل میشود.
پاسخ مورد انتظار در قرارداد بدون وزندهی اضافی:
۳.۸.تابع زیان Hinge؛ یادگیری با حاشیه اطمینان
در توابع آنتروپی متقاطع، هدف شبکه افزایش احتمال تعلق نمونه به کلاس واقعی بود.اما در برخی روشهای طبقهبندی، مسئله تنها احتمال کلاس نیست؛ بلکه میخواهیم نمونه در سمت صحیح مرز تصمیم و با فاصله مناسبی از آن قرار گیرد.
فرض کنید شبکه عصبی تراکنشهای بانکی را به دو گروه عادی و مشکوک تقسیم میکند.اگر یک تراکنش تنها اندکی در سمت درست مرز تصمیم قرار گرفته باشد، ممکن است تغییر کوچکی در ویژگیهای آن باعث اشتباه مدل شود.
تابع زیان Hinge برای تشویق طبقهبندی صحیح همراه با حاشیه تصمیم (Decision Margin) طراحی شده است.این تابع ارتباط تاریخی نزدیکی با ماشینهای بردار پشتیبان (Support Vector Machines) دارد.
۳.۸.۱.فرمول ریاضی و تعریف پارامترها
در این رابطه:
| نماد | مفهوم |
| (y) | برچسب واقعی، برابر ۱+ یا ۱− |
| (s) | امتیاز خام خروجی مدل |
| (ys) | حاشیه علامتدار نمونه |
| (1) | حاشیه هدف در این قرارداد |
| (max) | انتخاب بزرگترین مقدار میان دو عبارت |
برخلاف BCE، مقدار (s) لزوماً یک احتمال نیست و میتواند هر عدد حقیقی باشد.
اگر، زیان صفر میشود.اگر (ys<1)، نمونه با زیان مثبت مواجه خواهد شد؛ حتی اگر در سمت درست مرز تصمیم قرار گرفته باشد.
۳.۸.۲.مثال عددی:طبقهبندی چهار تراکنش
| تراکنش | برچسب (y) | امتیاز (s) | حاصلضرب (ys) | زیان |
| A | ۱+ | ۲ | ۲ | ۰ |
| B | ۱+ | ۰٫۴ | ۰٫۴ | ۰٫۶ |
| C | ۱− | ۰٫۵− | ۰٫۵ | ۰٫۵ |
| D | ۱− | ۱ | ۱− | ۲ |
- برای تراکنش A:
- برای تراکنش B:
- برای تراکنش C:
- برای تراکنش D:
بنابراین میانگین زیان:
تراکنش D نهتنها حاشیه کافی ندارد، بلکه در سمت اشتباه مرز تصمیم قرار گرفته است.
۳.۸.۳.نمودار تابع Hinge
شکل ۲۳ ـ رابطه حاشیه علامتدار و زیان Hinge
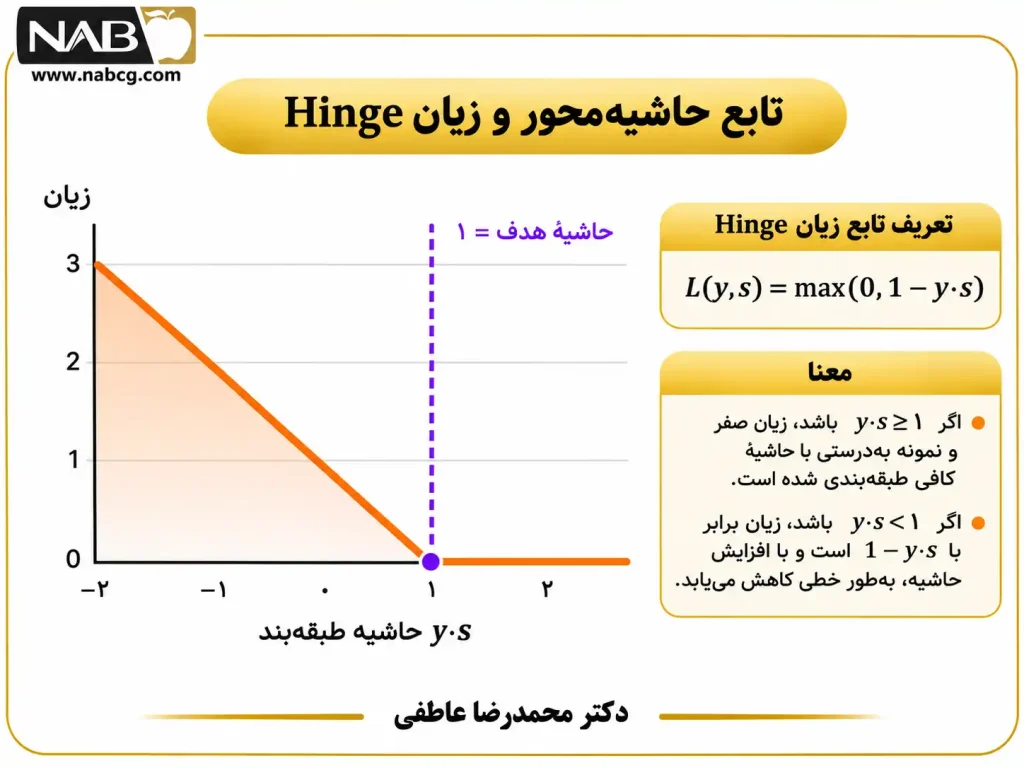
شکل ۲۳ ـ پس از رسیدن حاشیه علامتدار به مقدار ۱، زیان Hinge صفر میشود.نمونههایی که در سمت درست مرز تصمیم قرار دارند، ممکن است همچنان زیان مثبت داشته باشند.
۳.۸.۴.موارد استفاده و محدودیتها
Hinge Loss برای طبقهبندی حاشیهمحور، شبکههای دارای خروجی امتیازی و مقایسه با روشهای مبتنی بر SVM مناسب است.
محدودیت مهم آن است که خروجی مدل را مستقیماً به احتمال کالیبرهشده تبدیل نمیکند.همچنین تابع در نقطه حاشیه یک مشتق کلاسیک ندارد، اگرچه با زیرگرادیان قابل بهینهسازی است.
زیان صفر نیز به معنای تضمین پایداری مدل در برابر هر نوع تغییر ورودی نیست؛ زیرا حاشیه امتیازی با فاصله هندسی یا مقاومت واقعی در برابر اختلال لزوماً یکسان نیست.
۳.۸.۵.تفسیر و معیار پذیرش
زیان Hinge غیرمنفی است و صفر نشان میدهد تمام نمونههای بررسیشده دستکم حاشیه هدف را رعایت کردهاند.
اما صفر بودن زیان روی دادههای آموزش، تضمینکننده عملکرد مناسب روی دادههای آزمون نیست.
برای پذیرش مدل باید Accuracy، Precision، Recall، F1 و عملکرد در شرایط تغییر توزیع دادهها بررسی شود.مقدار حاشیه و مقیاس امتیاز خروجی نیز باید در تفسیر لحاظ شود.
۳.۹.تابع Squared Hinge؛ افزایش جریمه نقض حاشیه
در Hinge معمولی، اگر نمونهای حاشیه هدف را رعایت نکند، زیان بهصورت خطی با مقدار نقض حاشیه افزایش مییابد.
اما گاهی میخواهیم نقضهای بزرگتر حاشیه، جریمه شدیدتری دریافت کنند.در این شرایط میتوان از Squared Hinge Loss استفاده کرد.
۳.۹.۱.فرمول ریاضی
در این رابطه، (y) برچسب ۱+ یا ۱−، (s) امتیاز خام مدل و (ys) حاشیه علامتدار است.
تفاوت این تابع با Hinge در مجذورشدن نقض حاشیه است.
۳.۹.۲.مثال عددی
چهار مقدار حاشیه علامتدار را در نظر بگیرید:
که (m=ys) است.
برای هر نمونه:
بنابراین:
برای همین نمونهها، میانگین Hinge معمولی برابر است با:
مقایسه نشان میدهد Squared Hinge برای نقضهای بزرگ حاشیه جریمه بیشتری نسبت به Hinge اعمال میکند.
۳.۹.۳.نمودار مقایسه دو تابع
شکل ۲۴ ـ مقایسه Hinge و Squared Hinge در نقض حاشیه
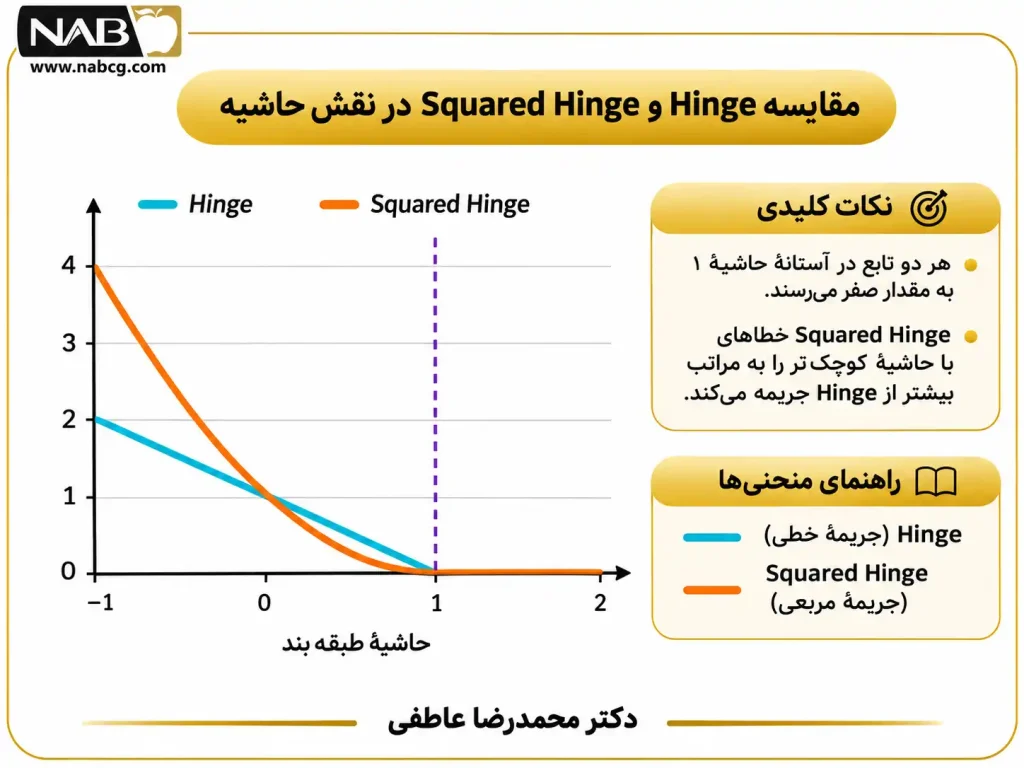
شکل ۲۴ ـ برای نقض حاشیه بزرگتر از یک، Squared Hinge سریعتر افزایش مییابد.برای نقضهای کوچکتر از یک، مربعکردن مقدار، زیان عددی کوچکتری ایجاد میکند.
۳.۹.۴.موارد استفاده و محدودیتها
Squared Hinge در طبقهبندی حاشیهمحور و شرایطی که نقضهای بزرگ حاشیه باید با شدت بیشتری جریمه شوند، کاربرد دارد.
با این حال، نسبت به نمونههای بسیار دشوار یا برچسبهای اشتباه میتواند حساستر از Hinge باشد.همچنین مانند Hinge، بهصورت ذاتی خروجی احتمالاتی کالیبرهشده ارائه نمیکند.
این تابع پیوسته مشتقپذیر است، اما مشتق دوم آن در محل اتصال قطعات پیوسته نیست.
۳.۹.۵.تفسیر و معیار پذیرش
کمینه نظری Squared Hinge صفر است و زمانی به دست میآید که تمام نمونهها حاشیه موردنیاز را رعایت کنند.
برای پذیرش مدل، علاوه بر بررسی زیان اعتبارسنجی، باید عملکرد طبقهبندی و هزینه اشتباهات در کاربرد موردنظر ارزیابی شود.عدد ۱٫۳۱۲۵ در مثال، بدون مدل مرجع و معیارهای تکمیلی، برچسب «خوب» یا «بد» ندارد.
۳.۱۰.تابع زیان Hinge چندکلاسه (Multi-Class Hinge Loss)
در طبقهبندی دودویی، دو کلاس در دو سوی یک مرز تصمیم قرار میگرفتند.اما اگر مسئله شامل سه یا تعداد بیشتری کلاس باشد، دیگر یک امتیاز مثبت یا منفی برای توصیف تمام کلاسها کافی نیست.
فرض کنید شبکه عصبی باید تصاویر محصولات را در سه گروه پوشاک، الکترونیکی و مواد غذایی طبقهبندی کند.شبکه برای هر کلاس یک امتیاز خام تولید میکند و کلاس دارای بیشترین امتیاز را انتخاب میکند.
هدف Multi-Class Hinge Loss آن است که امتیاز کلاس واقعی از امتیاز تمام کلاسهای اشتباه، بهاندازه یک حاشیه مشخص بیشتر باشد.
۳.۱۰.۱.فرمول و پارامترها
یکی از صورتهای رایج این تابع، نسخه Crammer–Singer است:
که در آن:
| نماد | تعریف |
| (c) | اندیس کلاس واقعی |
| (s_c) | امتیاز خام کلاس واقعی |
| (s_j) | امتیاز خام کلاس اشتباه (j) |
| (Delta) | حاشیه مطلوب، معمولاً برابر ۱ |
| (jne c) | تمام کلاسهای غیرواقعی |
| (L) | زیان حاشیهای نمونه |
این تعریف مبتنی بر بزرگترین امتیاز کلاس رقیب است.نسخههای دیگری نیز وجود دارند که نقض حاشیه را برای تمام کلاسهای اشتباه جمع میکنند؛ بنابراین هنگام پیادهسازی باید قرارداد دقیق تابع مشخص شود.
۳.۱۰.۲.مثال عددی:تشخیص نوع محصول
فرض کنید کلاس واقعی یک تصویر «الکترونیکی» باشد.شبکه امتیازهای زیر را تولید کرده است.
| کلاس | امتیاز خام |
| پوشاک | ۱٫۵ |
| الکترونیکی (واقعی) | ۲٫۰ |
| مواد غذایی | ۰٫۵ |
با فرض (Δ=1)، بزرگترین امتیاز کلاس اشتباه برابر ۱٫۵ است.
شبکه کلاس درست را انتخاب کرده است، اما فاصله امتیاز آن از نزدیکترین رقیب تنها ۰٫۵ است؛ درحالیکه حاشیه مطلوب برابر ۱ است.
اگر امتیاز کلاس واقعی به ۲٫۷ افزایش پیدا کند:
اکنون کلاس واقعی حاشیه موردنیاز را رعایت میکند.
۳.۱۰.۳.نمودار مقایسه امتیاز کلاسها
شکل ۲۵ ـ امتیاز کلاس واقعی و بزرگترین رقیب
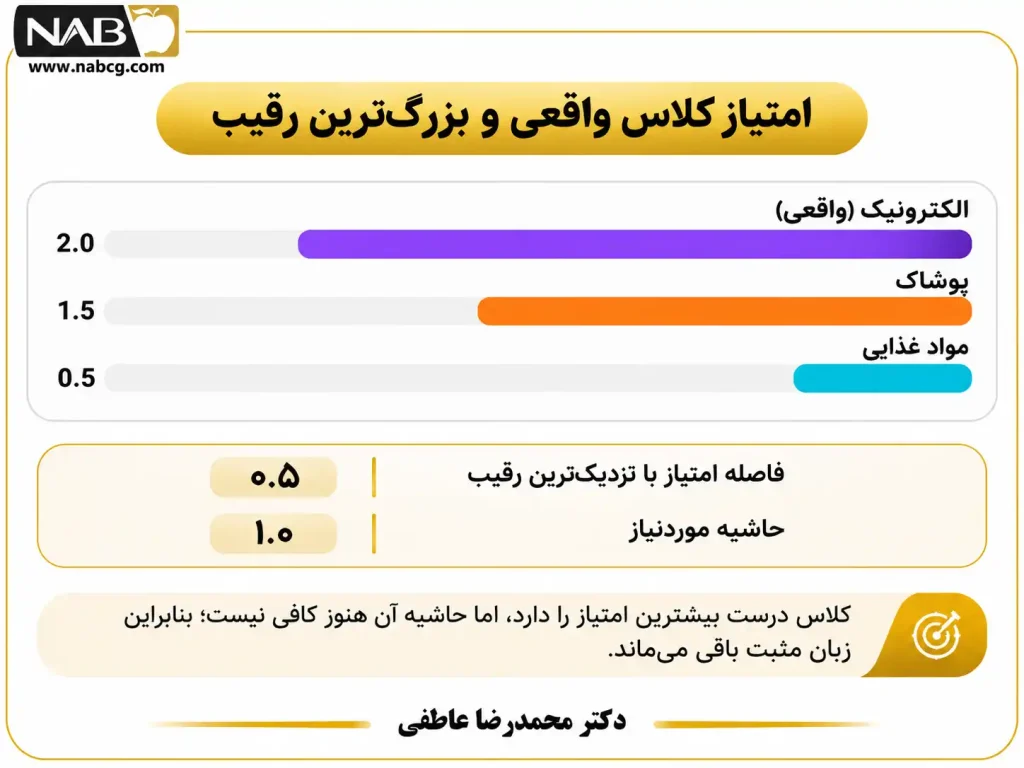
کلاس درست بیشترین امتیاز را دارد، اما حاشیه آن هنوز کافی نیست؛ بنابراین زیان مثبت باقی میماند.
۳.۱۰.۴.موارد استفاده و محدودیتها
این تابع در طبقهبندی چندکلاسه حاشیهمحور، برخی شبکههای یادگیری نمایش و روشهای مبتنی بر SVM کاربرد دارد.
محدودیت اصلی آن است که امتیازها مستقیماً احتمال کالیبرهشده نیستند.همچنین نسخه مبتنی بر بزرگترین رقیب، در هر نمونه عمدتاً بر شدیدترین نقض حاشیه تمرکز دارد و رفتار آن با نسخه جمعی متفاوت است.
وجود برچسبهای اشتباه یا نمونههای بسیار دشوار نیز میتواند روند آموزش را تحت تأثیر قرار دهد.
۳.۱۰.۵.تفسیر و معیار پذیرش
زیان صفر یعنی امتیاز کلاس واقعی دستکم بهاندازه حاشیه تعیینشده از امتیاز تمامی رقیبان بیشتر است.
در مثال اول، مقدار ۰٫۵ به معنای کمبود ۰٫۵ واحد امتیاز نسبت به حاشیه هدف است؛ نه خطای ۵۰ درصد.
برای پذیرش مدل باید زیان اعتبارسنجی با مدل مرجع و شاخصهایی مانند Accuracy و Macro-F1 مقایسه شود.در کاربردهای حساس، عملکرد جداگانه هر کلاس نیز اهمیت دارد.
۳.۱۱.تابع زیان Focal؛ تمرکز آموزش بر نمونههای دشوار
در بسیاری از مسائل طبقهبندی، تعداد نمونههای متعلق به کلاسهای مختلف یکسان نیست.
برای مثال، در یک مجموعهداده شامل ۱۰۰ هزار تراکنش بانکی، ممکن است تنها تعداد اندکی از تراکنشها مشکوک باشند.
در چنین وضعیتی، تعداد زیاد تراکنشهای عادی و آسان میتواند بر مجموع زیان آموزش اثر قابلتوجهی داشته باشد.
Focal Loss برای کاهش سهم نسبی نمونههایی که مدل آنها را با احتمال بالا درست پیشبینی کرده است، طراحی شد.این روش در مقاله Lin و همکاران (۲۰۱۷) برای تشخیص اشیای متراکم معرفی شد.
۳.۱۱.۱.فرمول و تعریف پارامترها
صورت متداول Focal Loss برای یک نمونه عبارت است از:
در این رابطه:
| نماد | مفهوم |
| (p_t) | احتمال پیشبینیشده برای کلاس واقعی |
| (alpha_t) | وزن کلاس واقعی |
| (gamma) | پارامتر تمرکز، عدد نامنفی |
| (1-p_t) | میزان دوربودن احتمال کلاس واقعی از یک |
| (FL) | زیان Focal نمونه |
در طبقهبندی دودویی، اگر (p) احتمال کلاس مثبت باشد:
وقتی γ = ۰ و α_t = ۱ باشد، Focal Loss دقیقاً به Cross-Entropy معمولی تبدیل میشود.
هرچه γ بزرگتر شود، وزن نمونههای آسان، یعنی نمونههایی با p_t نزدیک به یک، سریعتر کاهش مییابد.
۳.۱۱.۲.مثال عددی:دو تراکنش با دشواری متفاوت
برای روشنشدن اثر پارامتر تمرکز، فرض کنید:
در این مثال آموزشی، وزن کلاسها را برابر یک قرار میدهیم تا فقط اثر γ بررسی شود.
نمونه اول آسان است و شبکه به کلاس واقعی احتمال ۰٫۹ میدهد:
زیان Cross-Entropy:
عامل تمرکز:
پس:
نمونه دوم دشوار است و شبکه فقط احتمال ۰٫۲ به کلاس واقعی اختصاص میدهد:
زیان Cross-Entropy:
عامل تمرکز:
بنابراین:
تفاوت مهم این است که وزن زیان نمونه آسان به یکصدم و وزن زیان نمونه دشوار به ۰٫۶۴ مقدار Cross-Entropy آنها تبدیل شده است.
۳.۱۱.۳.نمودار تعاملی تأثیر پارامتر تمرکز
شکل ۲۶ ـ مقایسه Focal Loss و Cross-Entropy
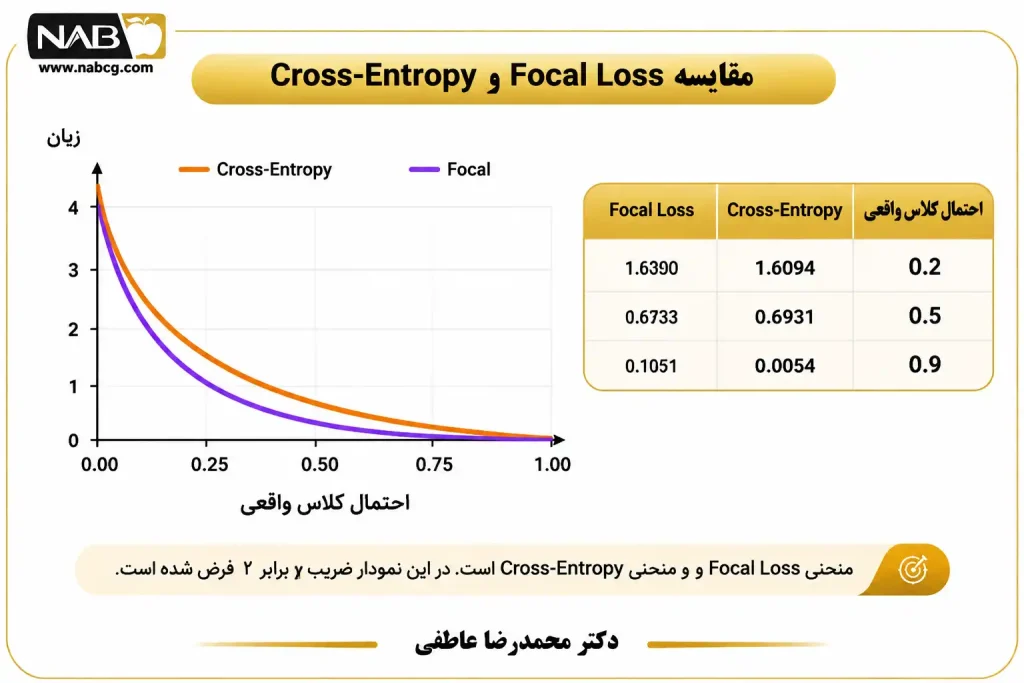
شکل ۲۶ ـ منحنی بنفش Focal Loss و منحنی نارنجی Cross-Entropy است.در این نمودار ضریب α برابر یک فرض شده است.تغییر γ سهم نسبی نمونههای آسان را کاهش میدهد.
۳.۱۱.۴.موارد استفاده و محدودیتها
Focal Loss بهویژه برای تشخیص اشیا، یادگیری از نمونههای نامتوازن و مسئلههایی که تعداد نمونههای آسان بسیار زیاد است، مناسب است.
برای مثال، در شناسایی نواحی دارای نقص در تصاویر صنعتی، ممکن است بخش بزرگی از تصویر پسزمینه عادی باشد.Focal Loss میتواند سهم این نمونههای آسان را کاهش دهد تا شبکه بیشتر بر موارد دشوار تمرکز کند.
اما این روش محدودیتهایی دارد:
- پارامتر γ و وزن α_t نیازمند تنظیم هستند.
- نمونههای دشوار همیشه نمونههای مفید نیستند؛ برخی ممکن است برچسب اشتباه داشته باشند.
- استفاده از Focal Loss لزوماً به بهترین کالیبراسیون احتمالات منجر نمیشود.
- کمشدن مقدار عددی Focal Loss در مقایسه با BCE به معنی بهترشدن مدل نیست؛ زیرا خود تابع هدف تغییر کرده است.
۳.۱۱.۵.تفسیر نتایج و معیار پذیرش
Focal Loss غیرمنفی است و مقدار صفر حداقل نظری آن است.
در مثال ما، زیان نمونه آسان حدود ۰٫۰۰۱ و زیان نمونه دشوار حدود ۱٫۰۳ بود.این اختلاف نشان میدهد تابع در آموزش به نمونه دشوار وزن نسبی بیشتری اختصاص میدهد.
برای پذیرش مدل در دادههای نامتوازن، معیارهای زیر اهمیت دارند:Recall کلاس نادر، Precision، PR-AUC، تعداد خطاهای مثبت و منفی کاذب و هزینه عملیاتی آنها.
فرض کنید سامانه تشخیص تقلب باید حداقل ۹۵ درصد تراکنشهای تقلبی را شناسایی کند و نرخ هشدار اشتباه نیز از یک سقف مشخص بیشتر نباشد.مدل تنها در صورت رعایت این شرایط روی داده آزمون، از نظر عملیاتی قابلپذیرش خواهد بود.
Focal Loss یک راهبرد برای جهتدهی آموزش است؛ نه جایگزینی برای ارزیابی مستقل عملکرد مدل.
۳.۱۲.واگرایی کولبک–لایبلر (Kullback–Leibler Divergence — KL)
تا اینجا بیشتر توابع زیان را برای مقایسه یک برچسب واقعی با خروجی شبکه بررسی کردیم.اما در برخی مسائل، هدف آموزشی خود یک توزیع احتمال است.
برای مثال، یک شبکه معلم ممکن است برای یک تصویر به سه کلاس احتمالهای مختلف اختصاص دهد و بخواهیم شبکه دانشآموز همین توزیع را یاد بگیرد.
در این وضعیت، تنها دانستن کلاس دارای بیشترین احتمال کافی نیست.لازم است میزان اختلاف دو توزیع احتمالاتی اندازهگیری شود.
یکی از معیارهای بنیادی برای این کار، واگرایی کولبک–لایبلر است.
۳.۱۲.۱.فرمول و پارامترها
برای دو توزیع گسسته (P) و (Q):
در این رابطه:
| نماد | مفهوم |
|---|---|
| P(k) | احتمال کلاس k در توزیع هدف |
| Q(k) | احتمال کلاس k در توزیع مدل |
| K | تعداد کلاسها |
| log | لگاریتم طبیعی |
| Dₖₗ | واگرایی توزیع هدف از توزیع مدل |
شرط مهم آن است که هرجا (P(k)>0)، مقدار (Q(k)) نیز مثبت باشد؛ در غیر این صورت واگرایی میتواند بینهایت شود.
واگرایی KL غیرمنفی است و برای توزیعهای یکسان صفر میشود، اما متقارن نیست:
۳.۱۲.۲.مثال عددی:انتقال دانش از شبکه معلم
فرض کنید شبکه معلم و شبکه دانشآموز برای یک تصویر این توزیعها را تولید کردهاند:
واگرایی برابر است با:
سهم هر کلاس:
بنابراین:
منفیبودن سهم بعضی کلاسها اشکالی ندارد؛ زیرا مجموع نهایی واگرایی KL همواره غیرمنفی است.
۳.۱۲.۳.نمودار توزیع هدف و پیشبینیشده
شکل ۲۷ ـ مقایسه توزیعهای معلم و دانشآموز
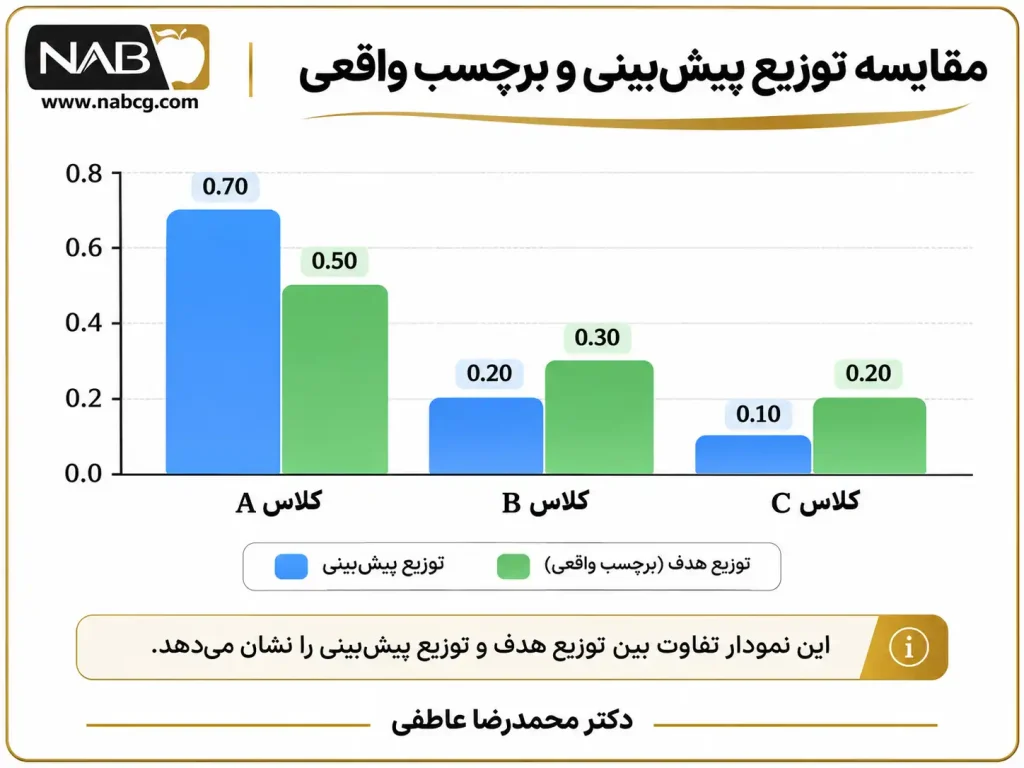
■ توزیع معلم آبی
■ توزیع دانشآموز
شکل ۲۷ ـ دانشآموز به کلاس A احتمال کمتری و به کلاسهای B و C احتمال بیشتری نسبت به معلم اختصاص داده است.واگرایی KL اختلاف کل توزیعها را میسنجد.
۳.۱۲.۴.موارد استفاده و محدودیتها
KL در انتقال دانش (Knowledge Distillation)، مدلهای احتمالاتی، تنظیم فضای نهفته در VAE و تطبیق توزیعها کاربرد دارد.
محدودیتهای آن شامل نامتقارنبودن، امکان بینهایتشدن در شرایط خاص و وابستگی نتیجه به جهت مقایسه است.
همچنین KL یک فاصله متریک ریاضی نیست؛ زیرا بهطور کلی ویژگی تقارن و نابرابری مثلثی را ندارد.
۳.۱۲.۵.تفسیر و معیار پذیرش
در مثال، KL حدود ۰٫۰۸۵۱ نات است؛ زیرا از لگاریتم طبیعی استفاده کردهایم.
این مقدار نشاندهنده نزدیکی نسبی دو توزیع است، اما بهتنهایی تضمین نمیکند شبکه دانشآموز در طبقهبندی واقعی عملکرد مطلوبی دارد.
برای پذیرش مدل انتقال دانش باید KL روی داده اعتبارسنجی، دقت یا سایر معیارهای عملکرد وظیفه اصلی و عملکرد نسبت به مدل معلم یا خط مبنا بررسی شود.
در ضمن، چون:
اگر توزیع هدف P ثابت باشد، کمینهسازی آنتروپی متقاطع و کمینهسازی D_KL(P‖Q) نسبت به پارامترهای Q به جواب یکسانی منجر میشود.
۳.۱۳.واگرایی جنسن–شانون (Jensen–Shannon Divergence — JS)
واگرایی KL برای مقایسه دو توزیع بسیار مفید است، اما دو محدودیت مهم دارد:نامتقارن است و ممکن است بینهایت شود.
واگرایی جنسن–شانون این دو مشکل را با مقایسه هر توزیع نسبت به توزیع میانگین برطرف میکند.
۳.۱۳.۱.فرمول ریاضی
ابتدا میانگین دو توزیع را تعریف میکنیم:
سپس:
در این رابطه P و Q توزیعهای احتمالاتی، M میانگین آنها و D_KL واگرایی کولبک–لایبلر است.
با لگاریتم طبیعی، دامنه JS بهصورت زیر است:
یعنی:
JS متقارن است و برای توزیعهای یکسان مقدار صفر دارد.
۳.۱۳.۲.مثال عددی:مقایسه دو توزیع دودویی
فرض کنید:
ابتدا توزیع میانگین را به دست میآوریم:
گام اول، واگرایی (P) از (M):
گام دوم، واگرایی (Q) از (M):
در نتیجه:
۳.۱۳.۳.نمودار مقایسه سه توزیع
شکل ۲۸ ـ توزیع هدف، مدل و توزیع میانگین
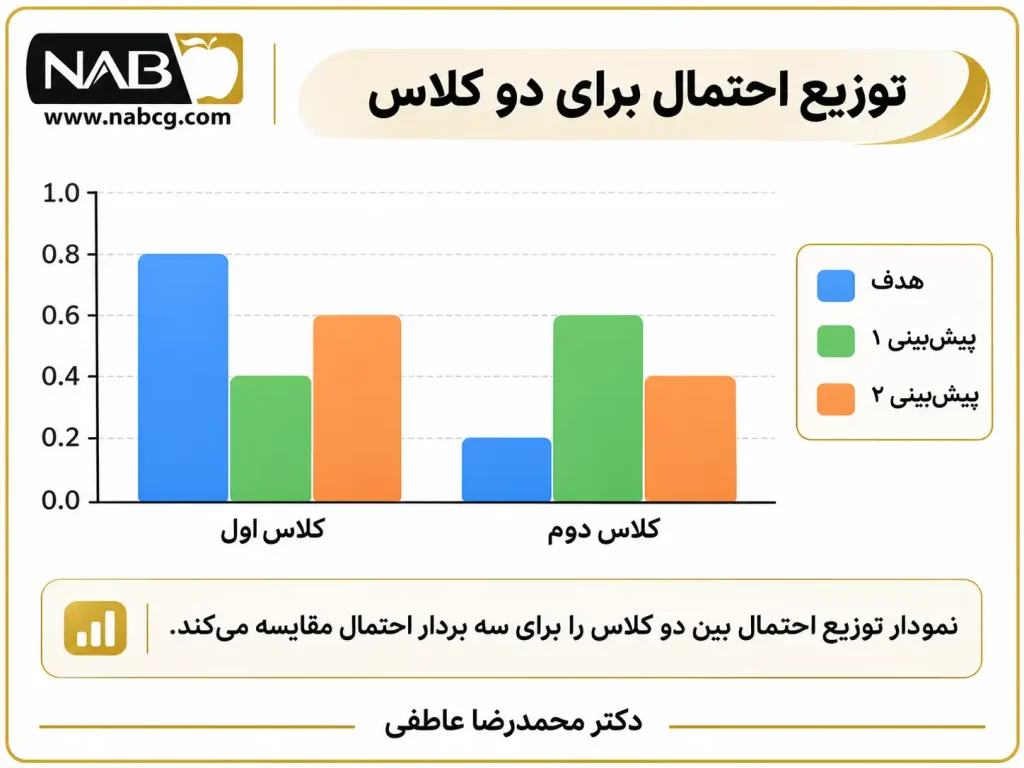
- توزیع P آبی
- توزیع Q سبز
- میانگین M
شکل ۲۸ ـ JS بهجای مقایسه مستقیم یک توزیع با دیگری، هر دو را نسبت به توزیع میانگین میسنجد.
۳.۱۳.۴.موارد استفاده و محدودیتها
JS برای مقایسه توزیعهای احتمالاتی، تحلیل تفاوت خروجی مدلها و برخی فرمولبندیهای یادگیری مولد کاربرد دارد.
بااینحال، صفر یا کوچکبودن JS الزاماً نشاندهنده عملکرد مناسب مدل در وظیفه اصلی نیست.همچنین در برخی مسائل مولد، زمانی که توزیعها همپوشانی بسیار کمی دارند، اهداف مبتنی بر JS میتوانند سیگنال یادگیری نامناسب یا ضعیفی فراهم کنند.
محاسبه JS نیز بهصورت خودکار جایگزین تمام ویژگیهای مطلوب یک تابع زیان آموزشی نمیشود.
۳.۱۳.۵.تفسیر و معیار پذیرش
JS با لگاریتم طبیعی بین صفر و حدود ۰٫۶۹۳۱ قرار دارد.صفر نشاندهنده برابری دو توزیع است.
اگر در یک پروژه هدف نزدیککردن توزیع پیشبینیشده به توزیع مرجع باشد، میتوان کاهش JS روی مجموعه ارزیابی ثابت را بررسی کرد.
اما تعیین آستانهای مانند ۰٫۱ فقط زمانی موجه است که بهصورت کاربردی یا تجربی اعتبارسنجی شده باشد.برای مثال، در یک سامانه مولد، کیفیت خروجی و تنوع نمونهها باید جداگانه ارزیابی شوند.
۳.۱۴.هموارسازی برچسبها (Label-Smoothed Cross-Entropy)
در طبقهبندی چندکلاسه، معمولاً از برچسبهای One-Hot استفاده میکنیم.برای مثال، اگر کلاس واقعی یک تصویر، کلاس دوم از میان سه کلاس باشد، برچسب آن چنین است:
y=0,1,0
این نمایش به شبکه میگوید که احتمال کلاس واقعی یک و احتمال همه کلاسهای دیگر صفر است.
اما در برخی مسائل، وادارکردن شبکه به یادگیری هدفهای کاملاً قطعی میتواند به بیشاطمینانی خروجیها کمک کند؛ بهویژه زمانی که دادهها دارای ابهام یا برچسبهای نهچندان دقیق باشند.
Label Smoothing با اختصاص مقدار احتمال کوچکی به کلاسهای غیرواقعی، برچسب هدف را از حالت کاملاً قطعی خارج میکند.
۳.۱۴.۱.فرمول ریاضی
یکی از قراردادهای رایج برای هموارسازی برچسب عبارت است از:
در این رابطه:
| نماد | مفهوم |
|---|---|
| yₖ | برچسب One-Hot کلاس k |
| ỹₖ | برچسب هموارشده |
| ε | شدت هموارسازی، بین صفر و یک |
| K | تعداد کلاسها |
| pₖ | احتمال پیشبینیشده کلاس k |
تابع زیان:
نکته مهم آن است که قرارداد دیگری نیز وجود دارد که سهم هموارسازی را فقط بین کلاسهای غیرواقعی توزیع میکند.بنابراین هنگام مقایسه مقالات و کتابخانههای نرمافزاری، باید تعریف دقیق (varepsilon) بررسی شود.
۳.۱۴.۲.مثال عددی:طبقهبندی سه نوع محصول
فرض کنید کلاس واقعی، کلاس دوم باشد:
و شدت هموارسازی:
برچسب هموارشده برابر است با:
حال فرض کنید شبکه پیشبینی کرده است:
زیان Cross-Entropy معمولی:
اما با برچسب هموارشده:
افزایش زیان در این مثال به معنای بدترشدن مدل نیست؛ زیرا توزیع هدف تغییر کرده است.
۳.۱۴.۳.نمودار تغییر توزیع هدف
شکل ۲۹ ـ تبدیل برچسب قطعی به توزیع هموارشده
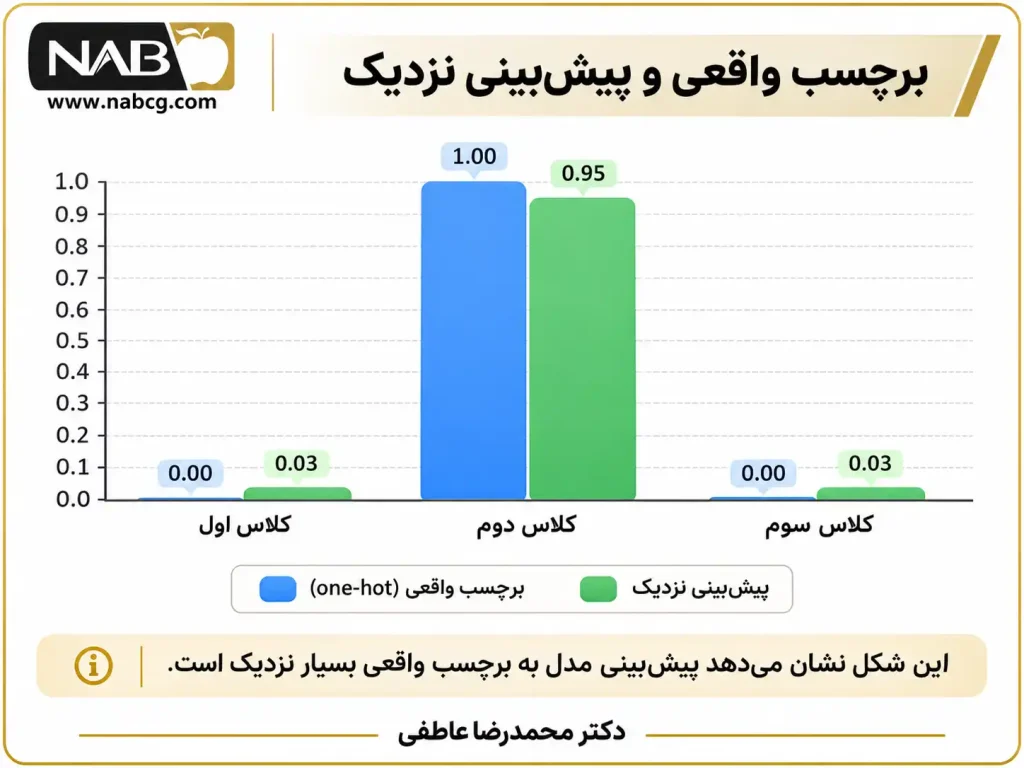
- برچسب اصلی
- برچسب هموارشده
شکل ۲۹ ـ برچسب کلاس واقعی از یک به حدود ۰٫۹۳۳ کاهش پیدا کرده و مقدار کوچکی به هر کلاس دیگر اختصاص یافته است.
۳.۱۴.۴.موارد استفاده و محدودیتها
Label Smoothing در طبقهبندی تصاویر، بعضی مدلهای زبانی و شبکههای چندکلاسهای کاربرد دارد که کاهش بیشاطمینانی یا نوعی تنظیمسازی خروجی در آنها مطلوب است.
با این حال، این روش همیشه کالیبراسیون یا دقت را بهبود نمیدهد.هموارسازی بیشازحد میتواند مانع یادگیری تمایز مناسب میان کلاسها شود.همچنین در مواردی که برچسبهای نرم معتبر از متخصص یا مدل معلم وجود دارند، جایگزینکردن آنها با هموارسازی یکنواخت ممکن است اطلاعات مفید را از بین ببرد.
۳.۱۴.۵.تفسیر و معیار پذیرش
در Label-Smoothed Cross-Entropy، مقدار صفر معمولاً دیگر برای یک هدف هموارشده و دارای احتمال مثبت در همه کلاسها قابل دستیابی نیست.
حداقل نظری آنتروپی متقاطع زمانی به دست میآید که توزیع پیشبینیشده با توزیع هدف برابر باشد؛ مقدار این حداقل، آنتروپی توزیع هدف است:
بنابراین نباید انتظار داشت زیان آموزش الزاماً به صفر نزدیک شود.
برای پذیرش مدل باید Accuracy، Macro-F1، NLL روی برچسبهای اصلی، معیارهای کالیبراسیون و عملکرد نسبت به مدل بدون هموارسازی بررسی شوند.
۳.۱۵.زیان متوازنسازی کلاسها (Class-Balanced Loss)
۳.۱۵.۱.چرا تعداد نمونههای هر کلاس اهمیت دارد؟
فرض کنید یک کارخانه تولید قطعات الکترونیکی، شبکه عصبی خود را برای تشخیص نوع عیب محصولات آموزش میدهد.مجموعه داده شامل ۱۰ هزار تصویر قطعه سالم، ۵۰۰ تصویر دارای خراش و تنها ۵۰ تصویر دارای ترک است.
اگر مدل با تابع زیان معمولی آموزش داده شود، کلاس قطعات سالم سهم بسیار بزرگی از دادههای آموزشی خواهد داشت.در نتیجه ممکن است عملکرد کلی مدل مناسب به نظر برسد، درحالیکه در شناسایی ترکها ضعیف عمل کند.
یکی از راهحلها، اختصاص وزنهای متفاوت به کلاسهاست.اما آیا وزن هر کلاس باید دقیقاً معکوس تعداد نمونههای آن باشد؟
Cui و همکاران (۲۰۱۹) روش Class-Balanced Loss Based on Effective Number of Samples را پیشنهاد کردند.ایده اصلی آن است که افزایش تعداد نمونهها الزاماً به همان نسبت اطلاعات جدید فراهم نمیکند؛ زیرا برخی نمونهها از نظر اطلاعاتی همپوشانی دارند.
۳.۱۵.۲.فرمول ریاضی و پارامترها
ابتدا تعداد مؤثر نمونههای یک کلاس محاسبه میشود:
سپس وزن اولیه کلاس برابر است با:
در نهایت میتوان این وزن را در یک تابع زیان پایه، مانند Cross-Entropy یا Focal Loss، ضرب کرد:
| نماد | تعریف |
|---|---|
| n | تعداد نمونههای کلاس |
| β | پارامتر کنترل تعداد مؤثر، در بازه ۰ ≤ β < ۱ |
| Eₙ | تعداد مؤثر نمونهها |
| wₙ | وزن اولیه کلاس |
| n_y | تعداد نمونههای کلاس واقعی |
| ℓ | زیان پایه، مانند Cross-Entropy |
| L_CB | زیان وزندهیشده نمونه |
هنگامی که (beta=0)، وزن اولیه تمام کلاسهای دارای نمونه برابر یک است.برای مقادیر (beta) نزدیک به یک، تعداد نمونههای هر کلاس تأثیر بیشتری بر وزن آن پیدا میکند.
۳.۱۵.۳.مثال عددی:تشخیص دو نوع قطعه
برای آنکه محاسبات روشن باشند، ابتدا دو کلاس کوچک را در نظر میگیریم:
- کلاس A:دارای ۱۰ نمونه آموزشی
- کلاس B:دارای ۲ نمونه آموزشی
فرض میکنیم:
برای کلاس A:
وزن کلاس A:
برای کلاس B:
بنابراین:
یعنی در این تنظیم، زیان یک نمونه کلاس کمتعداد B حدود ۳٫۴۳ برابر یک نمونه کلاس A با زیان پایه یکسان وزن میگیرد.
اکنون فرض کنید دو نمونه، یکی از هر کلاس، هر دو Cross-Entropy برابر ۰٫۴ داشته باشند.
برای کلاس A:
برای کلاس B:
این مقادیر از وزنهای خام به دست آمدهاند؛ در پیادهسازی عملی میتوان وزنها را نرمال کرد تا مقیاس میانگین زیان کنترل شود.
۳.۱۵.۴.نمودار تأثیر تعداد نمونه بر وزن کلاس
شکل ۳۰ ـ رابطه تعداد نمونه و وزن
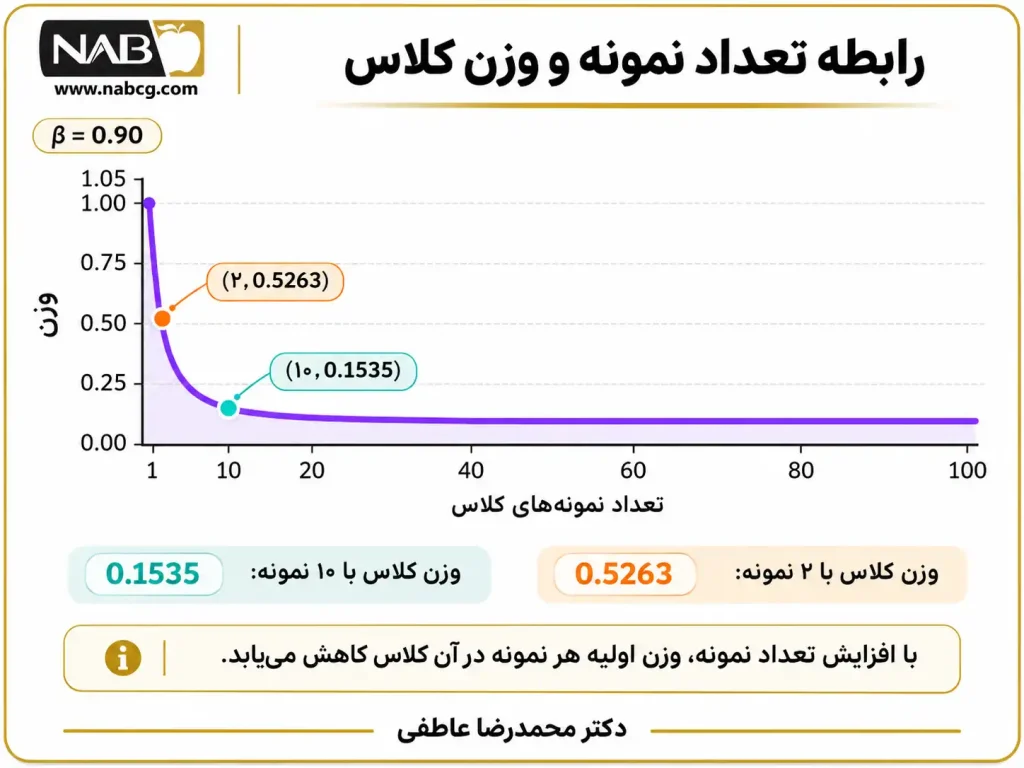
شکل ۳۰ ـ با افزایش تعداد نمونه، وزن اولیه هر نمونه در آن کلاس کاهش مییابد.شکل برای وزن خام، پیش از نرمالسازی، رسم شده است.
۳.۱۵.۵.چه زمانی استفاده کنیم؟
Class-Balanced Loss برای مجموعهدادههای دارای توزیع دنبالهبلند (Long-Tailed Data) و کلاسهای بسیار نامتوازن قابل بررسی است؛ مانند شناسایی عیوب نادر، طبقهبندی گونههای کمیاب و تشخیص کلاسهای کمتعداد در تصاویر.
مزیت آن این است که میتوان متوازنسازی را به تابع زیان اصلی اضافه کرد، بدون آنکه الزاماً ساختار شبکه تغییر کند.
۳.۱۵.۶.محدودیتها
نخست، پارامتر (بتا) باید تنظیم شود.دوم، وزن بیشتر کلاس نادر الزاماً باعث بهبود تعمیمپذیری آن نمیشود؛ بهخصوص اگر نمونههای نادر دارای برچسب اشتباه یا تنوع ناکافی باشند.
سوم، افزایش وزن کلاس نادر ممکن است باعث افزایش هشدارهای مثبت کاذب شود.در نتیجه، بهبود Recall ممکن است با کاهش Precision همراه باشد.
همچنین تعداد مؤثر نمونهها در این روش یک تقریب مبتنی بر مدل است، نه اندازهگیری مستقیم اطلاعات مستقل موجود در هر کلاس.
۳.۱۵.۷.تفسیر و معیار پذیرش
عدد Class-Balanced Loss به وزنهای انتخابشده و تابع زیان پایه وابسته است.بنابراین مقدار خام آن نباید مستقیماً با Cross-Entropy بدون وزن مقایسه شود.
برای پذیرش مدل باید عملکرد کلاسهای نادر و پرتعداد بهصورت جداگانه بررسی شود.معیارهایی مانند Macro-F1، Balanced Accuracy، Recall کلاس نادر و Precision در سطح هشدار عملیاتی اهمیت دارند.
اگر هدف کارخانه تشخیص حداقل ۹۵ درصد ترکها باشد، مدل باید این شرط را روی داده آزمون رعایت کند؛ صرف کاهش زیان وزندار کافی نیست.