۵6. اطلس مرجع بهینهسازها
۵6.۱. هدف و جایگاه اطلس
تا این مرحله، مفاهیم و الگوریتمهای اصلی بهینهسازی شبکههای عصبی را از مشتق و گرادیان تا روشهای تطبیقی، شبهنیوتنی و الگوریتمهای ماتریسی پیشرفته مطالعه کردیم.
بااینحال، هنگام اجرای یک پروژه واقعی، دانشجو یا پژوهشگر معمولاً به یک مرجع سریع نیاز دارد تا بتواند پاسخ پرسشهای زیر را بدون مرور دوباره تمام فصل پیدا کند:
- هر بهینهساز دقیقاً از چه اطلاعاتی استفاده میکند؟
- چه پارامترهایی باید تنظیم شوند؟
- هزینه محاسبات و حافظه اضافی چقدر است؟
- کدام مسئله را بهتر هدف قرار میدهد و چه محدودیتهایی دارد؟
- فرمول آموزشی آن چه تفاوتی با پیادهسازی کتابخانهای دارد؟
این اطلس، مرجع فشرده تصمیمگیری و محاسبات است. بنابراین برخلاف بخشهای آموزشی پیشین، استنتاجهای طولانی تکرار نمیشوند؛ اما هر فرمول با تعریف نمادها و نکات اجرایی همراه است.
۵6.۲. قرارداد ریاضی مشترک
برای جلوگیری از ابهام، در سراسر اطلس از قرارداد زیر استفاده میکنیم:
در این رابطه، Lₜ زیان دسته آموزشی مرحله t، θₜ₋₁ پارامترهای پیش از بهروزرسانی و gₜ گرادیان محاسبهشده است.
همچنین:
| نماد | معنا |
|---|---|
| P | تعداد کل پارامترهای قابل یادگیری |
| t | شماره گام بهروزرسانی، از ۱ |
| ηₜ | نرخ یادگیری مثبت در مرحله t |
| gₜ | بردار گرادیان زیان فعلی |
| θₜ | بردار پارامترها پس از بهروزرسانی |
| β، β₁، β₂، ρ | ضرایب حافظه؛ معنای دقیق آنها در هر روش مشخص میشود |
| ε | ثابت مثبت کوچک برای پایداری عددی |
| λ | ضریب کاهش وزن یا منظمسازی، متناسب با تعریف الگوریتم |
| I | ماتریس همانی |
| ⊙ | ضرب مؤلفهبهمؤلفه |
| ‖·‖₂ | نرم اقلیدسی |
| T | عملگر ترانهاده |
قاعده مهم: اشتراک نماد به معنای یکسان بودن الگوریتم نیست. برای مثال، نقش β در Momentum با نقش β₂ در Adam متفاوت است.
57. شناسنامه ریاضی الگوریتمهای اصلی
57.۱. Gradient Descent و SGD
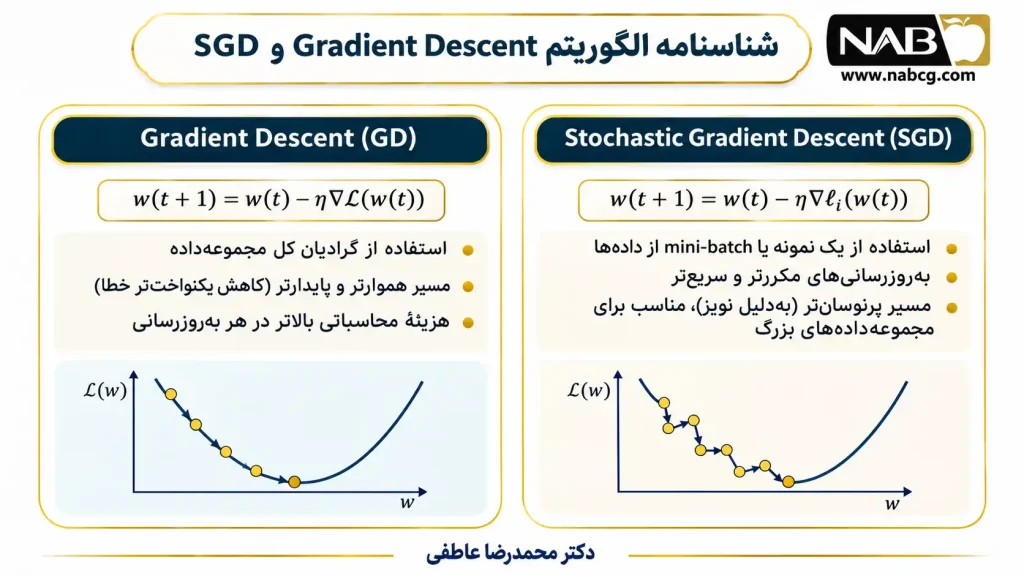
در فرمول بالا، gₜ گرادیان زیان در پارامترهای فعلی و ηₜ اندازه گام پایه است. SGD میتواند از برنامه زمانبندی نرخ یادگیری نیز استفاده کند.
شبهکد آموزشی:
Initialize model parameters θ
For each update t:
    Select training batch B
    Compute loss on B
    Compute gradient g
    θ ← θ - η*g
57.۲. Momentum و Nesterov
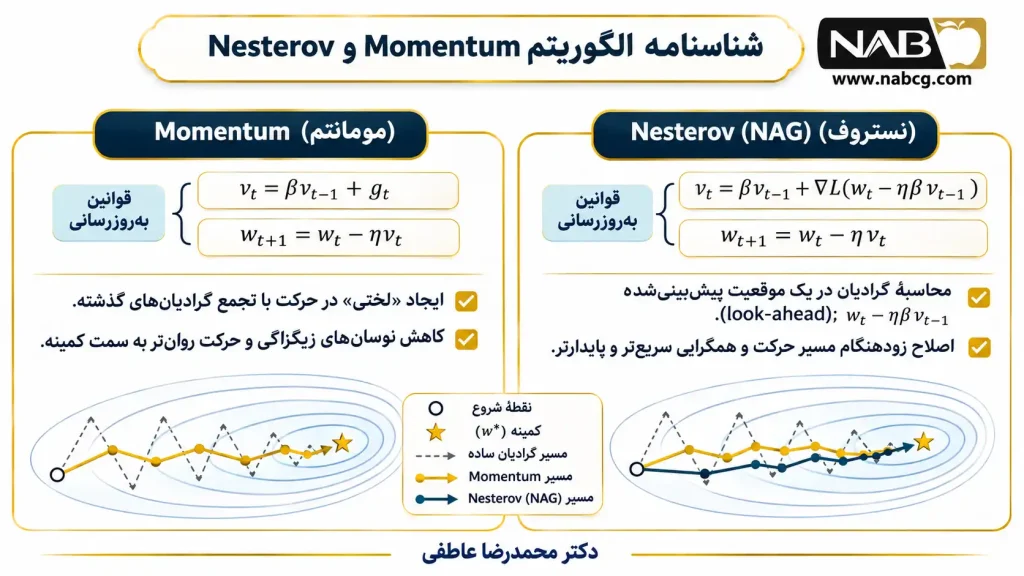
برای Nesterov، نسخه پیشنگر با نرخ یادگیری ثابت:
در این روابط، θ̃ₜ نقطه پیشنگر و ∇Lₜ(θ̃ₜ) گرادیان محاسبهشده در آن نقطه است.
این قرارداد را نباید بدون بررسی معادل تمام گونههای nesterov=True در کتابخانههای مختلف تلقی کرد.
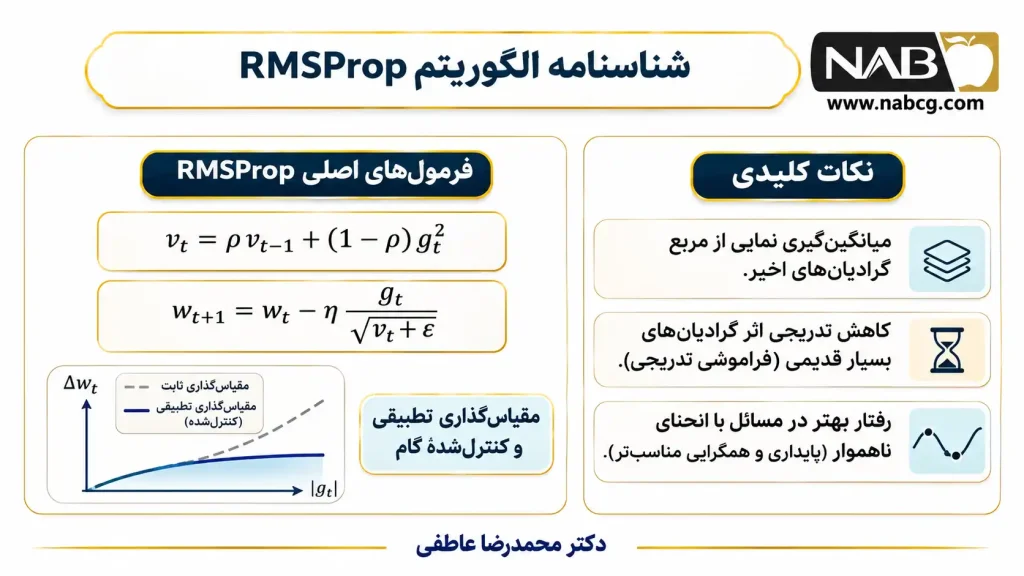
57.3.. AdaGrad، RMSProp و AdaDelta
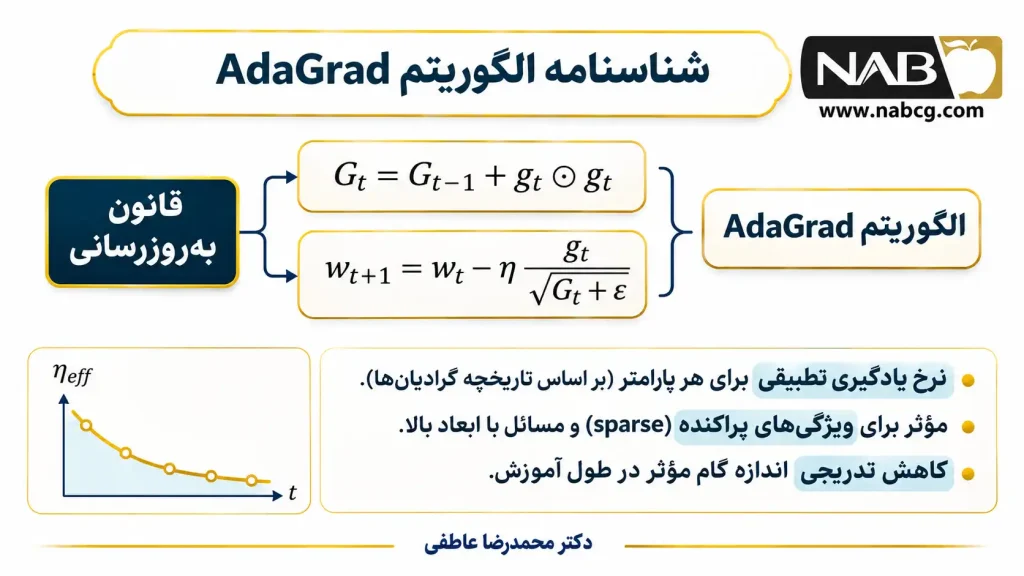
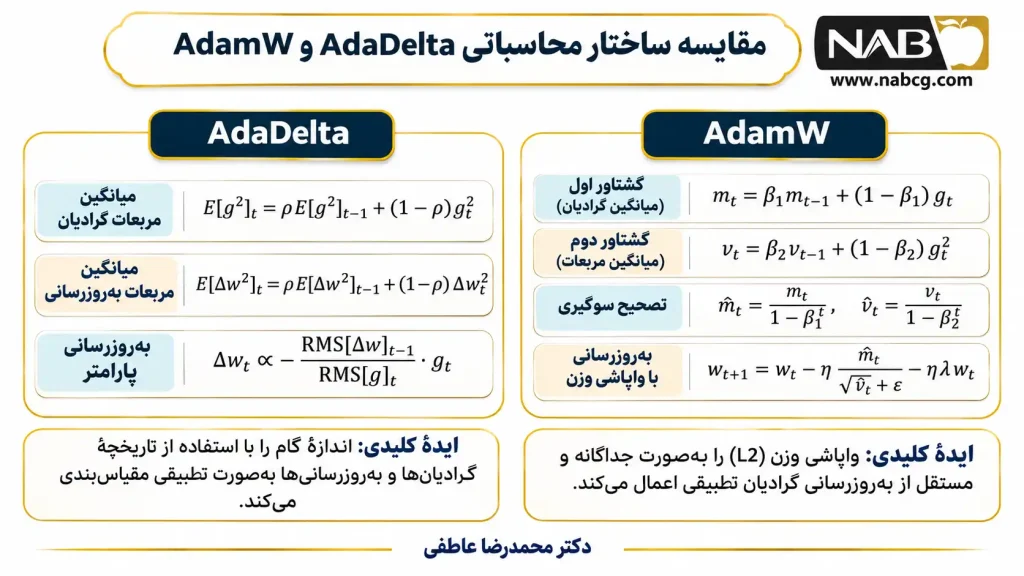
برای AdaDelta، دو میانگین متحرک تعریف میکنیم:
در این روابط، E[g²]ₜ آمار مربعات گرادیان و E[Δθ²]ₜ آمار مربعات تغییر پارامترهاست. هر دو از صفر مقداردهی اولیه میشوند و ρ ضریب حافظه آنهاست.
ویژگی ممتاز AdaDelta استفاده همزمان از اطلاعات تغییر گرادیان و تغییر پارامتر است. هزینه آن، نگهداری دو بردار وضعیت بهاندازه (P) است.
57.۴. Adam و AdamW
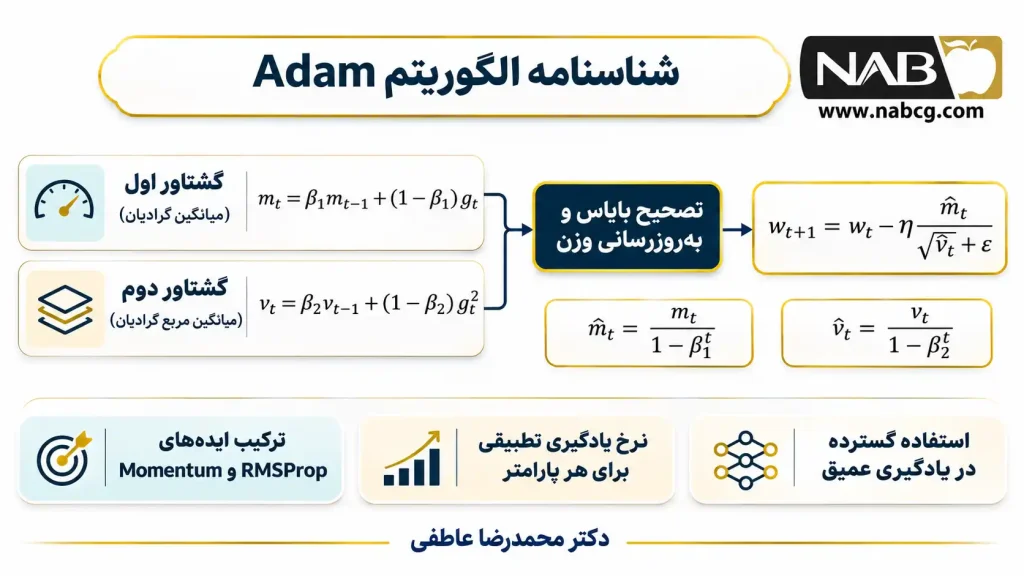
AdamW از همان ممانها استفاده میکند، اما کاهش وزن را مستقل از آنها اعمال میکند:
در این رابطه، λ ضریب کاهش وزن تفکیکشده است. بنابراین گرادیانی که برای ممانها استفاده میشود، گرادیان زیان اصلی است و جمله λθ به آن اضافه نمیشود.
این تفاوت در مستندات رسمی PyTorch نیز صریحاً بیان شده است.
57.۵. شبهکد مرجع AdamW
# AdamW:one conceptual optimization step
# g is already computed by backpropagation.

m = beta1 * m + (1 - beta1) * g
v = beta2 * v + (1 - beta2) * (g * g)

m_hat = m / (1 - beta1 ** t)
v_hat = v / (1 - beta2 ** t)

theta = (
    (1 - lr * weight_decay) * theta
    - lr * m_hat / (sqrt(v_hat) + eps)
)
این شبهکد، تعریف محاسباتی الگوریتم است و بدون مقداردهی اولیه متغیرها و تعریف عملیات آرایهای، یک برنامه مستقل محسوب نمیشود.
برای بهینهسازی واقعی شبکه، گرادیان باید با Backpropagation محاسبه شود و وضعیت (m) و (v) در طول مراحل حفظ گردد.
58. اطلس محاسباتی:حافظه، پیچیدگی و مقیاسپذیری
58.۱. چرا هزینه هر گام با زمان واقعی آموزش یکسان نیست؟
در یک شبکه عصبی، هزینه کل آموزش از چند جزء تشکیل میشود:
در این رابطه، T_forward زمان محاسبه خروجی، T_backward زمان محاسبه گرادیان، T_optimizer زمان اجرای قانون بهروزرسانی و T_overhead سربار انتقال داده، همگامسازی و دیگر عملیات است.
پس اگر یک الگوریتم در مرحله بهروزرسانی به عملیات بیشتری نیاز داشته باشد، لزوماً زمان کل آموزش آن به همان نسبت بیشتر نخواهد بود.
برای مثال، در یک مدل بزرگ ممکن است محاسبات Forward و Backward بخش عمده زمان را مصرف کنند. از طرف دیگر، برخی روشها مانند L-BFGS ممکن است در یک تکرار، چندین بار تابع زیان و گرادیان را ارزیابی کنند.
جدول 58-۱. اطلس هزینه محاسباتی
| الگوریتم | حافظه وضعیت اضافی | هزینه تقریبی بهروزرسانی | نکته اجرایی |
| SGD | ناچیز | (O(P)) | یک گرادیان برای هر گام |
| Momentum | (O(P)) | (O(P)) | یک بردار حافظه |
| Nesterov | (O(P)) | (O(P)) بهجز محاسبه گرادیان | وابسته به صورتبندی |
| AdaGrad | (O(P)) | (O(P)) | یک انباشتگر مربعات |
| RMSProp | (O(P)) | (O(P)) | یک میانگین متحرک |
| AdaDelta | (O(P)) | (O(P)) | دو میانگین متحرک |
| Adam | (O(P)) | (O(P)) | دو بردار ممان |
| AdamW | (O(P)) | (O(P)) | ممانها و کاهش وزن تفکیکشده |
| AMSGrad | (O(P)) | (O(P)) | آمار بیشینه اضافی |
| Nadam | (O(P)) | (O(P)) | اصلاح جهت مومنتوم |
| BFGS | (O(P^2)) | (O(P^2)) برای بهروزرسانی ماتریسی | جستوجوی خطی نیز هزینه دارد |
| L-BFGS | (O(mP)) | (O(mP)) برای بازگشت دوحلقهای | (m) تعداد جفتهای ذخیرهشده |
| Newton متراکم | (O(P^2)) | حل دستگاه متراکم معمولاً تا (O(P^3)) | روشهای ساختاریافته متفاوتاند |
| LM متراکم | (O(NP+P^2)) یا بیشتر | وابسته به ژاکوبین و حل دستگاه | مناسبتر برای مسائل کوچکتر |
مرتبههای محاسباتی این جدول عمدتاً مربوط به عملیات و وضعیت بهینهساز هستند؛ هزینه Forward، Backward و بعضی بافرهای موقت جداگانهاند. (P) تعداد پارامترها، (m) تاریخچه L-BFGS و (N) تعداد باقیماندهها در LM است.
58.۲. تخمین عددی حافظه وضعیت بهینهساز
فرض کنید مدلی دارای (P=100{,}000{,}000) پارامتر باشد. اگر تمام وضعیتهای بهینهساز را در دقت ۳۲بیتی ذخیره کنیم، هر بردار کامل بهاندازه پارامترها تقریباً ۴۰۰ مگابایت حافظه دهدهی نیاز دارد.
59. اطلس روشهای پیشرفته؛ چه چیزی ذخیره میشود؟
در بخشهای قبلی آموختیم که بهینهسازهای جدیدتر لزوماً تنها نسخه سریعتر Adam نیستند. بعضی روشها نحوه نمایش گرادیان و وضعیت بهینهساز را تغییر میدهند.
59.۱. خانواده مقیاسبندی لایهای
در LARS، مقیاس گام با استفاده از نسبت نرم وزنهای یک لایه به نرم گرادیان آن محاسبه میشود. در LAMB، همین ایده با جهت تطبیقی مبتنی بر ممانهای Adam ترکیب میشود.
هر دو به جای اتکا به یک نسبت جهانی، به رفتار لایهها توجه میکنند.
59.۲. خانواده کمحافظه
Adafactor برای ماتریسهای بزرگ، آمار ممان دوم را بهصورت فاکتورگیریشده نگهداری میکند.
برای یک ماتریس n×m، بهجای ذخیره nm مقدار، میتوان آمارهای سطری و ستونی با مجموع n+m مقدار نگهداری کرد.
در پیادهسازیهای واقعی، امکان فاکتورگیری، شکل تانسور، قواعد مقیاسبندی و سایر وضعیتها تعیین میکنند که صرفهجویی نهایی چقدر است. مستندات Optax نیز فاکتورگیری ممان دوم را ویژگی اساسی Adafactor معرفی میکنند.
59.۳. خانواده مبتنی بر علامت حرکت
Lion تنها یک بردار مومنتوم را نگه میدارد و از علامت ترکیبی از گرادیان فعلی و گذشته برای بهروزرسانی استفاده میکند.
به همین دلیل، کاهش حافظه وضعیت یکی از مزایای مهم آن در مقایسه با AdamW است. بااینحال، چون مقدار مؤلفه بهروزرسانی از تابع علامت حاصل میشود، انتخاب نرخ یادگیری آن باید با دقت انجام شود.
59.۴. خانواده هندسه ماتریسی
در Shampoo، بهروزرسانی با پیششرطسازهایی مرتبط با ساختار تانسور انجام میشود.
در Muon، بهجای استفاده مستقیم از ماتریس مومنتوم، یک نسخه تقریباً متعامدشده برای بهروزرسانی وزنهای ماتریسی استفاده میشود.
نکته مهم این است که نسخههای کاربردی Muon معمولاً برای همه پارامترهای مدل از یک قاعده واحد استفاده نمیکنند. برای مثال، در پیادهسازی Optax، پارامترهای غیرماتریسی به روش AdamW سپرده میشوند.
60. مرجع انتخاب بهینهساز بر اساس شرایط مسئله
این بخش برای استفاده سریع دانشجویان، پژوهشگران و تیمهای توسعه هوش مصنوعی تنظیم شده است.
۶0.۱. جدول تصمیمگیری
| شرایط مسئله | گزینههای اولیه | ملاحظه اصلی |
| یادگیری مفاهیم بهینهسازی | GD، SGD | شفافیت ریاضی |
| آموزش CNN | Momentum SGD، AdamW | تنظیم نرخ یادگیری و تعمیم |
| آموزش MLP عمومی | AdamW، Momentum SGD | مقایسه عملکرد اعتبارسنجی |
| ویژگیهای بسیار تنک | AdaGrad، SparseAdam | پشتیبانی از گرادیان تنک |
| مدل Transformer | AdamW | کاهش وزن و Scheduler |
| Transformer با محدودیت حافظه | Adafactor و روشهای کمحافظه | صرفهجویی در وضعیت |
| Batch بسیار بزرگ و آموزش توزیعشده | LAMB، LARS | مقیاسبندی لایهای |
| بهینهسازی هموار با پارامترهای کم | BFGS، LM | هزینه محاسبات خمیدگی |
| PINN با مجموعه نقاط نسبتاً ثابت | AdamW، L-BFGS | کیفیت جستوجوی خطی |
| پژوهش درباره بهینهسازی ماتریسی | Shampoo، Muon | هزینه عملیات و ساختار پارامترها |
این جدول یک راهنمای انتخاب اولیه است و حکم رتبهبندی تجربی قطعی ندارد.
60.۲. ملاحظات مربوط به پیادهسازی واقعی
بر اساس مستندات کنونی PyTorch، علاوه بر بهینهسازهای کلاسیک، گزینههایی مانند Adafactor، Muon، NAdam و L-BFGS نیز در این کتابخانه ارائه میشوند. همچنین برخی بهینهسازها دارای پیادهسازیهای متفاوت از نظر پردازش دستهای و عملیات تلفیقشده (Fused) هستند؛ بنابراین حتی نام یکسان الگوریتم نیز الزاماً هزینه اجرایی یکسانی ایجاد نمیکند.
برای مقایسه علمی، لازم است نسخه کتابخانه، نوع پیادهسازی، سختافزار، دقت عددی، تنظیمات پیشفرض و مقدار ابرپارامترها ثبت شوند.
61. تمرین مرجع:بررسی دستی و برنامهنویسی
برای ارزیابی تسلط دانشجو بر اطلس، یک مسئله مشترک تعریف میکنیم.
تابع زیان:
وزن اولیه:
گرادیان اولیه:
با نرخ یادگیری ۰٫۱، سه روش را مقایسه کنید.
SGD
Momentum
با حافظه اولیه صفر و β = ۰٫۹:
Adam
نتیجه مقایسه
| روش | وزن پس از گام اول | زیان جدید |
| SGD | ۱٫۳ | ۳٫۶۴۵ |
| Momentum | ۱٫۳ | ۳٫۶۴۵ |
| Adam | ۱٫۱ | ۴٫۲۰۵ |
در نخستین گام، Momentum با حافظه اولیه صفر همان نتیجه SGD را تولید میکند، اما Adam به دلیل مقیاسبندی تطبیقی، اندازه تغییر متفاوتی دارد.
دانشجو باید سه گام بعدی را نیز اجرا کند و بررسی کند آیا رتبهبندی الگوریتمها ثابت میماند یا تغییر میکند.
این مثال بار دیگر تأکید میکند که مقایسه بر اساس نرخ یادگیری عددی یکسان، لزوماً مقایسهای با اندازه گام یکسان نیست.
مطالعه موردی اول — پیشبینی تقاضای محصول در کارخانه صنایع غذایی
۱. تعریف مسئله صنعتی
یک کارخانه تولید مواد غذایی میخواهد مقدار تقاضای محصول را براساس تعداد فعالیتهای تبلیغاتی پیشبینی کند.
در مدل واقعی، عوامل بسیاری مانند قیمت، فصل، رقبا و موجودی نیز مهماند. اما برای آنکه تمام محاسبات قابل انجام دستی باشند، ابتدا یک مدل بسیار کوچک با یک ویژگی میسازیم.
دو مشاهده تاریخی داریم:
| هفته | شاخص فعالیت تبلیغاتی (x) | تقاضای واقعی (y) |
| ۱ | ۱ | ۳ |
| ۲ | ۲ | ۵ |
فرض میکنیم واحد تقاضا هزار بسته است و شاخص تبلیغات بدون واحد است.
هدف پیدا کردن رابطهای بین تبلیغات و تقاضاست.
۲. انتخاب مدل
مدل ساده خطی:
که در آن:
- (w): وزن اثر تبلیغات بر تقاضا
- (b): مقدار پایه مدل
- (x): شاخص تبلیغات
- ŷ: تقاضای پیشبینیشده
این مدل، سادهترین نمونه از یک نورون خطی است و پایه مفهومی بهینهسازی شبکههای چندلایه را نشان میدهد.
۳. انتخاب تابع زیان
تابع زیان را به شکل زیر انتخاب میکنیم:
چرا ضریب (1/2) وجود دارد؟
زیرا هنگام مشتقگیری، عدد ۲ ناشی از توان دوم با این ضریب ساده میشود.
در این مثال:
پس:
۴. مقداردهی اولیه
فرض میکنیم:
نرخ یادگیری:
پیشبینیهای اولیه:
خطاها:
زیان اولیه:
۵. محاسبه گرادیانها
از رابطه:
مشتق نسبت به وزن:
مشتق نسبت به بایاس:
در نقطه اولیه:
۶. نخستین گام Gradient Descent
قانون بهروزرسانی:
وزن جدید:
بایاس جدید:
مدل جدید:
۷. ارزیابی مدل پس از گام اول
برای هفته اول:
خطا:
برای هفته دوم:
خطا:
زیان:
زیان از ۸٫۵ به ۳٫۶۷۳۱۲۵ کاهش یافته است.
۸. دومین گام Gradient Descent
گرادیانهای جدید:
وزن جدید:
بایاس جدید:
مدل:
۹. محاسبه زیان پس از گام دوم
پیشبینی اول:
پیشبینی دوم:
زیان:
۱۰. پیشبینی برای هفته سوم
اگر شاخص تبلیغات هفته سوم:
باشد، مدل فعلی پیشبینی میکند:
هزار بسته.
آیا میتوان به این پیشبینی اعتماد کرد؟
هنوز خیر. فقط دو مشاهده برای آموزش داریم و مدل نیز تنها دو گام از بهینهسازی را طی کرده است. حتی اگر روند آموزش مطلوب باشد، برای تصمیمگیری تولید باید دادههای بیشتری جمعآوری شود.
بررسی جواب تحلیلی
با توجه به دو مشاهده، رابطه خطیای که هر دو را دقیقاً برازش میکند:
با تفریق دو رابطه:
پس:
این مدل روی دو مشاهده آموزشی خطای صفر دارد و برای (x=3) مقدار ۷ را پیشبینی میکند.
اما برازش کامل دو نقطه، تضمین پیشبینی صحیح در هفته سوم نیست.
جدول جمعبندی
| مرحله | وزن | بایاس | زیان آموزش |
| ابتدا | ۰ | ۰ | ۸٫۵ |
| گام اول | ۰٫۶۵ | ۰٫۴ | ۳٫۶۷۳۱۲۵ |
| گام دوم | ۱٫۰۷۷۵ | ۰٫۶۶۲۵ | ۱٫۵۸۷۷۲۷ |
| جواب برازش دقیق آموزشی | ۲ | ۱ | ۰ |
۱۱. تصمیم مدیریتی
در این مثال میتوان از مدل برای درک رابطه تبلیغات و تقاضا استفاده کرد، اما تصمیم واقعی تولید به اعتبارسنجی زمانی، موجودی فعلی، عدم قطعیت پیشبینی و هزینه کمبود یا مازاد محصول وابسته است.
معیار پذیرش پیشنهادی
میتوان از قبل تعیین کرد مدل فقط زمانی پذیرفته شود که روی هفتههای آینده، MAE کمتر از آستانه عملیاتی مشخص داشته باشد و از روش ساده پیشبینی تقاضای هفته قبل عملکرد بهتری ارائه کند.
نتیجه مطالعه اول: فهمیدیم چگونه از یک مسئله کسبوکار به تابع زیان برسیم، مشتقها را محاسبه کنیم، وزنها را با Gradient Descent اصلاح کنیم و تفاوت کاهش زیان آموزشی با اعتبار پیشبینی آینده را تشخیص دهیم.
مطالعه موردی دوم — پیشبینی احتمال نکول تسهیلات بانکی
۱. تعریف مسئله
یک بانک قصد دارد احتمال نکول تسهیلات را براساس ویژگیهای مالی متقاضیان برآورد کند.
در سیستم واقعی ممکن است دهها یا صدها متغیر استفاده شود، اما برای آموزش محاسبات Adam، فقط یک ویژگی در نظر میگیریم.
فرض کنید (x) یک شاخص استانداردشده ریسک مالی است؛ مقدار بزرگتر آن نشاندهنده وضعیت پرریسکتر است.
برچسب:
داده آموزشی:
| مشتری | شاخص ریسک (x) | وضعیت واقعی (y) |
| A | ۱ | ۰ |
| B | ۲ | ۱ |
این دو مشاهده برای اثبات کیفیت مدل اعتباری کافی نیستند؛ فقط به ما امکان میدهند تمام محاسبات Adam را دستی انجام دهیم.
۲. ساخت مدل
یک نورون با تابع فعالسازی سیگموید تعریف میکنیم:
برای ساده بودن، بایاس را در این مثال صفر و ثابت میگیریم.
پارامتر قابل یادگیری فقط (w) است.
۳. انتخاب تابع زیان
چون مسئله طبقهبندی دودویی است، از Binary Cross-Entropy استفاده میکنیم:
با این تابع و سیگموید، مشتق نسبت به وزن چنین میشود:
این رابطه از قاعده زنجیرهای به دست میآید.
۴. مقداردهی اولیه Adam
فرض میکنیم:
در این مثال ممان اول (m_t) میانگین متحرک گرادیانها و ممان دوم خام (v_t) میانگین متحرک مربعات گرادیانهاست.
۵. گام نخست Adam
برای مشتری A:
برای مشتری B:
محاسبه زیان اولیه
برای مشتری A که (y_A=0) است:
برای مشتری B که (y_B=1) است:
میانگین:
محاسبه گرادیان
ممان اول
ممان دوم
اصلاح بایاس
بهروزرسانی
۶. ارزیابی پس از گام اول
برای مشتری A:
برای مشتری B:
زیان:
در مقایسه با مقدار اولیه:
زیان تقریباً ۰٫۰۲۱۸۸ واحد کاهش یافته است.
۷. گام دوم Adam
اکنون وزن:
است.
گرادیان جدید:
ممان اول جدید
ممان دوم جدید
اصلاح بایاس
وزن جدید
پس از دو گام، وزن از صفر به حدود ۰٫۱۹۸۳ افزایش یافته است.
۸. ارزیابی دوم
برای مشتری A:
برای مشتری B:
زیان:
شکل . کاهش زیان مدل نکول با Adam
دو گام Adam روی دو مشاهده آموزشی
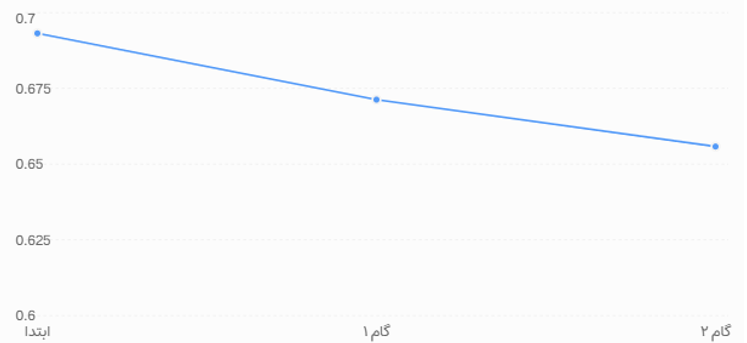
جدول کامل محاسبات
| گام | گرادیان | ممان اول خام | ممان دوم خام | وزن | زیان |
| ۰ | −۰٫۲۵۰۰۰۰ | ۰ | ۰ | ۰ | ۰٫۶۹۳۱۴۷ |
| ۱ | −۰٫۲۵۰۰۰۰ | −۰٫۰۲۵۰۰۰ | ۰٫۰۰۰۰۶۲۵ | ۰٫۱۰۰۰۰۰ | ۰٫۶۷۱۲۶۸ |
| ۲ | −۰٫۱۸۷۶۷۶ | −۰٫۰۴۱۲۶۸ | ۰٫۰۰۰۰۹۷۶۶ | ۰٫۱۹۸۲۶۶ | ۰٫۶۵۵۷۹۷ |
گرادیان سطر صفر صرفاً گرادیان محاسبهشده در نقطه اولیه است؛ در سطر اول از آن برای بهروزرسانی استفاده شده است.
۹. تصمیم اعتباری و هزینه نکول
در کاربرد واقعی، خروجی مدل باید پس از آموزش و کالیبراسیون روی داده مستقل ارزیابی شود.
فرض کنیم برای یک متقاضی جدید و از یک مدل اعتبارسنجیشده، احتمال نکول چنین برآورد شده باشد:
این عدد بخشی از خروجی دوگام آموزشی بالا نیست؛ سناریویی مستقل برای آموزش تصمیمگیری است.
اگر بانک وام را بپذیرد، زیان در صورت نکول را ۵۰ میلیون تومان و زیان در حالت عدم نکول را صفر فرض میکنیم.
امید زیان:
اگر سود خالص قراردادی در صورت عدم نکول ۸ میلیون تومان باشد و در صورت نکول، زیان خالص ۵۰ میلیون تومان رخ دهد، امید بازده:
این محاسبه ساده، هزینه سرمایه، بازیافت مطالبات، محدودیتهای اعتباری و سایر ریسکها را در بر نمیگیرد.
نتیجه مدیریتی
در اعتبارسنجی بانکی، انتخاب بهینهساز با تصمیم اعطای وام یکی نیست.
بهینهساز وزنهای مدل را آموزش میدهد. مدل، احتمال نکول را تخمین میزند. سپس تصمیم اعتباری با توجه به احتمال معتبر، هزینهها، سیاستهای ریسک و الزامات قانونی اتخاذ میشود.
نتیجه مطالعه دوم: تمام مراحل Adam، از گرادیان اولیه تا اصلاح بایاس و ارزیابی مجدد زیان، محاسبه شد و تفاوت بهینهسازی مدل با تصمیم اقتصادی روشن گردید.
مطالعه موردی سوم — کالیبراسیون حسگر در صنعت انرژی
۱. تعریف مسئله
در یک نیروگاه یا سامانه صنعتی انرژی، یک حسگر باید ورودی فیزیکی را به مقدار اندازهگیریشده تبدیل کند.
فرض کنیم پاسخ حسگر با مدل خطی زیر توصیف شود:
که (a) ضریب حساسیت حسگر، (b) مقدار آفست، (x) ورودی فیزیکی و (ŷ) خروجی پیشبینیشده است.
دو اندازهگیری مرجع در اختیار داریم:
| مشاهده | ورودی (x) | خروجی مرجع (y) |
| ۱ | ۱ | ۲ |
| ۲ | ۲ | ۳ |
هدف محاسبه (a) و (b) است.
از روش Levenberg–Marquardt (LM) استفاده میکنیم تا نقش ژاکوبین و میرایی در بهینهسازی روشن شود.
۲. تعریف باقیماندهها
باقیمانده مشاهده اول:
باقیمانده مشاهده دوم:
بردار باقیمانده:
تابع زیان:
۳. مقداردهی اولیه
فرض میکنیم:
و پارامتر میرایی:
باشد.
در نقطه اولیه:
زیان اولیه:
۴. محاسبه ژاکوبین
ژاکوبین از مشتق باقیماندهها نسبت به پارامترها تشکیل میشود:
چون:
پس:
۵. تشکیل دستگاه LM
رابطه:
ابتدا:
با λ = ۱:
اکنون:
بنابراین دستگاه:
۶. حل کامل دستگاه
معادله اول:
معادله دوم:
با تفریق:
جایگذاری در رابطه دوم:
پس:
مدل جدید:
۷. محاسبه زیان پس از گام اول
برای مشاهده اول:
باقیمانده:
برای مشاهده دوم:
باقیمانده:
زیان:
زیان از ۶٫۵ به حدود ۰٫۱۱۱۱ کاهش یافته است.
۸. دومین گام LM
باقیمانده فعلی:
چون مدل نسبت به پارامترها خطی است، ژاکوبین همچنان ثابت است.
حاصلضرب:
دستگاه گام دوم:
معادلات:
تفریق:
جایگذاری:
پارامترهای جدید:
بنابراین:
۹. ارزیابی گام دوم
برای مشاهده اول:
باقیمانده:
برای مشاهده دوم:
پس:
زیان:
شکل پ-۳. کاهش زیان کالیبراسیون حسگر با LM
دو گام LM با ضریب میرایی ثابت λ=۱
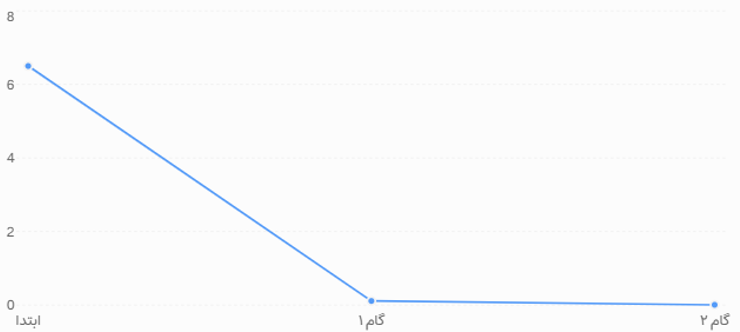
جدول نهایی
| مرحله | (a) | (b) | زیان |
| شروع | ۰ | ۰ | ۶٫۵ |
| گام اول | ۱ | ۰٫۶۶۶۶۶۷ | ۰٫۱۱۱۱۱۱ |
| گام دوم | ۱٫۱۱۱۱۱۱ | ۰٫۷۷۷۷۷۸ | ۰٫۰۰۶۱۷۳ |
| برازش دقیق دو مشاهده | ۱ | ۱ | ۰ |
نکته: در این مثال، LM با میرایی ثابت الزاماً در یک گام به برازش دقیق نمیرسد؛ هرچند مسئله خطی است.
۱۰. تفسیر صنعتی
در این مثال میتوانیم ببینیم چگونه با استفاده از ژاکوبین و یک دستگاه خطی، ضرایب حسگر اصلاح شدند.
اما مدل با دو مشاهده مرجع اعتبار صنعتی ندارد.
برای کالیبراسیون واقعی، باید حداقل موضوعات زیر بررسی شوند: تعداد کافی از نقاط مرجع، دامنه عملیاتی، عدم قطعیت اندازهگیری، پایداری زمانی، دما و شرایط محیطی، و خطای حسگر روی نقاطی که برای محاسبه ضرایب استفاده نشدهاند.
معیار پذیرش پیشنهادی
فرض کنید تلرانس قابل قبول برای خروجی حسگر:
واحد اندازهگیری باشد.
در گام دوم، خطای مشاهده اول:
است.
بنابراین با وجود کاهش بسیار زیاد زیان، مدل هنوز شرط سختگیرانه تلرانس را برای مشاهده اول برآورده نکرده است.
نتیجه مطالعه سوم: کاهش زیان الگوریتمی الزاماً معادل رسیدن به معیار پذیرش مهندسی نیست. در کاربرد واقعی، محدودیت فنی باید بهصراحت تعریف و ارزیابی شود.
مقایسه نهایی سه مطالعه موردی
| ویژگی | تولید | بانکداری | انرژی |
| مدل | نورون خطی | نورون سیگموید | مدل کالیبراسیون دوپارامتری |
| تابع زیان | مربعات خطا | Cross-Entropy | کمترین مربعات |
| روش | Gradient Descent | Adam | LM |
| پارامترهای قابل آموزش | ۲ | ۱ | ۲ |
| گامهای دستی | ۲ | ۲ | ۲ |
| معیار عملیاتی | خطای تقاضای آینده | ریسک و هزینه نکول | تلرانس اندازهگیری |
| محدودیت مهم | داده بسیار کم | اعتبار احتمال و تصمیم اعتباری | پوشش نقاط مرجع |
این سه مطالعه، نمونههایی از انتخاب هدفمند روش بهینهسازی هستند؛ نه ادعای اینکه هر صنعت باید الزاماً از همان روش استفاده کند.
الف. سؤالات مفهومی
۱۰ سؤال مفهومی همراه با پاسخ تشریحی
1.تفاوت گرادیان با مشتق دوم چیست؟
گرادیان نرخ و جهت تغییر موضعی تابع زیان را نشان میدهد؛ مشتق دوم یا هسین تغییرات گرادیان و خمیدگی موضعی را توصیف میکند.
2.چرا SGD با Mini-Batch نوسان دارد؟
زیرا هر Mini-Batch فقط تخمینی از گرادیان کل دادهها را تولید میکند و ترکیب نمونهها میان گامها متفاوت است.
3.Momentum چه اطلاعاتی را از گذشته حفظ میکند؟
ترکیبی از گرادیانهای قبلی را نگهداری میکند تا جهت حرکت فقط به گرادیان فعلی وابسته نباشد.
4.مهمترین تفاوت AdaGrad و RMSProp چیست؟
AdaGrad مجموع تجمعی مربعات گرادیانها را حفظ میکند، اما RMSProp میانگین متحرک نمایی آنها را نگه میدارد و اثر تاریخچه قدیمی بهتدریج کاهش مییابد.
5.چرا Adam از اصلاح بایاس استفاده میکند؟
برای جبران کشیده شدن مقادیر اولیه میانگینهای متحرک به سمت صفر در نتیجه مقداردهی اولیه صفر.
6.چرا Weight Decay و جریمه L2 در Adam عموماً یکسان نیستند؟
چون افزودن جریمه L2 به گرادیان موجب ورود آن به ممانهای تطبیقی میشود، اما AdamW کاهش وزن را جدا از مسیر ممانها اعمال میکند.
7.آیا AMSGrad همیشه بهتر از Adam است؟
خیر. انگیزه آن برطرف کردن برخی مسائل همگرایی و ایجاد حافظه بلندمدت در ممان دوم است؛ برتری تجربی همگانی تضمین نشده است.
8.چه تفاوتی میان BFGS و L-BFGS وجود دارد؟
BFGS تقریب متراکم وارون هسین را نگه میدارد، اما L-BFGS از تعداد محدودی جفت تغییر پارامتر و گرادیان برای محاسبه جهت استفاده میکند.
9.چرا Gradient Clipping مشکل گرادیان ناپدیدشونده را حل نمیکند؟
زیرا Clipping برای محدود کردن گرادیانهای بزرگ طراحی شده است و بهطور معمول گرادیانهای بسیار کوچک را تقویت نمیکند.
10.چرا کمترین زیان آموزش برای انتخاب بهترین بهینهساز کافی نیست؟
چون کیفیت تعمیم، پایداری، حافظه، زمان آموزش، هزینه تنظیم و معیار موفقیت واقعی نیز باید بررسی شوند.
ب. مسائل محاسباتی با پاسخ تشریحی
مسئله ۱ — یک گام Gradient Descent
تابع زیان:
وزن اولیه:
نرخ یادگیری:
مقدار وزن و زیان را بعد از یک گام محاسبه کنید.
حل
گرادیان:
وزن جدید:
زیان:
در ابتدا:
بنابراین زیان کاهش یافته است.
مسئله ۲ — یک Epoch از SGD
دو مشاهده داریم:
مدل:
زیان هر مشاهده:
وزن اولیه صفر و نرخ یادگیری ۰٫۱ است. دو مشاهده بهترتیب پردازش میشوند.
حل
برای مشاهده اول:
برای مشاهده دوم، از وزن جدید استفاده میکنیم:
پس از یک Epoch با دو اصلاح جداگانه، وزن برابر ۰٫۹۲ است.
مسئله ۳ — Momentum
گرادیانها:
ضریب مومنتوم:
نرخ یادگیری:
رابطه:
حل
گام اول:
گام دوم:
مسئله ۴ — AdaGrad
گرادیانهای یک پارامتر:
نرخ یادگیری:
و s₀ = ۰ است. ε را در این مثال صفر بگیرید.
حل
گام اول:
گام دوم:
اگر وزن اولیه صفر باشد:
مسئله ۵ — RMSProp
فرض کنید:
v₀ = ۰، g₁ = ۴، g₂ = ۲
ρ = ۰٫۵، η = ۰٫۱
با ε = ۰ محاسبه کنید.
حل
گام دوم:
از وزن اولیه صفر:
مسئله ۶ — اصلاح بایاس Adam
فرض کنید:
ممانهای اصلاحشده را محاسبه کنید.
حل
مسئله ۷ — AdamW
وزن اولیه:
نرخ یادگیری:
ضریب Weight Decay:
و نسبت ممانهای اصلاحشده:
است.
حل
مسئله ۸ — نیوتن
تابع:
با (w_0=1) یک گام نیوتن انجام دهید.
حل
بنابراین:
و زیان صفر است.
مسئله ۹ — Gradient Clipping
گرادیان:
آستانه Norm Clipping برابر ۶ است.
حل
ضریب:
گرادیان جدید:
یا تقریباً:
مسئله ۱۰ — برنامه نرخ یادگیری
فرض کنید:
و از Step Decay استفاده کنیم.
نرخ یادگیری در (t=10) چقدر است؟
حل
مسئله ۱۱ — آمار حافظه Adafactor
ماتریس وزن:
ممان دوم کامل چند عدد نیاز دارد و آمار فاکتورگیریشده سطری و ستونی چند عدد؟
حل
ممان دوم کامل:
آمار فاکتورگیریشده:
نسبت:
کاهش ۷۵۰ برابری تعداد اعداد آمار ممان دوم
این نتیجه درباره کل حافظه آموزش نیست.
مسئله ۱۲ — تصمیم اقتصادی
دو مدل تشخیص خرابی داریم.
- مدل A دارای ۵ خطای FN و ۱۰ خطای FP است.
- مدل B دارای ۳ خطای FN و ۲۵ خطای FP است.
هزینه هر FN برابر ۴۰ میلیون و هر FP برابر ۲ میلیون تومان است.
حل
مدل B در این سناریو:
میلیون تومان هزینه کمتری دارد.