درآمد فصل: چگونه میتوان تصمیمگیری را به یک محاسبه تبدیل کرد؟
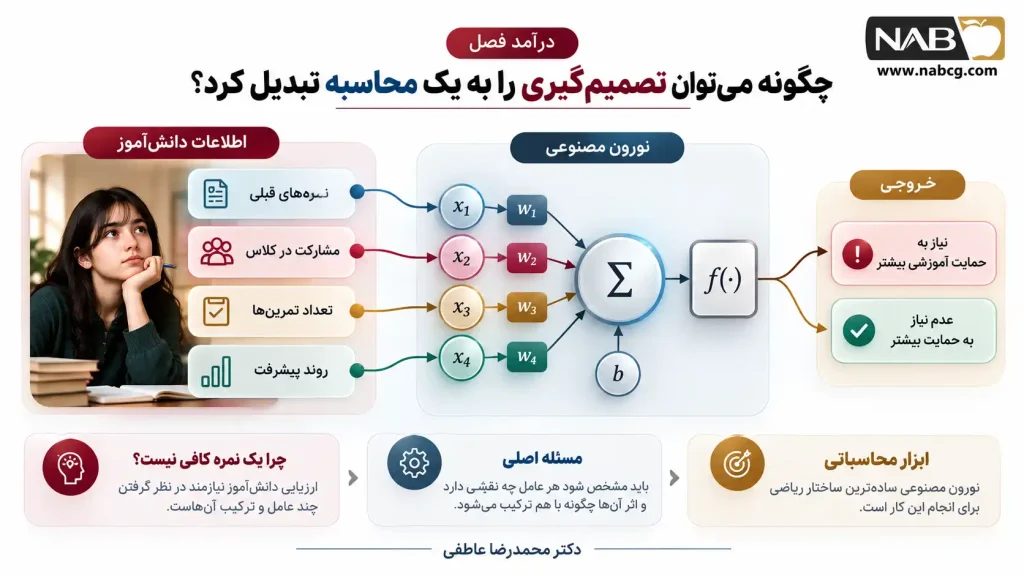
فرض کنید قرار است سامانهای طراحی کنیم که با دریافت اطلاعات یک دانشآموز، احتمال نیاز او به حمایت آموزشی بیشتر را بررسی کند. معلم برای چنین تصمیمی معمولاً به یک عامل اکتفا نمیکند. نمرههای قبلی، میزان مشارکت در کلاس، تعداد تمرینهای انجامشده و روند پیشرفت تحصیلی، هرکدام بخشی از اطلاعات موردنیاز را فراهم میکنند.
برای مثال، دانشآموزی ممکن است نمره نسبتاً پایینی داشته باشد، اما با تلاش مستمر و مشارکت فعال در کلاس، روند رو به رشدی را نشان دهد. دانشآموز دیگری ممکن است در آزمونهای اخیر نمره مناسبی گرفته باشد، اما کاهش مشارکت و انجام ندادن تمرینها از مشکلات احتمالی آینده حکایت کند. بنابراین، ارزیابی این دو دانشآموز صرفاً بر اساس یک نمره، تصویر کاملی از وضعیت آنها ارائه نمیدهد.
در چنین موقعیتی، مسئله اصلی فقط جمعآوری اطلاعات نیست؛ بلکه باید مشخص شود هر عامل چه نقشی در تصمیم نهایی دارد و چگونه میتوان اثر عوامل مختلف را با یکدیگر ترکیب کرد. اگر بخواهیم این فرایند را به یک برنامه رایانهای تبدیل کنیم، به سازوکاری نیاز داریم که چند ورودی را دریافت کند، میزان تأثیر هر ورودی را در نظر بگیرد و بر اساس نتیجه پردازش آنها، یک خروجی تولید کند.
یکی از سادهترین ساختارهای ریاضی برای انجام چنین کاری، نورون مصنوعی (Artificial Neuron) است؛ واحدی محاسباتی که در بسیاری از معماریهای شبکه عصبی نقش سازنده اولیه را ایفا میکند (Goodfellow et al., 2016; Haykin, 2009).
البته این مثال به معنای مناسب بودن یک نورون ساده برای تصمیمگیری واقعی درباره وضعیت تحصیلی دانشآموزان نیست. چنین کاربردی به داده معتبر، ارزیابی دقیق، بررسی سوگیری و نظارت انسانی نیاز دارد. در این فصل، مسئله صرفاً ابزاری آموزشی برای فهم نحوه تبدیل اطلاعات به محاسبات عددی است.
در پایان فصل، خواننده قادر خواهد بود نورونی را با ورودیها و پارامترهای دلخواه طراحی کند، خروجی آن را بهصورت دستی محاسبه کند و سپس همان محاسبه را با پایتون پیادهسازی کند. آنچه هنوز انجام نخواهد داد، آموزش خودکار وزنهای نورون از دادههاست؛ این موضوع در فصل چهارم، هنگام بررسی پرسپترون، توسعه مییابد.
۱. چرا برای ساخت هوش مصنوعی به نورون مصنوعی نیاز داریم؟
۱.۱. از تصمیمگیریهای ساده تا مدلهای محاسباتی
برای درک ضرورت نورون مصنوعی، بهتر است ابتدا مسئله تصمیمگیری را مستقل از شبکههای عصبی بررسی کنیم. بسیاری از تصمیمهای روزمره بر اساس ترکیبی از چند عامل گرفته میشوند. بانک برای ارزیابی یک درخواست وام، اطلاعات مالی مختلفی را بررسی میکند؛ سامانه کنترل صنعتی برای تشخیص وضعیت دستگاه، از چند حسگر استفاده میکند؛ و برنامه پایش انرژی برای برآورد میزان مصرف، به اطلاعاتی مانند دما، ساعت شبانهروز و الگوی مصرف گذشته نیاز دارد.
وجه مشترک این مثالها آن است که خروجی موردنظر به بیش از یک عامل وابسته است. بااینحال، وابستگی به چند عامل لزوماً به معنای پیچیده بودن روش محاسبه نیست. در بعضی مسائل میتوان با یک رابطه ریاضی نسبتاً ساده، اطلاعات ورودی را ترکیب کرد.
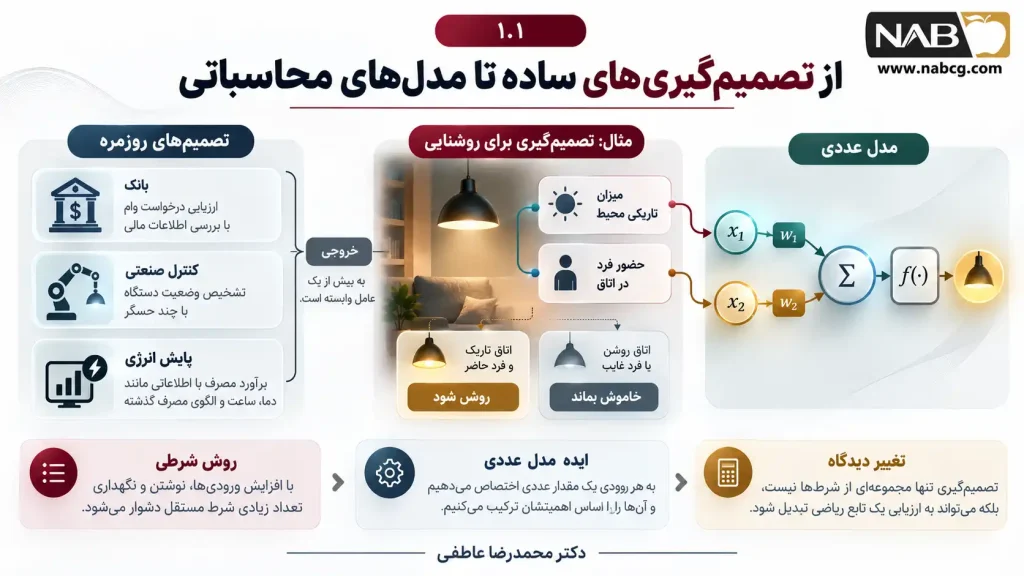
فرض کنید یک سامانه ساده روشنایی باید تصمیم بگیرد چراغ اتاق روشن شود یا خاموش بماند. برای این تصمیم، دو عامل را در نظر میگیریم: میزان تاریکی محیط و حضور فرد در اتاق.
اگر اتاق تاریک باشد و کسی در آن حضور داشته باشد، روشن شدن چراغ مطلوب است. اگر اتاق روشن باشد یا هیچکس در آن حضور نداشته باشد، ممکن است روشن کردن چراغ ضرورتی نداشته باشد.
این رفتار را میتوان با مجموعهای از قواعد شرطی برنامهنویسی کرد. برای نمونه، اگر دو شرط همزمان برقرار باشند، چراغ روشن شود. اما هنگامی که تعداد ورودیها افزایش مییابد، شدت اثر آنها متفاوت میشود یا تصمیم به آستانههای قابل تنظیم وابسته است، نوشتن و نگهداری تعداد زیادی شرط مستقل میتواند دشوار شود.
اینجاست که ایده استفاده از یک مدل عددی مطرح میشود.
بهجای آنکه برای هر ترکیب از شرایط یک دستور جداگانه نوشته شود، میتوان به هر ورودی یک مقدار عددی اختصاص داد و سپس این مقادیر را بر اساس اهمیتشان ترکیب کرد. حاصل این ترکیب، عددی خواهد بود که مبنای تصمیم نهایی قرار میگیرد.
این تغییر دیدگاه اهمیت زیادی دارد: تصمیمگیری دیگر صرفاً مجموعهای از دستورهای شرطی نیست، بلکه میتواند به ارزیابی یک تابع ریاضی تبدیل شود.
۱.۱.۱. نمایش عددی یک تصمیم ساده
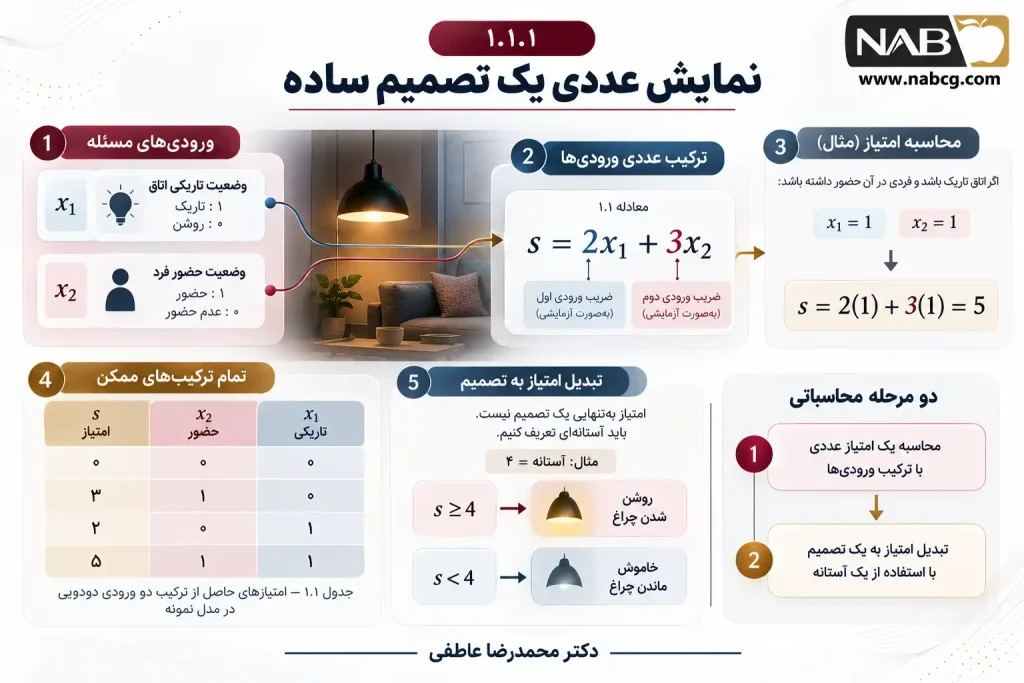
برای ساخت نخستین مثال، فرض میکنیم دو ورودی در اختیار داریم:
- x1: وضعیت تاریکی اتاق؛ مقدار یک به معنای تاریک بودن و صفر به معنای روشن بودن محیط است.
- x2 : وضعیت حضور فرد؛ مقدار یک به معنای حضور فرد و صفر به معنای نبود فرد است.
در این مثال، هر دو ورودی دودویی هستند؛ یعنی فقط یکی از دو مقدار صفر یا یک را اختیار میکنند.
میخواهیم عددی به نام (s) بسازیم که وضعیت اتاق را به یک امتیاز تبدیل کند. برای این کار، بهصورت آزمایشی رابطه زیر را انتخاب میکنیم:
معادله ۱.۱ — نمونهای از ترکیب عددی دو ویژگی ورودی
در معادله ۱.۱، عدد ۲ ضریب ورودی اول و عدد ۳ ضریب ورودی دوم است. این ضرایب را فعلاً خودمان انتخاب کردهایم و از هیچ فرایند یادگیری به دست نیامدهاند.
برای مثال، اگر اتاق تاریک باشد و فردی در آن حضور داشته باشد، مقادیر ورودی برابر (x1=1) و (x2=1) خواهند بود. بنابراین:
اگر اتاق تاریک باشد اما فردی حضور نداشته باشد، نتیجه برابر ۲ خواهد بود. در مقابل، اگر اتاق روشن باشد اما فردی حضور داشته باشد، امتیاز برابر ۳ میشود.
جدول ۱.۱ تمام ترکیبهای ممکن را نشان میدهد.
| تاریکی x1 | حضور x2 | امتیاز s |
| ۰ | ۰ | ۰ |
| ۰ | ۱ | ۳ |
| ۱ | ۰ | ۲ |
| ۱ | ۱ | ۵ |
جدول ۱.۱ — امتیازهای حاصل از ترکیب دو ورودی دودویی در مدل نمونه
این جدول نشان میدهد که با یک رابطه عددی، چهار وضعیت متفاوت را به چهار امتیاز تبدیل کردهایم. بااینحال، امتیاز بهتنهایی یک تصمیم دودویی نیست. برای تصمیمگیری باید قانونی نیز تعریف کنیم که مشخص کند کدام امتیازها به روشن شدن چراغ منجر شوند.
مثلاً اگر آستانه تصمیم را عدد ۴ در نظر بگیریم، تنها وضعیت چهارم باعث روشن شدن چراغ خواهد شد؛ زیرا تنها در آن وضعیت امتیاز دستکم برابر ۴ است.
بنابراین، حتی پیش از معرفی رسمی نورون مصنوعی، دو مرحله محاسباتی را از یکدیگر تشخیص دادهایم: نخست محاسبه یک امتیاز عددی و سپس تبدیل آن امتیاز به یک تصمیم.
این تمایز در تمام ادامه فصل اهمیت خواهد داشت.
۱.۱.۲. چرا ضرایب ورودیها یکسان نیستند؟
در رابطه قبلی، ضریب ورودی اول برابر ۲ و ضریب ورودی دوم برابر ۳ بود. انتخاب این اعداد نشان میدهد که در مدل فرضی ما، حضور فرد سهم عددی بیشتری از تاریکی محیط دارد.
اما آیا این موضوع در واقعیت نیز درست است؟
لزوماً خیر. ضرایب انتخابشده تنها فرضهای طراح مدل هستند و تا زمانی که با داده یا دانش معتبر پشتیبانی نشوند، نمیتوان آنها را توصیفی صحیح از اهمیت واقعی عوامل دانست.
نکته مهم آن است که مدل ریاضی اجازه میدهد میزان تأثیر ورودیها متفاوت باشد. اگر ضریب یکی از ورودیها تغییر کند، امتیاز محاسبهشده نیز تغییر خواهد کرد. همین انعطاف، اساس مفهوم وزن (Weight) در نورون مصنوعی است.
در بخشهای بعدی خواهیم دید که وزنها چگونه تعریف میشوند و چرا استفاده از آنها، امکان کنترل رفتار نورون را فراهم میکند.
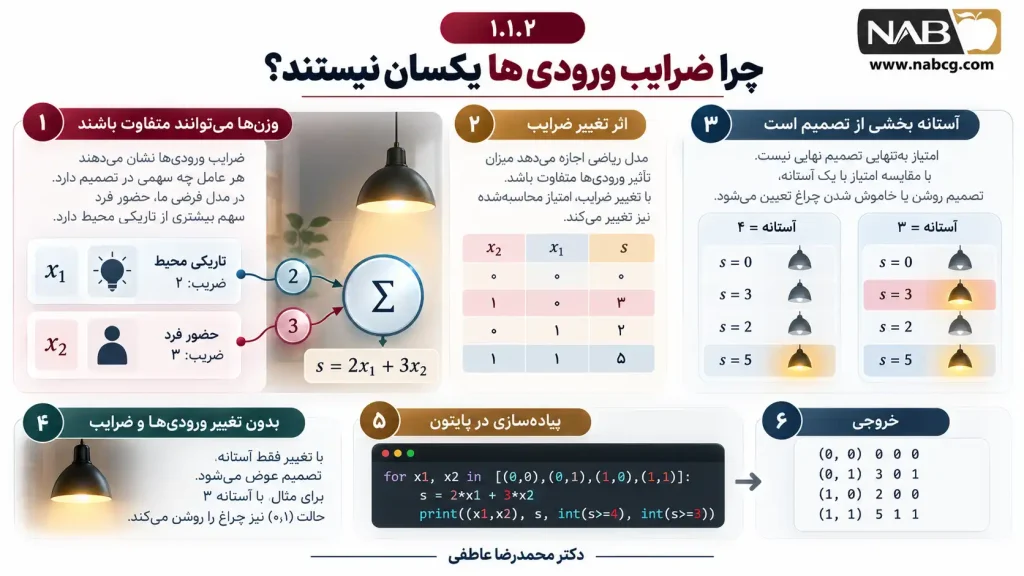
مثال :چرا آستانه بخشی از تصمیم است؟
در مثال روشنایی فایل اصلی، امتیاز برابر است با:
با آستانه ۴ فقط حالت (۱،۱) چراغ را روشن میکند. اگر آستانه ۳ شود، حالت (۰،۱) نیز روشن خواهد شد.
بنابراین بدون تغییر هیچ ورودی یا ضریبی، تصمیم عوض میشود.
کد پایتون:
for x1, x2 in [(0,0),(0,1),(1,0),(1,1)]:
    s = 2*x1 + 3*x2
    print((x1,x2), s, int(s>=4), int(s>=3))
خروجی:
(0, 0) 0 0 0
(0, 1) 3 0 1
(1, 0) 2 0 0
(1, 1) 5 1 1
۱.۲. تفاوت برنامهنویسی مبتنی بر قواعد ثابت با مدلهای دادهمحور
در برنامهنویسی مبتنی بر قواعد ثابت (Rule-Based Programming)، طراح معمولاً مجموعهای از دستورها را بهصورت مستقیم مشخص میکند. برنامه در زمان اجرا این دستورها را بررسی میکند و مطابق آنها پاسخ میدهد.
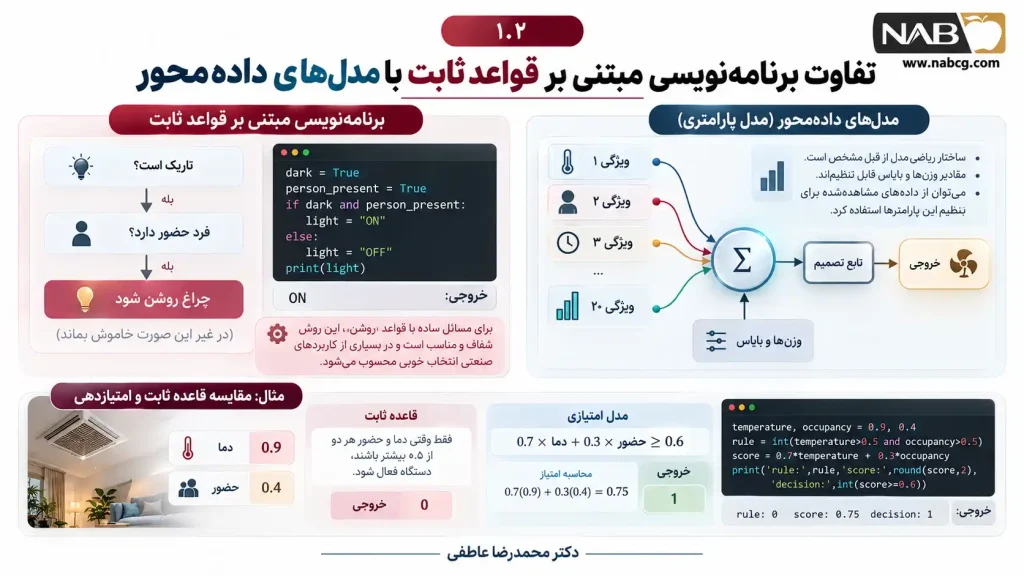
برای مثال، میتوان نوشت:
پایتون:
dark = True
person_present = True
if dark and person_present:
    light = "ON"
else:
    light = "OFF"
print(light)
خروجی این برنامه برابر ON خواهد بود؛ زیرا هر دو شرط برقرار هستند.
این روش برای مسئله حاضر ساده، شفاف و مناسب است. بنابراین، نباید تصور کرد که استفاده از نورون مصنوعی همیشه جایگزین بهتری برای قواعد شرطی است. در بسیاری از کاربردهای صنعتی، بهویژه هنگامی که قواعد روشن، محدود و قابل اعتماد هستند، روشهای مبتنی بر قواعد ممکن است انتخاب مهندسی مناسبتری باشند.
تفاوت اساسی زمانی آشکار میشود که بخواهیم رفتار سامانه را نه فقط با قواعدی که طراح از ابتدا تعیین کرده، بلکه با استفاده از دادههای مشاهدهشده تنظیم کنیم.
فرض کنید بهجای دو ورودی، بیست ویژگی در اختیار داشته باشیم. همچنین رابطه دقیق این ویژگیها با خروجی از قبل مشخص نباشد. در چنین شرایطی میتوان یک مدل پارامتری ساخت؛ مدلی که ساختار ریاضی آن از قبل تعیین شده است، اما مقدار پارامترهایش امکان تغییر دارد.
نورون مصنوعی نمونهای ابتدایی از چنین مدلهایی است. ورودیها مشخصاند، ساختار محاسبه معلوم است و وزنها و بایاس میتوانند رفتار مدل را تعیین کنند. بعداً الگوریتمی طراحی خواهیم کرد که این پارامترها را از دادههای آموزشی تنظیم کند.
بنابراین، باید میان دو مفهوم تمایز گذاشت: داشتن پارامترهای قابل تنظیم و داشتن سازوکار یادگیری خودکار. یک نورون مصنوعی میتواند پارامترهای قابل تنظیم داشته باشد، بدون آنکه هنوز هیچ الگوریتم آموزشی برای آن تعریف شده باشد.
این تمایز از سوءبرداشت رایجی جلوگیری میکند که بر اساس آن، هر محاسبه انجامشده توسط یک نورون را نوعی یادگیری تلقی میکنند.
مثال :مقایسه قاعده ثابت و امتیازدهی
برای تصمیم تهویه، قاعده ثابت میگوید فقط وقتی دما و حضور هر دو از ۰٫۵ بیشترند، دستگاه فعال شود.
مدل امتیازی میگوید:
برای دمای ۰٫۹ و حضور ۰٫۴، قاعده ثابت خروجی صفر ولی مدل امتیازی خروجی یک میدهد؛ هیچیک بدون معیار اعتبارسنجی لزوماً بهتر نیست.
کد پایتون:
temperature, occupancy = 0.9, 0.4
rule = int(temperature>0.5 and occupancy>0.5)
score = 0.7*temperature + 0.3*occupancy
print('rule:',rule,'score:',round(score,2),'decision:',int(score>=0.6))
خروجی:
rule: 0 score: 0.75 decision: 1۱.۳. چرا یک ویژگی بهتنهایی برای تصمیمگیری کافی نیست؟
کافی نبودن یک ویژگی، قانون عمومی همه مسائل نیست. بعضی مسائل با یک متغیر بهخوبی توصیف میشوند. برای نمونه، اگر هدف تنها تشخیص عبور دمای یک دستگاه از حد مجاز باشد، ممکن است اندازهگیری دما برای اتخاذ تصمیم کافی باشد.
بااینحال، در بسیاری از مسائل، یک ویژگی اطلاعات کافی درباره وضعیت موردنظر فراهم نمیکند.
فرض کنید سامانهای باید احتمال خرابی یک دستگاه صنعتی را بر اساس شرایط عملیاتی بررسی کند. اگر فقط دمای دستگاه اندازهگیری شود، افزایش دما ممکن است نشانه مشکل باشد؛ اما ممکن است دستگاه در شرایط کاری سنگینی قرار داشته باشد و این دما برای آن طبیعی باشد.
اگر علاوه بر دما، میزان ارتعاش، سرعت چرخش و جریان الکتریکی نیز بررسی شوند، مدل اطلاعات بیشتری درباره وضعیت دستگاه در اختیار خواهد داشت. البته افزودن ویژگیهای بیشتر همیشه به بهبود نتیجه منجر نمیشود. ویژگیهای نامربوط، اندازهگیریهای نادرست یا دادههای تکراری نیز میتوانند کیفیت مدلسازی را کاهش دهند (Bishop & Bishop, 2024).
از نظر محاسباتی، تفاوت میان یک ویژگی و چند ویژگی در این است که خروجی مدل دیگر تنها به یک عدد وابسته نیست. مدل باید بتواند رابطهای میان چند مقدار ورودی و خروجی موردنظر برقرار کند.
نورون مصنوعی چنین امکانی را در سادهترین شکل فراهم میکند.
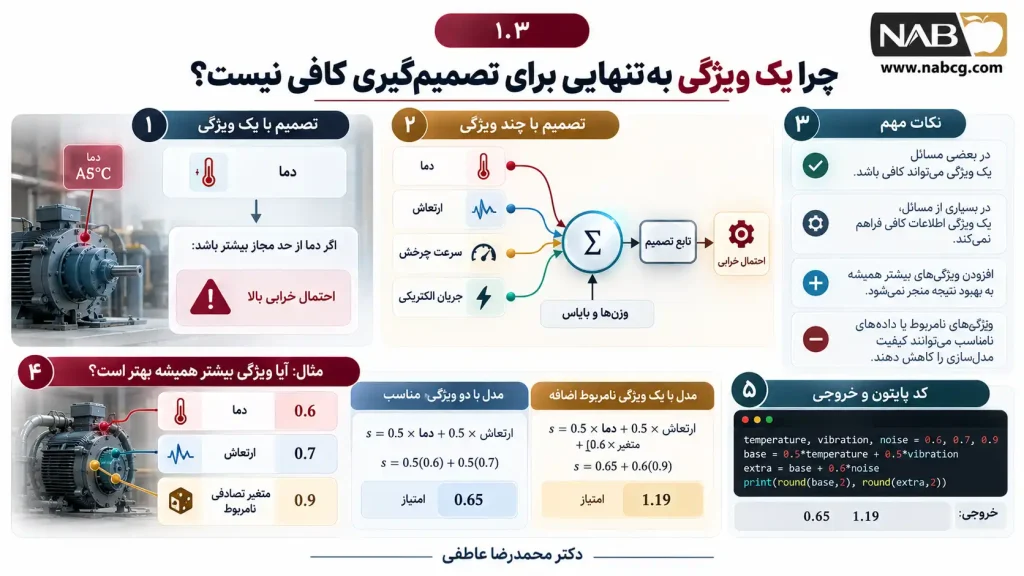
مثال :آیا ویژگی بیشتر همیشه بهتر است؟
در ارزیابی یک دستگاه، دو حسگر دما و ارتعاش را در نظر بگیرید. اضافه کردن یک متغیر تصادفی نامرتبط با وزن بزرگ میتواند امتیاز را بیدلیل جابهجا کند.
این مثال فقط خطر طراحی نامناسب ویژگی را نشان میدهد و درباره کیفیت واقعی حسگرها ادعایی ندارد.
کد پایتون:
temperature, vibration, noise = 0.6, 0.7, 0.9
base = 0.5*temperature + 0.5*vibration
extra = base + 0.6*noise
print(round(base,2),round(extra,2))
خروجی:
0.65 1.19۱.۴. ایده ترکیب اطلاعات و تولید یک خروجی
در مثال روشنایی، امتیاز حاصل از دو ورودی را با یک جمع وزندار محاسبه کردیم. اکنون میتوانیم این ایده را به تعداد بیشتری از ورودیها گسترش دهیم.
اگر یک سامانه سه ورودی داشته باشد، میتوان برای هر ورودی ضریب مشخصی در نظر گرفت و حاصلضرب هر ورودی در ضریبش را با حاصلضربهای دیگر جمع کرد. سپس عدد ثابتی نیز به مجموع افزود تا امکان تنظیم سطح پایه خروجی فراهم شود.
این عدد ثابت بعدها با عنوان بایاس (Bias) معرفی خواهد شد.
بنابراین، ساختار اولیه یک نورون مصنوعی را میتوان بهصورت یک زنجیره محاسباتی تصور کرد: اطلاعات وارد میشوند، هر ورودی در یک وزن ضرب میشود، حاصلها با یکدیگر جمع میشوند، یک بایاس به مجموع افزوده میشود و در نهایت نتیجه میتواند از یک تابع فعالسازی عبور کند.
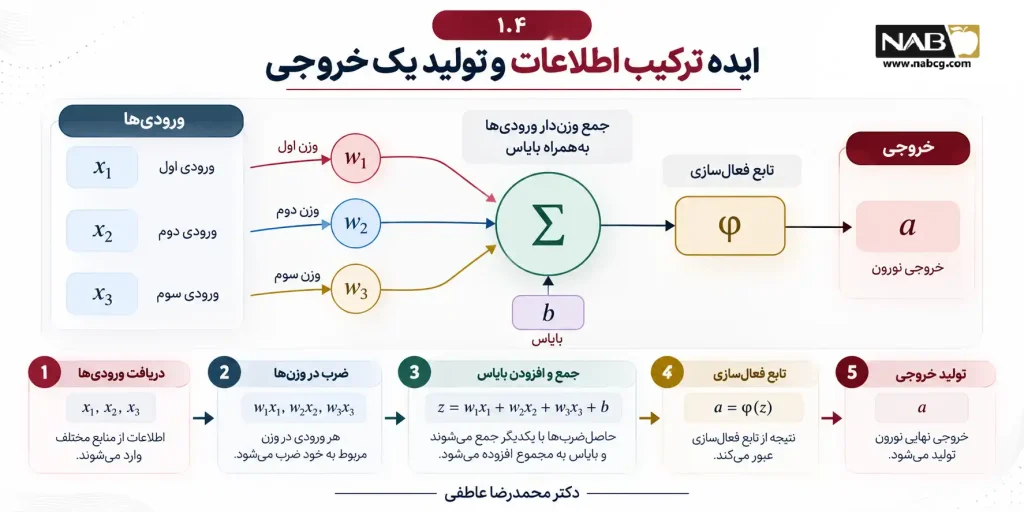
در شکل ۱.۱، نمادهای (x1) ، (x2) و (x3) ورودیهای نورون هستند. نمادهای (w1) ، (w2) و (w3) وزنهای متناظر را نشان میدهند. نماد (b) بیانگر بایاس، علامت (Sigma) نشاندهنده عملیات جمع و (phi) معرف تابع فعالسازی است. خروجی نورون با (a) نمایش داده شده است.
این شکل صرفاً یک نمایش مفهومی نیست. در ادامه فصل، هر جزء آن با تعریف دقیق ریاضی معرفی خواهد شد و سپس همین ساختار به کد پایتون تبدیل میشود.
۱.۵. جایگاه نورون مصنوعی در شبکههای عصبی
نام «شبکه عصبی» ممکن است این تصور را ایجاد کند که موضوع اصلی مطالعه ما از ابتدا ساختاری بسیار پیچیده با هزاران یا میلیونها جزء است. اما از نظر آموزشی، چنین ساختاری را بهتر است از واحدهای سادهتر آن بشناسیم.
یک نورون مصنوعی، بهتنهایی، تابعی است که ورودیهایی را به یک خروجی تبدیل میکند. هنگامی که چند نورون با آرایش مشخص کنار یکدیگر قرار میگیرند، میتوانند یک لایه بسازند. ترکیب لایهها نیز مبنای ساخت بسیاری از شبکههای عصبی متداول است (Goodfellow et al., 2016; Prince, 2023).
بااینحال، قدرت یک شبکه صرفاً از افزایش تعداد نورونها ناشی نمیشود. نحوه اتصال نورونها، نوع توابع فعالسازی، ساختار لایهها و روش تنظیم پارامترها همگی در توانایی مدل نقش دارند. برای مثال، اگر چندین تبدیل خطی بدون تابع فعالسازی غیرخطی بهصورت متوالی ترکیب شوند، حاصل همچنان یک تبدیل خطی یا آفین خواهد بود. بنابراین، افزودن لایههای بیشتر در چنین وضعیتی الزاماً قدرت نمایش غیرخطی ایجاد نمیکند.
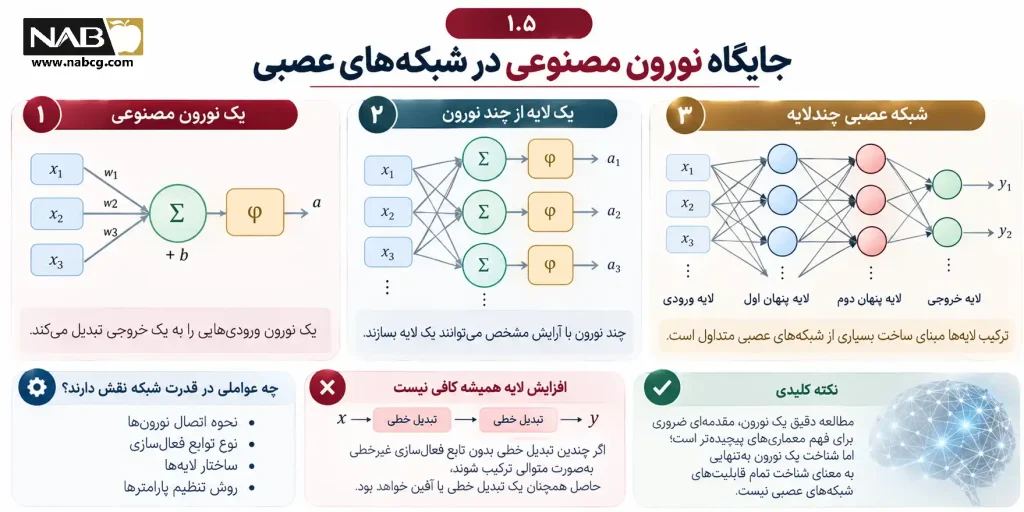
این ویژگی در فصل بعدی و هنگام معرفی شبکه عصبی چندلایه بررسی خواهد شد. در مرحله کنونی کافی است بدانیم که مطالعه دقیق یک نورون، مقدمهای ضروری برای فهم معماریهای پیچیدهتر فراهم میکند؛ اما شناخت یک نورون بهتنهایی به معنای شناخت تمام قابلیتهای شبکههای عصبی نیست.
۱.۶. نخستین فعالیت مفهومی: طراحی یک مدل تصمیمگیری
پیش از ورود به تاریخچه و صورتبندی رسمی نورون مصنوعی، مسئله زیر را بررسی کنید.
یک سامانه تهویه قرار است بر اساس دمای اتاق و میزان حضور افراد، شدت فعالیت خود را تنظیم کند. فرض کنید دما با عددی بین صفر و یک نمایش داده میشود؛ صفر بیانگر دمای پایین و یک بیانگر دمای بالا است. میزان حضور افراد نیز پس از مقیاسبندی در همین بازه قرار میگیرد.
برای طراحی یک مدل اولیه، سه پرسش مطرح میشود: آیا دما و میزان حضور باید تأثیر یکسانی بر خروجی داشته باشند؟ آیا خروجی مدل بهتر است یک مقدار پیوسته باشد یا تصمیمی دودویی؟ و اگر سامانه در شرایط مختلف رفتار مطلوبی نداشت، کدام بخشهای مدل را باید اصلاح کرد؟
در این مرحله، انتظار نمیرود خواننده پاسخ ریاضی کاملی ارائه دهد. هدف آن است که سه مفهوم را از یکدیگر تشخیص دهد: اطلاعات ورودی، روشی که اطلاعات را ترکیب میکند و خروجی حاصل از محاسبه.
تمرین ۱.۱ — محاسبه و تفسیر
فرض کنید امتیاز اولیه سامانه تهویه از رابطه زیر محاسبه شود:
در این رابطه، (x1) دمای مقیاسبندیشده و (x2) میزان حضور افراد است. مقدار امتیاز را برای دو وضعیت ((x1, x2)=(0.8,0.3)) و ((x1, x2)=(0.4,0.9)) محاسبه کنید. سپس توضیح دهید چرا نمیتوان فقط با مشاهده ضرایب ۴ و ۲، بدون آگاهی از مقیاس و معنای ورودیها، درباره اهمیت واقعی دما و حضور افراد نتیجه قطعی گرفت.
تمرین ۱.۲ — تحلیل مفهومی
فرض کنید طراح سامانه تصمیم بگیرد ضریب دما را از ۴ به ۱ کاهش دهد. آیا این تغییر لزوماً باعث کاهش خروجی در تمام شرایط میشود؟ پاسخ را با توجه به دامنه ورودیها توضیح دهید. سپس بررسی کنید اگر مقادیر دما امکان منفی شدن داشته باشند، پاسخ چگونه تغییر خواهد کرد.
تمرین ۱.۳ — طراحی
یک مسئله واقعی با سه ویژگی ورودی انتخاب کنید و توضیح دهید هر ویژگی چه اطلاعاتی به مدل میدهد. سپس یک رابطه جمع وزندار اولیه بنویسید. در این تمرین لازم نیست ضرایب شما بهترین مقادیر ممکن باشند؛ کافی است انتخاب هر ضریب توجیه روشن و قابل بررسی داشته باشد.
۲. از نورون زیستی تا مدل ریاضی نورون مصنوعی
۲.۱. چگونه مطالعه مغز به پیدایش مدلهای محاسباتی منجر شد؟
در بخش نخست این فصل، دیدیم که یک تصمیم را میتوان با ترکیب چند ورودی عددی به یک محاسبه تبدیل کرد. در مثال سامانه روشنایی، وضعیت تاریکی محیط و حضور افراد به اعداد تبدیل شدند و با ضرایب متفاوت در محاسبه یک امتیاز شرکت کردند. سپس نشان دادیم که با مقایسه امتیاز حاصل با یک آستانه، میتوان تصمیمی ساده تولید کرد.
اما یک پرسش بنیادی هنوز بیپاسخ مانده است: چرا چنین ساختاری را «نورون مصنوعی» مینامیم؟ چه ارتباطی میان یک رابطه ریاضی شامل چند ورودی، وزن و خروجی با سلولهای عصبی موجود در مغز برقرار است؟
برای پاسخ باید به یکی از تحولات فکری مهم قرن بیستم بازگردیم؛ زمانی که پژوهشگران علوم اعصاب، ریاضیات، منطق و مهندسی تلاش کردند عملکرد سامانه عصبی را با زبان محاسبات توصیف کنند.
هدف اولیه این پژوهشها الزاماً ساخت سامانههای هوش مصنوعی به معنای امروزی نبود. مسئله عمیقتر این بود که آیا میتوان بعضی جنبههای پردازش اطلاعات در موجودات زنده را به کمک قواعد ریاضی و منطقی توضیح داد؟ آیا واحدهایی ساده که به یکدیگر متصل شدهاند، میتوانند رفتارهایی ایجاد کنند که در سطح هر واحد بهتنهایی مشاهده نمیشود؟
این پرسشها در شکلگیری نظریه محاسبات عصبی (Neural Computation)، شبکههای عصبی مصنوعی و بعدها یادگیری عمیق نقش بنیادی داشتند (McCulloch & Pitts, 1943; Haykin, 2009).
۲.۱.۱. مغز بهعنوان سامانه پردازش اطلاعات
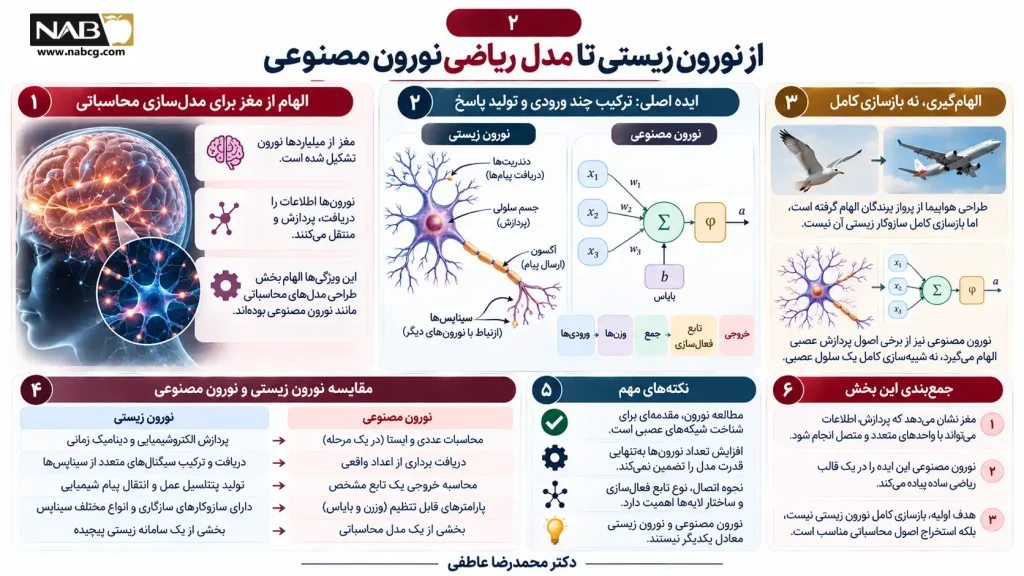
مغز انسان از شبکه گستردهای از سلولهای عصبی و دیگر سلولهای پشتیبان تشکیل شده است. نورونها از طریق مجموعهای از سازوکارهای الکتریکی و شیمیایی، اطلاعات را دریافت، پردازش و منتقل میکنند. این فرایندها در مقیاسهای زمانی و مکانی مختلف رخ میدهند و با فعالیت مدارهای عصبی، تجربه، سازگاری و یادگیری ارتباط دارند.
از دیدگاه مهندسی، یکی از ویژگیهای الهامبخش سامانه عصبی این است که پردازش اطلاعات در آن به یک واحد محاسباتی مرکزی محدود نیست. تعداد زیادی واحد با ارتباطات پیچیده در فعالیت شبکه مشارکت میکنند. رفتار سامانه نیز به وضعیت هر واحد، قدرت ارتباطات، الگوهای فعالیت و نحوه سازمانیافتگی مدارها وابسته است.
بااینحال، مغز را نمیتوان صرفاً مجموعهای از جمعکنندههای عددی تصور کرد. نورونهای زیستی دارای دینامیک زمانی، خواص الکتروشیمیایی، سازوکارهای متنوع انتقال پیام و فرایندهای سازگاری پیچیده هستند. همچنین سلولهای غیرعصبی، ساختار مدارها و فرایندهای تنظیمی در عملکرد دستگاه عصبی نقش دارند (Kandel et al., 2021).
آنچه برای نخستین مدلهای مصنوعی اهمیت داشت، بازسازی همه این پیچیدگیها نبود؛ بلکه استخراج چند اصل محاسباتی ساده بود که بتوان آنها را مطالعه کرد.
یکی از این اصول چنین بیان میشود: یک واحد ممکن است پیامهایی از چند منبع دریافت کند و با توجه به اثر ترکیبی آنها، پاسخ مشخصی تولید کند.
همین ایده ساده، نقطه آغاز مناسبی برای طراحی یک مدل ریاضی است.
۲.۱.۲. تفاوت الهام گرفتن از طبیعت و بازسازی کامل آن
در بسیاری از شاخههای مهندسی، مدلها از پدیدههای طبیعی الهام میگیرند، بدون آنکه نسخه کاملی از آن پدیده باشند.
برای مثال، طراحی هواپیما تا حدی از مشاهده پرواز پرندگان الهام گرفته است، اما هواپیما برای پرواز کردن لازم نیست ساختار استخوانی، ماهیچهای یا سازوکار بالزدن پرندگان را عیناً بازسازی کند. آنچه اهمیت دارد، شناسایی و بهکارگیری اصول فیزیکی مناسب برای تحقق هدف مهندسی است.
در مدلسازی عصبی نیز وضعیت مشابهی برقرار است. نورون مصنوعی قرار نیست تمام فعالیتهای زیستی یک سلول عصبی را بازسازی کند. این مدل فقط تعدادی از ویژگیهای انتزاعی پردازش اطلاعات را انتخاب میکند و در قالب روابط ریاضی بیان میکند.
این تمایز از نظر علمی ضروری است. اگر مدل مصنوعی را با نورون زیستی یکسان بدانیم، ممکن است درباره تواناییها یا محدودیتهای آن نتیجهگیریهای نادرستی داشته باشیم.
برای نمونه، یک نورون مصنوعی متداول معمولاً در یک مرحله محاسباتی، برداری از اعداد حقیقی را دریافت و خروجی تابعی مشخص را محاسبه میکند. در مقابل، فعالیت یک نورون زیستی میتواند شامل تغییرات زمانی ولتاژ غشا، تولید پتانسیل عمل، انتقال پیام شیمیایی و سازگاری سیناپسی باشد. این دو ساختار در سطح انتزاعی نقاط شباهتی دارند، اما از نظر سازوکار فیزیکی معادل نیستند.
بنابراین، در این کتاب، نورون مصنوعی را بهعنوان یک مدل محاسباتی الهامگرفته از برخی اصول پردازش عصبی مطالعه میکنیم، نه شبیهسازی کامل یک سلول عصبی.
۲.۲. نورون زیستی چگونه اطلاعات را دریافت و منتقل میکند؟
برای فهم منشأ نامگذاری اجزای نورون مصنوعی، لازم است با ساختار کلی نورون زیستی آشنا شویم. هدف این بخش آموزش تخصصی عصبشناسی نیست؛ بلکه شناخت ویژگیهایی است که در توسعه مدلهای اولیه شبکه عصبی مورد توجه قرار گرفتند.
۲.۲.۱. دندریتها، جسم سلولی و آکسون
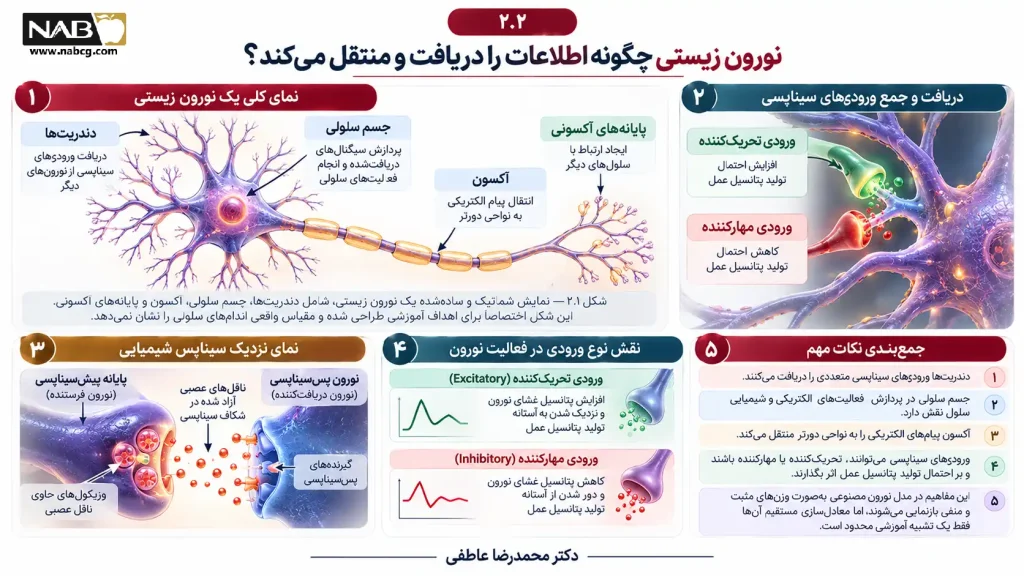
در یک نمایش آموزشی ساده، نورون زیستی از سه بخش اصلی تشکیل میشود: دندریتها، جسم سلولی و آکسون.
دندریتها (Dendrites) ساختارهای منشعبی هستند که بسیاری از ورودیهای سیناپسی نورون را دریافت میکنند. جسم سلولی (Soma) شامل هسته و بخش مهمی از سازوکارهای زیستی سلول است و در پردازش فعالیتهای الکتریکی و شیمیایی آن مشارکت دارد. آکسون (Axon) ساختاری است که میتواند پیامهای الکتریکی را به نواحی دورتر منتقل کند و از طریق پایانههای خود با سلولهای دیگر ارتباط برقرار سازد.
ارتباط میان دو نورون اغلب از طریق ساختارهایی به نام سیناپس (Synapse) برقرار میشود. در بسیاری از سیناپسهای شیمیایی، آزاد شدن ناقلهای عصبی بر فعالیت الکتریکی سلول دریافتکننده تأثیر میگذارد.
برای مطالعه شبکههای عصبی مصنوعی، میتوان از این تصویر یک برداشت اولیه داشت: نورون دارای مسیرهایی برای دریافت اطلاعات است، وضعیت ورودیها بر فعالیت آن اثر میگذارد و نتیجه فعالیت میتواند بر واحدهای دیگر تأثیر بگذارد.
اما باید در برابر یک سادهسازی بیشازحد مقاومت کرد. در نورون زیستی، دندریتها صرفاً سیمهای انتقال پیام نیستند و جسم سلولی نیز فقط یک جمعکننده ساده محسوب نمیشود. ساختار مکانی دندریتها، تغییرات زمانی پیامها و خواص غشای سلولی میتوانند رفتار محاسباتی نورون را تحت تأثیر قرار دهند.
۲.۲.۲. پیامهای تحریککننده و مهارکننده
فعالیت ورودیهای سیناپسی میتواند احتمال یا شرایط تولید پتانسیل عمل را تحت تأثیر قرار دهد. در بیان مقدماتی، بعضی ورودیها اثر تحریککننده (Excitatory) و برخی اثر مهارکننده (Inhibitory) دارند.
این مفاهیم در علوم اعصاب، به تغییرات الکتروشیمیایی غشا و شرایط فیزیولوژیکی وابستهاند. در نتیجه، معادلسازی مستقیم «ورودی تحریککننده = وزن مثبت» و «ورودی مهارکننده = وزن منفی» صرفاً یک تشبیه آموزشی محدود است، نه تعریفی دقیق از زیستشناسی سیناپسها.
در مدل مصنوعی، میتوان برای یک ورودی وزن مثبت تعیین کرد تا افزایش مقدار آن، با ثابت بودن سایر عوامل، مقدار جمع وزندار را افزایش دهد. وزن منفی نیز اثر معکوس دارد.
این امکان نشان میدهد که چگونه یک ایده کلی درباره تقویت یا کاهش اثر ورودیها میتواند در یک مدل ریاضی بسیار ساده بازنمایی شود.
مثال : وزن مثبت و منفی
برای ورودیهای ثابت (x1=0.8) و (x2=0.5)، وزن مثبت ورودی اول سهم (+1.6) و وزن منفی ورودی دوم سهم (-0.5) ایجاد میکند.
این تنها تشبیهی محاسباتی برای افزایش و کاهش امتیاز است، نه بازسازی واقعی فیزیولوژی سیناپس.
کد پایتون:
x1,x2=0.8,0.5
print('positive:',2*x1,'negative:',-1*x2,'sum:',2*x1-x2)
خروجی:
positive: 1.6 negative: -0.5 sum: 1.1۲.۲.۳. پتانسیل عمل و اهمیت آستانه
یکی از پدیدههای مهم در نورونهای زیستی تولید پتانسیل عمل (Action Potential) است؛ رویدادی الکتریکی که بر اثر دینامیک کانالهای یونی و ولتاژ غشا رخ میدهد. پتانسیل عمل یک فرایند زمانی و فیزیولوژیکی است و نباید با خروجی صفر یا یک یک تابع ریاضی کاملاً یکسان فرض شود.
بااینحال، ایده آستانه در تاریخ مدلسازی عصبی اهمیت داشت. پژوهشگران میتوانستند از خود بپرسند: آیا میتوان واحدی فرضی طراحی کرد که با دریافت ورودیهای کافی، فعال شود و در غیر این صورت غیرفعال بماند؟
برای مدل ابتدایی، کافی بود یک مقدار آستانه تعریف شود و مجموع اثر ورودیها با آن مقایسه شود.
این تصور، یکی از پایههای شکلگیری مدلهای منطقی اولیه نورون بود؛ مدلهایی که امکان بررسی رابطه میان ساختار شبکه و عملیات منطقی را فراهم کردند.
۲.۳. مدل مککالاک–پیتس: تبدیل ایده نورون به منطق ریاضی
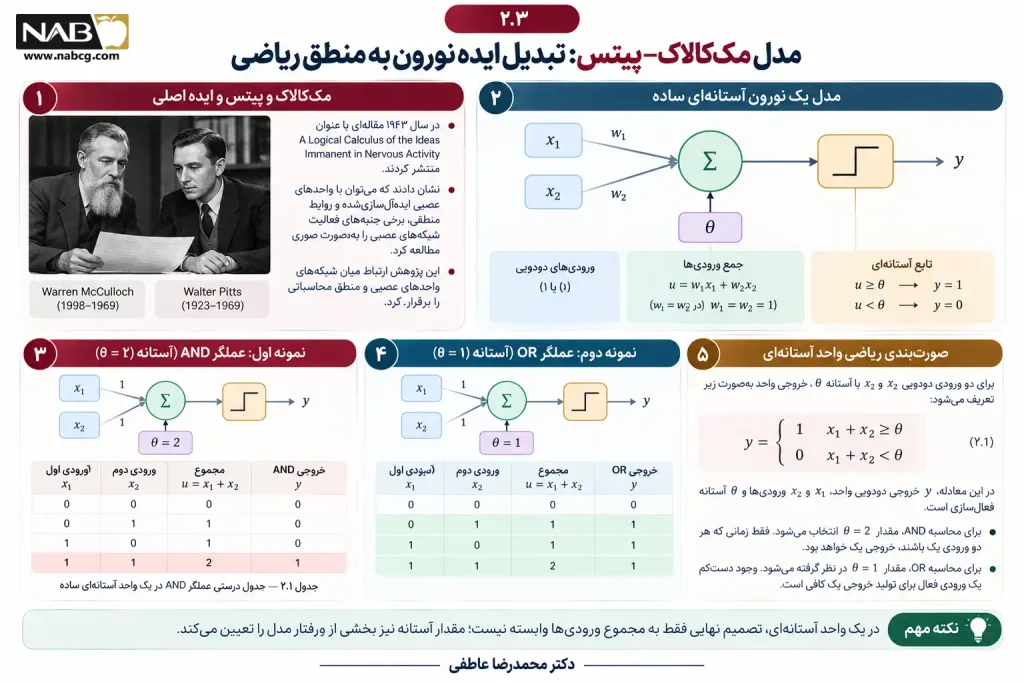
در سال ۱۹۴۳، وارن مککالاک (Warren McCulloch) و والتر پیتس (Walter Pitts) مقالهای منتشر کردند که یکی از آثار بنیادین تاریخ محاسبات عصبی به شمار میرود. عنوان مقاله آنها A Logical Calculus of the Ideas Immanent in Nervous Activity بود.
مککالاک و پیتس نشان دادند که میتوان با استفاده از واحدهای عصبی ایدهآلسازیشده و روابط منطقی، برخی جنبههای فعالیت شبکههای عصبی را بهصورت صوری مطالعه کرد (McCulloch & Pitts, 1943).
اهمیت این پژوهش صرفاً در معرفی یک ساختار شبیه نورون نبود. دستاورد اصلی، برقرار کردن ارتباطی میان شبکههای واحدهای عصبی انتزاعی و منطق محاسباتی بود. چنین نگرشی کمک کرد شبکه عصبی نه فقط بهعنوان یک پدیده زیستی، بلکه بهعنوان موضوعی قابل مطالعه در ریاضیات و نظریه محاسبه مطرح شود.
۲.۳.۱. از سلول عصبی به یک واحد منطقی
برای فهم ایده اصلی، نسخه آموزشی سادهای از یک نورون آستانهای را در نظر میگیریم.
این واحد دو ورودی دودویی دریافت میکند. اگر مجموع ورودیها به مقدار مشخصی برسد، خروجی یک تولید میشود؛ در غیر این صورت، خروجی صفر خواهد بود.
برای مثال، فرض کنید هر ورودی فقط میتواند صفر یا یک باشد و آستانه فعالسازی را عدد ۲ انتخاب کنیم.
در این صورت، اگر هر دو ورودی یک باشند، مجموع آنها برابر ۲ خواهد شد و واحد فعال میشود. اگر فقط یکی از ورودیها فعال باشد، مجموع برابر ۱ است و خروجی صفر باقی میماند.
این رفتار دقیقاً با عملگر منطقی AND سازگار است.
| ورودی اول | ورودی دوم | خروجی AND |
| ۰ | ۰ | ۰ |
| ۰ | ۱ | ۰ |
| ۱ | ۰ | ۰ |
| ۱ | ۱ | ۱ |
جدول ۲.۱ — جدول درستی عملگر AND در یک واحد آستانهای ساده
در این مثال، واحد آستانهای فقط زمانی خروجی یک تولید میکند که هر دو شرط برقرار باشند.
حال اگر آستانه را به جای ۲ برابر ۱ قرار دهیم، رفتار تغییر خواهد کرد. کافی است دستکم یکی از ورودیها برابر یک باشد تا خروجی فعال شود. این وضعیت با عملگر منطقی OR مطابقت دارد.
این دو مثال نشان میدهند چگونه میتوان با تغییر یک مقدار عددی، رفتار منطقی یک واحد محاسباتی را تغییر داد.
۲.۳.۲. صورتبندی ریاضی واحد آستانهای
برای بیان دقیق این رفتار، ابتدا دو ورودی دودویی (x1) و (x2) را تعریف میکنیم که هر یک به مجموعه ({0,1}) تعلق دارند.
مجموع ورودیها را با (u) و آستانه تصمیم را با (θ) نشان میدهیم. تابع خروجی بهصورت زیر تعریف میشود:
در معادله ۲.۱، (y) خروجی دودویی واحد، (x1) و (x2) ورودیها و (theta) آستانه فعالسازی است.
فرض اصلی آن است که ورودیها دودویی باشند و رفتار واحد صرفاً با مقایسه مجموع آنها با یک آستانه تعیین شود. این معادله، یک مدل آموزشی سادهشده از خانواده واحدهای آستانهای است، نه بازنویسی کامل دستگاه صوری و قواعد فیزیولوژیکی مدل تاریخی مککالاک–پیتس.
برای محاسبه AND ، مقدار (θ =2) را انتخاب میکنیم. با قرار دادن (x1=1) و (x2=0) ، مجموع برابر ۱ میشود و خروجی صفر خواهد بود. اگر هر دو ورودی یک باشند، مجموع برابر ۲ میشود و خروجی یک خواهد شد.
برای محاسبه OR، کافی است مقدار (θ =1) در نظر گرفته شود. در این حالت، وجود دستکم یک ورودی فعال برای تولید خروجی یک کافی است.
تفسیر علمی: در یک واحد آستانهای، تصمیم نهایی فقط به مجموع ورودیها وابسته نیست؛ مقدار آستانه نیز بخشی از رفتار مدل را تعیین میکند.
۲.۳.۳. یک پیادهسازی ساده با پایتون
میتوان مدل آستانهای فوق را بدون نیاز به هیچ کتابخانه خارجی پیادهسازی کرد.
def threshold_neuron(x1, x2, threshold):
    total = x1 + x2

    if total >= threshold:
        return 1

    return 0


inputs = [
    (0, 0),
    (0, 1),
    (1, 0),
    (1, 1)
]

print("AND")
for x1, x2 in inputs:
    print(x1, x2, threshold_neuron(x1, x2, 2))

print("OR")
for x1, x2 in inputs:
    print(x1, x2, threshold_neuron(x1, x2, 1))
نتیجه اجرای برنامه برای عملگر AND برابر است با:
AND
0 0 0
0 1 0
1 0 0
1 1 1
و برای OR :
OR
0 0 0
0 1 1
1 0 1
1 1 1
این کد هنوز یک الگوریتم یادگیری نیست. هیچ داده آموزشی برای تعیین خودکار آستانه استفاده نشده و هیچ اصلاحی در پارامترها انجام نمیشود. برنامه فقط تابعی را محاسبه میکند که رفتار آن از ابتدا مشخص شده است.
با وجود سادگی مثال، دو مفهوم مهم از آن به دست میآید. نخست اینکه یک واحد محاسباتی بسیار ساده میتواند رفتار منطقی مشخصی داشته باشد. دوم اینکه تغییر پارامتر آستانه میتواند رفتار همان واحد را تغییر دهد، بدون آنکه لازم باشد ساختار برنامه از نو نوشته شود.
۲.۳.۴. تفاوت مدل مککالاک–پیتس با نورون مصنوعی متداول
یکی از خطاهای رایج در آموزش تاریخ شبکههای عصبی این است که مدل مککالاک–پیتس، نورون پرسپترون و نورونهای متداول شبکههای عمیق کاملاً معادل معرفی میشوند.
این مدلها پیوند تاریخی و مفهومی دارند، اما اهداف، فرضها و قابلیتهای آنها یکسان نیست.
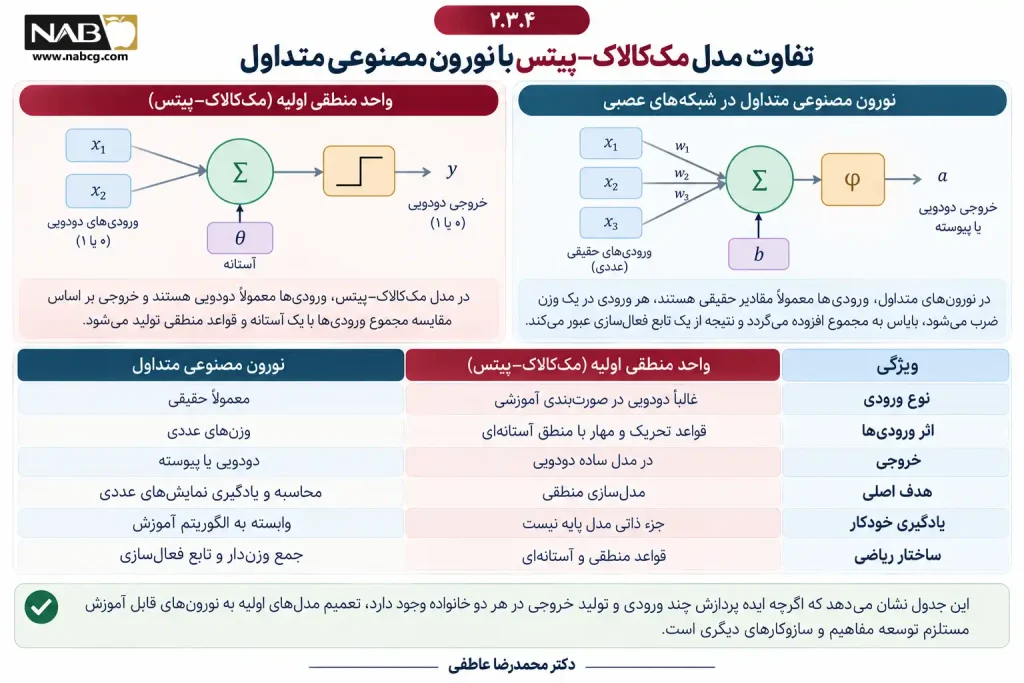
مدل مککالاک–پیتس در چارچوب اصلی خود با هدف مطالعه صوری ارتباط فعالیت عصبی و منطق ارائه شد. پرسپترون روزنبلات بعدها مسئله بازشناسی الگو و تنظیم ارتباطات بر اساس تجربه را به شکل متفاوتی دنبال کرد. نورونهای متداول در شبکههای یادگیری عمیق نیز معمولاً دارای ورودیهای حقیقی، پارامترهای قابل یادگیری و توابع فعالسازی متنوع هستند.
| ویژگی | واحد منطقی اولیه | نورون مصنوعی متداول |
| نوع ورودی | غالباً دودویی در صورتبندی آموزشی | معمولاً حقیقی |
| اثر ورودیها | قواعد تحریک و مهار یا منطق آستانهای | وزنهای عددی |
| خروجی | در مدل ساده دودویی | دودویی یا پیوسته |
| هدف اصلی | مدلسازی منطقی | محاسبه و یادگیری نمایشهای عددی |
| یادگیری خودکار | جزء ذاتی مدل پایه نیست | وابسته به الگوریتم آموزش |
| ساختار ریاضی | قواعد منطقی و آستانهای | جمع وزندار و تابع فعالسازی |
جدول ۲.۲ — مقایسه واحد منطقی اولیه و نورون مصنوعی متداول؛ ستون نخست یک صورتبندی آموزشی سادهشده را توصیف میکند.
این جدول نشان میدهد که اگرچه ایده پردازش چند ورودی و تولید خروجی در هر دو خانواده وجود دارد، تعمیم مدلهای اولیه به نورونهای قابل آموزش مستلزم توسعه مفاهیم و سازوکارهای دیگری است.
۲.۴. محدودیتهای مدلهای منطقی اولیه و ضرورت توسعه معماری
مدلهای آستانهای اولیه از نظر نظری اهمیت فراوانی داشتند، اما برای بسیاری از مسائل واقعی بیشازحد ساده بودند.
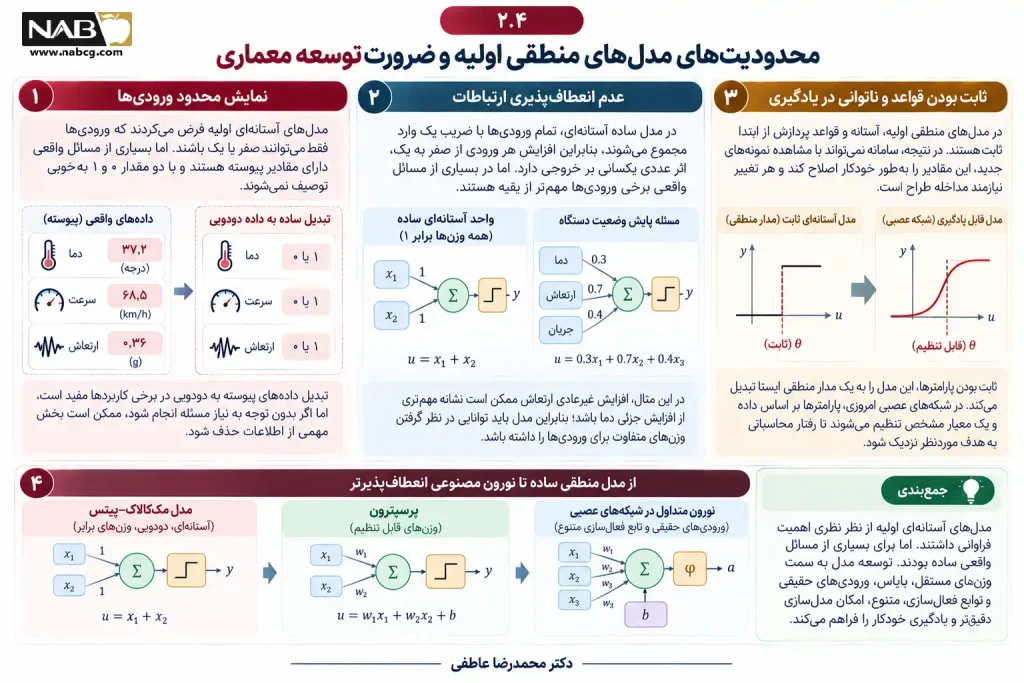
نخستین محدودیت، نمایش ورودیها بود. بسیاری از مسائل جهان واقعی را نمیتوان بهطور طبیعی و بدون از دست رفتن اطلاعات مهم، فقط با صفر و یک توصیف کرد. برای مثال، دمای یک دستگاه میتواند ۳۷٫۲ درجه باشد، سرعت یک خودرو ممکن است ۶۸٫۵ کیلومتر بر ساعت باشد و میزان ارتعاش یک موتور به مقادیری پیوسته وابسته باشد.
اگر همه این اطلاعات صرفاً به دو وضعیت صفر و یک تبدیل شوند، بخشی از تفاوتهای واقعی میان نمونهها حذف میشود. البته تبدیل دادههای پیوسته به دادههای دودویی در برخی کاربردها مفید است؛ مشکل زمانی ایجاد میشود که این تبدیل بدون توجه به نیاز مسئله انجام شود.
محدودیت دوم، انعطافپذیری ارتباطات است. در مدل سادهای که در معادله ۲.۱ ارائه کردیم، هر دو ورودی با ضریب یک وارد مجموع میشوند. این موضوع به معنای آن است که افزایش هر ورودی از صفر به یک، اثر عددی یکسانی بر مجموع دارد.
اما در بسیاری از مسائل، چنین فرضی قابل دفاع نیست. برای مثال، در پایش وضعیت دستگاه صنعتی، افزایش غیرعادی ارتعاش ممکن است نشانه مهمتری از افزایش جزئی دما باشد. در چنین مسئلهای، مدل باید بتواند تأثیر متفاوتی برای ورودیها در نظر بگیرد.
محدودیت سوم به تنظیم رفتار مدل مربوط است. اگر آستانه و قواعد پردازش از ابتدا ثابت باشند، سامانه نمیتواند صرفاً با مشاهده نمونههای جدید آنها را اصلاح کند. هرگونه تغییر باید از طریق مداخله طراح یا افزودن یک سازوکار مستقل برای تنظیم پارامترها انجام شود.
این موضوع، تفاوت میان یک مدار منطقی ثابت و یک سامانه یادگیرنده را آشکار میکند.
در شبکههای عصبی امروزی، مسئله فقط تولید خروجی از ورودی نیست. هدف آن است که پارامترهای مدل بر اساس داده و یک معیار مشخص تنظیم شوند تا رفتار محاسباتی به هدف موردنظر نزدیک شود.
بااینحال، وارد کردن کامل بحث یادگیری در این مرحله زودهنگام است. پیش از آن باید بفهمیم چگونه وزنهای مستقل، بایاس و تابع فعالسازی یک نورون را به مدلی انعطافپذیرتر تبدیل میکنند.
۲.۵. گذار از مدلهای منطقی به نورونهای دارای وزن و بایاس
توسعه مدلهای اولیه شبکه عصبی بهتدریج نشان داد که برای حل مسائل تشخیص الگو، وجود یک واحد منطقی با رفتار ثابت کافی نیست. لازم بود مدلها بتوانند تفاوت میان ورودیها را بهصورت عددی نمایش دهند و در مراحل بعد، این تفاوتها را بر اساس تجربه تنظیم کنند.
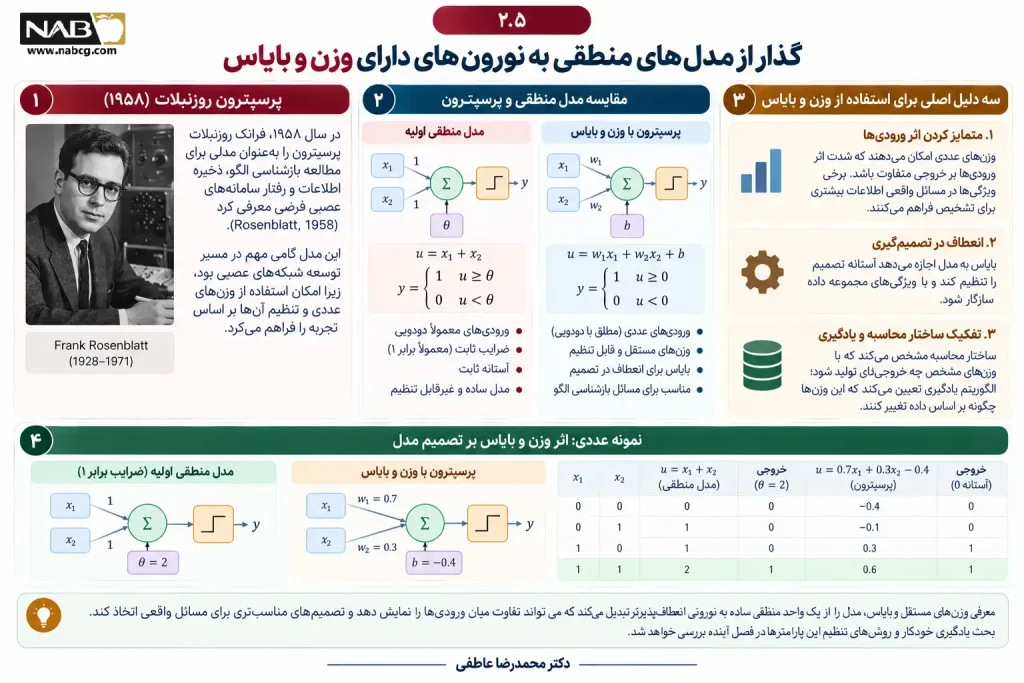
یکی از نقاط عطف این مسیر، معرفی نظریه پرسپترون توسط فرانک روزنبلات در سال ۱۹۵۸ بود. روزنبلات پرسپترون را در چارچوب مطالعه بازشناسی الگو، ذخیره اطلاعات و رفتار سامانههای عصبی فرضی بررسی کرد (Rosenblatt, 1958).
در این مرحله از تاریخ علم، مسئله دیگر صرفاً بازنمایی قواعد منطقی نبود. پژوهشگران میخواستند سامانههایی طراحی کنند که بتوانند بر اساس تجربه، رفتار خود را تغییر دهند.
این تحول را میتوان از سه منظر درک کرد.
نخست، مدل باید قادر باشد شدت اثر ورودیها را از یکدیگر متمایز کند. برای مثال، در یک مسئله تشخیص الگو، ممکن است بعضی ویژگیها برای تفکیک دو گروه اطلاعات بیشتری فراهم کنند. استفاده از وزنهای عددی امکان نمایش چنین تفاوتی را فراهم میسازد.
دوم، لازم است تصمیم مدل انعطافپذیر باشد. اگر آستانه تصمیم برای همه شرایط ثابت و غیرقابل تنظیم باشد، مدل نمیتواند بهراحتی با ویژگیهای مجموعه داده موردنظر سازگار شود. معرفی بایاس یا آستانه قابل تنظیم، یکی از ابزارهای ایجاد چنین انعطافی است.
سوم، باید میان ساختار محاسبه و فرایند یادگیری تمایز برقرار شود. ساختار محاسبه تعیین میکند که مدل با وزنهای مشخص چه خروجیای تولید کند؛ الگوریتم یادگیری مشخص میکند که این وزنها چگونه بر اساس داده تغییر کنند.
این سه موضوع در توسعه شبکههای عصبی اهمیت بنیادین پیدا کردند، اما در فصل حاضر تنها دو مورد نخست را بهصورت کامل بررسی خواهیم کرد. یادگیری خودکار موضوع اصلی فصل آینده خواهد بود.
۲.۵.۱. افزودن وزنهای مستقل به ورودیها
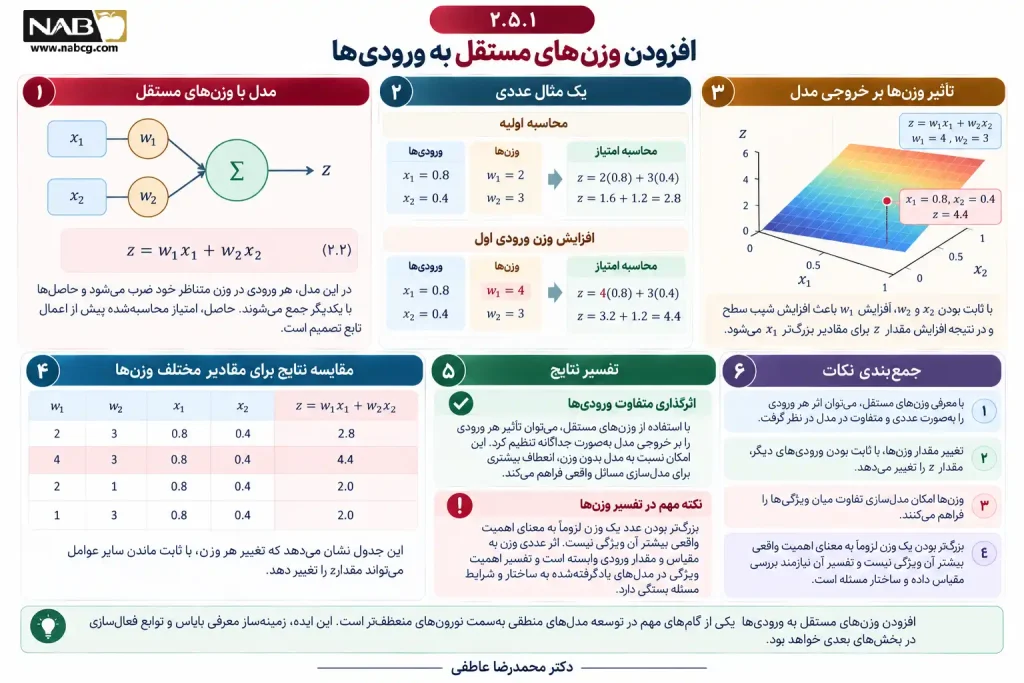
در واحد آستانهای ساده بخش ۲.۳، مجموع دو ورودی را بدون وزندهی محاسبه کردیم. اکنون میخواهیم امکان اثرگذاری متفاوت هر ورودی را فراهم کنیم.
برای این منظور، فرض میکنیم (x1) و (x2) دو ورودی عددی و (w1) و (w2) وزنهای متناظر آنها باشند.
مدل جدید ابتدا مقدار زیر را محاسبه میکند:
در معادله ۲.۲، (z) امتیاز محاسبهشده پیش از اعمال تابع تصمیم است. ورودیها و وزنها در این صورتبندی اسکالرهای حقیقی هستند و خروجی نیز یک عدد حقیقی خواهد بود.
برخلاف مدل بدون وزن، اکنون میتوانیم اثر هر ورودی را مستقل از دیگری تنظیم کنیم.
فرض کنید:
و وزنها برابر باشند با:
در این صورت:
اگر فقط وزن اول را از ۲ به ۴ افزایش دهیم، با ثابت ماندن تمام عوامل دیگر، امتیاز جدید برابر خواهد بود با:
بنابراین، تغییر یک وزن میتواند خروجی محاسبه را تغییر دهد.
اما این نتیجه باید با دقت تفسیر شود. بزرگتر بودن یک وزن لزوماً به معنای اهمیت واقعی بیشتر آن ویژگی در تمام شرایط نیست. اثر عددی وزن به مقیاس و مقدار ورودی وابسته است و تفسیر اهمیت ویژگی در مدلهای یادگرفتهشده نیز به ساختار و شرایط مسئله بستگی دارد.
این موضوع در بخش های بعدی، هنگام بررسی وزنها، با مثالها و آزمایشهای بیشتری توسعه خواهد یافت.
۲.۵.۲. افزودن بایاس برای تنظیم سطح پایه محاسبه
در معادله ۲.۲، هنگامی که هر دو ورودی صفر باشند، مقدار (z) نیز الزاماً صفر خواهد بود. برای ایجاد انعطاف بیشتر، یک مقدار مستقل از ورودیها به رابطه اضافه میکنیم.
این مقدار را بایاس (Bias) مینامیم و با نماد (b) نشان میدهیم:
بایاس یک پارامتر اسکالر است که به مدل اجازه میدهد مقدار پیشفعالسازی را مستقل از تغییرات ورودی جابهجا کند.
برای مثال، اگر وزنها و ورودیهای مثال قبل ثابت بمانند و (b=-1) باشد، خواهیم داشت:
در مقابل، اگر مقدار بایاس به ۱ تغییر کند، مقدار پیشفعالسازی برابر ۳٫۸ میشود.
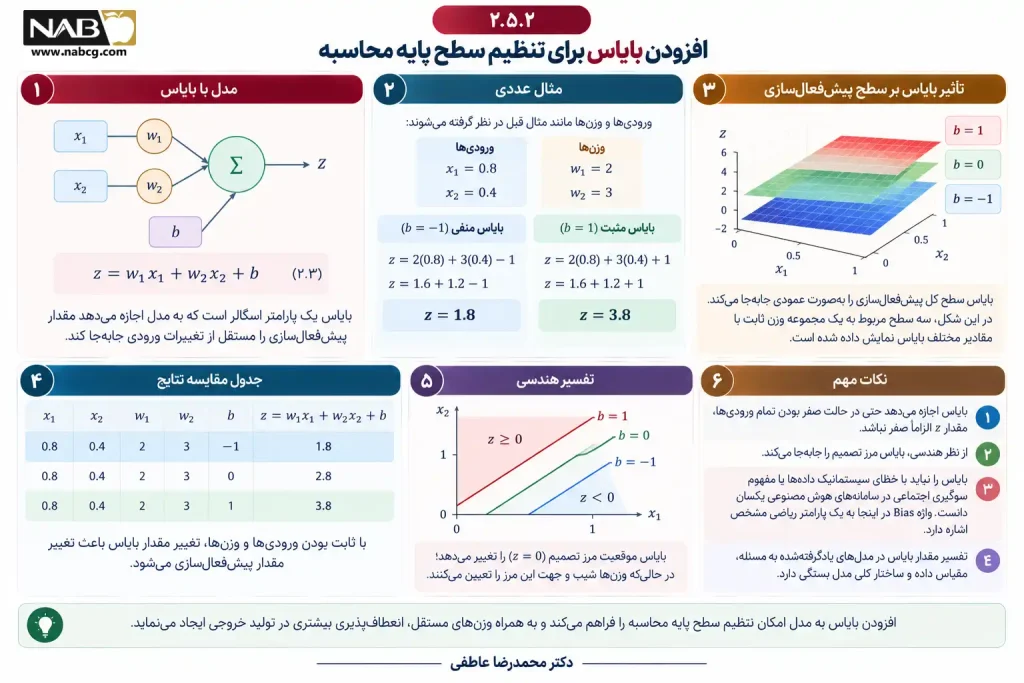
از دیدگاه هندسی، بایاس میتواند موقعیت مرز تصمیم را تغییر دهد؛ درحالیکه وزنها در تعیین جهت و شیب آن نیز نقش دارند. تحلیل کامل این ویژگی به بخش های بعدی اختصاص داده شده است.
نکته مهم آن است که بایاس را نباید با خطای سیستماتیک دادهها یا مفهوم سوگیری اجتماعی در سامانههای هوش مصنوعی یکسان دانست. واژه Bias در اینجا به یک پارامتر ریاضی مشخص اشاره دارد.
۲.۵.۳. چرا به تابع فعالسازی نیاز داریم؟
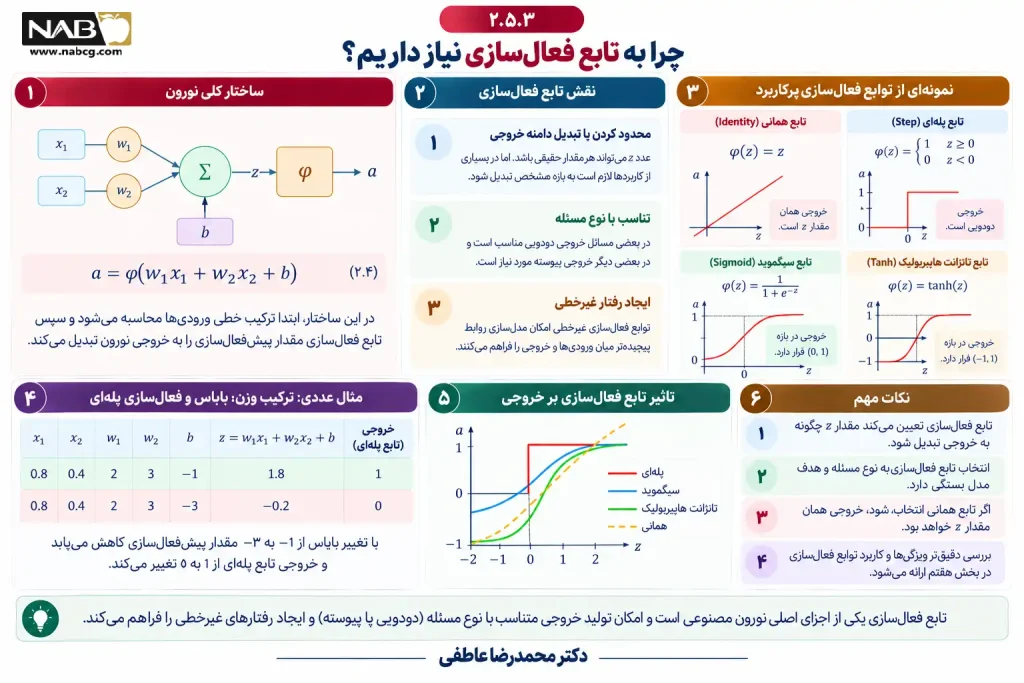
تا اینجا مدل فقط عددی به نام (z) محاسبه میکند. این عدد میتواند مثبت، منفی یا صفر باشد و محدود به بازه خاصی نیست.
اما در برخی کاربردها، هدف تولید یک تصمیم دودویی است. در کاربردهای دیگر، خروجی پیوسته مناسبتر خواهد بود. بنابراین، ممکن است لازم باشد مقدار پیشفعالسازی به شکلی متناسب با نوع مسئله تبدیل شود.
برای انجام این کار، تابعی به نام تابع فعالسازی (Activation Function) معرفی میکنیم که با نماد (φ) نمایش داده میشود.
در نتیجه، ساختار کلی نورون به شکل زیر درمیآید:
در معادله ۲.۴، (a) خروجی نهایی نورون است و تابع (φ) مقدار پیشفعالسازی را به خروجی تبدیل میکند.
اگر تابع فعالسازی، تابع همانی باشد، خروجی همان مقدار (z) خواهد بود. اگر تابع پلهای انتخاب شود، خروجی میتواند دودویی باشد. سایر توابع نیز رفتار متفاوتی ایجاد میکنند.
توضیح تفصیلی این توابع به بخش هفتم اختصاص دارد. در اینجا تنها لازم است نقش ساختاری تابع فعالسازی روشن شود: این تابع تعیین میکند مقدار حاصل از ترکیب خطی ورودیها چگونه به خروجی نورون تبدیل شود.
مثال : ترکیب وزن، بایاس و فعالسازی
ورودیهای (x1=0.8) و (x2=0.4)، وزنهای ۲ و ۳ و بایاس ۱-، پیشفعالسازی ۱٫۸ میسازند.
تابع پلهای با مرز صفر خروجی یک میدهد. با بایاس ۳-، پیشفعالسازی ۰٫۲- و خروجی صفر میشود؛ بنابراین بایاس سطح تصمیم را جابهجا میکند.
کد پایتون:
x1,x2=0.8,0.4
for b in [-1,-3]:
    z=2*x1+3*x2+b
    print('bias:',b,'z:',round(z,1),'output:',int(z>=0))
خروجی:
bias: -1 z: 1.8 output: 1
bias: -3 z: -0.2 output: 0
۲.۶. چه چیزهایی از نورون زیستی حفظ شده و چه چیزهایی حذف شدهاند؟
اکنون میتوان ارتباط میان مدل زیستی و مصنوعی را دقیقتر ارزیابی کرد.
مدل مصنوعی از ایده دریافت اطلاعات از چند منبع، تفاوت اثر ورودیها و تولید پاسخ استفاده میکند. اما بسیاری از جزئیات زیستی را بهصورت آگاهانه کنار میگذارد.
یکی از تفاوتهای مهم به پردازش در دندریتها مربوط است. پژوهشهای علوم اعصاب نشان دادهاند که دندریتها میتوانند دارای سازوکارهای پردازشی خطی و غیرخطی باشند. بنابراین، فرض اینکه همه ورودیهای یک نورون زیستی صرفاً در یک جمعکننده ساده جمع شوند، توصیف کاملی از محاسبات درونسلولی نیست (London & Häusser, 2005).
تفاوت دیگر، نقش زمان است. در نورون مصنوعی پایه، ورودیها معمولاً بهصورت مجموعهای از مقادیر عددی در یک مرحله دریافت میشوند و خروجی محاسبه میشود. در نورون زیستی، زمانبندی پیامها، وضعیت غشا و فعالیت گذشته سلول میتوانند در پاسخ آن تأثیر بگذارند.
این محدودیتها به معنای بیفایده بودن مدل مصنوعی نیستند. اعتبار یک مدل مهندسی را باید نسبت به هدفی که برای آن ساخته شده ارزیابی کرد. برای نمونه، یک نورون مصنوعی ساده ممکن است مدل مناسبی برای تمام پویاییهای زیستی سلول عصبی نباشد، اما همچنان واحد محاسباتی سودمندی برای ساخت مدلهای دادهمحور محسوب شود.
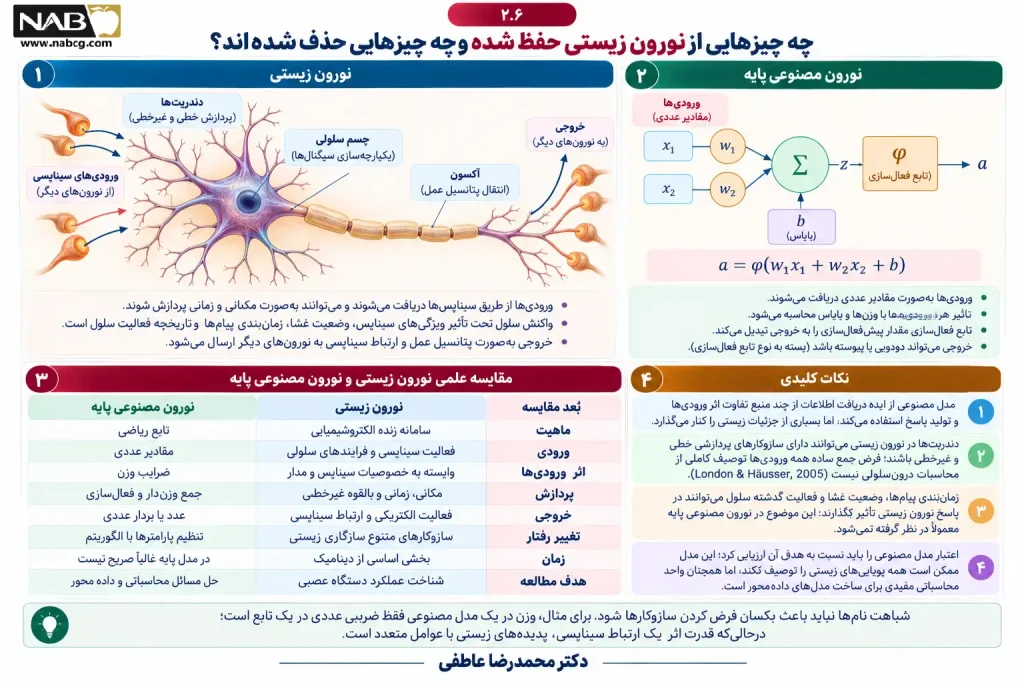
جدول ۲.۳ — مقایسه علمی نورون زیستی و نورون مصنوعی پایه
| بُعد مقایسه | نورون زیستی | نورون مصنوعی پایه |
| ماهیت | سامانه زنده الکتروشیمیایی | تابع ریاضی |
| ورودی | فعالیت سیناپسی و فرایندهای سلولی | مقادیر عددی |
| اثر ورودیها | وابسته به خصوصیات سیناپس و مدار | ضرایب وزن |
| پردازش | مکانی، زمانی و بالقوه غیرخطی | جمع وزندار و فعالسازی |
| خروجی | فعالیت الکتریکی و ارتباط سیناپسی | عدد یا بردار عددی |
| تغییر رفتار | سازوکارهای متنوع سازگاری زیستی | تنظیم پارامترها با الگوریتم |
| زمان | بخشی اساسی از دینامیک | در مدل پایه غالباً صریح نیست |
| هدف مطالعه | شناخت عملکرد دستگاه عصبی | حل مسائل محاسباتی و دادهمحور |
این مقایسه یک نتیجه روششناختی مهم دارد: شباهت نامها نباید باعث یکسان فرض کردن سازوکارها شود. برای مثال، وزن در یک مدل مصنوعی فقط ضریبی عددی در یک تابع است؛ درحالیکه قدرت اثر یک ارتباط سیناپسی، پدیدهای زیستی با عوامل متعدد است.
۲.۷. فعالیت کاربردی: ساخت واحدهای منطقی و بررسی محدودیتهای آنها
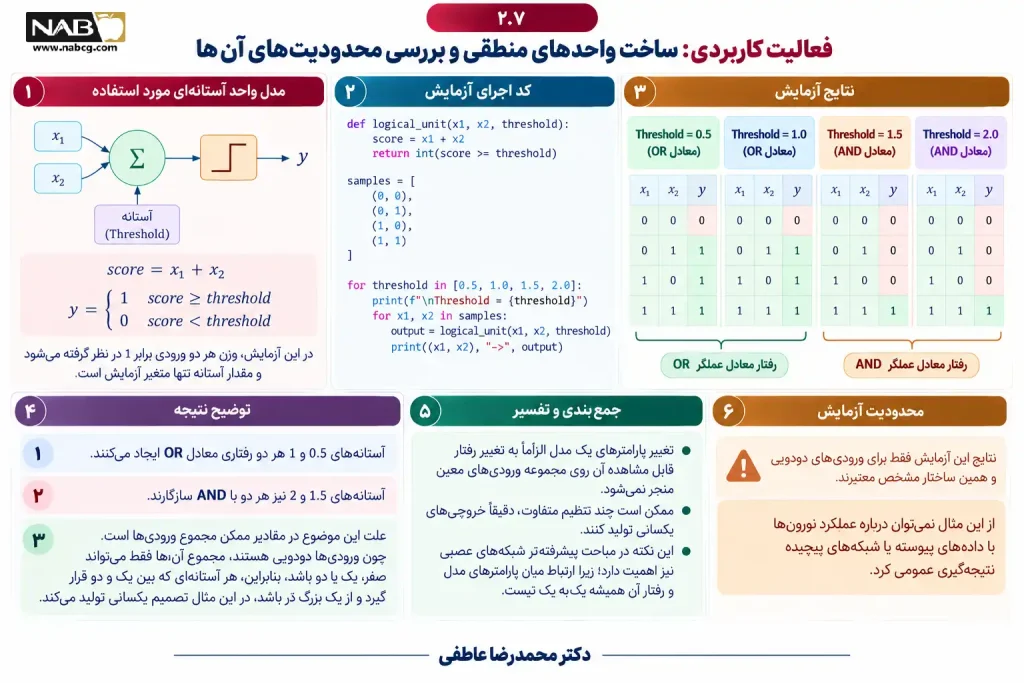
برای تثبیت مطالب این بخش، یک آزمایش کوچک طراحی میکنیم که در آن واحد آستانهای بتواند دو عملگر منطقی AND و OR را تولید کند.
آزمایش ۲.۱ — اثر آستانه بر رفتار یک واحد محاسباتی
پرسش علمی آزمایش این است که آیا تغییر آستانه، بدون تغییر ورودیها یا الگوریتم محاسبه، میتواند نوع تصمیم منطقی را تغییر دهد؟
دادههای آزمایش شامل چهار ترکیب دودویی ممکن برای دو ورودی است. وزن هر ورودی برابر یک در نظر گرفته میشود و مقدار آستانه، تنها متغیر آزمایش خواهد بود.
کد زیر مدل را برای چند آستانه مختلف اجرا میکند:
def logical_unit(x1, x2, threshold):
    score = x1 + x2
    return int(score >= threshold)

samples = [
    (0, 0),
    (0, 1),
    (1, 0),
    (1, 1)
]

for threshold in [0.5, 1.0, 1.5, 2.0]:
    print(f"nThreshold = {threshold}")

    for x1, x2 in samples:
        output = logical_unit(x1, x2, threshold)
        print((x1, x2), "->", output)
آستانه ۰٫۵ و ۱ هر دو رفتاری معادل OR ایجاد میکنند. آستانه ۱٫۵ و ۲ نیز هر دو با AND سازگارند.
علت این موضوع را باید در مقادیر ممکن مجموع ورودیها جستوجو کرد. چون ورودیها دودویی هستند، مجموع آنها فقط میتواند صفر، یک یا دو باشد. بنابراین، هر دو آستانهای که بین یک و دو قرار گیرند و از یک بزرگتر باشند، در این مثال تصمیم یکسانی تولید میکنند.
تفسیر نتیجه: تغییر پارامترهای یک مدل الزاماً به تغییر رفتار قابل مشاهده آن روی مجموعه ورودیهای معین منجر نمیشود. ممکن است چند تنظیم متفاوت، دقیقاً خروجیهای یکسانی تولید کنند.
این نکته در مباحث پیشرفتهتر شبکههای عصبی نیز اهمیت دارد؛ زیرا ارتباط میان پارامترهای مدل و رفتار آن همیشه یکبهیک نیست.
محدودیت آزمایش: نتایج فقط برای ورودیهای دودویی و همین ساختار مشخص معتبرند. از این مثال نمیتوان درباره عملکرد نورونها با دادههای پیوسته یا شبکههای پیچیده نتیجهگیری عمومی کرد.
۲.۸. تمرینهای پایان بخش
تمرین ۲.۱ — درک ساختاری
نورون زیستی و نورون مصنوعی را از نظر نوع ورودی، سازوکار پردازش و ماهیت خروجی مقایسه کنید. سپس توضیح دهید چرا عبارت «نورون مصنوعی شبیهسازی کامل نورون مغز است» از نظر علمی دقیق نیست.
تمرین ۲.۲ — محاسبه آستانهای
یک واحد دارای دو ورودی دودویی با مجموع (x1+x2) است. خروجی زمانی یک میشود که مجموع دستکم برابر آستانه باشد. برای آستانههای ۰، ۱، ۱٫۵، ۲ و ۳، جدول خروجیهای چهار حالت ممکن را تشکیل دهید و رفتار هر حالت را تفسیر کنید.
تمرین ۲.۳ — تحلیل وزنها
برای نورونی با دو ورودی، وزنهای (w1=3) و (w2=-2) انتخاب شدهاند. مقدار جمع وزندار را برای نمونههای ((1,1))، ((0,1))، ((1,0)) و ((0,0)) محاسبه کنید. سپس اثر منفی بودن وزن دوم را توضیح دهید.
تمرین ۲.۴ — بررسی بایاس
در معادله (z=2x1+3x2+b)، مقدار ورودیها برابر (x1=0.5) و (x2=0.8) است. مقدار (z) را برای بایاسهای منفی ۲، صفر و مثبت ۲ محاسبه کنید. آیا تغییر بایاس باعث تغییر سهم نسبی حاصلضرب وزن و هر ورودی میشود؟
تمرین ۲.۵ — برنامهنویسی
برنامه آزمایش ۲.۱ را توسعه دهید تا کاربر بتواند وزن هر ورودی و مقدار آستانه را تعیین کند. برنامه باید جدول خروجی همه ترکیبهای دودویی را تولید کند. برای جلوگیری از اشتباه، باید معتبر بودن ورودیهای صفر و یک را نیز بررسی کند.
تمرین ۲.۶ — تفکر انتقادی
فرض کنید پژوهشگری ادعا میکند چون نورون مصنوعی از نورون زیستی الهام گرفته است، هر نتیجهای درباره عملکرد یک شبکه عصبی مصنوعی را میتوان به مغز انسان تعمیم داد. توضیح دهید این استدلال چه اشکالی دارد و برای اعتباربخشی به چنین تعمیمی به چه نوع شواهد مستقلی نیاز است.
2.9. مطالعات موردی کاربردی با دادههای واقعی
پیشنیاز اجرای کدها:
pip install numpy matplotlib scikit-learnنکته روششناختی: دادههای مطالعات موردی واقعیاند، ولی وزنها و آستانهها صرفاً برای نمایش مفهوم، دستی انتخاب شدهاند؛ هیچ فرایند آموزش خودکار در این درس اجرا نمیشود.
مطالعه موردی: بررسی ترکیب شیمیایی نمونههای واقعی نوشیدنی
معرفی مسئله
آیا دو ویژگی اندازهگیریشده، الکل و شدت رنگ، میتوانند یک امتیاز آستانهای برای تفکیک گروه صفر از دو گروه دیگر بسازند؟
این دیتاست شیمیایی با ۱۷۸ مشاهده و ۱۳ ویژگی از UCI در کتابخانه scikit-learn موجود است.
برچسب گروه صرفاً برای مقایسه خروجی استفاده میشود؛ هیچ مدلی آموزش داده نشده است.
منبع مستقیم دیتاست:
Wine Dataset – UCI Machine Learning Repository
معرفی دادهها و محاسبه
پس از مقیاسبندی دو ویژگی، امتیاز زیر را محاسبه میکنیم:
و آن را با آستانه ۰٫۵۰ مقایسه میکنیم.
گروه صفر را مثبت تعریف میکنیم؛ این انتخاب صرفاً قراردادی است.
کد کامل پایتون
import numpy as np
from sklearn.preprocessing import MinMaxScaler
from sklearn.metrics import accuracy_score, confusion_matrix

def report(y, predicted):
    print('samples:',len(y))
    print('actual positives:',int(y.sum()))
    print('predicted positives:',int(predicted.sum()))
    print('accuracy:',round(accuracy_score(y,predicted),4))
    print('confusion matrix:',confusion_matrix(y,predicted,labels=[0,1]).tolist())
from sklearn.datasets import load_wine
D=load_wine()
idx=[list(D.feature_names).index('alcohol'),list(D.feature_names).index('color_intensity')]
X=MinMaxScaler().fit_transform(D.data[:,idx])
y=(D.target==0).astype(int)
score=0.55*X[:,0]+0.45*X[:,1]
predicted=(score>=0.50).astype(int)
report(y,predicted)
print('first scores:',np.round(score[:5],3).tolist())
خروجی:
samples: 178
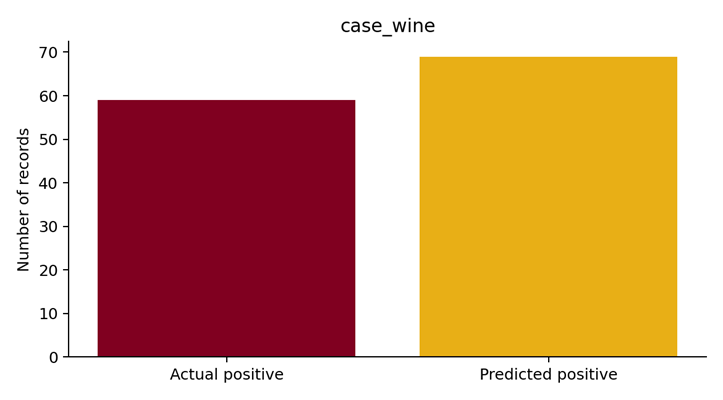
actual positives: 59
predicted positives: 69
accuracy: 0.7416
confusion matrix: [[91, 28], [18, 41]]
first scores: [0.631, 0.433, 0.477, 0.734, 0.437]
تفسیر نتایج
۴۱ مورد از ۵۹ نمونه گروه هدف درست شناسایی شدهاند؛ ۱۸ مورد از دست رفته و ۲۸ مورد از گروههای دیگر به اشتباه مثبت شدهاند.
مثال نشان میدهد ترکیب ویژگیها و انتخاب آستانه چگونه تصمیم را تعیین میکند؛ اما انتخاب دستی وزنها لزوماً با الگوی واقعی دادهها هماهنگ نیست.
مطالعه موردی: شناسایی رقم ۱ در تصاویر دستنویس
معرفی مسئله
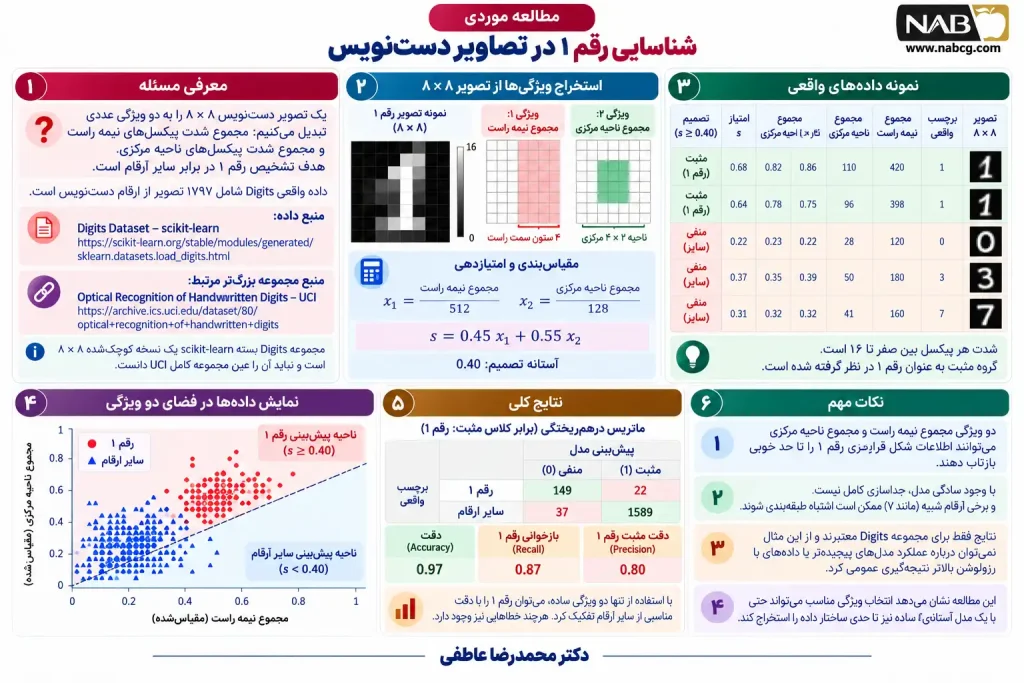
یک تصویر دستنویس ۸×۸ را به دو ویژگی عددی تبدیل میکنیم:
- مجموع شدت پیکسلهای نیمه راست
- مجموع شدت پیکسلهای ناحیه مرکزی
هدف تشخیص رقم ۱ در برابر سایر ارقام است. داده واقعی Digits شامل ۱۷۹۷ تصویر از ارقام دستنویس است.
منبع داده:
منبع مجموعه بزرگتر مرتبط:
Optical Recognition of Handwritten Digits – UCI
معرفی دادهها و محاسبات
مجموعه Digits بسته scikit-learn یک نسخه کوچکشده ۸×۸ است و نباید آن را عین مجموعه کامل UCI دانست.
شدت هر پیکسل بین صفر تا ۱۶ است.
برای مقیاسبندی، مجموع نیمه راست را بر ۵۱۲ و مجموع ناحیه ۴×۲ مرکزی را بر ۱۲۸ تقسیم میکنیم.
تابع امتیازدهی به شکل زیر است:
و آستانه تصمیم ۰٫۴۰ در نظر گرفته میشود.
کد کامل پایتون
import numpy as np
from sklearn.preprocessing import MinMaxScaler
from sklearn.metrics import accuracy_score, confusion_matrix

def report(y, predicted):
    print('samples:',len(y))
    print('actual positives:',int(y.sum()))
    print('predicted positives:',int(predicted.sum()))
    print('accuracy:',round(accuracy_score(y,predicted),4))
    print('confusion matrix:',confusion_matrix(y,predicted,labels=[0,1]).tolist())
from sklearn.datasets import load_digits
D=load_digits()
images=D.images
X=np.column_stack((images[:,:,4:].sum(axis=(1,2))/512,
                   images[:,2:6,3:5].sum(axis=(1,2))/128))
y=(D.target==1).astype(int)
score=0.45*X[:,0]+0.55*X[:,1]
predicted=(score>=0.40).astype(int)
report(y,predicted)
print('first scores:',np.round(score[:5],3).tolist())
خروجی
samples: 1797
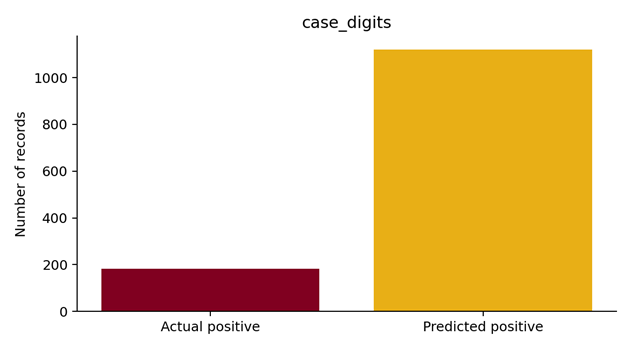
actual positives: 182
predicted positives: 1121
accuracy: 0.4719
confusion matrix: [[671, 944], [5, 177]]
first scores: [0.139, 0.697, 0.562, 0.417, 0.439]
تفسیر نتایج
با وجود شناسایی ۱۷۷ نمونه از ۱۸۲ رقم ۱، مدل ۹۴۴ رقم دیگر را به اشتباه ۱ تشخیص داده است.
این نتیجه ملموس نشان میدهد که دو ویژگی ساده برای مسئله پیچیده تشخیص تصویر کافی نیستند.
هدف این مطالعه نشان دادن محدودیت نمایش ویژگی و واحد آستانهای است، نه ساخت سامانه تشخیص رقم قابل اتکا.
جمعبندی نهایی
در این دو بخش آموختیم که تصمیم را میتوان با تعریف ورودیهای عددی، ترکیب آنها و اعمال یک آستانه به محاسبه تبدیل کرد. همچنین روشن شد که نورون مصنوعی تنها از برخی اصول پردازش اطلاعات در نورون زیستی الهام میگیرد و بازسازی کامل آن نیست.
مثالهای عددی و سه مجموعهداده واقعی نشان دادند که وزنها، آستانه و انتخاب ویژگیها بر خروجی اثر میگذارند؛ اما محاسبه خروجی با یادگیری خودکار تفاوت دارد.
در بخشهای بعدی، اجزای نورون و روشهای دقیقتر نمایش ورودیها بررسی خواهند شد.
یادداشت روششناختی: تمامی خروجیهای عددی مطالعات موردی با اجرای کد روی دادههای بسته scikit-learn محاسبه شدهاند. این محاسبات توصیفی و دروننمونهای هستند و نباید بهعنوان برآورد عملکرد تعمیمیافته مدل معرفی شوند.