1. از اطلاعات دنیای واقعی تا ورودیهای عددی نورون مصنوعی
در بخش قبلی، منشأ تاریخی نورون مصنوعی را بررسی کردیم و دیدیم چگونه تلاش برای مدلسازی برخی جنبههای فعالیت عصبی به پیدایش واحدهای محاسباتی ساده منجر شد. همچنین نشان دادیم که با اختصاص وزنهای متفاوت به ورودیها و افزودن بایاس، میتوان انعطافپذیری یک واحد محاسباتی را افزایش داد.
اکنون نوبت به پرسشی میرسد که در طراحی واقعی شبکههای عصبی، پیش از انتخاب وزنها، بایاس یا تابع فعالسازی مطرح میشود: اطلاعاتی که میخواهیم مدل پردازش کند، چگونه به ورودیهای عددی مناسب تبدیل میشوند؟
این پرسش بسیار بنیادیتر از آن است که در نگاه نخست به نظر میرسد. یک نورون مصنوعی مستقیماً با مفاهیمی مانند سن، تصویر، رضایت مشتری، دمای دستگاه، کیفیت محصول یا وضعیت سلامت سروکار ندارد. آنچه نورون دریافت میکند، مجموعهای از مقادیر عددی است که برای نمایش ویژگیهای مسئله انتخاب شدهاند.
بنابراین، پیش از طراحی نورون باید مشخص شود چه اطلاعاتی در اختیار داریم، هر مقدار عددی نماینده چه ویژگیای است، مقیاس اندازهگیری آن چیست و چگونه باید مجموعه ویژگیها را با ساختاری منظم به مدل ارائه کرد.
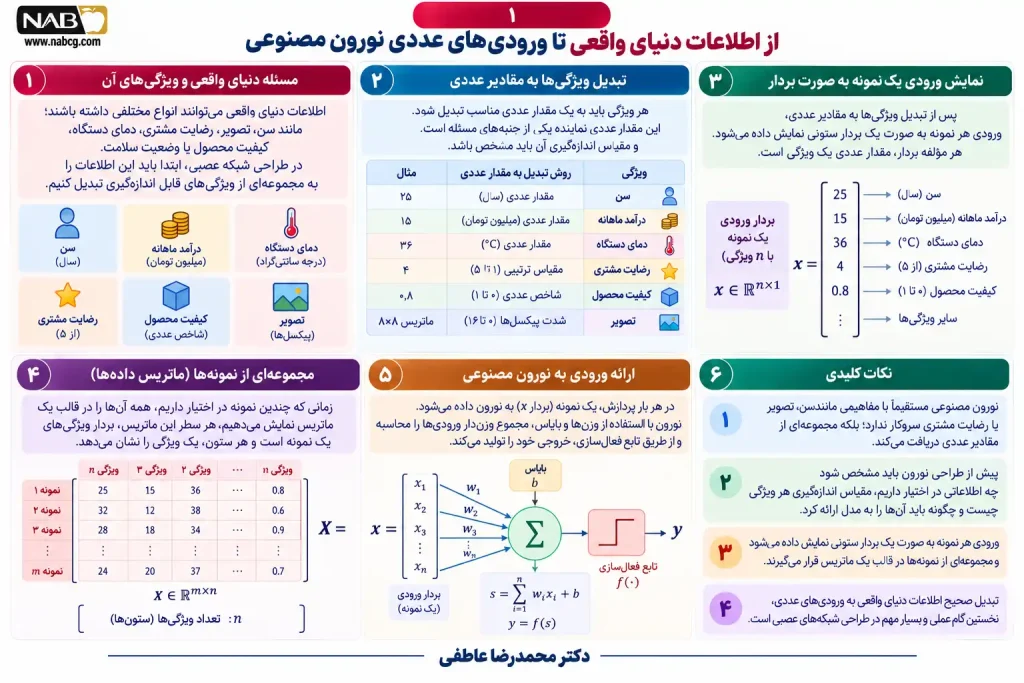
این بخش، نخستین گام عملی در مسیر طراحی شبکه عصبی است. در پایان آن، خواننده قادر خواهد بود یک مسئله واقعی را به مجموعهای از نمونهها و ویژگیهای عددی تبدیل کند، ورودیهای یک نورون را بهصورت برداری نمایش دهد و تفاوت میان پردازش یک نمونه و پردازش مجموعهای از نمونهها را درک کند.
1.۱. چرا نورون مصنوعی به ورودی عددی نیاز دارد؟
برای پاسخ، به ساختار محاسباتی نورون بازمیگردیم. در بخش قبل، رابطه زیر را معرفی کردیم:
در این رابطه، مقادیر (x1) و (x2) ورودیها هستند. عملیات ضرب و جمع زمانی معنای ریاضی مشخصی دارند که ورودیها و وزنها در یک فضای عددی مناسب تعریف شده باشند.
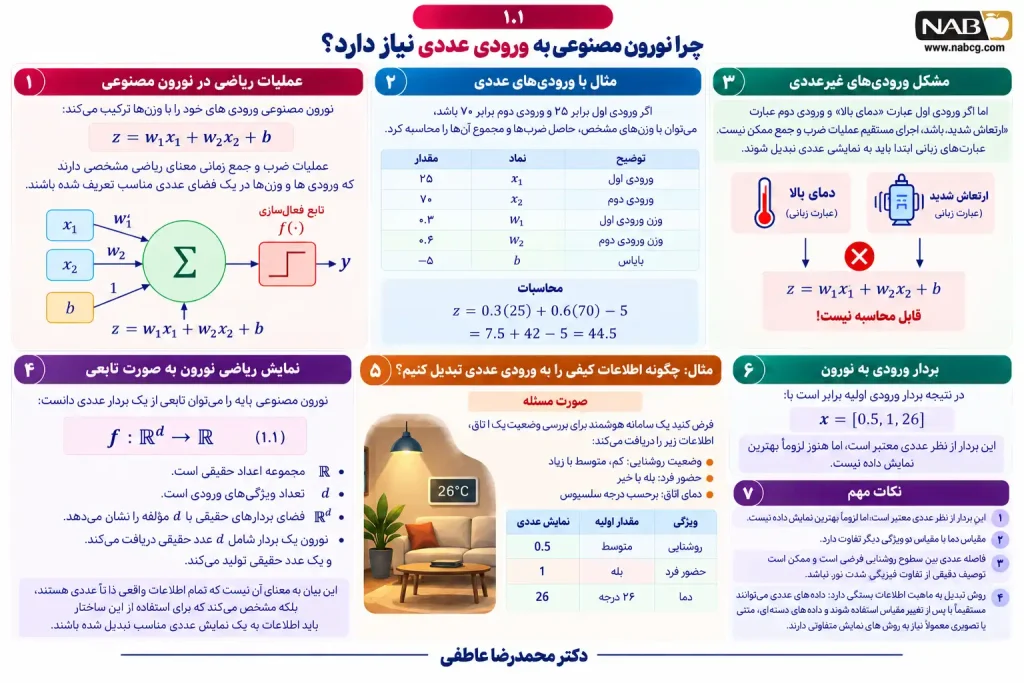
برای مثال، اگر ورودی اول برابر ۲۵ و ورودی دوم برابر ۷۰ باشد، میتوان با وزنهای مشخص، حاصلضربها و مجموع آنها را محاسبه کرد.
اما اگر ورودی اول عبارت «دمای بالا» و ورودی دوم عبارت «ارتعاش شدید» باشد، اجرای مستقیم همان عملیات ممکن نیست. عبارتهای زبانی ابتدا باید به نمایشی عددی تبدیل شوند.
این تبدیل، یکی از بخشهای مهم آمادهسازی داده (Data Preparation) است. روش تبدیل به ماهیت اطلاعات بستگی دارد؛ برای مثال، دادههای عددی میتوانند مستقیماً یا پس از تغییر مقیاس استفاده شوند، درحالیکه دادههای دستهای، متنی یا تصویری معمولاً به روشهای نمایش متفاوتی نیاز دارند (Bishop, 2006; Goodfellow et al., 2016).
از نظر ریاضی، نورون مصنوعی پایه را میتوان تابعی از یک بردار عددی دانست:
در معادله ۱.۱، نماد ℝ مجموعه اعداد حقیقی و d تعداد ویژگیهای ورودی است. مجموعه ℝ^d فضای بردارهای حقیقی با d مؤلفه را نشان میدهد. بنابراین، در سادهترین حالت مورد مطالعه ما، نورون یک بردار شامل d عدد حقیقی دریافت میکند و یک عدد حقیقی تولید میکند.
این بیان به معنای آن نیست که تمام اطلاعات واقعی ذاتاً عددی هستند. بلکه مشخص میکند که برای استفاده از یک نورون با این ساختار، باید اطلاعات موردنظر به یک نمایش عددی مناسب تبدیل شده باشند.
برای مثال، نام یک شهر، نوع دستگاه صنعتی یا رشته متنی یک نظر مشتری، خودشان اعداد حقیقی نیستند. این دادهها میتوانند پس از یک فرایند رمزگذاری یا استخراج ویژگی به ورودی مدل تبدیل شوند. روشهای تخصصی نمایش متن، تصویر و دادههای پیچیده در فصلهای مربوط به معماریهای پیشرفته بررسی خواهند شد.
مثال:چگونه اطلاعات کیفی را به ورودی عددی تبدیل کنیم؟
صورت مسئله
فرض کنید یک سامانه هوشمند برای بررسی وضعیت یک اتاق، اطلاعات زیر را دریافت میکند:
- وضعیت روشنایی: کم، متوسط یا زیاد
- حضور فرد: بله یا خیر
- دمای اتاق: برحسب درجه سلسیوس
نورون مصنوعی نمیتواند عبارتهایی مانند «کم» یا «بله» را مستقیماً در یک رابطه ریاضی ضرب کند. بنابراین لازم است اطلاعات به شکلی عددی نمایش داده شوند.
برای یک نمایش آموزشی ساده، میتوان وضعیت روشنایی را با صفر، ۰٫۵ و یک و وضعیت حضور را با صفر یا یک نشان داد.
| ویژگی | مقدار اولیه | نمایش عددی |
| روشنایی | متوسط | ۰٫۵ |
| حضور فرد | بله | ۱ |
| دما | ۲۶ درجه | ۲۶ |
در نتیجه بردار ورودی اولیه برابر است با:
این بردار از نظر عددی معتبر است، اما هنوز لزوماً بهترین نمایش داده نیست. برای مثال، مقیاس دما با مقیاس دو ویژگی دیگر تفاوت دارد. همچنین فاصله عددی بین سطوح روشنایی فرضی است و ممکن است توصیف دقیقی از تفاوت فیزیکی شدت نور نباشد.
کد پایتون
light_map = {
    "low": 0.0,
    "medium": 0.5,
    "high": 1.0
}

presence_map = {
    "no": 0,
    "yes": 1
}

light = "medium"
presence = "yes"
temperature = 26

features = [
    light_map[light],
    presence_map[presence],
    temperature
]

print("Numeric input:", features)
print("Number of features:", len(features))
خروجی
Numeric input: [0.5, 1, 26]
Number of features: 3
تفسیر آموزشی
خروجی نشان میدهد یک نمونه که ابتدا شامل اطلاعات کیفی و عددی بود، اکنون در قالب سه مقدار عددی قابل نمایش است. بااینحال، عددیشدن داده فقط شرط اولیه ورود به نورون است. انتخاب روش رمزگذاری و حفظ معنای ویژگیها نیز اهمیت دارد.
در بخش 1.۴ خواهیم دید که برای دستههایی که ترتیب طبیعی ندارند، روشهایی مانند رمزگذاری وانهات اغلب مناسبتر از اختصاص مستقیم اعداد ترتیبی هستند.
1.۱.۱. آیا هر عددی میتواند ورودی مناسبی باشد؟
از نظر محاسباتی، تقریباً هر مقدار حقیقی متناهی را میتوان به یک نورون پایه ارائه کرد. اما امکان انجام محاسبه به معنای مناسب بودن داده نیست.
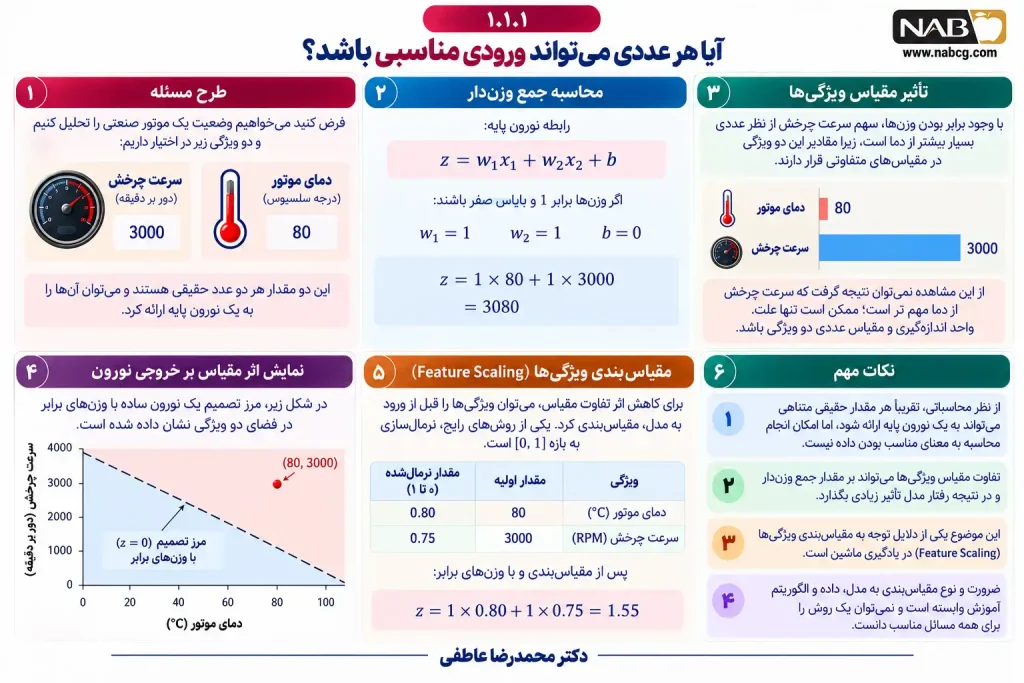
فرض کنید میخواهیم وضعیت یک موتور صنعتی را تحلیل کنیم و دو ویژگی در اختیار داریم: دمای موتور برحسب درجه سلسیوس و سرعت چرخش برحسب دور بر دقیقه.
اگر مقدار دما ۸۰ و مقدار سرعت چرخش ۳۰۰۰ باشد، تفاوت مقیاس این دو ویژگی ممکن است بر مقدار جمع وزندار تأثیر زیادی بگذارد. برای مثال، اگر وزن هر دو ویژگی برابر یک باشد، سهم سرعت چرخش از نظر عددی بسیار بیشتر خواهد بود.
اما از این مشاهده نمیتوان نتیجه گرفت که سرعت چرخش از دما مهمتر است. ممکن است تنها علت تفاوت، واحد اندازهگیری و مقیاس عددی دو ویژگی باشد.
این مسئله یکی از دلایلی است که در یادگیری ماشین، به مقیاسبندی ویژگیها (Feature Scaling) توجه میشود. البته ضرورت و نوع مقیاسبندی به مدل، داده و الگوریتم آموزش وابسته است و نمیتوان یک روش را برای همه مسائل مناسب دانست (Hastie et al., 2009).
در این فصل، هدف اصلی شناخت ساختار ورودی است؛ روشهای پیشپردازش پیشرفتهتر در مباحث آمادهسازی داده و آموزش مدل توسعه خواهند یافت.
مثال:چرا تفاوت مقیاس ویژگیها اهمیت دارد؟
صورت مسئله
فرض کنید دو ویژگی از یک دستگاه اندازهگیری شدهاند:
- دما: ۸۰ درجه سلسیوس
- سرعت چرخش: ۳۰۰۰ دور بر دقیقه
در یک محاسبه اولیه، وزن هر دو ویژگی را برابر یک در نظر میگیریم:
بنابراین:
سهم عددی سرعت چرخش بسیار بزرگتر است؛ اما این موضوع ثابت نمیکند که سرعت چرخش از نظر فیزیکی مهمتر از دماست.
اکنون فقط برای نمایش مفهوم، هر ویژگی را بر یک مقدار مرجع مشخص تقسیم میکنیم:
مجموع جدید برابر میشود با:
مقادیر مرجع ۱۰۰ و ۵۰۰۰ صرفاً فرضهای آموزشی هستند، نه محدوده استاندارد یک دستگاه واقعی.
کد پایتون
temperature = 80
speed = 3000

raw_score = temperature + speed

temperature_scaled = temperature / 100
speed_scaled = speed / 5000

scaled_score = temperature_scaled + speed_scaled

print("Raw score:", raw_score)
print("Scaled temperature:", temperature_scaled)
print("Scaled speed:", speed_scaled)
print("Scaled score:", round(scaled_score, 2))
خروجی
Raw score: 3080
Scaled temperature: 0.8
Scaled speed: 0.6
Scaled score: 1.4
نتیجه
تغییر مقیاس میتواند سهم عددی ویژگیها را بهشدت تغییر دهد. بنابراین، هنگام تفسیر ورودیهای یک نورون، باید واحد اندازهگیری، دامنه داده و نحوه مقیاسبندی مشخص باشند.
نکته مهمتر اینکه اگر وزنهای مدل از قبل تعیین شده باشند، تغییر مقیاس ورودیها بدون تنظیم متناسب وزنها میتواند معنای محاسبه را تغییر دهد.
1.۲. تفاوت نمونه، ویژگی و مجموعه داده
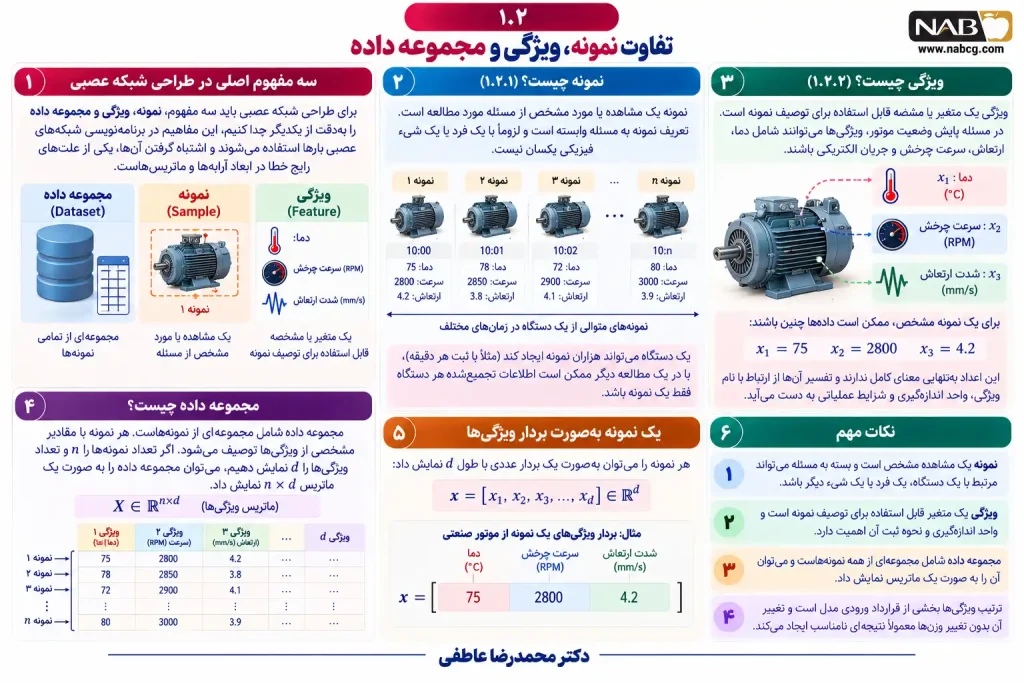
برای طراحی شبکه عصبی باید سه مفهوم را بهدقت از یکدیگر جدا کنیم: نمونه (Sample)، ویژگی (Feature) و مجموعه داده (Dataset) .
این مفاهیم در برنامهنویسی شبکههای عصبی بارها استفاده میشوند و اشتباه گرفتن آنها، یکی از علتهای رایج خطا در ابعاد آرایهها و ماتریسهاست.
1.۲.۱. نمونه چیست؟
نمونه یک مشاهده یا مورد مشخص از مسئله مورد مطالعه است.
اگر هدف تحلیل وضعیت دستگاههای صنعتی باشد، هر مشاهده ثبتشده از وضعیت یک دستگاه در یک زمان معین میتواند یک نمونه باشد. اگر هدف پیشبینی قیمت مسکن باشد، اطلاعات مربوط به هر واحد مسکونی ممکن است یک نمونه را تشکیل دهد. در مسئله تشخیص نوع گل، اندازهگیریهای یک گل، یک نمونه محسوب میشود.
بنابراین، نمونه را نباید الزاماً با یک فرد یا یک شیء فیزیکی یکسان دانست. تعریف نمونه به مسئله وابسته است.
برای مثال، اگر دادهها هر دقیقه از یک دستگاه ثبت شوند، یک دستگاه میتواند هزاران نمونه ایجاد کند. در مقابل، در یک مطالعه دیگر ممکن است اطلاعات تجمیعشده هر دستگاه فقط یک نمونه باشد.
این تفاوت در مراحل بعد، بهویژه هنگام تقسیم دادههای آموزشی و آزمون، اهمیت خواهد داشت؛ زیرا مشاهدههای مربوط به یک دستگاه یا یک فرد ممکن است مستقل از یکدیگر نباشند.
1.۲.۲. ویژگی چیست؟
ویژگی یک متغیر یا مشخصه قابل استفاده برای توصیف نمونه است.
در مسئله پایش وضعیت موتور، ویژگیها میتوانند دما، ارتعاش، سرعت چرخش و جریان الکتریکی باشند. هر نمونه با مقادیر مشخصی از این ویژگیها توصیف میشود.
فرض کنید برای هر موتور سه ویژگی زیر ثبت شده باشد:
- (x1) : دما برحسب درجه سلسیوس
- (x2) : سرعت چرخش برحسب دور بر دقیقه
- (x3) : شدت ارتعاش برحسب یک واحد اندازهگیری تعریفشده
در این حالت، هر نمونه سه مقدار ورودی دارد.
برای نمونهای مشخص، ممکن است دادهها چنین باشند:
این اعداد بهتنهایی معنای کامل ندارند. معنای آنها از ارتباط با نام ویژگی، واحد اندازهگیری، روش ثبت و شرایط عملیاتی به دست میآید.
اگر ترتیب ویژگیها تغییر کند اما وزنهای مدل مطابق ترتیب قبلی باقی بمانند، محاسبه از نظر نحوی همچنان قابل انجام است، ولی نتیجه معمولاً دیگر معنای موردنظر را نخواهد داشت.
ازاینرو، ترتیب ویژگیها بخشی از قرارداد ورودی مدل است.
1.۲.۳. مجموعه داده چیست؟
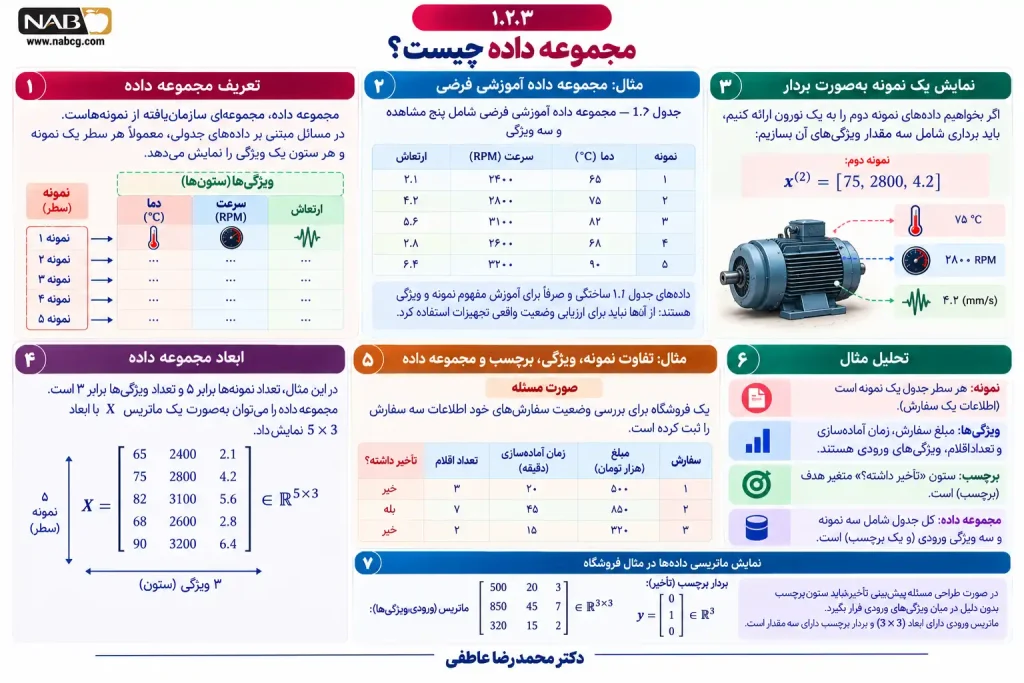
مجموعه داده، مجموعهای سازمانیافته از نمونههاست.
در مسائل مبتنی بر دادههای جدولی، معمولاً هر سطر یک نمونه و هر ستون یک ویژگی را نمایش میدهد.
فرض کنید پنج مشاهده از وضعیت یک موتور ثبت کردهایم.
جدول 1.۱ — مجموعه داده آموزشی فرضی شامل پنج مشاهده و سه ویژگی
| نمونه | دما (°C) | سرعت (RPM) | ارتعاش |
| ۱ | ۶۵ | ۲۴۰۰ | ۲٫۱ |
| ۲ | ۷۵ | ۲۸۰۰ | ۴٫۲ |
| ۳ | ۸۲ | ۳۱۰۰ | ۵٫۶ |
| ۴ | ۶۸ | ۲۶۰۰ | ۲٫۸ |
| ۵ | ۹۰ | ۳۲۰۰ | ۶٫۴ |
دادههای جدول 1.۱ ساختگی و صرفاً برای آموزش مفهوم نمونه و ویژگی هستند؛ از آنها نباید برای ارزیابی وضعیت واقعی تجهیزات استفاده کرد.
در این جدول، تعداد نمونهها برابر پنج و تعداد ویژگیها برابر سه است.
اگر بخواهیم دادههای نمونه دوم را به یک نورون ارائه کنیم، باید برداری شامل سه مقدار ۷۵، ۲۸۰۰ و ۴٫۲ بسازیم.
اما اگر هدف پردازش همه نمونهها باشد، به ساختاری نیاز خواهیم داشت که بتواند هر پنج بردار ورودی را نگهداری کند.
این ساختار، ماتریس داده است که در بخشهای بعد معرفی خواهد شد.
مثال: تفاوت نمونه، ویژگی، برچسب و مجموعه داده
صورت مسئله
یک فروشگاه برای بررسی وضعیت سفارشهای خود اطلاعات سه سفارش را ثبت کرده است.
| سفارش | مبلغ (هزار تومان) | زمان آمادهسازی (دقیقه) | تعداد اقلام | تأخیر داشته؟ |
| ۱ | ۵۰۰ | ۲۰ | ۳ | خیر |
| ۲ | ۸۵۰ | ۴۵ | ۷ | بله |
| ۳ | ۳۲۰ | ۱۵ | ۲ | خیر |
در این مثال، هر سطر یک نمونه است. مبلغ سفارش، زمان آمادهسازی و تعداد اقلام، ویژگیهای ورودی هستند. ستون تأخیر نیز برچسب یا متغیر هدف است و در صورت طراحی مسئله پیشبینی تأخیر، نباید بدون دلیل در میان ویژگیهای ورودی قرار بگیرد.
ماتریس ورودی دارای ابعاد (3˟3) و بردار برچسب دارای سه مقدار است.
کد پایتون
import numpy as np

X = np.array([
    [500, 20, 3],
    [850, 45, 7],
    [320, 15, 2]
])

y = np.array([0, 1, 0])

print("Input shape:", X.shape)
print("Target shape:", y.shape)
print("Second sample:", X[1].tolist())
print("Second target:", y[1])
خروجی
Input shape: (3, 3)
Target shape: (3,)
Second sample: [850, 45, 7]
Second target: 1
تفسیر
تفاوت ویژگی و برچسب در طراحی مدل اهمیت اساسی دارد. اگر هدف، پیشبینی تأخیر سفارش باشد، استفاده از نتیجه واقعی تأخیر بهعنوان یکی از ورودیهای پیشبینی میتواند به نشت اطلاعات منجر شود.
دادههای این مثال فرضی و صرفاً برای آموزش ساختار ماتریس و بردار هدف هستند.
1.۳. از چند متغیر مستقل تا یک بردار ورودی
در مثالهای قبلی، ورودیها را بهصورت متغیرهای جداگانه (x1)، (x2) و (x3) نوشتیم. این روش برای دو یا سه ویژگی خواناست، اما برای مدلهایی با صدها یا هزاران ورودی مناسب نیست.
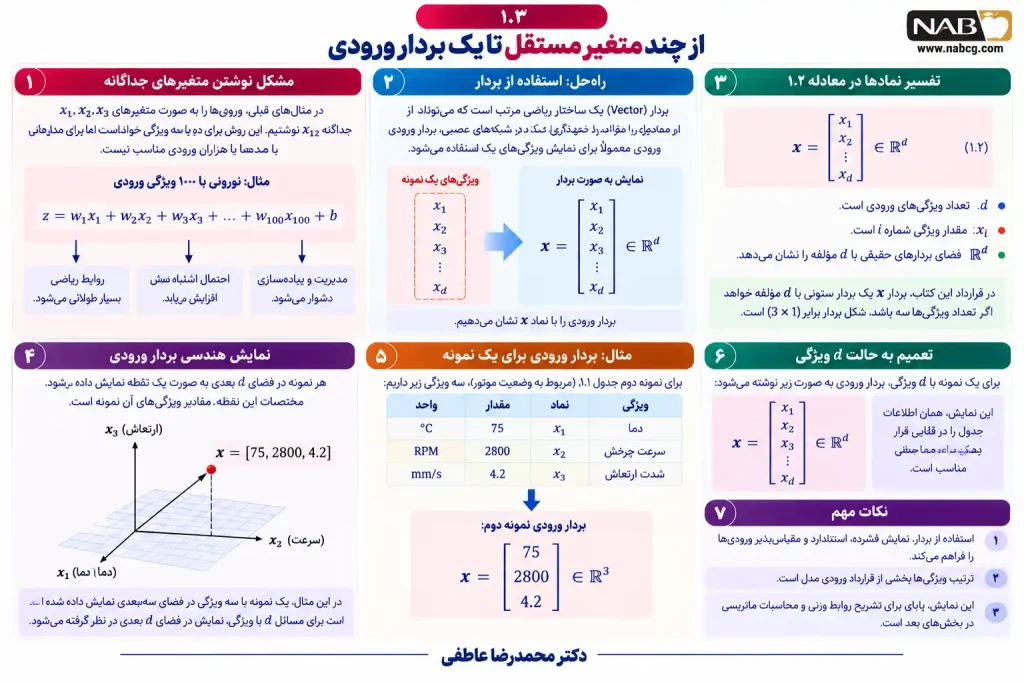
فرض کنید نورونی ۱۰۰ ویژگی ورودی داشته باشد. نوشتن تمام متغیرها بهصورت مستقل، هم روابط ریاضی را طولانی میکند و هم احتمال اشتباه را افزایش میدهد.
راهحل استاندارد، استفاده از بردار است.
بردار (Vector) یک ساختار ریاضی مرتب است که میتواند مجموعهای از مقادیر را در خود نگهداری کند. در شبکههای عصبی، بردار ورودی معمولاً برای نمایش ویژگیهای یک نمونه استفاده میشود.
بردار ورودی را با نماد 𝐱 نشان میدهیم:
در معادله 1.۲، (d) تعداد ویژگیها و (xi) مقدار ویژگی شماره (i) است. بردار (x) در قرارداد این کتاب، یک بردار ستونی با (d) مؤلفه خواهد بود.
اگر تعداد ویژگیها سه باشد، شکل بردار برابر (3˟1) است.
برای نمونه دوم جدول 1.۱، بردار ورودی چنین خواهد بود:
این نمایش، همان اطلاعات جدول را در قالبی قرار میدهد که برای محاسبات جبر خطی مناسب است.
1.۳.۱. چرا ترتیب مؤلفههای بردار مهم است؟
بردار ویژگیها یک مجموعه بدون ترتیب نیست. مؤلفه اول، دوم و سوم هرکدام معنای مشخصی دارند.
فرض کنید برای نمونه قبلی، ترتیب ویژگیها به شکل دما، سرعت و ارتعاش تعیین شده باشد. اگر بهاشتباه مقدار سرعت و دما جابهجا شوند، بردار جدید از نظر عددی معتبر است، اما معنای متفاوتی خواهد داشت.
برای مثال:
اگر وزن اول برای دما و وزن دوم برای سرعت طراحی شده باشد، استفاده از این بردار باعث میشود مقدار سرعت در وزن دما ضرب شود و برعکس.
بنابراین، اشتباه در ترتیب ویژگیها ممکن است بدون ایجاد هیچ خطای برنامهنویسی، خروجی نادرستی تولید کند.
این نوع خطا از نظر مهندسی خطرناک است؛ زیرا برنامه اجرا میشود، اما معنای محاسبه تغییر کرده است.
برای جلوگیری از چنین مشکلاتی، در سامانههای واقعی باید ساختار ورودی، نام ویژگیها، واحدها و ترتیب ستونها بهصورت روشن مستندسازی شود.
مثال آموزشی : چرا ترتیب ویژگیهای بردار ورودی باید ثابت بماند؟
صورت مسئله
فرض کنید یک مدل ساده برای بررسی وضعیت یک دستگاه، سه ویژگی را به ترتیب زیر دریافت میکند:
- دمای دستگاه
- شدت ارتعاش
- جریان الکتریکی
بردار ورودی برابر است با:
وزنهای متناظر را بهصورت آموزشی چنین انتخاب میکنیم:
مجموع وزندار برابر است با:
حال فرض کنید برنامهنویس بهاشتباه جای دما و ارتعاش را عوض کند، اما ترتیب وزنها را ثابت نگه دارد:
در این حالت:
خروجی جدید از نظر محاسباتی معتبر است، ولی معنای آن اشتباه است.
کد پایتون
import numpy as np

x = np.array([70, 4, 12], dtype=float)
weights = np.array([0.1, 2.0, 0.5])

correct_score = np.dot(x, weights)

wrong_x = np.array([4, 70, 12], dtype=float)
wrong_score = np.dot(wrong_x, weights)

print("Correct score:", correct_score)
print("Wrong score:", wrong_score)
print("Difference:", round(wrong_score - correct_score, 1))
خروجی:
Correct score: 21.0
Wrong score: 146.4
Difference: 125.4
تفسیر
برنامه بدون خطا اجرا میشود، اما عدد حاصل اشتباه است. بنابراین کنترل تعداد ستونها بهتنهایی کافی نیست؛ نام ویژگیها و ترتیب آنها نیز باید کنترل شوند.
این خطا در کاربردهای واقعی خطرناک است، زیرا برخلاف خطاهای نحوی پایتون، ممکن است هیچ پیام هشداری تولید نکند.
1.۳.۲. بعد بردار و تعداد ورودیهای نورون
اگر نورونی دارای (d) ورودی باشد، بردار ورودی آن باید (d) مؤلفه داشته باشد.
این رابطه ساده در طراحی معماری شبکههای عصبی بسیار مهم است؛ زیرا تعداد ورودیهای هر نورون باید با ابعاد دادهای که دریافت میکند سازگار باشد.
برای مثال، اگر یک نورون برای دریافت چهار ویژگی طراحی شده باشد، نمیتوان بدون اصلاح مدل یا تبدیل داده، برداری با سه یا پنج ویژگی را به همان ساختار ارائه کرد.
در بخش پیادهسازی خواهیم دید که کتابخانه NumPy چگونه ابعاد آرایهها را نمایش میدهد و چگونه میتوان پیش از انجام محاسبه، سازگاری آنها را بررسی کرد.
مثال :اعتبارسنجی تعداد ورودیهای نورون
صورت مسئله
نورونی طراحی شده که دقیقاً چهار ویژگی دریافت میکند. اگر کاربر بهاشتباه تنها سه ویژگی وارد کند، محاسبه مورد انتظار نباید انجام شود.
برای جلوگیری از این مشکل، تابعی مینویسیم که ابتدا تعداد ویژگیها را بررسی کند.
کد پایتون
import numpy as np

def validate_features(x, expected=4):
    x = np.asarray(x, dtype=float)

    if x.ndim != 1:
        raise ValueError("Input must be one-dimensional")

    if len(x) != expected:
        raise ValueError(
            f"Expected {expected} features, received {len(x)}"
        )

    return x

valid = [12, 5, 8, 3]
invalid = [12, 5, 8]

print("Valid input:", validate_features(valid).tolist())

try:
    validate_features(invalid)
except ValueError as error:
    print("Error:", error)
خروجی:
Valid input: [12.0, 5.0, 8.0, 3.0]
Error: Expected 4 features, received 3
تفسیر
این تابع از اجرای محاسبه با تعداد نادرست ویژگیها جلوگیری میکند. بااینحال، هنوز نوع معنایی هر ویژگی را تشخیص نمیدهد؛ برای مثال نمیتواند بفهمد مقدار دما در ستون سرعت وارد شده است.
برای کنترل چنین خطاهایی، اعتبارسنجی ساختار داده باید در مراحل بعد کاملتر شود.
1.۴. تفاوت دادههای عددی، دودویی و دستهای در طراحی ورودی
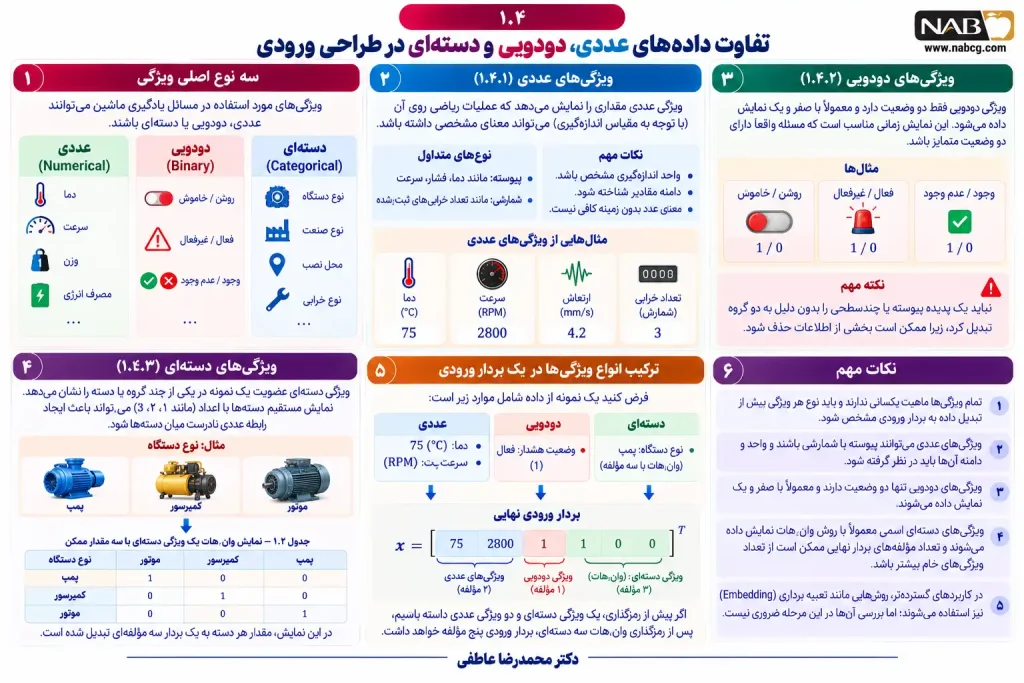
تمام ویژگیها ماهیت یکسانی ندارند. پیش از تبدیل داده به بردار ورودی، باید نوع هر ویژگی را مشخص کنیم.
در یک تقسیمبندی مقدماتی، ویژگیهای مورد استفاده در مسائل یادگیری ماشین میتوانند عددی، دودویی یا دستهای باشند.
1.۴.۱. ویژگیهای عددی
ویژگی عددی مقداری را نمایش میدهد که عملیات ریاضی روی آن، با توجه به مقیاس اندازهگیری، میتواند معنای مشخصی داشته باشد.
دما، طول، وزن، سرعت و میزان مصرف انرژی از نمونههای متداول هستند.
البته حتی در میان ویژگیهای عددی نیز تفاوتهایی وجود دارد. بعضی ویژگیها شمارشیاند، مانند تعداد خرابیهای ثبتشده؛ بعضی دیگر پیوستهاند، مانند دما یا فشار.
در مدلسازی، باید واحد و دامنه مقدارها شناخته شود. برای مثال، عدد ۳۰ بدون مشخص بودن اینکه دمای سلسیوس، سرعت یا تعداد رخداد است، اطلاعات کافی برای تفسیر یک ویژگی فراهم نمیکند.
1.۴.۲. ویژگیهای دودویی
ویژگی دودویی فقط دو وضعیت دارد. معمولاً این وضعیتها با صفر و یک نمایش داده میشوند.
برای مثال، میتوان روشن یا خاموش بودن دستگاه، فعال یا غیرفعال بودن یک هشدار و وجود یا عدم وجود یک ویژگی مشخص را بهصورت دودویی ثبت کرد.
این نمایش زمانی مناسب است که مسئله واقعاً دارای دو وضعیت متمایز باشد.
اما نباید یک پدیده پیوسته یا چندسطحی را بدون دلیل به دو گروه تبدیل کرد. چنین تغییری ممکن است بخشی از اطلاعات موجود در داده را حذف کند.
1.۴.۳. ویژگیهای دستهای
ویژگی دستهای (Categorical Feature) عضویت یک نمونه در یکی از چند گروه یا دسته را نشان میدهد.
برای مثال، نوع دستگاه میتواند یکی از سه دسته پمپ، کمپرسور یا موتور باشد.
اگر این دستهها را با اعداد ۱، ۲ و ۳ نمایش دهیم و آن اعداد مستقیماً وارد یک نورون شوند، مدل رابطهای عددی میان دستهها فرض خواهد کرد.
درحالیکه ممکن است هیچ معنای واقعی برای بزرگتر بودن عدد ۳ نسبت به عدد ۱ وجود نداشته باشد.
برای ویژگیهای دستهای اسمی، یکی از روشهای متداول، رمزگذاری وان-هات (One-Hot Encoding) است. در این روش، برای هر دسته یک مؤلفه جداگانه در نظر گرفته میشود.
برای مثال:
| نوع دستگاه | پمپ | کمپرسور | موتور |
| پمپ | ۱ | ۰ | ۰ |
| کمپرسور | ۰ | ۱ | ۰ |
| موتور | ۰ | ۰ | ۱ |
جدول 1.۲ — نمایش وان-هات یک ویژگی دستهای با سه مقدار ممکن
در این نمایش، مقدار هر دسته به یک بردار سهمؤلفهای تبدیل شده است.
اگر پیش از رمزگذاری، یک ویژگی دستهای و دو ویژگی عددی داشته باشیم، پس از رمزگذاری وان-هات سهدستهای، بردار ورودی پنج مؤلفه خواهد داشت.
این مثال نشان میدهد که تعداد ویژگیهای خام لزوماً با تعداد مؤلفههای بردار نهایی ورودی برابر نیست.
در کاربردهای گستردهتر، روشهایی مانند تعبیه برداری (Embedding) نیز استفاده میشوند؛ اما بررسی آنها در این مرحله ضروری نیست.
مثال: رمزگذاری وانهات و افزایش تعداد ویژگیهای ورودی
صورت مسئله
فرض کنید در یک مرکز خدمات، سه نوع درخواست وجود دارد:
- تعمیر
- نصب
- بازدید
اگر این سه درخواست را مستقیماً با اعداد ۱، ۲ و ۳ نمایش دهیم، مدل ممکن است رابطه ترتیبی نامناسبی میان آنها فرض کند.
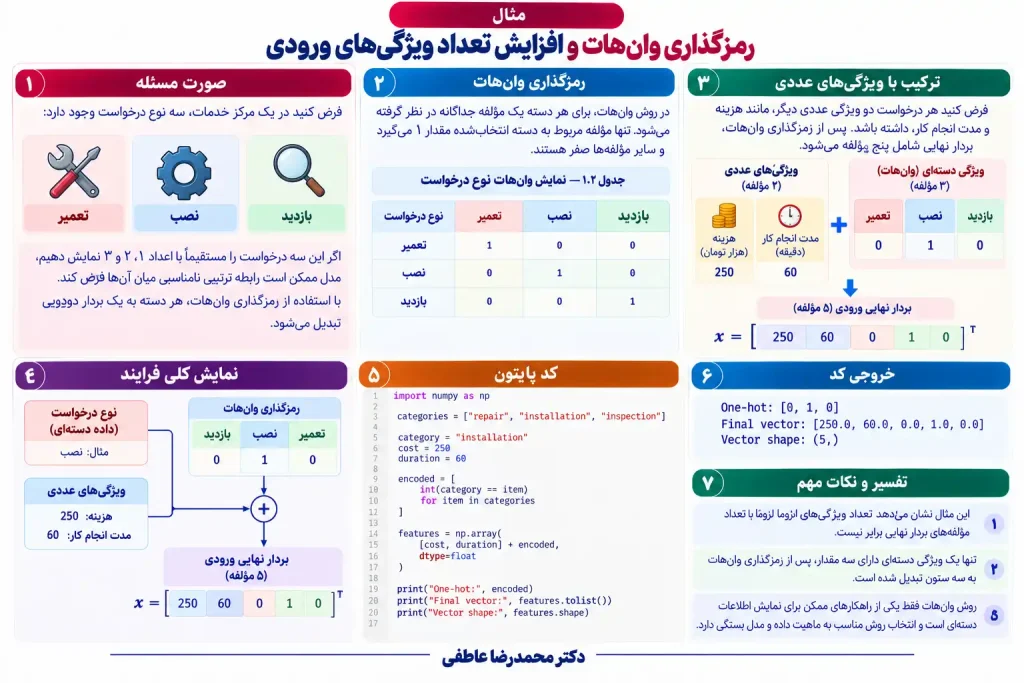
با استفاده از رمزگذاری وانهات، هر دسته به یک بردار دودویی تبدیل میشود.
| نوع درخواست | تعمیر | نصب | بازدید |
| تعمیر | ۱ | ۰ | ۰ |
| نصب | ۰ | ۱ | ۰ |
| بازدید | ۰ | ۰ | ۱ |
حال اگر هر درخواست دو ویژگی عددی دیگر، مانند هزینه و مدت انجام کار، داشته باشد، بردار نهایی شامل پنج مؤلفه میشود.
کد پایتون
import numpy as np

categories = ["repair", "installation", "inspection"]

category = "installation"
cost = 250
duration = 60

encoded = [
    int(category == item)
    for item in categories
]

features = np.array(
    [cost, duration] + encoded,
    dtype=float
)

print("One-hot:", encoded)
print("Final vector:", features.tolist())
print("Vector shape:", features.shape)
خروجی:
One-hot: [0, 1, 0]
Final vector: [250.0, 60.0, 0.0, 1.0, 0.0]
Vector shape: (5,)
تفسیر
این مثال نشان میدهد تعداد ویژگیهای اولیه لزوماً با تعداد مؤلفههای بردار نهایی برابر نیست. تنها یک ویژگی دستهای دارای سه مقدار، پس از رمزگذاری وانهات به سه ستون تبدیل شده است.
نکته دیگر اینکه روش وانهات فقط یکی از راهکارهای ممکن برای نمایش اطلاعات دستهای است و انتخاب روش مناسب به ماهیت داده و مدل بستگی دارد.
1.۵. یک نمونه و مجموعهای از نمونهها چگونه نمایش داده میشوند؟
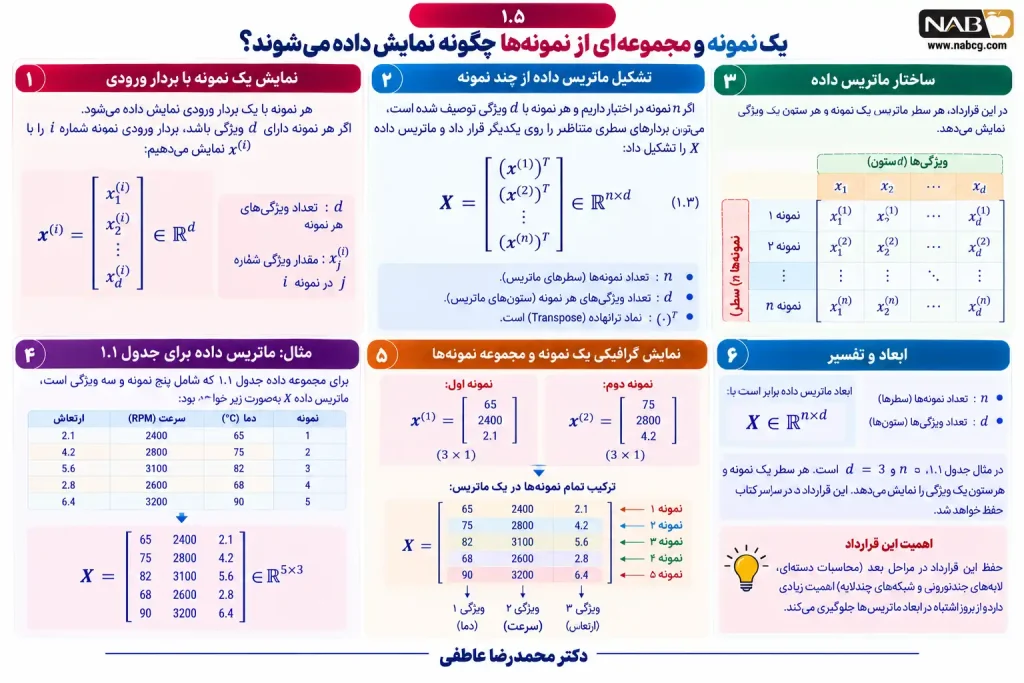
تا اینجا، بردار ورودی را برای نمایش یک نمونه معرفی کردیم. اکنون باید ببینیم چگونه چند نمونه را در قالب یک ساختار واحد سازماندهی کنیم.
فرض کنید (n) نمونه در اختیار داریم و هر نمونه با (d) ویژگی توصیف شده است.
بردار ورودی نمونه شماره i را با 𝐱^(i) نمایش میدهیم. برای نگهداری تمام نمونهها، میتوان بردارهای سطری متناظر را روی یکدیگر قرار داد و ماتریس داده X را تشکیل داد:
در معادله بالا، (n) تعداد نمونهها، (d) تعداد ویژگیهای هر نمونه و (T) نماد ترانهاده (Transpose) است.
هر سطر ماتریس یک نمونه و هر ستون یک ویژگی را نمایش میدهد.
برای مجموعه داده جدول 1.۱، ماتریس (X) دارای پنج سطر و سه ستون خواهد بود:
این قرارداد در سراسر کتاب حفظ خواهد شد: نمونهها در سطرها و ویژگیها در ستونها قرار میگیرند.
اهمیت این قرارداد زمانی روشنتر میشود که وارد محاسبات دستهای، لایههای چندنورونی و شبکههای چندلایه شویم.
مثال : تبدیل مجموعهای از نمونهها به ماتریس داده
صورت مسئله
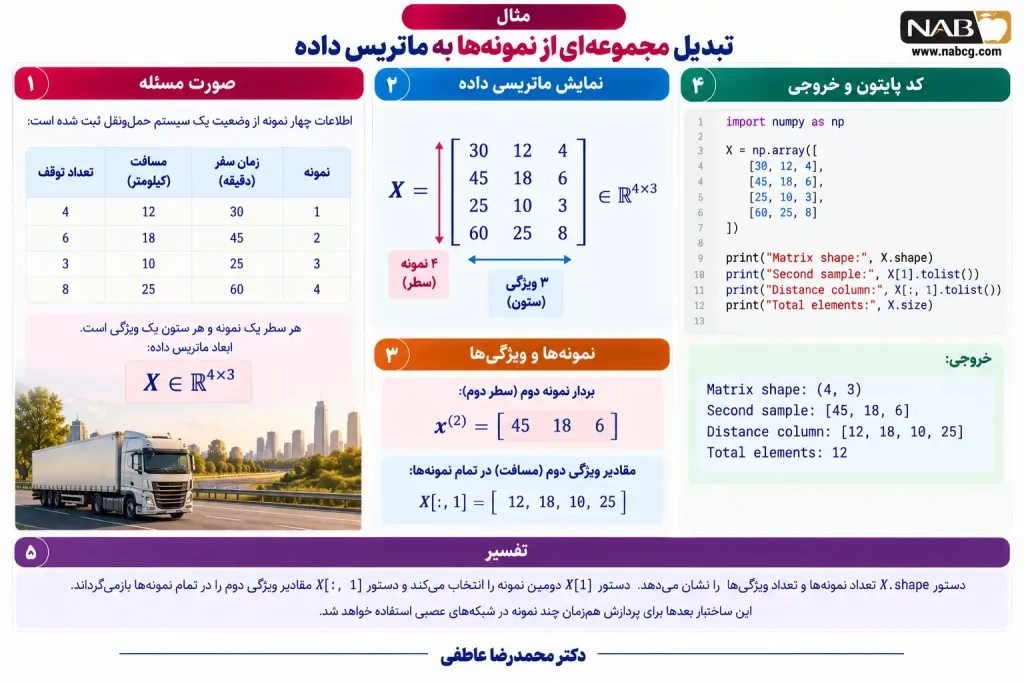
فرض کنید اطلاعات چهار نمونه از وضعیت یک سیستم حملونقل ثبت شده است:
| نمونه | زمان سفر (دقیقه) | مسافت (کیلومتر) | تعداد توقف |
| ۱ | ۳۰ | ۱۲ | ۴ |
| ۲ | ۴۵ | ۱۸ | ۶ |
| ۳ | ۲۵ | ۱۰ | ۳ |
| ۴ | ۶۰ | ۲۵ | ۸ |
هر سطر معرف یک نمونه و هر ستون معرف یک ویژگی است.
بنابراین ابعاد ماتریس داده برابر است با:
کد پایتون
import numpy as np

X = np.array([
    [30, 12, 4],
    [45, 18, 6],
    [25, 10, 3],
    [60, 25, 8]
])

print("Matrix shape:", X.shape)
print("Second sample:", X[1].tolist())
print("Distance column:", X[:, 1].tolist())
print("Total elements:", X.size)
خروجی:
Matrix shape: (4, 3)
Second sample: [45, 18, 6]
Distance column: [12, 18, 10, 25]
Total elements: 12
تفسیر
دستور X.shape تعداد نمونهها و تعداد ویژگیها را مشخص میکند. دستور X[1] دومین نمونه را انتخاب میکند و دستور X[:, 1] مقادیر ویژگی دوم را در تمام نمونهها بازمیگرداند.
این ساختار بعدها برای پردازش همزمان چند نمونه در شبکههای عصبی استفاده خواهد شد.
1.۶. نخستین پیادهسازی بردار و ماتریس داده با پایتون
اکنون میخواهیم مفاهیم قبلی را با برنامهنویسی پیوند دهیم. در این مرحله، هنوز نورون را آموزش نمیدهیم و حتی وزنهای آن را محاسبه نمیکنیم. هدف صرفاً ساخت ورودی معتبر برای مدل است.
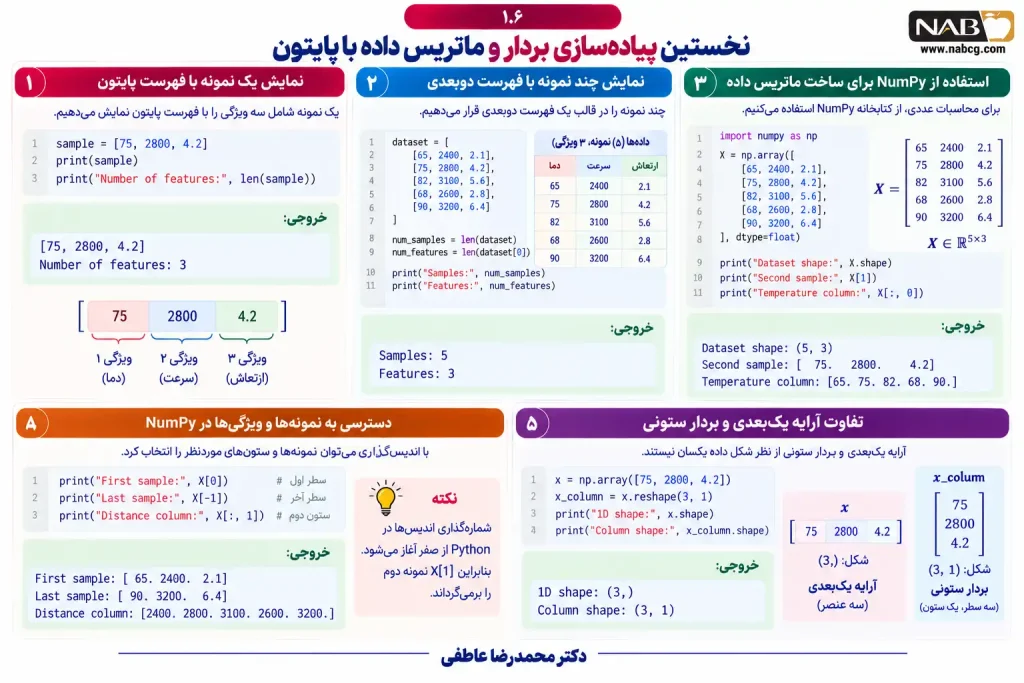
ابتدا یک نمونه شامل سه ویژگی را با فهرست پایتون نمایش میدهیم:
sample = [75, 2800, 4.2]
print(sample)
print("Number of features:", len(sample))
خروجی:
[75, 2800, 4.2]
Number of features: 3
اکنون چند نمونه را در قالب یک فهرست دوبعدی قرار میدهیم:
dataset = [
    [65, 2400, 2.1],
    [75, 2800, 4.2],
    [82, 3100, 5.6],
    [68, 2600, 2.8],
    [90, 3200, 6.4]
]
num_samples = len(dataset)
num_features = len(dataset[0])

print("Samples:", num_samples)
print("Features:", num_features)
خروجی:
Samples: 5
Features: 3
این شیوه برای آشنایی اولیه مناسب است، اما فهرستهای معمولی پایتون ابزار تخصصی محاسبات برداری و ماتریسی نیستند. برای محاسبات عددی گسترده، استفاده از NumPy رایج است.
import numpy as np

X = np.array([
    [65, 2400, 2.1],
    [75, 2800, 4.2],
    [82, 3100, 5.6],
    [68, 2600, 2.8],
    [90, 3200, 6.4]
], dtype=float)

print("Dataset shape:", X.shape)
print("Second sample:", X[1])
print("Temperature column:", X[:, 0])
خروجی:
Dataset shape: (5, 3)
Second sample: [  75.  2800.     4.2]
Temperature column: [65. 75. 82. 68. 90.]
ویژگی shape ابعاد آرایه را نمایش میدهد. در این مثال، (5, 3) به معنای پنج نمونه و سه ویژگی است.
دستور X[1] سطر دوم را انتخاب میکند؛ زیرا شمارهگذاری اندیسها در پایتون از صفر آغاز میشود.
دستور X[:, 0] نیز تمام سطرها از ستون اول را برمیگرداند؛ یعنی مقادیر دما برای همه نمونهها.
1.۶.۱. تفاوت شکل آرایه یکبعدی و بردار ستونی
یکی از نکات مهم برای مبتدیان این است که آرایه یکبعدی NumPy و بردار ستونی دوبعدی از نظر شکل داده یکسان نیستند.
import numpy as np
x = np.array([75, 2800, 4.2])
x_column = x.reshape(3, 1)
print("1D shape:", x.shape)
print("Column shape:", x_column.shape)
خروجی:
1D shape: (3,)
Column shape: (3, 1)
آرایه نخست دارای سه عنصر و یک بعد است. آرایه دوم دارای سه سطر و یک ستون است.
در بیان ریاضی، بردار (x) را بهصورت ستونی تعریف کردیم. اما هنگام برنامهنویسی با NumPy، میتوان در بسیاری از محاسبات از آرایه یکبعدی استفاده کرد؛ به شرط آنکه معنای ابعاد و رفتار عملیات بهدرستی درک شود.
این تمایز در محاسبه ضرب ماتریسی، تغییر شکل آرایهها و پیادهسازی لایههای شبکه عصبی اهمیت بیشتری پیدا خواهد کرد.
1.۷. آزمایش کنترلشده: چرا ترتیب ویژگیها اهمیت دارد؟
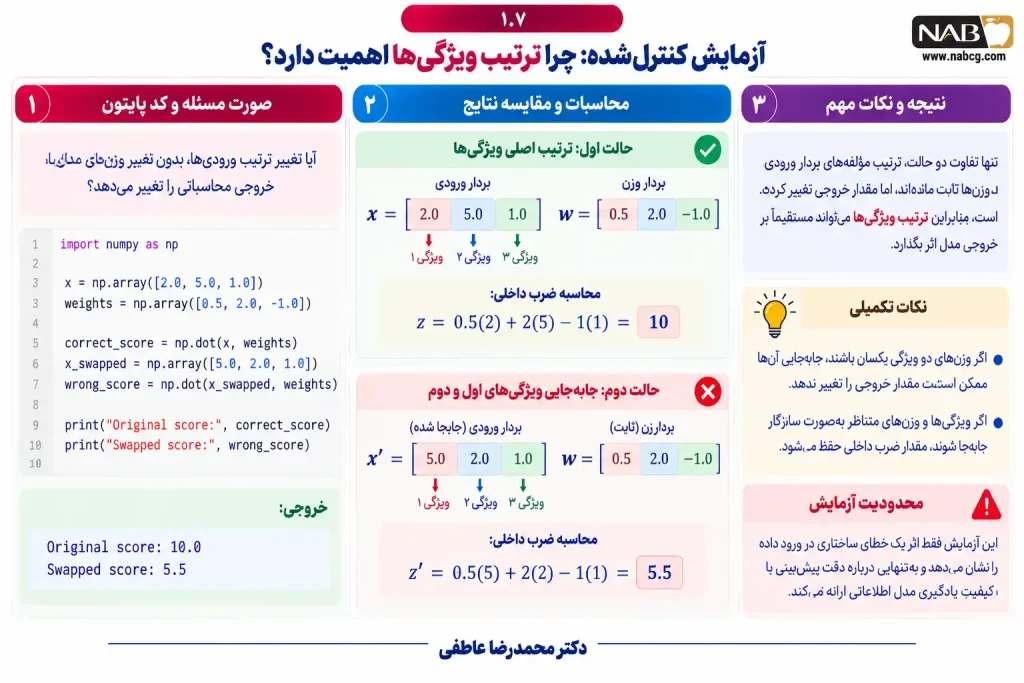
آزمایش 1.۱ — تأثیر جابهجایی ویژگیها بر خروجی محاسبه
پرسش آزمایش این است که آیا تغییر ترتیب ورودیها، بدون تغییر وزنهای مدل، مقدار خروجی محاسباتی را تغییر میدهد؟
برای پاسخ، یک بردار سهمؤلفهای و یک بردار وزن مشخص تعریف میکنیم:
import numpy as np

x = np.array([2.0, 5.0, 1.0])
weights = np.array([0.5, 2.0, -1.0])

correct_score = np.dot(x, weights)

x_swapped = np.array([5.0, 2.0, 1.0])
wrong_score = np.dot(x_swapped, weights)

print("Original score:", correct_score)
print("Swapped score:", wrong_score)
خروجی:
Original score: 10.0
Swapped score: 5.5
در حالت اول، محاسبه به شکل زیر است:
در حالت دوم، مقدار ورودیهای اول و دوم جابهجا شدهاند:
تنها تفاوت دو حالت، ترتیب ویژگیهاست. وزنها ثابت ماندهاند و عملیات محاسباتی نیز تغییر نکرده است.
بنابراین، نتیجه آزمایش نشان میدهد که ترتیب مؤلفههای بردار ورودی میتواند مستقیماً بر خروجی مدل اثر بگذارد.
البته این نتیجه به معنای آن نیست که هر جابهجایی ویژگیها الزاماً خروجی را تغییر میدهد. برای مثال، اگر وزنهای دو ویژگی یکسان باشند، جابهجایی آن دو ممکن است مقدار جمع وزندار را ثابت نگه دارد. همچنین اگر وزنها همراه با ویژگیها بهصورت سازگار جابهجا شوند، مقدار ضرب داخلی حفظ میشود.
محدودیت آزمایش: این آزمایش فقط نشاندهنده اثر یک خطای ساختاری در ورود داده است و بهتنهایی درباره دقت پیشبینی یا کیفیت یادگیری یک مدل اطلاعاتی ارائه نمیکند.
1.۸. خطاهای رایج هنگام آمادهسازی ورودی نورون
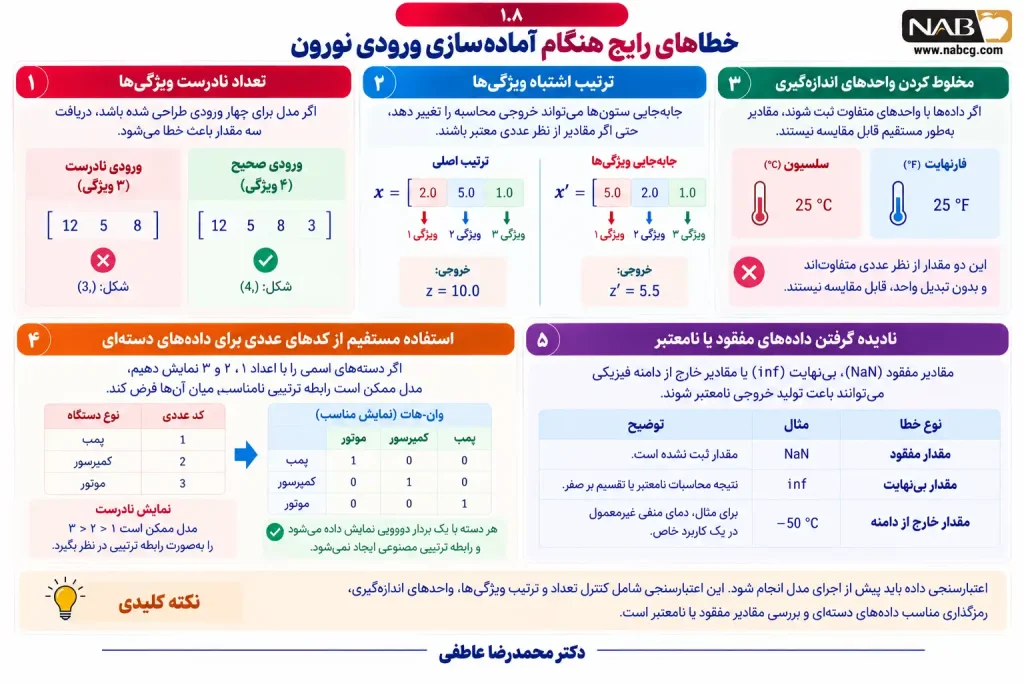
نخستین گروه خطاها به تعداد ویژگیها مربوط است. اگر مدلی برای چهار ورودی طراحی شده باشد و فقط سه مقدار دریافت کند، محاسبه وزندار به شکل مورد انتظار امکانپذیر نخواهد بود.
گروه دوم به ترتیب ویژگیها مربوط میشود. چنانکه در آزمایش 1.۱ مشاهده شد، جابهجایی ستونها میتواند خروجی را تغییر دهد، حتی اگر همه مقادیر از نظر عددی معتبر باشند.
- خطای سوم، مخلوط کردن واحدهای اندازهگیری است. اگر دمای یک نمونه برحسب سلسیوس و نمونه دیگر برحسب فارنهایت ثبت شده باشد، مقادیر بهطور مستقیم قابل مقایسه نیستند. در این حالت، حتی یک مدل ریاضی صحیح نیز ممکن است بر اساس اطلاعات ناسازگار محاسبه انجام دهد.
- خطای چهارم، استفاده مستقیم از کدهای عددی برای دادههای دستهای اسمی است. اگر سه نوع دستگاه با اعداد یک، دو و سه نمایش داده شوند، مدل ممکن است رابطه ترتیبی یا فاصلهای نامناسبی میان آنها برقرار کند.
- خطای پنجم، نادیده گرفتن دادههای مفقود یا نامعتبر است. برای مثال، مقادیر NaN و inf ممکن است وارد محاسبات شوند و باعث تولید خروجی نامعتبر شوند. همچنین وجود مقدار عددی خارج از دامنه فیزیکی مورد انتظار میتواند نشانه خطای ثبت یا پردازش داده باشد.
در طراحی سیستمهای واقعی، اعتبارسنجی داده باید پیش از اجرای مدل انجام شود. این اعتبارسنجی تنها به بررسی نوع داده محدود نیست و میتواند شامل کنترل دامنه، واحد، ترتیب، مقادیر مفقود و سازگاری معنایی ویژگیها باشد.
مثال : شناسایی دادههای نامعتبر پیش از ورود به نورون
صورت مسئله
در یک مجموعهداده، برخی اندازهگیریها ممکن است نامعتبر باشند. برای مثال، یک حسگر بهجای عدد واقعی مقدار NaN ثبت کند یا حاصل یک محاسبه نامعتبر به بینهایت برسد.
اگر این مقادیر بدون بررسی وارد نورون شوند، ممکن است خروجی نیز نامعتبر شود.
کد پایتون
import numpy as np

X = np.array([
    [70, 1500, 4.2],
    [75, np.nan, 3.8],
    [80, 1700, np.inf],
    [65, 1400, 2.5]
])

valid_rows = np.isfinite(X).all(axis=1)

print("Valid rows:", valid_rows.tolist())
print("Valid sample count:", int(valid_rows.sum()))
print("Invalid row indices:", np.where(~valid_rows)[0].tolist())
print("Cleaned matrix shape:", X[valid_rows].shape)
خروجی:
Valid rows: [True, False, False, True]
Valid sample count: 2
Invalid row indices: [1, 2]
Cleaned matrix shape: (2, 3)
1.۹. پروژه عملی بخش: طراحی ورودی یک سامانه پایش صنعتی
در این پروژه، هدف ساخت یک مدل پیشبینی نیست. میخواهیم ساختار ورودی یک نورون را برای مسئلهای واقعی طراحی کنیم.
فرض کنید واحد نگهداری و تعمیرات یک کارخانه، اطلاعات مربوط به تجهیزات را ثبت میکند. برای هر مشاهده، سه ویژگی دما، سرعت چرخش و ارتعاش اندازهگیری میشود.
ابتدا باید قرارداد داده مشخص شود: ترتیب ویژگیها، واحدها، تعداد مؤلفهها و نوع عددی آنها.
سپس مجموعهای از نمونههای آزمایشی را به یک ماتریس NumPy تبدیل میکنیم و پیش از استفاده، تعداد ویژگیها و معتبر بودن مقادیر را بررسی میکنیم.
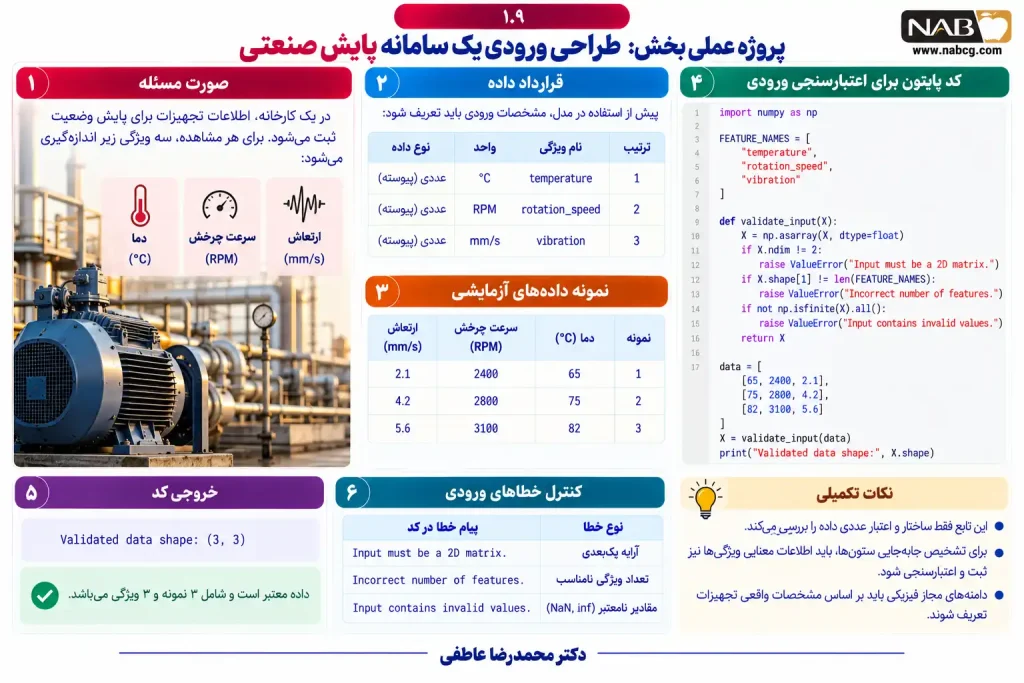
کد زیر یک نسخه مقدماتی از اعتبارسنجی ورودی را پیادهسازی میکند:
import numpy as np

FEATURE_NAMES = [
    "temperature",
    "rotation_speed",
    "vibration"
]

def validate_input(X):
    X = np.asarray(X, dtype=float)

    if X.ndim != 2:
        raise ValueError(
            "Input must be a 2D matrix."
        )

    if X.shape[1] != len(FEATURE_NAMES):
        raise ValueError(
            "Incorrect number of features."
        )

    if not np.isfinite(X).all():
        raise ValueError(
            "Input contains invalid numeric values."
        )

    return X


data = [
    [65, 2400, 2.1],
    [75, 2800, 4.2],
    [82, 3100, 5.6]
]

X = validate_input(data)

print("Validated data shape:", X.shape)
خروجی:
Validated data shape: (3, 3)این تابع سه موضوع را بررسی میکند: داده باید یک ماتریس دوبعدی باشد، تعداد ستونهای آن باید با قرارداد ویژگیها مطابقت داشته باشد و همه مقادیر باید عددی و متناهی باشند.
البته تابع فوق بهتنهایی نمیتواند تشخیص دهد که ستونهای دما و سرعت بهاشتباه جابهجا شدهاند. برای چنین کنترلی باید اطلاعات معنایی ستونها نیز در ساختار داده ثبت و اعتبارسنجی شود. همچنین دامنههای مجاز فیزیکی باید متناسب با مشخصات واقعی تجهیزات تعریف شوند؛ استفاده از محدودههای فرضی بدون مستندات فنی قابل اتکا نیست.
این پروژه مقدمهای برای ساخت نورون در بخشهای بعدی است؛ زیرا اکنون میتوانیم فرض کنیم ورودیهای مدل از نظر ساختار و ابعاد مشخص هستند.
1.۱۰. تمرینهای پایان بخش
تمرین 1.۱ — تشخیص نمونه و ویژگی
یک مجموعه داده شامل اطلاعات ۱۵۰ دانشآموز در اختیار دارید. برای هر دانشآموز، سن، معدل، تعداد ساعات مطالعه هفتگی و میزان حضور در کلاس ثبت شده است. مشخص کنید تعداد نمونهها و ویژگیها چقدر است و ابعاد ماتریس ورودی را بنویسید.
تمرین 1.۲ — ساخت بردار ورودی
یک دستگاه صنعتی با دمای ۷۸ درجه سلسیوس، سرعت ۲۷۰۰ دور بر دقیقه و ارتعاش ۳٫۵ اندازهگیری شده است. بردار ورودی آن را بر اساس ترتیب دما، سرعت و ارتعاش بنویسید و ابعاد آن را مشخص کنید.
تمرین 1.۳ — رمزگذاری دستهای
فرض کنید ویژگی «نوع دستگاه» شامل چهار دسته پمپ، موتور، کمپرسور و فن باشد. نمایش وان-هات هر دسته را طراحی کنید. سپس مشخص کنید اگر دو ویژگی عددی دیگر نیز وجود داشته باشد، بردار نهایی چند مؤلفه خواهد داشت.
تمرین 1.۴ — تحلیل ابعاد
یک ماتریس با ۵۰۰ سطر و ۱۲ ستون دارید. توضیح دهید هر سطر و ستون چه مفهومی دارد. سپس مشخص کنید اگر سه ویژگی جدید به داده افزوده شود، ابعاد ماتریس چه تغییری خواهد کرد.
تمرین 1.۵ — برنامهنویسی مقدماتی
با استفاده از پایتون، فهرستی شامل چهار نمونه و سه ویژگی بسازید. برنامهای بنویسید که تعداد نمونهها، تعداد ویژگیها، سطر سوم و ستون دوم را چاپ کند.
تمرین 1.۶ — اعتبارسنجی داده
تابع validate_input را توسعه دهید تا اگر تعداد نمونهها صفر باشد، پیام خطای مناسبی تولید کند. همچنین بررسی کنید برای ورودیهای نامعتبر مانند NaN و inf چه اتفاقی میافتد.
تمرین 1.۷ — مقایسه آرایهها
یک آرایه NumPy با چهار عنصر بسازید و آن را به شکلهای (4, 1) و (1, 4) تبدیل کنید. تفاوت این سه نمایش را توضیح دهید و بررسی کنید چرا یکی دانستن آنها ممکن است در محاسبات ماتریسی مشکل ایجاد کند.
تمرین 1.۸ — خطای پنهان در ترتیب ستونها
یک بردار ورودی و یک بردار وزن با چهار مؤلفه دلخواه تعریف کنید. مقدار ضرب داخلی آنها را محاسبه کنید. سپس ترتیب دو ویژگی را تغییر دهید و خروجی جدید را به دست آورید. شرایطی را بررسی کنید که این جابهجایی باعث تغییر خروجی نمیشود.
تمرین 1.۹ — تفکر انتقادی
آیا افزایش تعداد ویژگیهای ورودی همیشه باعث افزایش کیفیت مدل میشود؟ با توجه به ویژگیهای نامربوط، خطاهای اندازهگیری و محدودیت داده آموزشی، پاسخ خود را تحلیل کنید.
تمرین 1.۱۰ — پروژه توسعهای
برای مسئلهای به انتخاب خود، یک مجموعه داده فرضی با حداقل ده نمونه و پنج ویژگی طراحی کنید. نام ویژگیها، نوع داده، واحد اندازهگیری و دلیل انتخاب هر ویژگی را مستند کنید. سپس ماتریس ورودی را با NumPy بسازید و ابعاد آن را بررسی کنید.
1.۱۱. مطالعات موردی: آمادهسازی دادههای واقعی برای ورود به نورون مصنوعی
در مثالهای قبلی، از دادههای فرضی برای آموزش مفاهیم استفاده کردیم. اکنون سه مجموعهداده واقعی را بررسی میکنیم تا ببینیم اطلاعات چگونه از محیط واقعی جمعآوری شدهاند، چه ویژگیهایی دارند و چگونه میتوان آنها را به بردارها و ماتریسهای عددی مناسب برای مدلهای محاسباتی تبدیل کرد.
در هر مطالعه، مراحل زیر بررسی میشوند: معرفی مسئله و منبع داده، شناسایی نمونهها و ویژگیها، ساخت ماتریس ورودی، اعتبارسنجی، نمایش عددی، بررسی مقیاس، اجرای کد و تفسیر نتایج.
در این مرحله هنوز هدف آموزش یک نورون مصنوعی یا ارزیابی دقت پیشبینی آن نیست. هدف این است که بدانیم چگونه ورودی صحیح یک مدل را آماده کنیم.
مطالعه موردی ـ آمادهسازی دادههای واقعی تحلیل شیمیایی نمونهها
۱. معرفی مسئله
فرض کنید یک آزمایشگاه کنترل کیفیت موظف است نتایج اندازهگیری ترکیبات شیمیایی نمونههای مختلف را بررسی و برای استفاده در یک سامانه هوشمند آماده کند.
هر نمونه دارای چند ویژگی است. برای مثال، میزان الکل، شدت رنگ، غلظت منیزیم و مقدار ترکیبات فنولی در آزمایشگاه اندازهگیری شدهاند.
اگر بخواهیم این اطلاعات را به یک نورون مصنوعی ارائه کنیم، ابتدا باید چند پرسش را پاسخ دهیم: هر نمونه چند ویژگی دارد؟ آیا تمام ویژگیها عددی هستند؟ آیا مقیاس اندازهگیری آنها یکسان است؟ و چگونه میتوان اطلاعات چند نمونه را به شکل یک ماتریس ذخیره کرد؟
۲. معرفی مجموعهداده واقعی
برای پاسخ به این پرسشها از مجموعهداده Wine استفاده میکنیم که در مخزن داده UCI منتشر شده است.
لینک مستقیم مجموعهداده:
UCI Machine Learning Repository – Wine Dataset
این مجموعه شامل اندازهگیریهای شیمیایی ۱۷۸ نمونه متعلق به سه گروه است. هر نمونه دارای ۱۳ ویژگی اندازهگیریشده است.
مشخصات اصلی:
| ویژگی مجموعهداده | مقدار |
| تعداد نمونهها | ۱۷۸ |
| تعداد ویژگیهای ورودی | ۱۳ |
| تعداد گروهها | ۳ |
| ماهیت ورودیها | عددی |
| هدف فعلی | ساخت و بررسی ماتریس ورودی |
از میان ۱۳ ویژگی، در این مطالعه ابتدا روی دو مورد تمرکز میکنیم:
alcohol که مقدار الکل را نشان میدهد و color_intensity که بیانگر شدت رنگ نمونه است.
۳. شناسایی نمونه، ویژگی و برچسب
در این مجموعه، هر سطر معرف یک نمونه آزمایشگاهی است. ستونها مقادیر ویژگیهای شیمیایی را نمایش میدهند و برچسب گروه نمونه نیز جداگانه نگهداری میشود.
اگر تمام دادهها استفاده شوند:
و اگر فقط دو ویژگی انتخابشده را نگه داریم:
تعداد نمونهها تغییر نکرده است؛ فقط تعداد ویژگیهای مورد استفاده کاهش یافته است.
۴. بررسی چند مقدار واقعی
سه مشاهده نخست این مجموعه برای دو ویژگی انتخابشده به شکل زیر هستند:
| شماره نمونه | مقدار الکل | شدت رنگ |
| ۱ | ۱۴٫۲۳ | ۵٫۶۴ |
| ۲ | ۱۳٫۲۰ | ۴٫۳۸ |
| ۳ | ۱۳٫۱۶ | ۵٫۶۸ |
دقت کنید این اعداد از مجموعهداده واقعی استخراج شدهاند و فرضی نیستند.
۵. کد پایتون برای بارگذاری و بررسی دادهها
برای آنکه اجرای مطالعه ساده و تکرارپذیر باشد، از نسخه موجود در کتابخانه scikit-learn استفاده میکنیم.
import numpy as np
from sklearn.datasets import load_wine

dataset = load_wine()

X = dataset.data
y = dataset.target

print("Dataset shape:", X.shape)
print("Target shape:", y.shape)
print("Number of features:", len(dataset.feature_names))
print("Class counts:", np.bincount(y).tolist())

selected_indices = [
    dataset.feature_names.index("alcohol"),
    dataset.feature_names.index("color_intensity")
]

X_selected = X[:, selected_indices]

print("Selected shape:", X_selected.shape)
print("First three samples:")
print(X_selected[:3])
۶. خروجی واقعی کد
Dataset shape: (178, 13)
Target shape: (178,)
Number of features: 13
Class counts: [59, 71, 48]
Selected shape: (178, 2)
First three samples:
[[14.23  5.64]
 [13.2   4.38]
 [13.16  5.68]]
۷. تفسیر خروجی
عبارت (178, 13) به این معناست که ماتریس اصلی دارای ۱۷۸ سطر و ۱۳ ستون است. پس از انتخاب دو ویژگی، ابعاد به (178, 2) تغییر کرده است.
بردار y نیز ۱۷۸ مقدار دارد و گروه واقعی هر نمونه را مشخص میکند. برچسب گروه جزئی از دو ویژگی انتخابشده نیست.
اکنون میتوانیم هر نمونه را بهصورت بردار دوبعدی نمایش دهیم. مثلاً بردار ورودی نمونه اول برابر است با:
این بردار تنها مقادیر دو ویژگی انتخابشده را نمایش میدهد.
۸. مقیاسبندی ویژگیها
برای بررسی تفاوت مقیاس، ابتدا دامنه واقعی دو ویژگی را محاسبه میکنیم.
در این مجموعه، کمینه و بیشینه الکل بهترتیب ۱۱٫۰۳ و ۱۴٫۸۳ و کمینه و بیشینه شدت رنگ بهترتیب ۱٫۲۸ و ۱۳ هستند.
برای تبدیل مقدارهای هر ویژگی به بازه صفر تا یک، از رابطه زیر استفاده میکنیم:
سپس برای ویژگی الکل در نمونه اول:
برای شدت رنگ:
پس بردار مقیاسبندیشده نمونه اول برابر میشود با:
۹. کد کامل مقیاسبندی
import numpy as np
from sklearn.datasets import load_wine

dataset = load_wine()

indices = [
    dataset.feature_names.index("alcohol"),
    dataset.feature_names.index("color_intensity")
]

X = dataset.data[:, indices]

minimum = X.min(axis=0)
maximum = X.max(axis=0)

X_scaled = (X - minimum) / (maximum - minimum)

print("Minimum values:", minimum)
print("Maximum values:", maximum)
print("Scaled matrix shape:", X_scaled.shape)
print("First three scaled samples:")
print(np.round(X_scaled[:3], 3))
۱۰. خروجی واقعی
Minimum values: [11.03  1.28]
Maximum values: [14.83 13.  ]
Scaled matrix shape: (178, 2)
First three scaled samples:
[[0.842 0.372]
 [0.571 0.265]
 [0.561 0.375]]
۱۱. نمایش نقش ورودیها در یک محاسبه آموزشی
حال فقط برای نمایش کاربرد یک بردار ورودی، فرض میکنیم وزن دو ویژگی بهترتیب ۰٫۶ و ۰٫۴ باشد.
برای نمونه اول:
این مقدار یک امتیاز عددی آموزشی است و نباید آن را خروجی یک مدل آموزشدیده یا شاخص معتبر کیفیت محصول در نظر گرفت.
کد پایتون
weights = np.array([0.6, 0.4])

scores = X_scaled @ weights

print("Score vector shape:", scores.shape)
print("First three scores:", np.round(scores[:3], 3).tolist())
خروجی
Score vector shape: (178,)
First three scores: [0.654, 0.448, 0.486]
۱۲. نمودار پراکندگی ویژگیهای واقعی
نمودار پراکندگی میتواند نشان دهد که دو ویژگی در میان ۱۷۸ نمونه چگونه توزیع شدهاند.
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_wine

data = load_wine()
X = data.data
y = data.target

gold = "#F5B700"
burgundy = "#800020"
ai_blue = "#35B7F3"
silver = "#C0C0C0"
light_gray = "#F5F6F8"
white = "#FFFFFF"

fig, ax = plt.subplots(figsize=(9, 6))
fig.patch.set_facecolor(white)
ax.set_facecolor(light_gray)

colors = [gold, burgundy, ai_blue]

for group in range(3):
    mask = y == group
    ax.scatter(
        X[mask, 0],
        X[mask, 9],
        c=colors[group],
        label=f"Group {group}",
        s=48,
        alpha=0.82,
        edgecolors=white,
        linewidths=0.6
    )

ax.set_xlabel("Alcohol")
ax.set_ylabel("Color intensity")
ax.set_title("Wine dataset: two numerical features")
ax.grid(alpha=0.25, color=silver)
ax.legend()
plt.tight_layout()
plt.savefig("wine_features.png", dpi=220)
plt.show()
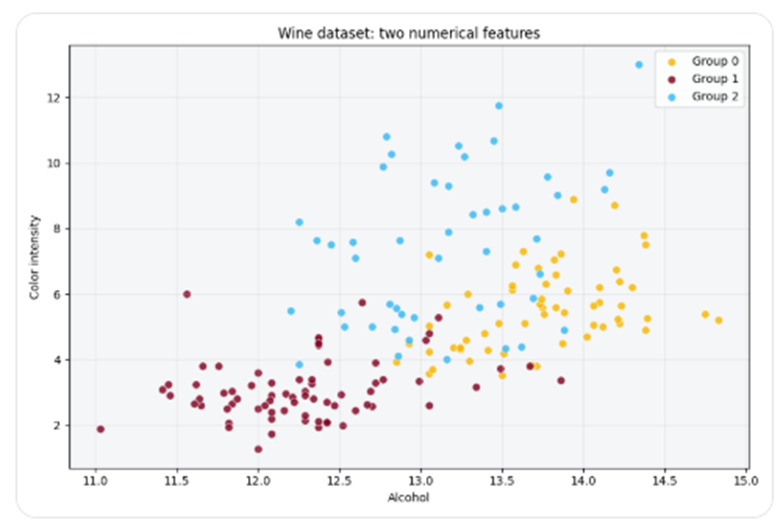
این مطالعه نشان میدهد که تبدیل داده واقعی به ورودی مناسب، فقط وارد کردن چند عدد در برنامه نیست. باید تعریف نمونه، معنای هر ستون، مقیاس داده و ترتیب مؤلفهها مشخص باشد.
همچنین دو نمونه میتوانند مقدار الکل نزدیک به هم داشته باشند، ولی از نظر شدت رنگ متفاوت باشند. بنابراین استفاده از چند ویژگی ممکن است توصیف کاملتری از نمونه فراهم کند.
۱۳. محدودیتهای مطالعه
این تحلیل صرفاً نحوه آمادهسازی داده و انجام یک محاسبه با وزنهای فرضی را آموزش میدهد. هیچ مدلی برای تفکیک گروهها آموزش داده نشده و امتیازهای محاسبهشده معیاری برای کیفیت یا منشأ نمونهها نیستند.
همچنین مقیاسبندی در این مثال روی کل مجموعه انجام شده است. اگر در آینده مدل یادگیرندهای ساخته شود، برای ارزیابی صحیح باید پارامترهای پیشپردازش را از داده آموزشی به دست آورد و سپس روی دادههای آزمون اعمال کرد.
۱۴. پرسشهای تحلیلی پایان مطالعه
- اگر فقط ویژگی الکل را نگه داریم، ابعاد ماتریس ورودی چگونه تغییر میکند؟
- چرا نمیتوان از بزرگتر بودن مقدار عددی یکی از ویژگیها، درباره اهمیت واقعی آن نتیجه قطعی گرفت؟
- اگر ترتیب دو ستون عوض شود اما بردار وزن ثابت بماند، چه اتفاقی برای امتیازهای محاسبهشده میافتد؟
- آیا انتخاب دو ویژگی از ۱۳ ویژگی موجود لزوماً باعث بهبود عملکرد یک مدل میشود؟
نتیجه نهایی: مهمترین دستاورد این مطالعه، تبدیل یک مجموعهداده شیمیایی واقعی به ماتریسی عددی و قابل پردازش است. این همان گامی است که پیش از محاسبات نورون مصنوعی باید با دقت انجام شود.
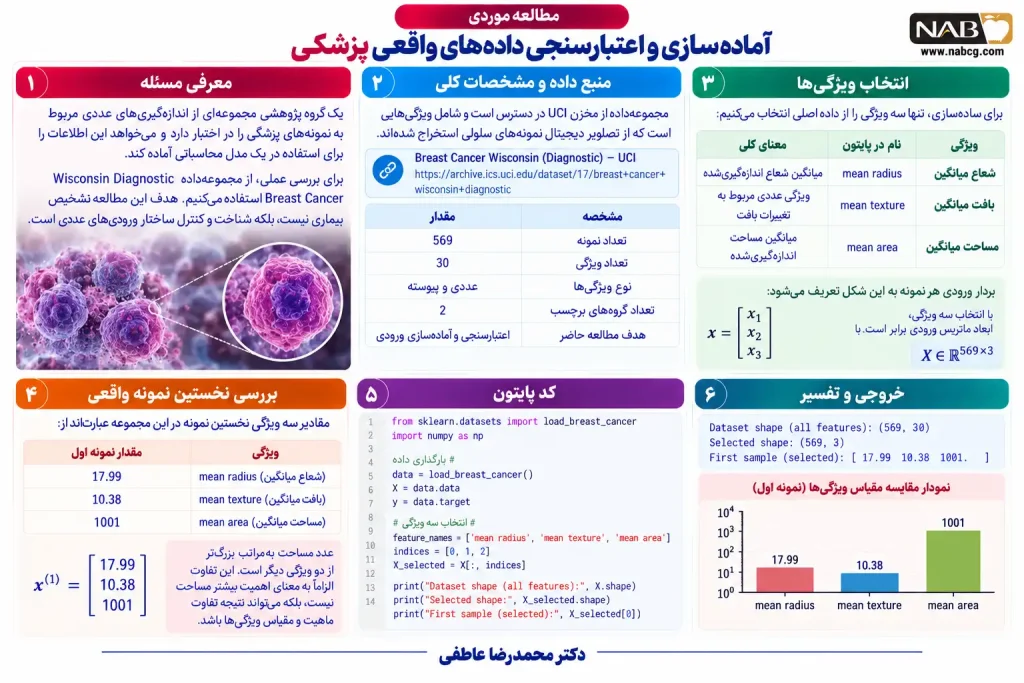
مطالعه موردی ـ آمادهسازی و اعتبارسنجی دادههای واقعی پزشکی
۱. معرفی مسئله
فرض کنید یک گروه پژوهشی مجموعهای از اندازهگیریهای عددی مربوط به نمونههای پزشکی را در اختیار دارد و میخواهد این اطلاعات را برای استفاده در یک مدل محاسباتی آماده کند.
قبل از هر نوع مدلسازی، باید مطمئن شود که دادهها دارای ساختار مشخص هستند، مقادیر نامعتبر ندارند و ویژگیها با ترتیب یکسان ثبت شدهاند.
برای بررسی عملی این موضوع از مجموعهداده Wisconsin Diagnostic Breast Cancer استفاده میکنیم.
این مجموعه شامل ویژگیهایی است که از تصاویر دیجیتال نمونههای سلولی استخراج شدهاند. هدف مطالعه حاضر تشخیص بیماری نیست، بلکه شناخت و کنترل ساختار ورودیهای عددی است.
۲. منبع داده
لینک مستقیم:
Breast Cancer Wisconsin (Diagnostic) – UCI
این مجموعه دارای ۵۶۹ نمونه و ۳۰ ویژگی عددی است. ویژگیها اطلاعاتی درباره خصوصیات هسته سلولها، مانند شعاع، بافت و مساحت، ارائه میکنند.
| مشخصه | مقدار |
| تعداد نمونه | ۵۶۹ |
| تعداد ویژگی | ۳۰ |
| نوع ویژگیها | عددی و پیوسته |
| تعداد گروههای برچسب | ۲ |
| هدف مطالعه حاضر | اعتبارسنجی و آمادهسازی ورودی |
۳. انتخاب ویژگیها
برای سادهسازی، تنها سه ویژگی را از داده اصلی انتخاب میکنیم:
| ویژگی | نام در پایتون | معنای کلی |
| شعاع میانگین | mean radius | میانگین شعاع اندازهگیریشده |
| بافت میانگین | mean texture | ویژگی عددی مربوط به تغییرات بافت |
| مساحت میانگین | mean area | میانگین مساحت اندازهگیریشده |
بردار ورودی هر نمونه به این شکل تعریف میشود:
بنابراین با انتخاب سه ویژگی، ابعاد ماتریس ورودی برابر است با:
۴. بررسی نخستین نمونه واقعی
مقادیر سه ویژگی نخستین نمونه عبارتاند از:
در اینجا با یک نکته مهم روبهرو میشویم: عدد مساحت بهمراتب بزرگتر از دو ویژگی دیگر است.
این تفاوت الزاماً به معنای اهمیت بیشتر مساحت نیست، بلکه میتواند حاصل تفاوت ماهیت و مقیاس ویژگیها باشد.
۵. بارگذاری مجموعهداده و استخراج ویژگیها
import numpy as np
from sklearn.datasets import load_breast_cancer

data = load_breast_cancer()

feature_names = list(data.feature_names)

selected_names = [
    "mean radius",
    "mean texture",
    "mean area"
]

indices = [
    feature_names.index(name)
    for name in selected_names
]

X = data.data[:, indices]

print("Original shape:", data.data.shape)
print("Selected shape:", X.shape)
print("First sample:", X[0].tolist())
print("First three samples:")
print(np.round(X[:3], 3))
۶. خروجی واقعی برنامه
Original shape: (569, 30)
Selected shape: (569, 3)
First sample: [17.99, 10.38, 1001.0]
First three samples:
[[  17.99   10.38 1001.  ]
 [  20.57   17.77 1326.  ]
 [  19.69   21.25 1203.  ]]
۷. تحلیل خروجی
خروجی نخست نشان میدهد داده اصلی دارای ۳۰ ویژگی است.
پس از انتخاب سه ویژگی، تعداد سطرها ثابت میماند، زیرا هیچ نمونهای حذف نشده است. تنها تعداد ستونها از ۳۰ به سه کاهش یافته است.
از دیدگاه ساختار ماتریسی، داده اکنون برای ورود به نورونی با سه ورودی مناسب است؛ هرچند هنوز لازم است نوع، دامنه و اعتبار مقادیر بررسی شود.
۸. بررسی مقادیر مفقود و نامعتبر
وجود مقادیری مانند NaN و inf میتواند باعث اختلال در محاسبات شود.
برای جلوگیری از این مشکل، ابتدا بررسی میکنیم همه مقادیر متناهی هستند یا خیر.
import numpy as np

missing_count = np.isnan(X).sum()
all_finite = np.isfinite(X).all()

print("Missing values:", int(missing_count))
print("All values finite:", bool(all_finite))
print("Data type:", X.dtype)
خروجی:
Missing values: 0
All values finite: True
Data type: float64
این نتیجه به معنای آن است که در سه ویژگی انتخابشده، هیچ مقدار NaN وجود ندارد و تمام مقادیر متناهی هستند.
البته معتبر بودن عددی داده تضمین نمیکند که تمام اندازهگیریها از نظر علمی صحیح باشند. برای بررسی اعتبار فیزیکی یا آزمایشگاهی، شناخت روش اندازهگیری و محدودههای قابل قبول نیز ضروری است.
۹. ایجاد کنترلشده یک خطای داده
برای فهم رفتار تابع اعتبارسنجی، نسخهای از داده را کپی میکنیم و مقدار یکی از خانهها را عمداً با NaN جایگزین میکنیم.
این تغییر فقط روی کپی داده انجام میشود و مقادیر واقعی مجموعه اصلی را تغییر نمیدهد.
X_test = X.copy()

X_test[1, 1] = np.nan

valid_rows = np.isfinite(X_test).all(axis=1)

print("Original samples:", X_test.shape[0])
print("Valid samples:", int(valid_rows.sum()))
print("Invalid rows:", np.where(~valid_rows)[0].tolist())
خروجی:
Original samples: 569
Valid samples: 568
Invalid rows: [1]
تفسیر
با قرار دادن مقدار نامعتبر در ردیف دوم، تعداد نمونههای معتبر از ۵۶۹ به ۵۶۸ کاهش یافته است.
این آزمایش نشان میدهد که تابع اعتبارسنجی چگونه میتواند نمونههای دارای داده نامعتبر را شناسایی کند.
در کاربرد واقعی، تصمیم درباره حذف یا اصلاح چنین نمونههایی باید بر اساس ماهیت داده گرفته شود.
۱۰. مقایسه آرایه یکبعدی و بردار ستونی
در بخش سوم ، تفاوت آرایه یکبعدی و بردار ستونی مطرح شده است. اکنون این تفاوت را روی نخستین نمونه واقعی بررسی میکنیم.
sample = X[0]

column_vector = sample.reshape(3, 1)
row_vector = sample.reshape(1, 3)

print("1D shape:", sample.shape)
print("Column vector shape:", column_vector.shape)
print("Row vector shape:", row_vector.shape)
خروجی
1D shape: (3,)
Column vector shape: (3, 1)
Row vector shape: (1, 3)
تفسیر
هر سه ساختار شامل همان سه مقدار هستند، اما ابعادشان متفاوت است. در محاسبات جبری، این تفاوت اهمیت دارد؛ زیرا ضرب ماتریسی فقط زمانی قابل انجام است که ابعاد عملوندها با یکدیگر سازگار باشند.
۱۱. مقیاسبندی سه ویژگی
اکنون برای مقایسه عددی سه ویژگی، از مقیاسبندی Min-Max استفاده میکنیم.
کمینه و بیشینه واقعی ستونهای انتخابشده چنین است:
| ویژگی | کمینه | بیشینه |
| شعاع میانگین | ۶٫۹۸۱ | ۲۸٫۱۱ |
| بافت میانگین | ۹٫۷۱ | ۳۹٫۲۸ |
| مساحت میانگین | ۱۴۳٫۵ | ۲۵۰۱ |
رابطه تبدیل:
کد پایتون
minimum = X.min(axis=0)
maximum = X.max(axis=0)

X_scaled = (X - minimum) / (maximum - minimum)

print("Minimum:", minimum.tolist())
print("Maximum:", maximum.tolist())
print("First scaled sample:", np.round(X_scaled[0], 3).tolist())
خروجی
Minimum: [6.981, 9.71, 143.5]
Maximum: [28.11, 39.28, 2501.0]
First scaled sample: [0.521, 0.023, 0.364]
۱۲. تحلیل مقیاسبندی
پیش از مقیاسبندی، بردار نمونه اول شامل مقادیری با اندازههای بسیار متفاوت بود:
پس از مقیاسبندی:
اکنون مقادیر هر سه ویژگی در بازه صفر تا یک قرار دارند.
این کار به معنای یکسانشدن اهمیت ویژگیها نیست. فقط نمایش عددی آنها را از نظر دامنه تغییر دادهایم.
۱۳. نمودار مقایسه ویژگیها پیش و پس از مقیاسبندی
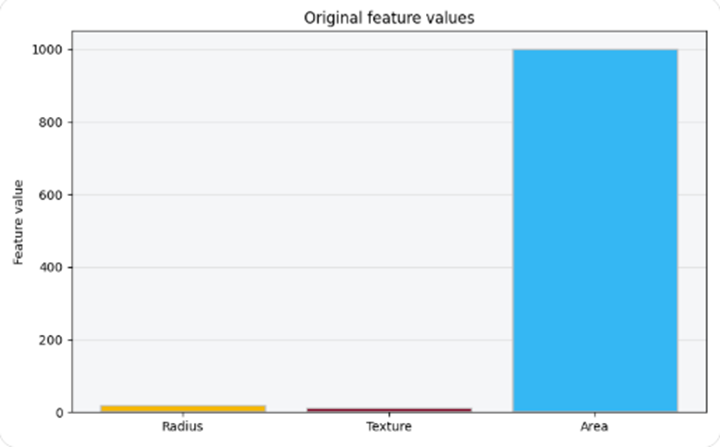
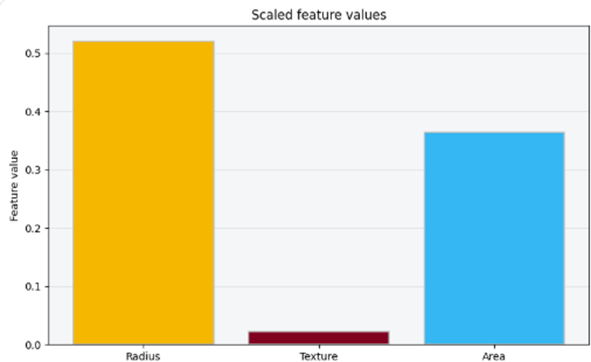
برای جلوگیری از فریب بصری ناشی از اختلاف مقیاس، دو نمودار جداگانه رسم میکنیم: یکی برای مقادیر خام نمونه اول و دیگری برای مقادیر مقیاسبندیشده همان نمونه.
import matplotlib.pyplot as plt
import numpy as np
from sklearn.datasets import load_breast_cancer

data = load_breast_cancer()

X = data.data[:, [0, 1, 3]]

minimum = X.min(axis=0)
maximum = X.max(axis=0)

X_scaled = (X - minimum) / (maximum - minimum)

gold = "#F5B700"
burgundy = "#800020"
ai_blue = "#35B7F3"
silver = "#C0C0C0"
light_gray = "#F5F6F8"

names = ["Radius", "Texture", "Area"]
colors = [gold, burgundy, ai_blue]

for values, title, filename in [
    (X[0], "Original feature values", "medical_raw.png"),
    (X_scaled[0], "Scaled feature values", "medical_scaled.png")
]:
    fig, ax = plt.subplots(figsize=(8, 5))
    fig.patch.set_facecolor("#FFFFFF")
    ax.set_facecolor(light_gray)

    ax.bar(
        names,
        values,
        color=colors,
        edgecolor=silver,
        linewidth=1.2
    )

    ax.set_title(title)
    ax.set_ylabel("Feature value")
    ax.grid(axis="y", color=silver, alpha=0.4)
    ax.set_axisbelow(True)

    plt.tight_layout()
    plt.savefig(filename, dpi=220)
    plt.show()
تفسیر نمودار
در نمودار اول، مقدار عددی مساحت نسبت به دو ویژگی دیگر بسیار بزرگتر است. پس از مقیاسبندی، مقدار هر سه ویژگی نسبت به دامنه مشاهدهشده همان ستون نمایش داده میشود.
این آزمایش نشان میدهد که مقایسه مستقیم مقدارهای خام ویژگیهایی با واحدها و دامنههای متفاوت، میتواند گمراهکننده باشد.
۱۴. محدودیتهای مطالعه
این مجموعهداده برای آموزش مفاهیم آمادهسازی داده به کار رفته است و هیچ سیستم تشخیص پزشکی ساخته نشده است.
مقیاسبندی روی کل مجموعه صرفاً برای نمایش آموزشی صورت گرفته است. در طراحی یک سیستم پیشبینی واقعی، دادهها باید بهدرستی تقسیم شوند و مراحل آمادهسازی بدون نشت اطلاعات اجرا شوند.
همچنین اعتبارسنجی با np.isfinite تنها مقادیر غیرمتناهی را تشخیص میدهد و نمیتواند خطاهای معنایی، اشتباه در ترتیب ویژگیها یا مقادیر خارج از محدوده معتبر آزمایشگاهی را بهتنهایی تشخیص دهد.
۱۵. پرسشهای تکمیلی
- اگر بهجای سه ویژگی، تمام ۳۰ ویژگی انتخاب شوند، ابعاد ماتریس چگونه تغییر میکند؟
- چرا وجود مقدارهای متناهی برای تأیید کیفیت کامل داده کافی نیست؟
- تفاوت آرایه با شکل (3,) و آرایه با شکل (3,1) چیست؟
- اگر دو ستون جابهجا شوند اما تعداد ستونها ثابت بماند، آیا کنترل شکل داده میتواند خطا را تشخیص دهد؟
نتیجه مطالعه: پیش از محاسبه خروجی یک نورون مصنوعی، باید از سازگاری تعداد، ترتیب، نوع و دامنه ویژگیهای ورودی اطمینان پیدا کنیم.
جمعبندی نهایی: از دادههای دنیای واقعی تا ورودیهای معتبر نورون مصنوعی
در این بخش آموختیم که نخستین گام در طراحی یک نورون مصنوعی، تبدیل اطلاعات دنیای واقعی به ورودیهای عددی مناسب است. بااینحال، عددی بودن دادهها بهتنهایی کافی نیست و برای انجام محاسبات معتبر، باید معنا، نوع، مقیاس و ساختار ویژگیهای ورودی نیز مشخص باشند.
در ابتدا، مفاهیم نمونه (Sample)، ویژگی (Feature) و مجموعهداده (Dataset) را بررسی کردیم. سپس با مفهوم بردار ورودی و ماتریس داده آشنا شدیم و دریافتیم که در ساختارهای جدولی، هر سطر معمولاً نماینده یک نمونه و هر ستون معرف یک ویژگی است. همچنین اهمیت حفظ ترتیب ویژگیها و سازگاری ابعاد ورودیها در محاسبات نورون مصنوعی مشخص شد.
در ادامه، تفاوت میان ویژگیهای عددی، دودویی و دستهای بررسی شد و رمزگذاری وانهات (One-Hot Encoding) بهعنوان یکی از روشهای تبدیل دادههای دستهای به نمایش عددی معرفی شد. همچنین آموختیم که تفاوت مقیاس و واحد اندازهگیری ویژگیها میتواند بر محاسبات تأثیر بگذارد و روشهایی مانند مقیاسبندی Min-Max برای تنظیم دامنه عددی دادهها کاربرد دارند.
در بخش عملی، با استفاده از پایتون و کتابخانه NumPy، نحوه ایجاد و پردازش بردارها و ماتریسها، بررسی ابعاد دادهها و شناسایی ورودیهای نامعتبر را تمرین کردیم. این آزمایشها نشان دادند که خطاهایی مانند جابهجایی ستونها، ناسازگاری ابعاد و وجود مقادیر نامعتبر میتوانند صحت محاسبات را تحت تأثیر قرار دهند.
برای درک کاربردی مباحث، دو مطالعه موردی با مجموعهدادههای واقعی بررسی شد. در مطالعه نخست، دادههای تحلیل شیمیایی نمونهها برای نمایش ساختار ویژگیها، مقیاسبندی و محاسبات عددی استفاده شدند. سپس در مطالعه دوم نیز با استفاده از مجموعهداده Wisconsin Diagnostic Breast Cancer، روشهای بررسی ساختار ورودی، شناسایی مقادیر نامعتبر و آمادهسازی دادهها مورد مطالعه قرار گرفتند.
در مجموع، نتایج نشان دادند که آمادهسازی صحیح ورودیها، یکی از پیشنیازهای اساسی عملکرد قابل اعتماد مدلهای محاسباتی است. انتخاب ویژگیهای مناسب، حفظ ترتیب و معنای آنها، توجه به مقیاس دادهها و اعتبارسنجی ورودیها، همگی در این فرایند نقش دارند. همچنین باید توجه داشت که آمادهسازی داده با یادگیری خودکار تفاوت دارد و در این بخش هنوز الگوریتمی برای آموزش پارامترهای نورون اجرا نشده است.
اکنون که با نحوه تبدیل اطلاعات واقعی به ورودیهای عددی معتبر آشنا شدهایم، در بخش بعدی به مفهوم وزن (Weight) میپردازیم و بررسی خواهیم کرد که وزنها چگونه میزان و جهت تأثیر هر ویژگی را بر محاسبات نورون مصنوعی تعیین میکنند.