13. توسعه مدل ریاضی و محاسباتی
13.۱. تبدیل ساختار مفهومی به مدل ریاضی
تبدیل مدل مفهومی به مدل ریاضی یکی از حساسترین مراحل توسعه مدل دینامیکی است. در مرحله مفهومسازی، پژوهشگر مشخص میکند چه متغیرهایی اهمیت دارند و چه روابطی میان آنها برقرار است؛ اما برای شبیهسازی رفتار سیستم باید این روابط به زبان کمی تبدیل شوند.
فرآیند ریاضیسازی را نباید صرفاً «نوشتن معادله برای هر پیکان» تلقی کرد. نخست باید مشخص شود کدام متغیرها وضعیت سیستم را در هر لحظه تعریف میکنند، چه فرآیندهایی موجب تغییر این وضعیت میشوند، چه روابط جبری یا فیزیکی نرخ تغییر را تعیین میکنند و کدام عوامل از خارج مدل وارد میشوند.
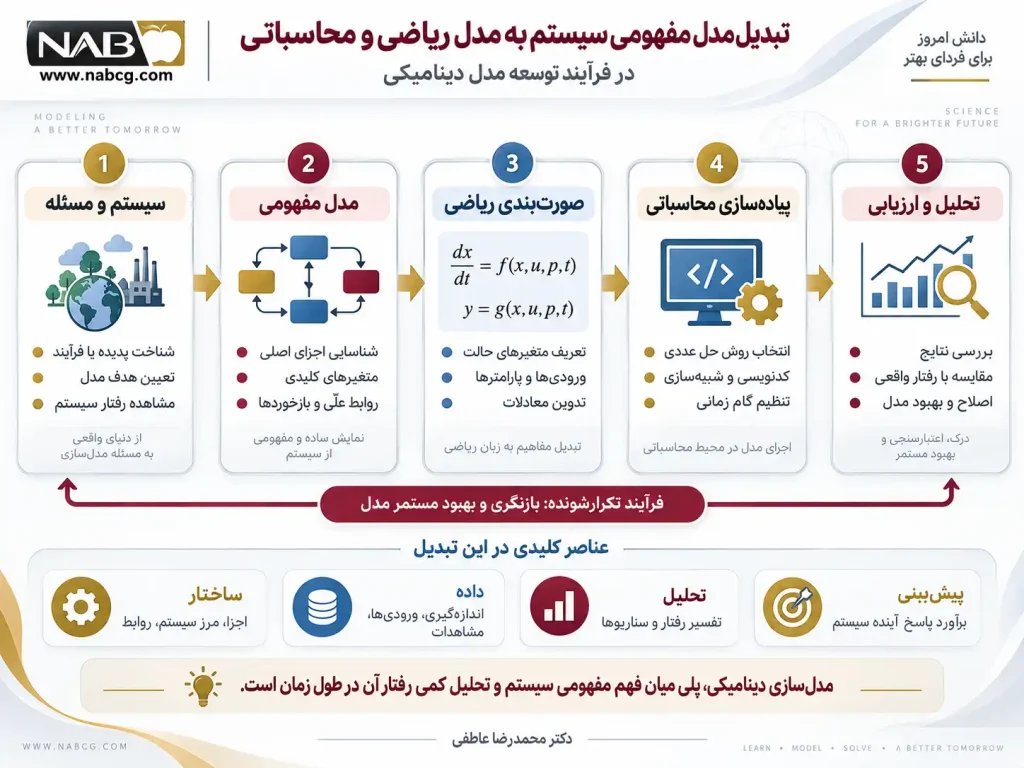
برای یک سیستم دینامیکی پیوسته، نمایش فضای حالت عمومی را میتوان به صورت زیر نوشت:
و معادله خروجی را به صورت:
تعریف کرد.
در این روابط، x(t) بردار متغیرهای حالت، u(t) بردار ورودیهای خارجی، θ مجموعه پارامترهای مدل، y(t) خروجیهای قابل مشاهده و f و g توابعی هستند که دینامیک و نگاشت خروجی سیستم را مشخص میکنند.
این نمایش، نقطه گذار از «داستان علّی» به «مدل قابل محاسبه» است. اما کیفیت این گذار مستقیماً به انتخاب صحیح متغیرهای حالت وابسته است.
13.2. تعریف متغیرهای حالت
متغیر حالت (State Variable) متغیری است که اطلاعات لازم درباره وضعیت فعلی سیستم را برای تعیین تحول آینده آن در خود نگه میدارد. در بسیاری از سیستمهای فیزیکی، متغیرهای حالت به کمیتهایی مربوط هستند که در طول زمان انباشته یا ذخیره میشوند.
اگر x(t) یک متغیر حالت باشد، مقدار آن را میتوان به شکل انتگرالی نوشت:
این رابطه از نظر مفهومی بسیار مهم است. مقدار فعلی متغیر حالت تنها محصول شرایط لحظهای نیست؛ بلکه نتیجه تاریخچه نرخهای تغییر سیستم از زمان اولیه تا زمان جاری است. به همین دلیل، متغیرهای حالت حافظه دینامیکی سیستم را تشکیل میدهند.
برای یک مخزن ساده:
حجم V متغیر حالت است، زیرا مقدار فعلی آن حاصل تجمع تاریخی تفاوت میان جریان ورودی و خروجی است.
همین منطق در سیستمهای مختلف برقرار است: غلظت یک ماده در راکتور، انرژی حرارتی ذخیرهشده، موجودی یک انبار، جمعیت یک منطقه یا سرمایه انباشتهشده، همگی در صورت تعریف مناسب مدل میتوانند نقش متغیر حالت را داشته باشند.
تمایز متغیر حالت از سایر متغیرها برای مدلسازی دینامیکی بنیادی است، زیرا دینامیک سیستم از فرآیند انباشت و تخلیه ایجاد میشود. در بخش بعدی، این مفهوم از طریق متغیرهای جریان و نرخ تغییر توسعه مییابد.
14. فرم عمومی مدل دینامیکی
پس از تعیین متغیرهای حالت، جریانها، پارامترها و روابط عملکردی، مرحله بعدی در توسعه مدل، انتخاب یک نمایش ریاضی مناسب برای توصیف کل سیستم است. فرم ریاضی مدل باید بتواند ساختار داخلی سیستم، نحوه تعامل اجزا و مسیر تغییرات زمانی آن را به شکلی منسجم نمایش دهد.
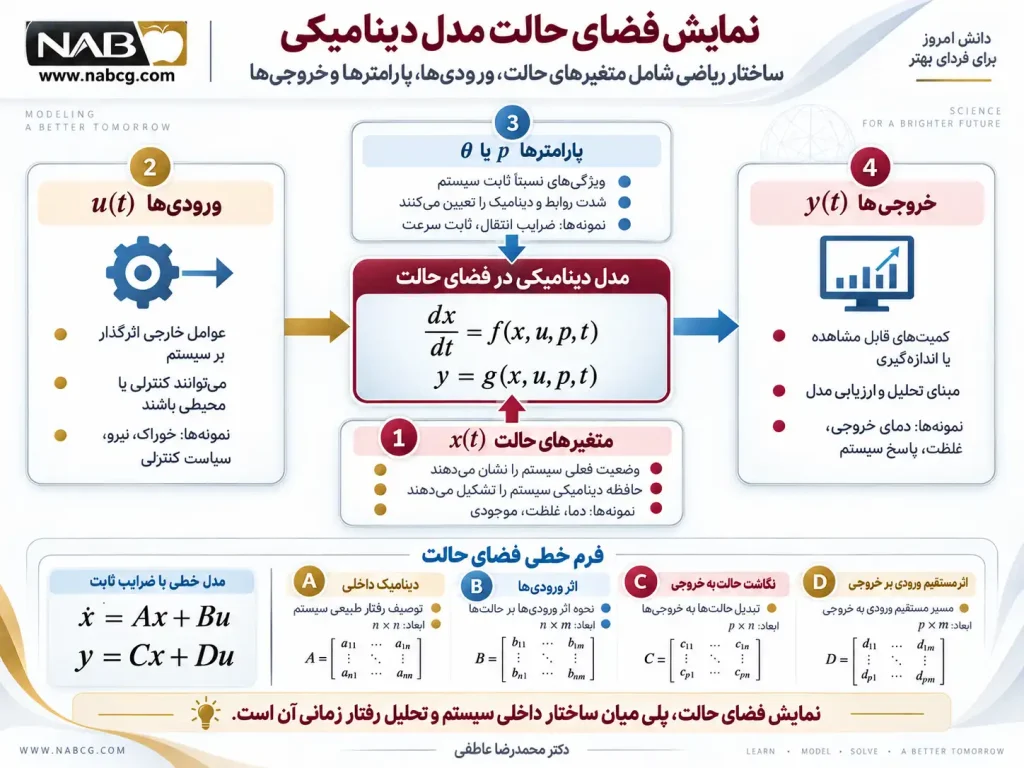
در نظریه سیستمها، یکی از عمومیترین نمایشها برای مدلهای دینامیکی، نمایش فضای حالت (State-Space Representation) است. این نمایش به دلیل قابلیت کاربرد در سیستمهای چندمتغیره، کنترل، شبیهسازی و تحلیل پایداری، یکی از مهمترین چارچوبهای ریاضی در مهندسی سیستمها محسوب میشود (Ogata, 2010).
فرم کلی یک سیستم دینامیکی غیرخطی در فضای حالت به صورت زیر بیان میشود:
که در آن:
- x(t) : بردار متغیرهای حالت سیستم؛
- u(t) : بردار ورودیهای خارجی؛
- P : بردار پارامترهای مدل؛
- y(t) : بردار خروجیهای سیستم؛
- f : تابع دینامیکی سیستم؛
- g : تابع تبدیل حالت و ورودی به خروجی.
این ساختار امکان میدهد یک سیستم پیچیده که شامل تعداد زیادی متغیر است، به مجموعهای از روابط ریاضی سازمانیافته تبدیل شود.
14.۱. نمایش فضای حالت در مدلهای دینامیکی
نمایش فضای حالت بر این ایده استوار است که رفتار آینده یک سیستم تنها با دانستن وضعیت فعلی آن و ورودیهای آینده قابل تعیین است.
به بیان ریاضی:
این ویژگی باعث میشود متغیرهای حالت نقش حافظه سیستم را ایفا کنند.
برای مثال، در یک سیستم حرارتی، دانستن دمای فعلی جسم و شرایط انتقال حرارت کافی است تا بتوان تغییرات آینده دما را محاسبه کرد. نیازی نیست تمام تاریخچه انتقال حرارت از لحظه شروع فرآیند ذخیره شود، زیرا اثر آن تاریخچه در مقدار فعلی انرژی ذخیرهشده سیستم وجود دارد.
ساختار ماتریسی مدل خطی فضای حالت
برای سیستمهای خطی، فرم عمومی مدل فضای حالت به صورت زیر نوشته میشود:
که در آن:
- A : ماتریس دینامیک داخلی سیستم؛
- B : ماتریس اثر ورودیها؛
- C : ماتریس تبدیل حالت به خروجی؛
- D : ماتریس اثر مستقیم ورودی بر خروجی.
این نمایش پایه بسیاری از روشهای تحلیل کنترل و شبیهسازی سیستمها است.
15. مدلهای ورودی–خروجی
در برخی کاربردها، تمرکز اصلی بر ارتباط میان ورودی سیستم و خروجی مشاهدهشده است و جزئیات داخلی سیستم اهمیت کمتری دارد. در این شرایط از مدلهای ورودی–خروجی استفاده میشود.
فرم عمومی:
یا در حالت دینامیکی:
در این مدلها تلاش میشود رفتار خروجی بر اساس تاریخچه ورودیها و خروجیهای گذشته بازسازی شود.
مدلهای ورودی–خروجی در حوزههایی مانند:
- شناسایی سیستم؛
- کنترل فرآیند؛
- پیشبینی سریهای زمانی؛
- یادگیری ماشین
کاربرد گسترده دارند.
برای مثال، یک مدل ARX در شناسایی سیستم میتواند به شکل زیر نوشته شود:
در این مدل، خروجی فعلی تابعی از خروجیهای قبلی و ورودیهای گذشته است.
15.1. مدلهای چندمتغیره و سیستمهای پیچیده
بسیاری از سیستمهای واقعی تنها یک متغیر حالت یا یک ورودی ندارند. در سیستمهای مهندسی، معمولاً چندین متغیر به صورت همزمان بر رفتار سیستم اثر میگذارند.
برای چنین سیستمهایی، مدل باید چندین معادله مرتبط را شامل شود.
برای مثال، یک مدل ساده راکتور میتواند شامل:
- غلظت مواد؛
- دما؛
- فشار؛
- فعالیت کاتالیست؛
باشد.
فرم کلی چنین سیستمی:
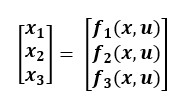
است.
در این شرایط، تعامل میان متغیرها اهمیت بیشتری از رفتار هر متغیر به صورت مستقل دارد. ممکن است یک متغیر به تنهایی رفتار سادهای داشته باشد، اما تعامل آن با سایر متغیرها باعث ایجاد رفتارهای پیچیده مانند:
- نوسان؛
- چند حالت پایدار؛
- رفتار بحرانی؛
- حساسیت بالا به شرایط اولیه؛
شود.
16. مدلسازی سیستمهای پیچیده
سیستمهای پیچیده معمولاً دارای ویژگیهایی هستند که مدلسازی آنها را دشوار میکند.
مهمترین ویژگیهای این سیستمها عبارتاند از:
غیرخطی بودن
در سیستمهای پیچیده، تغییر کوچک در ورودی ممکن است تغییر بزرگی در خروجی ایجاد کند.
برای مثال:
یک تغییر کوچک در x در محدودههای مختلف میتواند اثر متفاوتی داشته باشد.
بازخورد
بازخورد باعث میشود خروجی سیستم دوباره بر ورودیهای داخلی اثر بگذارد.
نمونه:
این ساختار اساس بسیاری از رفتارهای پیچیده است.
ظهور رفتارهای کلان (Emergent Behavior)
در سیستمهای پیچیده، رفتار کل سیستم ممکن است از تعامل اجزا ایجاد شود، بدون اینکه در یک جزء منفرد قابل مشاهده باشد.
برای مثال:
- رفتار بازار؛
- ترافیک شهری؛
- اکوسیستمها؛
- شبکههای اجتماعی.
عدم قطعیت
تقریباً تمام سیستمهای واقعی دارای عدم قطعیت هستند. این عدم قطعیت ممکن است ناشی از:
- اندازهگیری ناقص؛
- تغییر پارامترها؛
- دانش ناکامل درباره ساختار سیستم؛
- تغییر شرایط محیطی؛
باشد.
به همین دلیل، مدلهای دینامیکی مدرن باید علاوه بر ساختار اصلی، قابلیت بررسی عدم قطعیت و حساسیت را نیز داشته باشند. این موضوع در فصلهای بعدی به صورت مستقل بررسی خواهد شد.
17. انتخاب روش حل و شبیهسازی مدل
پس از ایجاد مدل ریاضی، مرحله بعدی تعیین روش مناسب برای حل و اجرای مدل است. بسیاری از مدلهای دینامیکی دارای معادلاتی هستند که حل تحلیلی آنها امکانپذیر نیست و باید از روشهای عددی استفاده شود.
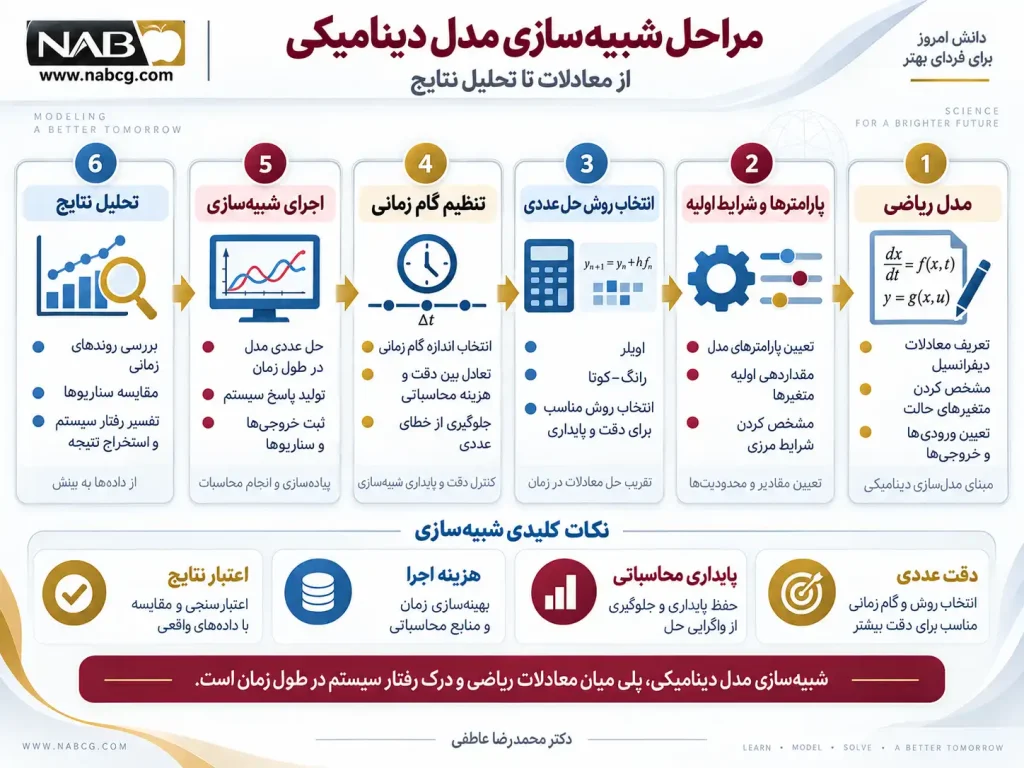
به طور کلی، فرآیند شبیهسازی شامل مراحل زیر است:
17.۱. روشهای حل عددی
روشهای عددی تلاش میکنند پاسخ تقریبی معادلات دیفرانسیل را در نقاط زمانی مشخص محاسبه کنند.
برای یک معادله:
روش ساده اویلر به صورت زیر است:
که در آن:
xₖ: مقدار متغیر در گام فعلی؛
Δt: اندازه گام زمانی.
اگرچه روش اویلر ساده است، اما در بسیاری از مسائل پیچیده دقت کافی ندارد.
17.۲. روش رانگ–کوتا (Runge–Kutta)
روشهای رانگ–کوتا از پرکاربردترین روشهای حل معادلات دیفرانسیل هستند.
روش مرتبه چهارم آن:
است.
که در آن:
مراحل مختلف تخمین شیب سیستم هستند.
مزیت اصلی این روش، دستیابی به دقت بالا بدون نیاز به محاسبه مشتقات مرتبه بالاتر است.
18. انتخاب گام زمانی مناسب
یکی از تصمیمهای مهم در شبیهسازی، انتخاب اندازه گام زمانی است.
گام زمانی بسیار بزرگ میتواند:
- باعث خطای عددی شود؛
- رفتار واقعی سیستم را مخدوش کند؛
- ناپایداری مصنوعی ایجاد کند.
از طرف دیگر، گام زمانی بسیار کوچک:
- هزینه محاسباتی را افزایش میدهد؛
- زمان اجرای مدل را طولانی میکند.
بنابراین انتخاب گام زمانی باید بر اساس:
- سریعترین دینامیک سیستم؛
- دقت مورد نیاز؛
- روش حل عددی؛
- هدف شبیهسازی؛
انجام شود.
جمعبندی
در این بخش، فرآیند تبدیل ساختار مفهومی سیستم به یک مدل ریاضی و محاسباتی بررسی شد. مدل دینامیکی زمانی ارزشمند است که بتواند ساختار علّی سیستم را به روابط کمی تبدیل کرده و امکان تحلیل رفتار در طول زمان را فراهم کند.
انتخاب فرم ریاضی، تعیین متغیرهای حالت، انتخاب روش حل و تنظیم پارامترهای شبیهسازی، همگی بر کیفیت نتایج مدل اثر مستقیم دارند.
در مراحل بعدی توسعه مدل، توجه از «ساخت مدل» به «انتخاب ساختار مناسب مدل» منتقل میشود؛ زیرا حتی یک مدل ریاضی صحیح، در صورت انتخاب ساختار نامناسب، ممکن است نتواند رفتار واقعی سیستم را بازنمایی کند.
19. انتخاب ساختار مدل
انتخاب ساختار مدل یکی از مهمترین مراحل توسعه یک مدل دینامیکی است، زیرا حتی اگر فرآیند حل عددی، دادههای ورودی و روش تخمین پارامترها بهدرستی انجام شوند، یک ساختار نامناسب میتواند منجر به مدلی شود که قادر به بازنمایی رفتار واقعی سیستم نباشد.
ساختار مدل مشخص میکند که:
- چه متغیرهایی در مدل حضور داشته باشند؛
- روابط میان متغیرها چگونه تعریف شوند؛
- چه مکانیزمهایی در سیستم لحاظ شوند؛
- چه فرآیندهایی حذف یا سادهسازی شوند.
در بسیاری از پروژههای مدلسازی، توجه اصلی به تعیین پارامترها معطوف میشود، در حالی که خطای ساختاری مدل (Structural Error) میتواند بسیار مهمتر از خطای پارامتری باشد. اگر ساختار مدل نتواند مکانیسم اصلی ایجاد رفتار سیستم را نمایش دهد، حتی دقیقترین تخمین پارامترها نیز نمیتواند مدل را به یک نمایش مناسب از سیستم تبدیل کند.
Box (1979) این موضوع را با این دیدگاه مطرح میکند که هر مدل یک تقریب از واقعیت است، اما کیفیت این تقریب به این بستگی دارد که آیا ساختار انتخابشده برای هدف مورد نظر مناسب است یا خیر.
19.۱. مفهوم انتخاب ساختار مدل
انتخاب ساختار مدل فرآیندی است که در آن مدلساز تصمیم میگیرد چه سطحی از جزئیات و چه نوع روابطی برای نمایش سیستم مناسب هستند.
این تصمیم معمولاً تحت تأثیر عوامل زیر قرار دارد:
- هدف مدلسازی؛
- میزان دانش موجود درباره سیستم؛
- کیفیت دادههای در دسترس؛
- مقیاس زمانی مورد مطالعه؛
- سطح دقت مورد نیاز.
برای مثال، یک مدل مورد استفاده برای کنترل لحظهای یک فرآیند صنعتی ممکن است نیازمند جزئیات دینامیکی بسیار بالا باشد، در حالی که یک مدل سیاستگذاری بلندمدت ممکن است تنها به روابط اصلی میان متغیرها نیاز داشته باشد.
بنابراین ساختار مناسب یک مفهوم مطلق نیست؛ بلکه به سؤال مورد نظر وابسته است.
19.2. رابطه میان هدف مدل و ساختار آن
یکی از اصول بنیادی در مدلسازی این است که:
ساختار مدل باید بر اساس هدف استفاده از مدل تعیین شود، نه صرفاً بر اساس در دسترس بودن دادهها.
برای مثال، اگر هدف مدل بررسی علت کاهش عملکرد یک تجهیز صنعتی باشد، مدل باید شامل مکانیزمهایی باشد که افت عملکرد را ایجاد میکنند.
اما اگر هدف تنها پیشبینی خروجی آینده تجهیز باشد، ممکن است یک مدل دادهمحور با ساختار سادهتر عملکرد مناسبی داشته باشد.
این تفاوت را میتوان به صورت زیر بیان کرد:
به عبارت دیگر، هیچ ساختار مدلی وجود ندارد که برای تمام اهداف بهترین باشد.
19.3. ساختار مدل و سطح انتزاع
یکی از تصمیمهای اصلی در انتخاب ساختار، تعیین سطح انتزاع است.
مدلها را میتوان در سطوح مختلف توسعه داد:
سطح جزئیات بالا (High-Fidelity Model)
در این مدلها:
- فرآیندهای بیشتری لحاظ میشوند؛
- روابط فیزیکی دقیقتر هستند؛
- تعداد پارامترها بیشتر است.
مزایا:
- واقعگرایی بالاتر؛
- قابلیت تحلیل جزئیات.
محدودیتها:
- نیازمند داده بیشتر؛
- هزینه محاسباتی بالا؛
- دشواری تحلیل.
سطح جزئیات پایین (Reduced-Order Model)
در این مدلها:
- فرآیندهای اصلی حفظ میشوند؛
- جزئیات کماهمیت حذف میشوند.
مزایا:
- سرعت محاسباتی بالا؛
- قابلیت استفاده در شبیهسازیهای گسترده؛
- تفسیر سادهتر.
محدودیت:
- احتمال حذف برخی رفتارهای مهم.
انتخاب سطح مناسب انتزاع یکی از مهمترین مهارتهای مدلساز است. مدل بسیار دقیق اما غیرقابل استفاده، ارزش عملی محدودی دارد؛ همانطور که مدل بسیار ساده ممکن است نتواند مسئله اصلی را توضیح دهد.
19.4. تعادل بین پیچیدگی و سادگی مدل
یکی از چالشهای اساسی در توسعه مدل، ایجاد تعادل میان سادگی و پیچیدگی است.
این مسئله به عنوان معضل پیچیدگی مدل (Model Complexity Trade-off) شناخته میشود.
از یک طرف:
- مدل پیچیدهتر میتواند فرآیندهای بیشتری را نمایش دهد.
از طرف دیگر:
- تعداد پارامترها افزایش مییابد؛
- عدم قطعیت بیشتر میشود؛
- کالیبراسیون دشوارتر میشود؛
- تفسیر مدل کاهش مییابد.
20. اصل پارسیمونی در مدلسازی
اصل پارسیمونی یا سادهگرایی علمی بیان میکند که اگر چند مدل بتوانند یک پدیده را به شکل مشابه توضیح دهند، معمولاً مدل سادهتر ترجیح داده میشود.
این اصل در مدلسازی با مفهوم:
حداقل پیچیدگی لازم برای توضیح رفتار سیستم
ارتباط دارد.
اما باید توجه داشت که سادهسازی بیش از حد میتواند خطرناک باشد.
برای مثال، حذف انتقال حرارت از یک مدل راکتور ممکن است ساختار مدل را ساده کند، اما اگر تغییرات دما نقش مهمی در سرعت واکنش داشته باشد، مدل دیگر قادر به بازنمایی رفتار واقعی نخواهد بود.
بنابراین سادهسازی باید بر اساس تحلیل فیزیکی و هدف مدل انجام شود، نه صرفاً برای کاهش تعداد معادلات.
21. پیچیدگی ساختاری و پیچیدگی پارامتری
پیچیدگی مدل دو شکل اصلی دارد:
21.1.پیچیدگی ساختاری (Structural Complexity)
مربوط به تعداد و نوع روابط موجود در مدل است.
مثلاً:
- تعداد معادلات؛
- تعداد حلقههای بازخورد؛
- تعداد فرآیندهای در نظر گرفتهشده.
21.2.پیچیدگی پارامتری (Parametric Complexity)
مربوط به تعداد پارامترهایی است که باید تعیین شوند.
مثلاً:
- ضرایب انتقال؛
- ثابتهای سرعت؛
- ضرایب تجربی.
گاهی یک مدل با ساختار ساده اما تعداد زیادی پارامتر میتواند پیچیده باشد.
22. بیشبرازش ساختاری (Structural Overfitting)
در مدلهای دادهمحور، مفهوم بیشبرازش معمولاً به یادگیری بیش از حد الگوهای خاص دادههای آموزشی اشاره دارد. اما در مدلهای دینامیکی، مفهوم مشابهی در سطح ساختار نیز وجود دارد.
بیشبرازش ساختاری زمانی رخ میدهد که مدل شامل جزئیات یا روابطی شود که برای توضیح دادههای موجود مفید هستند، اما نماینده مکانیزم واقعی سیستم نیستند.
این مسئله میتواند زمانی رخ دهد که مدلساز:
- تعداد زیادی فرآیند کماهمیت اضافه کند؛
- روابط تجربی زیادی وارد مدل کند؛
- ساختار مدل را فقط برای تطبیق بهتر با دادهها تغییر دهد.
22.1. تفاوت بیشبرازش ساختاری و پارامتری
در بیشبرازش پارامتری:
ساختار مدل ثابت است، اما مقادیر پارامترها بیش از حد با دادههای خاص تطبیق داده میشوند.
در بیشبرازش ساختاری:
خود ساختار مدل برای توضیح دادههای موجود بیش از حد پیچیده شده است.
به صورت مفهومی:
اما:
ممکن است اتفاق بیفتد.
23. پیامدهای ساختار بیش از حد پیچیده
مدلهای دارای پیچیدگی بیش از اندازه معمولاً مشکلات زیر را ایجاد میکنند:
کاهش قابلیت تفسیر
کاربر نمیتواند مشخص کند کدام بخش مدل مسئول رفتار مشاهدهشده است.
افزایش عدم قطعیت
هر پارامتر جدید منبعی از عدم قطعیت ایجاد میکند.
دشواری اعتبارسنجی
بررسی تمام روابط و فرضیات مدل دشوار میشود.
کاهش قابلیت تعمیم
مدل ممکن است فقط برای شرایط خاص مناسب باشد.
2۴. روشهای تعیین ساختار مدل
انتخاب ساختار مدل معمولاً بر اساس یکی از سه رویکرد اصلی انجام میشود:
۱. رویکرد مبتنی بر دانش و قوانین فیزیکی
۲. رویکرد دادهمحور
۳. رویکرد ترکیبی
هر یک از این رویکردها فلسفه متفاوتی درباره نحوه شناخت سیستم دارند.
24.۱. رویکرد مبتنی بر دانش فیزیکی
در این روش، ساختار مدل بر اساس قوانین شناختهشده سیستم ایجاد میشود.
منابع اصلی اطلاعات عبارتاند از:
- قوانین بقای جرم و انرژی؛
- روابط ترمودینامیکی؛
- سینتیک واکنش؛
- اصول انتقال؛
- دانش تخصصی حوزه.
برای مثال، مدل یک راکتور شیمیایی معمولاً از ترکیب:
- موازنه جرم:
- موازنه انرژی:
ساخته میشود.
مزیت اصلی این رویکرد، قابلیت تفسیر و ارتباط مستقیم با فیزیک سیستم است.
24.۲. محدودیت مدلهای مبتنی بر دانش
با وجود مزایا، این مدلها محدودیتهایی دارند:
- نیازمند دانش عمیق سیستم هستند؛
- برخی فرآیندهای پیچیده ممکن است ناشناخته باشند؛
- تعیین برخی پارامترها دشوار است.
برای مثال، در یک کاتالیست صنعتی ممکن است ساختار سطحی، غیرفعال شدن تدریجی و تغییرات میکروسکوپی بهطور کامل شناخته نشده باشند.
24.۳. رویکرد دادهمحور
در مدلهای دادهمحور، ساختار مدل از الگوهای موجود در داده استخراج میشود.
روشهای رایج:
- رگرسیون؛
- شبکه عصبی مصنوعی؛
- ماشین بردار پشتیبان؛
- روشهای یادگیری عمیق.
فرم عمومی:
که در آن:
پارامترهای یادگرفتهشده مدل هستند.
مزیت اصلی:
- توانایی کشف روابط پیچیده.
محدودیت اصلی:
- کاهش تفسیرپذیری.
25. رویکرد ترکیبی (Hybrid Modeling)
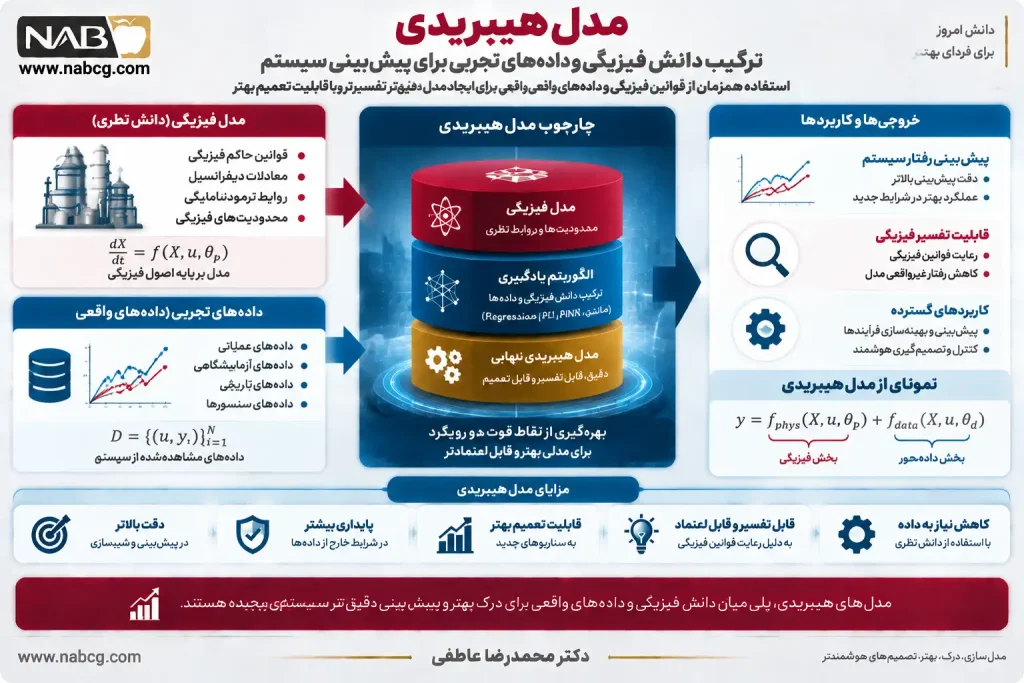
با افزایش پیچیدگی سیستمهای واقعی، محدودیتهای مدلهای کاملاً فیزیکی و مدلهای کاملاً دادهمحور بیش از پیش آشکار شده است. مدلهای مبتنی بر دانش فیزیکی معمولاً قابلیت تفسیر بالایی دارند، اما در مواجهه با فرآیندهایی که بخشی از مکانیزم آنها ناشناخته است یا روابط آنها بسیار پیچیده است، با محدودیت مواجه میشوند. در مقابل، مدلهای دادهمحور توانایی بالایی در استخراج الگوهای پیچیده از دادهها دارند، اما اغلب فاقد توضیح فیزیکی روشن درباره علت ایجاد رفتار سیستم هستند.
مدلسازی ترکیبی با هدف ترکیب نقاط قوت این دو رویکرد شکل گرفته است. در این رویکرد، دانش موجود درباره ساختار سیستم با اطلاعات استخراجشده از دادههای تجربی ترکیب میشود تا مدلی ایجاد شود که هم از نظر فیزیکی معتبر باشد و هم توانایی تطبیق با رفتارهای پیچیده مشاهدهشده را داشته باشد.
به صورت کلی میتوان ساختار یک مدل ترکیبی را چنین نمایش داد:
البته این رابطه الزاماً به معنای جمع ساده دو مدل نیست؛ بلکه بیانگر این است که بخش دادهمحور میتواند برای اصلاح، تکمیل یا کاهش خطای مدل فیزیکی مورد استفاده قرار گیرد.
25.1. ساختارهای اصلی مدلهای ترکیبی
مدلهای ترکیبی معمولاً در چند ساختار اصلی توسعه داده میشوند.
ساختار موازی (Parallel Hybrid Model)
در این روش، مدل فیزیکی یک پیشبینی اولیه ارائه میدهد و مدل دادهمحور خطای آن را اصلاح میکند.
ساختار کلی:
که در آن:
y_physical: خروجی مدل فیزیکی؛
y_correction: اصلاح دادهمحور.
این روش زمانی مناسب است که مدل فیزیکی ساختار کلی سیستم را به خوبی توصیف کند اما دارای خطاهای سیستماتیک باشد.
برای مثال، در یک مدل انتقال حرارت، معادلات فیزیکی ممکن است رفتار کلی را پیشبینی کنند، اما یک شبکه عصبی بتواند اثرات ناشناخته مانند تغییر خواص ماده یا شرایط محیطی را اصلاح کند.
- ساختار سری (Serial Hybrid Model)
در این روش، خروجی یک مدل به عنوان ورودی مدل دیگر استفاده میشود.
برای مثال:
در این حالت، مدل دادهمحور میتواند روابط پیچیدهای را بر اساس خروجی مدل فیزیکی یاد بگیرد.
- ساختار تعبیهشده (Embedded Hybrid Model)
در این روش، دانش فیزیکی مستقیماً داخل ساختار مدل یادگیری قرار میگیرد.
یکی از نمونههای مهم این رویکرد، یادگیری ماشین آگاه از فیزیک (Physics-Informed Machine Learning) است.
در این روش، قوانین فیزیکی به عنوان محدودیت در تابع هدف مدل وارد میشوند.
به طور کلی:
که در آن:
Loss Data: خطای مربوط به دادهها؛
Loss Physics: میزان نقض قوانین فیزیکی؛
λ: وزن اهمیت محدودیت فیزیکی.
این رویکرد باعث میشود مدل علاوه بر تطبیق با داده، رفتار سازگار با دانش فیزیکی داشته باشد (Karniadakis et al., 2021).
26.انتخاب بین مدلهای فیزیکی، دادهمحور و ترکیبی
انتخاب نوع مدل به ماهیت مسئله، میزان دانش موجود و هدف مطالعه وابسته است.
جدول زیر تفاوت سه رویکرد اصلی را نشان میدهد:
| ویژگی | مدل فیزیکی | مدل دادهمحور | مدل ترکیبی |
| نیاز به دانش سیستم | زیاد | کم | متوسط تا زیاد |
| نیاز به داده | متوسط | زیاد | متوسط |
| تفسیرپذیری | بالا | پایینتر | متوسط تا بالا |
| توانایی نمایش روابط پیچیده | محدود | بالا | بالا |
| تعمیم خارج از داده | معمولاً مناسب | ممکن است ضعیف باشد | معمولاً بهتر |
| توسعه مدل | زمانبر | سریعتر | پیچیدهتر |
هیچ رویکردی به صورت مطلق بر دیگری برتری ندارد. انتخاب مناسب باید بر اساس سؤال تحقیق انجام شود.
برای مثال:
- اگر قوانین فیزیکی سیستم کاملاً شناخته شده باشند، مدل مکانیکی مناسب است.
- اگر سیستم بسیار پیچیده باشد و داده زیادی وجود داشته باشد، مدل دادهمحور میتواند مناسب باشد.
- اگر دانش فیزیکی وجود دارد اما برخی فرآیندها ناشناخته هستند، مدل ترکیبی گزینه مناسبی خواهد بود.
27.پارامترسازی مدل
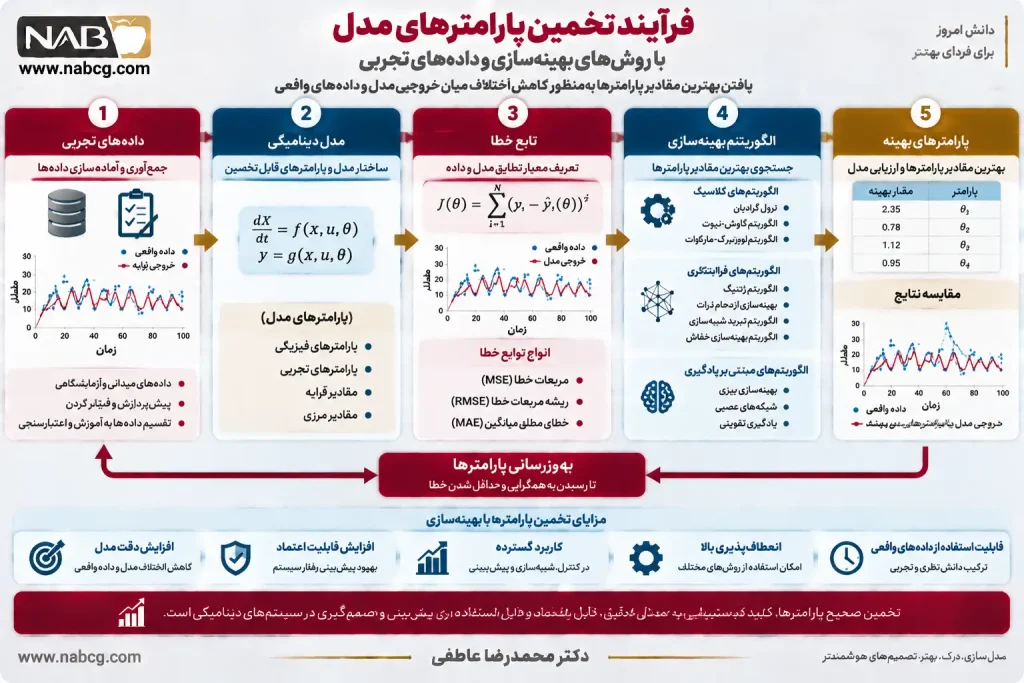
پس از تعیین ساختار مدل، مرحله بعدی تعیین مقادیر پارامترهایی است که رفتار سیستم را کنترل میکنند. حتی یک مدل با ساختار صحیح، بدون پارامترهای مناسب نمیتواند رفتار واقعی سیستم را بازنمایی کند.
پارامترسازی فرآیندی است که طی آن مقادیر نامعلوم یا کمیتهای قابل تنظیم مدل از طریق:
- دادههای تجربی؛
- آزمایشهای سیستم؛
- اطلاعات فیزیکی؛
- روشهای بهینهسازی؛
تعیین میشوند.
به بیان ساده:
ساختار مدل مشخص میکند سیستم چگونه رفتار میکند؛ پارامترها مشخص میکنند این رفتار با چه شدتی رخ میدهد.
27.1. مفهوم پارامتر در مدلهای دینامیکی
پارامترها مقادیری هستند که ویژگیهای ثابت یا نسبتاً ثابت سیستم را تعیین میکنند و در طول اجرای مدل معمولاً تغییر نمیکنند.
به عنوان مثال، در مدل واکنش شیمیایی:
پارامترهای مدل عبارتاند از:
- k : ثابت سرعت واکنش؛
- n : مرتبه واکنش.
در مدل انتقال حرارت:
پارامترها شامل:
- h : ضریب انتقال حرارت؛
- A : سطح انتقال.
هستند.
27.2. تفاوت پارامتر و متغیر حالت
یکی از اشتباهات رایج در مدلسازی، یکسان در نظر گرفتن پارامتر و متغیر حالت است.
متغیر حالت:
- در طول زمان تغییر میکند؛
- وضعیت سیستم را نشان میدهد؛
- دارای معادله دینامیکی است.
مثال:
پارامتر:
- معمولاً ثابت فرض میشود؛
- ویژگی سیستم را مشخص میکند؛
- مستقیماً تابع زمان نیست.
مثال:
در مدلهای پیشرفته، برخی پارامترها ممکن است تابع شرایط محیطی یا زمان شوند، اما در این حالت دیگر به عنوان پارامتر ثابت کلاسیک در نظر گرفته نمیشوند.
27.3. پارامترهای قابل شناسایی و غیرقابل شناسایی
یکی از مسائل مهم در پارامترسازی مدل، قابلیت شناسایی پارامترها (Parameter Identifiability) است.
یک پارامتر زمانی قابل شناسایی است که بتوان مقدار آن را با استفاده از دادههای موجود به صورت قابل اعتماد تعیین کرد.
فرض کنید مدل زیر وجود دارد:
اگر تنها مقدار y مشاهده شود، نمیتوان مشخص کرد مقدار دقیق a و b چقدر است.
مثلاً:
و
هر دو خروجی یکسان تولید میکنند.
در این حالت، پارامترها به صورت جداگانه قابل شناسایی نیستند.
اهمیت قابلیت شناسایی
عدم شناسایی پارامترها میتواند باعث شود:
- چند مجموعه پارامتر رفتار مشابه تولید کنند؛
- نتایج مدل دارای عدم قطعیت بالا باشد؛
- تفسیر فیزیکی مدل دشوار شود.
به همین دلیل، قبل از کالیبراسیون مدل باید بررسی شود که آیا دادههای موجود اطلاعات کافی برای تخمین پارامترها فراهم میکنند یا خیر.
28. روشهای تعیین پارامترها
پس از تعریف ساختار مدل و مشخص شدن پارامترهای مورد نیاز، مرحله بعدی تعیین مقادیر مناسب برای این پارامترها است. این فرآیند که با عنوان تخمین پارامتر (Parameter Estimation) یا شناسایی پارامتر (Parameter Identification) شناخته میشود، یکی از مراحل حیاتی توسعه مدلهای دینامیکی است.
حتی اگر ساختار مدل کاملاً صحیح انتخاب شده باشد، انتخاب نامناسب مقادیر پارامترها میتواند موجب شود مدل رفتار متفاوتی نسبت به سیستم واقعی نشان دهد. به همین دلیل، پارامترسازی تنها یک مرحله محاسباتی نیست، بلکه فرآیندی است که ارتباط میان مدل نظری و رفتار مشاهدهشده سیستم را برقرار میکند.
به طور کلی، روشهای تعیین پارامتر را میتوان در چهار گروه اصلی طبقهبندی کرد:
۱. تعیین مستقیم از قوانین فیزیکی و اندازهگیریها
۲. تخمین پارامتر از دادههای تجربی
۳. روشهای بهینهسازی عددی
۴. روشهای احتمالاتی و بیزی
انتخاب روش مناسب به ماهیت سیستم، میزان اطلاعات موجود و هدف مدلسازی وابسته است.
28.۱. اندازهگیری مستقیم پارامترها
در برخی سیستمها، پارامترهای مدل را میتوان مستقیماً از طریق آزمایش یا اندازهگیری تعیین کرد. این روش معمولاً زمانی استفاده میشود که پارامتر دارای معنای فیزیکی مشخص باشد و امکان اندازهگیری آن وجود داشته باشد.
برای مثال، در یک مدل انتقال حرارت:
ضریب انتقال حرارت h میتواند از آزمایشهای انتقال حرارت تعیین شود.
همچنین در یک مدل جریان سیال:
پارامترهای هندسی مانند سطح مقطع A مستقیماً قابل اندازهگیری هستند.
مزیت اصلی این روش، ارتباط مستقیم مقدار پارامتر با معنای فیزیکی آن است. در این حالت، پارامتر فقط یک عدد تنظیمشده برای تطبیق مدل نیست، بلکه نماینده یک ویژگی واقعی سیستم است.
28.2.محدودیتهای اندازهگیری مستقیم
با وجود مزایای روش اندازهگیری مستقیم، در بسیاری از سیستمهای پیچیده امکان تعیین تمام پارامترها به این روش وجود ندارد.
دلایل اصلی عبارتاند از:
- دشواری اندازهگیری مستقیم؛
- هزینه بالای آزمایش؛
- تغییرپذیری پارامتر در شرایط مختلف؛
- نبود تجهیزات مناسب.
برای مثال، در یک راکتور کاتالیستی صنعتی، پارامترهایی مانند:
- فعالیت مؤثر کاتالیست؛
- ضریب انتقال جرم مؤثر؛
- پارامترهای سینتیکی واکنشهای جانبی؛
ممکن است به صورت مستقیم قابل اندازهگیری نباشند.
در چنین شرایطی باید از روشهای تخمین پارامتر استفاده کرد.
29. تخمین پارامتر از دادههای تجربی
یکی از رایجترین روشهای تعیین پارامتر، استفاده از دادههای مشاهدهشده سیستم است. در این روش، مقادیر پارامترها به گونهای انتخاب میشوند که خروجی مدل بیشترین تطابق را با دادههای واقعی داشته باشد.
فرض کنید مدل به شکل زیر باشد:
که در آن:
- y : خروجی مشاهدهشده؛
- x : ورودی سیستم؛
- θ : بردار پارامترها.
هدف یافتن مقدار:
θ∗
است به گونهای که:
باشد.
29.۱. روش حداقل مربعات (Least Squares)
یکی از پرکاربردترین روشهای تخمین پارامتر، روش حداقل مربعات است.
در این روش، مجموع مربع اختلاف میان خروجی مدل و داده واقعی کمینه میشود:
که در آن:
y_i: مقدار واقعی مشاهدهشده؛
ŷ_i: خروجی مدل؛
N: تعداد دادهها.
پارامتر بهینه از حل مسئله زیر به دست میآید:
این روش به دلیل سادگی و پایه نظری قوی، در بسیاری از حوزهها از جمله مهندسی فرآیند، کنترل و شناسایی سیستم استفاده میشود.
29.2. تخمین بیشینه درستنمایی (Maximum Likelihood Estimation)
در روش بیشینه درستنمایی، پارامترها به گونهای انتخاب میشوند که احتمال مشاهده دادههای موجود بیشینه شود.
اگر دادهها دارای خطای تصادفی باشند:
که:
خطای مشاهده است، هدف یافتن پارامترهایی است که بیشترین احتمال تولید داده مشاهدهشده را داشته باشند.
تابع درستنمایی:
معمولاً به شکل لگاریتمی تبدیل میشود:
و سپس بیشینه میشود.
این روش زمانی اهمیت دارد که ساختار آماری خطاهای اندازهگیری شناخته شده باشد.
30. روشهای بهینهسازی عددی برای تخمین پارامتر
در مدلهای پیچیده، رابطه میان پارامترها و خروجی مدل معمولاً غیرخطی است. در این شرایط، حل تحلیلی مسئله تخمین پارامتر دشوار یا غیرممکن میشود و از الگوریتمهای بهینهسازی استفاده میشود.
مسئله کلی بهینهسازی:
است.
که در آن:
- θ : پارامترهای مدل؛
- J : تابع هزینه یا معیار خطا.
روش گرادیان نزولی (Gradient Descent)
در این روش، پارامترها در جهت کاهش تابع هزینه تغییر داده میشوند:
که در آن:
- α : نرخ یادگیری؛
- ∇J : گرادیان تابع هزینه.
این روش پایه بسیاری از الگوریتمهای یادگیری ماشین و بهینهسازی مدرن است.
الگوریتمهای تکاملی
برای مسائل پیچیده که دارای فضای جستجوی بزرگ یا چندین نقطه بهینه محلی هستند، روشهای تکاملی مورد استفاده قرار میگیرند.
نمونهها:
- الگوریتم ژنتیک (Genetic Algorithm)
- بهینهسازی ازدحام ذرات (Particle Swarm Optimization)
- الگوریتم تکامل تفاضلی (Differential Evolution)
این روشها بر اساس ایدههایی از تکامل طبیعی و جستجوی جمعی توسعه یافتهاند.
برای مثال، در الگوریتم ژنتیک:
- هر مجموعه پارامتر یک فرد محسوب میشود؛
- تابع هزینه میزان شایستگی فرد را تعیین میکند؛
- نسلهای جدید با ترکیب و جهش ایجاد میشوند.
31. روشهای بیزی در تخمین پارامتر
در بسیاری از سیستمهای واقعی، پارامترها کاملاً مشخص نیستند و دارای عدم قطعیت هستند. در این شرایط، نگاه قطعی به پارامترها ممکن است کافی نباشد.
روش بیزی پارامتر را به عنوان یک متغیر تصادفی در نظر میگیرد.
بر اساس قضیه بیز:
که در آن:
- p(θ) : توزیع اولیه پارامتر؛
- p(y∣θ) : احتمال مشاهده داده با توجه به پارامتر؛
- p(θ∣y) : توزیع پسین پارامتر پس از مشاهده داده.
مزیت اصلی این رویکرد این است که به جای ارائه یک مقدار منفرد برای پارامتر، یک توزیع احتمالی ارائه میدهد.
برای مثال، به جای بیان:
میتوان داشت:
که نشاندهنده عدم قطعیت موجود در مقدار پارامتر است.
این ویژگی باعث میشود روشهای بیزی ارتباط مستقیمی با تحلیل عدم قطعیت و ارزیابی ریسک داشته باشند.
32.ارتباط پارامترسازی با کالیبراسیون و اعتبارسنجی مدل
پارامترسازی، کالیبراسیون و اعتبارسنجی سه مرحله مرتبط اما متفاوت در توسعه مدل هستند.
این سه مفهوم اغلب با یکدیگر اشتباه گرفته میشوند.
32.۱. کالیبراسیون مدل (Model Calibration)
کالیبراسیون فرآیندی است که طی آن پارامترهای مدل تنظیم میشوند تا رفتار مدل با دادههای مشاهدهشده سازگار شود.
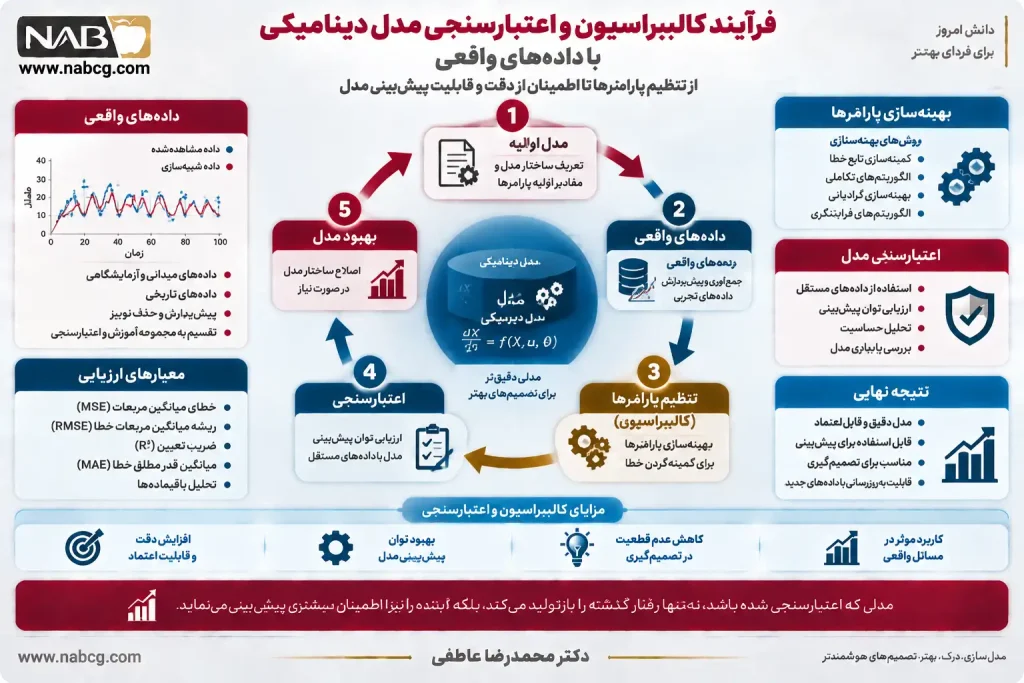
هدف:
در این مرحله، دادههای آموزشی یا دادههای کالیبراسیون استفاده میشوند.
32.۲. اعتبارسنجی مدل (Model Validation)
پس از کالیبراسیون، باید بررسی شود که آیا مدل در شرایط جدید نیز عملکرد مناسبی دارد یا خیر.
در اعتبارسنجی:
- دادههای جدید استفاده میشوند؛
- عملکرد مدل ارزیابی میشود؛
- قابلیت تعمیم بررسی میگردد.
یک مدل ممکن است روی دادههای کالیبراسیون عملکرد عالی داشته باشد، اما در شرایط دیگر ضعیف عمل کند.
32.۳. رابطه میان ساختار، پارامتر و اعتبار مدل
اعتبار مدل حاصل تعامل سه عامل اصلی است:
یعنی:
- ساختار باید مکانیزم درست را نمایش دهد؛
- پارامترها باید مقادیر مناسب داشته باشند؛
- دادهها باید اطلاعات کافی ارائه کنند.
اگر ساختار مدل اشتباه باشد، بهترین پارامترها نیز مشکل را حل نمیکنند.
جمعبندی
در این فصل فرآیند کامل توسعه مدل از مرحله تعریف مسئله تا ساختار ریاضی، انتخاب روش مدلسازی و تعیین پارامترها بررسی شد. مشخص شد که توسعه مدل تنها یک فعالیت محاسباتی نیست، بلکه فرآیندی علمی شامل تصمیمگیری درباره سطح انتزاع، انتخاب ساختار مناسب، تعیین روابط علّی، تبدیل دانش سیستم به معادلات و تنظیم پارامترها است.
مدلی که به درستی توسعه یافته باشد، پایهای برای مراحل بعدی چرخه مدلسازی خواهد بود؛ یعنی:
- اعتبارسنجی مدل؛
- تحلیل حساسیت؛
- تحلیل عدم قطعیت؛
- ارزیابی سناریوها؛
- تصمیمگیری مبتنی بر مدل.
منابع فصل (References)
Box, G. E. P. (1979). Robustness in the strategy of scientific model building. Robustness in Statistics, 201–236.
Forrester, J. W. (1961). Industrial Dynamics. MIT Press.
Karniadakis, G. E., Kevrekidis, I. G., Lu, L., Perdikaris, P., Wang, S., & Yang, L. (2021). Physics-informed machine learning. Nature Reviews Physics, 3, 422–440.
Ogata, K. (2010). Modern Control Engineering. Prentice Hall.
Sterman, J. D. (2000). Business Dynamics: Systems Thinking and Modeling for a Complex World. McGraw-Hill.
Ljung, L. (1999). System Identification: Theory for the User. Prentice Hall.
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep Learning. MIT Press.
Bishop, C. M. (2006). Pattern Recognition and Machine Learning. Springer.
Richardson, G. P. (1991). Feedback thought in social science and systems theory. University of Pennsylvania Press. اطلاعات کتاب Richardson